
著者注:本記事では、公式仕様、短いコンテキストでの価格、272Kの長いコンテキスト利用時の追加料金、キャッシュ読み取り価格、Anthropicの発表記事に掲載された比較スコアをもとに、Claude Fable 5.2とGPT-6 Astraを比較します。また、2026-11-10時点で、どちらをすぐに利用できるかも説明します。
Claude Fable 5.2とGPT-6 Astraのどちらに予算を割り当てるかを決めるには、まず3つの疑問に答える必要があります。どちらが高性能なのか、どちらが高価なのか、そして今日から利用できるのはどちらなのか。先に結論をお伝えします。Anthropicの発表記事にある比較表では、GPT-6 AstraがClaude Fable 5.2を上回る項目はありません。短いコンテキストでの標準価格も、Astraのほうが高額です。ただし、Astraは今日から注文できる一方、Fable 5.2はまだ提供開始を待つ必要があります。
本記事は「どちらにも一長一短がある」という折衷的な分析ではありません。 根拠としているのは、両社の公式モデルページと料金ページに記載された仕様・価格、およびAnthropicが2026-11-09の発表記事で公開した比較スコアの2種類だけです。公式資料に記載のない数値については、すべて「不明」としています。価格と提供状況の確認時刻は、いずれも北京時間の2026-11-10です。
この記事でわかること:自分のタスクの種類、コンテキストの長さ、キャッシュヒット率を踏まえて、Claude Fable 5.2とGPT-6 Astraのどちらがよりお得かを判断できます。
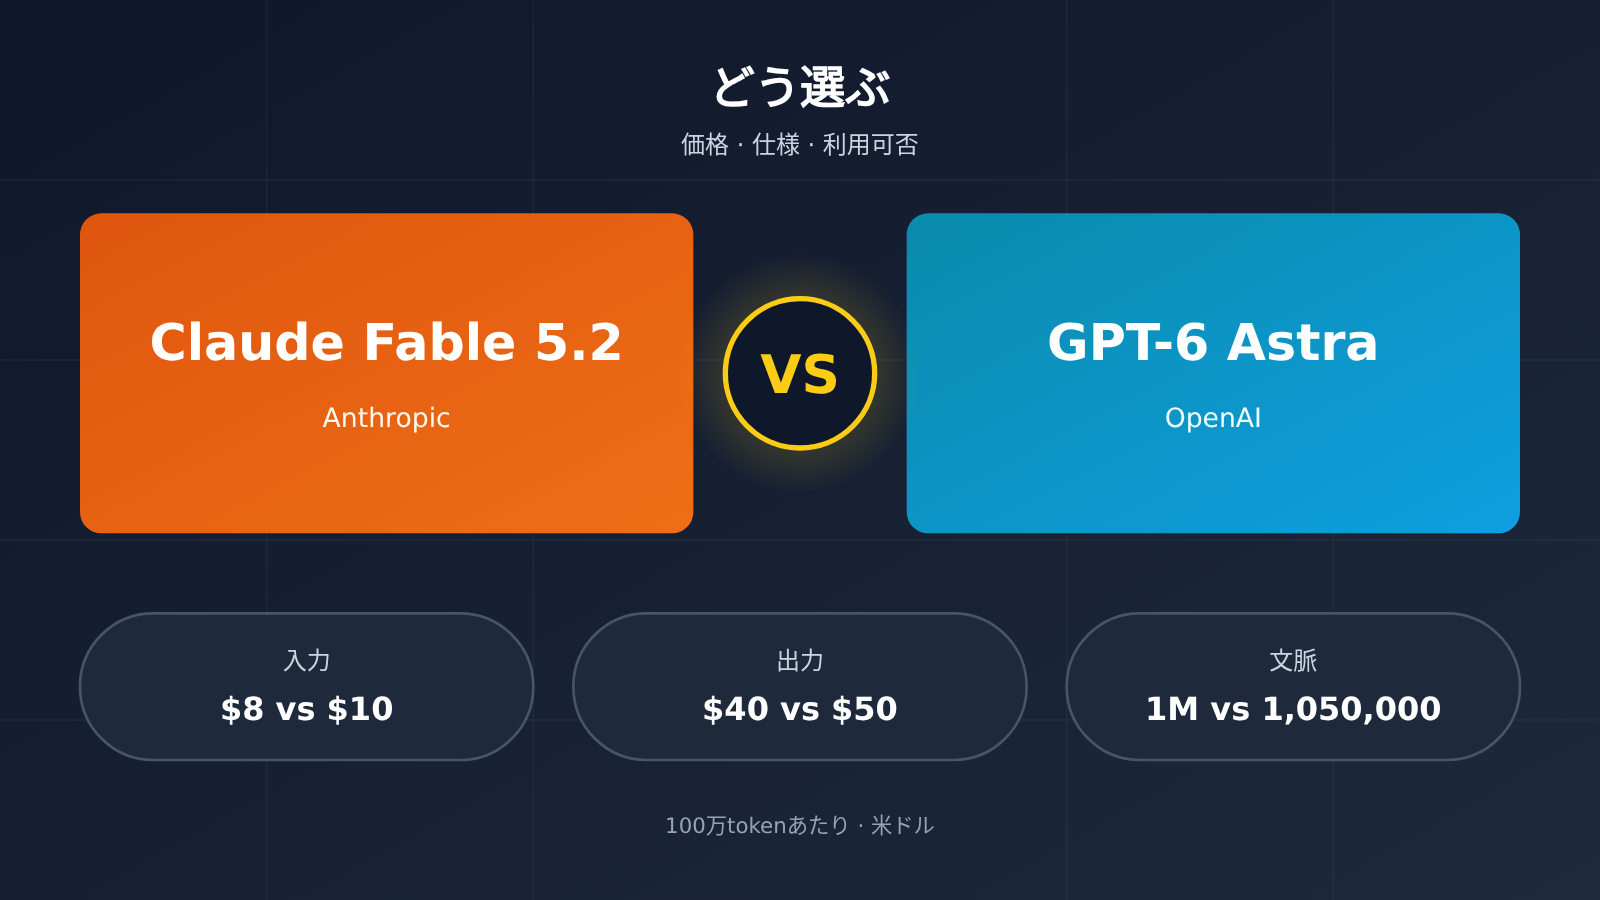
Claude Fable 5.2とGPT-6 Astraの主な違い
まず、Claude Fable 5.2とは何かを説明します。Anthropicは2026年11月9日、Claude Fable 5.2とClaude Mythos 5.2を同時に発表しました。発表文によると、両者は同じ基盤モデルです。Fableには、より強力なサイバーセキュリティとバイオセキュリティのガードレールが備わっているため、すべてのユーザーが利用できます。一方、Mythosは、生命科学またはサイバーセキュリティの審査プログラムを通過した組織のみが利用できます。Mythosは、Fableより強力な別のモデルというわけではありません。
GPT-6 Astraは、OpenAIが「最も難しい仕事」向けと位置付けるモデルで、モデルIDはgpt-6-astraです。GPT-6 Cyberとは別のモデルです。以下の比較はすべてAstraのみを対象としています。
| 比較項目 | Claude Fable 5.2 | GPT-6 Astra | 結論 |
|---|---|---|---|
| 短いコンテキストでの標準価格 | 入力 $8 / 出力 $40 | 入力 $10 / 出力 $50 | Fableのほうが安価 |
| キャッシュ読み取り | $0.20 | $1 | Fableのほうが大幅に安価 |
| 長いコンテキストの追加料金 | 公開価格表に272Kの区切りなし | 入力が272Kを超える場合、1回のリクエスト全体で入力とキャッシュは2倍、出力は1.5倍の料金 | 長いプロンプトではFableの価格優位性がさらに大きい |
| Anthropicの比較表での成績 | 同じ項目のすべてで上回る | Fable 5.2を上回る項目はなし | Fableが優勢。ただし、項目によっては差が小さい |
| 現在、APIYIで利用できるか | まだモデル一覧にない | すでにモデル一覧にある | Astraなら今すぐ利用可能 |
Claude Fable 5.2 と GPT-6 Astra の仕様比較
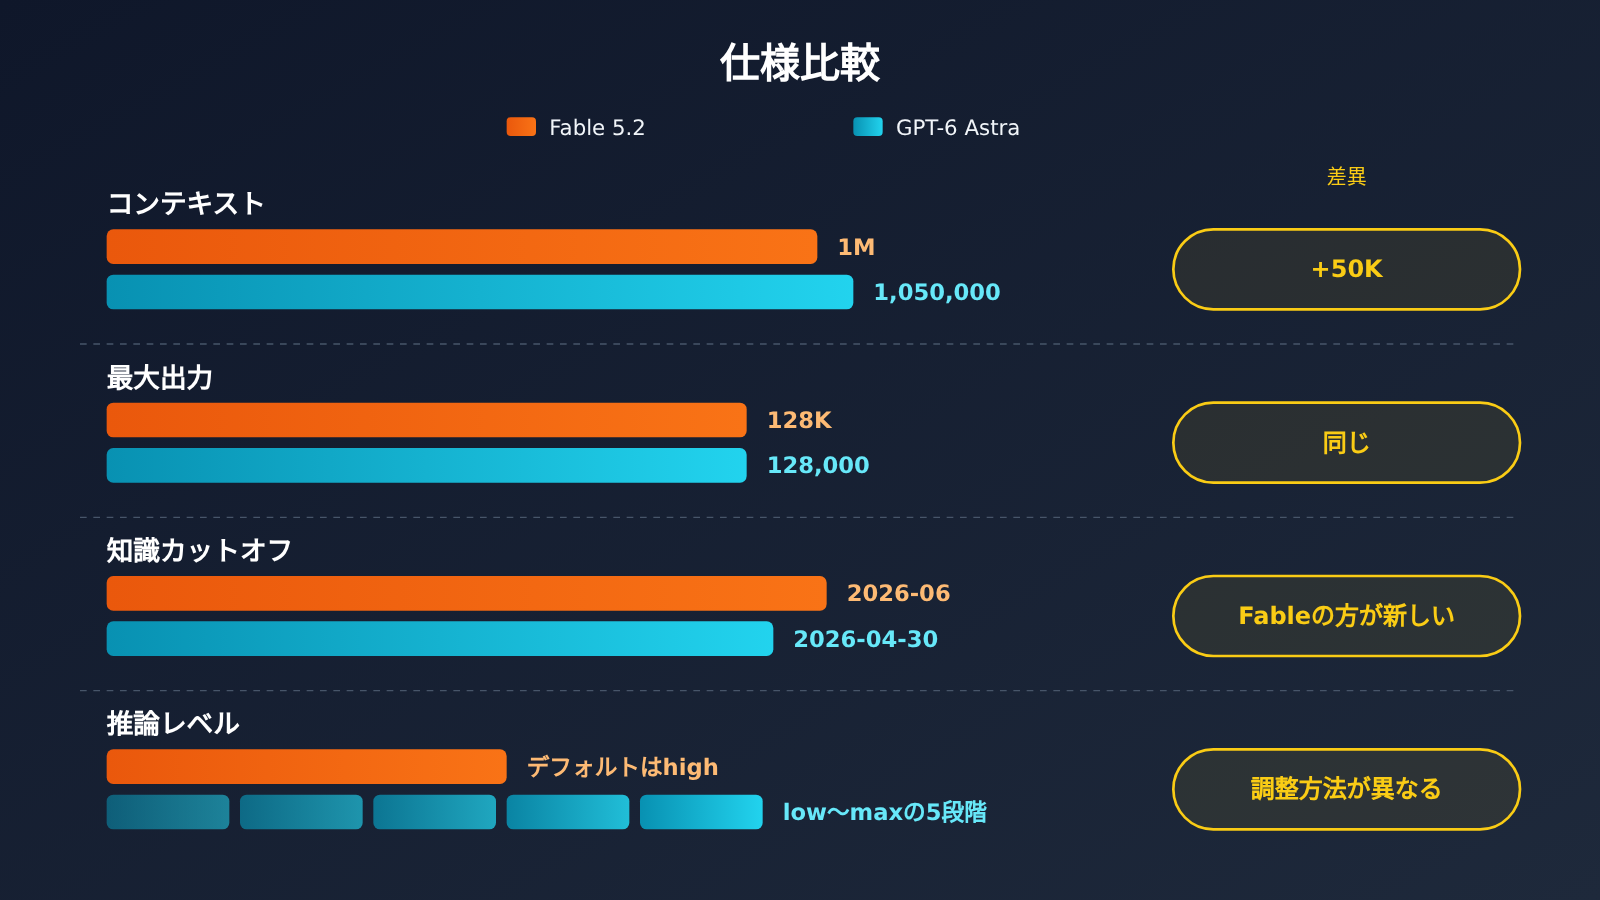
どちらもテキストと画像を入力でき、テキストを出力します。コンテキストはいずれも約100万トークンです。実際の導入に影響するのは、細かな違いです。Astraは最大入力を922,000トークンと明記していますが、Fableはコンテキストを1Mとだけ記載しています。Fableの知識カットオフは、Astraより約2か月新しいものです。
| 仕様項目 | Claude Fable 5.2 | GPT-6 Astra |
|---|---|---|
| モデルID | claude-fable-5-2(Bedrockでは anthropic.claude-fable-5-2) |
gpt-6-astra |
| コンテキスト | 1Mトークン | 1,050,000トークン |
| 最大入力 | 公式には個別記載なし | 922,000トークン |
| 最大出力 | 128K(同期Messages API) | 128,000トークン |
| 知識カットオフ | 2026年6月 | 2026-04-30 |
| 推論の強度 | アダプティブ思考は常時有効。Claude APIのデフォルトのeffortはhigh | reasoning.effortでlow、medium、high、xhigh、maxを選択可能 |
| 入力/出力モダリティ | テキストと画像/テキスト | テキストと画像/テキスト |
Fable 5.2にはいくつか導入上の制約があるため、移行前に確認が必要です。
- 思考を無効にできない:アダプティブ思考は常時有効です。思考量を減らすには、effortを調整する必要があります。medium以上では、プロンプトに「考えないでください」と書いても効果はありません。
- サンプリングパラメーターを指定するとエラーになる:リクエストに
temperature、top_p、top_kを含めると、400エラーが返されます。 - ツール呼び出しを強制できない:
tool_choiceをanyまたはtoolに設定すると、400エラーが返されます。 - データ保持:デフォルトでは、データを30日間保持する必要があります。Anthropicから明示的な許可を得ない限り、ゼロデータ保持は利用できません。
- 拒否時の応答:リクエストが拒否されても、HTTPステータスコードは200のままで、
stop_reasonはrefusalになります。こうしたリクエストもレート制限の枠を消費します。
既存コードでtemperatureによる調整やツール呼び出しの強制を行っている場合、Fable 5.2への移行にはコードの変更が必要です。その作業量も切り替えコストに含めて検討しましょう。
Claude Fable 5.2 と GPT-6 Astra の価格比較
ここでは、公式の短コンテキスト向け標準価格のみを比較します。価格の単位は、100万トークンあたりの米ドルです。第三者の再販サイトが提示する低価格は対象外です。
| 価格項目 | Claude Fable 5.2 | GPT-6 Astra |
|---|---|---|
| 標準入力 | $8 | $10 |
| 標準出力 | $40 | $50 |
| キャッシュ読み取り | $0.20 | $1 |
| キャッシュ書き込み | 5分 $10、1時間 $16 | $12.5 |
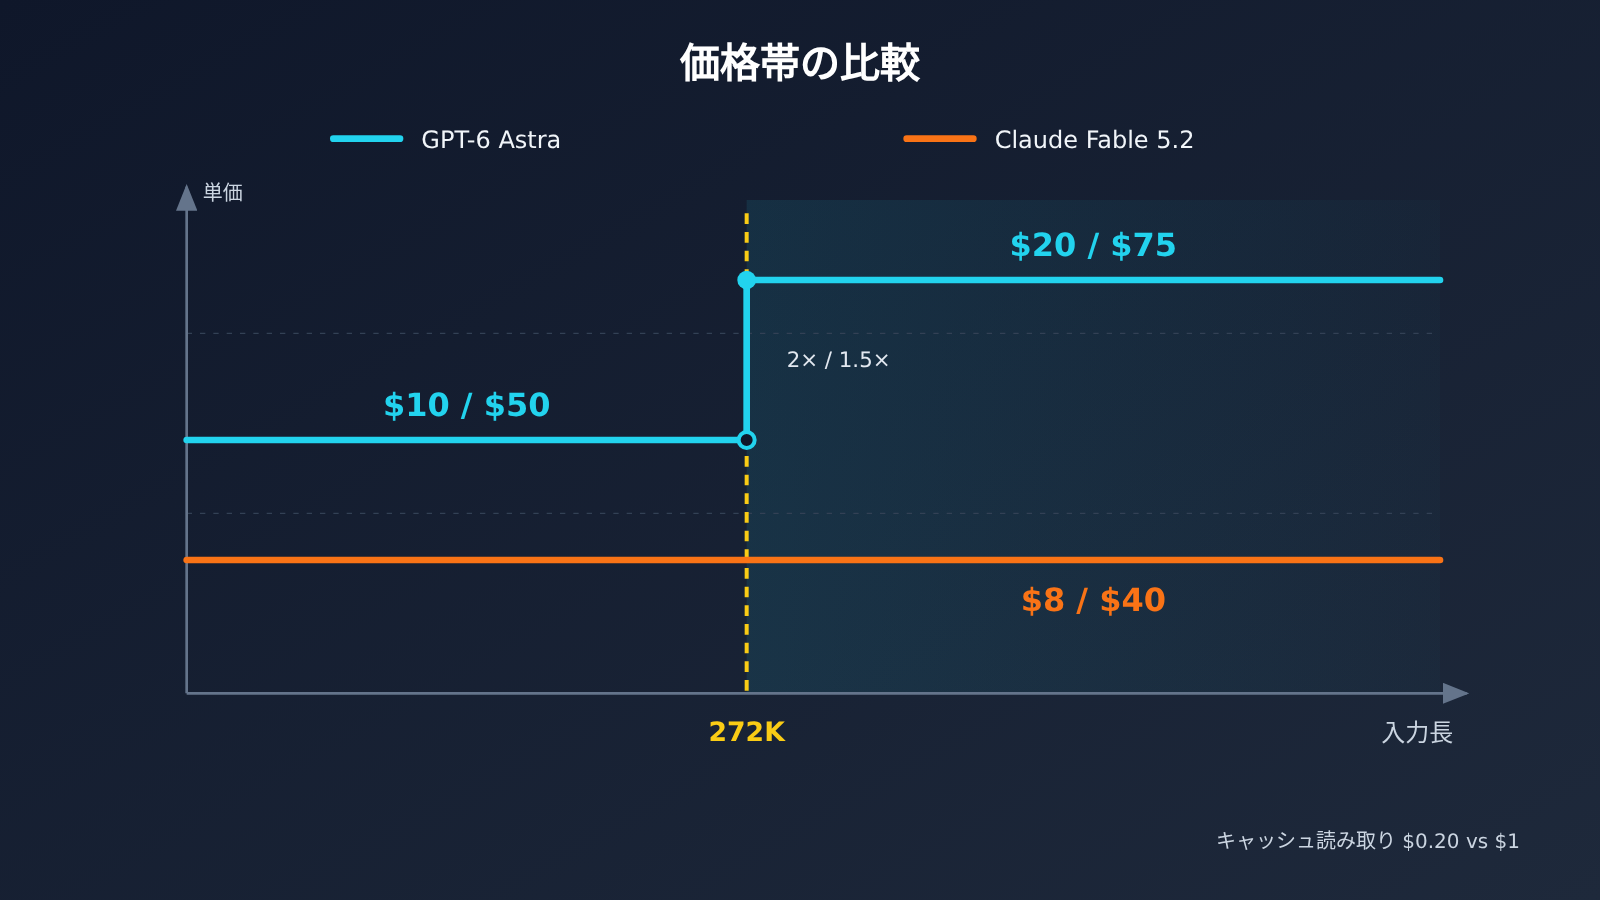
| 入力が272Kを超える場合 | 公開価格表にこの区分なし | 入力 $20、出力 $75(公式ルール) |
| バッチ処理 | バッチ価格は半額:入力 $4、出力 $20 | 参考資料に記載なし |
| 高速モード | 入力 $16、出力 $80 | 参考資料に記載なし |
短コンテキスト:Fableはすべての項目で20%安い
272K以内では、Fable 5.2の入力・出力価格はどちらもAstraより20%安くなっています。たとえば、1回のリクエストで入力が100Kトークン、出力が10Kトークンの場合、公式価格で計算するとAstraは約$1.50(入力$1.00+出力$0.50)、Fableは約$1.20(入力$0.80+出力$0.40)です。
キャッシュ読み取りの価格差はさらに大きくなります。Fableのキャッシュ読み取り価格は標準入力価格の0.025倍、つまり$0.20です。Astraのキャッシュ入力価格は$1で、Fableの5倍です。たとえば、長いシステムプロンプトやコードベースのコンテキストを毎回送るアプリケーションで、キャッシュヒットが毎回200Kトークン発生する場合、公式価格で計算するとFableは約$0.04、Astraは約$0.20です。
長コンテキスト:Astraの272Kの価格区分
Astraでは、1回のリクエストの入力が272Kトークンを超えると、リクエスト全体の入力とキャッシュが2倍、出力が1.5倍の価格になります。価格は入力が$20、出力が$75です。キャッシュ関連の単価は倍率で示されているため、その倍率から計算すると、キャッシュ入力は約$2、キャッシュ書き込みは約$25です。Fableの公開価格表にはこのような272Kの区分がないため、この記事では長コンテキスト向けの追加料金を仮定しません。
もう一つ例を見てみましょう。入力が400Kトークン、出力が20Kトークンの場合、倍率から計算するとAstraは約$9.50(入力$8+出力$1.50)です。Fableは公式標準価格で計算すると約$4.00(入力$3.20+出力$0.80)です。プロンプトが長くなるほど、両者の価格差は大きくなります。
Claude Fable 5.2 と GPT-6 Astra のベンチマーク比較
この節で紹介するスコアはすべて、Anthropicが2026-11-09に公開した発表文に基づいています。ここでの比較はAnthropicの発表文に掲載されたものであり、OpenAIが独自に公開したランキングではありません。特に記載がない限り、表のスコアは各モデルで当時利用できた最高の努力レベルで測定されたものです。Fable 5.2のスコアは、ガードレールを有効にした状態での結果です。
| 項目 | Fable 5.2 | GPT-6 Astra | 差 |
|---|---|---|---|
| FrontierSWE v2 | 69.9% | 65.5% | 小さい |
| Chartography(ツールなし) | 73.4% | 71.0% | 小さい |
| FrontierCode 2.0 | 49.1%(Xhigh) | 42.8% | 大きい |
| RoboDojo Sim | 64.9% | 29.8% | 非常に大きい |
| AutomationBench | 51.4% | 41.4% | 本項目の最高スコアはGemini 4 Carbonの53.9% |
| OSWorld 2.1(オフラインセット、一部) | 89.3% | 79.5% | 大きい |
| Terminal-Bench-Science 0.1 | 74.6% | 68.1% | 中程度 |
| Humanity’s Last Exam(ツールあり) | 74.2% | 57.2% | 大きい |
差が小さい2項目
FrontierSWEでは69.9%対65.5%、Chartographyでは73.4%対71.0%と、どちらもFableがリードしていますが、その差は小さめです。主なタスクが一般的なソフトウェアの修正やグラフの理解であれば、この2項目だけを根拠に「モデルを必ず切り替えるべき」と判断するには不十分です。ChartographyではGemini 4 Carbonも72.5%で、3社のスコアはほぼ拮抗しています。
差が大きい2項目
FrontierCode 2.0は、変更内容がオープンソースリポジトリのメンテナーにマージされるかどうかを評価します。この項目では、Fable 5.2はXhighレベルで49.1%、Astraは42.8%でした。発表文によると、HighレベルのFable 5.2も約45.3%で、Astraの最高スコアを上回り、タスクあたりのコストはおおむね同程度です。RoboDojo Simは、カメラ画像をもとにシミュレーション上の双腕ロボットを制御する能力を測定します。Fable 5.2は64.9%、Astraは29.8%で、両モデルの差が最も大きい項目です。ただし、64.9%はAnthropicによる内部実行の結果であり、公開ランキング上の順位ではない点に注意が必要です。
Astraに対する全面的な優位とは言えない項目
AutomationBenchでは、Fable 5.2が51.4%、Astraが41.4%です。ただし、この項目の最高スコアはGemini 4 Carbonの53.9%です。そのため、この結果から言えるのはFableがAstraを上回っていることまでであり、自動化の分野全体で優位に立っているとは言えません。
発表文にあるサイバーセキュリティの比較項目CyScenarioBenchは、AstraではなくGPT-6 Cyberを対象としており、Anthropic側のスコアもMythos 5.2のものです。そのため、この記事では比較対象に含めていません。WANDRではAstraの欄が空欄のため、スコアを補っていません。
現在、APIYIで呼び出せるモデル
2026-11-10時点で、APIYIのモデル一覧(docs.apiyi.com)と公開価格APIを確認しました。価格APIから返された283モデルの中に、claude-fable-5-2は含まれておらず、Mythos系のモデルもありませんでした。このモデルは近日中に提供開始する予定です。モデル名と価格は、プラットフォームのモデル一覧をご確認ください。 提供開始前のため、この記事ではAPIYIでの価格を掲載せず、グループ倍率を公式価格に掛けて推定することもありません。
| モデルID | 一覧表示価格(入力 / 出力 / キャッシュ読み取り) | エンドポイント | 状態 |
|---|---|---|---|
gpt-6-astra |
$10 / $50 / $1 | responses(メイン)、chat | 提供中 |
claude-opus-5-5、claude-opus-5-5-thinking |
$4 / $20 / $0.2 | chat、messages | 提供中 |
claude-fable-5-1、claude-fable-5-1-thinking |
$10 / $50 / $0.25 | chat、messages | 提供中 |
claude-fable-5-2 |
未掲載 | 未掲載 | 未提供 |
APIYIでgpt-6-astraを呼び出す際は、次の点を押さえておきましょう。
- 接続方法:APIYIはOpenAI互換インターフェースを提供しています。
base_urlにhttps://api.apiyi.com/v1、モデル名にgpt-6-astraを指定します。公式のメインエンドポイントはresponsesですが、chatにも対応しています。 - 長い入力の料金:モデル一覧の脚注によると、入力が0~272,000トークンの場合は100万トークンあたり$10、272,001~1,050,000トークンの場合は100万トークンあたり$20です。
- 長文コンテキスト利用時の出力料金:モデル一覧の脚注には、このケースの出力料金が記載されていません。コンソールの請求額をご確認ください。
- 実際の請求額:一覧に表示されている価格は表示価格です。実際の請求額にはトークンのグループ倍率が適用されます。最終的な金額は請求明細をご確認ください。
今すぐClaudeシリーズを使いたい場合は、まずclaude-opus-5-5またはclaude-fable-5-1で動作を確認し、Fable 5.2の提供開始後にモデルを切り替えるとよいでしょう。Anthropicの発表でも、一般的なコーディングや知識業務ではまずOpus 5.5から始め、タスクの難易度に応じてFableに切り替えることが推奨されています。新規ユーザーは、APIYI(apiyi.com)の無料テスト枠を利用して、手元のプロンプトを試せます。
Claude Fable 5.2とGPT-6 Astraの使い分け
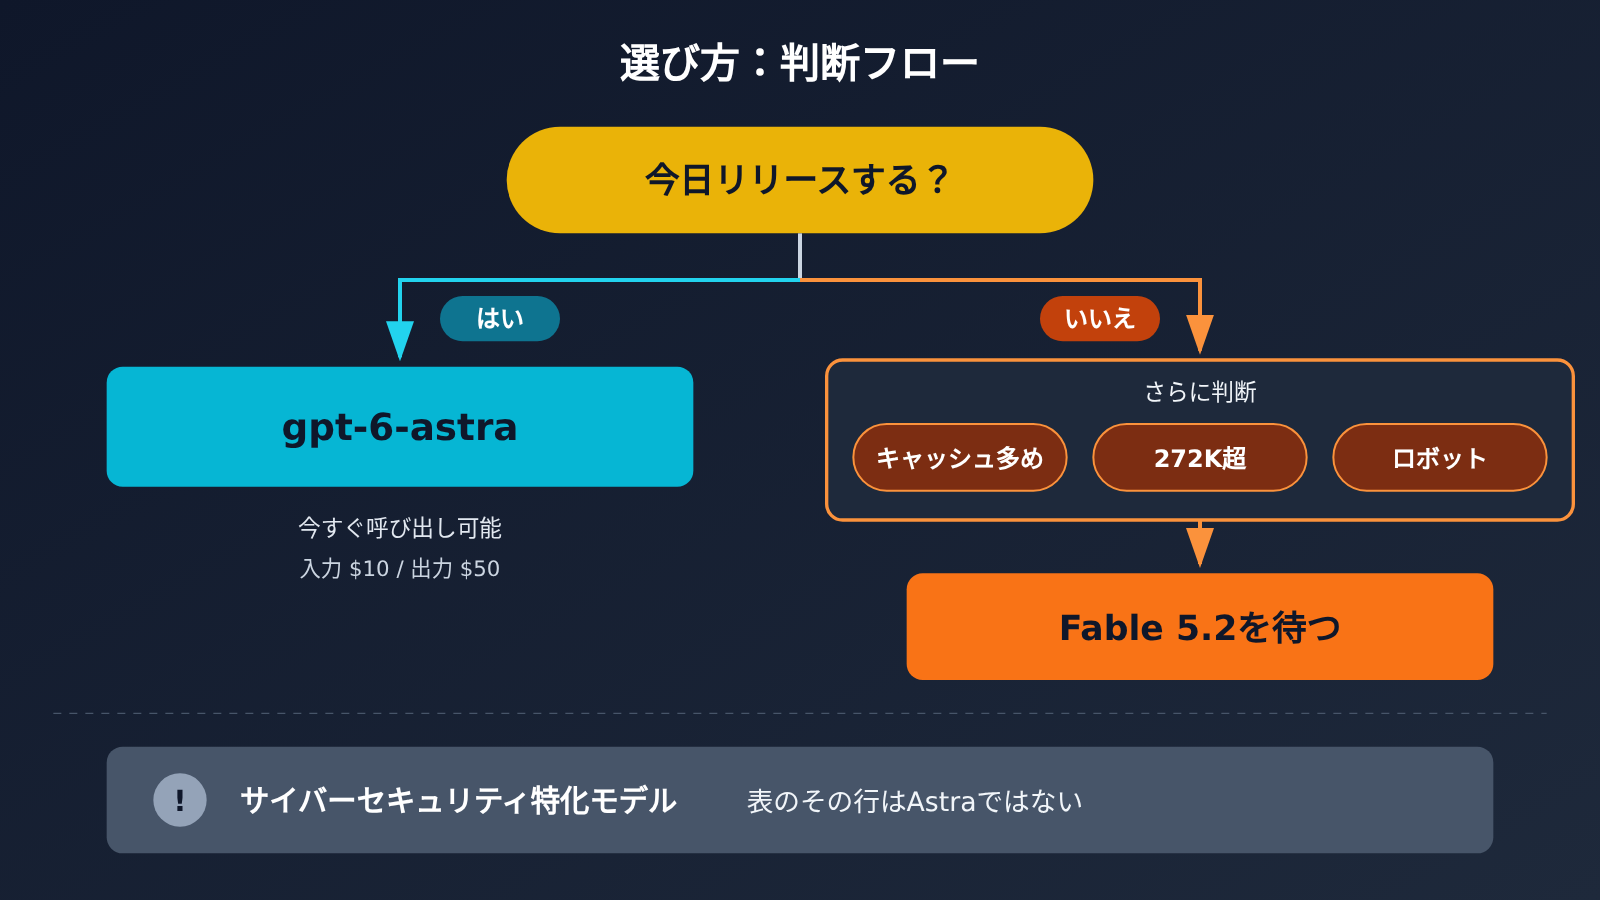
GPT-6 Astraが向いているケース
- 今日中にリリースしたい:今すぐAPIYIで注文するなら、まずは
gpt-6-astraを呼び出しましょう。 - 推論レベルを細かく調整したい:Astraの
reasoning.effortには5段階あり、コストを細かく調整できます。 - 主な用途が一般的なソフトウェアの修正やグラフの理解:この2種類のタスクでは、Anthropicの比較表を見る限り、両モデルに大きな差はありません。
Claude Fable 5.2が向いているケース
- キャッシュヒット率が高い:キャッシュ読み取り料金は、Astraの$1に対して$0.20です。長時間稼働するエージェント型アプリでは、特にコストを抑えられます。
- プロンプトが272Kを超えることが多い:Fableには、Astraのような272K超の長文コンテキストに対する追加料金の境界がありません。
- ロボットシミュレーションや長期的なコーディング:RoboDojoとFrontierCodeでは、両モデルの差が特に大きくなっています。
- Claudeのツールエコシステムに依存している:Claude Codeや高速モードを利用する場合などです。
判断のポイント:乗り換えるべきとき、乗り換えないほうがよいとき
💡 選び方の目安:今すぐ使うなら、APIYI(apiyi.com)で
gpt-6-astraを呼び出してみましょう。総合料金表では、入力が$10、出力が$50、キャッシュ読み取りが$1です。入力が272,000トークンを超える場合は、100万トークンあたり$20になります。Claudeのツールを使いたい場合や、キャッシュ読み取りのコストを抑えたい場合、あるいはロボットシミュレーションや長期的なコーディングを重視する場合は、claude-fable-5-2の提供開始をお待ちください。このモデルは近日中に提供する予定です。モデル名と価格は、apiyi.comのプラットフォームに掲載されているモデル一覧をご確認ください。
次の2つのケースでは、この比較表だけを根拠にモデルを乗り換えるのはおすすめしません。1つ目は、表に掲載されていないタスクに使う場合です。たとえば、特定分野の質疑応答や、中国語の長文執筆などが該当します。こうした用途では、表のスコア差をそのまま当てはめることはできません。自分のサンプルを使って比較しましょう。2つ目は、サイバーセキュリティ専用モデルが必要な場合です。表の該当項目で比較対象になっているのはAstraではなくGPT-6 Cyberです。また、Fable 5.2自体には強化されたサイバーセキュリティガードレールが備わっており、ブロックされたリクエストにはOpus 4.8が代わりに回答します。
よくある質問(FAQ)
Q1:Claude Fable 5.2 と Claude Mythos 5.2 の違いは何ですか?
どちらも同じ基盤モデルで、価格も同じです。Fable はサイバーセキュリティとバイオセーフティに関するガードレールが強化されており、すべてのユーザーが利用できます。一方、Mythos は審査プログラムを通過した組織のみが利用できます。
Q2:GPT-6 Astra と GPT-6 Cyber は同じモデルですか?
いいえ。発表資料のサイバーセキュリティに関する項目で比較されているのは GPT-6 Cyber です。その項目のスコアを Astra の成績として扱うことはできません。
Q3:これらの成績は OpenAI が公表したものですか?
いいえ。成績はすべて、2026-11-09 に Anthropic が公開した資料に基づくもので、Anthropic 自身が行った比較です。資料で言及されている外部評価機関は、このブログ記事を確認していません。
Q4:Fable 5.2 のバッチ価格はいくらですか?
公式ルールでは、バッチ API の入力・出力料金がともに半額になります。半額のバッチ料金を適用すると、Fable 5.2 は入力 $4、出力 $20 です。Astra のバッチ価格は参考資料に記載がないため、わかりません。
Q5:Fable 5.2 で 300K の出力を利用できますか?
公式の対象モデル一覧に Fable 5.2 の記載はありません。そのため、この記事では Messages API と同じ 128K の上限を適用しています。
Q6:Fable 5.2 にはどのような既知の制限がありますか?
主な制限は次のとおりです。思考機能を無効にできないこと、サンプリングパラメーターを指定したリクエストやツール呼び出しを強制するリクエストは 400 エラーになること、データがデフォルトで30日間保持されることです。また、アクセラレーターカーネルの最適化や大規模言語モデルのアーキテクチャ改善など、AI研究開発に直結する能力は、意図的に Opus 5.5 程度に制限されています。
Claude Fable 5.2 と GPT-6 Astra の比較:要点
- ベンチマーク成績:Anthropicの比較表では、AstraがFable 5.2を上回る項目はありません。
- 差が小さい項目:FrontierSWEは69.9%対65.5%、Chartographyは73.4%対71.0%です。
- 差が大きい項目:FrontierCodeは49.1%対42.8%、RoboDojoは64.9%対29.8%です。
- 短いコンテキストでの料金:入力・出力ともに、FableはAstraより20%安価です。
- キャッシュと長いコンテキスト:キャッシュ読み取りは$0.20対$1です。Astraでは入力が272Kを超えると、入力料金は2倍、出力料金は1.5倍になります。
- 利用状況:2026-11-10時点で、直接呼び出せるのは
gpt-6-astraのみです。
まとめ
- 性能面:Anthropicが公開した比較によると、Fable 5.2が全項目で優位です。特に、ロボットシミュレーションと長時間にわたるコーディングで差が目立ちます。
- コスト面:短いコンテキスト、キャッシュ読み取り、長いプロンプトのいずれでも、Fableのほうが低コストです。
- 利用開始時期:Astraはすぐに呼び出せますが、Fable 5.2は提供開始を待つ必要があります。
すぐに業務で使う必要がある場合は、まずAstraで運用を開始し、プロンプトキャッシュの活用と、コンテキスト長を272K以内に抑えることをおすすめします。コストやロボット、長時間にわたるコーディングのタスクを重視する場合は、まずOpus 5.5またはFable 5.1でワークフローを構築し、Fable 5.2の提供開始後にモデルを切り替えて比較するとよいでしょう。
著者:APIYI 技術チーム
技術に関するお問い合わせ:APIYI(apiyi.com)のトップページからお気軽にお問い合わせください。詳しい資料はdocs.apiyi.comのドキュメントセンターをご覧ください。


