
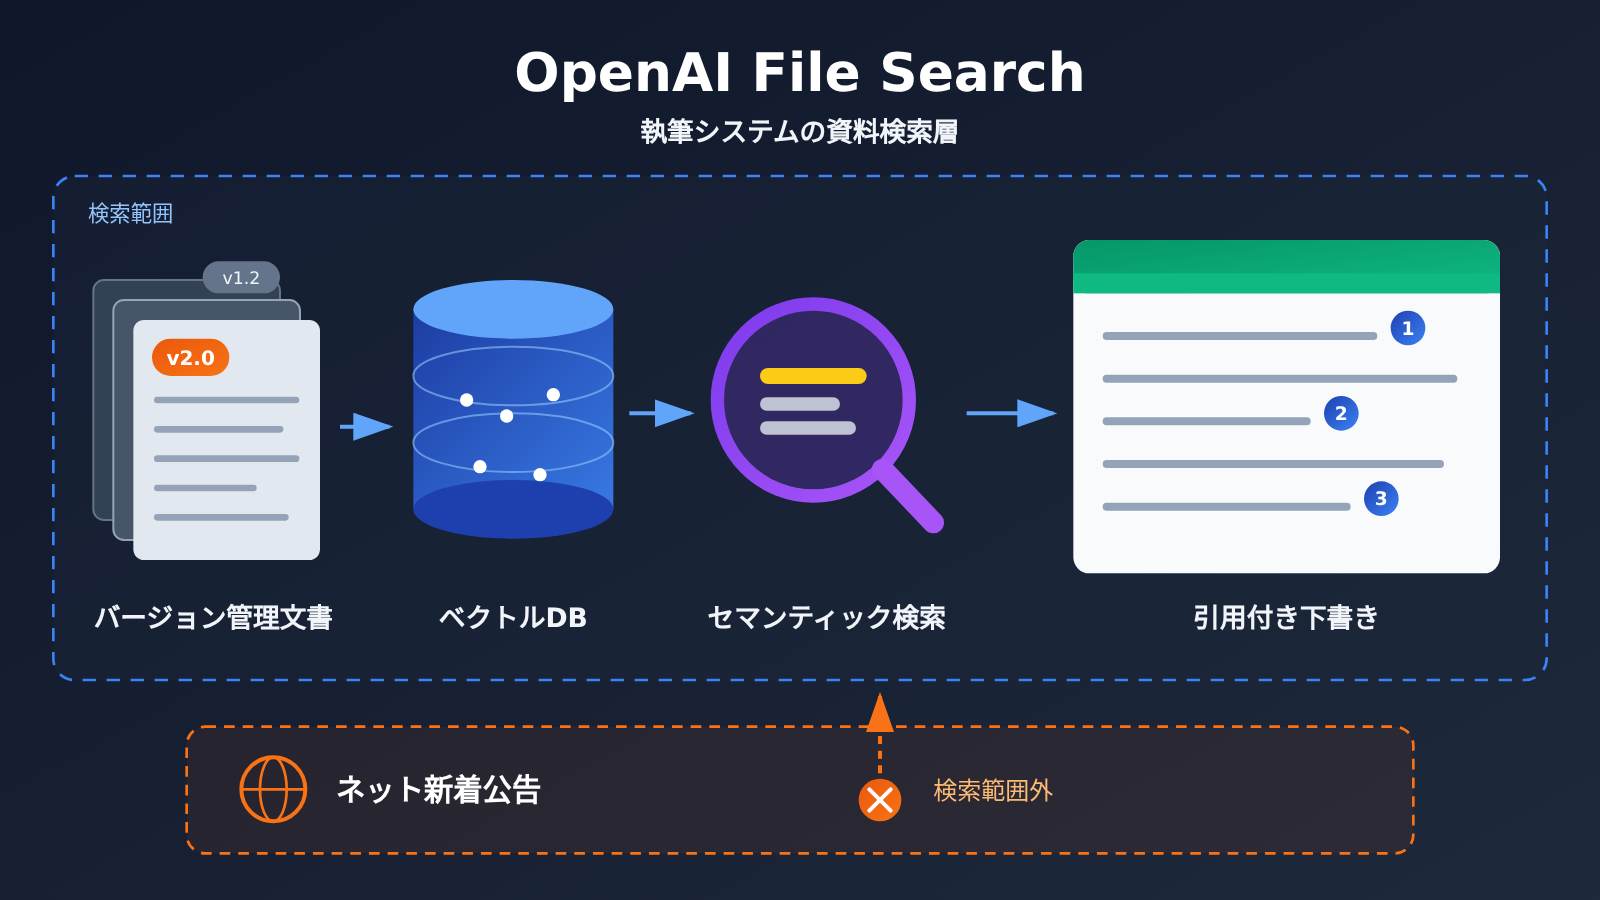
一部は補えますが、すべては補えません。 OpenAI File Search が解決するのは「既存資料を正確に探せない、引用が不明瞭」という問題です。ベクターストアからファイルをセマンティック検索し、回答にファイル引用を付けてくれます。これは執筆システムにとって非常に有用です。しかし「資料そのものが欠けている、または古くなっている」という問題は解決しません。ツールはあくまで自分が投入したファイルだけを検索し、インターネット上の新しい告知を自動的に見つけることはありません。引用マークは内容がどのファイルに由来するかを示すだけで、結論が正しいことを保証するものではありません。
したがって、より正確な判断はこうです。File Search は執筆システムの「資料検索レイヤー」として機能できますが、資料収集、バージョン管理、ファクトチェックは別途行う必要があります。
この記事を読むとわかること
- Responses API における File Search の位置づけと、執筆フローに提供できる機能
- リコール件数の調整方法、および実際に検索された内容をレスポンスで返す方法(トラブル調査に便利)
- ファイル削除後、短期間はまだ検索でヒットする可能性がある理由と、執筆システム側の対処法
- 資料欠如、リコール失敗、生成ミスの3種類の問題を、それぞれどのレイヤーで修正すべきか
- 登録時にどのメタデータを保存すべきか。古い制限事項を現行ルールとして書いてしまうのを避けるために
目次: 本文の前書きではまずいくつかの重要概念を説明し、対象読者別に影響を整理します。「客観的事実」パートでは OpenAI 公式ドキュメントに基づき、File Search の動作方式、調整可能なパラメータ、既知の挙動をまとめます。「分析判断」パートでは、執筆システムに組み込んだ際の役割分担、トラブルシューティングの道筋、登録規範について議論し、最後に警戒すべきいくつかの誤解を説明します。
OpenAI File Search の関連概念
| 概念 | 簡単な説明 |
|---|---|
| Responses API | OpenAI の応答生成インターフェース。1回のリクエストでツールを組み付けることができ、File Search はそのうちの一つです |
| File Search | Responses API の組み込みツール。ベクトルストア内のファイルから関連する断片を検索し、回答の生成を支援します |
| ベクトルストア(Vector Store) | アップロード済みのファイルとそのベクトル表現を格納するストア。File Search の検索範囲はここになります |
| セマンティック検索 | 意味の類似度に基づいて内容を探す方法。字面の用語が違っていても、意味が関連する段落を見つけられます |
| ファイル引用(Citation) | 回答の中で、ある内容がどのファイルに由来するかを示す注記。読者やレビュー担当者が確認しやすくなります |
max_num_results |
1回の検索で最大何件の結果を返すかを制御するパラメータ |
include |
リクエストパラメータ。file_search_call.results を渡すと、応答に実際に取得された内容が含まれます |
| 結果整合性 | 書き込みや削除の操作がすぐにすべての場所へ反映されるわけではなく、短時間は古い状態が見えることがあります |
OpenAI File Search の影響早見表
| 対象者 | 主な影響 |
|---|---|
| ライティングシステムの開発者 | 検索サービスを自前で構築しなくても、セマンティック検索とファイル引用が手に入ります。ただし、データ投入のルールやトラブルシューティングの流れは自分で設計する必要があります |
| コンテンツ編集者 / レビュー担当者 | 引用があると確認が楽になりますが、結論はやはり1件ずつ照合する必要があり、「引用があるから」といってそのまま通すわけにはいきません |
| 技術ドキュメントの保守担当者 | 新旧バージョンのドキュメントにはバージョンと日付を明記してください。そうしないと古い制限事項が検索でヒットし、新しい記事に書かれてしまう可能性があります |
| コスト責任者 | ベクトルストアのストレージとツール呼び出しはどちらも課金対象です。具体的な料金は OpenAI の現在の価格ページに準拠します。資料の量が多い場合は事前に見積もりが必要です |
OpenAI File Search の客観的事実
以下の内容は、OpenAI 開発者ドキュメントのうち File Search と Retrieval の2つのガイドに基づいており、確認日は 2026-11-17 です。この2つは継続的に更新されているドキュメントであり、本記事ではこの機能の初回リリース日を確認していません。
File Search とは:Responses API における検索ツール
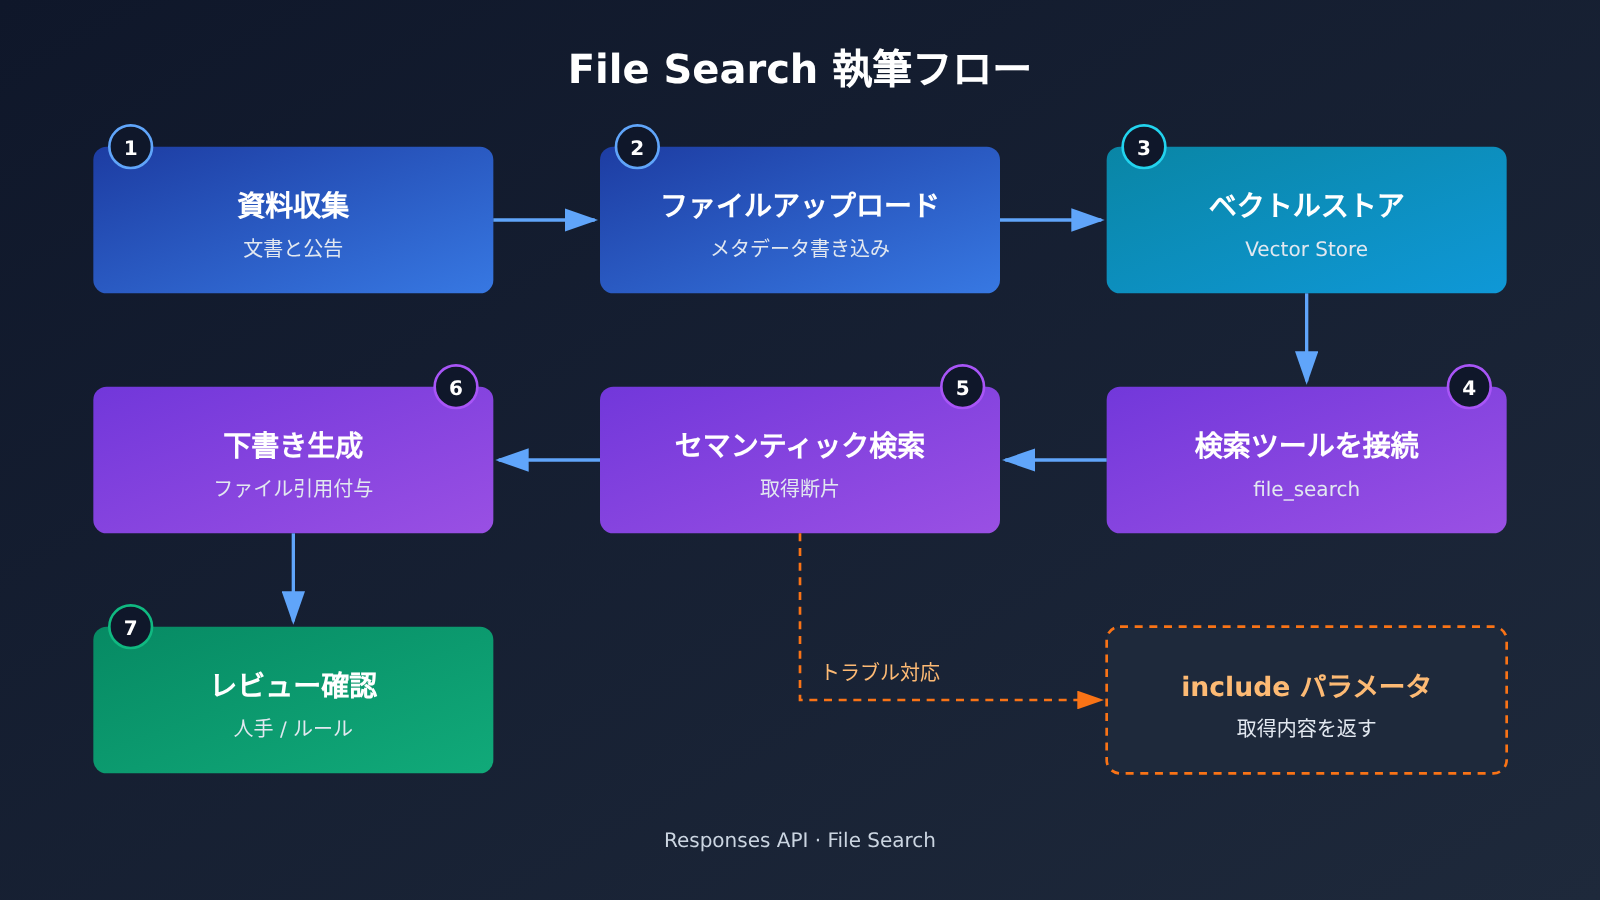
File Search は Responses API が提供するツールです。開発者はまずファイルをベクターストアにアップロードし、リクエストを送るときに tools の中で File Search を宣言してベクターストアを指定します。モデルが回答を生成する際には、これらのファイルから関連する内容を検索し、回答にファイル参照を付けて情報の出典を示すことができます。
セマンティック検索を採用しているため、意味は関連しているものの語句が完全には一致しない内容も見つけられます。たとえば「APIレート制限」で検索した場合、ドキュメントに「リクエスト頻度の上限」と書かれていてもヒットする可能性があります。執筆システムにとってこれは、質問するときに原文の言い回しをそのまま再現する必要がないことを意味します。
File Search の調整可能なパラメータとトラブルシューティング用スイッチ
ドキュメントの中で、執筆システムと最も直接的な関係があるパラメータは次の2つです。
| パラメータ / 動作 | 役割 | 執筆フローにおける意味 |
|---|---|---|
max_num_results |
1回の検索で返す結果数を調整する | 数が少ないほどコンテキストを節約できますが、証拠が不足する可能性があります。数が多いほど広くカバーできますが、ノイズも増えます |
| デフォルトの返却内容 | ツール呼び出しはデフォルトで完全な検索結果を返しません | 最終回答だけを見ると、モデルが実際に何を読んだのか判断できません |
include: ["file_search_call.results"] |
レスポンスに実際に取得した内容を含める | 「取得できなかった」と「取得したが誤って書いた」を切り分けられます。トラブルシューティングに必須です |
| ファイル引用 | 回答に出典ファイルを明記する | 確認には便利ですが、結論が正しいこととは別です |
以下は最小限の呼び出し例です。ベクトルストアのマウント、検索結果数の制限、レスポンスへの検索結果の包含を指定する方法を示しています。モデル名とベクトルストアIDは、ご自身の設定に置き換えてください。
from openai import OpenAI

client = OpenAI()  # 環境変数 OPENAI_API_KEY からキーを読み取る

response = client.responses.create(
    model="YOUR_MODEL",
    input="根据资料库,总结该接口目前的调用限制,并标明出处。",
    tools=[{
        "type": "file_search",
        "vector_store_ids": ["YOUR_VECTOR_STORE_ID"],
        "max_num_results": 8,   # 取得件数:証拠の網羅性とノイズのバランスを取る
    }],
    include=["file_search_call.results"],  # 実際に取得した内容を返し、トラブルシューティングを容易にする
)

# 出力を走査:最終テキストだけでなく、どの断片が検索されたかも確認できる
for item in response.output:
    if item.type == "file_search_call":
        for r in (item.results or []):
            print("召回:", r.filename, r.score)
    elif item.type == "message":
        print(item.content[0].text)
File Search におけるファイル削除の結果整合性
ドキュメントでは、ベクターストアからファイルを削除する処理は結果整合性であると説明されています。削除してからしばらくの間は、そのファイルが検索結果に現れる可能性があります。そのため「削除後すぐに検索できなくなる」と外部に向けて断言することはできません。ある資料を誤りや期限切れのために公開停止にする必要がある場合、執筆システム側でも独自にフィルタリングを行うのが望ましく、削除操作だけに依存しないほうがよいでしょう。
File Search が行わないこと
公式ドキュメントの記述とツール自体の仕組みから、明確にしておくべき点がいくつかあります:
- File Search はベクターストアにすでに存在するファイルだけを検索し、インターネット上の新しい告知やドキュメントの更新を自動的に発見することはありません。
- 引用マーカーは、その内容がどのファイルに由来するかを示すものであり、そのファイルに基づいて導かれた結論が正しいことを保証するものではありません。
- ベクターストアの保存とツール呼び出しはどちらも有料で、料金は OpenAI が現在公開している価格に準じます。本文では具体的な金額は示しません。
- 本文では、APIYI やその他のサードパーティプラットフォームが File Search 関連のインターフェースに対応しているかどうかを検証していません。関連するサポート状況については、各プラットフォームの公式説明をご確認ください。
OpenAI File Search の分析と判断
判断その1:File Search が補うのは「検索レイヤー」であり「資料レイヤー」ではない
執筆システムにおける資料面の弱点には、通常2つのパターンがあります。1つは、資料は手元にあるものの的確に探し出せず、モデルが印象で書いてしまい、出典を説明できないケースです。もう1つは、そもそも資料がない、あるいは資料がすでに古くなっているケースです。File Search は前者に対して非常に有効です。セマンティック検索によって必要な情報を拾い上げる柔軟性が高まり、ファイル引用によって各段落の内容を後から確認できるようになります。
後者に対しては、無力です。ツールは自ら新しいアナウンスを取りに行くことはなく、ベクトルデータベースに入っているものだけを検索できます。たとえば、あるモデルの価格や制限がちょうど変更されたばかりで、データベースには古いドキュメントしかない場合、File Search は期限切れの情報を「正確に」検索し、さらに信頼できそうに見える引用を添えてくれます。これは引用がない場合よりも危険です。なぜなら、レビューをより簡単にすり抜けてしまうからです。
したがって、File Search は執筆システムの中の一層として捉えるべきであり、資料戦略の全体と見なすべきではありません。資料の収集、定期的な更新、旧バージョンの淘汰は、依然として別のプロセスが担う必要があります。
判断その2:三分法で File Search のライティング問題を特定する
記事の書き間違いが起きたとき、問題は3つの異なる段階のいずれかに潜んでいます。include: ["file_search_call.results"] の価値は、これら3種類の問題を初めて切り分けられるようにすることにあります。
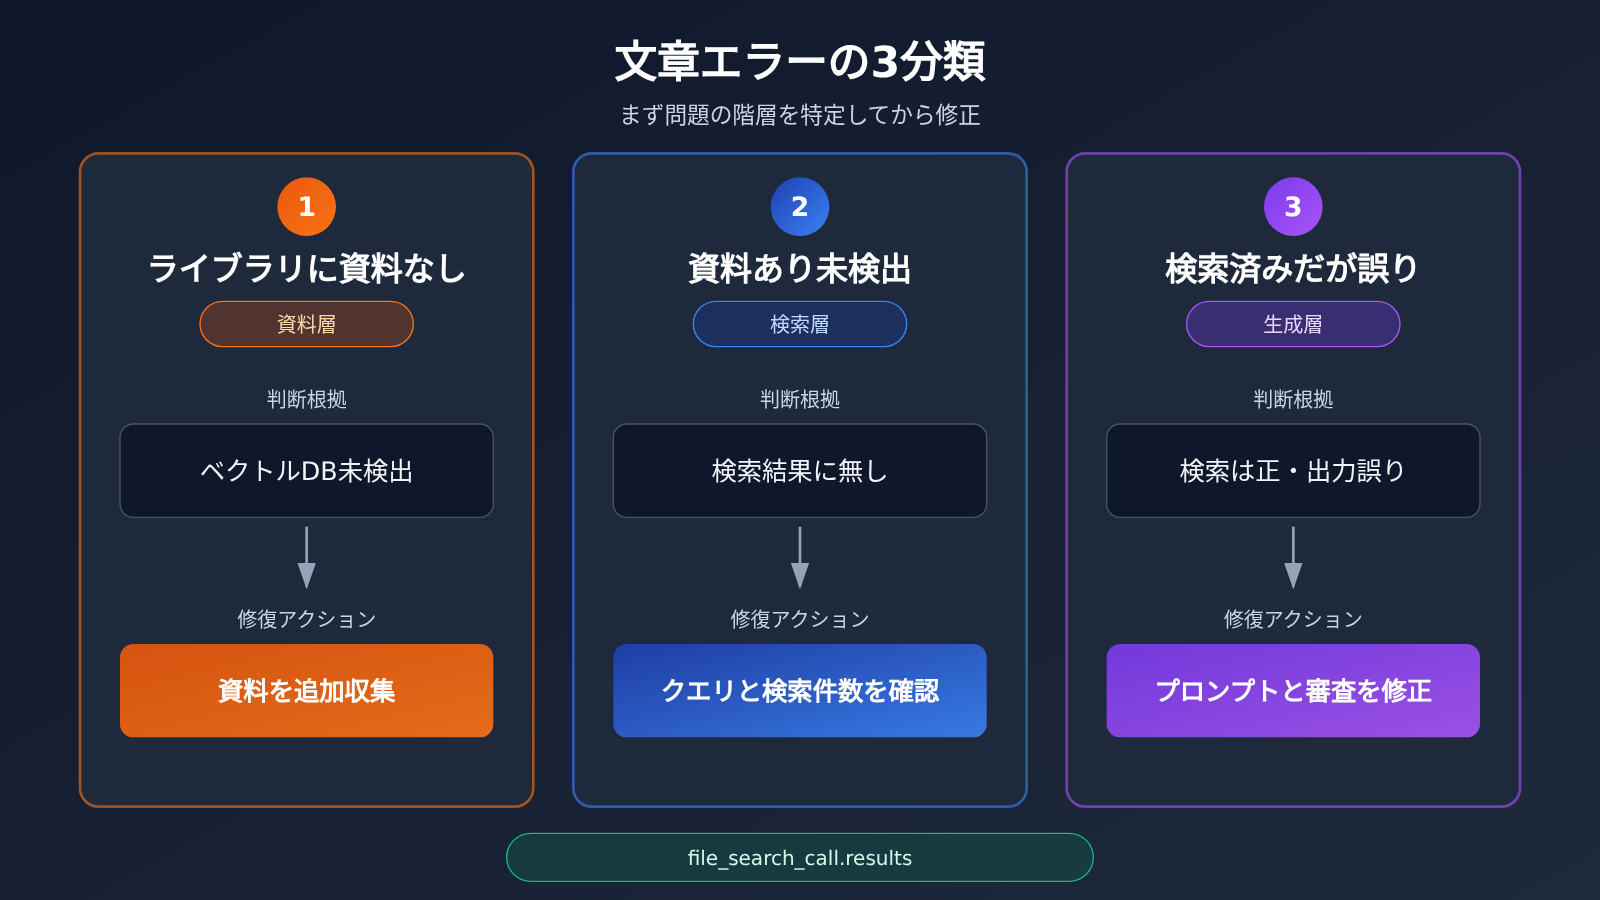
| 問題の種類 | 判断根拠 | 修正の方向性 |
|---|---|---|
| ライブラリに資料がない | ベクトルDBで関連ファイルが見つからない | 資料を追加収集する。資料レイヤーの問題 |
| 資料はあるが取得できない | ファイルはライブラリにあるが、file_search_call.results に含まれていない |
クエリの表現を調整する、質問を分割する、または max_num_results を適切に増やす |
| 取得できたが書き間違い | 取得結果は正しいのに、成稿がそれと一致しない | 生成プロンプトとレビュー規則を修正する。生成レイヤーの問題 |
取得内容が返ってこないと、チームは往々にして「またAIがでっち上げた」と大ざっぱに結論づけて、プロンプトを書き換えようとします。しかし本当の原因は、ライブラリにその資料がないことや、クエリがそれをヒットしていないことである場合が多くあります。まず問題がどのレイヤーにあるのかを判断してから手を動かすことで、無駄な回り道をかなり減らせます。
判断3:OpenAI File Search の登録メタデータが執筆品質の上限を決める
検索はストア内の内容しか返せません。そのため、ストア内の内容の品質は、登録時に何を記録したかで決まります。執筆システムでは、ファイルの本文をアップロードするだけでは不十分です。各資料には、少なくとも以下の情報を付けておくことをおすすめします。
| メタデータフィールド | 用途 |
|---|---|
| 元の URL | 元の情報源に戻って確認できるうえ、参考資料にも記載できます |
| 発行元 | 公式見解、第三者による解釈、コミュニティの噂を区別できます |
| 公開日 | 情報が現在も有効か判断できます |
| クロール日 | 資料がどのくらい更新されていないか判断できます |
| バージョン番号 | 新旧ドキュメントが共存する場合に、古い制限を現行ルールと誤認しないようにできます |
| 資料種別 | 告知、ドキュメント、ブログ、フォーラム投稿を区別し、信頼度を設定しやすくできます |
このうち、バージョン情報は最も見落とされやすい項目です。同じ API の新旧ドキュメントがどちらもストアに残っていて、意味的にもよく似ている場合、検索時に同時に取得される可能性が高いです。バージョンと日付がなければ、モデルはどの制限がすでに廃止されたのか判断するのが難しくなります。古いドキュメントを削除するより、バージョン情報を残しておくほうが安全です。履歴比較を書くときに使えるうえ、削除自体も結果整合性があるため、削除してもすぐには消えないことがあります。
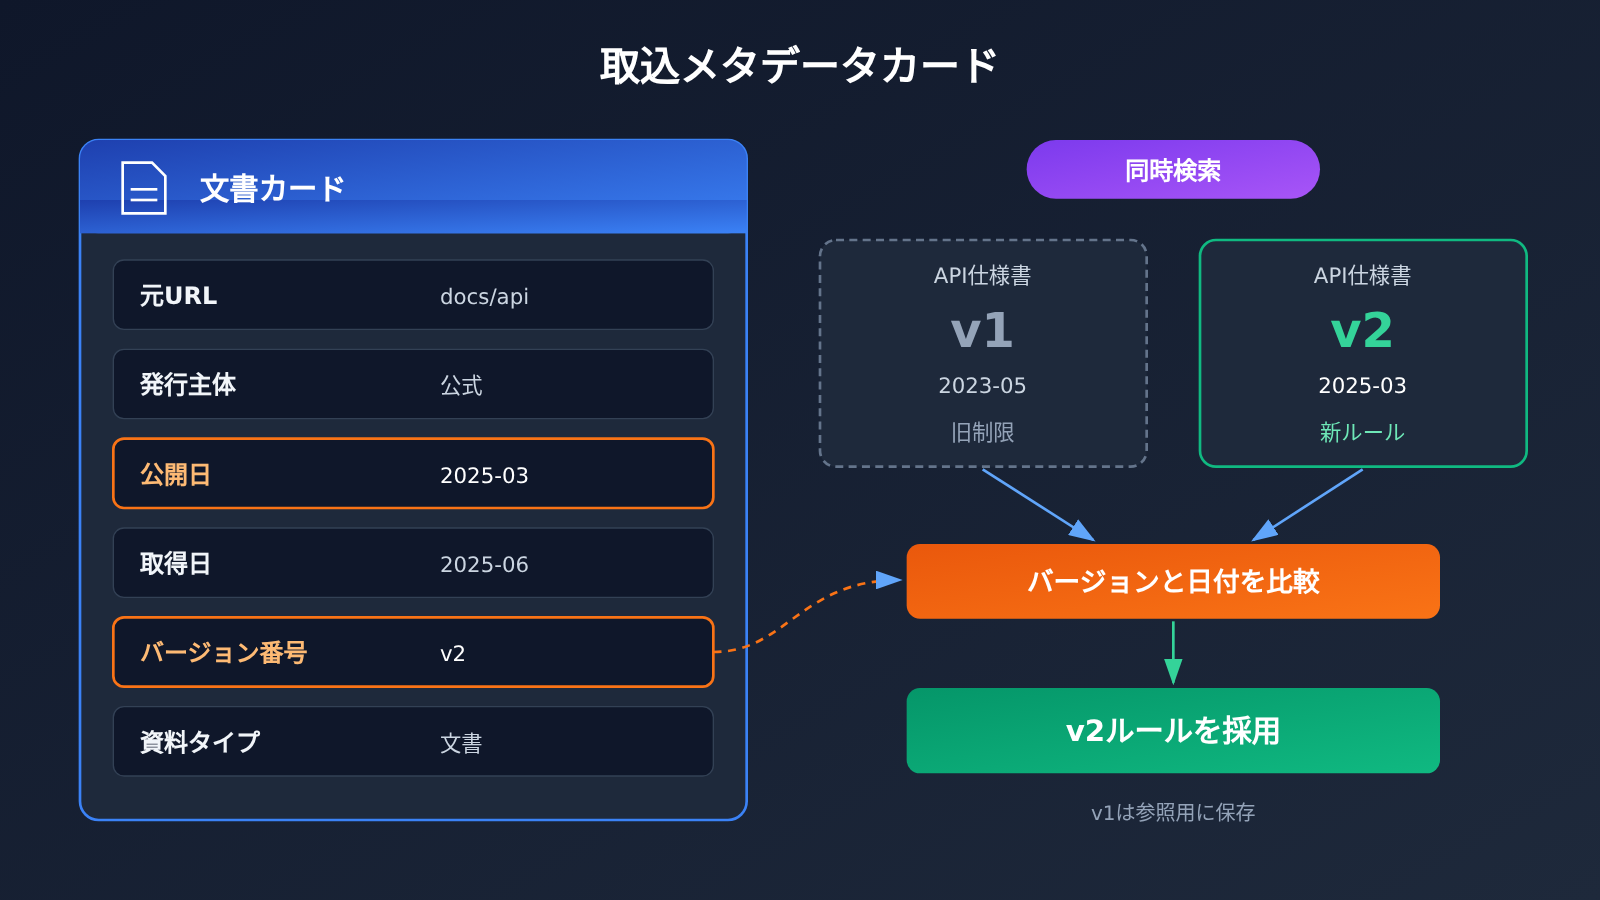
判断4:取得件数に標準的な正解はない
max_num_results を小さくするとコンテキストはよりクリーンになり、コストもノイズも下がりますが、重要な証拠を取りこぼす可能性があります。特に、価格・制限・バージョン差異が同時に絡むような、複数の資料を突き合わせて裏付けを取る必要があるテーマでは注意が必要です。逆に大きくするとカバー範囲は広がりますが、無関係な断片が注意力を薄めてしまい、モデルが異なるバージョンの情報を混同するリスクも高まります。
より実際的なのは、記事のタイプ別に設定を分けることです。ニュース解説系は複数ソースのクロス検証が必要なので、少し緩めに設定できます。単一APIのパラメータ解説であれば、厳しめに絞れます。具体的な数値に汎用的な最適解はなく、実際に返ってくる取得内容を観察したうえで調整すべきであり、感覚で固定値を決めるべきではありません。
注目すべき今後の変化
以下は注視する価値のある方向性であり、確認済みの事実ではありません。File Search がバージョンや日付で直接絞り込めるよう、より細粒度のメタデータフィルタを提供するかどうか。削除操作の反映遅延について、より明確な説明が出るかどうか。課金方式が調整されるかどうか。こうした変化はいずれも執筆システムのアーキテクチャ選択に直結するため、導入前には公式ドキュメントと価格ページをあらためて確認することをおすすめします。
File Search を執筆システムに組み込む際に最もよくある誤解は、「検索と引用があれば資料の問題は解決する」というものです。実際には、それは既存の資料をより上手く活用できるようにするだけであって、資料そのものの鮮度と正確性は、収集・バージョン管理・レビューによって担保し続ける必要があります。
「問渠那得清如許?為有源頭活水来」(なぜこの池はこれほど清いのか。源に活きた水が流れ込むからだ)――朱熹『観書有感』


