
概要:本稿では同じワークロードを使い、Prompt Caching におけるキャッシュ書き込み、キャッシュ読み取り、動的入力、出力の4部分の費用を計算し、ヒット率・TTL・呼び出しペースが実際の節約額にどう影響するかを説明します。
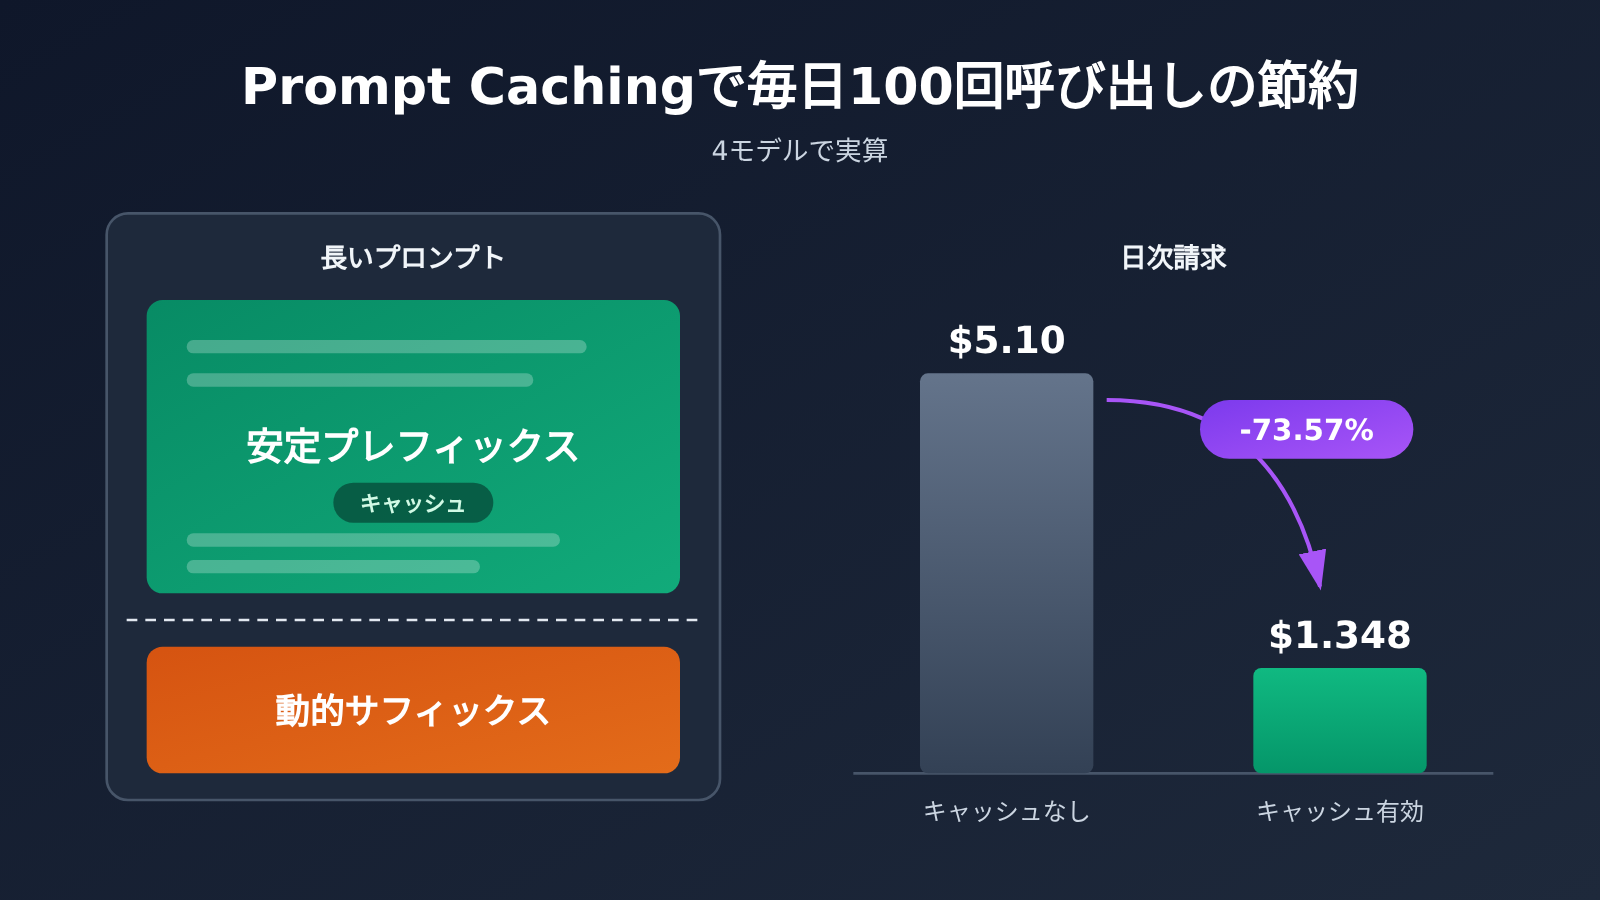
結論:本稿で設定したワークロードは、毎回固定プレフィックス20K Token、動的入力500 Token、出力1K Token、1日100回の呼び出しです。「初回書き込み、以降99回はすべてヒット」という理想条件では、GPT-6.1 Sol の1日合計請求額は$5.10から$1.348に下がり、削減率は約73.57%となります。Claude Sonnet 5.5 の結果も同じで、GPT-6 Astra は$25.50から$7.73へ下がり、削減率は約69.69%、Gemini 3.8 Flash は$1.9125から$0.576へ下がり、削減率は約69.88%です。固定プレフィックスだけに注目すると、節約率は88%から94%の範囲になります。合計請求額の削減率がより低いのは、出力Tokenと動的入力にキャッシュ割引が適用されないためです。上記の数値は公式単価に基づく予算試算であり、実際の請求額ではありません。価格はすべて標準の短コンテキスト料金を採用しており、確認日は2026-11-13です。
内容予告:第1部では、キャッシュがリクエストのどの部分を再利用するのか、そしてそれが請求額のどの部分に影響するのかを説明します。第2部では、OpenAI、Claude、Geminiの3社のキャッシュルールを比較します。第3部では4つのモデルの計算式を項目ごとに示し、読者自身で再計算できるようにします。第4部では、TTLと呼び出しペースの試算を用いて、ヒット率がなぜ下がるのかを説明します。第5部では、プロンプトの構成方法、TTLの選び方、コード例、ヒット率の監視方法を紹介します。第6部では、バッチAI生成のシナリオでTokenコストを抑えるための判断基準について考察します。
To Know:Prompt Caching 用語の予備知識
| 用語 | 説明 |
|---|---|
| Token | モデルがテキストを計量する単位。APIはToken数で課金され、単価は通常「ドル / 百万Token(MTok)」で表されます |
| Prompt Caching | すでに処理済みのプロンプト接頭辞をキャッシュし、後続のリクエストが同じ接頭辞を含む場合にそのまま再利用することで、重複処理にかかるコストを削減する仕組みです |
| 安定した接頭辞 | 複数のリクエスト間で一字一句同じプロンプトの冒頭部分。役割の説明、ライティング規範、模範例、ナレッジベースなどが該当します |
| 動的入力 | リクエストごとに変化する内容。その日のニュース素材、記事タイトル、ユーザーの要望などが該当します |
| キャッシュ書き込み | 安定した接頭辞を初めて処理してキャッシュに保存すること。単価は通常の入力より高くなるのが一般的です |
| キャッシュ読み取り | 後続のリクエストが既存のキャッシュにヒットした場合の課金で、通常の入力よりはるかに低い単価が適用されます |
| キャッシュヒット | 新しいリクエストの接頭辞が利用可能なキャッシュとToken単位で一致し、再利用に成功すること |
| TTL | キャッシュの生存時間。OpenAIはこれを最低生存時間と定義しており、正確な削除時刻までは保証していません |
| キャッシュブレークポイント | プロンプト内で「キャッシュ可能な接頭辞はここまで」という位置を示すものです |
| 暗黙的 / 明示的キャッシュ | 暗黙的キャッシュはシステムが自動的に判断して再利用します。明示的キャッシュは開発者が自らブレークポイントを宣言するか、キャッシュオブジェクトを作成します |
| タスク全体のコスト | 1回の呼び出しにおける入力・出力・該当するツール費用の合計。節約率を測るうえでの真の分母となります |
1 Prompt Caching はコスト削減につながるのか、具体的にどこが節約になる?
1.1 Prompt Caching が再利用するものとは
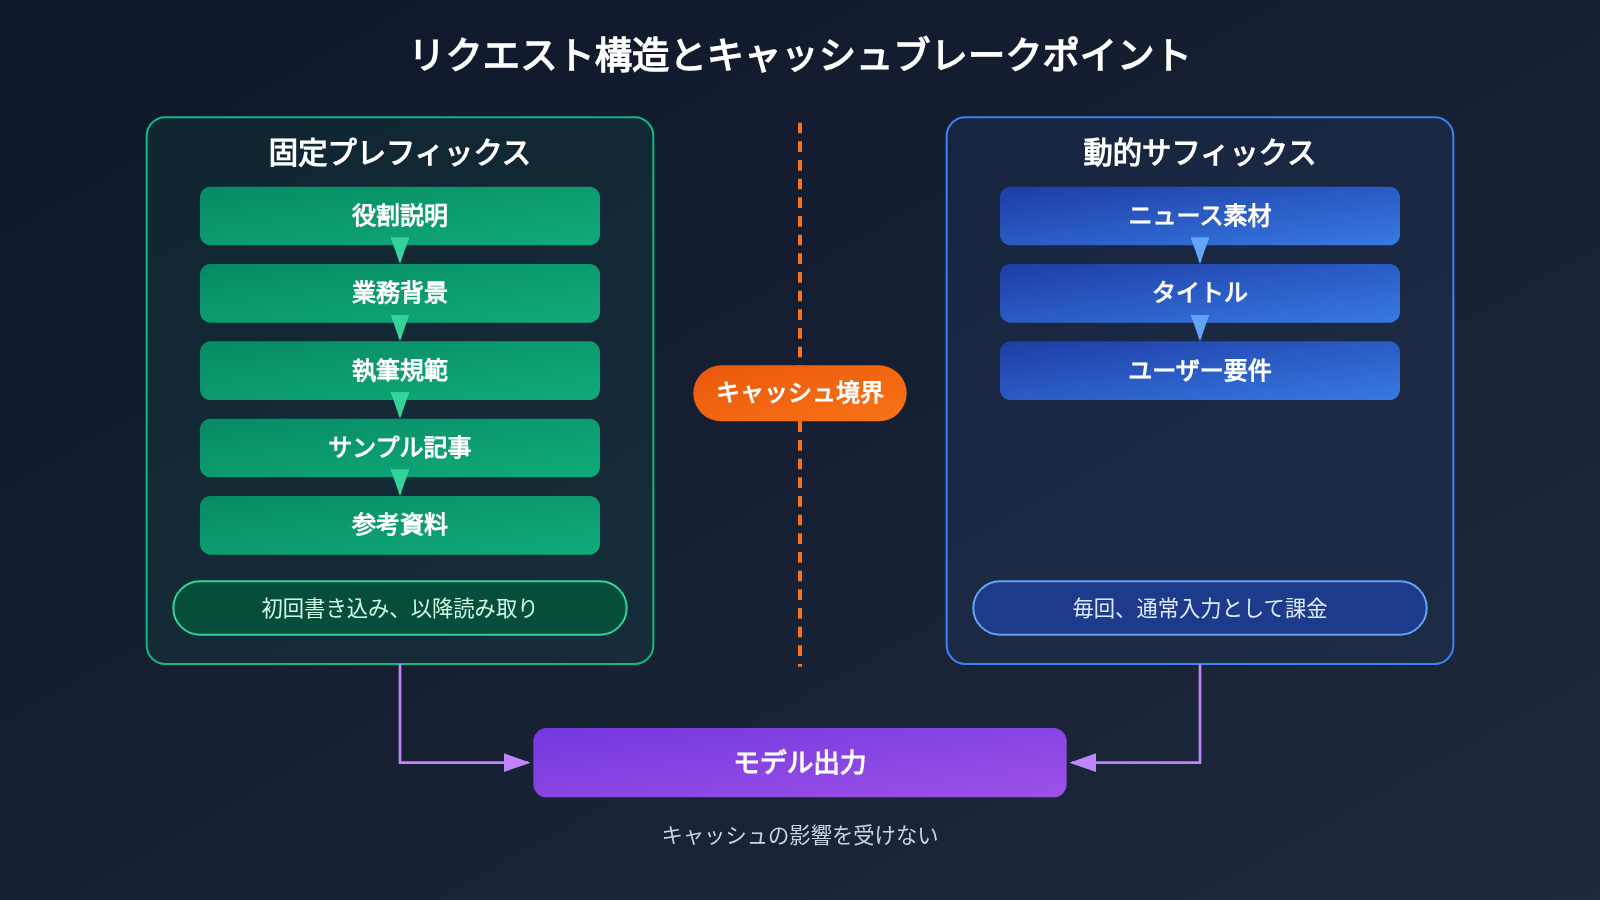
AI ライティングプラットフォームを例に考えてみましょう。記事を 1 本生成するたびに、リクエストは 2 つの部分から構成されます。1 つ目は固定内容です。役割説明、業務背景、執筆ルール、サンプル記事、用語と参考資料が含まれます。2 つ目は動的コンテンツで、その日のニュース素材、記事タイトル、ユーザーの具体的な要望です。
Prompt Caching が再利用するのは 1 つ目の部分、つまりトークン単位で同一のプレフィックスです。キャッシュのマッチングではトークンシーケンスが完全に一致している必要があり、意味が近いだけではヒットしません。表現を 1 か所変える、段落の順序を調整する、ツール定義の並びを変える、といったことだけでもプレフィックスは新しい内容になり、キャッシュは無効になります。
したがって、キャッシュ最適化には基本的な原則が 1 つあります。安定した内容を先頭に置き、変化する内容を後ろに置くことです。
1.2 Prompt Caching が節約するのはどの費用か
1 回の呼び出しの請求は 5 つの項目に分けられます。そのうち、キャッシュによって変わるのは固定プレフィックスの費用だけです。
| 費用項目 | キャッシュなし | キャッシュ有効化後 |
|---|---|---|
| 固定プレフィックス | 毎回通常入力価格で課金 | 初回は書き込み価格、ヒット後は読み取り価格 |
| 動的入力 | 通常入力価格 | 通常入力価格、変更なし |
| モデル出力 | 出力価格 | 出力価格、変更なし |
| ツール費用 | ツールのルールに従う | ツールのルールに従う、変更なし |
| 明示的キャッシュストレージ(Gemini) | なし | 保存期間に応じて別途課金 |
この表は重要な違いを 1 つ示しています。固定プレフィックスの節約率と請求全体の節約率は別の指標です。前者はキャッシュ対象部分の削減率だけを測り、後者は請求全体の削減率を測ります。出力が長くなるほど、後者の値は小さくなります。
2 GPT、Claude、Gemini の Prompt Caching ルールにはどのような違いがあるのか?
2.1 OpenAI Prompt Caching:30分と12時間
OpenAI のドキュメントでは、GPT-5.6 以降のモデルについて、キャッシュプレフィックスの最小長は通常 1,024 個の可視入力トークンであり、暗黙(implicit)と明示(explicit)の2つのモードをサポートすると規定されています。明示モードでは、開発者は適切なメッセージコンテンツブロック内で prompt_cache_breakpoint をマークし、キャッシュプレフィックスの境界を明示します。
TTL はデフォルトで30分ですが、Responses API では prompt_cache_options.ttl = "12h" を指定して最低12時間の生存時間を選択できます。課金は書き込みと読み取りに分かれます:
- 30分の書き込み:通常入力の 1.25倍
- 12時間の書き込み:通常入力の 2.5倍
- キャッシュ読み取り:ほとんどの新モデルでは通常入力の 0.1倍、GPT-6.1 Sol と GPT-6.1 Terra は 0.05倍
prompt_cache_key は、異なるユーザーやワークスペースのキャッシュ課金を区別するために使用できます。GPT-5.6 以降のモデルでは、キャッシュルーティングは公式によって自動管理されています。
2.2 Claudeのプロンプトキャッシュ:5分と1時間
Claudeはcache_controlを通じて、自動キャッシュまたは明示的キャッシュをサポートします。デフォルトの有効時間は5分で、ヒットするたびに有効期限が更新されます。5分はキャッシュの書き込みまたは読み取りリクエストの開始時点から計算され、応答の生成にかかる時間もその中に含まれます。そのため、長い出力を伴うタスクでは、実際に利用できる間隔は5分より短くなります。
課金倍率は、5分書き込みが1.25倍、1時間書き込みが2倍、通常の読み取りが0.1倍です。Claude Sonnet 5.5とClaude Opus 5.5では、読み取り料率が0.05倍に下がります。Sonnet 5.5の標準単価は、入力 $2、5分間の書き込み $2.50、1時間の書き込み $4、読み取り $0.10、出力 $10です(いずれも米ドル/100万トークン)。
2.3 Geminiコンテキストキャッシュ:暗黙的と明示的
Gemini 2.5およびそれ以降のモデルでは、暗黙的キャッシュがデフォルトで有効になり、追加の設定は不要です。最低入力要件はモデルによって異なります。Gemini 3.8 Flashは4,096トークン、Gemini 2.5 Flashと2.5 Proは2,048トークンです。Googleは、共有する内容をプロンプトの先頭に置き、短い間隔で同じプレフィックスを再利用することを推奨しています。
明示的キャッシュでは、開発者が能動的にキャッシュオブジェクトを作成し、存続時間を設定する必要があります。料金は、キャッシュ内容、その後の読み取り、保存期間の3つで構成されます。Gemini Interactions APIは現在、暗黙的キャッシュのみをサポートしています。明示的キャッシュオブジェクトが必要な場合は、generateContent APIを使用してください。
Gemini 3.8 Flashの2026年12月31日時点の価格は、入力 $0.75、出力 $3.75、キャッシュ読み取り $0.075、明示的キャッシュの保存 $0.50/100万トークン/時間です。公式には、2027年1月1日から $1.50、$7.50、$0.15、$1.00 に調整する予定です。4項目の価格は同じ割合で2倍になるため、後述する計算上の節約率は変わらず、絶対額は2倍になります。
2.4 3社のPrompt Cachingルール比較
| 項目 | OpenAI | Claude | Gemini |
|---|---|---|---|
| キャッシュ方式 | 暗黙的 / 明示的ブレークポイント | cache_control による自動 / 明示的 |
暗黙的(デフォルト) / 明示的キャッシュオブジェクト |
| デフォルトTTL | 30分(最低存続時間) | 5分、ヒット時に更新 | 暗黙的はシステムが管理;明示的は任意の期間を設定 |
| 長いTTLのオプション | 12時間(Responses API) | 1時間 | 明示的キャッシュは任意に設定可能 |
| 書き込み料率 | 30m:1.25倍;12h:2.5倍 | 5m:1.25倍;1h:2倍 | 暗黙的は初回のみ通常入力として課金 |
| 読み取り料率 | 0.1倍(Sol / Terra は0.05倍) | 0.1倍(Sonnet / Opus 5.5 は0.05倍) | 3.8 Flash:$0.075 / MTok |
| 追加コスト | ストレージ料金なし | ストレージ料金なし | 明示的キャッシュは時間単位でストレージ料金が発生 |
| 最小プレフィックス | 通常1,024トークン | 公式ドキュメントに準拠 | 3.8 Flash:4,096トークン |
3 毎日100回呼び出す場合、Prompt Cachingでいったいどれだけ節約できるのか?
3.1 共通の計算条件
以下は公式の単価に基づく理論上の試算であり、実際のユーザー請求額ではありません。共通の前提は次のとおりです。
- 毎回固定のプレフィックス 20,000 Token、動的入力 500 Token、出力 1,000 Token
- 1日あたり100回呼び出し、常に同じモデルを使用
- 動的コンテンツはすべて安定したプレフィックスの後ろに配置
- キャッシュのシナリオ:1回目に書き込み、以降の99回は完全にヒット。すべての呼び出しが TTL 内に完了するか、ヒット時に有効期限を継続的に更新する
- サードパーティによる加価、バルク割引、ツール費用は考慮しない
- 20K のプレフィックスは、GPT-6 Astra が 272K Token を超えた場合の長コンテキスト追加課金を発生させない
計算式はすべて次のとおりです。
単項費用 = Token 数 × 呼び出し回数 ÷ 1,000,000 × 単価(米ドル / MTok)
キャッシュ後のプレフィックス費用 = 20,000 × 1 ÷ 1,000,000 × 書き込み価格 + 20,000 × 99 ÷ 1,000,000 × 読み取り価格
3.2 GPT-6 Astra の完全な計算式
GPT-6 Astra の単価:通常入力 $10、出力 $50、30分の書き込み $12.50、キャッシュ読み取り $1。
キャッシュなし:
- 固定プレフィックス:20,000 × 100 ÷ 1,000,000 × $10 = $20
- 動的入力:500 × 100 ÷ 1,000,000 × $10 = $0.50
- 出力:1,000 × 100 ÷ 1,000,000 × $50 = $5
- 1日の合計:$25.50
30分キャッシュ:
- 初回書き込み:20,000 ÷ 1,000,000 × $12.50 = $0.25
- 99回の読み取り:20,000 × 99 ÷ 1,000,000 × $1 = $1.98
- 動的入力:$0.50;出力:$5
- 1日の合計:$7.73
請求額全体では $17.77 の節約、約 69.69% になります。固定プレフィックスは $20 から $2.23 に下がり、約 88.85% の節約です。
3.3 GPT-6.1 Sol、Claude Sonnet 5.5、Gemini 3.8 Flash
GPT-6.1 Sol(入力 $2、出力 $10、30分キャッシュの書き込み $2.50、読み取り $0.10):
- キャッシュなし:プレフィックス $4 + 動的入力 $0.10 + 出力 $1 = $5.10
- キャッシュ後:書き込み $0.05 + 読み取り $0.198 + 動的入力 $0.10 + 出力 $1 = $1.348
- $3.752 の節約、約 73.57%;プレフィックスは $4 から $0.248 に下がり、約 93.8% の節約
Claude Sonnet 5.5(5分間キャッシュ)の単価は GPT-6.1 Sol と同じで、計算過程と結果も同じです:$5.10 から $1.348 に下がります。ただし、呼び出し間隔が継続して5分間の有効期間を維持できることが前提です。
Gemini 3.8 Flash(暗黙的キャッシュ、初回は通常入力として $0.75 で計算):
- キャッシュなし:プレフィックス $1.50 + 動的入力 $0.0375 + 出力 $0.375 = $1.9125
- キャッシュ後:初回プレフィックス $0.015 + 99回の読み取り $0.1485 + 動的入力 $0.0375 + 出力 $0.375 = $0.576
- $1.3365 の節約、約 69.88%;プレフィックスは $1.50 から $0.1635 に下がり、約 89.1% の節約
- この結果は暗黙的キャッシュがすべてヒットすることを仮定しており、明示的キャッシュのストレージ費用は含みません
3.4 Prompt Caching における節約率と絶対金額の違い
| モデル | キャッシュなし / 日 | キャッシュ後 / 日 | 1日あたりの節約額 | 30日間の節約額(外挿) | プレフィックス節約率 | 請求全体の節約率 |
|---|---|---|---|---|---|---|
| GPT-6 Astra | $25.50 | $7.73 | $17.77 | $533.10 | 88.85% | 69.69% |
| GPT-6.1 Sol | $5.10 | $1.348 | $3.752 | $112.56 | 93.8% | 73.57% |
| Claude Sonnet 5.5 | $5.10 | $1.348 | $3.752 | $112.56 | 93.8% | 73.57% |
| Gemini 3.8 Flash | $1.9125 | $0.576 | $1.3365 | $40.10 | 89.1% | 69.88% |
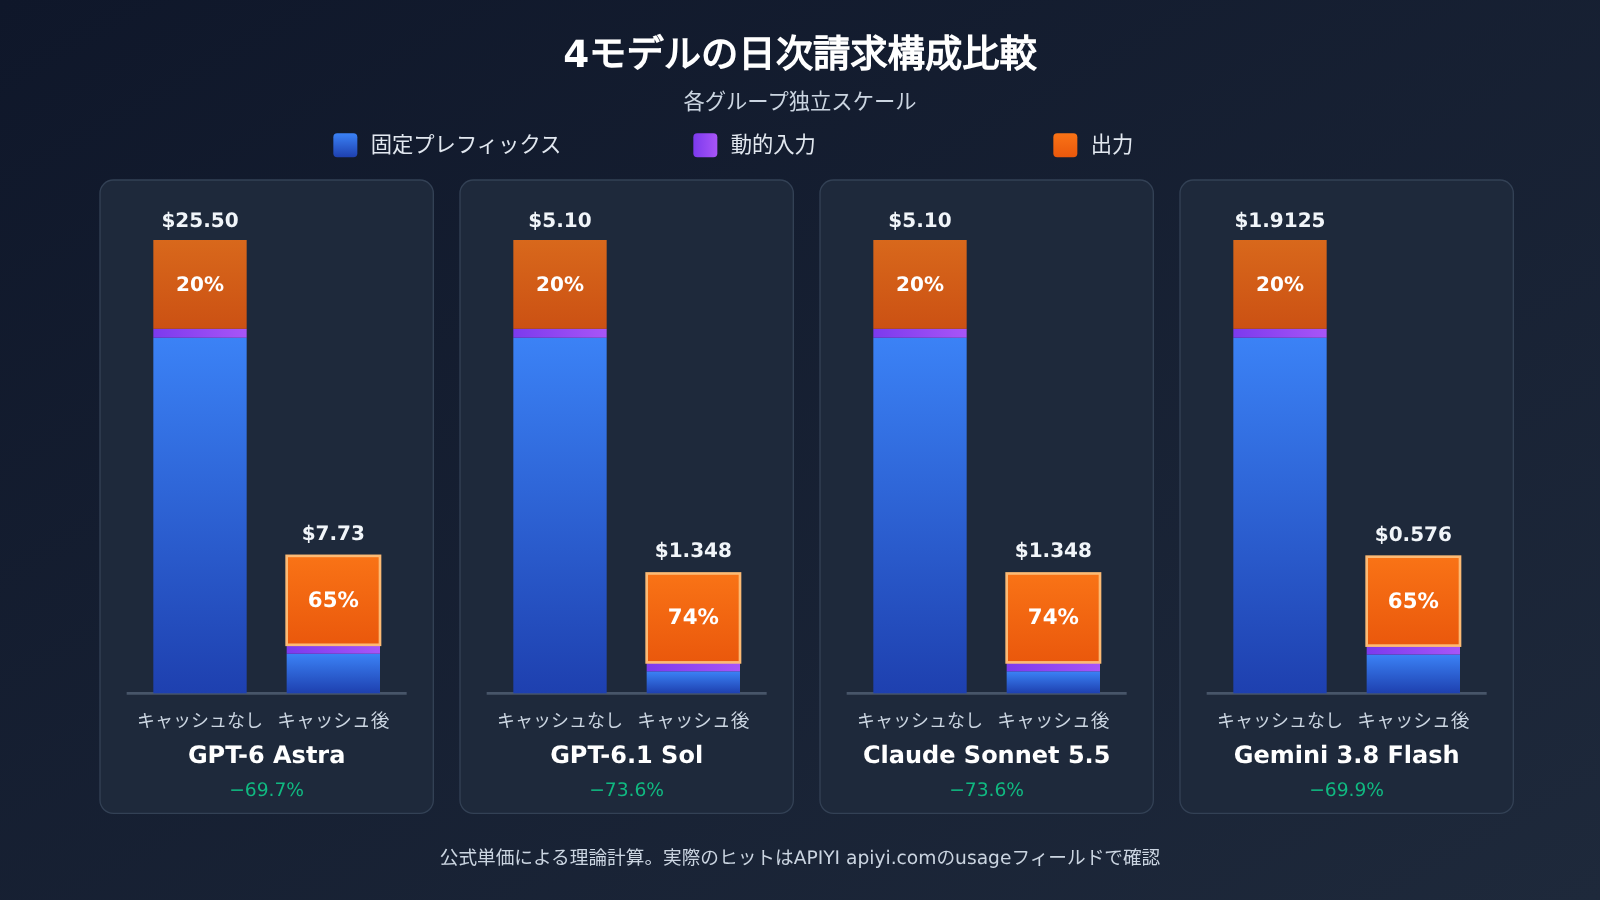
この表からは次の2点が読み取れます。
- 比率は読み取り割引で決まる。GPT-6.1 Sol と Claude Sonnet 5.5 の読み取り価格は通常入力の0.05倍で、プレフィックス節約率は93.8%に達し、読み取り0.1倍のAstraとGeminiを上回ります。
- 金額は単価の水準で決まる。Astraの節約率は最も低いものの、1日あたり$17.77を節約でき、これはGemini 3.8 Flashの13倍以上です。単価が高いモデルほど、キャッシュを有効にしたときの絶対的なメリットは大きくなります。
キャッシュ後、GPT-6 Astraの請求額に占める出力の割合は約20%から約65%($5 ÷ $7.73)に上昇します。この場合、さらなるコスト削減の重点は出力長の制御に移ります。なお、4モデルで同じトークン数を使用しているのは、あくまで比較を容易にするためです。同じタスクを完了する場合でも、各モデルの実際の出力長や正答率は同じではありません。
💡 モデル選定のアドバイス:節約率が近い場合は、1日あたりの絶対節約額とタスク品質のバランスを優先して確認しましょう。まず APIYI apiyi.com で同じテンプレートを使って複数の候補モデルをそれぞれ呼び出し、実際の出力長とキャッシュされたトークンを記録してから、上記の計算式に当てはめて月間予算を見積もることをおすすめします。
4 毎日同じプロンプトを繰り返しているのに、Prompt Caching の請求が依然として高くなるのはなぜか?
4.1 TTL と呼び出し頻度がヒット率を決める
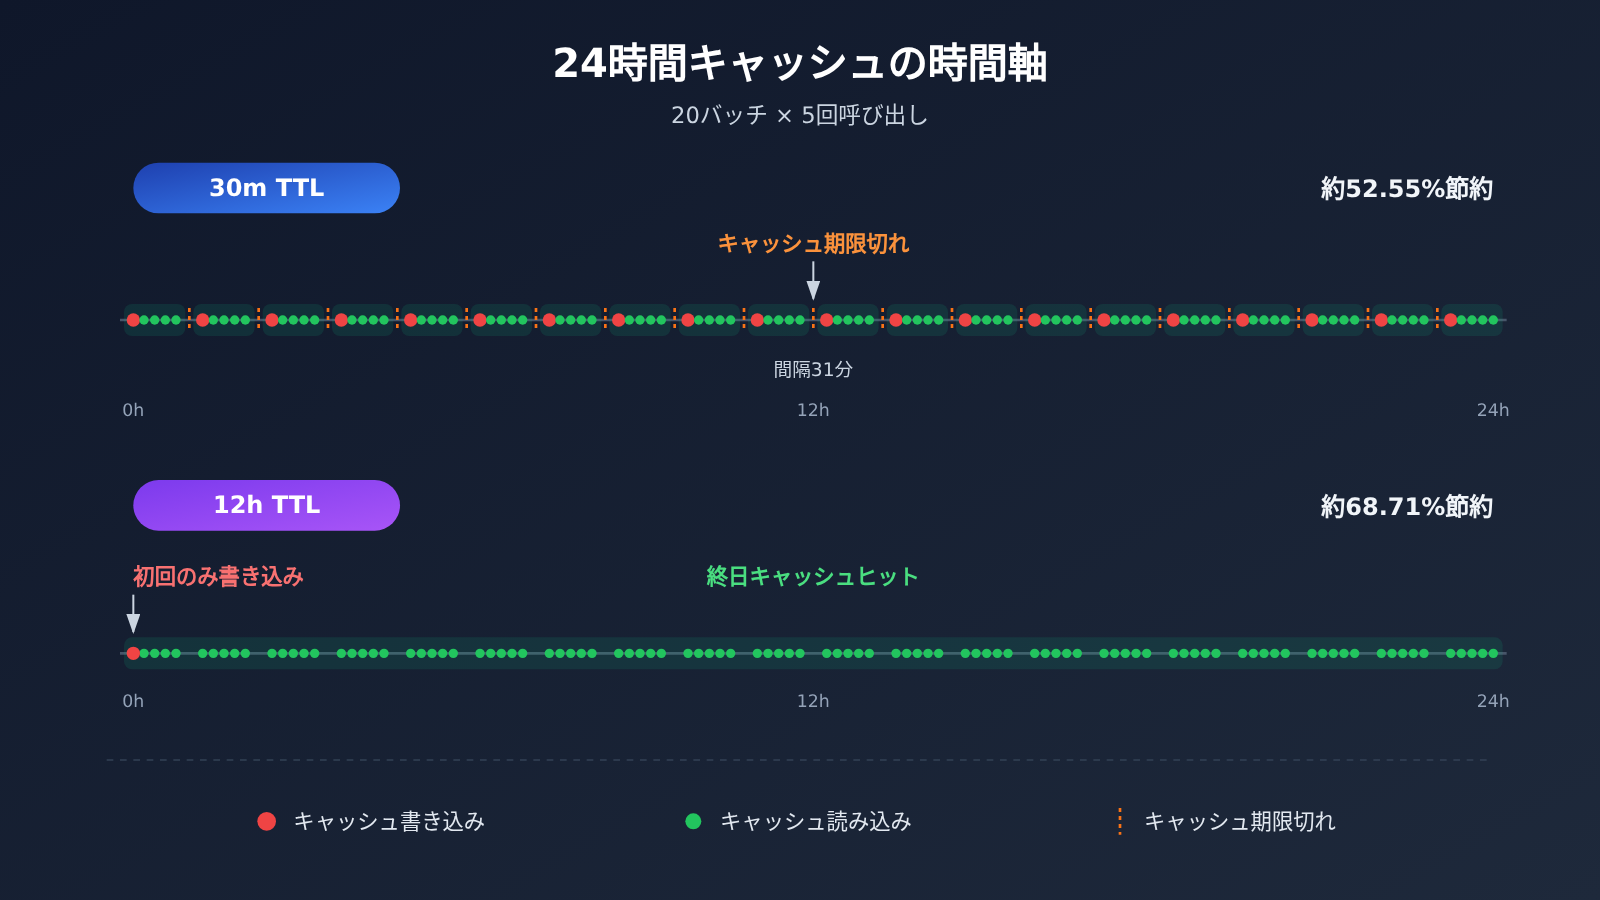
1日に100回呼び出しても、1回の書き込みで丸一日をカバーできるわけではありません。以下では GPT-6 Astra を例に説明します。1日を20バッチに分け、各バッチで5回連続して呼び出し、バッチ間の間隔は31分です。
| シナリオ | 書き込み回数と費用 | 読み取り回数と費用 | プレフィックス費用 | 動的入力と出力を加算 | 1日の合計 | 節約率 |
|---|---|---|---|---|---|---|
| キャッシュなし | — | — | $20 | $5.50 | $25.50 | — |
| A:30分キャッシュ | 20 × $0.25 = $5 | 80 × $0.02 = $1.60 | $6.60 | $5.50 | $12.10 | 約 52.55% |
| B:12時間キャッシュ(同一ウィンドウ内) | 1 × $0.50 | 99 × $0.02 = $1.98 | $2.48 | $5.50 | $7.98 | 約 68.71% |
シナリオAでは、バッチ間隔が30分を超えるため、バッチごとに再書き込みが必要になり、節約率は理想値の69.69%から52.55%に下がります。シナリオBの1回あたりの書き込み価格は30分の場合の2倍ですが、丸一日で1回しか書き込まないため、分散した呼び出しにはより経済的です。12時間の方式は同一ウィンドウのみをカバーし、翌日に同じキャッシュを再利用できる保証はありません。1日に1〜2回しか呼び出さないタスクでは、同じプロンプトだけでは日をまたいだキャッシュを実現できません。
各種 TTL の損益分岐点は、安定したプレフィックスのみに着目し、通常入力を1倍として計算できます:
| 方式 | 書き込み倍率 | 読み取り倍率 | 書き込み1回+読み取り1回 vs キャッシュなし2回 | 書き込み1回+読み取り2回 vs キャッシュなし3回 | 元を取るのに必要な有効読み取り回数 |
|---|---|---|---|---|---|
| OpenAI 30m | 1.25 | 0.1 | 1.35 < 2 | — | 1回 |
| OpenAI 12h | 2.5 | 0.1 | 2.6 > 2 | 2.7 < 3 | 2回 |
| Claude Sonnet 5.5 · 5m | 1.25 | 0.05 | 1.30 < 2 | — | 1回 |
| Claude Sonnet 5.5 · 1h | 2 | 0.05 | 2.05 > 2 | 2.10 < 3 | 2回 |
結論は明快です。短い TTL は1回ヒットすれば元が取れ、長い TTL は有効期間内に少なくとも2回ヒットする必要があります。
4.2 キャッシュブレークポイントとプロンプトの順序
最もよくある失敗の原因は、安定したプレフィックスが変更されてしまうことです。タイムスタンプ、ユーザーID、タスクのタイトル、リアルタイムの素材などをプロンプトの先頭に置くと、リクエストのたびにプレフィックスが新しい内容になってしまい、キャッシュは永久にヒットしません。
OpenAI の暗黙モードでは、最初のリクエストで動的な内容までキャッシュ範囲に含めてしまうと、その後の動的な内容が変わったときに、期待していた安定プレフィックスにヒットしない可能性があります。解決策は、安定した内容が終わる位置に明示的なキャッシュブレークポイントを設定することです。
そのほかによくある原因としては、次のようなものがあります。
- モデル、プロバイダー、サービス組織を切り替えた。あるいは一部のパラメータを変更した
- Agent が会話の圧縮、ツール定義の並べ替え、履歴メッセージの変更などを行い、再利用可能なプレフィックスが書き換えられた
- サードパーティのゲートウェイがキャッシュパラメータを転送していない。またはキャッシュ割引を請求に反映していない
4.3 出力トークンとツール費用の影響
キャッシュは入力プレフィックスにのみ作用します。3.2 の Astra の計算例では、プレフィックス費用がゼロに下がっても、請求額は $5.50(動的入力+出力)を下回りません。出力が長く、ツール呼び出しの多いタスクでは、全体の請求額の削減率はプレフィックスの節約率を大きく下回ります。そのため、キャッシュを有効にした後も、出力長の制御やツール呼び出しの簡素化をあわせて行う必要があります。
5 AIアプリケーションでPrompt Cachingを設定・監視する方法
5.1 安定したプレフィックスと動的サフィックスの構成方法
「変化の頻度が低いものから高いものへ」の順に内容を配置します:
- ツール定義:固定された順序と固定された説明を維持し、リクエストごとに動的に増減しない
- システムルールとライティング規約:役割の説明、ブランド規約、文体の要件
- 模範文とナレッジベース:大量の参考ドキュメント。バージョン更新時には全体を置き換える
- (キャッシュブレークポイント)
- 動的素材:当日のニュース、検索結果、ユーザー入力
- 現在のタスク指示:タイトル、文字数、具体的な要件
以下の例では、OpenAI互換インターフェース経由で呼び出しを行い、レスポンスに含まれるキャッシュトークンを読み取ります:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI互換インターフェース
)

STABLE_PREFIX = """你是一名技术博客作者……(写作规范、范文、术语表,约 20K Token,内容逐字固定)"""

resp = client.chat.completions.create(
    model="gpt-6.1-sol",  # プラットフォームのモデルリストにある実際の名称を基準にしてください
    messages=[
        {"role": "system", "content": STABLE_PREFIX},          # 安定したプレフィックスを先頭に配置
        {"role": "user", "content": "今日材料:……\n标题:……"},  # 動的コンテンツを後方に配置
    ],
)
details = getattr(resp.usage, "prompt_tokens_details", None)
cached = getattr(details, "cached_tokens", 0) or 0
print(f"输入 {resp.usage.prompt_tokens},命中缓存 {cached}")
完全なコードを表示:コスト計算機 + ヒット率統計
from openai import OpenAI

M = 1_000_000

def daily_cost(prefix, dynamic, output, calls,
               p_in, p_out, p_write, p_read,
               writes=1, use_cache=True):
    """公式の単価で日額コスト(米ドル)を試算し、(プレフィックス, 動的入力, 出力, 合計) を返す"""
    dyn = dynamic * calls / M * p_in
    out = output * calls / M * p_out
    if use_cache:
        pre = prefix * writes / M * p_write + prefix * (calls - writes) / M * p_read
    else:
        pre = prefix * calls / M * p_in
    return round(pre, 4), round(dyn, 4), round(out, 4), round(pre + dyn + out, 4)

MODELS = {
    # 名称: (入力, 出力, 書き込み, 読み取り)  米ドル / 100万 Token、確認日 2026-11-13
    "GPT-6 Astra (30m)":   (10,   50,   12.5, 1),
    "GPT-6.1 Sol (30m)":   (2,    10,   2.5,  0.10),
    "Claude Sonnet 5.5":   (2,    10,   2.5,  0.10),
    "Gemini 3.8 Flash":    (0.75, 3.75, 0.75, 0.075),  # 暗黙的キャッシュの初回は通常入力として計算
}

for name, (p_in, p_out, p_w, p_r) in MODELS.items():
    base = daily_cost(20000, 500, 1000, 100, p_in, p_out, p_w, p_r, use_cache=False)[-1]
    cached = daily_cost(20000, 500, 1000, 100, p_in, p_out, p_w, p_r)[-1]
    print(f"{name}: ${base} -> ${cached},节省 {(base - cached) / base:.2%}")

# シナリオ A: Astra 30m、20 バッチそれぞれで再書き込みが必要
a = daily_cost(20000, 500, 1000, 100, 10, 50, 12.5, 1, writes=20)[-1]
print(f"Astra 分批 30m: ${a}")  # 12.1

# ---- 本番環境のヒット率統計 ----
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

def run_and_track(stable_prefix, dynamic_inputs, model="gpt-6.1-sol"):
    total_in = total_cached = 0
    for text in dynamic_inputs:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "system", "content": stable_prefix},
                      {"role": "user", "content": text}],
        )
        d = getattr(r.usage, "prompt_tokens_details", None)
        total_in += r.usage.prompt_tokens
        total_cached += (getattr(d, "cached_tokens", 0) or 0)
    hit = total_cached / total_in if total_in else 0
    print(f"实际缓存命中率:{hit:.2%}")
    return hit
🚀 クイックスタートのヒント:まず上記の計算ツールで予算を見積もり、次に実際のテンプレートで 10~20 回の呼び出しを実行し、
cached_tokensが 2 回目以降から安定して出てくるかを確認しましょう。新規ユーザーは APIYI apiyi.com で無料テスト枠を受け取り、この検証ステップを完了できます。ヒットが確認できた後にトラフィックを拡大してください。
5.2 Prompt Caching の TTL とキャッシュモードを選ぶ
- 高頻度の連続呼び出し(間隔が数分以内で安定している場合):デフォルトの短い TTL を使います。OpenAI は 30 分、Claude は 5 分です。1 回ヒットすればコストを回収でき、書き込み時の割増も最も低くなります。Claude では、応答生成にかかる時間も 5 分間のウィンドウに含める必要があります。
- 1 日を通して分散した呼び出し(バッチ間隔が 30 分を超える場合):OpenAI の 12 時間、または Claude の 1 時間を検討します。ウィンドウ内で 2 回以上ヒットできれば、長い TTL の方が繰り返し書き込むより安くなります。4.1 のシナリオ B がその好例です。
- プレフィックスが非常に長く、長い時間帯にわたって再利用する Gemini タスク:明示的キャッシュを検討し、ストレージ料金も含めて計算します。Gemini 3.8 Flash の場合、20K Token を 12 時間保存するストレージ料金は 0.02 × $0.50 × 12 = $0.12 です。本記事のワークロードでは、この費用は $0.576 の日次請求に対してかなり目立つ金額になります。暗黙的キャッシュのヒット率が良好なら、デフォルトのままにします。
- プレフィックスが頻繁に変わる場合:まずプレフィックスを固定し、その後で TTL を検討します。プレフィックスが不安定なときは、どんな TTL でもヒットは得られません。
5.3 Prompt Caching の実際のヒット率と請求を確認する
3 社の usage フィールドはそれぞれ次のとおりです。
- OpenAI(Responses API):
usage.input_tokens、usage.input_tokens_details.cached_tokens、usage.input_tokens_details.cache_write_tokens - Claude:
usage.input_tokens、usage.cache_creation_input_tokens、usage.cache_read_input_tokens - Gemini:対応する API の usage フィールド。たとえば
total_cached_tokensです。明示的キャッシュでは、オブジェクトストレージ料金が別途発生します。
次の 2 つの指標を継続的に追跡することをおすすめします。
実際のキャッシュヒット率 = キャッシュ読み取り Token ÷ 総入力 Token
実際の節約額         = 未キャッシュ基準コスト − 実際の API 請求コスト
未キャッシュ基準コストは、同じモデル、同じワークロード、同じ出力規模で計算する必要があります。そうでなければ、節約額に比較可能性はありません。APIYI apiyi.com のコンソールで請求を確認する際は、同じ期間の usage 集計と課金明細を項目ごとに突き合わせ、キャッシュ Token がキャッシュ価格で課金されていることを確認できます。
6 APIYI のシナリオ:固定テンプレートとバッチ AI 生産で Prompt Caching を使ってコストをどう抑えるか?
Prompt Caching に適した典型的な業務としては、毎日同じ記事テンプレートを実行する AI ライティングプラットフォーム、同じツール定義を繰り返し読み込む Agent、同じ大型参照ドキュメントを何度も引用する資料分析システム、そしてブランド規範と文体説明を共有するバッチコンテンツ生成などが挙げられます。こうしたタスクには共通点があります。それは、プレフィックスが長く、重複率が高く、呼び出し量が多いということで、まさにキャッシュ効果が最も大きくなる領域に当てはまります。
こうしたシナリオでコスト判断を行う際は、次の 3 つの基準で評価できます。
- モデルが必要なキャッシュ機能をサポートしているか。最低プレフィックス長、選択可能な TTL、読み取り割引倍率などが含まれます。読み取り 0.05 倍のモデルは、長いプレフィックスのタスクでプレフィックス節約率がより高くなります。
- プロンプトと TTL がワークロードに合っているか。連続バッチ処理には短い TTL を使います。スケジュールに従って分散実行するタスクでは長い TTL を検討し、4.1 節の式で回収回数を計算します。
- API プロバイダーがキャッシュを完全にサポートし、実際のキャッシュ費用で課金しているか。上流がキャッシュをサポートしていることは、コスト削減の必要条件の一つにすぎません。ゲートウェイはキャッシュパラメータを正しく伝達し、usage の中でキャッシュ Token を報告し、キャッシュ価格を課金に反映する必要があります。
APIYI apiyi.com 経由で呼び出す場合は、3 番目の項目を固定的な受け入れ手順として実践することをおすすめします。同じ 20K テンプレートで何度か連続して呼び出し、usage のキャッシュフィールドを確認したうえで、請求の課金額と照合します。技術的なヒットと課金の反映の両方を確認できたら、上記の試算結果を月次予算の根拠として活用しましょう。
よくある質問 FAQ
Q1:プロンプトキャッシュとは何ですか?
プロンプト内で既に処理済みの同一プレフィックスをキャッシュし、後続のリクエストがヒットした際には通常の入力よりもはるかに低い価格で課金されます。マッチングにはトークンの完全一致が要求されるため、固定テンプレート、固定ナレッジベース、固定ツール定義といったシーンに適しています。
Q2:なぜプレフィックスは90%以上節約できるのに、請求書全体では70%程度しか節約できないのですか?
キャッシュは固定プレフィックスにのみ作用し、動的入力と出力は依然として通常価格で課金されます。GPT-6.1 Solを例にすると、キャッシュ後の日次請求額$1.348のうち、出力が$1、動的入力が$0.10を占めています。出力が長くなるほど、請求書全体の節約率は低くなります。
Q3:1日に1〜2回しか呼び出さない場合、キャッシュを有効にすべきですか?
メリットは非常に小さいです。OpenAIの12時間とClaudeの1時間は、有効期間内に少なくとも2回ヒットしないと元が取れず、日をまたいだ再利用は保証されません。より効果的な方法は、同種のタスクを同じ時間帯に集中してバッチ実行し、ウィンドウ内のヒット回数を増やすことです。
Q4:30分と12時間のどちらを選ぶべきですか?
呼び出し間隔によります。間隔が安定して30分以内であれば30分を選択し、1回ヒットすれば元が取れます。バッチ間隔が長く、1日中分散している場合は12時間を選択します。GPT-6 Astraを20バッチに分けて呼び出す例では、12時間の日次費用は$7.98、30分は$12.10です。
Q5:API集約プラットフォーム経由で呼び出す場合、キャッシュはまだ有効ですか?
これはプラットフォームによるキャッシュパラメータの伝達と課金実装に依存します。APIYI apiyi.comで無料テスト枠を使って同一テンプレートを連続呼び出しし、usage内の`cached_tokens`などのフィールドを確認し、請求明細と照合することをお勧めします。キャッシュがヒットし、かつキャッシュ価格で課金されていることを確認してからバッチ利用してください。
Q6:キャッシュヒット率が突然低下した場合、まずどこを確認すべきですか?
以下の順に確認してください:プレフィックスにタイムスタンプやIDなどの動的コンテンツが混入していないか。ツール定義の順序が変わっていないか。エージェントが履歴メッセージを圧縮または書き換えていないか。モデルやパラメータが切り替わっていないか。呼び出し間隔がTTLを超えていないか。5.3節のヒット率公式で時間単位の統計を取ると、変化が発生した時点を比較的早く特定できます。
Q7:Geminiの暗黙的キャッシュと明示的キャッシュはどう選ぶべきですか?
暗黙的キャッシュはデフォルトで有効になっており、ストレージ料金はかからず、プレフィックスがモデルの最低長(3.8 Flashは4,096トークン)を超える場合に優先的に使用されます。明示的キャッシュは確実な再利用が必要な超長コンテンツに適していますが、時間単位のストレージ料金を支払う必要があり、generateContent APIを使用する必要があります。Interactions APIは現在、暗黙的キャッシュのみをサポートしています。
まとめ
Prompt Caching の核心ポイント:
- どこを削減できるか:固定プレフィックスのコストだけを抑えられます。本記事のワークロードでは、プレフィックスの節約率は 88.85%~93.8%、全体請求の節約率は 69.69%~73.57% です。
- どれだけ節約できるか:GPT-6.1 Sol と Claude Sonnet 5.5 は 1 日あたり $5.10 から $1.348 に、GPT-6 Astra は $25.50 から $7.73 に下がります。単価が高いほど、絶対的な節約額も大きくなります。
- どのくらいの頻度が最もお得か:高頻度・連続・長いプレフィックスの呼び出しです。短い TTL は 1 回ヒットで元が取れ、長い TTL は 2 回ヒットが必要です。
- どう実装するか:安定した内容を先に、動的な内容を後に配置し、安定した内容の末尾にブレークポイントを設定します。呼び出しのリズムに応じて TTL を選び、usage フィールドで継続的にヒット率を監視します。
- 成立する前提:キャッシュは技術的にヒットするだけでなく、課金上でもキャッシュ価格で請求される必要があります。
まず本文中の計算ツールで予算を算出し、その後 APIYI apiyi.com で実際のテンプレートを使ってヒット率と課金を検証し、両方が確認できた段階でスケールアップすることをおすすめします。
📚 参考資料
- OpenAI Prompt Caching ガイド:キャッシュモード、ブレークポイント、TTL、課金倍率
- リンク:
developers.openai.com/api/docs/guides/prompt-caching -
説明:
prompt_cache_options、prompt_cache_breakpointパラメータの説明 -
OpenAI モデルと料金:GPT-6 Astra、GPT-6.1 Sol の単価
- リンク:
developers.openai.com/api/docs/pricing - リンク:
developers.openai.com/api/docs/models/gpt-6-astra - リンク:
developers.openai.com/api/docs/models/gpt-6.1-sol -
説明:標準の短いコンテキスト向け料金、確認日 2026-11-13
-
Claude Prompt Caching ドキュメント:
cache_control、5m / 1h の書き込み・読み取り倍率 - リンク:
platform.claude.com/docs/en/build-with-claude/prompt-caching - リンク:
platform.claude.com/docs/en/models/sonnet-5-5/overview -
説明:Sonnet 5.5 のキャッシュ読み取りは 0.05 倍の料金
-
Gemini Context Caching と料金:暗黙的 / 明示的キャッシュ、ストレージ料金と 2027 年の価格改定
- リンク:
ai.google.dev/gemini-api/docs/caching - リンク:
ai.google.dev/gemini-api/docs/pricing - 説明:各モデルの最低キャッシュ長と API サポート範囲
著者:APIYI 技術チーム
技術交流:APIYI 公式サイトのトップページからお問い合わせください。その他の導入資料は docs.apiyi.com ドキュメントセンターでご覧いただけます。


