
Résumé : cet article utilise une même charge de travail pour calculer les coûts de Prompt Caching dans ses quatre composantes — écriture de cache, lecture de cache, entrée dynamique et sortie — et montre comment le taux de réussite, le TTL et le rythme des appels influencent les économies réelles.
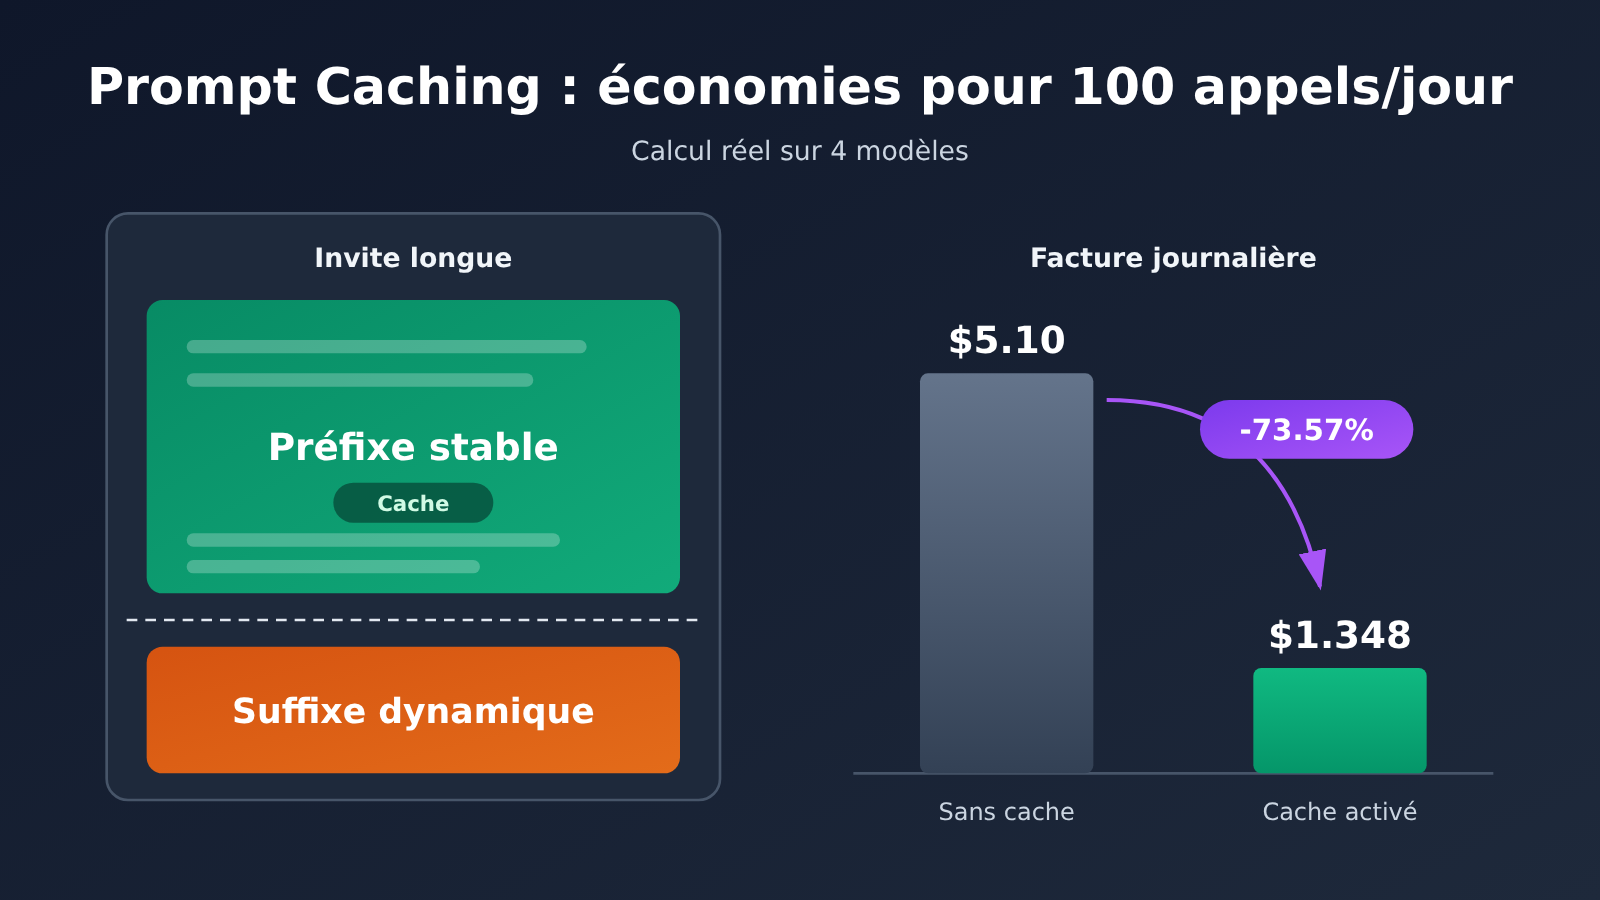
Conclusion : la charge de travail définie ici est un préfixe fixe de 20K tokens par appel, une entrée dynamique de 500 tokens et une sortie de 1K token, avec 100 appels par jour. Dans des conditions idéales — « première écriture, puis 99 appels suivants tous en cache » — la facture journalière complète de GPT-6.1 Sol passe de 5,10 $ à 1,348 $, soit une baisse d’environ 73,57 %. Claude Sonnet 5.5 obtient le même résultat, GPT-6 Astra passe de 25,50 $ à 7,73 $, soit une baisse d’environ 69,69 %, et Gemini 3.8 Flash de 1,9125 $ à 0,576 $, soit une baisse d’environ 69,88 %. Si l’on ne considère que la ligne du préfixe fixe, l’économie se situe entre 88 % et 94 %. La baisse sur la facture complète est moins forte, car les tokens de sortie et l’entrée dynamique ne bénéficient pas de la remise de cache. Ces chiffres sont des projections budgétaires calculées à partir des tarifs unitaires officiels, pas des factures réelles. Les prix utilisés sont uniformément les tarifs standards pour contexte court, vérifiés à la date du 13 novembre 2026.
Aperçu du contenu : la partie 1 explique quel segment de la requête le cache réutilise et sur quelle partie de la facture il agit. La partie 2 compare les règles de cache d’OpenAI, de Claude et de Gemini. La partie 3 détaille les formules de calcul des quatre modèles, pour que les lecteurs puissent refaire les calculs eux-mêmes. La partie 4 montre, à l’aide de calculs sur le TTL et le rythme des appels, pourquoi le taux de réussite peut baisser. La partie 5 présente l’organisation des invites, le choix du TTL, des exemples de code et des méthodes de suivi du taux de réussite. La partie 6 aborde les critères de décision pour maîtriser les coûts en tokens dans les scénarios de production IA en lot.
À savoir : préparation du vocabulaire Prompt Caching
| Terme | Explication |
|---|---|
| Token | Unité de mesure du texte utilisée par le modèle ; l’API facture au nombre de Tokens, et le prix unitaire s’exprime généralement en « dollars / million de Tokens (MTok) » |
| Prompt Caching | Mise en cache des préfixes d’invite déjà traités : les requêtes suivantes qui rencontrent le même préfixe le réutilisent directement, ce qui réduit le coût du traitement répété |
| Préfixe stable | Partie initiale de l’invite identique mot pour mot d’une requête à l’autre, par exemple la description du rôle, les consignes de rédaction, les exemples de textes, la base de connaissances |
| Entrée dynamique | Contenu qui change à chaque requête, par exemple les éléments d’actualité du jour, le titre de l’article, les demandes de l’utilisateur |
| Écriture en cache | Premier traitement du préfixe stable puis stockage en cache ; le prix unitaire est généralement plus élevé que celui d’une entrée normale |
| Lecture du cache | Les requêtes suivantes touchent le cache existant et sont facturées à un prix unitaire bien inférieur à celui d’une entrée normale |
| Succès du cache | Le préfixe de la nouvelle requête correspond Token par Token au cache disponible ; la réutilisation a réussi |
| TTL | Durée de vie du cache. OpenAI la définit comme une durée de vie minimale, sans garantir le moment exact de la suppression |
| Point de rupture du cache | Position indiquée dans l’invite qui signale « le préfixe pouvant être mis en cache s’arrête ici » |
| Cache implicite / explicite | Le cache implicite est déterminé et réutilisé automatiquement par le système ; le cache explicite est déclaré activement par le développeur, via un point de rupture ou la création d’un objet de cache |
| Coût complet de la tâche | Total des coûts d’entrée, de sortie et des outils applicables pour un appel ; c’est le vrai dénominateur pour mesurer le pourcentage d’économies |
1 Prompt Caching permet d’économiser, mais où exactement ?
1.1 Ce que Prompt Caching réutilise
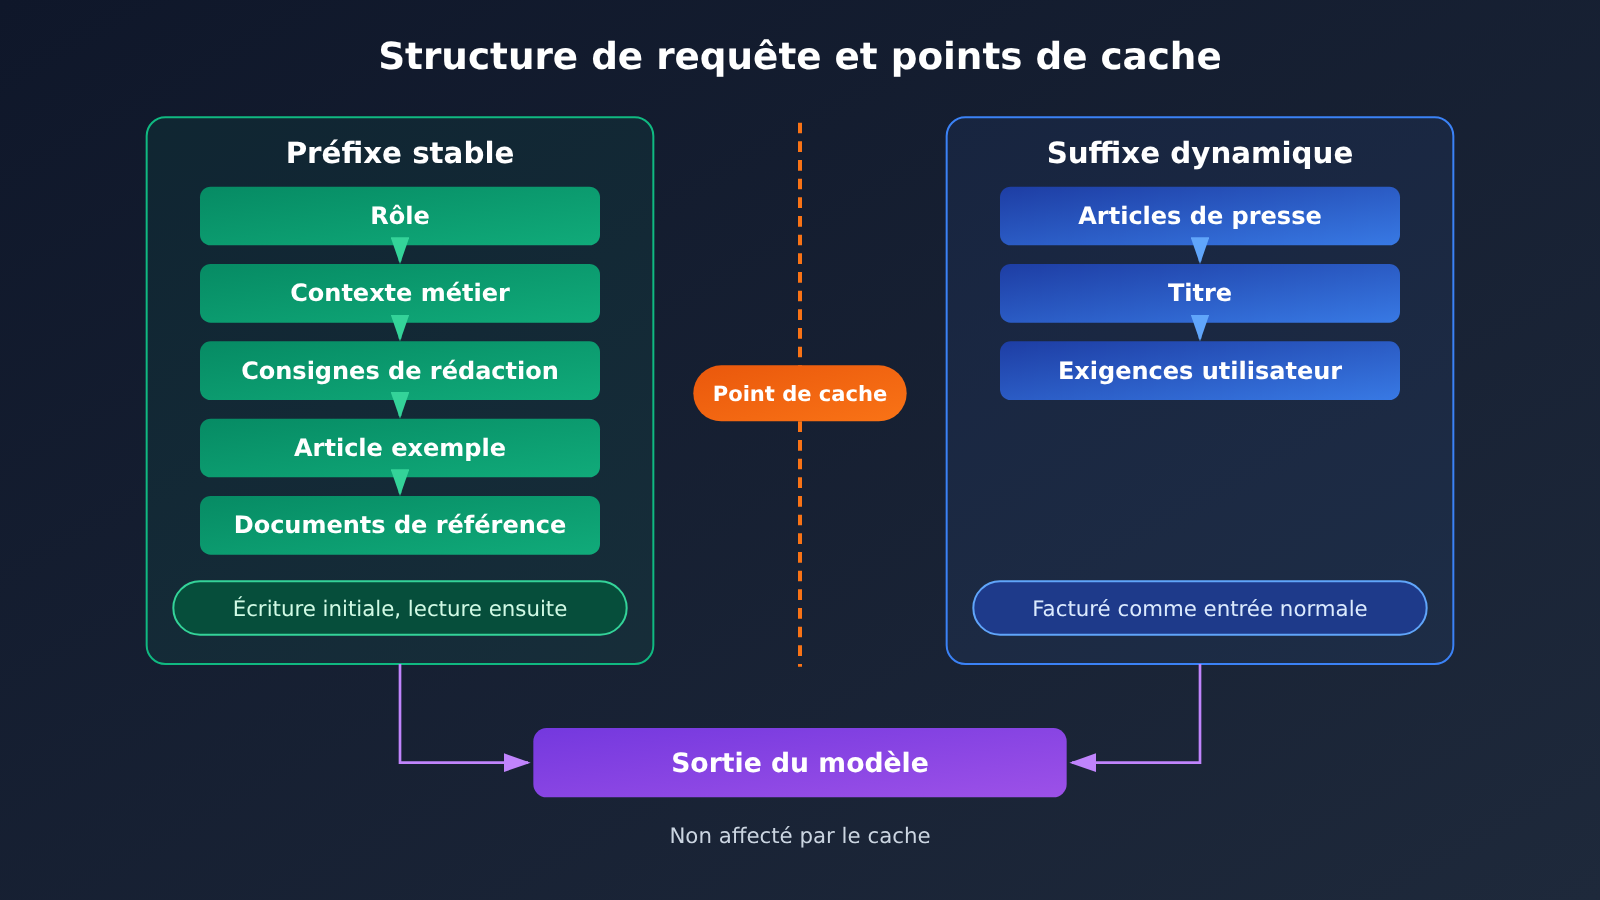
Prenons l’exemple d’une plateforme d’écriture assistée par IA. Pour chaque article généré, la requête se compose de deux parties. La première est le contenu fixe : consignes de rôle, contexte métier, règles de rédaction, articles d’exemple, terminologie et documents de référence. La seconde est le contenu dynamique : les actualités du jour, le titre de l’article et les demandes précises de l’utilisateur.
Prompt Caching réutilise la première partie, c’est-à-dire le préfixe strictement identique token par token. La mise en cache exige que la séquence de tokens soit exactement identique ; une simple proximité sémantique ne compte pas comme un succès de cache. Changer un mot, réordonner les paragraphes ou réorganiser les définitions d’outils peut transformer le préfixe en nouveau contenu et faire tomber le cache.
L’optimisation du cache repose donc sur un principe de base : placer le contenu stable au début et le contenu variable à la fin.
1.2 Quelle partie des coûts Prompt Caching permet-il d’économiser ?
La facture d’un appel peut être décomposée en cinq postes, et seul le coût du préfixe fixe est modifié par le cache :
| Poste de coût | Sans cache | Avec cache activé |
|---|---|---|
| Préfixe fixe | Facturé à chaque fois au prix d’entrée standard | Facturé au prix d’écriture la première fois, puis au prix de lecture lors des hits |
| Entrée dynamique | Prix d’entrée standard | Prix d’entrée standard, inchangé |
| Sortie du modèle | Prix de sortie | Prix de sortie, inchangé |
| Frais d’outils | Selon les règles de l’outil | Selon les règles de l’outil, inchangé |
| Stockage explicite du cache (Gemini) | Aucun | Facturé en plus selon la durée de stockage |
Ce tableau met en évidence une distinction essentielle : le taux d’économie sur le préfixe fixe et le taux d’économie sur la facture totale sont deux indicateurs différents. Le premier mesure uniquement la baisse sur la partie mise en cache ; le second mesure la baisse sur l’ensemble de la facture. Plus la sortie est longue, plus le taux d’économie sur la facture totale est faible.
2 Quelles sont les différences entre les règles de Prompt Caching de GPT, Claude et Gemini ?
2.1 OpenAI Prompt Caching : 30 min et 12 h
La documentation OpenAI précise, pour GPT-5.6 et les modèles suivants, que la longueur minimale du préfixe mis en cache est généralement de 1 024 tokens d’entrée visibles, avec prise en charge de deux modes : implicite (implicit) et explicite (explicit). En mode explicite, le développeur marque prompt_cache_breakpoint dans le bloc de contenu de message approprié, afin de délimiter explicitement la frontière du préfixe mis en cache.
La durée de vie (TTL) par défaut est de 30 minutes ; l’API Responses permet de choisir une durée de vie minimale de 12 heures via prompt_cache_options.ttl = "12h". La facturation distingue l’écriture et la lecture :
- Écriture 30 minutes : 1,25 fois une entrée normale
- Écriture 12 heures : 2,5 fois une entrée normale
- Lecture du cache : 0,1 fois une entrée normale pour la plupart des nouveaux modèles, et 0,05 fois pour GPT-6.1 Sol et GPT-6.1 Terra
prompt_cache_key permet de distinguer la facturation du cache entre différents utilisateurs ou espaces de travail. Sur GPT-5.6 et les modèles suivants, le routage du cache est désormais géré automatiquement par OpenAI.
2.2 Claude Prompt Caching : 5 min et 1 h
Claude prend en charge le cache automatique ou explicite via cache_control. La durée de validité par défaut est de 5 minutes, et chaque hit de cache rafraîchit cette durée. Le décompte des 5 minutes commence au moment de la requête d’écriture ou de lecture du cache, et le temps de génération de la réponse est également inclus. Ainsi, dans les tâches à sortie longue, l’intervalle réellement disponible est plus court que 5 minutes.
Les multiplicateurs de facturation sont : écriture 5 min 1,25x, écriture 1 h 2x, lecture standard 0,1x. Les tarifs de lecture de Claude Sonnet 5.5 et Claude Opus 5.5 descendent à 0,05x. Le tarif standard de Sonnet 5.5 est : entrée $2, écriture 5 min $2.50, écriture 1 h $4, lecture $0.10, sortie $10 (tous en USD / million de tokens).
2.3 Gemini Context Caching : implicite et explicite
Gemini 2.5 et les modèles plus récents activent par défaut le cache implicite, sans configuration supplémentaire. L’exigence minimale d’entrée varie selon le modèle : 4,096 tokens pour Gemini 3.8 Flash, 2,048 tokens pour Gemini 2.5 Flash et 2.5 Pro. Google recommande de placer le contenu partagé au début de l’invite et de réutiliser le même préfixe dans un intervalle de temps relativement court.
Le cache explicite exige que le développeur crée activement un objet de cache et définisse sa durée de vie. Les coûts comprennent trois parties : le contenu mis en cache, les lectures ultérieures et la durée de stockage. L’API Gemini Interactions ne prend actuellement en charge que le cache implicite ; pour un objet de cache explicite, utilisez l’API generateContent.
Les prix de Gemini 3.8 Flash jusqu’au 31 décembre 2026 sont : entrée $0.75, sortie $3.75, lecture de cache $0.075, stockage de cache explicite $0.50 / million de tokens / heure. À partir du 1er janvier 2027, l’ajustement officiel prévu est de $1.50, $7.50, $0.15, $1.00. Les quatre prix doublent dans les mêmes proportions ; les pourcentages d’économie calculés ci-dessous restent donc inchangés, mais les montants absolus doublent.
2.4 Comparaison des règles de mise en cache des invites chez les trois fournisseurs
| Dimension | OpenAI | Claude | Gemini |
|---|---|---|---|
| Méthode de mise en cache | Implicite / points de rupture explicites | cache_control automatique / explicite |
Implicite (par défaut) / objet de cache explicite |
| TTL par défaut | 30 minutes (durée de conservation minimale) | 5 minutes, rafraîchi à chaque succès du cache | Implicite : géré par le système ; explicite : durée définie par l’utilisateur |
| Option de TTL long | 12 heures (Responses API) | 1 heure | Cache explicite : durée personnalisable |
| Tarif d’écriture | 30 min : ×1,25 ; 12 h : ×2,5 | 5 min : ×1,25 ; 1 h : ×2 | Implicite : première fois facturé au tarif d’entrée standard |
| Tarif de lecture | ×0,1 (×0,05 pour Sol / Terra) | ×0,1 (×0,05 pour Sonnet / Opus 5.5) | 3.8 Flash : 0,075 $ / MTok |
| Frais supplémentaires | Aucun frais de stockage | Aucun frais de stockage | Cache explicite : frais de stockage facturés à l’heure |
| Préfixe minimum | Généralement 1 024 tokens | Voir la documentation officielle | 3.8 Flash : 4 096 tokens |
3 Avec 100 appels par jour, combien Prompt Caching permet-il réellement d’économiser ?
3.1 Conditions de calcul communes
Voici un calcul théorique fondé sur les tarifs officiels ; il ne s’agit pas d’une facture utilisateur réelle. Les hypothèses communes sont les suivantes :
- À chaque appel : un préfixe fixe de 20 000 tokens, une entrée dynamique de 500 tokens et une sortie de 1 000 tokens
- 100 appels par jour, toujours avec le même modèle
- Tout le contenu dynamique se trouve après le préfixe stable
- Scénario avec cache : écriture lors du 1er appel, puis 99 hits de cache complots ; tous les appels sont effectués dans le TTL, ou la validité est rafraîchie à chaque hit
- On ne tient pas compte des majorations de tiers, des remises de volume ni des frais d’outils
- Le préfixe de 20K ne déclenche pas la surfacturation de contexte long de GPT-6 Astra au-delà de 272K tokens
La formule de calcul commune est la suivante :
Coût par élément = nombre de tokens × nombre d'appels ÷ 1,000,000 × prix unitaire (USD / MTok)
Coût du préfixe après mise en cache = 20,000 × 1 ÷ 1,000,000 × prix d'écriture + 20,000 × 99 ÷ 1,000,000 × prix de lecture
3.2 Formule complète pour GPT-6 Astra
Tarifs unitaires de GPT-6 Astra : entrée normale $10, sortie $50, écriture 30 minutes $12.50, lecture du cache $1.
Sans cache :
- Préfixe fixe : 20 000 × 100 ÷ 1 000 000 × $10 = $20
- Entrée dynamique : 500 × 100 ÷ 1 000 000 × $10 = $0.50
- Sortie : 1 000 × 100 ÷ 1 000 000 × $50 = $5
- Total journalier : $25.50
Cache 30 minutes :
- Première écriture : 20 000 ÷ 1 000 000 × $12.50 = $0.25
- 99 lectures : 20 000 × 99 ÷ 1 000 000 × $1 = $1.98
- Entrée dynamique : $0.50 ; sortie : $5
- Total journalier : $7.73
Sur la facture complète, on économise $17.77, soit environ 69.69 %. Le préfixe fixe passe de $20 à $2.23, une économie d’environ 88.85 %.
3.3 GPT-6.1 Sol, Claude Sonnet 5.5 et Gemini 3.8 Flash
GPT-6.1 Sol (entrée $2, sortie $10, écriture 30 minutes $2.50, lecture $0.10) :
- Sans cache : préfixe $4 + entrée dynamique $0.10 + sortie $1 = $5.10
- Avec cache : écriture $0.05 + lectures $0.198 + entrée dynamique $0.10 + sortie $1 = $1.348
- Économie de $3.752, soit environ 73.57 % ; le préfixe passe de $4 à $0.248, une économie d’environ 93.8 %
Claude Sonnet 5.5 (cache de 5 minutes) affiche les mêmes tarifs unitaires que GPT-6.1 Sol, et le calcul comme le résultat sont identiques : on passe de $5.10 à $1.348. La condition étant que l’intervalle entre les appels permette de maintenir la validité de 5 minutes.
Gemini 3.8 Flash (cache implicite, la première fois facturée comme une entrée normale à $0.75) :
- Sans cache : préfixe $1.50 + entrée dynamique $0.0375 + sortie $0.375 = $1.9125
- Avec cache : premier préfixe $0.015 + 99 lectures $0.1485 + entrée dynamique $0.0375 + sortie $0.375 = $0.576
- Économie de $1.3365, soit environ 69.88 % ; le préfixe passe de $1.50 à $0.1635, une économie d’environ 89.1 %
- Ce résultat suppose que le cache implicite soit intégralement touché, et n’inclut pas les frais de stockage du cache explicite
3.4 Mise en cache des prompts (Prompt Caching) : différence entre taux d’économie et montant absolu
| Modèle | Sans cache / jour | Après cache / jour | Économies par jour | Économies sur 30 jours (extrapolées) | Taux d’économie sur le préfixe | Taux d’économie sur la facture complète |
|---|---|---|---|---|---|---|
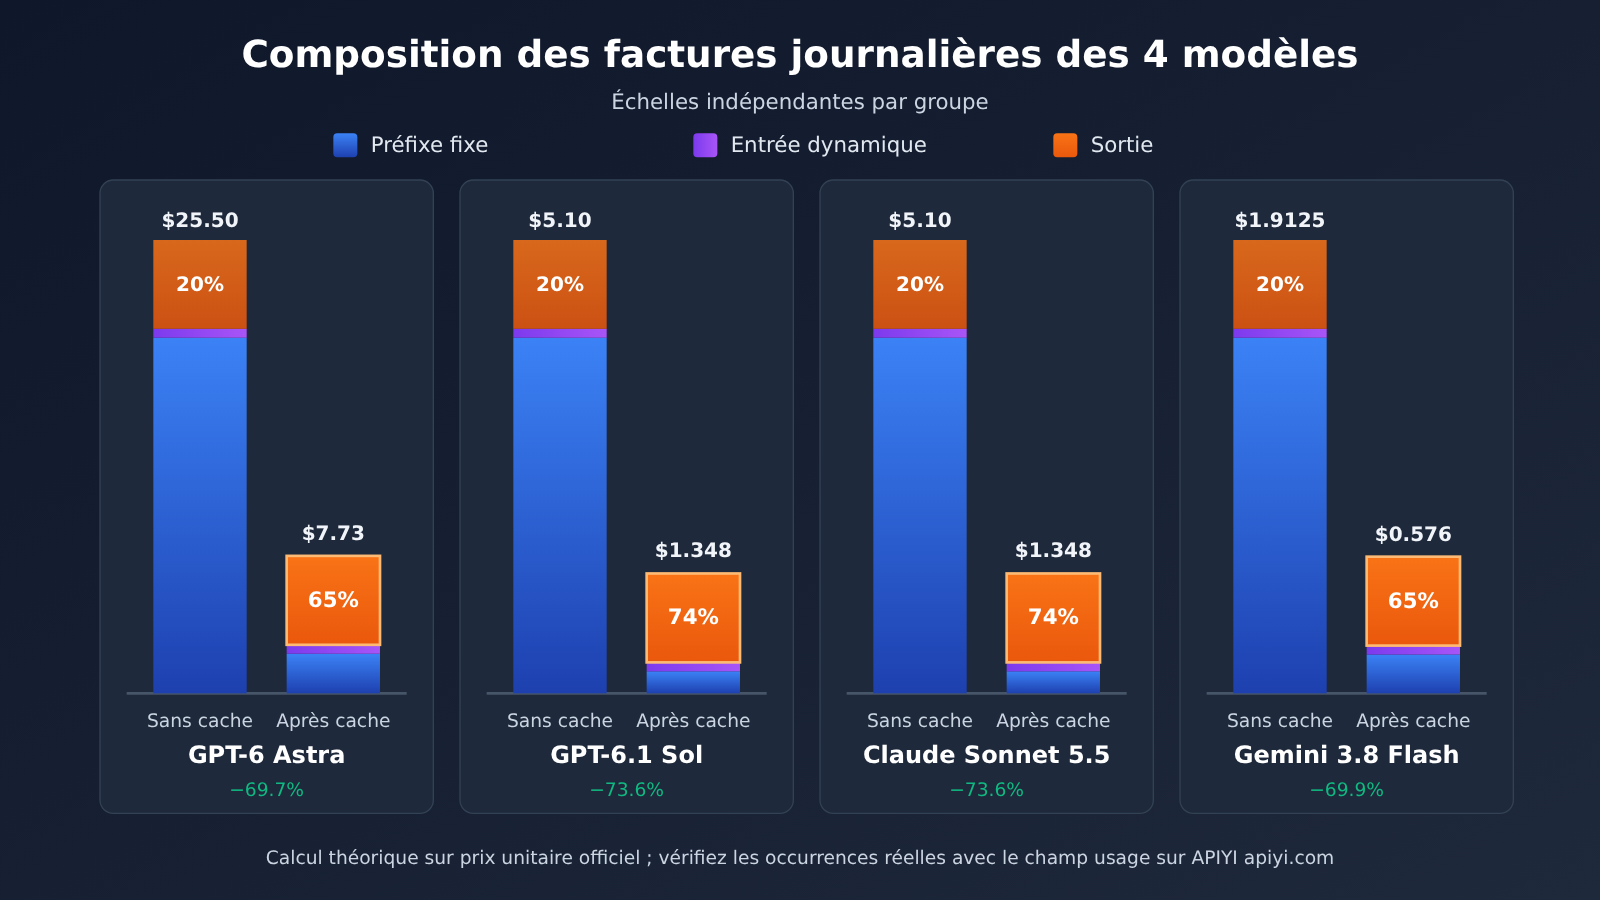
| GPT-6 Astra | $25.50 | $7.73 | $17.77 | $533.10 | 88.85% | 69.69% |
| GPT-6.1 Sol | $5.10 | $1.348 | $3.752 | $112.56 | 93.8% | 73.57% |
| Claude Sonnet 5.5 | $5.10 | $1.348 | $3.752 | $112.56 | 93.8% | 73.57% |
| Gemini 3.8 Flash | $1.9125 | $0.576 | $1.3365 | $40.10 | 89.1% | 69.88% |
Deux enseignements ressortent du tableau :
- Le ratio reflète la remise sur la lecture. Pour GPT-6.1 Sol et Claude Sonnet 5.5, le prix de lecture représente 0.05 fois celui d’une entrée normale ; le taux d’économie sur le préfixe atteint 93.8 %, soit plus que pour Astra et Gemini, dont la lecture est à 0.1 fois.
- Le montant dépend du prix unitaire de base. Astra affiche le taux d’économie le plus faible, mais permet d’économiser $17.77 par jour, soit plus de 13 fois les économies de Gemini 3.8 Flash. Plus le prix unitaire d’un modèle est élevé, plus le gain absolu apporté par l’activation du cache est important.
Après mise en cache, la part de la sortie dans la facture de GPT-6 Astra passe d’environ 20 % à environ 65 % ($5 ÷ $7.73). À ce stade, l’optimisation des coûts se déplace vers le contrôle de la longueur de sortie. À noter : le fait que les quatre modèles utilisent le même nombre de tokens sert uniquement à faciliter la comparaison. Pour une même tâche, la longueur réelle de sortie et le taux de réussite varient selon le modèle.
💡 Conseil de sélection : lorsque les ratios sont proches, privilégiez l’équilibre entre le montant absolu économisé chaque jour et la qualité sur la tâche. Je vous conseille de commencer par appeler plusieurs modèles candidats avec le même modèle de prompt sur APIYI apiyi.com, de noter la longueur réelle de sortie et les tokens mis en cache, puis d’utiliser la formule ci-dessus pour estimer le budget mensuel.
4 Pourquoi la facture de Prompt Caching peut quand même être élevée lorsqu’on répète la même invite chaque jour ?
4.1 Le TTL et la fréquence d’appel déterminent le taux de succès du cache
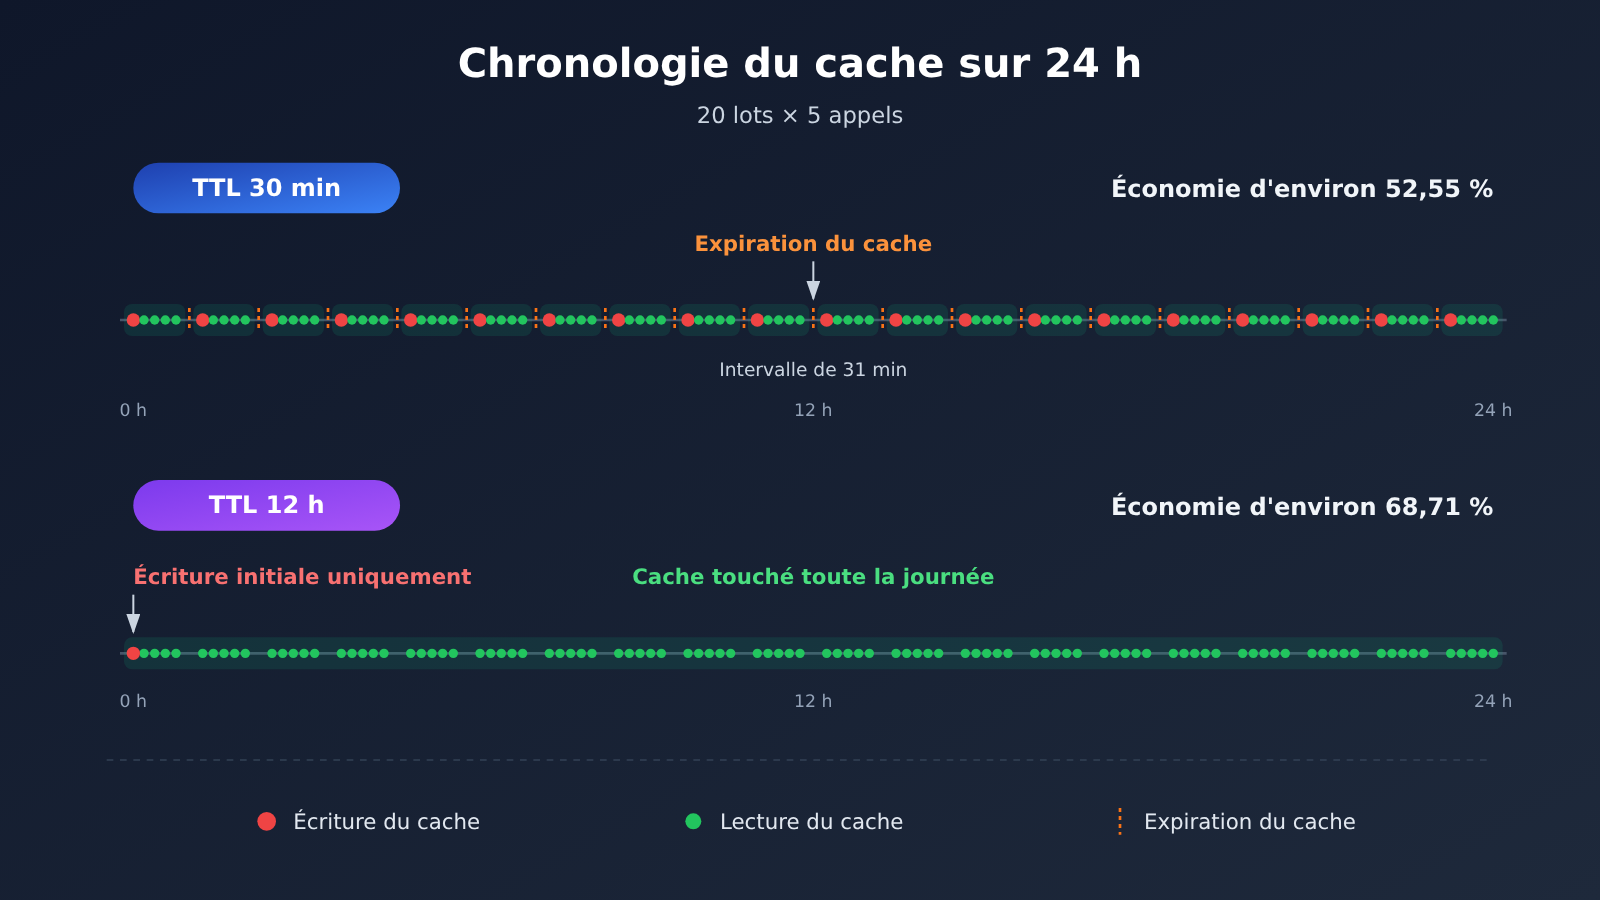
Appeler 100 fois par jour ne signifie pas qu’une seule écriture couvre toute la journée. Prenons GPT-6 Astra comme exemple : 20 lots par jour, 5 appels consécutifs par lot, avec un intervalle de 31 minutes entre deux lots.
| Scénario | Nombre d’écritures et coût | Nombre de lectures et coût | Coût du préfixe | + entrée dynamique et sortie | Total journalier | Taux d’économie |
|---|---|---|---|---|---|---|
| Sans cache | — | — | 20 $ | 5,50 $ | 25,50 $ | — |
| A : cache 30 min | 20 × 0,25 $ = 5 $ | 80 × 0,02 $ = 1,60 $ | 6,60 $ | 5,50 $ | 12,10 $ | env. 52,55 % |
| B : cache 12 h (dans une même fenêtre) | 1 × 0,50 $ | 99 × 0,02 $ = 1,98 $ | 2,48 $ | 5,50 $ | 7,98 $ | env. 68,71 % |
Dans le scénario A, l’intervalle entre les lots dépasse 30 minutes : chaque lot doit donc réécrire, et le taux d’économie passe de l’idéal de 69,69 % à 52,55 %. Dans le scénario B, le prix d’une écriture unique est le double de celui du cache 30 min, mais on n’écrit qu’une seule fois dans la journée, ce qui est plus rentable pour des appels dispersés. La formule 12 h ne couvre qu’une même fenêtre ; rien ne garantit que la même cache soit réutilisable le lendemain. Pour les tâches qui n’appellent qu’une ou deux fois par jour, impossible d’obtenir un cache inter-journées avec la même invite seule.
Pour le point d’équilibre de chaque type de TTL, on peut ne regarder que le préfixe stable, en prenant l’entrée normale comme base de 1 :
| Formule | Multiplicateur d’écriture | Multiplicateur de lecture | 1 écriture + 1 lecture vs 2 sans cache | 1 écriture + 2 lectures vs 3 sans cache | Lectures effectives pour rentabiliser |
|---|---|---|---|---|---|
| OpenAI 30 min | 1,25 | 0,1 | 1,35 < 2 | — | 1 fois |
| OpenAI 12 h | 2,5 | 0,1 | 2,6 > 2 | 2,7 < 3 | 2 fois |
| Claude Sonnet 5.5 · 5 min | 1,25 | 0,05 | 1,30 < 2 | — | 1 fois |
| Claude Sonnet 5.5 · 1 h | 2 | 0,05 | 2,05 > 2 | 2,10 < 3 | 2 fois |
La conclusion est simple : un TTL court est rentabilisé dès un seul succès du cache ; un TTL long exige au moins deux succès pendant sa période de validité.
4.2 Points de rupture du cache et ordre des invites
La cause d’échec la plus fréquente est un préfixe stable qui a été modifié. Si vous placez un horodatage, un ID utilisateur, un titre de tâche ou des documents en temps réel au début de l’invite, le préfixe de chaque requête devient du nouveau contenu, et le cache ne pourra jamais être touché.
Dans le mode implicite d’OpenAI, si la première requête inclut aussi du contenu dynamique dans la plage mise en cache, il suffit que ce contenu dynamique change ensuite pour que le préfixe stable attendu ne soit plus touché. La solution consiste à définir un point de rupture de cache explicite à la fin du contenu stable.
Autres causes fréquentes :
- changement de modèle, de fournisseur, d’organisation de service, ou modification de certains paramètres
- un Agent qui compresse la conversation, réordonne les définitions d’outils ou modifie les messages d’historique, ce qui réécrit le préfixe réutilisable
- une passerelle tierce qui ne transmet pas les paramètres de cache, ou qui n’applique pas la remise de cache à la facturation
4.3 Impact des tokens de sortie et des frais d’outils
Le cache n’agit que sur le préfixe d’entrée. Dans l’exemple de calcul Astra du point 3.2, même si le coût du préfixe tombe à zéro, la facture ne descendra pas sous $5.50 (entrée dynamique plus sortie). Pour les tâches à sortie longue et à nombreux appels d’outils, la baisse de la facture totale sera nettement inférieure au taux d’économie sur le préfixe. Donc, après avoir activé le cache, il faut aussi contrôler la longueur de sortie et alléger les appels d’outils.
5 Comment configurer et surveiller le Prompt Caching dans les applications d’IA ?
5.1 Méthode d’organisation : préfixe stable et suffixe dynamique
Classez le contenu par « fréquence de variation croissante » :
- Définition des outils : gardez un ordre fixe et des descriptions fixes, sans ajout ni suppression dynamique selon la requête
- Règles système et normes de rédaction : description du rôle, charte de marque, exigences de style
- Exemples de référence et base de connaissances : longs documents de référence, remplacés en bloc à chaque mise à jour de version
- (Point de rupture de cache)
- Matériel dynamique : actualités du jour, résultats de recherche, saisie de l’utilisateur
- Instructions de la tâche en cours : titre, nombre de mots, exigences précises
L’exemple ci-dessous lance un appel via l’interface compatible OpenAI et lit les tokens mis en cache dans la réponse :
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d'APIYI
)

STABLE_PREFIX = """Vous êtes un auteur de blog technique…… (normes de rédaction, exemples, glossaire, environ 20K Token, contenu fixé au mot près)"""

resp = client.chat.completions.create(
    model="gpt-6.1-sol",  # Utilisez le nom réel figurant dans la liste des modèles de la plateforme
    messages=[
        {"role": "system", "content": STABLE_PREFIX},          # Le préfixe stable vient en premier
        {"role": "user", "content": "Matériel du jour : ……\nTitre : ……"},  # Le contenu dynamique vient ensuite
    ],
)
details = getattr(resp.usage, "prompt_tokens_details", None)
cached = getattr(details, "cached_tokens", 0) or 0
print(f"Entrée {resp.usage.prompt_tokens}, cache touché {cached}")
Voir le code complet : calculateur de coûts + statistiques de taux de réussite du cache
from openai import OpenAI

M = 1_000_000

def daily_cost(prefix, dynamic, output, calls,
               p_in, p_out, p_write, p_read,
               writes=1, use_cache=True):
    """Calcule le coût journalier (en USD) d'après les tarifs officiels, renvoie (préfixe, entrée dynamique, sortie, total)"""
    dyn = dynamic * calls / M * p_in
    out = output * calls / M * p_out
    if use_cache:
        pre = prefix * writes / M * p_write + prefix * (calls - writes) / M * p_read
    else:
        pre = prefix * calls / M * p_in
    return round(pre, 4), round(dyn, 4), round(out, 4), round(pre + dyn + out, 4)

MODELS = {
    # nom : (entrée, sortie, écriture, lecture) en USD / million de tokens, vérifié le 2026-11-13
    "GPT-6 Astra (30m)":   (10,   50,   12.5, 1),
    "GPT-6.1 Sol (30m)":   (2,    10,   2.5,  0.10),
    "Claude Sonnet 5.5":   (2,    10,   2.5,  0.10),
    "Gemini 3.8 Flash":    (0.75, 3.75, 0.75, 0.075),  # cache implicite : la première fois facturé comme entrée normale
}

for name, (p_in, p_out, p_w, p_r) in MODELS.items():
    base = daily_cost(20000, 500, 1000, 100, p_in, p_out, p_w, p_r, use_cache=False)[-1]
    cached = daily_cost(20000, 500, 1000, 100, p_in, p_out, p_w, p_r)[-1]
    print(f"{name}: ${base} -> ${cached},节省 {(base - cached) / base:.2%}")

# Scénario A : Astra 30m, 20 lots nécessitant chacun une nouvelle écriture
a = daily_cost(20000, 500, 1000, 100, 10, 50, 12.5, 1, writes=20)[-1]
print(f"Astra 分批 30m: ${a}")  # 12.1

# ---- Statistiques du taux de réussite du cache en production ----
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

def run_and_track(stable_prefix, dynamic_inputs, model="gpt-6.1-sol"):
    total_in = total_cached = 0
    for text in dynamic_inputs:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "system", "content": stable_prefix},
                      {"role": "user", "content": text}],
        )
        d = getattr(r.usage, "prompt_tokens_details", None)
        total_in += r.usage.prompt_tokens
        total_cached += (getattr(d, "cached_tokens", 0) or 0)
    hit = total_cached / total_in if total_in else 0
    print(f"实际缓存命中率:{hit:.2%}")
    return hit
🚀 Conseil pour bien démarrer : commencez par estimer votre budget avec le calculateur ci-dessus, puis lancez 10 à 20 appels avec votre vrai modèle d’invite pour vérifier si
cached_tokensapparaît bien de façon stable dès le deuxième appel. Les nouveaux utilisateurs peuvent récupérer un crédit de test gratuit sur APIYI apiyi.com pour réaliser cette vérification, et ne monter en charge qu’une fois le cache confirmé.
5.2 Choisir le TTL du Prompt Caching et le mode de cache
- Appels consécutifs à haute fréquence (intervalles stables de quelques minutes) : utilisez le TTL court par défaut, c’est-à-dire 30 min pour OpenAI et 5 min pour Claude. Un seul hit suffit à rentabiliser l’opération, et la prime d’écriture est minimale. Claude doit intégrer la durée de génération de la réponse dans la fenêtre de 5 minutes.
- Appels dispersés tout au long de la journée (intervalles entre lots supérieurs à 30 minutes) : évaluez 12 h pour OpenAI ou 1 h pour Claude. Dès lors qu’on obtient au moins deux hits dans la fenêtre, un TTL long revient moins cher que des écritures répétées — le scénario B de la section 4.1 en est la preuve.
- Tâches Gemini à préfixe très long, destinées à être réutilisées sur une période assez longue : envisagez le cache explicite, en tenant compte des frais de stockage. Prenons Gemini 3.8 Flash : stocker 20K tokens pendant 12 heures coûte 0.02 × $0.50 × 12 = $0.12 en frais de stockage. Avec la charge de travail décrite dans cet article, ce montant est déjà assez significatif au regard de la facture journalière de $0.576. Si le cache implicite donne de bons résultats, gardez la configuration par défaut.
- Préfixe fréquemment modifié : commencez par figer le préfixe, puis envisagez le TTL. Tant que le préfixe reste instable, aucun TTL ne permettra d’obtenir des hits.
5.3 Vérifier le taux de réussite réel et la facturation du Prompt Caching
Les champs usage des trois fournisseurs sont les suivants :
- OpenAI (Responses API) :
usage.input_tokens,usage.input_tokens_details.cached_tokens,usage.input_tokens_details.cache_write_tokens - Claude :
usage.input_tokens,usage.cache_creation_input_tokens,usage.cache_read_input_tokens - Gemini : les champs usage de l’API correspondante, par exemple
total_cached_tokens; le cache explicite est facturé en plus comme du stockage d’objets
Il est conseillé de suivre deux indicateurs en continu :
Taux de réussite réel du cache = Tokens lus dans le cache ÷ Tokens d'entrée totaux
Économies réelles              = Coût de référence sans cache − Coût réel de la facture API
Le coût de référence sans cache doit être calculé avec le même modèle, la même charge de travail et la même taille de sortie, sinon les économies ne sont pas comparables. Lorsque vous vérifiez la facture dans la console APIYI apiyi.com, vous pouvez comparer point par point le récapitulatif usage de la même période avec le détail des débits, afin de confirmer que les tokens mis en cache sont bien facturés au prix du cache.
6 Scénario APIYI : comment utiliser Prompt Caching pour maîtriser les coûts avec des modèles fixes et de la production IA en masse ?
Les activités typiques qui profitent du Prompt Caching : les plateformes de rédaction IA qui font tourner chaque jour le même modèle d’article, les Agents qui rechargent sans cesse la même définition d’outils, les systèmes d’analyse documentaire qui citent plusieurs fois le même gros document de référence, et la génération de contenu en masse qui partage une charte de marque et des consignes de style. Ces tâches ont un point commun : préfixe long, taux de répétition élevé, volume d’appels important — exactement la zone où le gain du cache est le plus fort.
Pour prendre une décision de coût dans ce type de scénario, on peut s’appuyer sur trois critères :
- Le modèle prend-il en charge les capacités de cache nécessaires ? Cela inclut la longueur minimale du préfixe, la durée de vie (TTL) optionnelle et le multiplicateur de remise à la lecture. Un modèle dont la lecture est facturée 0,05× offre un meilleur taux d’économie sur le préfixe pour les tâches à préfixe long.
- L’invite et le TTL correspondent-ils à la charge de travail ? Pour le traitement par lots en continu, utilisez un TTL court ; pour les tâches réparties selon un planning, évaluez un TTL long et calculez le nombre de retours sur investissement avec la formule de la section 4.1.
- Le fournisseur d’API prend-il pleinement en charge le cache et facture-t-il au coût réel du cache ? Le fait que l’amont gère le cache n’est qu’une condition nécessaire à la baisse des coûts. La passerelle doit aussi transmettre correctement les paramètres de cache, remonter les tokens mis en cache dans l’usage et répercuter le prix du cache dans la facturation.
Lors d’un appel via APIYI apiyi.com, je vous conseille de transformer le point 3 en étape de validation systématique : appelez plusieurs fois de suite avec le même modèle de 20K, vérifiez les champs de cache dans l’usage, puis recoupez avec les débits de la facture. Une fois les deux aspects confirmés — la réussite technique et l’application de la facturation — vous pourrez utiliser le résultat du calcul ci-dessus comme base de votre budget mensuel.
FAQ — Questions fréquentes
Q1 : Qu’est-ce que le Prompt Caching ?
Cette fonctionnalité met en cache le préfixe identique déjà traité dans l’invite. Lorsqu’une requête ultérieure le retrouve, la facturation se fait à un tarif bien inférieur à celui d’une entrée normale. La correspondance exige que les Tokens soient identiques au caractère près, ce qui la destine aux cas d’usage à modèle fixe, base de connaissances fixe ou définitions d’outils fixes.
Q2 : Pourquoi le préfixe économise plus de 90 % alors que la facture totale n’économise qu’environ 70 % ?
Le cache ne s’applique qu’au préfixe fixe ; les entrées dynamiques et les sorties restent facturées au tarif normal. Prenons GPT-6.1 Sol : sur une facture journalière de 1,348 $, la sortie représente 1 $ et l’entrée dynamique 0,10 $. Plus la sortie est longue, plus le taux d’économie sur la facture complète est faible.
Q3 : Je n’appelle le service qu’une ou deux fois par jour, est-ce que le cache vaut la peine d’être activé ?
Le gain est très faible. Le cache OpenAI 12h et le cache Claude 1h doivent tous deux être sollicités au moins deux fois pendant leur durée de validité pour être rentabilisés, et la réutilisation d’un jour sur l’autre n’est pas garantie. Une approche plus efficace consiste à regrouper des tâches de même nature dans un même créneau pour exécution par lots, afin d’augmenter le nombre de correspondances pendant la fenêtre.
Q4 : Faut-il choisir 30m ou 12h ?
Tout dépend de l’intervalle entre les appels. Si l’intervalle reste sous 30 minutes, utilisez 30m : une seule correspondance suffit à rentabiliser. Si les appels sont dispersés sur toute la journée avec de longs intervalles entre lots, utilisez 12h. Pour GPT-6 Astra réparti en 20 lots, le coût journalier est de 7,98 $ avec 12h, contre 12,10 $ avec 30m.
Q5 : En passant par une plateforme d’agrégation d’API, le cache fonctionne-t-il toujours ?
Cela dépend de la façon dont la plateforme transmet les paramètres de cache et implémente la facturation. Nous vous conseillons de faire sur APIYI apiyi.com des appels successifs au même modèle avec le quota de test gratuit, de vérifier les champs tels que `cached_tokens` dans `usage`, puis de les recouper avec le détail des débits. Ne passez en production à grande échelle qu’après avoir confirmé que le cache se déclenche bien et qu’il est facturé au tarif cache.
Q6 : Le taux de correspondance du cache chute brutalement, où chercher en premier ?
Procédez dans cet ordre : le préfixe contient-il des données dynamiques comme des horodatages ou des ID ; l’ordre des définitions d’outils a-t-il changé ; l’Agent a-t-il compressé ou réécrit les messages historiques ; le modèle ou les paramètres ont-ils été changés ; l’intervalle entre appels dépasse-t-il le TTL. Utilisez la formule de taux de correspondance de la section 5.3 pour faire des statistiques horaires, ce qui permet d’identifier assez vite le moment du changement.
Q7 : Cache implicite ou cache explicite de Gemini, comment choisir ?
Le cache implicite est activé par défaut, sans frais de stockage, et il est utilisé en priorité lorsque le préfixe dépasse la longueur minimale du modèle (4 096 Tokens pour 3.8 Flash). Le cache explicite convient aux contenus très longs nécessitant une réutilisation déterministe, mais il implique des frais de stockage à l’heure et l’usage de l’API generateContent. L’API Interactions ne prend actuellement en charge que le cache implicite.
En résumé
Les points clés de Prompt Caching :
- Où se trouvent les économies : uniquement sur le coût du préfixe fixe. Pour la charge de travail de cet article, le taux d’économie sur le préfixe va de 88.85 % à 93.8 %, et celui sur la facture complète de 69.69 % à 73.57 %.
- Combien on économise : GPT-6.1 Sol et Claude Sonnet 5.5 passent de $5.10 à $1.348 par jour, GPT-6 Astra de $25.50 à $7.73. Plus le prix unitaire est élevé, plus l’économie absolue est importante.
- Quelle fréquence est la plus rentable : des appels à haute fréquence, continus et avec un préfixe long. Avec un TTL court, un seul hit suffit à rentabiliser ; avec un TTL long, il en faut deux.
- Comment le mettre en œuvre : contenu stable devant, contenu dynamique derrière, avec un point de rupture à la fin du contenu stable ; choisir le TTL selon le rythme des appels ; surveiller en continu le taux de hit via le champ
usage. - La condition pour que ça marche : il faut que le cache soit touché techniquement, et que la facturation applique bien le tarif cache.
Mon conseil : commencez par estimer votre budget avec le calculateur décrit dans cet article, puis vérifiez le taux de hit et la facturation avec un vrai template sur APIYI apiyi.com. Une fois les deux confirmés, passez à l’échelle.
📚 Références
- Guide OpenAI Prompt Caching : modes de cache, points de rupture, TTL et multiplicateurs de facturation
- Lien :
developers.openai.com/api/docs/guides/prompt-caching -
Description : paramètres
prompt_cache_optionsetprompt_cache_breakpoint -
Modèles et tarifs OpenAI : prix unitaires de GPT-6 Astra et GPT-6.1 Sol
- Lien :
developers.openai.com/api/docs/pricing - Lien :
developers.openai.com/api/docs/models/gpt-6-astra - Lien :
developers.openai.com/api/docs/models/gpt-6.1-sol -
Description : tarifs standard à contexte court, vérifiés le 2026-11-13
-
Documentation Claude Prompt Caching :
cache_control, multiplicateurs d’écriture et de lecture 5m / 1h - Lien :
platform.claude.com/docs/en/build-with-claude/prompt-caching - Lien :
platform.claude.com/docs/en/models/sonnet-5-5/overview -
Description : lecture du cache Sonnet 5.5 à un multiplicateur de 0.05
-
Gemini Context Caching et tarifs : cache implicite / explicite, frais de stockage et changement de tarif en 2027
- Lien :
ai.google.dev/gemini-api/docs/caching - Lien :
ai.google.dev/gemini-api/docs/pricing - Description : longueur minimale de cache par modèle et périmètre de prise en charge par l’API
Auteur : l’équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site officiel APIYI ; d’autres ressources d’intégration sont disponibles dans le centre de documentation docs.apiyi.com


