
Resumo: Este artigo usa o mesmo conjunto de cargas de trabalho para calcular o custo do Prompt Caching em quatro partes — gravação em cache, leitura de cache, entrada dinâmica e saída — e explica como a taxa de acerto, o TTL e o ritmo de chamadas influenciam a economia real.
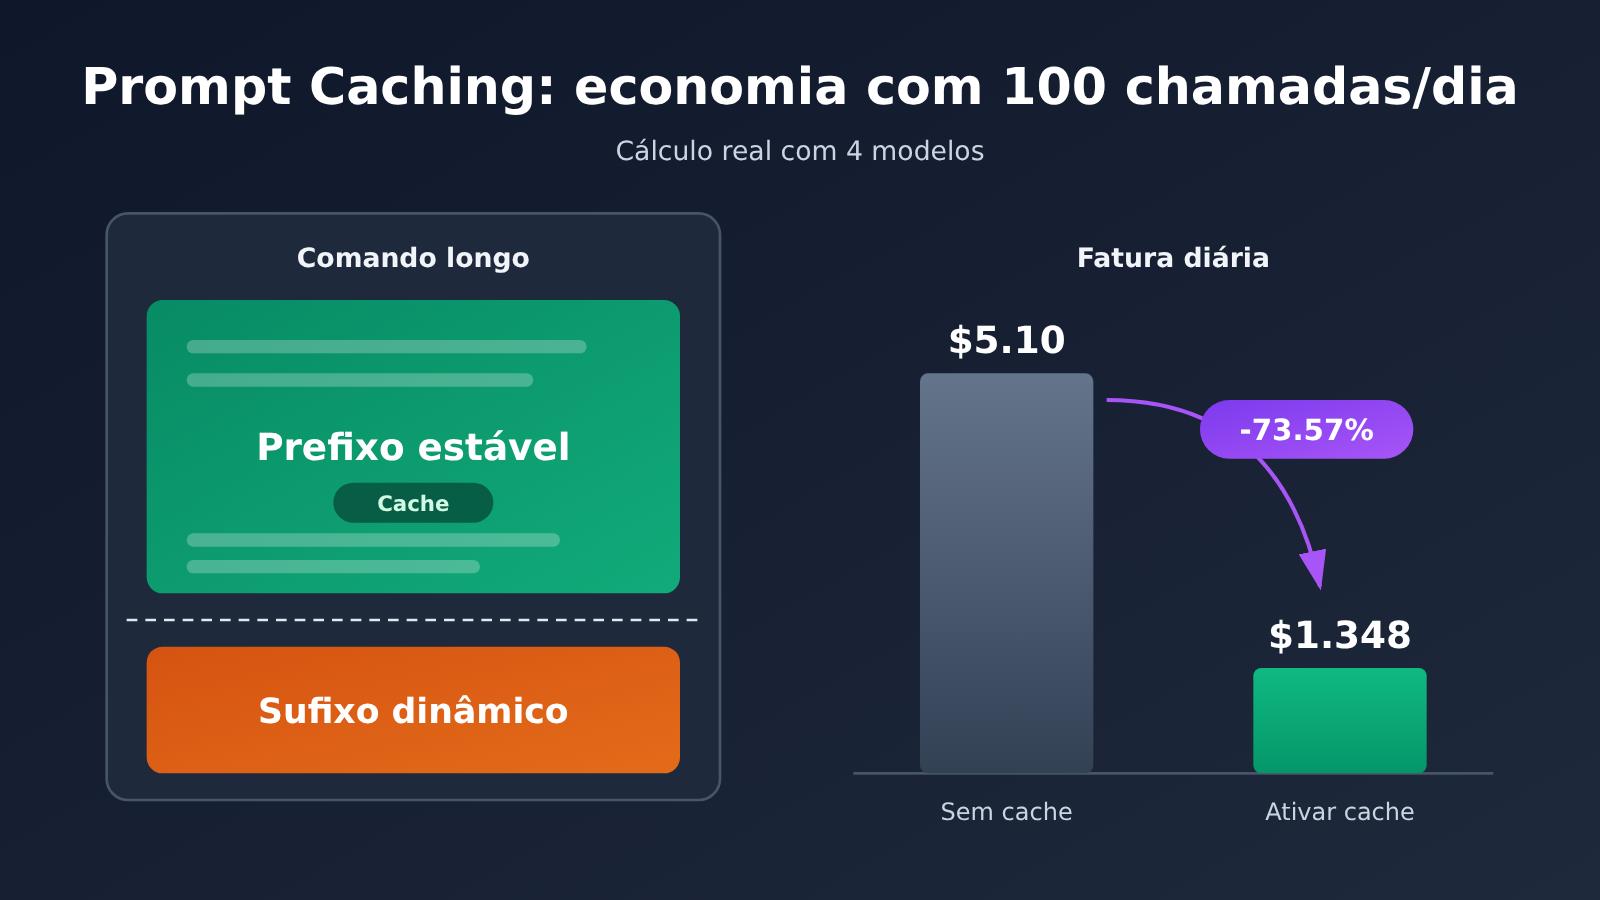
Conclusão: A carga de trabalho definida neste artigo consiste em 20K Tokens de prefixo fixo, 500 Tokens de entrada dinâmica e 1K Tokens de saída por chamada, com 100 chamadas por dia. Nas condições ideais de “primeira gravação e as 99 chamadas seguintes com acerto total”, a fatura diária completa do GPT-6.1 Sol cai de $5.10 para $1.348, uma redução de aproximadamente 73,57%. O resultado do Claude Sonnet 5.5 é o mesmo, o GPT-6 Astra cai de $25.50 para $7.73, uma redução de aproximadamente 69,69%, e o Gemini 3.8 Flash cai de $1.9125 para $0.576, uma redução de aproximadamente 69,88%. Considerando apenas o prefixo fixo, a proporção de economia fica entre 88% e 94%. A redução da fatura completa é menor porque os Tokens de saída e a entrada dinâmica não recebem desconto de cache. Os números acima são simulações orçamentárias feitas com os preços unitários oficiais, não faturas reais. Os preços adotam uniformemente a tarifa padrão de contexto curto, com data de verificação em 2026-11-13.
Prévia do conteúdo: A Parte 1 explica qual trecho da requisição o cache reutiliza e qual parte da fatura ele afeta. A Parte 2 compara as regras de cache das três plataformas OpenAI, Claude e Gemini. A Parte 3 lista item por item as fórmulas de cálculo dos quatro modelos, para que o leitor possa refazer as contas por conta própria. A Parte 4 usa simulações de TTL e ritmo de chamadas para explicar por que a taxa de acerto diminui. A Parte 5 apresenta a forma de organizar o prompt, a escolha de TTL, exemplos de código e métodos de monitoramento da taxa de acerto. A Parte 6 discute os critérios para controlar o custo de Tokens em cenários de produção em massa com IA.
Para saber: termos preliminares de Prompt Caching
| Termo | Explicação |
|---|---|
| Token | Unidade usada pelo modelo para medir texto; a API cobra pelo número de tokens, e o preço unitário costuma ser expresso em “dólares por milhão de tokens (MTok)” |
| Prompt Caching | Armazena em cache o prefixo do comando já processado; quando uma solicitação posterior encontra o mesmo prefixo, ele é reutilizado diretamente, reduzindo o custo de reprocessamento |
| Prefixo estável | Parte inicial do comando que é idêntica caractere por caractere em várias solicitações, como descrição de papéis, regras de escrita, textos de exemplo e base de conhecimento |
| Entrada dinâmica | Conteúdo que muda a cada solicitação, como o material jornalístico do dia, o título do artigo e as exigências do usuário |
| Gravação em cache | Primeiro processamento do prefixo estável e armazenamento no cache; o preço unitário costuma ser maior que o da entrada comum |
| Leitura do cache | Solicitações posteriores acertam um cache existente e são cobradas a um preço unitário bem menor que o da entrada comum |
| Acerto de cache | O prefixo da nova solicitação corresponde token a token a um cache disponível, e a reutilização ocorre com sucesso |
| TTL | Tempo de vida do cache. A OpenAI o define como tempo mínimo de vida, sem prometer um momento exato de remoção |
| Ponto de corte do cache | Posição marcada no comando que indica “o prefixo cacheável termina aqui” |
| Cache implícito / explícito | O cache implícito é determinado e reutilizado automaticamente pelo sistema; o cache explícito é declarado ativamente pelo desenvolvedor por meio de pontos de corte ou da criação de objetos de cache |
| Custo total da tarefa | Soma dos custos de entrada, saída e ferramentas aplicáveis em uma chamada; é o denominador real para medir a proporção de economia |
1 O Prompt Caching economiza dinheiro — onde exatamente?
1.1 O que o Prompt Caching reutiliza
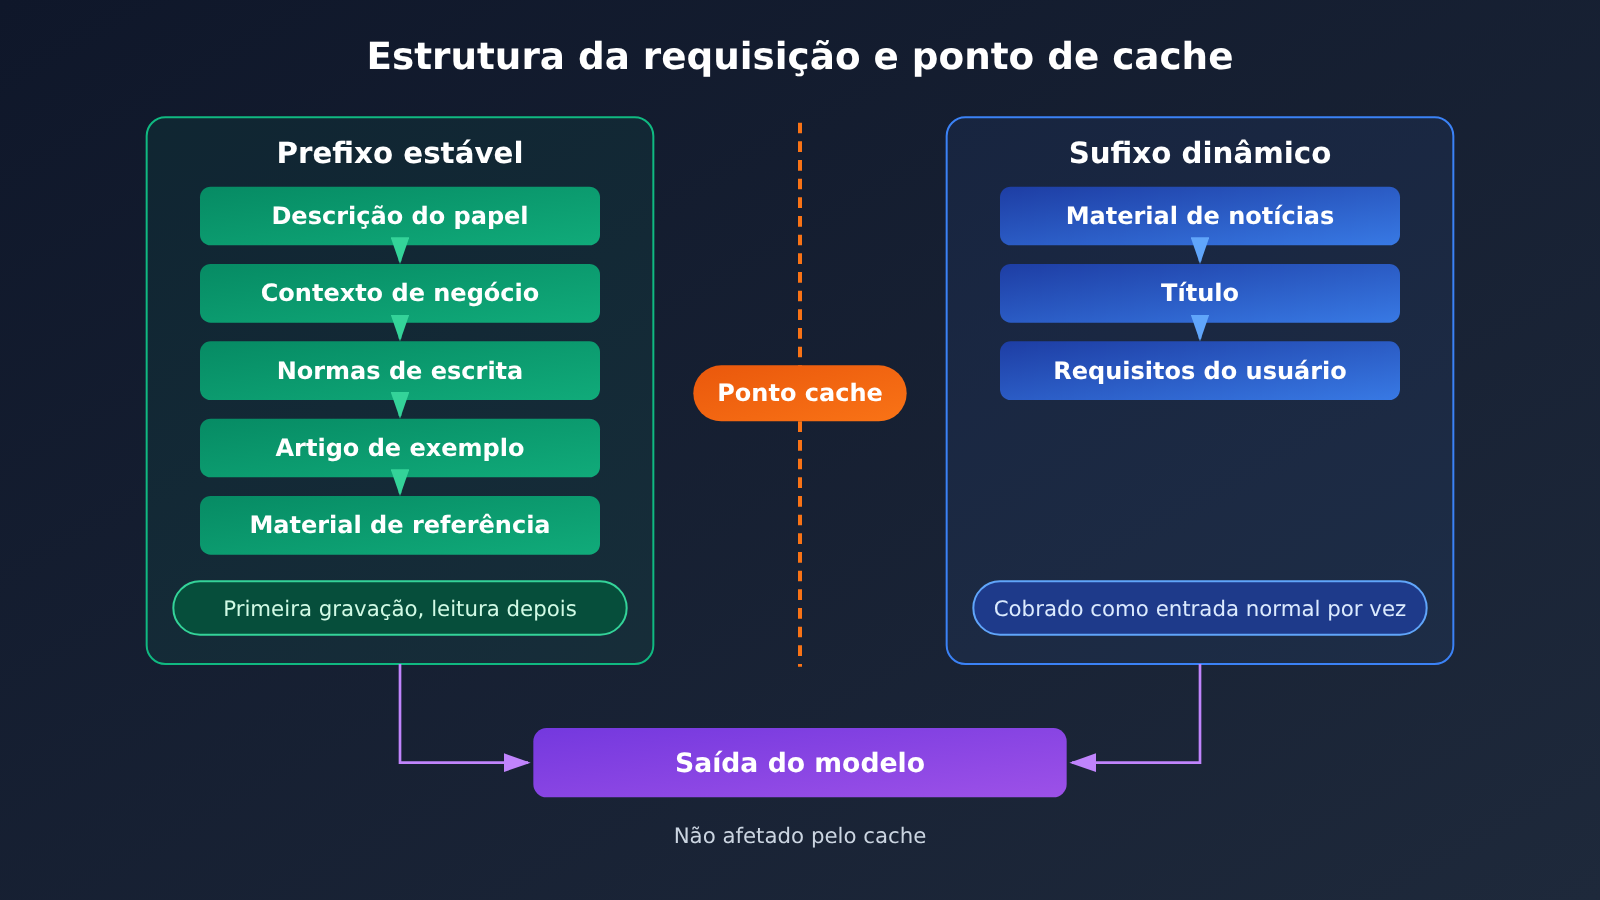
Tome como exemplo uma plataforma de escrita com IA. A cada artigo gerado, a requisição é composta de duas partes. A primeira é conteúdo fixo: descrição do papel, contexto de negócio, regras de escrita, artigos de exemplo, terminologia e materiais de referência. A segunda é conteúdo dinâmico: o material de notícias do dia, o título do artigo e as exigências específicas do usuário.
O Prompt Caching reutiliza a primeira parte, ou seja, o prefixo idêntico token a token. A correspondência de cache exige que a sequência de tokens seja exatamente igual; semelhança semântica não conta como acerto. Alterar uma palavra, mudar a ordem dos parágrafos ou reordenar a definição de ferramentas pode fazer o prefixo virar conteúdo novo, e o cache deixa de valer.
Por isso, há um princípio básico para otimizar cache: conteúdo estável na frente, conteúdo variável depois.
1.2 Que parte do custo o Prompt Caching economiza
A conta de uma chamada pode ser dividida em cinco itens, e apenas o custo do prefixo fixo muda com o cache:
| Item de custo | Sem cache | Com cache ativado |
|---|---|---|
| Prefixo fixo | Cobrado como entrada comum a cada chamada | Primeira vez pelo preço de escrita; depois, pelo preço de leitura a cada acerto |
| Entrada dinâmica | Preço de entrada comum | Preço de entrada comum, sem alteração |
| Saída do modelo | Preço de saída | Preço de saída, sem alteração |
| Custo de ferramentas | Conforme as regras da ferramenta | Conforme as regras da ferramenta, sem alteração |
| Armazenamento em cache explícito (Gemini) | Nenhum | Cobrado à parte conforme o tempo de armazenamento |
Esta tabela mostra uma diferença crucial: taxa de economia do prefixo fixo e taxa de economia da conta completa são duas métricas. A primeira mede apenas a redução da parte armazenada em cache; a segunda mede a redução da conta inteira. Quanto mais longa a saída, menor é a segunda taxa.
2 Qual é a diferença entre as regras de cache de prompt do GPT, Claude e Gemini?
2.1 Cache de prompt da OpenAI: 30m e 12h
A documentação da OpenAI especifica, para o GPT-5.6 e modelos posteriores, que o comprimento mínimo do prefixo de cache normalmente é de 1,024 tokens de entrada visíveis, com suporte aos modos implícito (implicit) e explícito (explicit). No modo explícito, o desenvolvedor marca prompt_cache_breakpoint no bloco de conteúdo de mensagem apropriado, delimitando claramente a fronteira do prefixo de cache.
O TTL padrão é de 30 minutos, e a Responses API permite definir um tempo de vida mínimo de 12 horas por meio de prompt_cache_options.ttl = "12h". A cobrança é dividida entre gravação e leitura:
- Gravação de 30 minutos: 1.25 vezes o valor da entrada normal
- Gravação de 12 horas: 2.5 vezes o valor da entrada normal
- Leitura do cache: 0.1 vezes o valor da entrada normal na maioria dos modelos novos; 0.05 vezes para GPT-6.1 Sol e GPT-6.1 Terra
O prompt_cache_key pode ser usado para separar a cobrança de cache de diferentes usuários ou workspaces. No GPT-5.6 e nos modelos posteriores, o roteamento de cache já é gerenciado automaticamente pela OpenAI.
2.2 Claude Prompt Caching: 5m e 1h
O Claude oferece suporte a cache automático ou explícito por meio de cache_control. O tempo de validade padrão é de 5 minutos, e cada acerto (hit) renovar a validade. Os 5 minutos são contados a partir do início da requisição de escrita ou leitura do cache, e o tempo gasto para gerar a resposta também entra nessa conta. Por isso, em tarefas com saídas longas, o intervalo realmente disponível é menor que 5 minutos.
Os multiplicadores de cobrança são: escrita de 5 minutos 1,25x, escrita de 1 hora 2x, leitura normal 0,1x. Claude Sonnet 5.5 e Claude Opus 5.5 têm a tarifa de leitura reduzida para 0,05x. O preço unitário padrão do Sonnet 5.5 é: entrada US$ 2, escrita de 5 minutos US$ 2,50, escrita de 1 hora US$ 4, leitura US$ 0,10, saída US$ 10 (todos em dólares por milhão de tokens).
2.3 Gemini Context Caching: implícito e explícito
O Gemini 2.5 e os modelos mais recentes habilitam o cache implícito por padrão, sem necessidade de configuração adicional. O requisito mínimo de entrada varia conforme o modelo: Gemini 3.8 Flash é 4.096 tokens, Gemini 2.5 Flash e 2.5 Pro são 2.048 tokens. O Google recomenda colocar o conteúdo compartilhado no início do comando e reutilizar o mesmo prefixo em um intervalo de tempo curto.
O cache explícito exige que o desenvolvedor crie ativamente um objeto de cache e defina o tempo de vida (TTL). O custo inclui três partes: o conteúdo em cache, as leituras subsequentes e o tempo de armazenamento. A API Gemini Interactions atualmente só suporta cache implícito; quando precisar de objetos de cache explícitos, use a API generateContent.
Os preços do Gemini 3.8 Flash até 31 de dezembro de 2026 são: entrada US$ 0,75, saída US$ 3,75, leitura de cache US$ 0,075, armazenamento de cache explícito US$ 0,50 / milhão de tokens / hora. A empresa planeja reajustar, a partir de 1º de janeiro de 2027, para US$ 1,50, US$ 7,50, US$ 0,15 e US$ 1,00. Os quatro preços dobram na mesma proporção, portanto as proporções de economia calculadas abaixo permanecem as mesmas, com os valores absolutos dobrados.
2.4 Comparação das regras de Prompt Caching dos três fornecedores
| Dimensão | OpenAI | Claude | Gemini |
|---|---|---|---|
| Modo de cache | Implícito / breakpoint explícito | cache_control automático / explícito |
Implícito (padrão) / objeto de cache explícito |
| TTL padrão | 30 minutos (tempo mínimo de vida) | 5 minutos, renovados a cada acerto | O implícito é gerenciado pelo sistema; o explícito tem duração definida por você |
| Opção de TTL longo | 12 horas (Responses API) | 1 hora | Cache explícito personalizado |
| Tarifa de escrita | 30m: 1,25x; 12h: 2,5x | 5m: 1,25x; 1h: 2x | No implícito, a primeira gravação é cobrada como entrada normal |
| Tarifa de leitura | 0,1x (0,05x no Sol / Terra) | 0,1x (0,05x no Sonnet / Opus 5.5) | 3.8 Flash: US$ 0,075 / MTok |
| Custos adicionais | Sem taxa de armazenamento | Sem taxa de armazenamento | O cache explícito cobra armazenamento por hora |
| Prefixo mínimo | Normalmente 1.024 tokens | Conforme a documentação oficial | 3.8 Flash: 4.096 tokens |
3 Se você faz 100 chamadas por dia, quanto o Prompt Caching realmente economiza?
3.1 Condições de cálculo unificadas
Os valores abaixo são cálculos teóricos baseados nos preços oficiais por unidade, e não faturas reais de usuários. As premissas são as mesmas para todos os casos:
- Prefixo fixo de 20,000 Tokens por chamada, entrada dinâmica de 500 Tokens e saída de 1,000 Tokens
- 100 chamadas por dia, sempre usando o mesmo modelo
- Todo o conteúdo dinâmico fica após o prefixo estável
- Cenário com cache: a 1ª chamada grava o cache e as 99 seguintes acertam o cache integralmente; todas as chamadas acontecem dentro do TTL, ou o tempo de validade é renovado continuamente a cada acerto
- Sem considerar markup de terceiros, descontos por volume ou custos de ferramentas
- O prefixo de 20K não dispara a cobrança adicional de contexto longo do GPT-6 Astra, aplicada quando se ultrapassa 272K Tokens
A fórmula de cálculo é a mesma em todos os casos:
Custo de um item = número de Tokens × número de chamadas ÷ 1,000,000 × preço unitário (USD / MTok)
Custo do prefixo com cache = 20,000 × 1 ÷ 1,000,000 × preço de gravação + 20,000 × 99 ÷ 1,000,000 × preço de leitura
3.2 A fórmula completa do GPT-6 Astra
Preços do GPT-6 Astra: entrada normal $10, saída $50, gravação de cache de 30 minutos $12.50, leitura de cache $1.
Sem cache:
- Prefixo fixo: 20,000 × 100 ÷ 1,000,000 × $10 = $20
- Entrada dinâmica: 500 × 100 ÷ 1,000,000 × $10 = $0.50
- Saída: 1,000 × 100 ÷ 1,000,000 × $50 = $5
- Total diário: $25.50
Com cache de 30 minutos:
- Primeira gravação: 20,000 ÷ 1,000,000 × $12.50 = $0.25
- 99 leituras: 20,000 × 99 ÷ 1,000,000 × $1 = $1.98
- Entrada dinâmica: $0.50; saída: $5
- Total diário: $7.73
A fatura completa economiza $17.77, cerca de 69.69%. O prefixo fixo cai de $20 para $2.23, uma economia de aproximadamente 88.85%.
3.3 GPT-6.1 Sol, Claude Sonnet 5.5 e Gemini 3.8 Flash
GPT-6.1 Sol (entrada $2, saída $10, gravação de 30 minutos $2.50, leitura $0.10):
- Sem cache: prefixo $4 + entrada dinâmica $0.10 + saída $1 = $5.10
- Com cache: gravação $0.05 + leitura $0.198 + entrada dinâmica $0.10 + saída $1 = $1.348
- Economia de $3.752, cerca de 73.57%; o prefixo cai de $4 para $0.248, uma economia de aproximadamente 93.8%
Claude Sonnet 5.5 (cache de 5 minutos) tem o mesmo preço unitário do GPT-6.1 Sol, e o processo de cálculo e o resultado também são iguais: de $5.10 para $1.348. O pré-requisito é que o intervalo entre chamadas consiga manter continuamente a validade de 5 minutos.
Gemini 3.8 Flash (cache implícito, na primeira vez cobrado como entrada normal de $0.75):
- Sem cache: prefixo $1.50 + entrada dinâmica $0.0375 + saída $0.375 = $1.9125
- Com cache: prefixo da primeira vez $0.015 + 99 leituras $0.1485 + entrada dinâmica $0.0375 + saída $0.375 = $0.576
- Economia de $1.3365, cerca de 69.88%; o prefixo cai de $1.50 para $0.1635, uma economia de aproximadamente 89.1%
- Este resultado assume que o cache implícito seja totalmente acertado e não inclui a taxa de armazenamento do cache explícito
3.4 Diferença entre percentual de economia e valor absoluto do Prompt Caching
| Modelo | Sem cache / dia | Com cache / dia | Economia diária | Economia em 30 dias (extrapolada) | Taxa de economia do prefixo | Taxa de economia da fatura completa |
|---|---|---|---|---|---|---|
| GPT-6 Astra | $25.50 | $7.73 | $17.77 | $533.10 | 88.85% | 69.69% |
| GPT-6.1 Sol | $5.10 | $1.348 | $3.752 | $112.56 | 93.8% | 73.57% |
| Claude Sonnet 5.5 | $5.10 | $1.348 | $3.752 | $112.56 | 93.8% | 73.57% |
| Gemini 3.8 Flash | $1.9125 | $0.576 | $1.3365 | $40.10 | 89.1% | 69.88% |
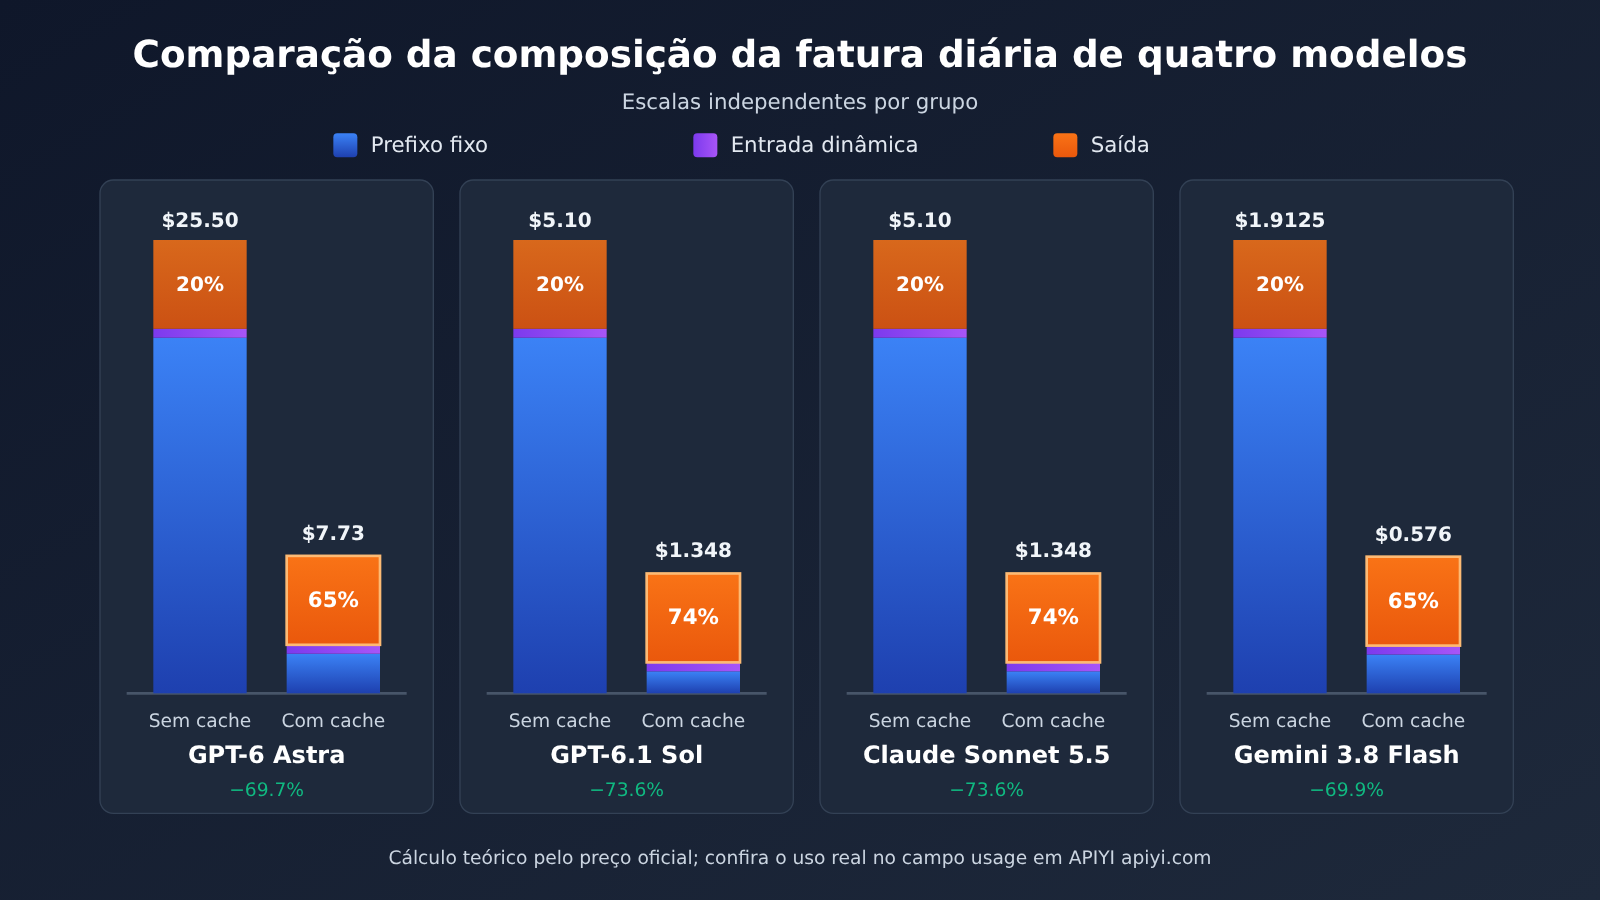
Do quadro podemos extrair dois pontos:
- O percentual olha para o desconto de leitura. O preço de leitura do GPT-6.1 Sol e do Claude Sonnet 5.5 é 0.05 vez o da entrada normal, e a taxa de economia do prefixo chega a 93.8%, acima do Astra e do Gemini, cuja leitura é 0.1 vez.
- O valor olha para a base do preço unitário. O Astra tem a menor taxa de economia percentual, mas economiza $17.77 por dia — mais de 13 vezes o que o Gemini 3.8 Flash economiza. Quanto maior o preço unitário do modelo, maior o ganho absoluto ao ativar o cache.
Após o cache, a participação da saída na fatura do GPT-6 Astra sobe de cerca de 20% para cerca de 65% ($5 ÷ $7.73). Nesse momento, o foco para reduzir custos ainda mais passa a ser o controle do comprimento da saída. Vale notar que os quatro modelos usam a mesma quantidade de Tokens apenas para facilitar a comparação. Ao concluir a mesma tarefa, o comprimento real da saída e a taxa de acerto variam entre os modelos.
💡 Sugestão de seleção de modelo: quando as proporções forem parecidas, priorize o equilíbrio entre a economia absoluta diária e a qualidade da tarefa. Uma boa prática é primeiro chamar alguns modelos candidatos em APIYI apiyi.com usando o mesmo template, registrar o comprimento real de saída e os Tokens em cache, e só então aplicar a fórmula acima para estimar o orçamento mensal.
4 Por que repetir o mesmo prompt todos os dias ainda pode gerar uma fatura alta de Prompt Caching?
4.1 O TTL e a frequência de invocação determinam a taxa de acerto no cache
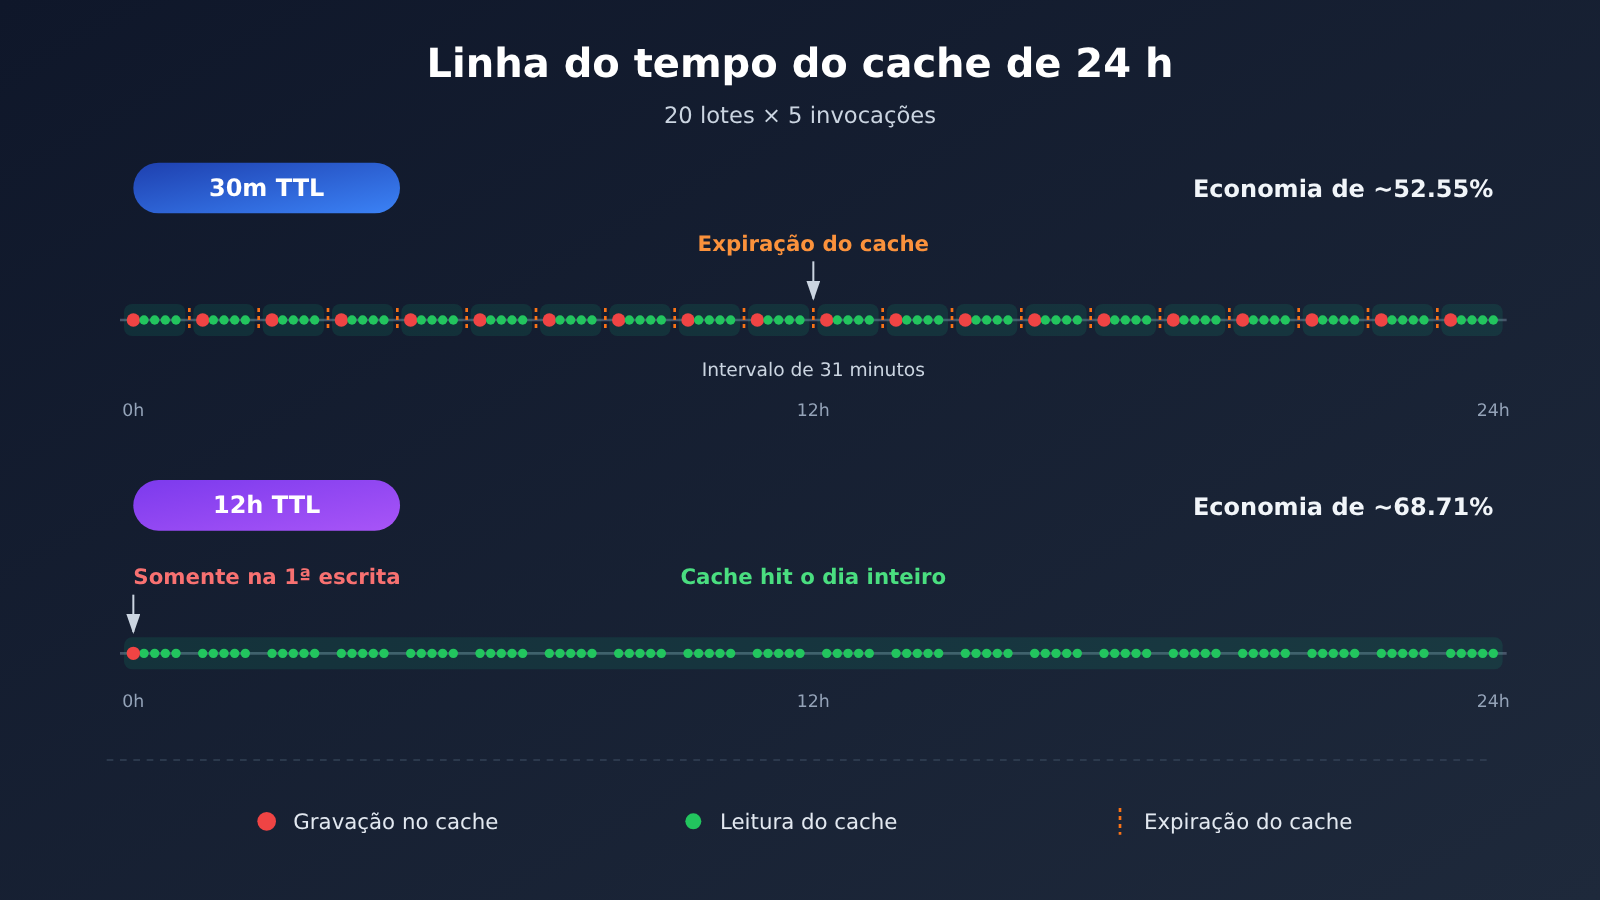
Chamar 100 vezes por dia não significa que uma única gravação cubra o dia inteiro. Vejamos o GPT-6 Astra como exemplo: 20 lotes por dia, com 5 chamadas consecutivas em cada lote e um intervalo de 31 minutos entre os lotes.
| Cenário | Gravações e custo | Leituras e custo | Custo do prefixo | Mais entrada dinâmica e saída | Total diário | Taxa de economia |
|---|---|---|---|---|---|---|
| Sem cache | — | — | $20 | $5.50 | $25.50 | — |
| A: cache de 30m | 20 × $0.25 = $5 | 80 × $0.02 = $1.60 | $6.60 | $5.50 | $12.10 | cerca de 52.55% |
| B: cache de 12h (na mesma janela) | 1 × $0.50 | 99 × $0.02 = $1.98 | $2.48 | $5.50 | $7.98 | cerca de 68.71% |
No cenário A, o intervalo entre os lotes ultrapassa 30 minutos, então cada lote precisa ser gravado novamente; a taxa de economia cai dos 69.69% ideais para 52.55%. No cenário B, o preço de uma gravação é o dobro do de 30m, mas só se grava uma vez por dia, o que torna a opção mais vantajosa para chamadas dispersas. A solução de 12h cobre apenas a mesma janela; não há garantia de que o mesmo cache possa ser reutilizado no dia seguinte. Para tarefas chamadas apenas uma ou duas vezes por dia, não é possível obter cache entre dias apenas com o mesmo prompt.
O ponto de equilíbrio para os diferentes TTLs pode considerar apenas o prefixo estável, tomando a entrada comum como 1 vez:
| Solução | Multiplicador de gravação | Multiplicador de leitura | Gravar 1 + ler 1 vs sem cache 2 vezes | Gravar 1 + ler 2 vs sem cache 3 vezes | Leituras efetivas necessárias para recuperar o custo |
|---|---|---|---|---|---|
| OpenAI 30m | 1.25 | 0.1 | 1.35 < 2 | — | 1 vez |
| OpenAI 12h | 2.5 | 0.1 | 2.6 > 2 | 2.7 < 3 | 2 vezes |
| Claude Sonnet 5.5 · 5m | 1.25 | 0.05 | 1.30 < 2 | — | 1 vez |
| Claude Sonnet 5.5 · 1h | 2 | 0.05 | 2.05 > 2 | 2.10 < 3 | 2 vezes |
A conclusão é direta: um TTL curto se paga com apenas um acerto no cache; um TTL longo precisa de pelo menos dois acertos dentro do período de validade.
4.2 Pontos de quebra de cache e ordem do comando
A causa mais comum de invalidação é a alteração de um prefixo estável. Colocar timestamp, ID de usuário, título da tarefa ou materiais em tempo real no início do comando faz com que o prefixo de cada requisição se torne conteúdo novo, e o cache nunca consegue acertar.
No modo implícito da OpenAI, se a primeira requisição incluir conteúdo dinâmico dentro do escopo de cache, assim que o conteúdo dinâmico mudar, pode ser que não se acerte o prefixo estável esperado. A solução é definir um ponto de quebra de cache explícito no final do conteúdo estável.
Outras causas comuns incluem:
- Troca de modelo, fornecedor, organização de serviço, ou modificação de parte dos parâmetros
- O Agent faz compactação de conversa, reorganiza definições de ferramentas, modifica mensagens históricas, fazendo com que o prefixo reutilizável seja reescrito
- O gateway de terceiros não repassa os parâmetros de cache, ou não desconta o desconto de cache na fatura
4.3 Impacto dos tokens de saída e dos custos de ferramentas
O cache atua apenas sobre o prefixo de entrada. No exemplo de cálculo da Astra em 3.2, mesmo que o custo do prefixo caia a zero, a fatura não ficará abaixo de $5.50 (entrada dinâmica mais saída). Em tarefas com saídas longas e muitas invocações de ferramentas, a redução da fatura total será claramente menor do que a taxa de economia de prefixo. Portanto, depois de ativar o cache, ainda é preciso controlar o comprimento da saída e enxugar as invocações de ferramentas.
5 Como configurar e monitorar o Prompt Caching em aplicações de IA?
5.1 Método de organização de prefixo estável e sufixo dinâmico
Organize o conteúdo na ordem de “frequência de mudança do menor para o maior”:
- Definições de ferramentas: mantenha a ordem e as descrições fixas, não adicione ou remova dinamicamente a cada requisição
- Regras do sistema e normas de escrita: descrição de persona, normas de marca, requisitos de estilo
- Exemplos e base de conhecimento: grandes blocos de documentos de referência, substituídos integralmente quando a versão é atualizada
- (ponto de cache)
- Materiais dinâmicos: notícias do dia, resultados de busca, entrada do usuário
- Instruções da tarefa atual: título, número de caracteres, requisitos específicos
O exemplo a seguir faz uma chamada através da interface compatível com OpenAI e lê os tokens de cache na resposta:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # interface compatível com OpenAI do APIYI
)

STABLE_PREFIX = """Você é um autor de blog técnico... (normas de escrita, exemplos, glossário, cerca de 20K tokens, conteúdo fixo palavra por palavra)"""

resp = client.chat.completions.create(
    model="gpt-6.1-sol",  # use o nome real da lista de modelos da plataforma
    messages=[
        {"role": "system", "content": STABLE_PREFIX},          # prefixo estável no início
        {"role": "user", "content": "Materiais de hoje: ...\nTítulo: ..."},  # conteúdo dinâmico depois
    ],
)
details = getattr(resp.usage, "prompt_tokens_details", None)
cached = getattr(details, "cached_tokens", 0) or 0
print(f"entrada {resp.usage.prompt_tokens}, cache hit {cached}")
Ver código completo: calculadora de custos + estatísticas de taxa de acerto
from openai import OpenAI

M = 1_000_000

def daily_cost(prefix, dynamic, output, calls,
               p_in, p_out, p_write, p_read,
               writes=1, use_cache=True):
    """Calcula o custo diário em dólares com base no preço unitário oficial; retorna (prefixo, entrada dinâmica, saída, total)"""
    dyn = dynamic * calls / M * p_in
    out = output * calls / M * p_out
    if use_cache:
        pre = prefix * writes / M * p_write + prefix * (calls - writes) / M * p_read
    else:
        pre = prefix * calls / M * p_in
    return round(pre, 4), round(dyn, 4), round(out, 4), round(pre + dyn + out, 4)

MODELS = {
    # nome: (entrada, saída, escrita, leitura)  dólares / milhão de tokens, verificado em 2026-11-13
    "GPT-6 Astra (30m)":   (10,   50,   12.5, 1),
    "GPT-6.1 Sol (30m)":   (2,    10,   2.5,  0.10),
    "Claude Sonnet 5.5":   (2,    10,   2.5,  0.10),
    "Gemini 3.8 Flash":    (0.75, 3.75, 0.75, 0.075),  # cache implícito: a primeira vez é cobrada como entrada comum
}

for name, (p_in, p_out, p_w, p_r) in MODELS.items():
    base = daily_cost(20000, 500, 1000, 100, p_in, p_out, p_w, p_r, use_cache=False)[-1]
    cached = daily_cost(20000, 500, 1000, 100, p_in, p_out, p_w, p_r)[-1]
    print(f"{name}: ${base} -> ${cached}, economia de {(base - cached) / base:.2%}")

# Cenário A: Astra 30m, 20 lotes, cada um exigindo nova escrita
a = daily_cost(20000, 500, 1000, 100, 10, 50, 12.5, 1, writes=20)[-1]
print(f"Astra em lotes de 30m: ${a}")  # 12.1

# ---- Estatísticas de taxa de acerto em produção ----
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

def run_and_track(stable_prefix, dynamic_inputs, model="gpt-6.1-sol"):
    total_in = total_cached = 0
    for text in dynamic_inputs:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "system", "content": stable_prefix},
                      {"role": "user", "content": text}],
        )
        d = getattr(r.usage, "prompt_tokens_details", None)
        total_in += r.usage.prompt_tokens
        total_cached += (getattr(d, "cached_tokens", 0) or 0)
    hit = total_cached / total_in if total_in else 0
    print(f"Taxa de acerto real do cache: {hit:.2%}")
    return hit
🚀 Dica para começar rápido: primeiro use a calculadora acima para estimar o orçamento e depois rode de 10 a 20 chamadas com seu template real, verificando se o
cached_tokenspassa a aparecer de forma estável já a partir da segunda chamada. Novos usuários podem resgatar créditos de teste gratuitos em APIYI apiyi.com para fazer essa verificação; depois de confirmar que o cache está acertando, é só aumentar o volume.
5.2 Escolhendo o TTL do Prompt Caching e o modo de cache
- Chamadas consecutivas em alta frequência (intervalos estáveis na casa de poucos minutos): use o TTL curto padrão, ou seja, 30m na OpenAI e 5m no Claude. Um único acerto já paga o custo, e o prêmio de gravação é o mais baixo. No Claude, é preciso contabilizar o tempo de geração da resposta dentro da janela de 5 minutos.
- Chamadas dispersas ao longo do dia (intervalos entre lotes superiores a 30 minutos): avalie o TTL de 12h da OpenAI ou o de 1h do Claude. Desde que você consiga dois ou mais acertos dentro da janela, o TTL longo sai mais barato do que reescrever o cache repetidamente — o cenário B da seção 4.1 é justamente uma prova disso.
- Tarefas no Gemini com prefixo muito longo e que precisam ser reutilizadas por períodos mais extensos: avalie o cache explícito e inclua a tarifa de armazenamento na conta. Tomando o Gemini 3.8 Flash como exemplo, armazenar 20K tokens por 12 horas custa 0.02 × $0.50 × 12 = $0.12. Na carga de trabalho deste artigo, esse valor já é bastante significativo em relação à fatura diária de $0.576. Se o cache implícito estiver acertando bem, mantenha o padrão.
- Prefixo que muda com frequência: primeiro estabilize o prefixo, depois pense no TTL. Com um prefixo instável, nenhum TTL vai render acertos.
5.3 Verificando a taxa real de acerto e a fatura do Prompt Caching
Os campos de usage das três plataformas são:
- OpenAI (Responses API):
usage.input_tokens,usage.input_tokens_details.cached_tokens,usage.input_tokens_details.cache_write_tokens - Claude:
usage.input_tokens,usage.cache_creation_input_tokens,usage.cache_read_input_tokens - Gemini: os campos de usage da API correspondente, como
total_cached_tokens; o cache explícito é cobrado à parte como armazenamento de objetos
Vale acompanhar dois indicadores continuamente:
Taxa real de acerto do cache = Tokens lidos do cache ÷ Total de tokens de entrada
Economia real               = Custo base sem cache − Custo real da fatura de API
O custo base sem cache precisa ser calculado com o mesmo modelo, a mesma carga de trabalho e o mesmo volume de saída; caso contrário, a economia não terá base de comparação. Ao conferir a fatura no console do APIYI apiyi.com, você pode confrontar item a item o resumo de usage do mesmo período com o detalhamento das cobranças, confirmando que os tokens de cache são cobrados pelo preço de cache.
6 Cenário APIYI: como controlar custos com Prompt Caching em templates fixos e produção em lote de IA?
Casos de uso típicos para Prompt Caching (cache de prompt): plataformas de escrita com IA que rodam o mesmo template de artigo todo dia, Agents que recarregam repetidamente a mesma definição de ferramentas, sistemas de análise de documentos que citam várias vezes o mesmo documento de referência grande e geração de conteúdo em lote que compartilha diretrizes de marca e estilo. Todos esses têm um ponto em comum: prefixo longo, taxa de repetição alta, volume de chamadas grande — exatamente a faixa em que o ganho do cache é maior.
Para tomar decisões de custo nesse tipo de cenário, dá para julgar por três critérios:
- O modelo suporta a capacidade de cache necessária? Isso inclui comprimento mínimo de prefixo, TTL opcional e multiplicador de desconto na leitura. Modelos com leitura a 0,05x entregam uma taxa de economia de prefixo maior em tarefas com prefixo longo.
- O comando e o TTL combinam com a carga de trabalho? Processamento em lote contínuo pede TTL curto; tarefas distribuídas por agendamento devem avaliar TTL longo, calculando pela fórmula da seção 4.1 quantas reutilizações são necessárias para o custo se pagar.
- O fornecedor de API suporta o cache de ponta a ponta e cobra conforme o custo real de cache? O suporte a cache no upstream é apenas uma das condições necessárias para reduzir custo. O gateway também precisa repassar corretamente os parâmetros de cache, reportar os Tokens de cache em
usagee refletir o preço do cache na cobrança.
Ao chamar via APIYI apiyi.com, sugiro transformar o item 3 em um passo de aceitação fixo: use o mesmo template de 20K para chamar várias vezes seguidas, verifique os campos de cache em usage e depois confira com a cobrança da fatura. Só depois de confirmar tanto o acerto técnico quanto a cobrança efetiva, use o resultado dos cálculos acima como base para o orçamento mensal.
Perguntas Frequentes (FAQ)
Q1: O que é o Prompt Caching?
Ele armazena em cache o mesmo prefixo já processado do comando; quando uma solicitação posterior o reutiliza, a cobrança é muito menor do que a de uma entrada normal. A correspondência exige que os tokens sejam exatamente iguais, por isso é adequado para cenários como templates fixos, bases de conhecimento fixas e definições de ferramentas fixas.
Q2: Por que o prefixo economiza mais de 90%, mas a fatura total só economiza cerca de 70%?
O cache só se aplica ao prefixo fixo; entradas dinâmicas e saídas continuam sendo cobradas pelo preço normal. No caso do GPT-6.1 Sol, em uma fatura diária de $1.348 após o cache, a saída representa $1 e a entrada dinâmica representa $0.10. Quanto mais longa a saída, menor a taxa de economia na fatura completa.
Q3: Se eu fizer apenas uma ou duas chamadas por dia, vale a pena ativar o cache?
O ganho é muito pequeno. Tanto o cache de 12h da OpenAI quanto o de 1h da Claude exigem pelo menos dois acertos dentro do período de validade para se pagarem; não há garantia de reutilização entre dias. Uma abordagem mais eficaz é concentrar tarefas do mesmo tipo e executá-las em lote no mesmo período, aumentando o número de acertos dentro da janela.
Q4: Escolher 30m ou 12h?
Depende do intervalo entre chamadas. Se o intervalo se mantiver estável em até 30 minutos, use 30m: um único acerto já paga o custo. Se os lotes tiverem intervalos mais longos e forem distribuídos ao longo do dia, use 12h. No caso do GPT-6 Astra com chamadas divididas em 20 lotes, o custo diário com 12h é $7.98, e com 30m é $12.10.
Q5: Ao chamar por uma plataforma agregadora de APIs, o cache ainda funciona?
Isso depende de como a plataforma repassa os parâmetros de cache e implementa a cobrança. Recomendo usar a cota gratuita de testes na APIYI (apiyi.com) para chamar repetidamente o mesmo template, verificar campos como `cached_tokens` no usage e comparar com os detalhes de cobrança. Só use em lote depois de confirmar que o cache está acertando e que a cobrança é feita pelo preço de cache.
Q6: Se a taxa de acertos do cache cair de repente, por onde começar a investigar?
Verifique na seguinte ordem: se o prefixo contém conteúdo dinâmico, como timestamps e IDs; se a ordem das definições de ferramentas mudou; se o Agent comprimiu ou reescreveu mensagens do histórico; se o modelo ou os parâmetros foram trocados; e se o intervalo entre chamadas ultrapassou o TTL. Use a fórmula de taxa de acertos da seção 5.3 para calcular por hora; assim, é mais rápido localizar o momento em que a mudança ocorreu.
Q7: Como escolher entre cache implícito e cache explícito no Gemini?
O cache implícito vem ativado por padrão, não tem taxa de armazenamento e é priorizado quando o prefixo excede o comprimento mínimo do modelo (4,096 tokens para o 3.8 Flash). O cache explícito é indicado para conteúdos muito longos que exigem reutilização determinística, mas exige o pagamento de uma taxa de armazenamento por hora e o uso da API generateContent. A API Interactions atualmente só suporta cache implícito.
Resumo
Pontos-chave do Prompt Caching:
- Onde se economiza: reduz apenas o custo do prefixo fixo. Nesta carga de trabalho, a taxa de economia no prefixo foi de 88,85% a 93,8%, e a economia na fatura completa ficou entre 69,69% e 73,57%.
- Quanto se economiza: GPT-6.1 Sol e Claude Sonnet 5.5 caem de $5,10 para $1,348 por dia, e GPT-6 Astra de $25,50 para $7,73. Quanto maior o preço unitário, maior a economia absoluta.
- Com que frequência vale mais a pena: chamadas de alta frequência, contínuas e com prefixo longo. Com TTL curto, basta 1 acerto para empatar o custo; com TTL longo, são necessários 2 acertos.
- Como colocar em prática: conteúdo estável na frente, conteúdo dinâmico depois, e definir o ponto de quebra (breakpoint) ao final do conteúdo estável; escolher o TTL conforme o ritmo das chamadas; monitorar continuamente a taxa de acerto pelos campos de
usage. - Premissa para funcionar: o cache precisa acertar tecnicamente e também ser cobrado pelo preço de cache na fatura.
A sugestão é primeiro usar a calculadora descrita no artigo para estimar o orçamento, depois validar a taxa de acerto e a cobrança no APIYI apiyi.com com seus templates reais, e só aumentar o volume depois de confirmar os dois pontos.
📚 Referências
- Guia de Prompt Caching da OpenAI: modos de cache, breakpoints, TTL e multiplicadores de cobrança
- Link:
developers.openai.com/api/docs/guides/prompt-caching -
Descrição: explicação dos parâmetros
prompt_cache_optionseprompt_cache_breakpoint -
Modelos e preços da OpenAI: preço unitário de GPT-6 Astra e GPT-6.1 Sol
- Link:
developers.openai.com/api/docs/pricing - Link:
developers.openai.com/api/docs/models/gpt-6-astra - Link:
developers.openai.com/api/docs/models/gpt-6.1-sol -
Descrição: tarifas padrão de contexto curto, data de verificação 2026-11-13
-
Documentação de Prompt Caching da Claude:
cache_control, multiplicadores de escrita e leitura de 5m / 1h - Link:
platform.claude.com/docs/en/build-with-claude/prompt-caching - Link:
platform.claude.com/docs/en/models/sonnet-5-5/overview -
Descrição: leitura de cache do Sonnet 5.5 com multiplicador de 0,05
-
Cache de Contexto e preços do Gemini: cache implícito / explícito, taxa de armazenamento e reajuste de 2027
- Link:
ai.google.dev/gemini-api/docs/caching - Link:
ai.google.dev/gemini-api/docs/pricing - Descrição: comprimento mínimo de cache por modelo e abrangência de suporte da API
Autor: Time técnico da APIYI
Contato técnico: fale conosco pela página inicial do site oficial do APIYI; mais materiais de integração estão disponíveis no centro de documentação docs.apiyi.com


