
Ringkasan: Artikel ini menggunakan satu set beban kerja yang sama untuk menghitung biaya Prompt Caching pada empat bagian: penulisan cache, pembacaan cache, input dinamis, dan output, sekaligus menjelaskan bagaimana tingkat hit, TTL, dan ritme pemanggilan memengaruhi penghematan aktual.
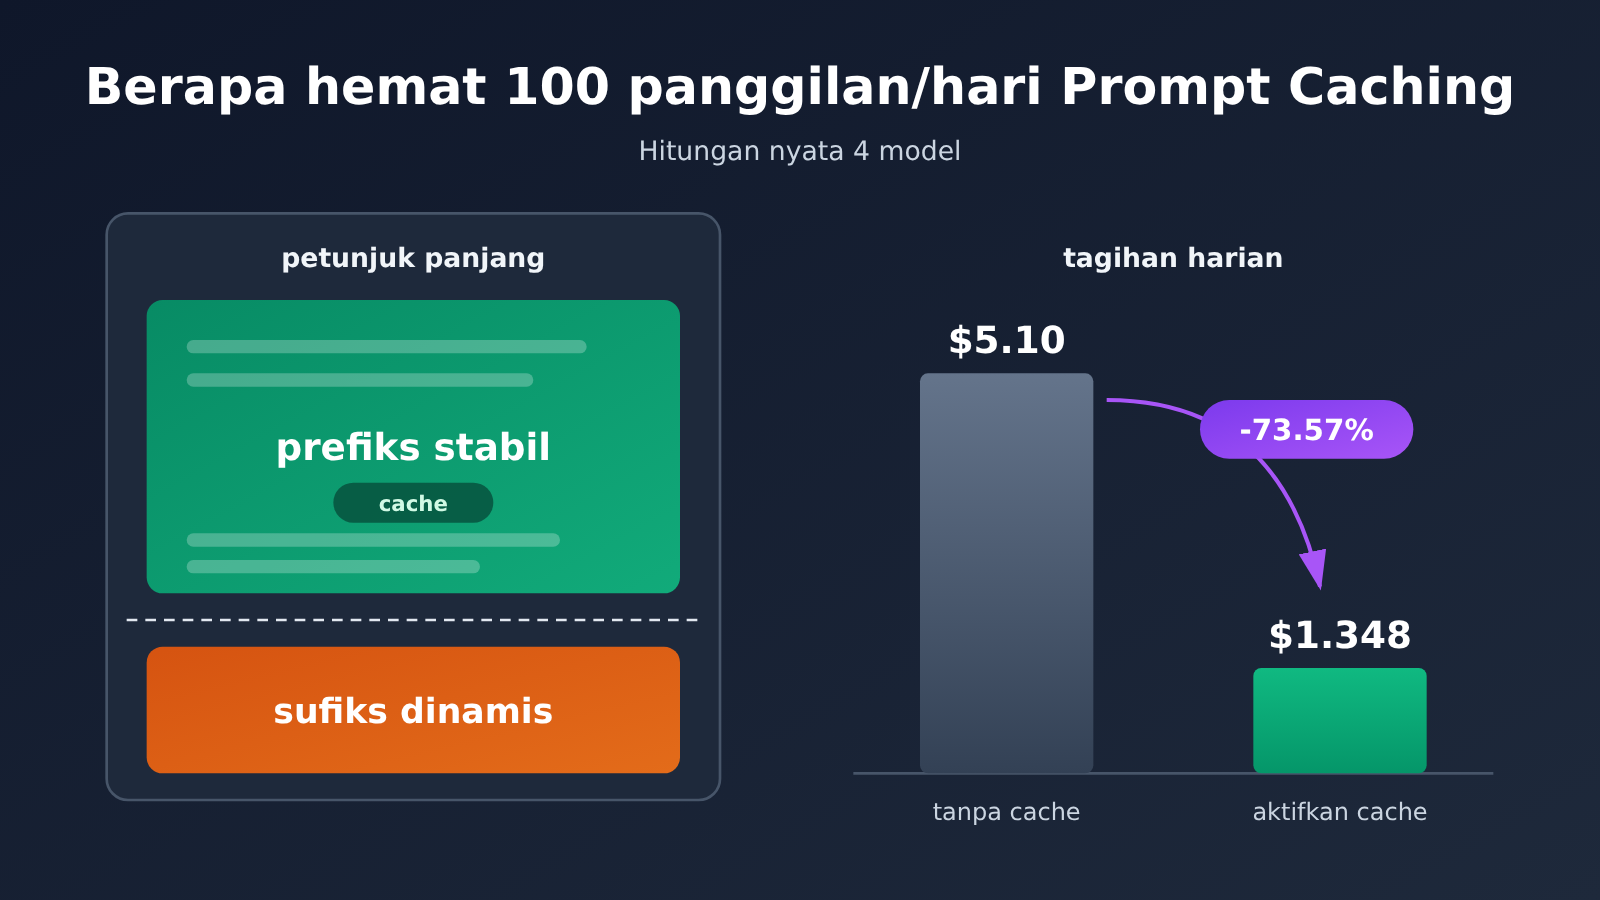
Kesimpulan: Beban kerja yang ditetapkan dalam artikel ini adalah prefiks tetap 20K Token per panggilan, input dinamis 500 Token, dan output 1K Token, dengan 100 panggilan per hari. Dalam kondisi ideal “penulisan pertama, lalu 99 panggilan berikutnya semuanya hit cache”, tagihan harian penuh GPT-6.1 Sol turun dari $5.10 menjadi $1.348, penurunan sekitar 73.57%. Hasil Claude Sonnet 5.5 sama; GPT-6 Astra turun dari $25.50 menjadi $7.73, penurunan sekitar 69.69%; Gemini 3.8 Flash turun dari $1.9125 menjadi $0.576, penurunan sekitar 69.88%. Jika hanya melihat pos prefiks tetap, proporsi penghematan berada di antara 88% dan 94%. Penurunan tagihan penuh lebih rendah karena Token output dan input dinamis tidak mendapat diskon cache. Angka di atas adalah perhitungan anggaran berdasarkan harga satuan resmi, bukan tagihan sebenarnya. Harga secara konsisten menggunakan tarif standar konteks pendek, dengan tanggal verifikasi 2026-11-13.
Pratinjau Konten: Bagian 1 menjelaskan segmen mana dalam permintaan yang digunakan ulang oleh cache, dan bagian mana dari tagihan yang terpengaruh. Bagian 2 membandingkan aturan cache dari OpenAI, Claude, dan Gemini. Bagian 3 merinci rumus perhitungan untuk keempat model, sehingga pembaca dapat menghitung ulang sendiri. Bagian 4 menggunakan perhitungan TTL dan ritme pemanggilan untuk menjelaskan mengapa tingkat hit cache menurun. Bagian 5 memberikan cara penyusunan petunjuk, pemilihan TTL, contoh kode, dan metode pemantauan tingkat hit cache. Bagian 6 membahas kriteria penilaian untuk mengendalikan biaya Token dalam skenario produksi AI batch.
Perlu Diketahui: Persiapan Terminologi Prompt Caching
| Istilah | Penjelasan |
|---|---|
| Token | Unit yang digunakan model untuk mengukur teks; API menagih berdasarkan jumlah Token, dengan harga satuan biasanya dinyatakan sebagai “dolar / juta Token (MTok)” |
| Prompt Caching | Menyimpan prefiks petunjuk yang sudah diproses di cache; saat permintaan berikutnya memiliki prefiks yang sama, prefiks itu langsung digunakan kembali sehingga biaya pemrosesan berulang berkurang |
| Prefiks stabil | Bagian awal petunjuk yang identik kata per kata di beberapa permintaan, misalnya deskripsi peran, aturan penulisan, contoh tulisan, dan basis pengetahuan |
| Input dinamis | Konten yang berubah pada setiap permintaan, misalnya materi berita hari itu, judul artikel, dan permintaan pengguna |
| Penulisan cache | Pemrosesan pertama atas prefiks stabil lalu menyimpannya ke cache; harga satuannya biasanya lebih tinggi daripada input biasa |
| Pembacaan cache | Permintaan berikutnya mengenai cache yang sudah ada dan ditagih dengan harga satuan yang jauh lebih rendah daripada input biasa |
| Cache hit | Prefiks pada permintaan baru cocok per Token dengan cache yang tersedia, sehingga berhasil digunakan kembali |
| TTL | Masa hidup cache. OpenAI mendefinisikannya sebagai waktu hidup minimum dan tidak menjanjikan waktu penghapusan yang presisi |
| Breakpoint cache | Posisi dalam petunjuk yang menandai “prefiks yang dapat di-cache berhenti di sini” |
| Cache implisit / eksplisit | Cache implisit ditentukan dan digunakan kembali secara otomatis oleh sistem; cache eksplisit dideklarasikan secara aktif oleh pengembang melalui breakpoint atau dengan membuat objek cache |
| Biaya tugas penuh | Total biaya input, output, dan alat yang berlaku untuk satu panggilan; ini adalah penyebut sebenarnya untuk mengukur persentase penghematan |
1 Prompt Caching bisa menghemat biaya, tepatnya di bagian mana?
1.1 Apa yang dipakai ulang oleh Prompt Caching
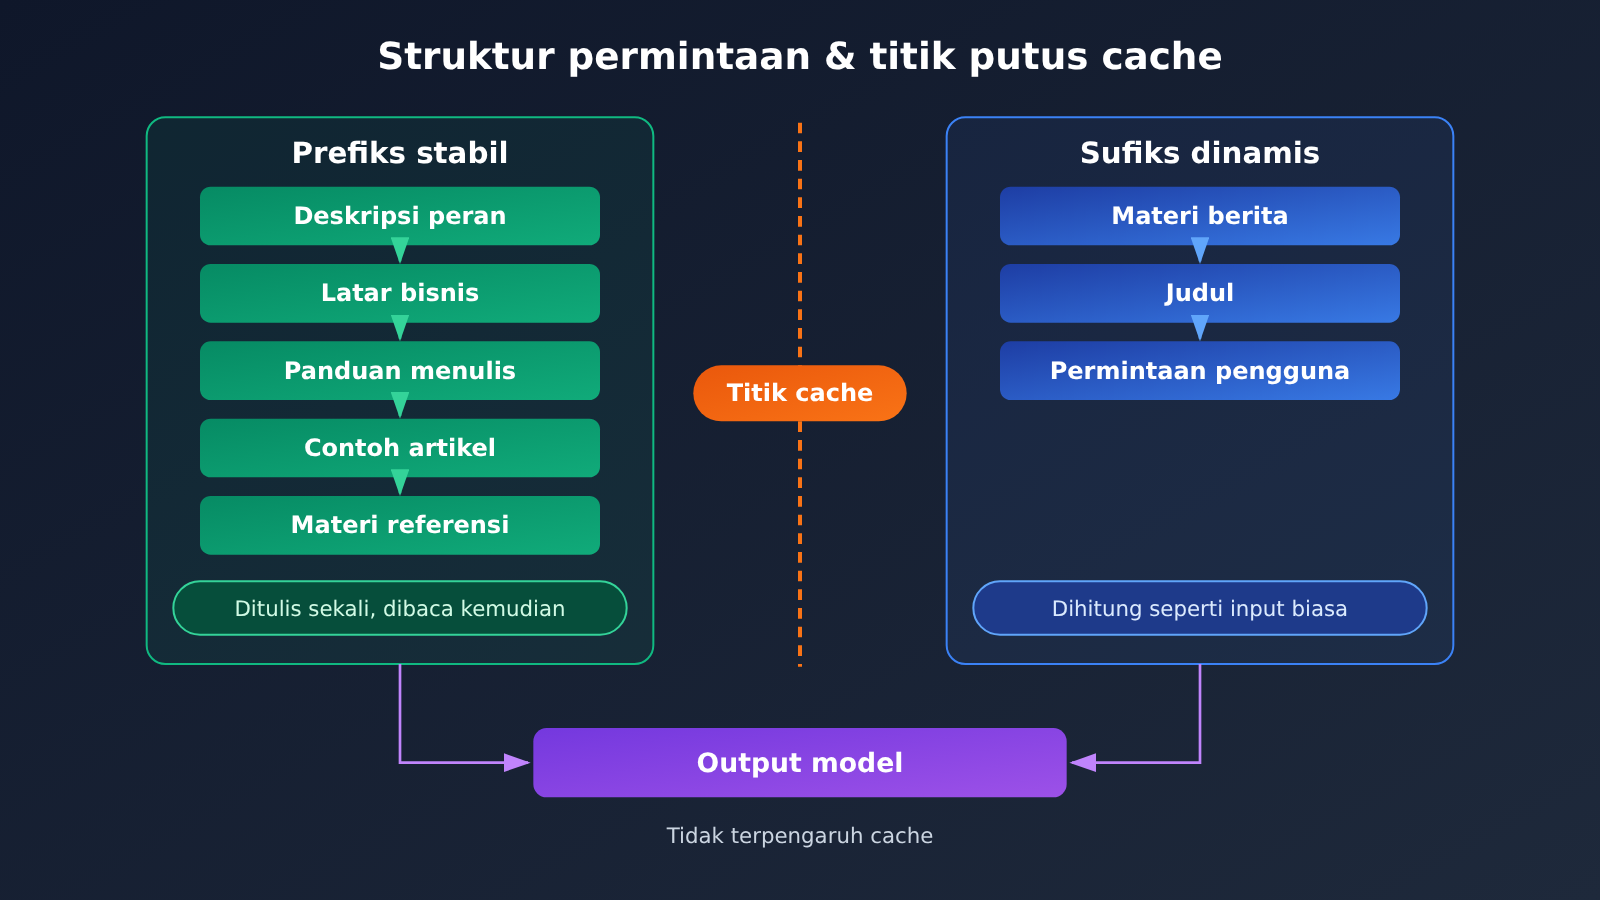
Ambil contoh sebuah platform penulisan AI. Setiap kali menghasilkan satu artikel, permintaan terdiri dari dua bagian. Bagian pertama adalah konten tetap: penjelasan peran, latar belakang bisnis, pedoman penulisan, contoh artikel, serta terminologi dan materi referensi. Bagian kedua adalah konten dinamis: materi berita hari itu, judul artikel, dan permintaan spesifik pengguna.
Yang dipakai ulang oleh Prompt Caching adalah bagian pertama, yaitu prefiks yang identik token demi token. Pencocokan cache mengharuskan urutan Token sepenuhnya sama; kemiripan makna tidak dihitung sebagai hit. Mengubah satu pilihan kata, menyesuaikan urutan paragraf, atau menyusun ulang definisi tool, semuanya bisa membuat prefiks menjadi konten baru, dan cache pun tidak berlaku.
Jadi ada satu prinsip dasar dalam optimasi cache: konten stabil diletakkan paling depan, konten yang berubah diletakkan di belakang.
1.2 Bagian biaya mana yang dihemat oleh Prompt Caching
Tagihan satu pemanggilan dapat dipecah menjadi lima item, dan hanya biaya prefiks tetap yang berubah karena cache:
| Item biaya | Tanpa cache | Setelah cache diaktifkan |
|---|---|---|
| Prefiks tetap | Ditagih dengan harga input biasa setiap kali | Pertama kali dengan harga penulisan, setelah hit dengan harga pembacaan |
| Input dinamis | Harga input biasa | Harga input biasa, tidak berubah |
| Output model | Harga output | Harga output, tidak berubah |
| Biaya tool | Mengikuti aturan tool | Mengikuti aturan tool, tidak berubah |
| Penyimpanan cache eksplisit (Gemini) | Tidak ada | Ditagih terpisah berdasarkan durasi penyimpanan |
Tabel ini menunjukkan satu perbedaan penting: tingkat penghematan prefiks tetap dan tingkat penghematan tagihan penuh adalah dua metrik. Yang pertama hanya mengukur penurunan pada bagian yang di-cache, sedangkan yang kedua mengukur penurunan pada seluruh tagihan. Semakin panjang output, semakin rendah nilai yang kedua.
2 Apa perbedaan aturan Prompt Caching antara GPT, Claude, dan Gemini?
2.1 OpenAI Prompt Caching: 30 menit dan 12 jam
Dokumentasi OpenAI untuk GPT-5.6 dan model-model setelahnya menetapkan bahwa panjang minimum prefix cache biasanya 1.024 Token input yang terlihat, serta mendukung dua mode: implisit (implicit) dan eksplisit (explicit). Dalam mode eksplisit, pengembang menandai prompt_cache_breakpoint pada blok konten pesan yang sesuai untuk menetapkan batas prefix cache secara jelas.
TTL default adalah 30 menit. Melalui Responses API, Anda dapat memilih masa aktif minimum 12 jam dengan prompt_cache_options.ttl = "12h". Penagihan dibagi menjadi penulisan dan pembacaan:
- Penulisan 30 menit: 1,25 kali input biasa
- Penulisan 12 jam: 2,5 kali input biasa
- Pembacaan cache: untuk sebagian besar model baru, 0,1 kali input biasa; untuk GPT-6.1 Sol dan GPT-6.1 Terra, 0,05 kali
prompt_cache_key dapat digunakan untuk membedakan penagihan cache antar pengguna atau workspace. Pada GPT-5.6 dan model-model setelahnya, perutean cache sudah dikelola secara otomatis oleh pihak resmi.
2.2 Claude Prompt Caching: 5m dan 1h
Claude mendukung cache otomatis atau eksplisit melalui cache_control. Masa berlaku defaultnya adalah 5 menit, dan setiap hit akan menyegarkan masa berlaku tersebut. Lima menit dihitung mulai dari permintaan penulisan atau pembacaan cache, dan waktu yang digunakan untuk menghasilkan respons juga ikut dihitung. Jadi, pada tugas dengan output panjang, interval yang benar-benar tersedia lebih pendek dari 5 menit.
Pengali biayanya adalah: penulisan cache 5 menit 1.25 kali, penulisan 1 jam 2 kali, pembacaan biasa 0.1 kali. Tarif pembacaan Claude Sonnet 5.5 dan Claude Opus 5.5 turun menjadi 0.05 kali. Harga standar Sonnet 5.5 adalah: input $2, penulisan 5 menit $2.50, penulisan 1 jam $4, pembacaan $0.10, output $10 (semuanya dalam USD per 1 juta Token).
2.3 Gemini Context Caching: implisit dan eksplisit
Gemini 2.5 dan model yang lebih baru mengaktifkan cache implisit secara default, tanpa perlu konfigurasi tambahan. Persyaratan input minimum berbeda-beda per model: Gemini 3.8 Flash adalah 4,096 Token, sedangkan Gemini 2.5 Flash dan 2.5 Pro adalah 2,048 Token. Google menyarankan untuk meletakkan konten yang dipakai bersama di depan petunjuk, dan menggunakan kembali prefiks yang sama dalam waktu yang relatif singkat.
Cache eksplisit mengharuskan pengembang membuat objek cache secara aktif dan menetapkan durasi masa berlakunya. Biayanya mencakup tiga bagian: konten cache, pembacaan berikutnya, dan durasi penyimpanan. Gemini Interactions API saat ini hanya mendukung cache implisit; jika memerlukan objek cache eksplisit, gunakan generateContent API.
Harga Gemini 3.8 Flash per 31 Desember 2026 adalah: input $0.75, output $3.75, pembacaan cache $0.075, penyimpanan cache eksplisit $0.50 / 1 juta Token / jam. Rencana resmi mulai 1 Januari 2027 akan menyesuaikannya menjadi $1.50, $7.50, $0.15, $1.00. Keempat harga berlipat ganda secara proporsional, sehingga rasio penghematan yang dihitung di bawah ini tidak berubah, tetapi nominal absolutnya berlipat ganda.
2.4 Perbandingan aturan Prompt Caching dari tiga penyedia
| Dimensi | OpenAI | Claude | Gemini |
|---|---|---|---|
| Cara caching | Implisit / titik henti eksplisit | cache_control otomatis / eksplisit |
Implisit (default) / objek cache eksplisit |
| TTL default | 30 menit (waktu hidup minimum) | 5 menit, diperbarui setiap cache hit | Implisit dikelola sistem; eksplisit durasinya diatur sendiri |
| Opsi TTL panjang | 12 jam (Responses API) | 1 jam | Cache eksplisit kustom |
| Tarif penulisan | 30m: 1,25x; 12j: 2,5x | 5m: 1,25x; 1j: 2x | Implisit dihitung sebagai input biasa pada pemakaian pertama |
| Tarif pembacaan | 0,1x (Sol / Terra 0,05x) | 0,1x (Sonnet / Opus 5.5 0,05x) | 3.8 Flash: $0.075 / MTok |
| Biaya tambahan | Tanpa biaya penyimpanan | Tanpa biaya penyimpanan | Cache eksplisit dikenakan biaya penyimpanan per jam |
| Prefiks minimum | Biasanya 1.024 Token | Sesuai dokumentasi resmi | 3.8 Flash: 4.096 Token |
3 Memanggil 100 kali sehari, berapa banyak yang sebenarnya bisa dihemat dengan Prompt Caching?
3.1 Kondisi perhitungan yang seragam
Berikut adalah kalkulasi teoretis berdasarkan harga satuan resmi, bukan tagihan pengguna yang sebenarnya. Asumsi yang digunakan seragam sebagai berikut:
- Setiap kali ada prefiks tetap 20.000 Token, input dinamis 500 Token, output 1.000 Token
- 100 panggilan per hari, selalu menggunakan model yang sama
- Seluruh konten dinamis berada setelah prefiks stabil
- Skenario cache: penulisan pertama, 99 panggilan berikutnya sepenuhnya cache hit; semua panggilan selesai dalam TTL, atau masa berlaku terus diperbarui saat terjadi cache hit
- Tidak memperhitungkan markup pihak ketiga, diskon massal, dan biaya tool
- Prefiks 20K tidak memicu biaya tambahan konteks panjang GPT-6 Astra saat melewati 272K Token
Rumus perhitungan seragam adalah:
biaya per item = jumlah Token × jumlah panggilan ÷ 1.000.000 × harga satuan (USD / MTok)
biaya prefiks setelah cache = 20.000 × 1 ÷ 1.000.000 × harga tulis + 20.000 × 99 ÷ 1.000.000 × harga baca
3.2 Rumus lengkap GPT-6 Astra
Harga satuan GPT-6 Astra: input biasa $10, output $50, penulisan 30 menit $12,50, pembacaan cache $1.
Tanpa cache:
- Prefiks tetap: 20.000 × 100 ÷ 1.000.000 × $10 = $20
- Input dinamis: 500 × 100 ÷ 1.000.000 × $10 = $0,50
- Output: 1.000 × 100 ÷ 1.000.000 × $50 = $5
- Total harian: $25,50
Cache 30 menit:
- Penulisan pertama: 20.000 ÷ 1.000.000 × $12,50 = $0,25
- 99 pembacaan: 20.000 × 99 ÷ 1.000.000 × $1 = $1,98
- Input dinamis: $0,50; output: $5
- Total harian: $7,73
Penghematan tagihan penuh sebesar $17,77, sekitar 69,69%. Prefiks tetap turun dari $20 menjadi $2,23, menghemat sekitar 88,85%.
3.3 GPT-6.1 Sol, Claude Sonnet 5.5, dan Gemini 3.8 Flash
GPT-6.1 Sol (input $2, output $10, penulisan 30 menit $2.50, pembacaan $0.10):
- Tanpa cache: prefiks $4 + input dinamis $0.10 + output $1 = $5.10
- Dengan cache: penulisan $0.05 + pembacaan $0.198 + input dinamis $0.10 + output $1 = $1.348
- Penghematan $3.752, sekitar 73.57%; prefiks turun dari $4 menjadi $0.248, menghemat sekitar 93.8%
Claude Sonnet 5.5 (cache 5 menit) memiliki harga satuan yang sama dengan GPT-6.1 Sol, dan proses perhitungan serta hasilnya juga identik: dari $5.10 menjadi $1.348. Syaratnya, interval pemanggilan harus terus menjaga masa berlaku 5 menit.
Gemini 3.8 Flash (cache implisit, pertama kali dihitung sebagai input biasa $0.75):
- Tanpa cache: prefiks $1.50 + input dinamis $0.0375 + output $0.375 = $1.9125
- Dengan cache: prefiks pertama $0.015 + 99 kali pembacaan $0.1485 + input dinamis $0.0375 + output $0.375 = $0.576
- Penghematan $1.3365, sekitar 69.88%; prefiks turun dari $1.50 menjadi $0.1635, menghemat sekitar 89.1%
- Hasil ini mengasumsikan semua cache implisit mengalami hit, tidak termasuk biaya penyimpanan cache eksplisit.
3.4 Perbedaan antara Rasio Penghematan dan Jumlah Absolut pada Prompt Caching
| Model | Tanpa cache / hari | Setelah cache / hari | Penghematan per hari | Penghematan 30 hari (ekstrapolasi) | Rasio penghematan prefiks | Rasio penghematan tagihan penuh |
|---|---|---|---|---|---|---|
| GPT-6 Astra | $25.50 | $7.73 | $17.77 | $533.10 | 88.85% | 69.69% |
| GPT-6.1 Sol | $5.10 | $1.348 | $3.752 | $112.56 | 93.8% | 73.57% |
| Claude Sonnet 5.5 | $5.10 | $1.348 | $3.752 | $112.56 | 93.8% | 73.57% |
| Gemini 3.8 Flash | $1.9125 | $0.576 | $1.3365 | $40.10 | 89.1% | 69.88% |
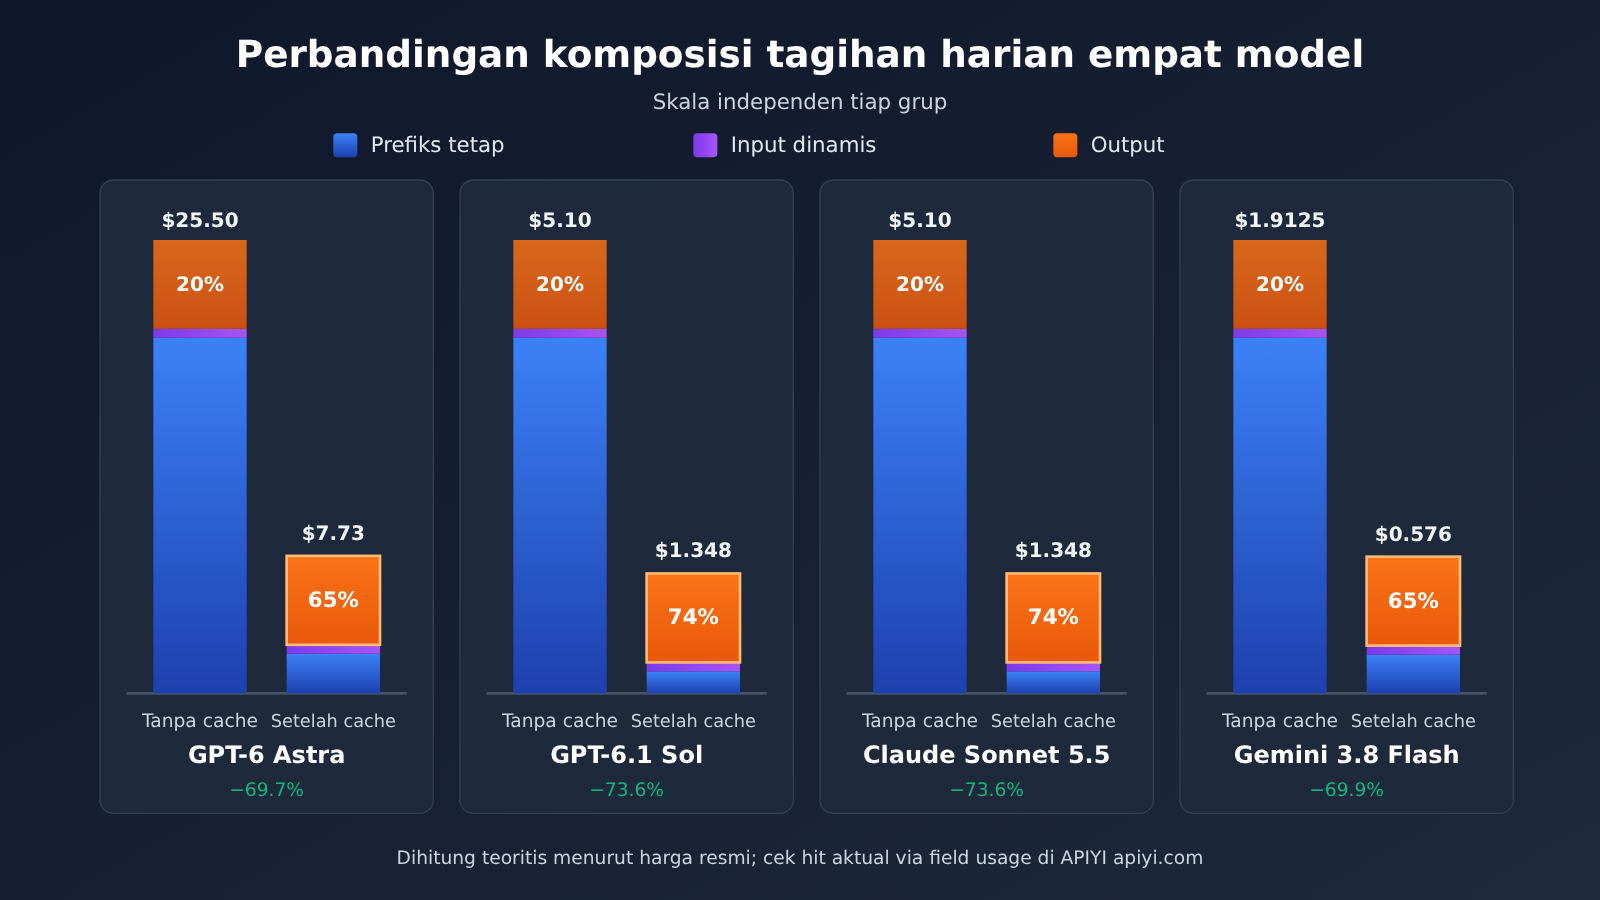
Dari tabel di atas, kita bisa membaca dua hal:
- Rasio dilihat dari diskon pembacaan. Harga baca GPT-6.1 Sol dan Claude Sonnet 5.5 adalah 0.05 kali input reguler, sehingga rasio penghematan prefiks mencapai 93.8%, lebih tinggi daripada Astra dan Gemini yang harga bacanya 0.1 kali.
- Jumlah absolut dilihat dari basis harga satuan. Rasio penghematan Astra paling rendah, tetapi penghematan hariannya $17.77, lebih dari 13 kali lipat Gemini 3.8 Flash. Semakin tinggi harga satuan sebuah model, semakin besar keuntungan absolut yang didapat dari mengaktifkan cache.
Setelah cache aktif, proporsi output dalam tagihan GPT-6 Astra naik dari sekitar 20% menjadi sekitar 65% ($5 ÷ $7.73). Di titik ini, fokus penurunan biaya lebih lanjut akan bergeser ke pengendalian panjang output. Perlu dicatat bahwa keempat model menggunakan jumlah Token yang sama hanya untuk memudahkan perbandingan. Saat mengerjakan tugas yang sama, panjang output aktual dan tingkat akurasi tiap model tidak sama.
💡 Saran pemilihan model: Saat rasionya berdekatan, utamakan keseimbangan antara jumlah absolut penghematan harian dan kualitas tugas. Sebaiknya panggil beberapa model kandidat secara terpisah di APIYI apiyi.com dengan templat yang sama, catat panjang output aktual dan Token cache, lalu masukkan ke rumus di atas untuk memperkirakan anggaran bulanan.
4 Mengapa Mengulang Petunjuk yang Sama Setiap Hari, Tagihan Prompt Caching Tetap Bisa Tinggi?
4.1 TTL dan frekuensi pemanggilan menentukan tingkat cache hit
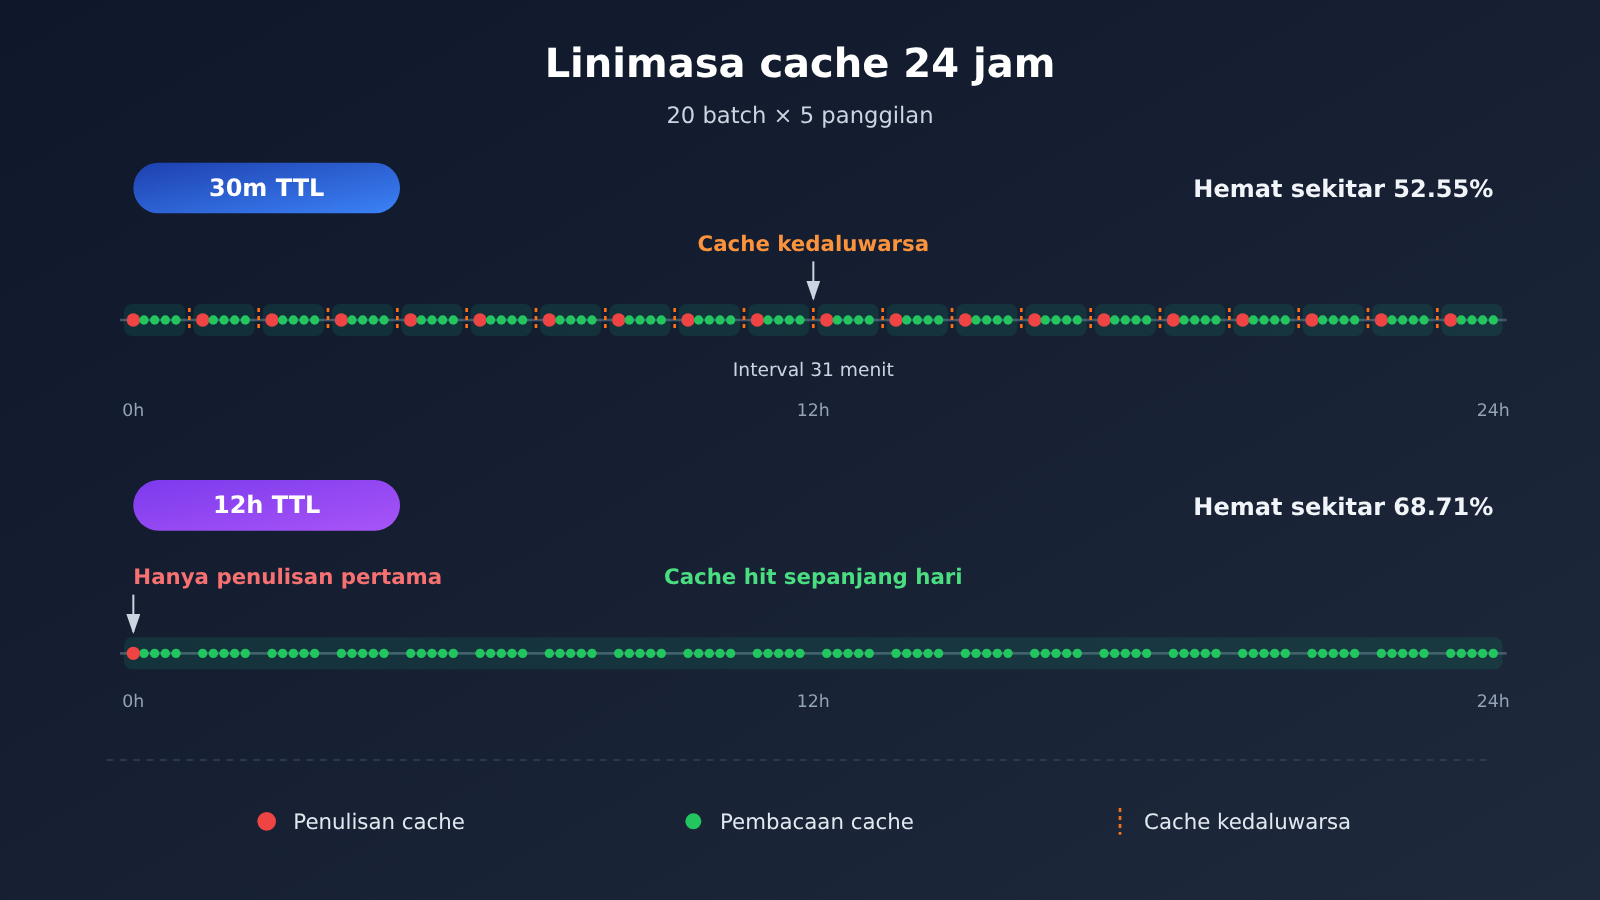
Memanggil 100 kali sehari bukan berarti satu kali penulisan bisa mencakup sepanjang hari. Berikut contoh dengan GPT-6 Astra: setiap hari dibagi menjadi 20 batch, setiap batch memanggil secara berturut-turut 5 kali, dengan interval 31 menit antar batch.
| Skenario | Jumlah penulisan dan biaya | Jumlah pembacaan dan biaya | Biaya prefiks | Ditambah input dinamis dan output | Total harian | Tingkat penghematan |
|---|---|---|---|---|---|---|
| Tanpa cache | — | — | $20 | $5.50 | $25.50 | — |
| A: Cache 30m | 20 × $0.25 = $5 | 80 × $0.02 = $1.60 | $6.60 | $5.50 | $12.10 | sekitar 52.55% |
| B: Cache 12h (dalam jendela yang sama) | 1 × $0.50 | 99 × $0.02 = $1.98 | $2.48 | $5.50 | $7.98 | sekitar 68.71% |
Pada skenario A, interval antar batch melebihi 30 menit, sehingga setiap batch harus ditulis ulang; tingkat penghematan turun dari ideal 69.69% menjadi 52.55%. Harga penulisan sekali pada skenario B dua kali lipat dari 30m, tetapi sepanjang hari hanya menulis sekali, jadi lebih hemat untuk pemanggilan yang tersebar. Skema 12h hanya mencakup jendela yang sama; tidak ada jaminan cache yang sama dapat dipakai lagi pada hari berikutnya. Untuk tugas yang hanya dipanggil satu atau dua kali sehari, mengandalkan petunjuk yang sama saja tidak bisa mewujudkan cache lintas hari.
Titik impas berbagai TTL dapat dihitung hanya dengan melihat prefiks stabil, dengan input biasa sebagai acuan 1x:
| Skenario | Pengali penulisan | Pengali pembacaan | Tulis 1 + baca 1 vs tanpa cache 2 kali | Tulis 1 + baca 2 vs tanpa cache 3 kali | Pembacaan efektif yang diperlukan untuk balik modal |
|---|---|---|---|---|---|
| OpenAI 30m | 1.25 | 0.1 | 1.35 < 2 | — | 1 kali |
| OpenAI 12h | 2.5 | 0.1 | 2.6 > 2 | 2.7 < 3 | 2 kali |
| Claude Sonnet 5.5 · 5m | 1.25 | 0.05 | 1.30 < 2 | — | 1 kali |
| Claude Sonnet 5.5 · 1h | 2 | 0.05 | 2.05 > 2 | 2.10 < 3 | 2 kali |
Kesimpulannya lugas: TTL pendek cukup satu kali hit untuk balik modal; TTL panjang perlu setidaknya dua kali hit dalam masa berlakunya.
4.2 Titik putus cache dan urutan petunjuk
Penyebab kegagalan paling umum adalah prefiks stabil diubah. Jika stempel waktu, ID pengguna, judul tugas, atau materi real-time diletakkan di awal petunjuk, prefiks setiap permintaan akan menjadi konten baru, sehingga cache tidak akan pernah kena.
Dalam mode implisit OpenAI, jika permintaan pertama juga memasukkan konten dinamis ke dalam cakupan cache, ketika konten dinamis berikutnya berubah, prefiks stabil yang diharapkan bisa saja tidak kena. Solusinya adalah menetapkan titik putus cache eksplisit di akhir konten stabil.
Penyebab umum lainnya:
- Berganti model, penyedia, organisasi layanan, atau mengubah sebagian parameter
- Agen melakukan kompresi percakapan, menyusun ulang definisi tool, atau mengubah pesan riwayat, sehingga prefiks yang dapat digunakan kembali ditulis ulang
- Gateway pihak ketiga tidak meneruskan parameter cache, atau tidak memasukkan diskon cache ke dalam tagihan
4.3 Dampak Token keluaran dan biaya tool
Cache hanya berlaku pada prefiks masukan. Dalam contoh perhitungan Astra di 3.2, bahkan jika biaya prefiks turun menjadi nol, tagihan tidak akan lebih rendah dari $5.50 (masukan dinamis ditambah keluaran). Untuk tugas dengan keluaran panjang dan banyak pemanggilan tool, penurunan tagihan penuh akan jauh lebih rendah daripada tingkat penghematan prefiks. Jadi setelah mengaktifkan cache, perlu juga mengontrol panjang keluaran dan merampingkan pemanggilan tool.
5 Bagaimana aplikasi AI mengonfigurasi dan memantau Prompt Caching?
5.1 Cara menyusun prefiks stabil dan sufiks dinamis
Susun konten dengan urutan “frekuensi perubahan dari rendah ke tinggi”:
- Definisi alat: pertahankan urutan dan deskripsi yang tetap, jangan menambah atau mengurangi secara dinamis per permintaan
- Aturan sistem dan pedoman penulisan: penjelasan peran, standar merek, persyaratan gaya bahasa
- Contoh tulisan dan basis pengetahuan: dokumen referensi dalam jumlah besar, diganti seluruhnya saat versi diperbarui
- (Titik putus cache)
- Materi dinamis: berita hari ini, hasil pencarian, input pengguna
- Instruksi tugas saat ini: judul, jumlah kata, persyaratan khusus
Contoh berikut mengirim pemanggilan melalui antarmuka kompatibel OpenAI, lalu membaca Token cache pada respons yang dikembalikan:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # antarmuka kompatibel OpenAI APIYI
)

STABLE_PREFIX = """你是一名技术博客作者……(写作规范、范文、术语表,约 20K Token,内容逐字固定)"""

resp = client.chat.completions.create(
    model="gpt-6.1-sol",  # sesuai nama sebenarnya pada daftar model platform
    messages=[
        {"role": "system", "content": STABLE_PREFIX},          # prefiks stabil diletakkan paling depan
        {"role": "user", "content": "今日材料:……\n标题:……"},  # konten dinamis diletakkan di belakang
    ],
)
details = getattr(resp.usage, "prompt_tokens_details", None)
cached = getattr(details, "cached_tokens", 0) or 0
print(f"输入 {resp.usage.prompt_tokens},命中缓存 {cached}")
Lihat kode lengkap: kalkulator biaya + statistik hit rate
from openai import OpenAI

M = 1_000_000

def daily_cost(prefix, dynamic, output, calls,
               p_in, p_out, p_write, p_read,
               writes=1, use_cache=True):
    """Hitung biaya harian berdasarkan harga resmi (dolar AS), kembalikan (prefix, input dinamis, output, total)"""
    dyn = dynamic * calls / M * p_in
    out = output * calls / M * p_out
    if use_cache:
        pre = prefix * writes / M * p_write + prefix * (calls - writes) / M * p_read
    else:
        pre = prefix * calls / M * p_in
    return round(pre, 4), round(dyn, 4), round(out, 4), round(pre + dyn + out, 4)

MODELS = {
    # Nama: (input, output, tulis, baca)  dolar AS / juta Token, tanggal verifikasi 2026-11-13
    "GPT-6 Astra (30m)":   (10,   50,   12.5, 1),
    "GPT-6.1 Sol (30m)":   (2,    10,   2.5,  0.10),
    "Claude Sonnet 5.5":   (2,    10,   2.5,  0.10),
    "Gemini 3.8 Flash":    (0.75, 3.75, 0.75, 0.075),  # cache implisit pertama kali dihitung sebagai input biasa
}

for name, (p_in, p_out, p_w, p_r) in MODELS.items():
    base = daily_cost(20000, 500, 1000, 100, p_in, p_out, p_w, p_r, use_cache=False)[-1]
    cached = daily_cost(20000, 500, 1000, 100, p_in, p_out, p_w, p_r)[-1]
    print(f"{name}: ${base} -> ${cached},节省 {(base - cached) / base:.2%}")

# Skenario A: Astra 30m, 20 batch yang masing-masing perlu ditulis ulang
a = daily_cost(20000, 500, 1000, 100, 10, 50, 12.5, 1, writes=20)[-1]
print(f"Astra 分批 30m: ${a}")  # 12.1

# ---- Statistik tingkat hit di produksi ----
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

def run_and_track(stable_prefix, dynamic_inputs, model="gpt-6.1-sol"):
    total_in = total_cached = 0
    for text in dynamic_inputs:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "system", "content": stable_prefix},
                      {"role": "user", "content": text}],
        )
        d = getattr(r.usage, "prompt_tokens_details", None)
        total_in += r.usage.prompt_tokens
        total_cached += (getattr(d, "cached_tokens", 0) or 0)
    hit = total_cached / total_in if total_in else 0
    print(f"实际缓存命中率:{hit:.2%}")
    return hit
🚀 Saran memulai cepat: gunakan kalkulator di atas untuk memperkirakan anggaran, lalu jalankan 10–20 panggilan dengan template nyata untuk melihat apakah
cached_tokensmulai muncul secara stabil sejak panggilan kedua. Pengguna baru dapat mengambil kuota uji gratis di APIYI apiyi.com untuk menyelesaikan verifikasi langkah ini, dan setelah memastikan cache hit, baru tingkatkan volume.
5.2 Memilih TTL Prompt Caching dan Mode Cache
- Pemanggilan beruntun berfrekuensi tinggi (interval stabil dalam beberapa menit): gunakan TTL pendek bawaan, yaitu OpenAI 30m, Claude 5m. Sekali hit saja sudah balik modal, dengan biaya溢价 penulisan terendah. Claude perlu memasukkan durasi pembuatan respons ke dalam jendela 5 menit.
- Pemanggilan tersebar sepanjang hari (interval antar batch lebih dari 30 menit): evaluasi OpenAI 12h atau Claude 1h. Selama dalam jendela bisa hit lebih dari dua kali, TTL panjang lebih murah daripada penulisan berulang, seperti yang dicontohkan skenario B di 4.1.
- Tugas Gemini dengan前缀 sangat panjang yang perlu digunakan ulang lintas periode waktu cukup lama: evaluasi cache eksplisit, sekaligus hitung biaya penyimpanan. Dengan Gemini 3.8 Flash sebagai contoh, penyimpanan 20K Token selama 12 jam memakan biaya 0.02 × $0.50 × 12 = $0.12. Pada beban kerja artikel ini, biaya tersebut sudah cukup signifikan dibandingkan tagihan harian $0.576. Jika cache implisit sudah baik hit-nya, biarkan bawaan.
- Prefix sering berubah: stabilkan prefix dulu, baru pertimbangkan TTL. Saat prefix tidak stabil, TTL apa pun tidak akan menghasilkan hit.
5.3 Memeriksa Tingkat Hit dan Tagihan Prompt Caching yang Sebenarnya
Field usage ketiga penyedia adalah:
- OpenAI (Responses API):
usage.input_tokens,usage.input_tokens_details.cached_tokens,usage.input_tokens_details.cache_write_tokens - Claude:
usage.input_tokens,usage.cache_creation_input_tokens,usage.cache_read_input_tokens - Gemini: field usage API terkait, misalnya
total_cached_tokens; cache eksplisit dihitung terpisah dengan biaya penyimpanan objek
Disarankan untuk terus melacak dua metrik:
Tingkat hit cache aktual = Token baca cache ÷ Total Token input
Jumlah penghematan aktual = Biaya baseline tanpa cache − Biaya tagihan API aktual
Biaya baseline tanpa cache harus dihitung dengan model yang sama, beban kerja yang sama, dan skala output yang sama, jika tidak, jumlah penghematan tidak akan memiliki perbandingan yang setara. Saat memeriksa tagihan di konsol APIYI apiyi.com, Anda dapat membandingkan ringkasan usage pada periode yang sama dengan rincian pemotongan biaya item demi item, untuk memastikan Token cache ditagih dengan harga cache.
6 Skenario APIYI: Bagaimana Produksi AI Massal dan Template Tetap Mengendalikan Biaya dengan Prompt Caching?
Bisnis tipikal yang cocok untuk Prompt Caching antara lain: platform penulisan AI yang setiap hari menjalankan template artikel tetap, Agent yang berulang kali memuat definisi tool yang sama, sistem analisis dokumen yang berkali-kali merujuk satu dokumen referensi besar yang sama, serta pembuatan konten massal yang berbagi pedoman merek dan penjelasan gaya penulisan. Tugas-tugas semacam ini punya satu kesamaan: prefiks panjang, tingkat pengulangan tinggi, dan volume pemanggilan besar — tepat berada di rentang dengan keuntungan cache tertinggi.
Dalam skenario seperti ini, pengambilan keputusan biaya bisa dinilai lewat tiga kriteria:
- Apakah model mendukung kemampuan cache yang dibutuhkan. Ini mencakup panjang prefiks minimum, TTL opsional, dan faktor diskon pembacaan. Model dengan pembacaan 0,05 kali punya tingkat penghematan prefiks yang lebih tinggi pada tugas berprefiks panjang.
- Apakah petunjuk dan TTL sesuai dengan beban kerja. Pemrosesan batch berkelanjutan sebaiknya memakai TTL pendek; tugas yang dieksekusi tersebar menurut jadwal perlu dievaluasi dengan TTL panjang, lalu hitung jumlah pengembalian modal (break-even) memakai rumus di bagian 4.1.
- Apakah penyedia API sepenuhnya mendukung cache dan menagih sesuai biaya cache aktual. Dukungan cache di sisi upstream hanyalah salah satu syarat perlu untuk menurunkan biaya. Gateway juga harus meneruskan parameter cache dengan benar, melaporkan Token cache di usage, dan mencerminkan harga cache pada penagihan.
Saat memanggil lewat APIYI apiyi.com, sebaiknya jadikan poin ke-3 sebagai langkah verifikasi tetap: panggil beberapa kali berturut-turut dengan template 20K yang sama, periksa field cache di usage, lalu cocokkan dengan penagihan di tagihan. Setelah dua hal — hit teknis dan realisasi penagihan — sama-sama terkonfirmasi, barulah hasil perhitungan di atas dipakai sebagai dasar anggaran bulanan.
Pertanyaan yang Sering Diajukan (FAQ)
Q1: Apa itu Prompt Caching?
Prompt Caching menyimpan prefiks identik yang sudah diproses di dalam petunjuk, sehingga permintaan berikutnya yang mengenai cache akan ditagih dengan harga jauh lebih murah daripada input biasa. Pencocokan mensyaratkan Token yang benar-benar identik, jadi mekanisme ini cocok untuk hal-hal seperti templat tetap, basis pengetahuan tetap, dan definisi tool yang tetap.
Q2: Kenapa prefiks bisa hemat lebih dari 90%, tapi tagihan keseluruhan hanya sekitar 70%?
Cache hanya berlaku pada prefiks tetap, sementara input dinamis dan output tetap ditagih dengan harga normal. Ambil contoh GPT-6.1 Sol: dari tagihan harian $1.348 setelah caching, output menyumbang $1 dan input dinamis menyumbang $0.10. Semakin panjang output, semakin rendah tingkat penghematan pada tagihan keseluruhan.
Q3: Kalau sehari cuma memanggil satu atau dua kali, apakah cache masih layak diaktifkan?
Manfaatnya sangat kecil. OpenAI 12h dan Claude 1h sama-sama perlu mengenai cache minimal dua kali dalam masa berlakunya agar modal kembali, sedangkan pemakaian ulang lintas hari tidak dijamin. Pendekatan yang lebih efektif adalah mengumpulkan tugas sejenis dan menjalankannya secara batch pada rentang waktu yang sama, sehingga jumlah hit di dalam jendela waktu meningkat.
Q4: Pilih 30m atau 12h?
Tergantung interval pemanggilan. Kalau intervalnya stabil di bawah 30 menit, pakai 30m — sekali hit sudah cukup untuk balik modal. Kalau jeda antar batch lebih panjang dan tersebar sepanjang hari, pakai 12h. Contohnya GPT-6 Astra yang dipanggil dalam 20 batch: biaya harian dengan 12h adalah $7.98, sedangkan dengan 30m adalah $12.10.
Q5: Kalau memanggil lewat platform agregator API, apakah cache tetap berfungsi?
Ini bergantung pada bagaimana platform meneruskan parameter cache dan mengimplementasikan penagihannya. Sebaiknya di APIYI apiyi.com lakukan pemanggilan berurutan ke templat yang sama menggunakan kuota uji gratis, lalu periksa field seperti `cached_tokens` di dalam usage dan cocokkan dengan rincian potongan biaya. Setelah memastikan cache benar-benar mengenai sasaran sekaligus ditagih dengan harga cache, barulah digunakan secara batch.
Q6: Tiba-tiba tingkat hit cache turun, di mana yang harus diperiksa lebih dulu?
Periksa dengan urutan berikut: apakah ada konten dinamis seperti timestamp atau ID yang tercampur ke dalam prefiks; apakah urutan definisi tool berubah; apakah Agent mengompresi atau menulis ulang pesan riwayat; apakah model atau parameter berganti; apakah interval pemanggilan melewati TTL. Gunakan rumus tingkat hit di bagian 5.3 dan hitung per jam — dengan cara ini titik waktu terjadinya perubahan bisa lebih cepat ditemukan.
Q7: Bagaimana memilih antara implicit caching dan explicit caching di Gemini?
Implicit caching aktif secara default, tidak ada biaya penyimpanan, dan diprioritaskan ketika prefiks melewati panjang minimum model (untuk 3.8 Flash sekitar 4,096 Token). Explicit caching cocok untuk konten sangat panjang yang butuh pemakaian ulang deterministik, tetapi Anda harus membayar biaya penyimpanan per jam dan menggunakan generateContent API. Interactions API saat ini hanya mendukung implicit caching.
Ringkasan
Poin-poin inti Prompt Caching:
- Hemat di mana: hanya menurunkan biaya prefiks tetap. Pada beban kerja di artikel ini, tingkat penghematan prefiks mencapai 88.85%~93.8%, sedangkan penghematan tagihan penuh 69.69%~73.57%.
- Berapa penghematannya: GPT-6.1 Sol dan Claude Sonnet 5.5 turun dari $5.10 menjadi $1.348 per hari, GPT-6 Astra dari $25.50 menjadi $7.73. Semakin tinggi harga satuan, semakin besar penghematan absolutnya.
- Frekuensi seperti apa yang paling hemat: pemanggilan dengan frekuensi tinggi, berurutan, dan prefiks panjang. TTL pendek balik modal hanya dengan 1 kali hit, TTL panjang butuh 2 kali hit.
- Cara menerapkannya: konten stabil di depan, konten dinamis di belakang, lalu letakkan breakpoint di akhir konten stabil; pilih TTL sesuai ritme pemanggilan; pantau terus hit rate lewat field
usage. - Prasyarat yang harus terpenuhi: cache tidak hanya harus hit secara teknis, tetapi juga harus ditagih dengan harga cache saat penagihan.
Saran: hitung dulu anggaran dengan kalkulator di artikel ini, lalu verifikasi hit rate dan penagihan memakai template nyata di APIYI apiyi.com. Setelah keduanya terkonfirmasi, barulah tingkatkan volume.
📚 Referensi
- Panduan Prompt Caching OpenAI: pola cache, breakpoint, TTL, dan pengali biaya
- Tautan:
developers.openai.com/api/docs/guides/prompt-caching -
Keterangan: penjelasan parameter
prompt_cache_options,prompt_cache_breakpoint -
Model dan Harga OpenAI: harga satuan GPT-6 Astra, GPT-6.1 Sol
- Tautan:
developers.openai.com/api/docs/pricing - Tautan:
developers.openai.com/api/docs/models/gpt-6-astra - Tautan:
developers.openai.com/api/docs/models/gpt-6.1-sol -
Keterangan: tarif standar konteks pendek, tanggal verifikasi 2026-11-13
-
Dokumentasi Claude Prompt Caching:
cache_control, pengali penulisan dan pembacaan 5m / 1h - Tautan:
platform.claude.com/docs/en/build-with-claude/prompt-caching - Tautan:
platform.claude.com/docs/en/models/sonnet-5-5/overview -
Keterangan: tarif pembacaan cache Sonnet 5.5 sebesar 0.05 kali
-
Gemini Context Caching dan Harga: cache implisit / eksplisit, biaya penyimpanan, dan penyesuaian harga tahun 2027
- Tautan:
ai.google.dev/gemini-api/docs/caching - Tautan:
ai.google.dev/gemini-api/docs/pricing - Keterangan: panjang cache minimum tiap model dan cakupan dukungan API
Penulis: Tim Teknis APIYI
Jejaring teknis: Silakan hubungi kami lewat halaman utama situs resmi APIYI; materi integrasi lainnya tersedia di pusat dokumentasi docs.apiyi.com


