
ملخص: يستخدم هذا المقال مجموعة أحمال عمل واحدة لحساب تكلفة Prompt Caching في أربعة أجزاء: كتابة الذاكرة المؤقتة، وقراءة الذاكرة المؤقتة، والمدخلات الديناميكية، والمخرجات، ثم يوضح كيف تؤثر نسبة الإصابة وTTL وإيقاع الاستدعاء في التوفير الفعلي.
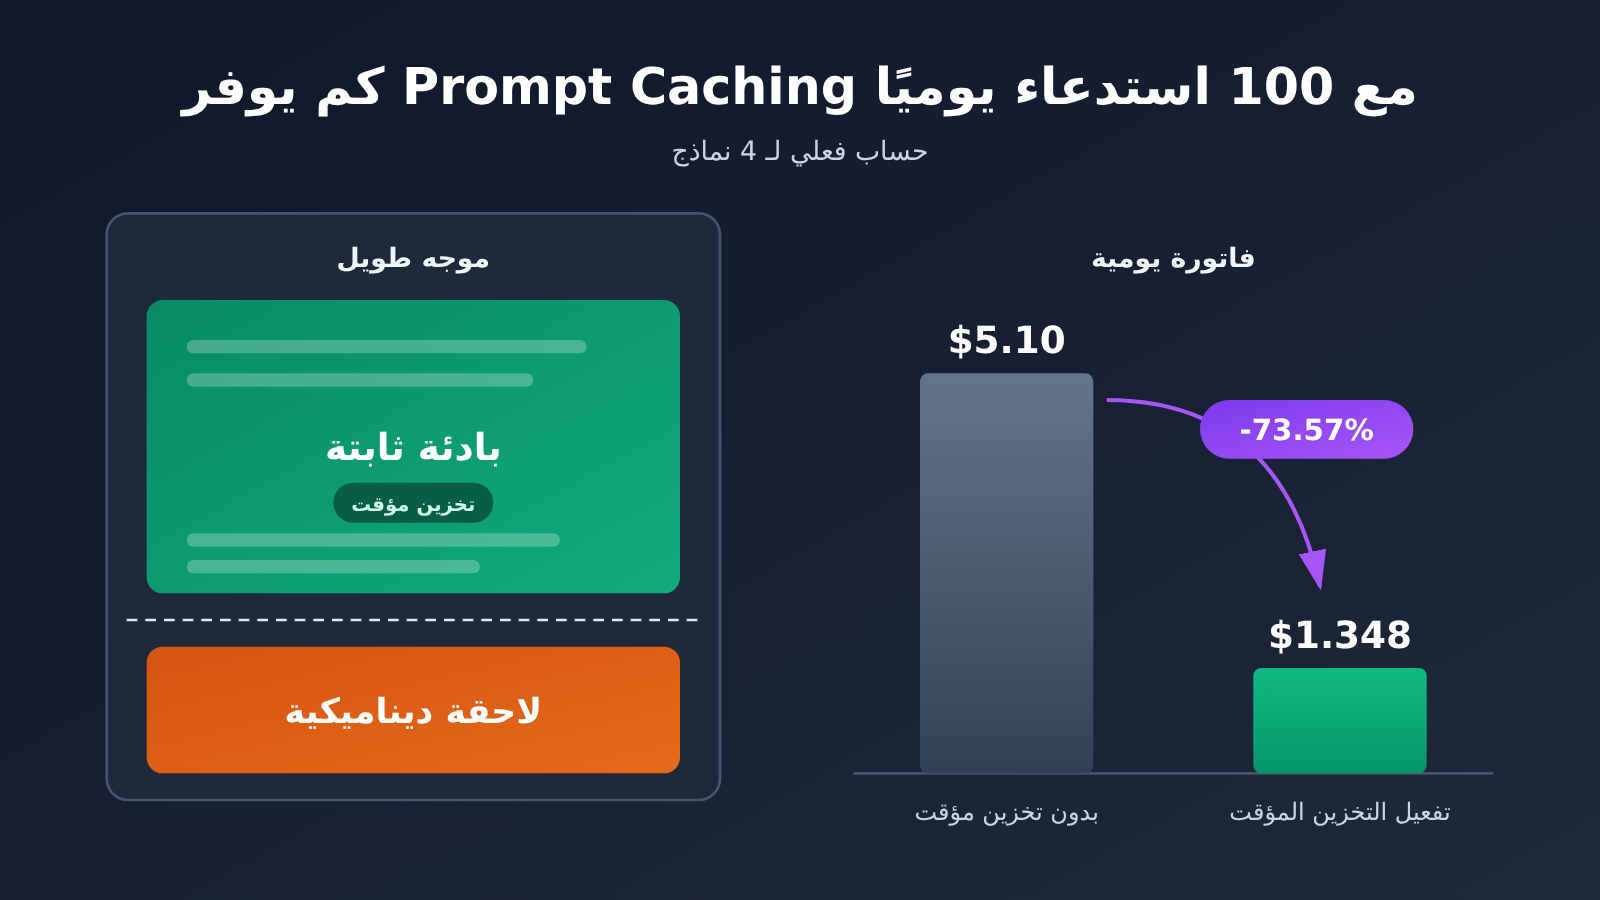
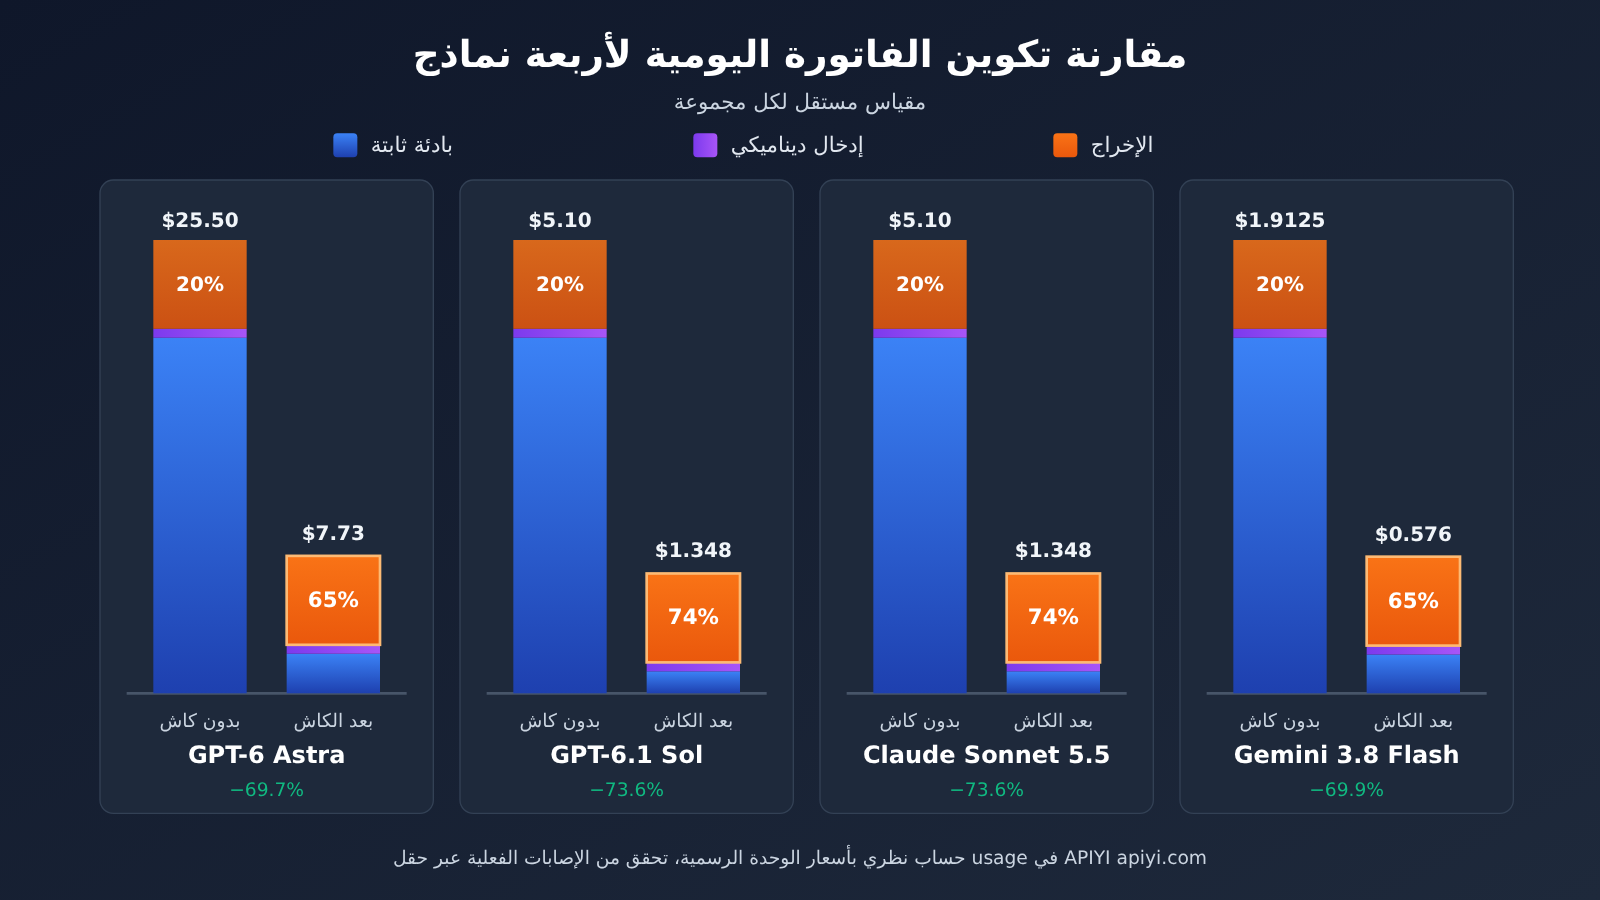
الاستنتاج: حمل العمل المفترض في هذا المقال هو بادئة ثابتة بحجم 20K Token في كل استدعاء، ومدخلات ديناميكية بحجم 500 Token، ومخرجات بحجم 1K Token، مع 100 استدعاء يوميًا. وفي الظروف المثالية التي تكون فيها «الكتابة الأولى مرة واحدة، ثم إصابة كاملة في الاستدعاءات الـ99 التالية»، تنخفض الفاتورة اليومية الكاملة لـ GPT-6.1 Sol من $5.10 إلى $1.348، أي بانخفاض يبلغ نحو 73.57%. وتتطابق نتيجة Claude Sonnet 5.5 معه، بينما ينخفض GPT-6 Astra من $25.50 إلى $7.73، أي بنحو 69.69%، وGemini 3.8 Flash من $1.9125 إلى $0.576، أي بنحو 69.88%. وبالنظر إلى البادئة الثابتة وحدها، تتراوح نسبة التوفير بين 88% و94%. انخفاض الفاتورة الكاملة أقل، لأن رموز المخرجات والمدخلات الديناميكية لا تستفيد من خصم التخزين المؤقت. الأرقام أعلاه حسابات تقديرية مبنية على أسعار الوحدة الرسمية، وليست فواتير فعلية. وتم اعتماد أسعار السياق القصير القياسية بشكل موحد، بتاريخ التحقق 2026-11-13.
نظرة على المحتوى: يوضح الجزء الأول أي مقطع من الطلب تعيد الذاكرة المؤقتة استخدامه، وأي جزء من الفاتورة يتأثر بذلك. ويقارن الجزء الثاني قواعد التخزين المؤقت لدى OpenAI وClaude وGemini. ويسرد الجزء الثالث معادلات الحساب للنماذج الأربعة بندًا بندًا، ليتمكن القارئ من إعادة الحساب بنفسه. ويشرح الجزء الرابع، عبر حسابات TTL وإيقاع الاستدعاء، لماذا تنخفض نسبة الإصابة. ويقدّم الجزء الخامس طريقة تنظيم الموجهات، واختيار TTL، وأمثلة برمجية، وطرق مراقبة نسبة الإصابة. ويناقش الجزء السادس معايير الحكم على ضبط تكلفة Token في سيناريوهات الإنتاج بالذكاء الاصطناعي على نطاق واسع.
للمعرفة: مقدمة مصطلحات Prompt Caching
| المصطلح | الشرح |
|---|---|
| Token | وحدة قياس النص في النموذج؛ تُحتسب التكلفة في API حسب عدد الـ Token، ويُعبّر عن سعر الوحدة عادةً بصيغة «دولار / مليون Token (MTok)» |
| Prompt Caching | تخزين بادئة الموجه التي عُالجت سابقًا في ذاكرة مؤقتة، ثم إعادة استخدامها مباشرةً عندما يصادف الطلب اللاحق البادئة نفسها، ما يقلل تكلفة المعالجة المتكررة |
| البادئة الثابتة | الجزء الأول من الموجه المتطابق حرفيًا في طلبات متعددة، مثل وصف الدور، وقواعد الكتابة، ونماذج نصية، وقاعدة معرفية |
| الإدخال الديناميكي | المحتوى الذي يتغير مع كل طلب، مثل مواد الأخبار اليومية، وعنوان المقال، ومتطلبات المستخدم |
| كتابة الذاكرة المؤقتة | معالجة البادئة الثابتة لأول مرة وتخزينها في الذاكرة المؤقتة، وسعر الوحدة عادةً أعلى من الإدخال العادي |
| قراءة الذاكرة المؤقتة | الطلبات اللاحقة التي تصيب ذاكرة مؤقتة موجودة، فتُحتسب بسعر وحدة أقل بكثير من الإدخال العادي |
| إصابة الذاكرة المؤقتة | تطابق بادئة الطلب الجديد مع الذاكرة المؤقتة المتاحة Tokenًا Tokenًا، ونجاح إعادة الاستخدام |
| TTL | مدة بقاء الذاكرة المؤقتة. تعرّفها OpenAI بأنها الحد الأدنى لمدة البقاء، ولا تلتزم بوقت حذف دقيق |
| نقطة توقف التخزين المؤقت | موضع في الموجه يحدد «انتهاء البادئة القابلة للتخزين هنا» |
| التخزين المؤقت الضمني / الصريح | التخزين الضمني يقرره النظام ويُعيد استخدامه تلقائيًا؛ والتخزين الصريح يعلن فيه المطوّر نقطة التوقف بنفسه أو ينشئ كائن ذاكرة مؤقتة |
| تكلفة المهمة الكاملة | مجموع تكاليف الإدخال والإخراج والأدوات المطبقة في استدعاء واحد، وهو المقام الحقيقي لقياس نسبة التوفير |
1. Prompt Caching يوفر المال، لكن أين يظهر التوفير بالضبط؟
1.1 ما الذي يعيد Prompt Caching استخدامه؟
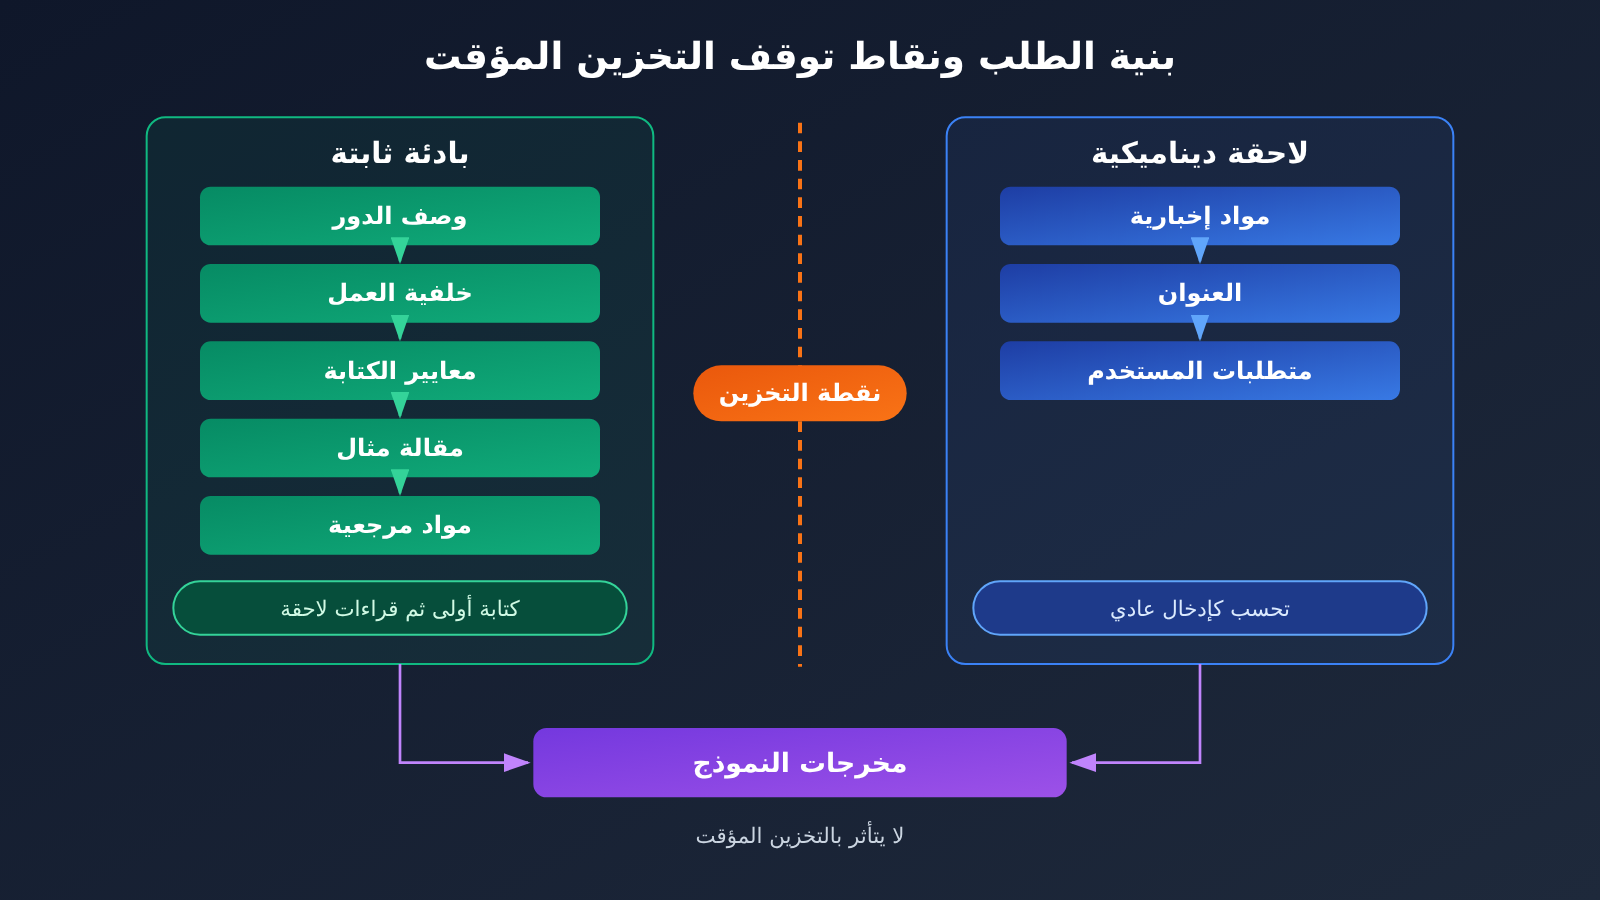
لنأخذ منصة كتابة بالذكاء الاصطناعي كمثال. عند توليد مقال واحد، يتكوّن الطلب من جزئين. الجزء الأول محتوى ثابت: وصف الدور، وخلفية العمل، وقواعد الكتابة، ومقالات نموذجية، والمصطلحات والمواد المرجعية. الجزء الثاني محتوى متغير: مواد أخبار اليوم، وعنوان المقال، ومتطلبات المستخدم المحددة.
يعيد Prompt Caching استخدام الجزء الأول، أي البادئة المتطابقة Tokenًا بتوكن. وتتطلب مطابقة التخزين المؤقت أن يكون تسلسل Token متطابقًا تمامًا؛ فالتشابه الدلالي لا يُعد إصابة. تغيير كلمة واحدة، أو إعادة ترتيب الفقرات، أو إعادة تنظيم تعريفات الأدوات، قد يجعل البادئة محتوى جديدًا، فتفشل بذلك إصابة التخزين المؤقت.
لذلك هناك مبدأ أساسي في تحسين التخزين المؤقت: ضع المحتوى المستقر في المقدمة، والمحتوى المتغير في المؤخرة.
1.2 أي جزء من التكلفة يوفره Prompt Caching؟
يمكن تقسيم فاتورة استدعاء واحد إلى خمسة بنود، ولا يتغير بفضل التخزين المؤقت فيها إلا تكلفة البادئة الثابتة:
| بند التكلفة | دون تخزين مؤقت | بعد تفعيل التخزين المؤقت |
|---|---|---|
| البادئة الثابتة | تُحتسب كمدخل عادي في كل مرة | تُحتسب أول مرة بسعر الكتابة، ثم بسعر القراءة عند الإصابة |
| المدخل الديناميكي | سعر المدخل العادي | سعر المدخل العادي، دون تغيير |
| إخراج النموذج | سعر الإخراج | سعر الإخراج، دون تغيير |
| تكلفة الأدوات | وفق قواعد الأدوات | وفق قواعد الأدوات، دون تغيير |
| التخزين الصريح للتخزين المؤقت (Gemini) | لا يوجد | يُحتسب بشكل منفصل حسب مدة التخزين |
توضح هذه الجدول فرقًا أساسيًا: نسبة التوفير في البادئة الثابتة ونسبة التوفير في الفاتورة الكاملة مؤشران مختلفان. الأولى تقيس فقط مقدار الانخفاض في الجزء المخزّن مؤقتًا، بينما تقيس الثانية مقدار الانخفاض في الفاتورة كاملة. وكلما زاد طول الإخراج، انخفضت النسبة الثانية.
2 ما الفرق بين قواعد التخزين المؤقت للموجه (Prompt Caching) لدى GPT وClaude وGemini؟
2.1 التخزين المؤقت للموجه في OpenAI: 30 دقيقة و12 ساعة
تحدد وثائق OpenAI الخاصة بـ GPT-5.6 والنماذج اللاحقة أن الحد الأدنى لطول البادئة المخزنة مؤقتًا هو عادةً 1,024 توكن من توكنات الإدخال المرئية، وأنها تدعم الوضعين الضمني (implicit) والصريح (explicit). في الوضع الصريح، يضع المطور العلامة prompt_cache_breakpoint داخل كتل محتوى الرسائل المناسبة، ليحدد حدود بادئة التخزين المؤقت بوضوح.
مدة البقاء الافتراضية (TTL) هي 30 دقيقة، ويمكن لواجهة Responses API عبر prompt_cache_options.ttl = "12h" اختيار مدة بقاء لا تقل عن 12 ساعة. وتنقسم الفوترة بين الكتابة والقراءة:
- الكتابة لمدة 30 دقيقة: 1.25 ضعف الإدخال العادي
- الكتابة لمدة 12 ساعة: 2.5 ضعف الإدخال العادي
- القراءة من التخزين المؤقت: 0.1 ضعف الإدخال العادي في معظم النماذج الجديدة، و0.05 ضعف في GPT-6.1 Sol وGPT-6.1 Terra
يمكن استخدام prompt_cache_key للتمييز بين حسابات التخزين المؤقت الخاصة بمستخدمين أو مساحات عمل مختلفة. وفي GPT-5.6 والنماذج اللاحقة، أصبح توجيه التخزين المؤقت يُدار تلقائيًا من قبل الجهة الرسمية.
2.2 التخزين المؤقت للموجهات في Claude: 5 دقائق و1 ساعة
يدعم Claude التخزين المؤقت التلقائي أو الصريح عبر cache_control. المدة الافتراضية للصلاحية هي 5 دقائق، وكل مرة تتحقق فيها إصابة يتم تحديث مدة الصلاحية. تُحسب الخمس دقائق بدءًا من طلب الكتابة إلى ذاكرة التخزين المؤقت أو القراءة منها، ويُحتسب ضمنها أيضًا الوقت المستغرق في توليد الاستجابة. لذلك، في المهام ذات المخرجات الطويلة، يكون الفاصل الزمني المتاح فعليًا أقصر من 5 دقائق.
معاملات الفوترة هي: الكتابة لمدة 5 دقائق ×1.25، والكتابة لمدة ساعة واحدة ×2، والقراءة العادية ×0.1. وفي Claude Sonnet 5.5 وClaude Opus 5.5 ينخفض معدل القراءة إلى ×0.05. سعر الوحدة القياسي لـ Sonnet 5.5 هو: الإدخال 2 دولار، والكتابة لمدة 5 دقائق 2.50 دولار، والكتابة لمدة ساعة واحدة 4 دولارات، والقراءة 0.10 دولار، والإخراج 10 دولارات (جميعها بالدولار لكل مليون توكن).
2.3 التخزين المؤقت للسياق في Gemini: ضمني وصريح
تُفعّل نماذج Gemini 2.5 والأحدث التخزين المؤقت الضمني افتراضيًا، دون حاجة إلى إعداد إضافي. الحد الأدنى للإدخال يختلف حسب النموذج: Gemini 3.8 Flash هو 4,096 توكن، وGemini 2.5 Flash و2.5 Pro هو 2,048 توكن. تنصح Google بوضع المحتوى المشترك في مقدمة الموجه، وإعادة استخدام نفس البادئة خلال فترة زمنية قصيرة.
التخزين المؤقت الصريح يتطلب من المطور إنشاء كائن ذاكرة تخزين مؤقت بنفسه وتحديد مدة بقائه. وتشمل التكلفة ثلاثة أجزاء: المحتوى المخزن مؤقتًا، والقراءات اللاحقة، ومدة التخزين. واجهة Gemini Interactions API تدعم حاليًا التخزين المؤقت الضمني فقط؛ وعند الحاجة إلى كائن تخزين مؤقت صريح، استخدم واجهة generateContent API.
أسعار Gemini 3.8 Flash حتى 31 ديسمبر 2026 هي: الإدخال 0.75 دولار، والإخراج 3.75 دولار، وقراءة ذاكرة التخزين المؤقت 0.075 دولار، وتخزين ذاكرة التخزين المؤقت الصريح 0.50 دولار / مليون توكن / ساعة. وتخطط الجهة الرسمية لتعديلها اعتبارًا من 1 يناير 2027 إلى 1.50 و7.50 و0.15 و1.00 دولار. الأسعار الأربعة تتضاعف بالنسبة نفسها، لذا تبقى نسبة التوفير المحسوبة أدناه كما هي، بينما تتضاعف المبالغ المطلقة.
2.4 مقارنة قواعد التخزين المؤقت للموجهات لدى الشركات الثلاث
| البعد | OpenAI | Claude | Gemini |
|---|---|---|---|
| طريقة التخزين المؤقت | ضمني / نقاط توقف صريحة | cache_control تلقائي / صريح |
ضمني (افتراضي) / كائن تخزين مؤقت صريح |
| مدة البقاء الافتراضية (TTL) | 30 دقيقة (الحد الأدنى لمدة البقاء) | 5 دقائق، تُحدَّث عند الإصابة | الضمني يديره النظام؛ الصريح بمدة محددة ذاتيًا |
| خيار TTL الطويل | 12 ساعة (واجهة Responses API) | ساعة واحدة | تخزين مؤقت صريح قابل للتخصيص |
| سعر الكتابة | 30 دقيقة: 1.25 ضعف؛ 12 ساعة: 2.5 ضعف | 5 دقائق: 1.25 ضعف؛ ساعة: ضعفان | الضمني يُحاسَب كإدخال عادي في المرة الأولى |
| سعر القراءة | 0.1 ضعف (Sol / Terra: 0.05 ضعف) | 0.1 ضعف (Sonnet / Opus 5.5: 0.05 ضعف) | 3.8 Flash: $0.075 / MTok |
| تكاليف إضافية | لا رسوم تخزين | لا رسوم تخزين | التخزين المؤقت الصريح يُحاسَب بالساعة على التخزين |
| أقل بادئة | عادةً 1,024 Token | وفقًا للوثائق الرسمية | 3.8 Flash: 4,096 Token |
3 عند استدعاء النموذج 100 مرة يوميًا، كم يمكن أن يوفّر Prompt Caching فعلاً؟
3.1 شروط الحساب الموحدة
فيما يلي حساب نظري مبني على أسعار الوحدات الرسمية، وليس فاتورة فعلية لمستخدم. الافتراضات الموحدة كالتالي:
- بادئة ثابتة بطول 20,000 Token في كل مرة، وإدخال ديناميكي 500 Token، وإخراج 1,000 Token
- 100 استدعاء يوميًا، مع استخدام النموذج نفسه دائمًا
- المحتوى الديناميكي كله يأتي بعد البادئة الثابتة
- سيناريو التخزين المؤقت: الكتابة في المرة الأولى، ثم 99 إصابة كاملة بعدها؛ وكل الاستدعاءات تتم خلال مدة TTL، أو تُحدَّث مدة الصلاحية باستمرار عند الإصابة
- لا تُحتسب الزيادات التي يفرضها طرف ثالث، ولا الخصومات بالكميات، ولا رسوم الأدوات
- بادئة 20K لا تُفعّل رسوم السياق الطويل الإضافية الخاصة بـ GPT-6 Astra عند تجاوز 272K Token
صيغة الحساب الموحدة هي:
تكلفة البند الواحد = عدد الـ Token × عدد الاستدعاءات ÷ 1,000,000 × سعر الوحدة (دولار / MTok)
تكلفة البادئة بعد التخزين المؤقت = 20,000 × 1 ÷ 1,000,000 × سعر الكتابة + 20,000 × 99 ÷ 1,000,000 × سعر القراءة
3.2 الصيغة الكاملة لـ GPT-6 Astra
سعر وحدة GPT-6 Astra: الإدخال العادي $10، والإخراج $50، والكتابة لمدة 30 دقيقة $12.50، وقراءة التخزين المؤقت $1.
بدون تخزين مؤقت:
- البادئة الثابتة: 20,000 × 100 ÷ 1,000,000 × $10 = $20
- الإدخال الديناميكي: 500 × 100 ÷ 1,000,000 × $10 = $0.50
- الإخراج: 1,000 × 100 ÷ 1,000,000 × $50 = $5
- الإجمالي اليومي: $25.50
تخزين مؤقت لمدة 30 دقيقة:
- الكتابة الأولى: 20,000 ÷ 1,000,000 × $12.50 = $0.25
- 99 قراءة: 20,000 × 99 ÷ 1,000,000 × $1 = $1.98
- الإدخال الديناميكي: $0.50؛ الإخراج: $5
- الإجمالي اليومي: $7.73
إجمالي الفاتورة يوفر $17.77، أي نحو 69.69%. وتنخفض البادئة الثابتة من $20 إلى $2.23، بتوفير نحو 88.85%.
3.3 GPT-6.1 Sol وClaude Sonnet 5.5 وGemini 3.8 Flash
GPT-6.1 Sol (الإدخال $2، والإخراج $10، والكتابة لمدة 30 دقيقة $2.50، والقراءة $0.10):
- بدون تخزين مؤقت: البادئة $4 + الإدخال الديناميكي $0.10 + الإخراج $1 = $5.10
- بعد التخزين المؤقت: الكتابة $0.05 + القراءة $0.198 + الإدخال الديناميكي $0.10 + الإخراج $1 = $1.348
- توفير $3.752، أي نحو 73.57%؛ وتنخفض البادئة من $4 إلى $0.248، بتوفير نحو 93.8%
Claude Sonnet 5.5 (تخزين مؤقت لمدة 5 دقائق) سعر وحدته مطابق لـ GPT-6.1 Sol، وعملية الحساب والنتيجة متطابقتان أيضًا: من $5.10 إلى $1.348. والشرط أن تظل الفترة الفاصلة بين الاستدعاءات تحافظ على صلاحية مدتها 5 دقائق.
Gemini 3.8 Flash (تخزين مؤقت ضمني، ويُحتسب في المرة الأولى كإدخال عادي بـ $0.75):
- بدون تخزين مؤقت: البادئة $1.50 + الإدخال الديناميكي $0.0375 + الإخراج $0.375 = $1.9125
- بعد التخزين المؤقت: البادئة الأولى $0.015 + 99 قراءة $0.1485 + الإدخال الديناميكي $0.0375 + الإخراج $0.375 = $0.576
- توفير $1.3365، أي نحو 69.88%؛ وتنخفض البادئة من $1.50 إلى $0.1635، بتوفير نحو 89.1%
- تفترض هذه النتيجة إصابة كل عمليات التخزين المؤقت الضمني، دون احتساب رسوم تخزين التخزين المؤقت الصريح
3.4 الفرق بين نسبة التوفير في التخزين المؤقت للموجهات والمبلغ المطلق
| النموذج | بدون تخزين مؤقت / يوم | بعد التخزين المؤقت / يوم | التوفير اليومي | توفير 30 يومًا (استقراء) | معدل توفير البادئة | معدل التوفير على الفاتورة الكاملة |
|---|---|---|---|---|---|---|
| GPT-6 Astra | $25.50 | $7.73 | $17.77 | $533.10 | 88.85% | 69.69% |
| GPT-6.1 Sol | $5.10 | $1.348 | $3.752 | $112.56 | 93.8% | 73.57% |
| Claude Sonnet 5.5 | $5.10 | $1.348 | $3.752 | $112.56 | 93.8% | 73.57% |
| Gemini 3.8 Flash | $1.9125 | $0.576 | $1.3365 | $40.10 | 89.1% | 69.88% |
يمكن استخلاص نقطتين من الجدول:
- النسبة تعكس خصم قراءة الذاكرة المؤقتة. سعر القراءة لدى GPT-6.1 Sol وClaude Sonnet 5.5 يساوي 0.05 مرة من سعر الإدخال العادي، لذا يبلغ معدل توفير البادئة 93.8%، وهو أعلى من Astra وGemini حيث سعر القراءة 0.1 مرة.
- المبلغ يعكس أساس سعر الوحدة. نسبة التوفير لدى Astra هي الأدنى، لكنه يوفر $17.77 يوميًا، أي أكثر من 13 ضعف ما يوفره Gemini 3.8 Flash. وكلما ارتفع سعر وحدة النموذج، زاد العائد المطلق لتفعيل التخزين المؤقت.
بعد التخزين المؤقت، ترتفع حصة المخرجات في فاتورة GPT-6 Astra من نحو 20% إلى نحو 65% ($5 ÷ $7.73). عندها يتحول تركيز خفض التكلفة الإضافي إلى التحكم في طول المخرجات. ومن الجدير بالذكر أن استخدام النماذج الأربعة لنفس عدد الرموز (Tokens) هو فقط لتسهيل المقارنة؛ فعند تنفيذ المهمة نفسها، يختلف الطول الفعلي للمخرجات ودقة الإجابات من نموذج لآخر.
💡 نصيحة لاختيار النموذج: عندما تكون النسب متقاربة، أولِ الأولوية لموازنة المبلغ المطلق الموفر يوميًا مع جودة المهمة. يُنصح أولاً باستدعاء عدة نماذج مرشحة في APIYI apiyi.com باستخدام القالب نفسه، وتسجيل طول المخرجات الفعلي ورموز التخزين المؤقت، ثم إدخالها في المعادلة أعلاه لتقدير الميزانية الشهرية.
4 لماذا قد تظل فاتورة التخزين المؤقت للموجه مرتفعة رغم تكرار الموجه نفسه كل يوم؟
4.1 مدة TTL وتكرار الاستدعاء يحددان معدل الإصابة
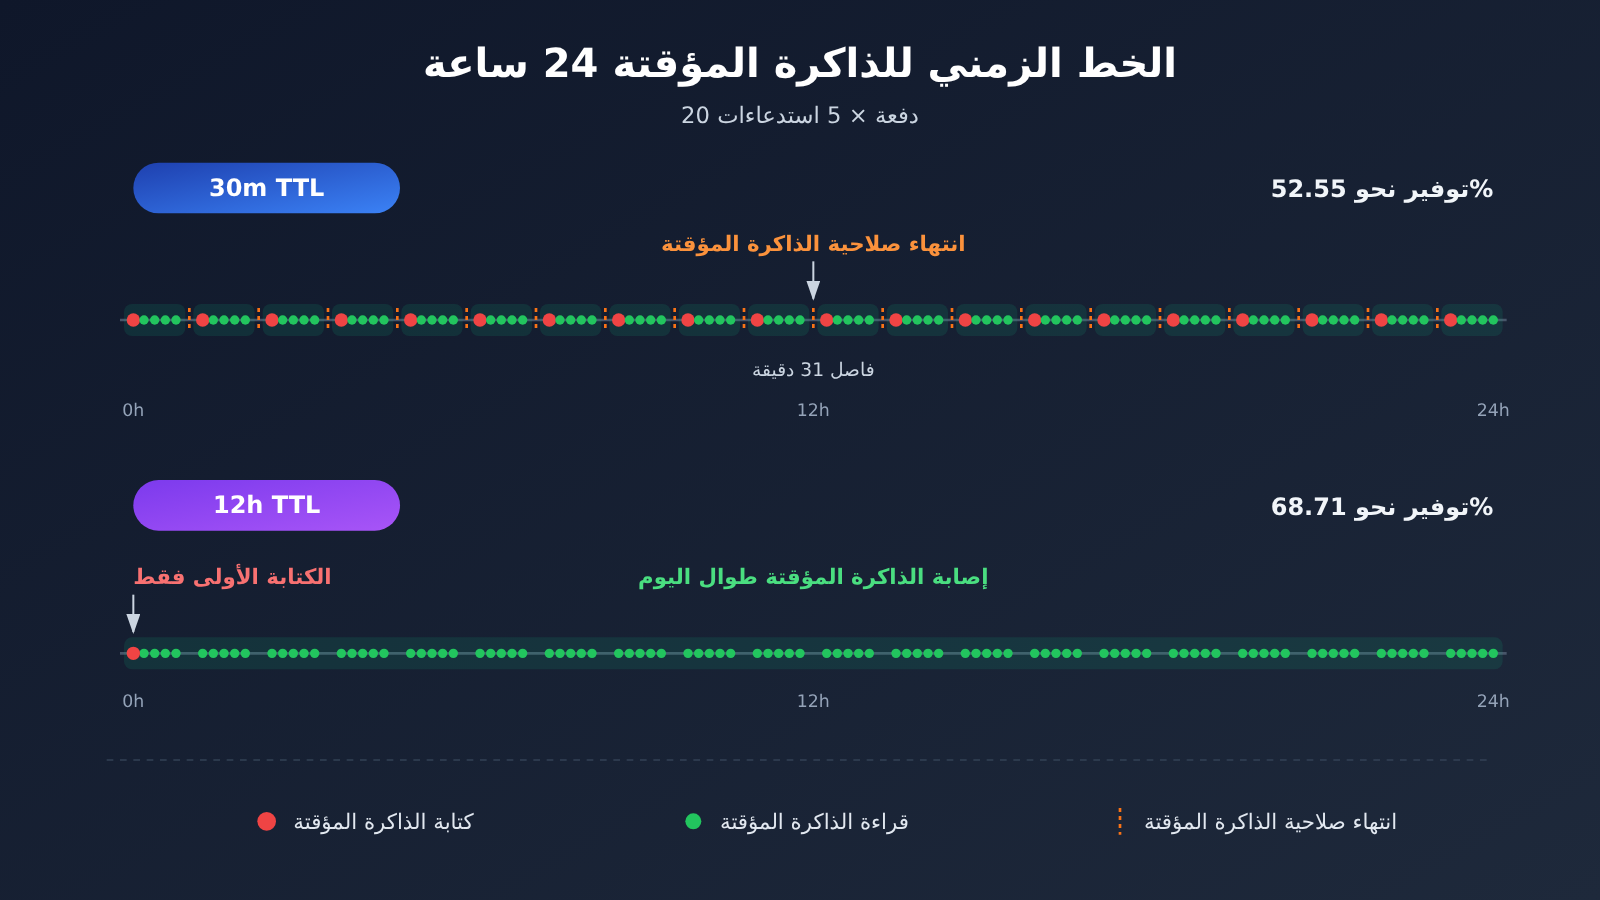
استدعاء النموذج 100 مرة يوميًا لا يعني أن كتابة واحدة تغطي اليوم بأكمله. فيما يلي مثال GPT-6 Astra: 20 دفعة يوميًا، وفي كل دفعة 5 استدعاءات متتالية، والفاصل الزمني بين الدفعتين 31 دقيقة.
| السيناريو | عدد مرات الكتابة والتكلفة | عدد مرات القراءة والتكلفة | تكلفة البادئة | بإضافة الإدخال والإخراج الديناميكي | الإجمالي اليومي | نسبة التوفير |
|---|---|---|---|---|---|---|
| بدون تخزين مؤقت | — | — | $20 | $5.50 | $25.50 | — |
| A: تخزين مؤقت لمدة 30m | 20 × $0.25 = $5 | 80 × $0.02 = $1.60 | $6.60 | $5.50 | $12.10 | حوالي 52.55% |
| B: تخزين مؤقت لمدة 12h (داخل النافذة نفسها) | 1 × $0.50 | 99 × $0.02 = $1.98 | $2.48 | $5.50 | $7.98 | حوالي 68.71% |
في السيناريو A، يتجاوز الفاصل بين الدفعات 30 دقيقة، لذا يجب إعادة الكتابة مع كل دفعة، فتنخفض نسبة التوفير من 69.69% المثالية إلى 52.55%. سعر الكتابة الواحدة في السيناريو B هو ضعف سعر 30m، لكنه يُكتب مرة واحدة فقط طوال اليوم، لذا يكون أكثر اقتصادية للاستدعاءات المتباعدة. خطة 12h تغطي النافذة نفسها فقط، وليس هناك ضمان بإمكانية إعادة استخدام التخزين المؤقت نفسه في اليوم التالي. المهام التي تستدعي النموذج مرة أو مرتين فقط يوميًا لا يمكنها تحقيق تخزين مؤقت يمتد بين الأيام بمجرد الاعتماد على الموجه نفسه.
يمكن تحديد نقطة التعادل لأنواع TTL المختلفة بالنظر إلى البادئة الثابتة فقط، مع احتساب الإدخال العادي كمعامل 1:
| الخطة | معامل الكتابة | معامل القراءة | كتابة 1 + قراءة 1 مقابل 2 بدون تخزين مؤقت | كتابة 1 + قراءة 2 مقابل 3 بدون تخزين مؤقت | القراءات الصالحة اللازمة لاسترداد التكلفة |
|---|---|---|---|---|---|
| OpenAI 30m | 1.25 | 0.1 | 1.35 < 2 | — | مرة واحدة |
| OpenAI 12h | 2.5 | 0.1 | 2.6 > 2 | 2.7 < 3 | مرتان |
| Claude Sonnet 5.5 · 5m | 1.25 | 0.05 | 1.30 < 2 | — | مرة واحدة |
| Claude Sonnet 5.5 · 1h | 2 | 0.05 | 2.05 > 2 | 2.10 < 3 | مرتان |
الاستنتاج واضح: يكفي أن يصيب التخزين المؤقت قصير TTL مرة واحدة لاسترداد التكلفة؛ أما TTL الطويل فيحتاج إلى إصابتين على الأقل ضمن مدة الصلاحية.
4.2 نقاط توقف التخزين المؤقت وترتيب الموجهات
السبب الأكثر شيوعًا لفشل التخزين المؤقت هو تغيير البادئة المستقرة. إذا وضعت الطوابع الزمنية أو معرفات المستخدم أو عناوين المهام أو المواد اللحظية في بداية الموجه، فستصبح بادئة كل طلب محتوى جديدًا، ولن تحقق أي إصابة في التخزين المؤقت.
في الوضع الضمني لدى OpenAI، إذا كان الطلب الأول قد أدخل المحتوى الديناميكي ضمن نطاق التخزين المؤقت، فقد لا تصيب الطلبات اللاحقة البادئة المستقرة المتوقعة بمجرد تغير المحتوى الديناميكي. الحل هو وضع نقطة توقف تخزين مؤقت صريحة عند نهاية المحتوى المستقر.
وهناك أسباب شائعة أخرى:
- تبديل النموذج أو المزود أو مؤسسة الخدمة، أو تعديل بعض المعاملات
- قيام الوكيل بضغط المحادثة أو إعادة ترتيب تعريفات الأدوات أو تعديل الرسائل السابقة، ما يعيد كتابة البادئة القابلة لإعادة الاستخدام
- عدم تمرير بوابة طرف ثالث معاملات التخزين المؤقت، أو عدم احتساب خصم التخزين المؤقت في الفاتورة
4.3 تأثير توكنات الإخراج وتكاليف الأدوات
التخزين المؤقت يؤثر على بادئة الإدخال فقط. في مثال Astra الوارد في 3.2، حتى لو انخفضت تكلفة البادئة إلى الصفر، فلن تقل الفاتورة عن $5.50 (الإدخال الديناميكي بالإضافة إلى الإخراج). أما المهام ذات الإخراج الطويل والاستدعاءات الكثيرة للأدوات، فسيكون الانخفاض في الفاتورة الكاملة أقل بوضوح من نسبة التوفير في البادئة. لذلك، بعد تفعيل التخزين المؤقت، لا يزال عليك التحكم في طول الإخراج وتقليل استدعاءات الأدوات.
5 كيف تُعدّ تطبيقات الذكاء الاصطناعي التخزين المؤقت للموجهات (Prompt Caching) وتراقبه؟
5.1 طريقة تنظيم البادئة الثابتة واللاحقة الديناميكية
رتّب المحتوى وفق ترتيب «تكرار التغير من الأقل إلى الأعلى»:
- تعريفات الأدوات: حافظ على ترتيب ثابت ووصف ثابت، ولا تُضِف أو تحذف عناصر ديناميكيًا حسب الطلب
- قواعد النظام ومعايير الكتابة: وصف الدور، معايير العلامة التجارية، متطلبات الأسلوب
- نماذج كتابة مرجعية وقاعدة معرفة: مستندات مرجعية مطولة، تُستبدل بالكامل عند تحديث الإصدار
- (نقطة فاصل التخزين المؤقت)
- مواد ديناميكية: أخبار اليوم، نتائج البحث، مدخلات المستخدم
- تعليمات المهمة الحالية: العنوان، عدد الكلمات، المتطلبات المحددة
يبدأ المثال التالي الاستدعاء عبر واجهة OpenAI المتوافقة، ويقرأ رموز التخزين المؤقت (Token) من الاستجابة:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة OpenAI المتوافقة من APIYI
)

STABLE_PREFIX = """你是一名技术博客作者……(写作规范、范文、术语表,约 20K Token,内容逐字固定)"""

resp = client.chat.completions.create(
    model="gpt-6.1-sol",  # اسم النموذج الفعلي وفق قائمة النماذج في المنصة
    messages=[
        {"role": "system", "content": STABLE_PREFIX},          # توضع البادئة الثابتة أولاً
        {"role": "user", "content": "今日材料:……\n标题:……"},  # يوضع المحتوى الديناميكي لاحقًا
    ],
)
details = getattr(resp.usage, "prompt_tokens_details", None)
cached = getattr(details, "cached_tokens", 0) or 0
print(f"输入 {resp.usage.prompt_tokens},命中缓存 {cached}")
عرض الشيفرة الكاملة: حاسبة التكلفة + إحصاءات معدل إصابة التخزين المؤقت
from openai import OpenAI

M = 1_000_000

def daily_cost(prefix, dynamic, output, calls,
               p_in, p_out, p_write, p_read,
               writes=1, use_cache=True):
    """يحسب التكلفة اليومية (بالدولار) وفق أسعار الوحدات الرسمية، ويعيد (البادئة، المدخلات الديناميكية، المخرجات، الإجمالي)"""
    dyn = dynamic * calls / M * p_in
    out = output * calls / M * p_out
    if use_cache:
        pre = prefix * writes / M * p_write + prefix * (calls - writes) / M * p_read
    else:
        pre = prefix * calls / M * p_in
    return round(pre, 4), round(dyn, 4), round(out, 4), round(pre + dyn + out, 4)

MODELS = {
    # الاسم: (الإدخال، الإخراج، الكتابة، القراءة)  دولار / مليون توكن، تاريخ المراجعة 2026-11-13
    "GPT-6 Astra (30m)":   (10,   50,   12.5, 1),
    "GPT-6.1 Sol (30m)":   (2,    10,   2.5,  0.10),
    "Claude Sonnet 5.5":   (2,    10,   2.5,  0.10),
    "Gemini 3.8 Flash":    (0.75, 3.75, 0.75, 0.075),  # التخزين المؤقت الضمني يُحسب في المرة الأولى كإدخال عادي
}

for name, (p_in, p_out, p_w, p_r) in MODELS.items():
    base = daily_cost(20000, 500, 1000, 100, p_in, p_out, p_w, p_r, use_cache=False)[-1]
    cached = daily_cost(20000, 500, 1000, 100, p_in, p_out, p_w, p_r)[-1]
    print(f"{name}: ${base} -> ${cached},节省 {(base - cached) / base:.2%}")

# السيناريو أ: Astra 30m، 20 دفعة تحتاج كل منها إلى إعادة كتابة
a = daily_cost(20000, 500, 1000, 100, 10, 50, 12.5, 1, writes=20)[-1]
print(f"Astra 分批 30m: ${a}")  # 12.1

# ---- إحصاء نسبة الإصابة في بيئة الإنتاج ----
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

def run_and_track(stable_prefix, dynamic_inputs, model="gpt-6.1-sol"):
    total_in = total_cached = 0
    for text in dynamic_inputs:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "system", "content": stable_prefix},
                      {"role": "user", "content": text}],
        )
        d = getattr(r.usage, "prompt_tokens_details", None)
        total_in += r.usage.prompt_tokens
        total_cached += (getattr(d, "cached_tokens", 0) or 0)
    hit = total_cached / total_in if total_in else 0
    print(f"实际缓存命中率:{hit:.2%}")
    return hit
🚀 نصيحة للبدء السريع: ابدأ بتقدير الميزانية باستخدام الحاسبة أعلاه، ثم شغّل قالبًا حقيقيًا في 10 إلى 20 استدعاءً وراقب ما إذا كان
cached_tokensيظهر بثبات ابتداءً من الاستدعاء الثاني. يمكن للمستخدمين الجدد الحصول على حصة تجريبية مجانية من APIYI عبر apiyi.com لإتمام هذه الخطوة من التحقق، وبعد التأكد من تحقق الإصابة في التخزين المؤقت يمكن زيادة حجم الاستخدام.
5.2 اختيار TTL لذاكرة التخزين المؤقت للموجه ونمط التخزين المؤقت
- الاستدعاءات المتكررة عالية التردد (الفاصل الزمني مستقر داخل بضع دقائق): استخدم TTL قصيرًا افتراضيًا، أي OpenAI 30m وClaude 5m. تكفي إصابة واحدة لاسترداد التكلفة، ورسوم الكتابة هي الأدنى. يحتاج Claude إلى احتساب مدة توليد الاستجابة ضمن نافذة الـ 5 دقائق.
- الاستدعاءات الموزعة على مدار اليوم (الفاصل بين الدفعات يتجاوز 30 دقيقة): قيّم OpenAI 12h أو Claude 1h. طالما يمكن تحقيق إصابتين أو أكثر داخل النافذة، فإن الـ TTL الطويل أرخص من إعادة الكتابة المتكررة، والسيناريو B في 4.1 هو المثال على ذلك.
- مهام Gemini ذات البادئة الطويلة جدًا والتي تحتاج إلى إعادة استخدام عبر فترة زمنية أطول: قيّم التخزين المؤقت الصريح، مع احتساب رسوم التخزين أيضًا. بأخذ Gemini 3.8 Flash كمثال، فإن رسوم تخزين 20K Token لمدة 12 ساعة هي 0.02 × $0.50 × 12 = $0.12. في حمل العمل الخاص بهذا المقال، تُعد هذه التكلفة ملحوظة نسبيًا مقارنة بفاتورة يومية قدرها $0.576. إذا كانت إصابات التخزين المؤقت الضمني جيدة، فابقَ على الإعداد الافتراضي.
- البادئة تتغير كثيرًا: ثبّت البادئة أولاً، ثم فكّر في TTL. عندما تكون البادئة غير مستقرة، لن يجلب أي TTL أي إصابات.
5.3 مراجعة نسبة الاستفادة الفعلية من Prompt Caching والفاتورة
حقول usage لدى المزوّدين الثلاثة هي:
- OpenAI (Responses API):
usage.input_tokens،usage.input_tokens_details.cached_tokens،usage.input_tokens_details.cache_write_tokens - Claude:
usage.input_tokens،usage.cache_creation_input_tokens،usage.cache_read_input_tokens - Gemini: حقول usage في API المقابل، مثل
total_cached_tokens؛ أما التخزين المؤقت الصريح فتُحتسب عليه رسوم تخزين كائنات منفصلة
يُنصح بمتابعة مؤشرين باستمرار:
نسبة الاستفادة الفعلية من ذاكرة التخزين المؤقت = توكنات قراءة ذاكرة التخزين المؤقت ÷ إجمالي توكنات الإدخال
مبلغ التوفير الفعلي = التكلفة الأساسية دون تخزين مؤقت − تكلفة فاتورة API الفعلية
تُحسب التكلفة الأساسية دون تخزين مؤقت وفق النموذج نفسه، وحمل العمل نفسه، وحجم الإخراج نفسه؛ وإلا فإن مبلغ التوفير لن يكون قابلًا للمقارنة. عند التحقق من الفاتورة في لوحة تحكم APIYI apiyi.com، يمكنك مقارنة ملخص usage للفترة نفسها بتفاصيل الخصم بندًا ببند، والتأكد من أن توكنات ذاكرة التخزين المؤقت تُحاسب بسعر ذاكرة التخزين المؤقت.
6 سيناريو APIYI: كيف نتحكم في التكلفة باستخدام Prompt Caching مع القوالب الثابتة والإنتاج الدفعي بالذكاء الاصطناعي؟
من الأعمال النموذجية التي تناسب Prompt Caching: منصات كتابة بالذكاء الاصطناعي تشغّل قالب مقال ثابتًا كل يوم، وأنظمة Agent تعيد تحميل تعريفات الأدوات نفسها، وأنظمة تحليل مواد تعيد الاستشهاد بالمستند المرجعي الكبير نفسه عدة مرات، وتوليد محتوى دفعي يتشارك معايير العلامة التجارية وإرشادات أسلوب الكتابة. تشترك هذه المهام في نقطة واحدة: بادئة طويلة، ونسبة تكرار عالية، وحجم استدعاءات كبير، وهي بالضبط المنطقة التي تعطي فيها ذاكرة التخزين المؤقت أعلى فائدة.
في مثل هذه السيناريوهات، يمكن بناء قرار التكلفة على ثلاثة معايير:
- هل يدعم النموذج قدرات التخزين المؤقت المطلوبة؟ ويشمل ذلك الحد الأدنى لطول البادئة، وTTL الاختياري، ومضاعف خصم القراءة. النماذج التي تُحاسب قراءة ذاكرة التخزين المؤقت فيها بـ 0.05 ضعف تحقق نسبة توفير أعلى في مهام البادئات الطويلة.
- هل يتوافق الموجه وTTL مع حمل العمل؟ المعالجة على دفعات متواصلة تستخدم TTL قصيرًا؛ أما المهام الموزعة وفق جدول زمني فتُقيّم TTL طويلًا، ويُحسب عدد الاستدعاءات اللازمة للوصول إلى نقطة التعادل باستخدام معادلة القسم 4.1.
- هل يدعم مزوّد API التخزين المؤقت بالكامل ويحاسب وفق تكلفة التخزين المؤقت الفعلية؟ إن دعم المزوّد الأعلى (upstream) للتخزين المؤقت ليس إلا شرطًا ضروريًا واحدًا لخفض التكلفة. تحتاج البوابة أيضًا إلى تمرير معلمات التخزين المؤقت بشكل صحيح، والإبلاغ عن توكنات ذاكرة التخزين المؤقت ضمن usage، وإظهار سعر ذاكرة التخزين المؤقت في الفاتورة.
عند الاستدعاء عبر APIYI apiyi.com، يُنصح بتحويل البند 3 إلى خطوة تحقق ثابتة: استدعِ القالب نفسه بحجم 20K عدة مرات متتالية، وافحص حقول ذاكرة التخزين المؤقت في usage، ثم قارنها بخصم الفاتورة. بعد التأكد من نجاح التخزين المؤقت تقنيًا ومن انعكاسه فعليًا في الفاتورة، استخدم نتيجة الحساب أعلاه أساسًا للميزانية الشهرية.
الأسئلة الشائعة FAQ
س1: ما هو Prompt Caching؟
يقوم بتخزين البادئة المتطابقة التي سبق معالجتها داخل الموجه، وعند إصابة الطلب اللاحق بها تتم الفوترة بسعر أقل بكثير من الإدخال العادي. يشترط أن تتطابق الـ Tokens حرفيًا، لذا يناسب السيناريوهات التي تعتمد على قوالب ثابتة وقواعد معرفة ثابتة وتعريفات أدوات ثابتة.
س2: لماذا تنخفض تكلفة البادئة بأكثر من 90% بينما تنخفض الفاتورة الكاملة بنحو 70% فقط؟
التخزين المؤقت يطبق فقط على البادئة الثابتة، بينما يظل الإدخال الديناميكي والإخراج مفوترة بالسعر الأصلي. على سبيل المثال مع GPT-6.1 Sol، من فاتورة يومية مقدارها $1.348 بعد التخزين المؤقت، يمثل الإخراج $1 والإدخال الديناميكي $0.10. كلما زاد طول الإخراج، انخفضت نسبة التوفير في الفاتورة الكاملة.
س3: إذا كنت أستدعي النموذج مرة أو مرتين فقط يوميًا، فهل يستحق تفعيل التخزين المؤقت؟
العائد ضئيل جدًا. يتطلب التخزين المؤقت 12h في OpenAI و1h في Claude حدوث إصابتين على الأقل خلال فترة الصلاحية لاسترداد التكلفة، ولا يوجد ضمان لإعادة الاستخدام عبر الأيام. الطريقة الأكثر فاعلية هي تجميع المهام المتشابهة وتنفيذها دفعة واحدة في الفترة نفسها، لزيادة عدد الإصابات داخل النافذة.
س4: هل أختار 30m أم 12h؟
يعتمد ذلك على الفاصل الزمني بين الاستدعاءات. إذا كان الفاصل مستقرًا داخل 30 دقيقة، فاستخدم 30m؛ إصابة واحدة تكفي لاسترداد التكلفة. وإذا كانت الفواصل بين الدفعات أطول وموزعة على مدار اليوم، فاستخدم 12h. على سبيل المثال، عند استدعاء GPT-6 Astra على 20 دفعة، تكون التكلفة اليومية مع 12h هي $7.98، ومع 30m هي $12.10.
س5: عند الاستدعاء عبر منصة تجميع API، هل يظل التخزين المؤقت فعالاً؟
يعتمد ذلك على طريقة المنصة في تمرير معلمات التخزين المؤقت وتنفيذ الفوترة. نوصي باستخدام حصة اختبار مجانية على APIYI apiyi.com لاستدعاء القالب نفسه على التوالي، وفحص الحقول مثل `cached_tokens` في usage، ومطابقتها مع تفاصيل الخصم. بعد التأكد من أن التخزين المؤقت يتحقق فعلًا ويُفوتر بسعر التخزين المؤقت، استخدمه على نطاق واسع.
س6: إذا انخفض معدل إصابة التخزين المؤقت فجأة، فأين أفحص أولاً؟
افحص بالترتيب التالي: هل تسلل محتوى ديناميكي مثل الطوابع الزمنية والمعرفات إلى البادئة؛ هل تغير ترتيب تعريفات الأدوات؛ هل قام Agent بضغط رسائل السجل أو إعادة كتابتها؛ هل تم تبديل النموذج أو المعلمات؛ هل تجاوز الفاصل بين الاستدعاءات مدة TTL. استخدم صيغة معدل الإصابة في القسم 5.3 للإحصاء بالساعة، فستتمكن من تحديد وقت حدوث التغيير بسرعة.
س7: كيف أختار بين التخزين المؤقت الضمني والتخزين المؤقت الصريح في Gemini؟
التخزين المؤقت الضمني مفعّل افتراضيًا، ولا توجد رسوم تخزين، ويُستخدم أولًا عندما تتجاوز البادئة الحد الأدنى لطول النموذج (4,096 Token في 3.8 Flash). يناسب التخزين المؤقت الصريح المحتوى الطويل جدًا الذي يحتاج إلى إعادة استخدام مؤكدة، لكنه يتطلب دفع رسوم تخزين بالساعة واستخدام generateContent API. تدعم Interactions API حاليًا التخزين المؤقت الضمني فقط.
الملخص
النقاط الأساسية لتخزين الموجهات المؤقت (Prompt Caching):
- أين يتحقق التوفير: يقلل فقط من تكلفة البادئة الثابتة. في حملة العمل هذه، بلغت نسبة التوفير في البادئة 88.85%–93.8%، وفي الفاتورة الكاملة 69.69%–73.57%.
- كم يبلغ التوفير: ينخفض GPT-6.1 Sol وClaude Sonnet 5.5 يوميًا من $5.10 إلى $1.348، وGPT-6 Astra من $25.50 إلى $7.73. وكلما ارتفع سعر الوحدة، زاد التوفير المطلق.
- أي وتيرة هي الأفضل: الاستدعاءات عالية التكرار والمتواصلة وذات البادئة الطويلة. مع TTL القصير تكفي إصابة واحدة (hit) لاسترداد التكلفة، بينما يحتاج TTL الطويل إلى إصابتين.
- كيف تطبقه عمليًا: ضع المحتوى الثابت أولًا والمحتوى المتغير بعده، ثم ضع نقطة توقف في نهاية المحتوى الثابت؛ واختر TTL وفق إيقاع الاستدعاء؛ وراقب باستمرار نسبة الإصابة عبر حقل usage.
- شرط التطبيق: يجب أن تتحقق الإصابة تقنيًا في ذاكرة التخزين المؤقت، وأن تُحتسب الفاتورة بسعر التخزين المؤقت.
نوصي أولًا بحساب الميزانية باستخدام الحاسبة الواردة في المقال، ثم التحقق من نسبة الإصابة والخصم الفعلي باستخدام قالب حقيقي على APIYI apiyi.com، وبعد تأكيد الأمرين معًا يمكنك التوسع في الاستخدام.
📚 المراجع
- دليل التخزين المؤقت للموجهات في OpenAI: أنماط التخزين المؤقت، نقاط التوقف، مدة الصلاحية، ومضاعفات الفاتورة
- الرابط:
developers.openai.com/api/docs/guides/prompt-caching -
الوصف: شرح المعاملين
prompt_cache_optionsوprompt_cache_breakpoint -
نماذج OpenAI والأسعار: أسعار GPT-6 Astra وGPT-6.1 Sol
- الرابط:
developers.openai.com/api/docs/pricing - الرابط:
developers.openai.com/api/docs/models/gpt-6-astra - الرابط:
developers.openai.com/api/docs/models/gpt-6.1-sol -
الوصف: تعرفة السياق القصير القياسية، تاريخ التحقق 2026-11-13
-
وثائق التخزين المؤقت للموجهات في Claude:
cache_control، ومضاعفات الكتابة والقراءة لـ 5m / 1h - الرابط:
platform.claude.com/docs/en/build-with-claude/prompt-caching - الرابط:
platform.claude.com/docs/en/models/sonnet-5-5/overview -
الوصف: قراءة التخزين المؤقت في Sonnet 5.5 بمعدل 0.05 ضعف
-
التخزين المؤقت للسياق في Gemini والأسعار: التخزين المؤقت الضمني والصري، رسوم التخزين، وتعديل الأسعار في 2027
- الرابط:
ai.google.dev/gemini-api/docs/caching - الرابط:
ai.google.dev/gemini-api/docs/pricing - الوصف: الحد الأدنى لطول التخزين المؤقت لكل نموذج ونطاق الدعم في API
المؤلف: فريق APIYI التقني
للتواصل التقني: يمكنك التواصل معنا من خلال الصفحة الرئيسية لموقع APIYI، ولمزيد من مواد التكامل يمكنك زيارة مركز الوثائق docs.apiyi.com


