
結論:AI記事のAPIコストは、まず呼び出し、次に完成品を計算
本稿の価格スナップショットに基づくと、入力1万、出力3000 Tokenで、1回生成の理論コストは約 0.0066~0.10米ドル です。公開可能な記事を1本完成させるには、修正、検証、ツール呼び出し、人手による編集のコストも積み重なります。
本当に比較すべきは「1本の合格コスト」です。本稿では同じ入出力量で7モデルを比較し、チャネル、キャッシュ、推論、修正ラウンドが請求額をどう変えるかを解説します。
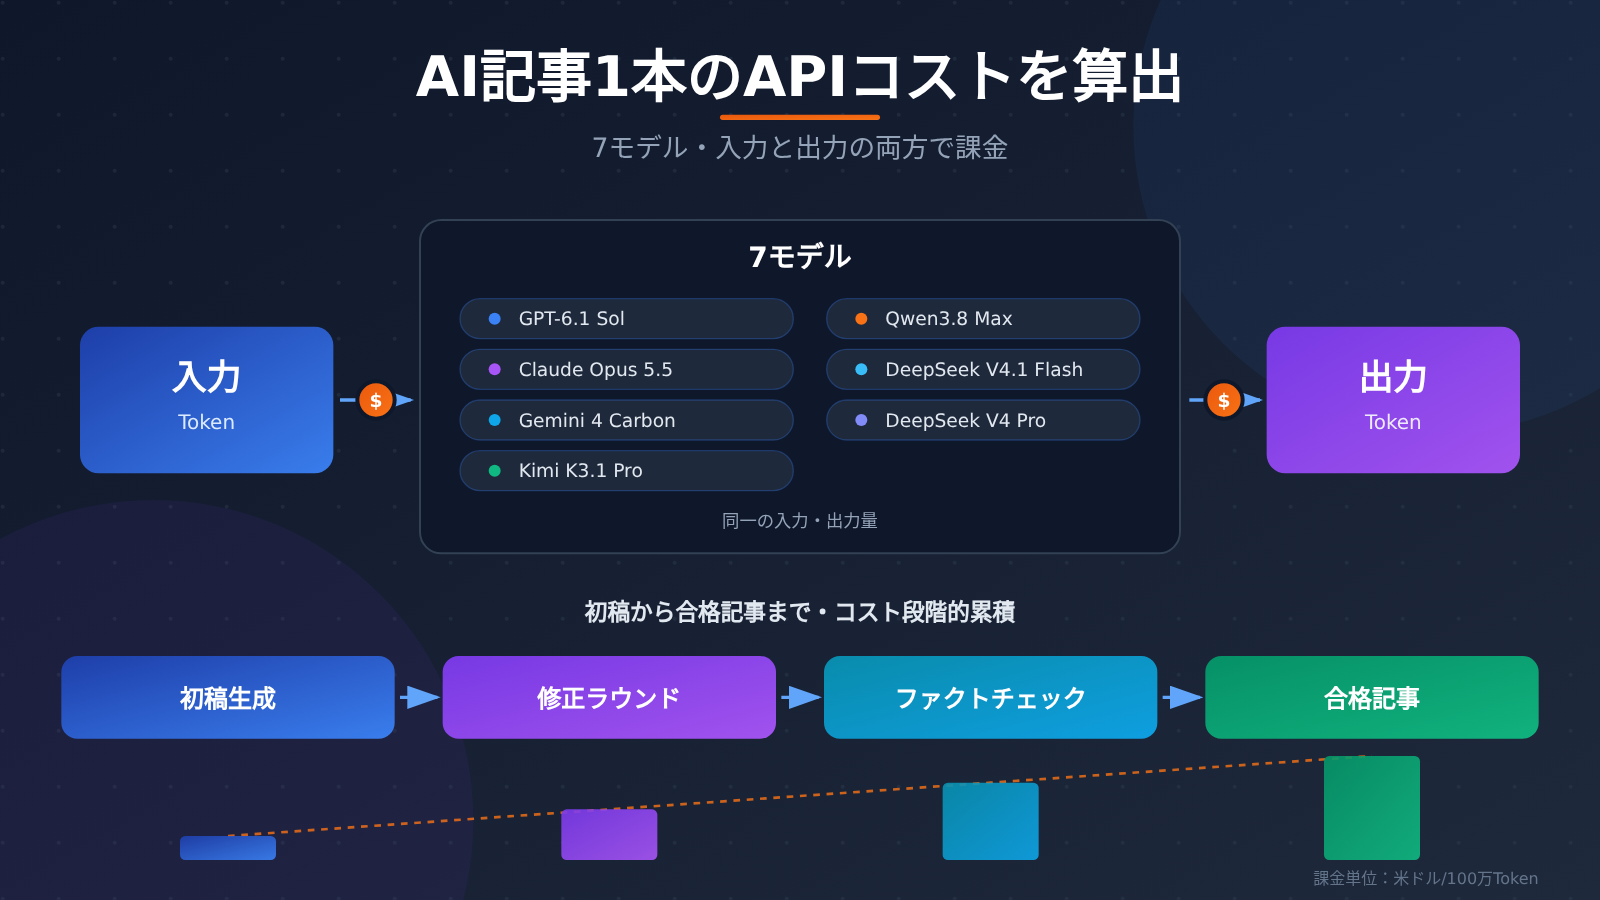
この後で解説する内容:AI記事のAPIコスト試算ルート
- 入力・出力・課金計算式を理解する。
- 7モデルを3種類のタスク規模で費用比較する。
- プラットフォーム表示価格、公式の地域別価格、時間帯ルールを区別する。
- 呼び出し記録と編集時間から制作案を決める。
すぐに始めるためのヒント:APIYI apiyi.com の統一インターフェースから、同じ資料パッケージをテストできます。新規ユーザーには無料テスト枠があります。具体的な枠と適用ルールは、プラットフォームの最新説明に従ってください。
AI記事のAPIコスト:まず計量の基準を統一する
Token はAPIでテキストを計量する単位であり、中国語の文字数との間に固定の換算比率はありません。資料一式、プロンプト、記事の企画、送信済みの会話履歴は、いずれも入力Tokenを消費します。
入力価格と出力価格は通常、「米ドル/100万Token」で表示されます。本稿のすべてのシミュレーションでは通常の入力・出力単価を用い、キャッシュ、追加推論、ボリュームディスカウント、ツール費用は除外します。
計算式は次のとおりです。
$$
C=\frac{T_{\text{入力}}}{1{,}000{,}000}P_{\text{入力}}
+\frac{T_{\text{出力}}}{1{,}000{,}000}P_{\text{出力}}
$$
GPT-6.1 Solを例に、入力1万、出力3000 Tokenの場合:
$$
C=0.01\times2+0.003\times10=0.05\text{米ドル}
$$
この費用で得られるのは1回分の生成結果です。記事をそのまま公開できるかどうかは、事実、構成、文体が基準を満たしているかで決まり、請求書が編集者の署名を代わることはありません。
AI記事のAPIコスト:7モデルの入力・出力価格を比較
以下の表は、APIYI apiyi.com の2026年11月12日10:45(UTC+8)時点の価格スナップショットに基づいています。単位はすべて米ドル/100万Tokenで、課金方式は使用量に応じたToken課金です。
| モデル | 入力価格 | 出力価格 | 出力/入力単価比 |
|---|---|---|---|
| GPT-6.1 Sol | 2.00 | 10.00 | 5倍 |
| Claude Opus 5.5 | 4.00 | 20.00 | 5倍 |
| Gemini 4 Carbon | 2.00 | 10.00 | 5倍 |
| Kimi K3.1 Pro | 2.00 | 10.00 | 5倍 |
| Qwen3.8 Max | 1.65 | 4.95 | 3倍 |
| DeepSeek V4.1 Flash | 0.30 | 1.20 | 4倍 |
| DeepSeek V4 Pro | 1.32 | 3.96 | 3倍 |
| 比較項目 | 接続の説明 |
|---|---|
| 利用可能なプラットフォーム | APIYI apiyi.com;各社公式API。リージョンと課金ルールはそれぞれ確認が必要 |
出力Tokenは通常より高価ですが、資料一式が非常に長い場合、入力費用も主要な支出になります。そのため、モデル選定では記事の長さだけに注目するのではなく、入力・出力の両方の価格列を確認すべきです。
AI記事のAPIコスト:公式直結ではどのような価格差がある?
以下は2026年11月12日時点で確認した公式直結のルールです。チャネル間の差異を確認するためのもので、上記のプラットフォーム価格表には反映していません。
| モデル/チャネル | 公式価格またはルール |
|---|---|
| GPT-6.1 Sol、Standard | 入力2、出力10 |
| Claude Opus 5.5、標準呼び出し | 入力4、出力20 |
| Gemini 4 Carbon、標準呼び出し | 紹介期間は11月30日まで、入力2、出力10;12月1日から入力4、出力20 |
| Qwen3.8 Max、北京/米国バージニアGlobal | 入力1.65、出力4.951 |
| Qwen3.8 Max、シンガポールInternational | 入力2、出力6 |
| Kimi K3.1 Pro、Alibaba Cloud北京/シンガポール | それぞれ1.837/9.611、2/10 |
| DeepSeek、2モデル | ピーク時の価格は上表の数値と一致、非ピーク時は半額 |
Geminiの価格改定はGoogle公式直結に適用されます。サードパーティチャネルでは各社の告知を確認してください。Qwenのプラットフォーム出力価格4.95と、公式の一部リージョンにおける4.951は、それぞれ別個に保持すべきです。
DeepSeek公式のピーク時は、平日の北京時間09:00—12:00、14:00—18:00です。その他の時間帯および週末は非ピーク時のルールで処理され、法定休日は別途計算されます。
公式の非ピーク時単価では、Flashは入力0.15、出力0.60;Proは入力0.66、出力1.98です。時間帯をずらすことで得られるメリットは、実際のチャネルがこのルールを適用しているかどうかに左右されます。
AI記事のAPIコスト:資料規模と3回修正の計算方法
まず2つの資料規模を比較します。以下はすべて理論シミュレーションであり、出力トークンはモデルが計量する長さを表し、中国語の文字数ではありません。
| モデル | 5万入力+5000出力 | 10万入力+1万出力 | 3回累計 |
|---|---|---|---|
| GPT-6.1 Sol | 0.15000 | 0.30000 | 0.16200 |
| Claude Opus 5.5 | 0.30000 | 0.60000 | 0.32400 |
| Gemini 4 Carbon | 0.15000 | 0.30000 | 0.16200 |
| Kimi K3.1 Pro | 0.15000 | 0.30000 | 0.16200 |
| Qwen3.8 Max | 0.10725 | 0.21450 | 0.10395 |
| DeepSeek V4.1 Flash | 0.02100 | 0.04200 | 0.02160 |
| DeepSeek V4 Pro | 0.08580 | 0.17160 | 0.08316 |
単位:ドル。3列はいずれも前述のプラットフォームのスナップショットを使用し、キャッシュやその他の費用は含みません。
5万入力・5000出力のGPTタスクを例にします:
$$
C=0.05\times2+0.005\times10=0.15\text{ドル}
$$
うち入力費用は0.10ドル、出力費用は0.05ドルです。資料を大量に扱うタスクでは、数段落の本文を圧縮するよりも、入力資料を整理することを優先して検討した方がよいことがよくあります。
「3回累計」は次の独立呼び出しフローを採用しています:
- 初稿:入力10000、出力3000トークン。
- 修正:資料パッケージ+初稿、入力13000、出力3000トークン。
- 最終稿:資料パッケージ+前バージョン、入力13000、出力3000トークン。
合計入力36000、出力9000トークン。GPTの対応費用は次のとおりです:
$$
C=0.036\times2+0.009\times10=0.162\text{ドル}
$$
これは初回生成費用の3.24倍です。このフローは直前のバージョンのみを保持します。各ラウンドで全履歴を添付すると、入力量はさらに増加します。
以下の図は同一タスクにおける費用差を示すのに適しており、データは上記の式による推計で、品質評価の結果ではありません。
AI記事のAPIコスト:見落としやすい4種類の費用
AI記事のAPIコストと思考トークン、ツール呼び出し
思考トークンは、一部のモデルが回答を生成する前に出す推論内容です。GoogleはGeminiの推論トークンを出力費用に明確に計上しており、Qwen Thinkingモードでの追加推論もコストを押し上げます。
ウェブ検索やページ取得などのツールは、別途料金が発生する場合があります。モデルのトークンとツールへのリクエストは別々に記録し、特に1回の執筆リクエストが複数回の検索を引き起こす可能性に注意してください。
AI記事のAPIコストとキャッシュ、Batch API
プロンプトキャッシュは、同じプレフィックスを再利用して入力費用の一部を削減します。キャッシュヒット量、書き込み費用、有効期間によって、最終的にどれだけ節約できるかが決まります。
GPT-6.1 Solの公式キャッシュ入力価格は0.10、Claude Opus 5.5のキャッシュ読み取りは0.20、5分と1時間のキャッシュ書き込みはそれぞれ5と8です。単位はいずれも米ドル/100万トークンです。
Batch APIは非同期のバッチ処理に使います。Claudeの公式Batchは入力・出力とも50%割引、Geminiの公式Batch価格も12月1日の標準価格改定に合わせて調整されます。
これらのルールは接続チャネルごとに確認する必要があります。たとえば、Alibaba CloudのKimi K3.1 ProはBatch Inferenceをサポートしていません。Qwen北京のBatch Fileは0.825/2.475で、コンテキスト上限は256Kです。
基本的な進め方はシンプルです。安定した資料パッケージはまずキャッシュを検討し、納期に余裕のあるタスクではBatchを検討します。そして、キャッシュ書き込みも総コストに計上しましょう。
AI記事のAPIコスト:コードで実際のTokenを記録する
以下の例ではOpenAI互換インターフェースを使用します。APIキーは環境変数から読み込み、コードに直接書き込まないようにしてください。モデルの可用性とパラメータのサポート状況は、最新のドキュメントを基準にしてください。
最小限の呼び出し:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "解释输入和输出Token如何计费。"}],
)
print(response.choices[0].message.content)
通常Tokenのコスト試算の完全な例:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[
        {"role": "system", "content": "仅依据提供的资料写作。"},
        {"role": "user", "content": "资料:输入输出分别计费。请写一段说明。"},
    ],
)

usage = response.usage
if usage is None:
    raise RuntimeError("响应未返回Token用量,请核对调用日志。")

input_tokens = usage.prompt_tokens
output_tokens = usage.completion_tokens
estimated_cost = (
    input_tokens * 2.0 + output_tokens * 10.0
) / 1_000_000

print(response.choices[0].message.content)
print(f"输入:{input_tokens},输出:{output_tokens}")
print(f"普通Token理论费用:${estimated_cost:.6f}")
このコードは通常Tokenの費用を試算するためのものです。キャッシュの内訳、推論の計測、ツール費用については、プロバイダーの使用量フィールドや請求ログと組み合わせて確認してください。
AI記事のAPIコスト:シーン別の推奨と意思決定のヒント
予算を重視する通常の初稿では、まずFlash、Pro、Qwenを試すのがおすすめです。複雑なブログ記事や深掘り記事では、GPTやClaudeなどを候補に加え、編集にかかる時間を使って「高い単価だけの価値があるか」を検証するとよいでしょう。
AI Writing Benchmarkが2026年11月11日に更新した英語版ランキングでは、GPT-6.1 Solの総合スコアは95.3、記事カテゴリーのスコアは98.5で、いずれも基準スコアとなっています。
このベンチマークでは、GPTを英語ブログのテストに含めることができます。一方、中国語の記事は別途検証が必要です。2026年10月26日から11月3日までの金融・経済長文テストはわずか26本で、サンプルの偏りもあり、あくまで候補を見つける手がかりとして扱うのが適切です。
資料パッケージ、目標とする文字数、ツールの権限を統一し、モデル名を伏せた状態でレビューすることをおすすめします。あわせて、事実誤認、修正の回数、編集に費やした分数、最終的な採用状況を記録しておきましょう。
最終的なコスト計算には、次の式を使えます。
$$
C_{\text{合格記事}}
=C_{\text{すべてのAPI呼び出しと関連費用}}
+C_{\text{人による編集}}
$$
人件費は、編集の時間単価に実際の作業時間を掛けて算出できます。検証に追加のAPIや人手が関わる場合も、それぞれ対応する項目に含め、二重計上を避けてください。
AI記事のAPIコストFAQ:7つのモデルを公平に比較するには?
APIYI apiyi.com でモデルを切り替える際は、資料、執筆要件、ツール権限をそろえておきましょう。複数回生成して使用量を記録すると、安定性や修正コストの違いが見えやすくなります。
AI記事のAPIコストFAQ:無料枠はコスト計算の代わりになりますか?
APIYI apiyi.com の無料テスト枠は、インターフェースや文体の確認に適しています。長期的な予算は、あくまで現在の単価と実際の消費量に基づいて計算し、割引枠は別途扱うようにしてください。
おわりに:AI記事のAPIコスト、その本質は生産効率
単価表は候補の絞り込みに、呼び出しログはコスト計算に、編集記録は意思決定に使います。資料の圧縮、キャッシュの再利用、手戻りの削減は、いずれも「出力単価の最安値」を追いかけるよりも有効な場合があります。
候補モデルの検証には APIYI(apiyi.com)の活用をおすすめします。最終的には、妥当な総コストで安定して合格水準の記事を納品できるプランを選び、編集者がその時間を「判断」に充てられるようにしたいところです。
AI記事のAPIコスト関連資料
- APIYIのモデル価格とAPIドキュメント:help.apiyi.com。本文のプラットフォーム価格スナップショットは2026年11月12日時点のものです。
- Alibaba Cloudのモデル価格:alibabacloud.com/help/en/model-studio/model-pricing。リージョン別価格の確認に使用。
- Google Gemini 公式発表:blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/。
- AI Writing Benchmark:aiwritingbenchmark.com。本文は2026年11月11日時点の英語版ランキング基準を採用しています。
- 中国語の深掘り長文テスト:omnitools.ai/evals/longform-writing。サンプルとタスクの限界については本文をご参照ください。
作者:APIYI技術コンテンツチーム。apiyi.com にて、モデル呼び出しや記事のコスト計算に関するノウハウの交換を歓迎しています。


