
결론: AI 글의 API 비용, 먼저 호출을 계산하고 그다음 완성품을 계산하세요
이 글의 가격 스냅샷을 기준으로, 입력 1만 개·출력 3000개 토큰일 때 한 번 생성의 이론 비용은 약 0.0066~0.10달러예요. 발행 가능한 글 한 편을 완성하려면 수정, 검증, 도구 호출, 그리고 사람의 편집 비용까지 누적해야 하죠.
정말로 비교할 가치가 있는 것은 “한 편당 합격 비용”이에요. 이 글에서는 동일한 입력·출력량으로 7개 모델을 비교하고, 채널, 캐시, 추론, 수정 라운드가 어떻게 청구서를 바꾸는지 설명할게요.
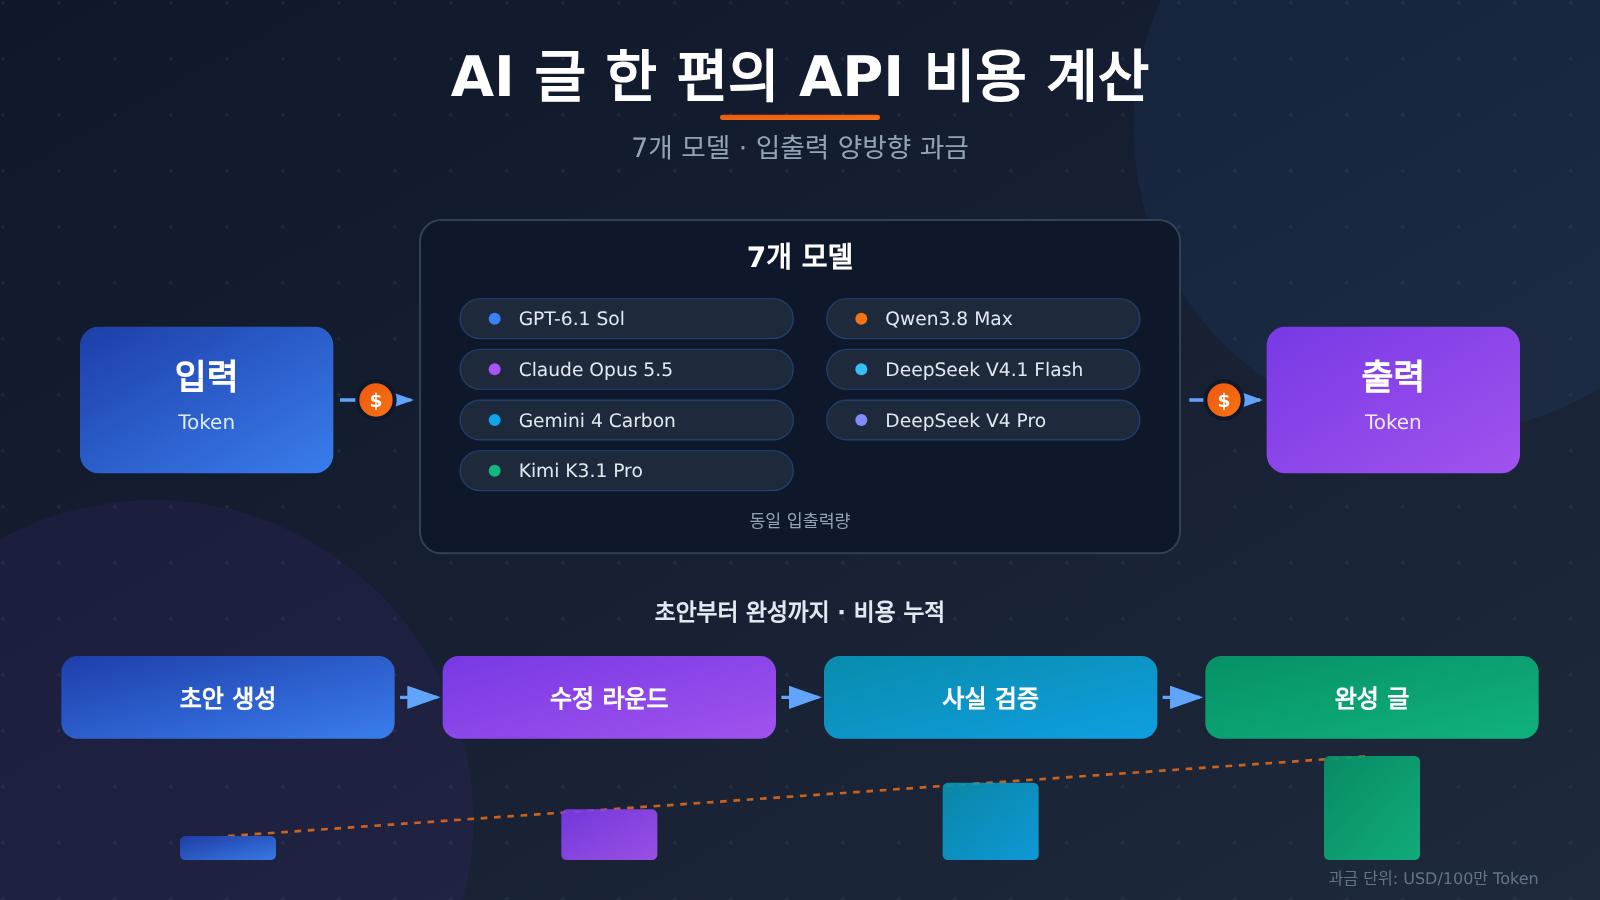
이어서 다룰 내용: AI 글의 API 비용 산정 경로
- 입력, 출력, 과금 공식을 이해하기.
- 7개 모델을 세 가지 작업 규모에서 비용 비교하기.
- 플랫폼 표시 가격, 공식 지역 가격, 시간대 규칙 구분하기.
- 호출 기록과 편집 시간으로 생산 방안 정하기.
빠른 시작 팁: APIYI apiyi.com의 통합 인터페이스로 동일한 자료 패키지를 테스트해 볼 수 있어요. 신규 사용자에게는 무료 테스트 크레딧이 제공되며, 구체적인 크레딧과 적용 규칙은 플랫폼의 현재 안내를 기준으로 해요.
AI 기사의 API 비용: 먼저 계량 기준부터 통일하기
Token은 API가 텍스트를 계량하는 단위로, 중국어 글자 수와 고정된 환산 비율이 없어요. 자료 패키지, 프롬프트, 기사 기획, 제출한 과거 대화까지 모두 입력 Token을 차지하죠.
입력 가격과 출력 가격은 보통 “달러/백만 Token” 단위로 표시해요. 이 글의 모든 시뮬레이션은 일반 입력·출력 단가를 사용하며, 캐시, 추가 추론, 일괄 할인, 도구 비용은 제외했어요.
계산 공식은 다음과 같아요:
$$
C=\frac{T_{\text{입력}}}{1{,}000{,}000}P_{\text{입력}}
+\frac{T_{\text{출력}}}{1{,}000{,}000}P_{\text{출력}}
$$
GPT-6.1 Sol을 예로 들어 볼게요. 입력 1만, 출력 3000 Token이라면:
$$
C=0.01\times2+0.003\times10=0.05\text{달러}
$$
이 돈으로 생성 한 번을 사는 셈이에요. 기사가 바로 발행 가능한지는 사실, 구조, 문체가 기준을 충족하는지에 달려 있고, 청구서가 편집자를 대신해 서명해 주지는 않아요.
AI 기사의 API 비용: 7개 모델 입력·출력 가격 비교
아래 표는 APIYI apiyi.com의 2026년 11월 12일 10:45(UTC+8) 가격 스냅숏을 사용했어요. 단위는 모두 달러/백만 Token이며, 방식은 사용량 기반 Token 과금이에요.
| 모델 | 입력 가격 | 출력 가격 | 출력/입력 단가 비율 |
|---|---|---|---|
| GPT-6.1 Sol | 2.00 | 10.00 | 5배 |
| Claude Opus 5.5 | 4.00 | 20.00 | 5배 |
| Gemini 4 Carbon | 2.00 | 10.00 | 5배 |
| Kimi K3.1 Pro | 2.00 | 10.00 | 5배 |
| Qwen3.8 Max | 1.65 | 4.95 | 3배 |
| DeepSeek V4.1 Flash | 0.30 | 1.20 | 4배 |
| DeepSeek V4 Pro | 1.32 | 3.96 | 3배 |
| 비교 항목 | 연동 설명 |
|---|---|
| 사용 가능 플랫폼 | APIYI apiyi.com, 벤더 공식 API. 리전과 과금 규칙은 각각 확인해야 함 |
출력 Token이 보통 더 비싸지만, 자료 패키지가 아주 길면 입력 비용도 주요 지출이 될 수 있어요. 그래서 모델을 고를 때는 두 열의 가격을 함께 봐야 하고, 기사 길이만 쳐다보면 안 돼요.
AI 기사의 API 비용: 공식 직결에는 어떤 가격 차이가 있을까요?
아래는 2026년 11월 12일 조회 기준 공식 직결 규칙이에요. 채널 차이를 확인하는 데 쓰이며, 위의 플랫폼 가격표에는 적용하지 않아요.
| 모델/채널 | 공식 가격 또는 규칙 |
|---|---|
| GPT-6.1 Sol, Standard | 입력 2, 출력 10 |
| Claude Opus 5.5, 표준 호출 | 입력 4, 출력 20 |
| Gemini 4 Carbon, 표준 호출 | 소개 기간은 11월 30일까지로 입력 2, 출력 10. 12월 1일부터는 입력 4, 출력 20 |
| Qwen3.8 Max, 베이징/미국 버지니아 Global | 입력 1.65, 출력 4.951 |
| Qwen3.8 Max, 싱가포르 International | 입력 2, 출력 6 |
| Kimi K3.1 Pro, 알리클라우드 베이징/싱가포르 | 각각 1.837/9.611, 2/10 |
| DeepSeek, 두 모델 | 피크 시간 가격은 위 표 값과 같고, 비피크 시간은 절반 |
Gemini의 가격 조정은 Google 공식 직결에 적용되며, 제3자 채널은 각자의 공지를 확인해야 해요. Qwen의 플랫폼 출력가 4.95와 공식 일부 리전의 4.951도 각각 따로 보존해야 해요.
DeepSeek 공식 피크 시간은 평일 베이징 시간 09:00—12:00, 14:00—18:00이며, 그 외 시간대와 주말은 비피크 규칙을 적용하고, 법정 공휴일은 별도로 계산해요.
공식 비피크 단가 기준으로 Flash는 입력 0.15, 출력 0.60이고 Pro는 입력 0.66, 출력 1.98이에요. 스케줄링 이득은 실제 채널이 이 규칙을 실행하는지에 달려 있어요.
AI 글의 API 비용: 자료 규모와 3회 수정은 어떻게 계산할까요?
먼저 두 가지 자료 규모를 비교해 볼게요. 아래 내용은 모두 이론적 시뮬레이션이며, 출력 토큰은 모델이 계산하는 길이를 뜻할 뿐 중국어 글자 수와는 다릅니다.
| 모델 | 5만 입력+5,000 출력 | 10만 입력+1만 출력 | 3회 누적 |
|---|---|---|---|
| GPT-6.1 Sol | 0.15000 | 0.30000 | 0.16200 |
| Claude Opus 5.5 | 0.30000 | 0.60000 | 0.32400 |
| Gemini 4 Carbon | 0.15000 | 0.30000 | 0.16200 |
| Kimi K3.1 Pro | 0.15000 | 0.30000 | 0.16200 |
| Qwen3.8 Max | 0.10725 | 0.21450 | 0.10395 |
| DeepSeek V4.1 Flash | 0.02100 | 0.04200 | 0.02160 |
| DeepSeek V4 Pro | 0.08580 | 0.17160 | 0.08316 |
단위는 미국 달러(USD)예요. 세 열 모두 앞서 언급한 플랫폼 스냅샷을 사용했으며, 캐시와 기타 비용은 계산에 넣지 않았어요.
5만 입력, 5,000 출력의 GPT 작업을 예로 들어 볼게요:
$$
C=0.05\times2+0.005\times10=0.15\text{달러}
$$
여기서 입력 비용은 0.10달러, 출력 비용은 0.05달러예요. 자료 밀도가 높은 작업에서는 본문 몇 단락을 압축하는 것보다 입력 자료를 정리하는 일이 우선순위가 되는 경우가 많아요.
‘3회 누적’은 다음과 같은 독립 호출 흐름을 사용해요:
- 초안: 입력 10000, 출력 3000 토큰.
- 수정: 자료 패키지 + 초안, 입력 13000, 출력 3000 토큰.
- 최종본: 자료 패키지 + 직전 버전, 입력 13000, 출력 3000 토큰.
합계는 입력 36000, 출력 9000 토큰이에요. GPT 기준 비용은 이렇게 됩니다:
$$
C=0.036\times2+0.009\times10=0.162\text{달러}
$$
이 비용은 첫 생성 비용의 3.24배예요. 이 흐름은 직전 버전 하나만 유지해요. 만약 매 회차마다 전체 이력을 함께 넣는다면 입력량은 더욱 늘어나게 됩니다.
아래 그림은 동일한 작업에서의 비용 차이를 보여 주기에 적합해요. 데이터는 위 공식을 바탕으로 산출한 추정치이며, 품질 평가 결과는 아니에요.
AI 글쓰기의 API 비용: 놓치기 쉬운 네 가지 비용
AI 글쓰기의 API 비용과 사고 토큰, 도구 호출
사고 토큰(Thinking Token) 은 일부 모델이 답변을 생성하기 전에 수행하는 추론 내용이에요. Google은 Gemini 추론 토큰을 출력 비용에 명시적으로 포함하고, Qwen Thinking 모드의 추가 추론도 비용을 늘려요.
웹 검색, 페이지 스크래핑 같은 도구는 별도로 과금될 수 있어요. 모델 토큰과 도구 요청을 따로 기록하고, 특히 글쓰기 요청 한 번이 여러 번의 검색을 유발할 수 있으니 주의해야 해요.
AI 글쓰기의 API 비용과 캐시, Batch API
프롬프트 캐시는 동일한 접두사를 재사용해 일부 입력 비용을 낮춰요. 캐시 적중량, 쓰기 비용, 유효 기간이 실제로 얼마나 절감되는지를 결정해요.
공식 GPT-6.1 Sol의 캐시 입력 가격은 0.10이고, Claude Opus 5.5의 캐시 읽기는 0.20이며 5분·1시간 캐시 쓰기는 각각 5와 8이에요. 단위는 모두 달러/백만 토큰이에요.
Batch API는 비동기 일괄 처리를 위한 기능이에요. Claude 공식 Batch는 입력과 출력 모두 50% 할인되고, Gemini 공식 Batch 가격도 12월 1일 표준가 조정에 따라 바뀌어요.
이 규칙은 연결 채널별로 반드시 확인해야 해요. 예를 들어 알리바바 클라우드 Kimi K3.1 Pro는 Batch Inference를 지원하지 않아요. Qwen 베이징 Batch File의 가격은 0.825/2.475이고, 컨텍스트 상한은 256K예요.
핵심 방법은 간단해요. 안정적인 자료 묶음은 캐시를 먼저 검토하고, 납기가 급하지 않은 작업은 Batch를 검토한 뒤, 캐시 쓰기 비용까지 전체 비용에 포함하는 거예요.
AI 글의 API 비용: 코드로 실제 Token 기록하기
다음 예시는 OpenAI 호환 인터페이스를 사용해요. 키는 환경 변수에서 읽어서 코드에 직접 적어 넣지 않도록 하고, 모델 사용 가능 여부와 파라미터 지원 범위는 현재 문서를 기준으로 확인하세요.
아주 간단한 호출:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "解释输入和输出Token如何计费。"}],
)
print(response.choices[0].message.content)
일반 Token 비용을 추정하는 전체 예시:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[
        {"role": "system", "content": "仅依据提供的资料写作。"},
        {"role": "user", "content": "资料:输入输出分别计费。请写一段说明。"},
    ],
)

usage = response.usage
if usage is None:
    raise RuntimeError("响应未返回Token用量,请核对调用日志。")

input_tokens = usage.prompt_tokens
output_tokens = usage.completion_tokens
estimated_cost = (
    input_tokens * 2.0 + output_tokens * 10.0
) / 1_000_000

print(response.choices[0].message.content)
print(f"输入:{input_tokens},输出:{output_tokens}")
print(f"普通Token理论费用:${estimated_cost:.6f}")
이 코드는 일반 Token 비용을 추정할 때 사용해요. 캐시 상세 내역, 추론 계량, 도구 비용은 서비스 제공자의 사용량 필드와 결산 로그를 함께 대조해서 확인해야 해요.
AI 글의 API 비용: 시나리오별 추천과 의사결정 제안
예산이 빠듯한 일반 초안이라면 먼저 Flash, Pro, Qwen을 테스트해 보세요. 복잡한 블로그나 심층 원고는 GPT, Claude 등을 후보에 넣고, 편집에 드는 시간으로 높은 단가가 그만한 가치가 있는지 검증하세요.
2026년 11월 11일 업데이트된 AI Writing Benchmark의 영어 리더보드에서 GPT-6.1 Sol은 종합 점수 95.3, 글 카테고리 점수 98.5를 기록했으며, 두 점수 모두 벤치마크 점수예요.
이 벤치마크는 GPT를 영어 블로그 테스트에 포함할 수 있어요. 중국어 원고는 여전히 별도로 검증해야 해요. 2026년 10월 26일부터 11월 3일까지의 경제 장문 테스트는 단 26편뿐이고 표본도 불균형해, 후보를 가늠할 단서로 활용하기에 적합해요.
자료 패키지, 목표 분량, 도구 권한을 통일하고, 모델명을 가린 채 평가하며, 사실 오류, 수정 라운드, 편집 소요 분, 최종 채택 여부를 기록하는 것이 좋아요.
최종 산정에는 다음 공식을 사용할 수 있어요:
$$
C_{\text{합격 글}}
=C_{\text{전체 API 호출 및 관련 비용}}
+C_{\text{사람의 편집}}
$$
편집 인건비는 시간당 편집 비용에 실제 소요 시간을 곱해 계산할 수 있어요. 검증에 추가 API나 사람의 작업이 들어가면 해당 항목에도 반영하되, 중복 계산은 피하세요.
AI 글의 API 비용 FAQ: 7개 모델을 어떻게 공정하게 비교할까요?
APIYI(apiyi.com)에서 모델을 바꿀 때는 자료, 작성 요구사항, 도구 권한을 동일하게 유지하세요. 여러 번 생성하고 사용량을 기록하면 안정성과 수정 비용을 더 쉽게 확인할 수 있어요.
AI 글의 API 비용 FAQ: 무료 크레딧이 비용 산정을 대신할 수 있을까요?
APIYI(apiyi.com)의 무료 테스트 크레딧은 인터페이스와 문체를 검증하는 데 적합해요. 장기 예산은 여전히 현재 단가와 실제 사용량을 기준으로 계산하고, 할인 크레딧은 별도 항목으로 처리하세요.
마무리: AI 글쓰기의 API 비용, 결국은 생산 효율
단가표는 후보를 걸러내는 데 쓰고, 호출 로그는 실제 비용을 계산하는 데 쓰며, 편집 기록은 의사결정에 써요. 자료 압축, 캐시 재사용, 재작업 줄이기는 최저 출력 단가를 쫓는 것보다 더 효과적일 수 있어요.
후보 모델은 APIYI apiyi.com에서 검증해 보시고, 합리적인 총비용으로 꾸준히 쓸 만한 글을 내놓는 방안을 최종 선택해서, 편집자가 판단에 쓸 시간을 남겨 두세요.
AI 글쓰기 API 비용 참고 자료
- APIYI 모델 가격 및 API 문서: help.apiyi.com. 본문의 플랫폼 가격 스냅샷은 2026년 11월 12일 기준이에요.
- 알리바바 클라우드 모델 가격: alibabacloud.com/help/en/model-studio/model-pricing. 지역별 가격을 확인하는 데 씁니다.
- Google Gemini 공식 공지: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/.
- AI Writing Benchmark: aiwritingbenchmark.com. 본문은 2026년 11월 11일 영어권 순위 기준을 따랐어요.
- 중국어 심층 장문 테스트: omnitools.ai/evals/longform-writing. 샘플과 과제의 한계는 본문을 참고하세요.
글쓴이: APIYI 기술 콘텐츠 팀. 모델 호출과 글쓰기 비용 산정 경험은 apiyi.com에서 나눠 주세요.


