
Conclusión: el costo de API de un artículo de IA, primero calcula la invocación, luego el producto final
Según la instantánea de precios de este artículo, con 10.000 tokens de entrada y 3000 de salida, el costo teórico de una sola generación es aproximadamente 0,0066~0,10 USD. Para completar un artículo publicable, todavía hay que acumular costos de revisión, verificación, invocación de herramientas y edición humana.
Lo que realmente vale la pena comparar es el «costo por artículo apto». Este artículo compara 7 modelos con la misma cantidad de entrada y salida, y luego explica cómo los canales, la caché, la inferencia y las rondas de revisión cambian la factura.
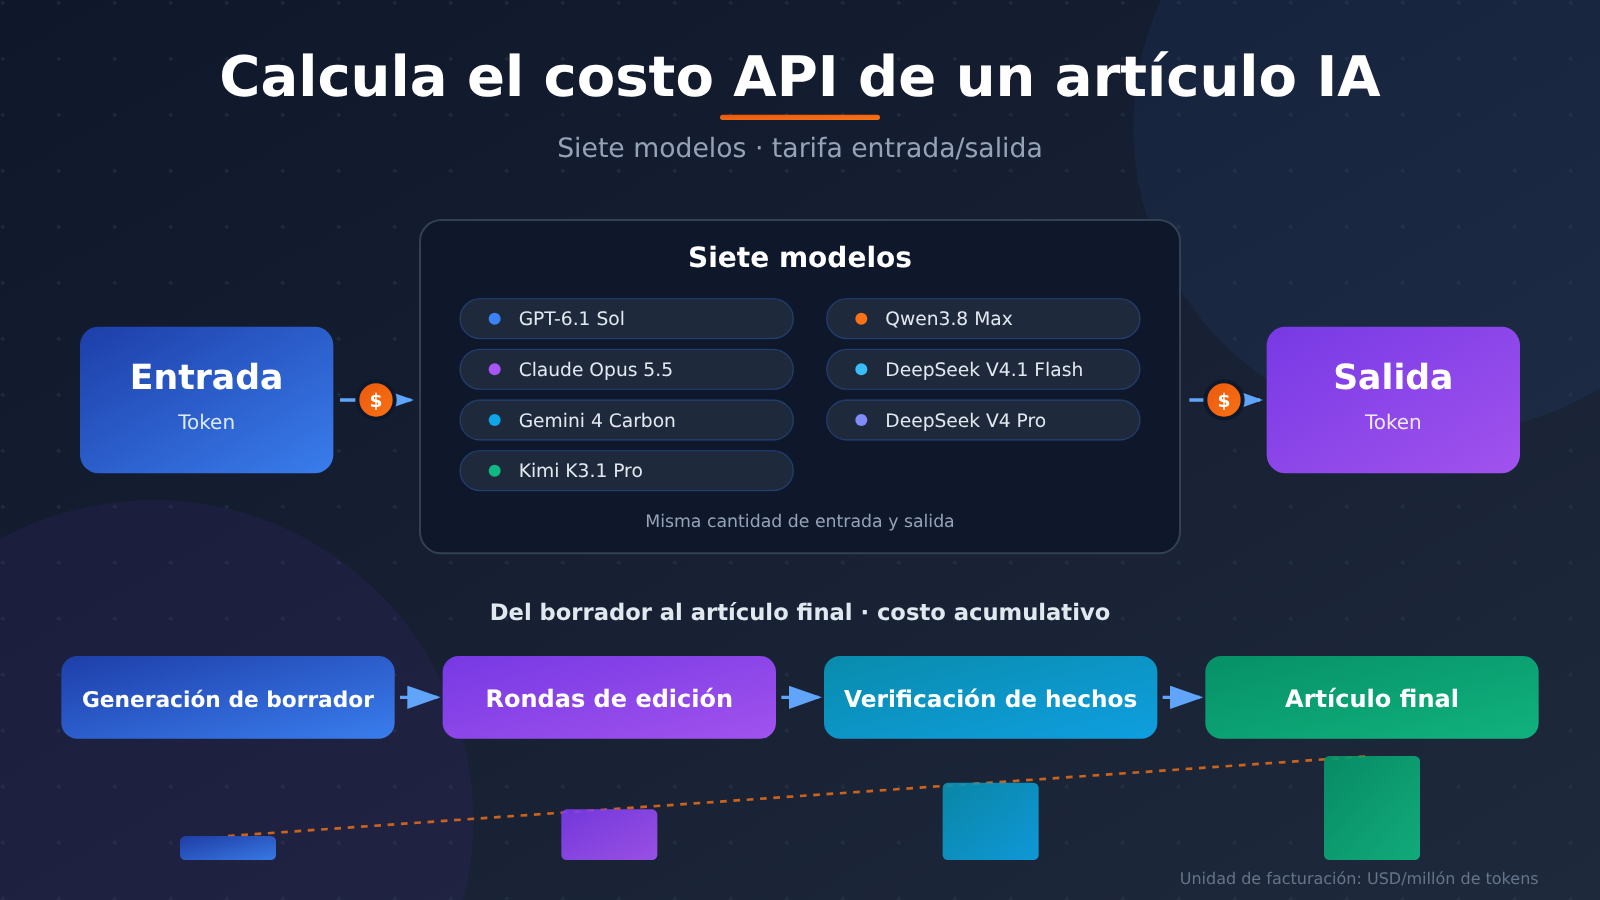
Lo que veremos más adelante: la ruta de cálculo del costo de API de un artículo de IA
- Entender la entrada, la salida y la fórmula de facturación.
- Comparar el costo de 7 modelos en tres escalas de tarea.
- Distinguir entre el precio de plataforma, el precio regional oficial y las reglas por franja horaria.
- Decidir el plan de producción usando los registros de invocación y el tiempo de edición.
Consejo para empezar rápido: Puedes probar el mismo paquete de materiales a través de la interfaz unificada de APIYI apiyi.com. Los nuevos usuarios tienen una cuota de prueba gratuita; la cuota específica y las reglas aplicables están sujetas a las instrucciones actuales de la plataforma.
Coste de API de un artículo de IA: primero, unifiquemos la unidad de medida
Token es la unidad con la que la API mide el texto y no tiene una proporción de conversión fija con el número de caracteres chinos. El paquete de documentación, las indicaciones, la planificación del artículo y el historial de conversaciones enviado también ocupan tokens de entrada.
Los precios de entrada y salida se suelen indicar en «USD por millón de tokens». Todas las simulaciones de este artículo usan las tarifas normales de entrada y salida, y excluyen caché, inferencia adicional, descuentos por volumen y costes de herramientas.
La fórmula de cálculo es:
$$
C=\frac{T_{\text{entrada}}}{1{,}000{,}000}P_{\text{entrada}}
+\frac{T_{\text{salida}}}{1{,}000{,}000}P_{\text{salida}}
$$
Tomando GPT-6.1 Sol como ejemplo, con 10 000 tokens de entrada y 3000 de salida:
$$
C=0.01\times2+0.003\times10=0.05\text{ USD}
$$
Ese dinero compra una generación. Que el artículo se pueda publicar directamente depende de si los hechos, la estructura y el estilo de redacción cumplen los requisitos; la factura no firma en lugar del editor.
Coste de API de un artículo de IA: comparación de precios de entrada y salida entre 7 modelos
La siguiente tabla usa una instantánea de precios de APIYI apiyi.com tomada el 12 de noviembre de 2026 a las 10:45 (UTC+8). Todas las unidades están en USD por millón de tokens y el modelo de facturación es por consumo de tokens.
| Modelo | Precio de entrada | Precio de salida | Relación de precio salida/entrada |
|---|---|---|---|
| GPT-6.1 Sol | 2.00 | 10.00 | 5× |
| Claude Opus 5.5 | 4.00 | 20.00 | 5× |
| Gemini 4 Carbon | 2.00 | 10.00 | 5× |
| Kimi K3.1 Pro | 2.00 | 10.00 | 5× |
| Qwen3.8 Max | 1.65 | 4.95 | 3× |
| DeepSeek V4.1 Flash | 0.30 | 1.20 | 4× |
| DeepSeek V4 Pro | 1.32 | 3.96 | 3× |
| Elemento de comparación | Notas de acceso |
|---|---|
| Plataformas disponibles | APIYI apiyi.com; API oficial del fabricante; las reglas por región y de facturación deben verificarse por separado |
Los tokens de salida normalmente son más caros, pero cuando el paquete de documentación es muy largo, el coste de entrada también puede convertirse en el gasto principal. Por eso, al elegir modelo conviene mirar ambas columnas de precios, no solo la longitud del artículo.
Coste de API de un artículo de IA: ¿qué diferencias de precio hay en la conexión directa oficial?
Las siguientes son las reglas de conexión directa oficial consultadas hasta el 12 de noviembre de 2026, para verificar diferencias entre canales; no se aplican a la tabla de precios de la plataforma anterior.
| Modelo / canal | Precio oficial o regla |
|---|---|
| GPT-6.1 Sol, Standard | entrada 2, salida 10 |
| Claude Opus 5.5, llamada estándar | entrada 4, salida 20 |
| Gemini 4 Carbon, llamada estándar | periodo de introducción hasta el 30 de noviembre, entrada 2, salida 10; a partir del 1 de diciembre, entrada 4, salida 20 |
| Qwen3.8 Max, Pekín / Virginia (EE. UU.) Global | entrada 1.65, salida 4.951 |
| Qwen3.8 Max, Singapur International | entrada 2, salida 6 |
| Kimi K3.1 Pro, Alibaba Cloud Pekín / Singapur | 1.837 / 9.611 y 2 / 10, respectivamente |
| DeepSeek, dos modelos | el precio en hora pico coincide con los valores de la tabla anterior; en hora valle se reduce a la mitad |
El ajuste de precios de Gemini se aplica a la conexión directa oficial de Google; para los canales de terceros, consulta sus propios anuncios. El precio de salida de Qwen en la plataforma, 4.95, y el 4.951 de algunas regiones oficiales también deben mantenerse por separado.
La hora pico oficial de DeepSeek es de 09:00 a 12:00 y de 14:00 a 18:00, hora de Pekín, en días laborables; el resto del horario y los fines de semana se rigen por las reglas de hora valle, y los días festivos oficiales se calculan aparte.
Con las tarifas oficiales de hora valle, Flash cuesta 0.15 de entrada y 0.60 de salida; Pro, 0.66 de entrada y 1.98 de salida. El ahorro por programación depende de si el canal real aplica esa regla.
Coste de API de un artículo de IA: ¿cómo calcularlo según el volumen de material y las tres rondas de revisión?
Empecemos comparando dos volúmenes de material. Todo lo siguiente es una simulación teórica: los tokens de salida representan la longitud medida por el modelo, no el número de caracteres chineses.
| Modelo | 50 000 de entrada + 5000 de salida | 100 000 de entrada + 10 000 de salida | Acumulado en tres rondas |
|---|---|---|---|
| GPT-6.1 Sol | 0.15000 | 0.30000 | 0.16200 |
| Claude Opus 5.5 | 0.30000 | 0.60000 | 0.32400 |
| Gemini 4 Carbon | 0.15000 | 0.30000 | 0.16200 |
| Kimi K3.1 Pro | 0.15000 | 0.30000 | 0.16200 |
| Qwen3.8 Max | 0.10725 | 0.21450 | 0.10395 |
| DeepSeek V4.1 Flash | 0.02100 | 0.04200 | 0.02160 |
| DeepSeek V4 Pro | 0.08580 | 0.17160 | 0.08316 |
Unidad: dólares estadounidenses. Las tres columnas usan la instantánea de precios de la plataforma mencionada antes, sin contar caché ni otros costes.
Tomemos como ejemplo una tarea de GPT con 50 000 de entrada y 5000 de salida:
$$
C=0.05\times2+0.005\times10=0.15\text{ dólares}
$$
De los cuales 0.10 dólares corresponden a la entrada y 0.05 dólares a la salida. En tareas con mucho material, organizar los documentos de entrada suele merecer más la pena que recortar unos párrafos de texto.
El «acumulado en tres rondas» sigue este flujo de llamadas independientes:
- Primer borrador: entrada de 10 000, salida de 3000 tokens.
- Revisión: paquete de material más el primer borrador, entrada de 13 000, salida de 3000 tokens.
- Versión final: paquete de material más la versión anterior, entrada de 13 000, salida de 3000 tokens.
En total, 36 000 de entrada y 9000 de salida. El coste correspondiente con GPT es:
$$
C=0.036\times2+0.009\times10=0.162\text{ dólares}
$$
Es 3.24 veces el coste de la primera generación. Este flujo solo conserva la versión anterior; si cada ronda incluyera todo el historial, el volumen de entrada seguiría creciendo.
El siguiente gráfico sirve para mostrar la diferencia de coste en una misma tarea; los datos provienen del cálculo con las fórmulas anteriores y no son resultados de una evaluación de calidad.
Costos de API para artículos de IA: cuatro tipos de gastos que se pasan por alto fácilmente
Costos de API para artículos de IA, tokens de pensamiento y uso de herramientas
Los tokens de pensamiento son el contenido de razonamiento que algunos modelos generan antes de producir una respuesta. Google incluye explícitamente los tokens de razonamiento de Gemini en el costo de salida, y el razonamiento adicional del modo Qwen Thinking también aumenta el costo.
Las herramientas como la búsqueda web y el scraping de páginas pueden cobrarse por separado. Conviene registrar por separado los tokens del modelo y las solicitudes a herramientas, prestando especial atención a que una sola solicitud de escritura puede desencadenar varias búsquedas.
Costos de API para artículos de IA, caché y Batch API
La caché de indicaciones reduce parte del costo de entrada al reutilizar el mismo prefijo. El volumen de aciertos, el costo de escritura y el periodo de validez determinan cuánto se puede ahorrar al final.
El precio oficial de entrada en caché de GPT-6.1 Sol es 0.10; en Claude Opus 5.5, la lectura de caché cuesta 0.20, y la escritura de caché por 5 minutos y 1 hora cuesta 5 y 8 respectivamente, en todos los casos en USD por millón de tokens.
Batch API se utiliza para el procesamiento asíncrono por lotes. Tanto la entrada como la salida de Batch oficial de Claude tienen un 50 % de descuento; el precio oficial de Batch de Gemini también se ajusta conforme al precio estándar del 1 de diciembre.
Estas reglas deben verificarse según el canal de acceso. Por ejemplo, Alibaba Cloud Kimi K3.1 Pro no admite Batch Inference; Qwen Beijing Batch File cuesta 0.825/2.475, con un límite de ventana de contexto de 256K.
El enfoque central es sencillo: para conjuntos de materiales estables, evaluar primero la caché; para tareas cuya entrega no es urgente, evaluar después Batch; y contabilizar la escritura de caché en el total.
El coste de API de los artículos de IA: registrar los tokens reales con código
Los siguientes ejemplos utilizan la interfaz compatible con OpenAI. La clave se lee desde una variable de entorno para no escribirla directamente en el código; la disponibilidad de los modelos y el soporte de parámetros se rigen por la documentación vigente.
Llamada mínima:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "解释输入和输出Token如何计费。"}],
)
print(response.choices[0].message.content)
Ejemplo completo de estimación del coste de tokens normales:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[
        {"role": "system", "content": "仅依据提供的资料写作。"},
        {"role": "user", "content": "资料:输入输出分别计费。请写一段说明。"},
    ],
)

usage = response.usage
if usage is None:
    raise RuntimeError("响应未返回Token用量,请核对调用日志。")

input_tokens = usage.prompt_tokens
output_tokens = usage.completion_tokens
estimated_cost = (
    input_tokens * 2.0 + output_tokens * 10.0
) / 1_000_000

print(response.choices[0].message.content)
print(f"输入:{input_tokens},输出:{output_tokens}")
print(f"普通Token理论费用:${estimated_cost:.6f}")
Este código sirve para estimar el coste de los tokens normales. Los detalles de caché, la medición del razonamiento y los costes de herramientas deben contrastarse con los campos de uso del proveedor y los registros de liquidación.
Costo de API para artículos con IA: recomendaciones por escenario y criterios de decisión
Para borradores habituales sensibles al presupuesto, conviene probar primero Flash, Pro y Qwen. En blogs complejos y artículos de fondo, incluya GPT, Claude y otros modelos en la lista de candidatos, y use el tiempo de edición para comprobar si merece la pena el precio unitario más alto.
En la clasificación en inglés de AI Writing Benchmark actualizada el 11 de noviembre de 2026, GPT-6.1 Sol obtiene 95.3 en la puntuación global y 98.5 en la categoría de artículos, ambas como puntuaciones de referencia.
La evaluación permite incluir GPT en las pruebas de blogs en inglés. Los textos en chino aún deben validarse por separado: la prueba de artículos largos de finanzas del 26 de octubre al 3 de noviembre de 2026 abarcó solo 26 textos y tuvo una muestra desequilibrada, así que sirve solo como pista para candidatos.
Se recomienda usar el mismo paquete de materiales, la misma extensión objetivo y los mismos permisos de herramientas, evaluar sin revelar el nombre del modelo y registrar errores de hecho, rondas de revisión, minutos de edición y si el texto se adoptó finalmente.
El cálculo final puede hacerse así:
$$
C_{\text{artículo aprobado}}
=C_{\text{todas las llamadas API y costos relacionados}}
+C_{\text{edición humana}}
$$
El costo de la edición humana se puede calcular multiplicando la tarifa horaria de edición por el tiempo real dedicado. Si la verificación implica llamadas API adicionales o trabajo humano adicional, inclúyalas en la partida correspondiente para evitar duplicar el registro de costos.
Preguntas frecuentes sobre el costo de API para artículos con IA: ¿cómo comparar 7 modelos de forma justa?
Al cambiar de modelo a través de APIYI apiyi.com, mantenga constantes los materiales, los requisitos de redacción y los permisos de herramientas. Generar varias veces y registrar el uso facilita ver la estabilidad y el costo de revisión.
Preguntas frecuentes sobre el costo de API para artículos con IA: ¿se puede sustituir el cálculo de costos con la cuota gratuita?
La cuota de prueba gratuita de APIYI apiyi.com sirve para validar la interfaz y el estilo de redacción. Para el presupuesto a largo plazo, conviene seguir calculando según el precio unitario actual y el consumo real; las cuotas promocionales deben registrarse por separado.
Cierre: en los artículos de IA, el costo de API se mide en eficiencia productiva
La tabla de precios unitarios sirve para filtrar; el registro de invocaciones, para calcular; el historial de edición, para decidir. Comprimir materiales, reutilizar caché y reducir retrabajos puede ser más eficaz que perseguir el precio de salida más bajo.
Recomendamos validar los modelos candidatos con APIYI apiyi.com y elegir al final la opción que entregue de forma estable artículos aceptables con un costo total razonable, para que los editores dediquen su tiempo a juzgar.
Referencias sobre costos de API para artículos de IA
- Precios de modelos y documentación de API de APIYI: help.apiyi.com. La instantánea de precios de la plataforma en este artículo corresponde al 12 de noviembre de 2026.
- Precios de modelos de Alibaba Cloud: alibabacloud.com/help/en/model-studio/model-pricing. Para verificar precios por región.
- Anuncio oficial de Google Gemini: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/.
- AI Writing Benchmark: aiwritingbenchmark.com. Este artículo usa el criterio del ranking en inglés del 11 de noviembre de 2026.
- Prueba de redacción profunda de formato largo en chino: omnitools.ai/evals/longform-writing. Las limitaciones de la muestra y de las tareas se explican en el texto principal.
Autoría: equipo de contenido técnico de APIYI. Puedes compartir experiencias sobre invocación de modelos y cálculo de costos de artículos en apiyi.com.


