
Conclusão: custo de API de artigos de IA — primeiro calcule as chamadas, depois o resultado final
Com o snapshot de preços deste artigo, entrada de 10 mil e saída de 3000 tokens, o custo teórico de uma geração fica em cerca de 0.0066–0.10 dólares. Para chegar a um artigo publicável, ainda é preciso somar custos de revisão, verificação, chamadas de ferramentas e edição humana.
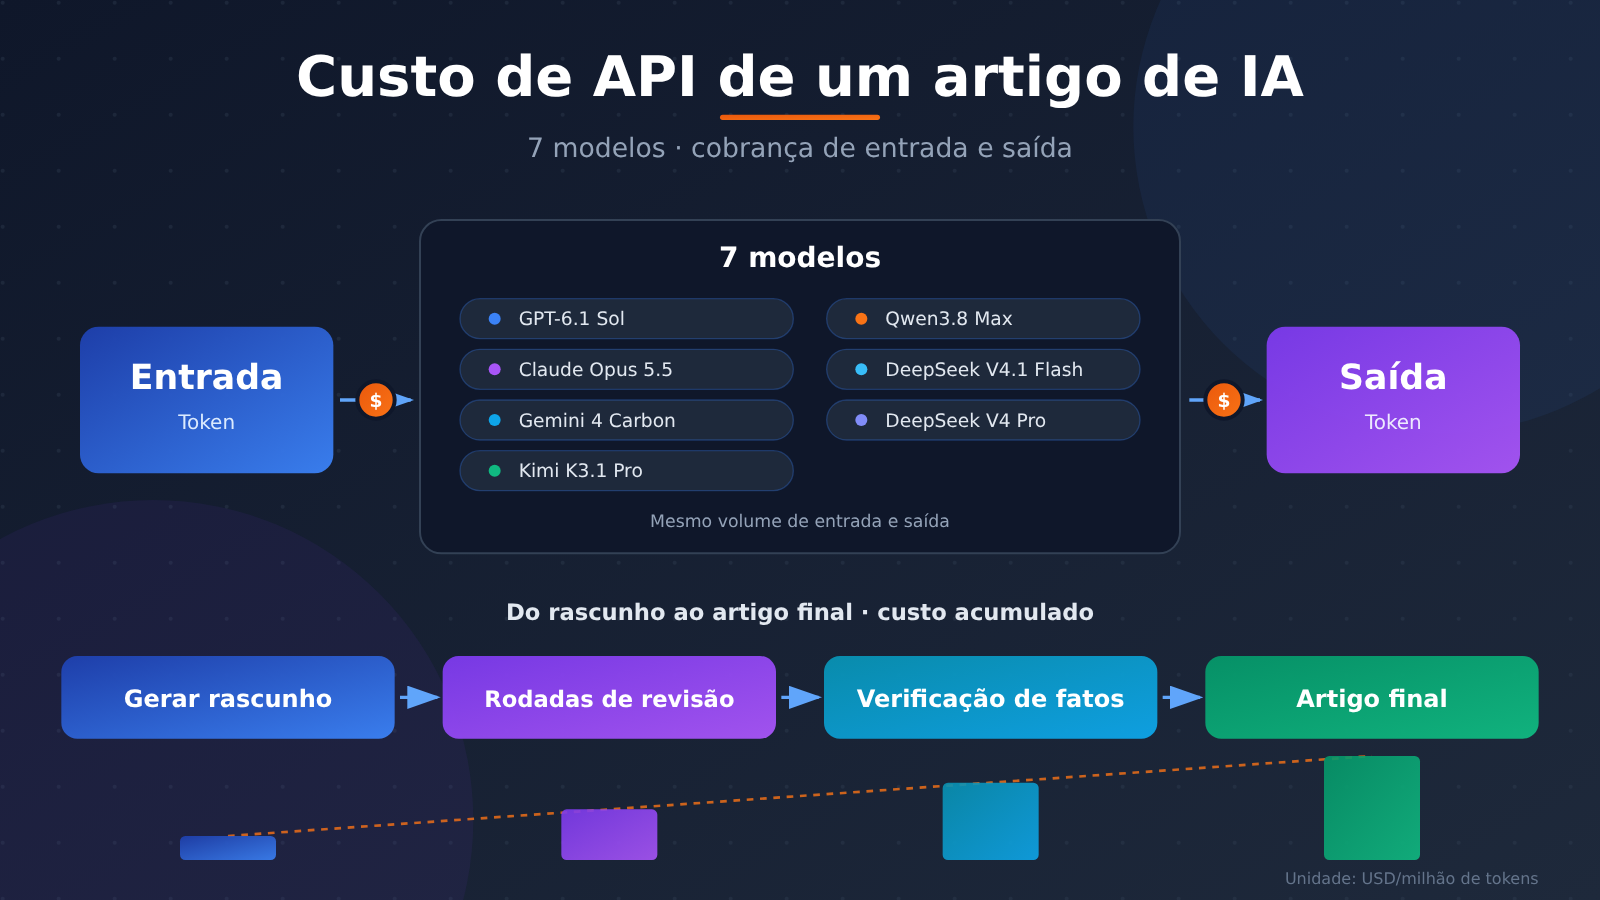
O que realmente vale comparar é o “custo por artigo aprovado”. Este artigo compara 7 modelos com o mesmo volume de entrada e saída e, em seguida, explica como canal, cache, raciocínio e rodadas de revisão alteram a conta.
O que vem a seguir: roteiro de cálculo do custo de API de artigos de IA
- Entender entrada, saída e a fórmula de cobrança.
- Comparar o custo de 7 modelos em três escalas de tarefa.
- Distinguir preço de tabela da plataforma, preço regional oficial e regras de horário.
- Usar registros de chamadas e tempo de edição para decidir o plano de produção.
Sugestão para começar rápido: é possível testar o mesmo pacote de materiais pela interface unificada da APIYI em apiyi.com. Novos usuários têm cota gratuita de teste; a cota específica e as regras aplicáveis seguem a descrição atual da plataforma.
Custo de API de artigos com IA: primeiro, unificar a métrica de medição
Token é a unidade que a API usa para medir texto, e não existe uma proporção fixa de conversão com o número de caracteres chineses. Pacote de materiais, comandos, planejamento do artigo e o histórico de conversa enviado — tudo isso ocupa tokens de entrada.
Os preços de entrada e de saída costumam ser indicados em “USD por milhão de tokens”. Todas as simulações deste artigo usam o preço unitário padrão de entrada e de saída, excluindo cache, raciocínio adicional, descontos por lote e custos de ferramentas.
A fórmula de cálculo é:
$$
C=\frac{T_{\text{entrada}}}{1{,}000{,}000}P_{\text{entrada}}
+\frac{T_{\text{saída}}}{1{,}000{,}000}P_{\text{saída}}
$$
Tomemos o GPT-6.1 Sol como exemplo, com 10 mil tokens de entrada e 3.000 de saída:
$$
C=0{,}01\times2+0{,}003\times10=0{,}05\text{ USD}
$$
Esse valor compra uma geração. Se o artigo pode ou não ser publicado diretamente depende de fatos, estrutura e estilo estarem à altura — a fatura não assina no lugar do editor.
Custo de API de artigos com IA: comparação de preços de entrada e saída de 7 modelos
A tabela abaixo usa o snapshot de preços da APIYI apiyi.com em 12 de novembro de 2026, às 10h45 (UTC+8). Todas as unidades estão em USD por milhão de tokens, no modo de cobrança por token consumido.
| Modelo | Preço de entrada | Preço de saída | Razão saída/entrada |
|---|---|---|---|
| GPT-6.1 Sol | 2,00 | 10,00 | 5× |
| Claude Opus 5.5 | 4,00 | 20,00 | 5× |
| Gemini 4 Carbon | 2,00 | 10,00 | 5× |
| Kimi K3.1 Pro | 2,00 | 10,00 | 5× |
| Qwen3.8 Max | 1,65 | 4,95 | 3× |
| DeepSeek V4.1 Flash | 0,30 | 1,20 | 4× |
| DeepSeek V4 Pro | 1,32 | 3,96 | 3× |
| Item de comparação | Observações de acesso |
|---|---|
| Plataformas disponíveis | APIYI apiyi.com; API oficial do fabricante — região e regras de cobrança precisam ser verificadas separadamente |
Os tokens de saída costumam ser mais caros, mas quando o pacote de materiais é muito longo, o custo de entrada também se torna a despesa principal. Por isso, a escolha do modelo deve olhar as duas colunas de preço ao mesmo tempo, e não apenas o comprimento do artigo.
Custo de API de artigos com IA: quais diferenças de preço existem no acesso direto oficial?
A seguir estão as regras de acesso direto oficial consultadas até 12 de novembro de 2026, usadas para verificar diferenças entre canais e não incorporadas à tabela de preços da plataforma acima.
| Modelo / canal | Preço ou regra oficial |
|---|---|
| GPT-6.1 Sol, Standard | entrada 2, saída 10 |
| Claude Opus 5.5, chamada padrão | entrada 4, saída 20 |
| Gemini 4 Carbon, chamada padrão | período de introdução até 30 de novembro: entrada 2, saída 10; a partir de 1º de dezembro: entrada 4, saída 20 |
| Qwen3.8 Max, Pequim / Virgínia (Global) | entrada 1,65, saída 4,951 |
| Qwen3.8 Max, Singapura (International) | entrada 2, saída 6 |
| Kimi K3.1 Pro, Alibaba Cloud Pequim / Singapura | 1,837 / 9,611 e 2 / 10, respectivamente |
| DeepSeek, os dois modelos | preço de pico igual aos valores da tabela acima; fora do pico, pela metade |
O ajuste de preço do Gemini vale para o acesso direto oficial do Google; canais de terceiros devem consultar seus próprios comunicados. O preço de saída de 4,95 da plataforma Qwen e o 4,951 de algumas regiões oficiais também devem ser mantidos separadamente.
O horário de pico oficial da DeepSeek é, em dias úteis, das 09h00 às 12h00 e das 14h00 às 18h00 no horário de Pequim; os demais períodos e os fins de semana seguem a regra de fora do pico, e feriados nacionais são calculados à parte.
Pelos preços unitários oficiais fora do pico, o Flash fica em 0,15 na entrada e 0,60 na saída; o Pro, em 0,66 na entrada e 1,98 na saída. O ganho de agendamento depende de o canal real aplicar essa regra.
Custo de API de um artigo de IA: como calcular o volume de material e as três rodadas de revisão?
Comece comparando os dois volumes de material. Tudo o que segue é simulação teórica: os tokens de saída representam o comprimento medido pelo modelo, e não a quantidade de caracteres chineses.
| Modelo | 50 mil de entrada + 5000 de saída | 100 mil de entrada + 10 mil de saída | Acumulado em três rodadas |
|---|---|---|---|
| GPT-6.1 Sol | 0.15000 | 0.30000 | 0.16200 |
| Claude Opus 5.5 | 0.30000 | 0.60000 | 0.32400 |
| Gemini 4 Carbon | 0.15000 | 0.30000 | 0.16200 |
| Kimi K3.1 Pro | 0.15000 | 0.30000 | 0.16200 |
| Qwen3.8 Max | 0.10725 | 0.21450 | 0.10395 |
| DeepSeek V4.1 Flash | 0.02100 | 0.04200 | 0.02160 |
| DeepSeek V4 Pro | 0.08580 | 0.17160 | 0.08316 |
Unidade: dólares. As três colunas usam o snapshot da plataforma citada acima, sem considerar cache nem outros custos.
Tomando como exemplo uma tarefa GPT com 50 mil tokens de entrada e 5000 de saída:
$$
C=0.05\times2+0.005\times10=0.15\text{ dólares}
$$
Sendo 0.10 dólares de entrada e 0.05 dólares de saída. Em tarefas com muito material de referência, organizar o material de entrada costuma valer mais a pena do que espremer alguns parágrafos do texto.
O “acumulado em três rodadas” segue este fluxo de chamadas independentes:
- Rascunho: entrada de 10000, saída de 3000 tokens.
- Revisão: pacote de material mais o rascunho, entrada de 13000, saída de 3000 tokens.
- Versão final: pacote de material mais a versão anterior, entrada de 13000, saída de 3000 tokens.
Total: 36000 de entrada e 9000 de saída. O custo correspondente no GPT é:
$$
C=0.036\times2+0.009\times10=0.162\text{ dólares}
$$
Isso dá 3.24 vezes o custo da primeira geração. Esse fluxo guarda apenas a versão anterior; se cada rodada carregar todo o histórico, o volume de entrada aumenta ainda mais.
O gráfico abaixo serve para mostrar a diferença de custo dentro de uma mesma tarefa. Os dados vêm das fórmulas acima, não são resultado de avaliação de qualidade.
Custo de API de artigos de IA: quatro tipos de despesas fáceis de esquecer
Custo de API de artigos de IA: tokens de raciocínio e chamadas de ferramentas
Os tokens de raciocínio são o conteúdo de inferência que alguns modelos geram antes de produzir a resposta. O Google inclui explicitamente os tokens de raciocínio do Gemini no custo de saída, e a inferência extra do modo Qwen Thinking também aumenta o custo.
Ferramentas como busca na web e scraping de páginas podem ser cobradas à parte. O ideal é registrar separadamente os tokens do modelo e as requisições de ferramentas, prestando atenção especial ao fato de que uma única requisição de escrita pode disparar várias buscas.
Custo de API de artigos de IA: cache de comandos e Batch API
O cache de comandos reduz parte do custo de entrada ao reaproveitar o mesmo prefixo. O volume de acertos, o custo de escrita e o tempo de validade é que determinam quanto se economiza no final.
O preço oficial de entrada em cache do GPT-6.1 Sol é 0.10; no Claude Opus 5.5, a leitura de cache é 0.20, e a escrita de cache de 5 minutos e de 1 hora custa 5 e 8, respectivamente — todos os valores em dólares por milhão de tokens.
A Batch API serve para processamento assíncrono em lote. Na Claude oficial, tanto a entrada quanto a saída da Batch têm 50% de desconto; os preços oficiais da Batch do Gemini também acompanham o ajuste do preço padrão de 1º de dezembro.
Essas regras precisam ser conferidas de acordo com o canal de acesso. Por exemplo, o Kimi K3.1 Pro do Alibaba Cloud não oferece suporte a Batch Inference; o Batch File do Qwen Pequim é 0.825/2.475, com limite de contexto de 256K.
A abordagem central é simples: para pacotes de materiais estáveis, avalie primeiro o cache; para tarefas sem urgência de entrega, avalie depois a Batch; e inclua o custo de escrita do cache na conta total.
Custo de API de artigos de IA: registre os Tokens reais com código
O exemplo a seguir usa a interface compatível com OpenAI. A chave é lida por variável de ambiente, para evitar escrevê-la diretamente no código; a disponibilidade do modelo e o suporte a parâmetros devem ser consultados na documentação atual.
Chamada mínima:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "解释输入和输出Token如何计费。"}],
)
print(response.choices[0].message.content)
Exemplo completo de estimativa de custo de Tokens normais:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[
        {"role": "system", "content": "仅依据提供的资料写作。"},
        {"role": "user", "content": "资料:输入输出分别计费。请写一段说明。"},
    ],
)

usage = response.usage
if usage is None:
    raise RuntimeError("响应未返回Token用量,请核对调用日志。")

input_tokens = usage.prompt_tokens
output_tokens = usage.completion_tokens
estimated_cost = (
    input_tokens * 2.0 + output_tokens * 10.0
) / 1_000_000

print(response.choices[0].message.content)
print(f"输入:{input_tokens},输出:{output_tokens}")
print(f"普通Token理论费用:${estimated_cost:.6f}")
Este código serve para estimar o custo de Tokens normais. Detalhes de cache, medição de raciocínio e custos de ferramentas devem ser verificados em conjunto com os campos de uso do provedor e os logs de cobrança.
Custo de API para artigos de IA: recomendações por cenário e sugestões de decisão
Para rascunhos iniciais de rotina com orçamento apertado, vale a pena começar testando Flash, Pro e Qwen. Já para blogs complexos e textos mais aprofundados, inclua GPT, Claude e outros modelos na lista de candidatos, e use o tempo de edição para confirmar se o preço unitário mais alto realmente compensa.
No ranking em inglês atualizado em 11 de novembro de 2026 pelo AI Writing Benchmark, o GPT-6.1 Sol tem pontuação geral de 95.3 e pontuação na categoria de artigos de 98.5, ambas tratadas como pontuações de referência.
A ferramenta permite incluir o GPT nos testes de blogs em inglês. Já os textos em chinês ainda precisam de validação separada: o teste com textos longos de finanças, realizado entre 26 de outubro e 3 de novembro de 2026, contou com apenas 26 artigos e amostra desequilibrada, servindo no máximo como pista de candidato.
A recomendação é padronizar o pacote de materiais, o comprimento-alvo e as permissões de ferramentas, fazer a avaliação sem revelar o nome do modelo e registrar erros factuais, número de rodadas de revisão, minutos de edição e se o texto foi de fato adotado.
No fechamento da conta, dá para usar:
$$
C_{\text{artigo aprovado}}
=C_{\text{todas as chamadas de API e custos relacionados}}
+C_{\text{edição humana}}
$$
O custo de mão de obra pode ser calculado multiplicando o custo por hora de edição pelo tempo efetivamente gasto. Se a verificação envolver APIs extras ou trabalho humano adicional, inclua também no item correspondente, para não contar duas vezes.
FAQ sobre custo de API para artigos de IA: como comparar 7 modelos de forma justa?
Ao alternar entre modelos pelo APIYI apiyi.com, mantenha iguais os materiais, as exigências de escrita e as permissões de ferramentas. Gerar várias vezes o mesmo conteúdo e registrar o consumo ajuda a enxergar com clareza a estabilidade e o custo de revisão.
FAQ sobre custo de API para artigos de IA: a cota gratuita pode substituir o cálculo de custos?
A cota gratuita de testes do APIYI apiyi.com é boa para validar a interface e o estilo de escrita. Para o orçamento de longo prazo, ainda é preciso calcular com base no preço unitário atual e no consumo real, tratando as cotas com desconto como um item à parte.
Conclusão: o custo de API para artigos de IA se resume à eficiência de produção
A tabela de preços unitários serve para triagem, os logs de invocação servem para contabilização, e os registros de edição servem para decisão. Compressão de materiais, reutilização de cache e redução de retrabalho podem ser mais eficazes do que perseguir o menor preço de saída.
Recomendamos validar os modelos candidatos através do APIYI apiyi.com e, ao final, escolher a solução que consiga entregar artigos qualificados de forma estável a um custo total razoável — deixando o tempo dos editores para o julgamento.
Materiais de referência sobre custos de API para artigos de IA
- Preços de modelos e documentação de interface do APIYI: help.apiyi.com. O snapshot de preços da plataforma neste artigo é de 12 de novembro de 2026.
- Preços de modelos da Alibaba Cloud: alibabacloud.com/help/en/model-studio/model-pricing. Usado para verificar preços regionais.
- Anúncio oficial do Google Gemini: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/.
- AI Writing Benchmark: aiwritingbenchmark.com. Este artigo adota os critérios do ranking em inglês de 11 de novembro de 2026.
- Teste de artigos longos e aprofundados em chinês: omnitools.ai/evals/longform-writing. Limitações de amostra e de tarefa estão descritas no texto principal.
Autor: equipe de conteúdo técnico do APIYI. Ficamos à disposição via apiyi.com para trocar experiências sobre invocação de modelos e contabilização de custos de artigos.


