
概要:本記事は、GPT-6.2 Sol がフロントエンドユーザーのデータに関する問い合わせに応えられるのか、どの質問が追加確認を要するのかという点に答えます。
GPT-6.2 Sol のデータ分析における性能は、2つの側面から見られます。Plotly が2026年11月17日に公開した単一ラウンドの専用テストでは、通常分析、曖昧性の判断、データで回答できない問題、データ品質、統計的な落とし穴という5種類の設問を合計 38問すべて正解し、1問あたりの所要時間中央値は約10.5秒でした。同じテストラウンドでは、隠れた規則に関する5問のうち2問だけ正解しました。
これに基づく判断は次のとおりです。定義が明確で影響の小さい集計問い合わせは、試験的に Sol に読み取り専用権限で直接回答させられます。定義が欠けている場合は、まず Sol に確認を求めさせます。オープンエンドな要因分析や対外的な意思決定は、アナリストのレビューに回してください。 この結論には3つの前提があります。テストは1ラウンドのみ、問題セットは風力発電企業を模した英語の問題、費用は OpenRouter チャネル経由です。自社のデータとチャネルに置き換えた後は、問題タイプごとに再検証が必要です。
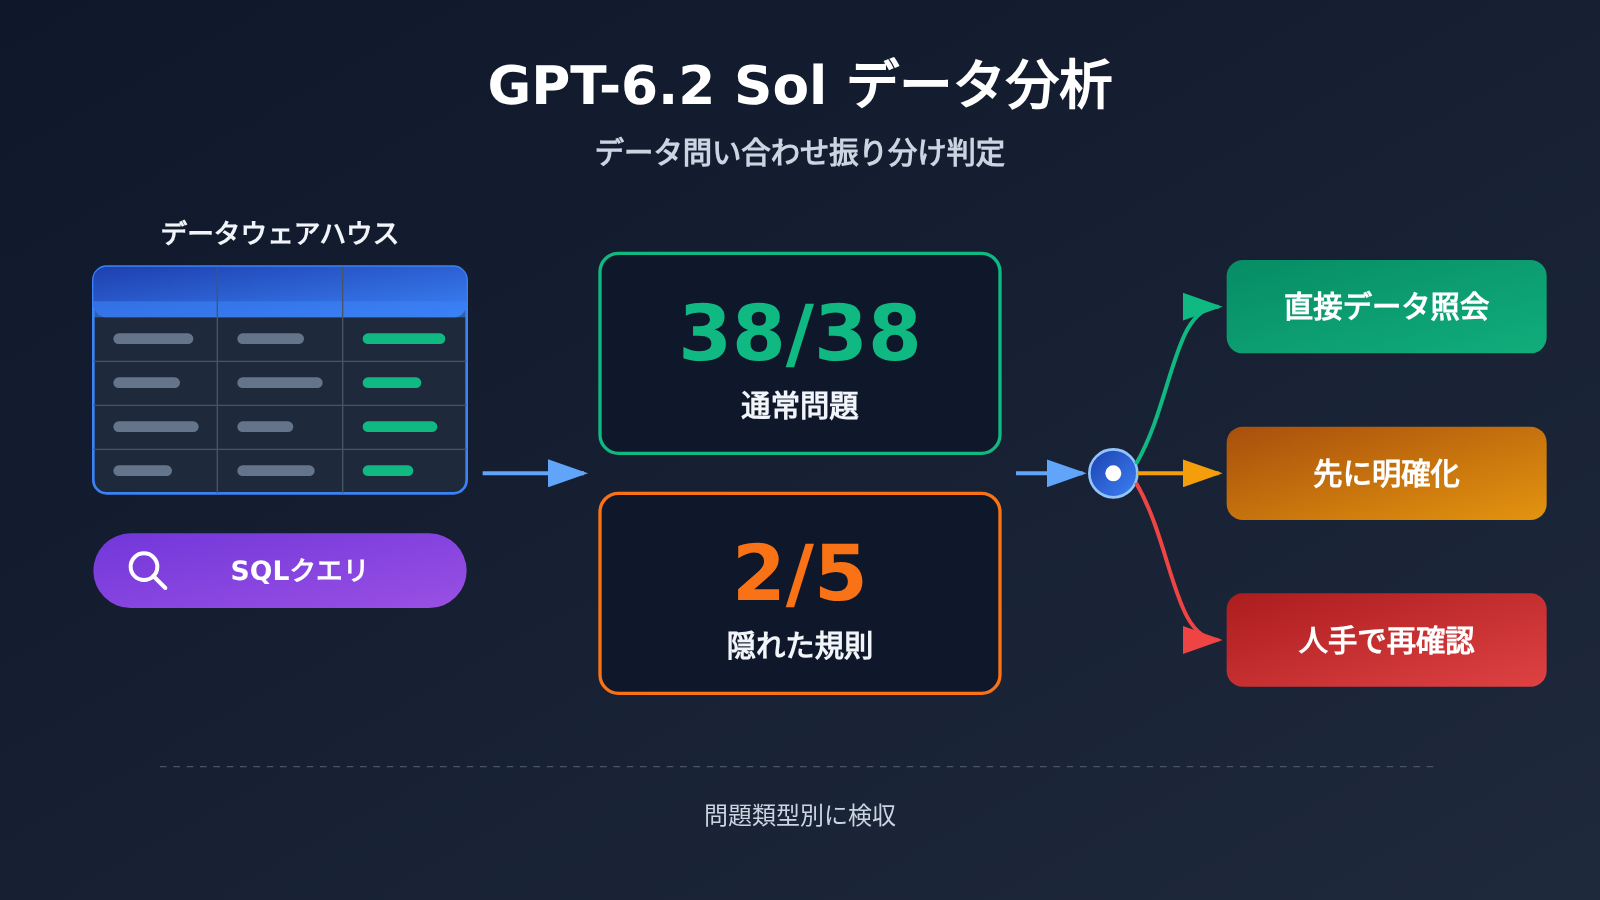
GPT-6.2 Sol データ分析ナレッジマップと読書索引
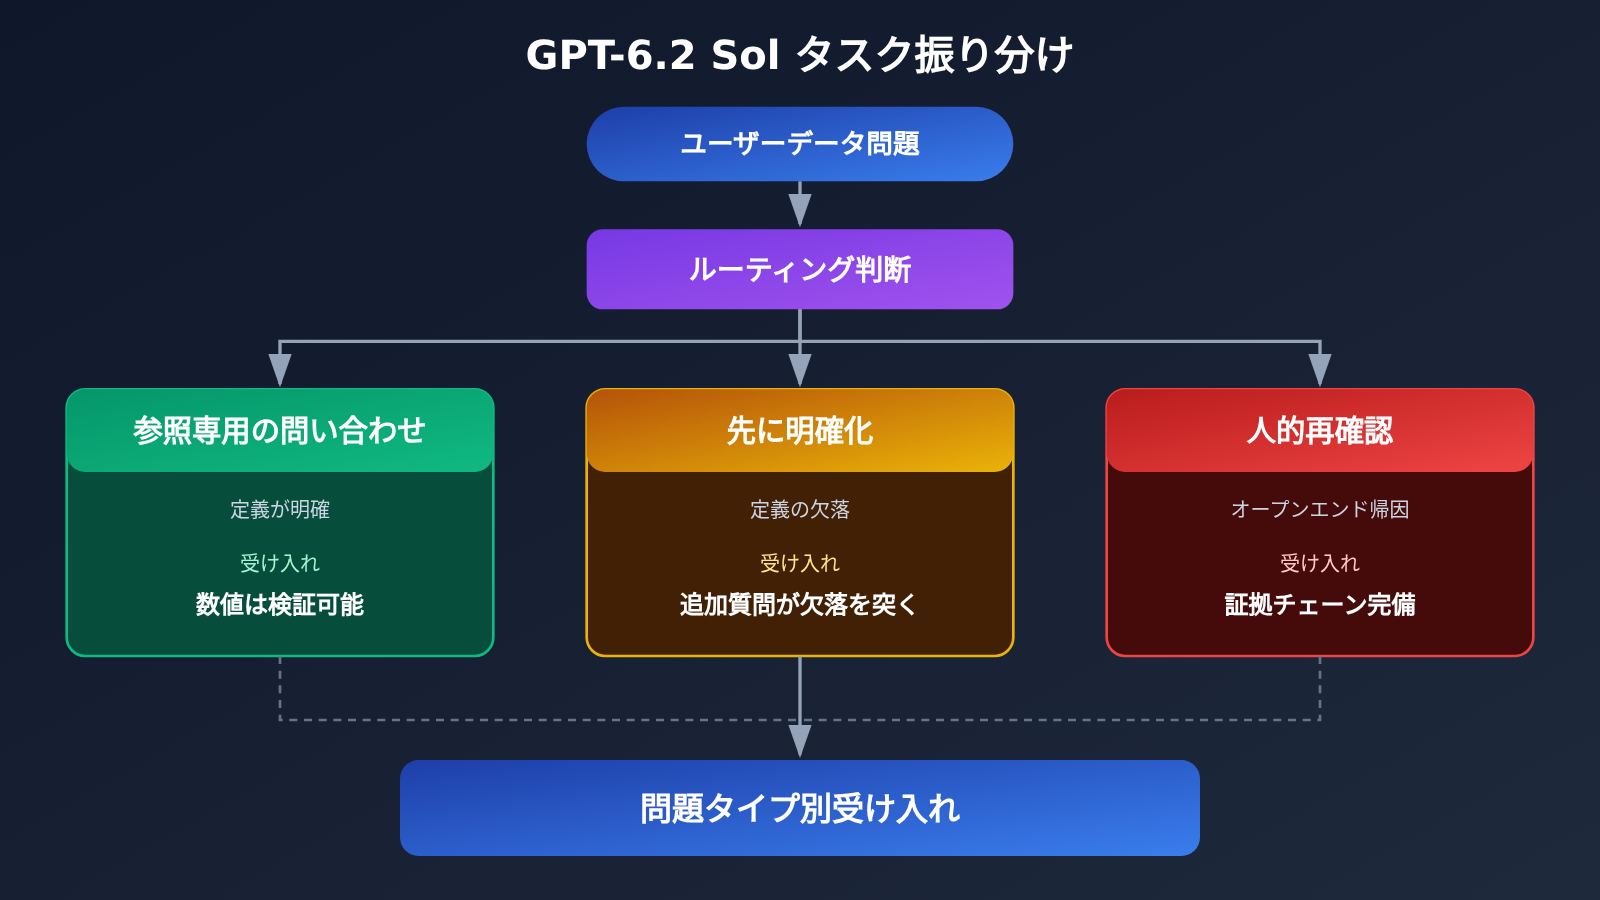
以下の図は全文のタスク振り分けロジックです。各分岐には入力条件、モデルが返すべき出力、そしてこの分岐が本文中でどの番号に対応するかが明記されています。
ユーザーがデータに関する質問を提起
 │
 ├─ 口径が明確 + 影響の小さい集計 ──→ [1] Sol 読み取り専用の問い合わせ
 │                              出力:数値 + 分子/分母 + 期間とタイムゾーン + クエリ文
 │
 ├─ 口径の欠落 / データ不足 ────→ [3.2] まず明確化
 │                              出力:具体的な追加質問 1 件 + 選択可能な口径リスト
 │
 └─ オープンな原因分析 / 対外意思決定 ──→ [3.3] アナリストによるレビューへ
                                出力:初期的な調査記録 + 裏付け証拠 + 代替説明のチェック
            ↓
   [2] レイテンシと 1 問あたりのコストで前面に置くか判断
            ↓
   [4] 自分のデータで問題タイプ別に受け入れ検証し、データ日付とクエリ証拠を添えた結果を納品
各節の前後関係は以下のとおりです。並列する第 3 節は必要に応じて参照でき、その他の節は順番に読むことをおすすめします。
| 節番号 | 答える問い | 次の節に何を提供するか | 読み終えたらできること |
|---|---|---|---|
| 1 | Sol はどの種類の問題で安定するか | 問題タイプの境界:38/38 と 2/5 | 直接データを問い合わせできる範囲を線引きする |
| 2 | 前面に置くのは割に合うか | レイテンシ、1 問あたりのコスト、外挿の仮定 | 対話型シーンの予算と待ち時間を判断する |
| 3 | どんな手がかりを明確化したり人手に回したりすべきか | 3 種の失点パターンと 3 種の出力サンプル | ルーティングルールを設計する |
| 4 | 自分のデータでどう受け入れ検証するか | 問題タイプ別の指標と境界 | 再検証可能な成果物を 1 つ生み出す |
To Know:GPT-6.2 Sol データ分析関連用語
| 用語 | 簡潔な説明 |
|---|---|
| データウェアハウス | 業務システムに散在する履歴データを集約し、問い合わせ分析に供するデータ集合 |
| 指標口径 | 指標の定義、フィルタ条件、分子分母、時間境界 |
| 読み取り専用 SQL | 検索と集計のみを行うクエリ方式。データソース自体は読み取り専用の権限を保つ |
| 隠れた規則性問題 | データに構造的な異常をあらかじめ埋め込み、問題は手がかりのみを与え、モデルが能動的に具体的な規則を見つける必要がある |
| クエリ証拠 | 他者が結論を再検証できるクエリ文、口径、結果、データ日付 |
| p50 / p95 レイテンシ | 半数リクエストがどれだけの時間で完了するか / 95% のリクエストがどれだけの時間で完了するか |
| キャッシュ入力 | 上流の課金時に再利用可能な入力トークンとして識別される。単価は通常の入力よりはるかに低い |
| 問題タイプ別の受け入れ検証 | 問い合わせ、明確化、拒否回答、探索などの問題タイプを別々に採点し、総合スコアが特定の種類の誤りを覆い隠すのを防ぐ |
1. GPT-6.2 Sol によるデータ分析:まずは安定的に検証できる問い合わせ結果から
1.1 Plotly のテストでは何をしたのか
Plotly は Plotly Studio Embedded のテストフレームワークの中で、OpenRouter 経由でモデルを呼び出し、読み取り専用のツールを4種類だけ開放しました。データセットの一覧表示、SQLクエリの実行、グラフ描画、テーブル表示です。テスト用リポジトリはある風力発電企業を模擬しており、約1,990万行のデータ、44テーブル、554列を含んでいます。英語の43問を、答案キーと採点ルールに基づいて1問ずつ合否判定しました。採点モデルは Claude Sonnet 5、temperature=0 で、減点された問題はチームが人手で再確認しています。
この設定は、企業BIにおける問い合わせの実際の姿に近いものです。モデルはデータ全体を見ることができず、自分でテーブルを探し、SQLを書き、結果を読んでから回答します。問題集と答案キーは Plotly が保持しており、外部から1問ずつ再現することはできないため、以下の数値は「方法が説明された単回観察」として理解すべきで、安定したランキングと見なすのは適切ではありません。
| 問題タイプ | 問題数 | GPT-6.2 Sol の結果 | 業務上の意味 |
|---|---|---|---|
| 通常分析 | 20 | 20/20 | 固定した集計定義の集計は、試行的に直接回答できる |
| 曖昧性の判定 | 5 | 5/5 | 質問自体に複数の解釈があり得ることを識別できる |
| データで回答不能 | 5 | 5/5 | データが支持しない場合は回答を拒否し、無理に数字を作らない |
| データ品質 | 3 | 3/3 | 欠損や重複などの問題に気づくことができる |
| 統計の落とし穴 | 5 | 5/5 | よくある統計的な誤読を避けられる |
| 隠れた規則性 | 5 | 2/5 | オープンエンドな規則性の発見は、なお人手による検証が必要 |
| 合計 | 43 | 40/43 | 前半38問はすべて合格、減点はすべて探索系の問題に集中 |
Plotly はさらに、他のモデルが再実行時に最大3問の変動があったことにも言及しています。40/43 は満点とわずか3問の差で、ちょうどこの変動範囲に収まります。したがって、より注目すべきは減点の分布です。減点はすべて「隠れた規則性」の問題に集中しており、前の5類型では1問も間違えていません。
1.2 固定した集計定義の問い合わせがなぜ検証可能なのか
アフターサービスレポートを例にすると、「過去7日間の各倉庫の返品率」が安定的に検証できるのは、次の3点があらかじめ固定されていることが前提です。分母は受領済み注文なのか全注文なのか、時間範囲はどのタイムゾーンで区切るのか、フィルタ条件はテスト注文や社内注文を除外しているのか。この3点が集計定義のドキュメントに書かれていれば、モデルが生成したSQLと結果を、人手によるクエリと項目ごとに突き合わせられます。
固定した集計定義は、「モデルが賢いかどうか」という問いを「数字が一致するかどうか」に変え、後者は自動比較が可能になります。これが38問すべて合格でき、しかもその合格に意味がある理由でもあります。これらの問題の多くには、唯一の標準答案があるからです。
2. GPT-6.2 Sol のデータ分析におけるレイテンシとコスト:フロントエンドに置くべきか
2.1 2世代の Sol による1ラウンドの比較
ユーザーがフロントエンドでデータについて質問するとき、待ち時間が体験を直接左右します。Plotly のレポートでは、同一の43問からなる1ラウンドにおける GPT-6.2 Sol と GPT-6.1 Sol の比較が示されています。
| 指標 | GPT-6.1 Sol | GPT-6.2 Sol | 変化 |
|---|---|---|---|
| 1ラウンドの費用 | $2.61 | $1.22 | 約53.3%減 |
| 1問あたりの所要時間の中央値 | 17.6 秒 | 10.5 秒 | 約40.3%減 |
| ツール呼び出し回数 | 258 | 158 | 明確に減少 |
| モデル呼び出し回数 | 227 | 173 | 減少 |
| 入力量 | 約780万 tokens | 約460万 tokens | 減少 |
| 出力量 | 約7万 tokens | 約4.5万 tokens | 減少 |
| キャッシュ入力の割合 | 94% | 97% | 向上 |
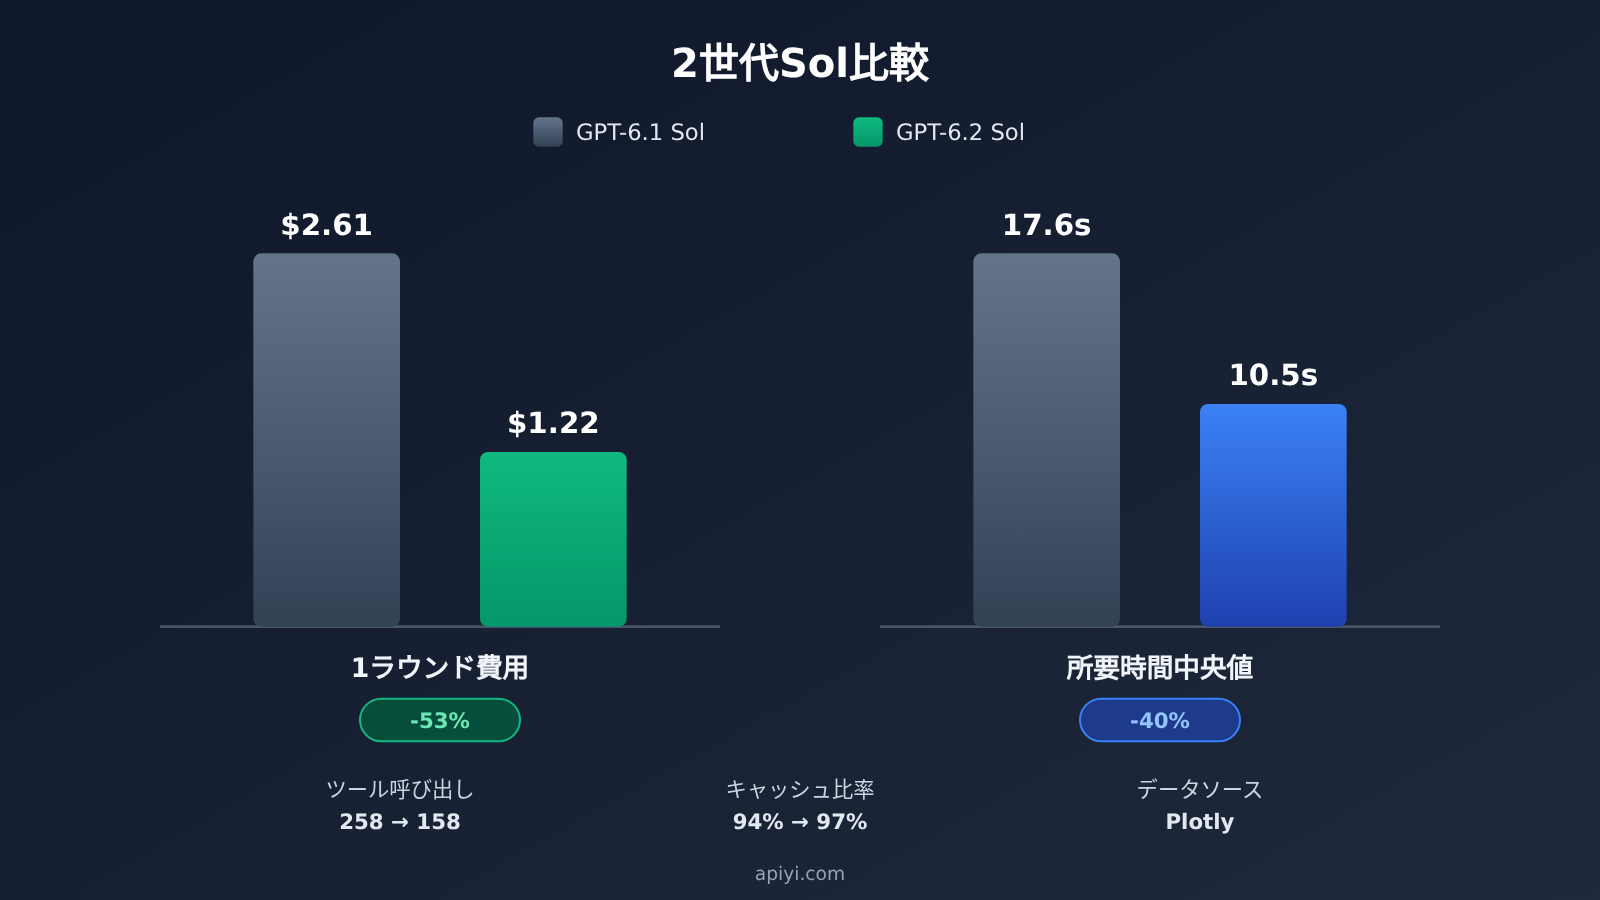
2世代の Sol は短いコンテキストの Standard 基本料金が同じですが、1ラウンドの費用はほぼ半減しています。差はタスクの過程に由来します。呼び出しの回数が減り、読み書きする token が減り、キャッシュヒット率が上がったのです。そのためデータ分析シーンのコストを評価するときは、「1問を解くのにいくらかかるか」を単位にすべきで、100万 token あたりの料金はその一要素にすぎません。
2.2 1000問あたり約 $28.4 という外挿とその前提
1ラウンドの $1.22 を43問で割ると、1問あたり約 $0.0284、1000問に外挿すると約 $28.4 になります。この数字が成り立つには、次の前提を同時に満たす必要があります。
- 問題の種類の分布が Plotly の43問と同じで、そのうち探索型の問題が約12%を占める
- 同じ OpenRouter チャネルと同じ料金体系を使う
- キャッシュ率が97%前後に保たれ、問題間で同じシステムプロンプトとテーブル構造の説明を共有する
- 各問を1回だけ実行し、リトライしない
Plotly ランキングのもう一つの数字は1問あたりコストの中央値 $0.017 で、これは均等割り値とは別の統計量です。探索型の問題はツール呼び出しが多く時間もかかるため平均値を押し上げますが、中央値はふつうのデータ質問1問のコストに近くなります。予算を立てるときは、日常的な質問は中央値で見積もり、探索型問題の割合に応じて別途上乗せするとよいでしょう。
OpenAI 公式の短いコンテキストの Standard 価格は、通常入力 $2.00、キャッシュ読み取り $0.10、出力 $10.00(USD / 100万 token、出力には推論 token を含む)です。リクエストの入力総量が272Kを超えると、注文全体が長いコンテキスト枠に切り替わります。APIYI apiyi.com の公開価格 API の短い枠は公式と一致し、長い枠は入力 $3、キャッシュ読み取り $0.15、キャッシュ書き込み $3.75、出力 $11.25 です。データ質問のシーンでは1回のリクエストは通常272Kをはるかに下回るので、大量のテーブル構造や過去の結果を一度に詰め込む場合にだけ枠の切り替えを気にすればよいでしょう。
3. GPT-6.2 Sol データ分析における3種類の手がかり:いつ明確化し、いつ人間に引き継ぐか
3.1 隠れた規則の問題でなぜ失点するのか
隠れた規則を含まない38問では、6.2 Sol は1問あたり平均約2.9回のツール呼び出し、6.1 Sol は約4.3回で、どちらも全問通過しました。隠れた規則を含む5問になると、Sol 専門レポートには 6.2 Sol が平均約9回のデータベースクエリ、6.1 Sol が約16回と記録されています。(Plotly 総合ランキングの記事では、前世代を約18回という基準で例示していますが、本記事では専門レポートを基準とします。)
人的なチェックの結果、失点した3問はそれぞれ次のとおりでした。
- 埋め込まれた規則を単独で切り分けられなかった;
- 具体的にどの対象が影響を受けたかを指摘できなかった;
- 効果が実際に存在するその部分のデータに到達できなかった。
3つの失点には共通点が1つあります。クエリが表層で止まってしまっていることです。これを1つの観察として記しておきます。新しいバージョンは探索型の問題での検索がより浅い、ということです。「クエリ回数が少ないことが失点につながる」という因果関係については、変数を統制した実験で確認する必要があります。ビジネスの観点では結論は同じです。自ら証拠を探す必要がある帰属型の問題では、モデルの最初の回答をそのまま結論として扱ってはいけません。
3.2 口径の欠落:まず問い、それから答える
以下では架空のアフターサービスチケットのデータセットを使って3種類の出力を演示します。このデータセットは注文、チケット、商品ロット、倉庫の4つのテーブルを含み、以下の出力は設計サンプルであり、実測結果ではありません。
正常な回答(口径が明確)。ユーザーが「倉庫別に過去7日間の返品率を出して」と尋ねた場合、合格となる出力は各倉庫の数値だけでなく、分子(実物返品チケット数)、分母(同期間に受領済みの注文数)、日付範囲とタイムゾーン(例:北京時間11-13から11-19)、集計の軸(倉庫)を保持し、さらに実行した SQL を添える必要があります。
まず口径を確認(口径が欠落)。ユーザーが「先週の返品率はいくら?」とだけ尋ねた場合、モデルはまず次のように逆質問すべきです。「返品率は返金申請で数えますか、それとも実物の返品で数えますか? 返金のみのケースでは両者に大きな差が出ます。」そのうえで2つの口径を選べるように提示し、ユーザーが選ぶまでは数値を出力しません。
3.3 オープンエンドな帰属:アナリストに引き継ぐ
ユーザーが「あるチャネルの返品率が倍になった。異常はどのロットに集中しているか」と尋ねた時点で、これは隠れた規則の問題の範囲に入ります。モデルはまず初期的な調査を行えます。データの欠落がないか、全体のサンプル数が十分かを確認し、その後チャネル、カテゴリ、倉庫、ロットの順に分割していきます。出力には少なくとも、裏付けとなる証拠を1つと、代替説明を排除するためのチェックを1つ(たとえば、そのチャネルの当週の注文数が異常に落ち込んでいないことを確認し、分母が小さくなったことで倍増した可能性を排除する)を残す必要があります。
ここまで終えたら、出力は「結論」ではなく「アナリストのレビュー待ち」と表示すべきです。ルーティングのルールは1つの表にまとめられます。
| 手がかり | 典型的な質問 | ルーティング | モデルの出力 | 受け入れ時の重点 |
|---|---|---|---|---|
| 口径が明確・影響が小さい | 各倉庫の7日間返品率 | Sol による読み取り専用の問い合わせ | 数値 + 口径 + SQL | 数値が人手のクエリと一致する |
| 口径またはデータが不足 | 先週の返品率はいくらか | まず明確化 | 逆質問1つ + 候補の口径 | 逆質問が不足部分を突いている |
| オープンエンドな帰属・対外意思決定 | 異常はどのロットに集中しているか | アナリストのレビューに引き継ぐ | 調査記録 + 裏付け証拠 + 代替説明のチェック | 証拠の網羅性、誤検知と見逃し |
4. 自社データで GPT-6.2 Sol のデータ分析能力を検証する
4.1 接続とルーティングのコード
gpt-6.2-sol は Responses と Chat Completions の2つのエンドポイントから呼び出せます。関数呼び出しと組み込みツールは Responses のパスを通ります。どちらのエンドポイントも none 推論ティアを受け付けないため、既存コードを移行する際はこのパラメータを確認する必要があります。以下は Chat Completions でルーティング分類を行う最小例です。
import openai, json

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の OpenAI 互換インターフェース
)

question = "上周退货率多少"
resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[
        {"role": "system", "content": "把用户的数据问题分类为 direct / clarify / escalate,"
                                      "只返回 JSON:{\"route\":..., \"reason\":...}"},
        {"role": "user", "content": question},
    ],
)
print(json.loads(resp.choices[0].message.content))
読み取り専用 SQL ツール呼び出しの完全な例を表示(Responses API)
import openai, json, sqlite3

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# データベースレベルで読み取り専用として開く。正規表現チェックは二重の安全策にすぎない
conn = sqlite3.connect("file:aftersales.db?mode=ro", uri=True)

def run_readonly_sql(sql: str) -> str:
    head = sql.strip().lower()
    if not (head.startswith("select") or head.startswith("with")):
        return json.dumps({"error": "only read-only queries allowed"})
    rows = conn.execute(sql).fetchmany(200)
    return json.dumps({"rows": rows, "row_count": len(rows)}, default=str)

tools = [{
    "type": "function",
    "name": "run_readonly_sql",
    "description": "在售后数据仓库执行只读 SQL,返回最多 200 行",
    "parameters": {
        "type": "object",
        "properties": {"sql": {"type": "string"}},
        "required": ["sql"],
    },
}]

instructions = (
    "你是数据分析助手。回答必须包含:分子、分母、时间范围与时区、聚合维度、所执行的 SQL。"
    "口径不明确时先提问;涉及归因的结论标注为待分析师复核。"
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    instructions=instructions,
    input="按仓库列过去 7 天的退货率",
    tools=tools,
)

# モデルが最終回答を返すまで、ツール呼び出しをループ処理する
while True:
    calls = [o for o in resp.output if o.type == "function_call"]
    if not calls:
        break
    outputs = [{
        "type": "function_call_output",
        "call_id": c.call_id,
        "output": run_readonly_sql(json.loads(c.arguments)["sql"]),
    } for c in calls]
    resp = client.responses.create(
        model="gpt-6.2-sol",
        previous_response_id=resp.id,
        input=outputs,
        tools=tools,
    )

print(resp.output_text)
print("output_tokens:", resp.usage.output_tokens)
🚀 クイックスタート:自社の業務サンプルで検証する際は、APIYI apiyi.com から新規ユーザー向けの無料テスト枠を申請できます。同じ API Key で
gpt-6.2-solと他の主要モデルを切り替え、同じ問題セットで横断比較できます。データソースは読み取り専用のままで構いません。
4.2 問題タイプ別の受け入れ指標
受け入れ用の問題バンクは、第3節で示した3種類のルーティングをカバーすることをおすすめします。問題タイプごとに個別に採点します。
| 問題タイプ | 主要指標 | 判定方法 | 推奨記録項目 |
|---|---|---|---|
| 固定定義の数値質問 | 数値正解率 | 手作業のSQL結果と行ごとに照合 | 1問あたりのコスト、p50/p95レイテンシ |
| 集計定義の欠落 | 確認の適切率 | 問い返しが本当に欠けている集計定義を捉えているか | 「聞くべきでないのに聞いてしまう」ケースの有無 |
| データが回答不能 | 回答拒否の正解率 | 数値を捏造しない | 誤答回数 |
| オープンエンドの要因分析 | 証拠のカバレッジ、誤検出と検出漏れ | 裏付け証拠+代替解釈のチェックが揃っているか | 複数回再実行した際の一貫性 |
Plotlyのレポートは所要時間の中央値しか示していませんが、自社の受け入れテストではp95を補う必要があります。フロントエンドの体験は、少数のロングテールリクエストに引きずられがちです。特に探索型の質問ではロングテールが発生しやすくなります。コスト面では、usage.output_tokens から出力量を読み取り、推論トークンは通常 output_tokens_details.reasoning_tokens サブ項目に記載されているので、さらにキャッシュ読み取り量を組み合わせて1問あたりの実際のコストを算出します。
4.3 小サンプルと再実行の境界
Plotlyの隠しパターンはわずか5問しかなく、2/5の信頼区間は非常に広くなります。別の問題セットに変えると1/5になるかもしれませんし、4/5になるかもしれません。他のモデルで再実行した際には最大3問の変動が発生したことがあるため、単一ラウンドの総合スコアの差だけではモデル選定を裏付けるには不十分です。自社で受け入れテストを行う際は、探索型の質問を少なくとも数ラウンド繰り返し実行し、かつ5つの変数を揃えてください。データスナップショット、ツールセット、モデルの推論レベル、呼び出しチャネル、採点表の5つです。どれか1つでも変われば、前後の結果を直接比較することはできません。
💡 受け入れテストの提案:チャネルは見落とされやすい変数です。Plotlyの費用はOpenRouterからのものですが、自社の本番チャネルでは課金とキャッシュ戦略が異なる可能性があります。APIYI apiyi.com 上で同じデータスナップショットを使って再実行し、実際の請求書と照らし合わせて1,000問あたりのコストを再計算したうえで、フロントエンドのクォータを決めることをおすすめします。
4.4 受け入れ可能な成果物
受け入れの基準は、各データ問い合わせ結果を第三者が独立して再確認できることです。以下は合格する成果物の一例です(架空データ)。
question: 按仓库列过去 7 天的退货率
route: direct
data_snapshot: 2026-11-19 23:59 (Asia/Shanghai)
metric_definition:
  numerator: 实物退回工单数(status = returned)
  denominator: 同期已签收订单数(排除测试单、内部单)
  time_range: 2026-11-13 ~ 2026-11-19,北京时间
  group_by: warehouse_id
query: "SELECT w.warehouse_id, ... GROUP BY w.warehouse_id"
result: [{warehouse: 华东一仓, rate: 3.1%}, {warehouse: 华南二仓, rate: 2.4%}]
model: gpt-6.2-sol
cost_usd: 0.012
latency_s: 8.7
reviewer: 无需复核(固定口径问数)
1件の成果物にはデータ日付、集計口径、クエリ、結果が含まれ、GPT-6.2 Sol はフロントエンドのデータ問い合わせの段階で受け入れできます。これらの項目がない出力は、たとえ数字がたまたま正しくてもレポートに入れるべきではありません。自社のデータウェアハウスでこの一連の流れを稼働させたい場合は、APIYI apiyi.com の OpenAI 互換インターフェースから始め、まず固定口径のデータ問い合わせをリリースし、その後、段階的に確認と要因分析へ広げてください。
参考資料
- Plotly – GPT-6.2 Sol データ分析専門レポート:43問の項目別結果、費用と所要時間の比較
- リンク:
plotly.com/blog/gpt-6-2-sol-plotly-data-analytics-bench
- リンク:
- Plotly – DataAnalyticsBench のテスト方法:出題形式の設計、採点ルール、ランキング集計の基準
- リンク:
plotly.com/blog/introducing-dataanalyticsbench
- リンク:
- OpenAI – GPT-6.2 Sol モデルカード:コンテキストウィンドウ、対応エンドポイント、長コンテキストの課金ルール
- リンク:
developers.openai.com/api/docs/models/gpt-6.2-sol
- リンク:
- OpenAI – API 価格:Standard の入力・キャッシュ・出力単価
- リンク:
developers.openai.com/api/docs/pricing
- リンク:
- APIYI 公開価格API:
gpt-6.2-solの短コンテキスト枠と長コンテキスト枠の料金計算式- リンク:
api.apiyi.com/api/pricing
- リンク:
著者: APIYI 技術チーム
技術交流: APIYI 公式サイトのトップページよりお問い合わせください。その他の導入資料は docs.apiyi.com のドキュメントセンターをご覧ください。


