
作者注:拆解 Code Arena WebDev 榜第 6 名 Qwen4-Max:前六格局、国产内部差距、与头部模型的分差、票数与单任务成本的正确读法。
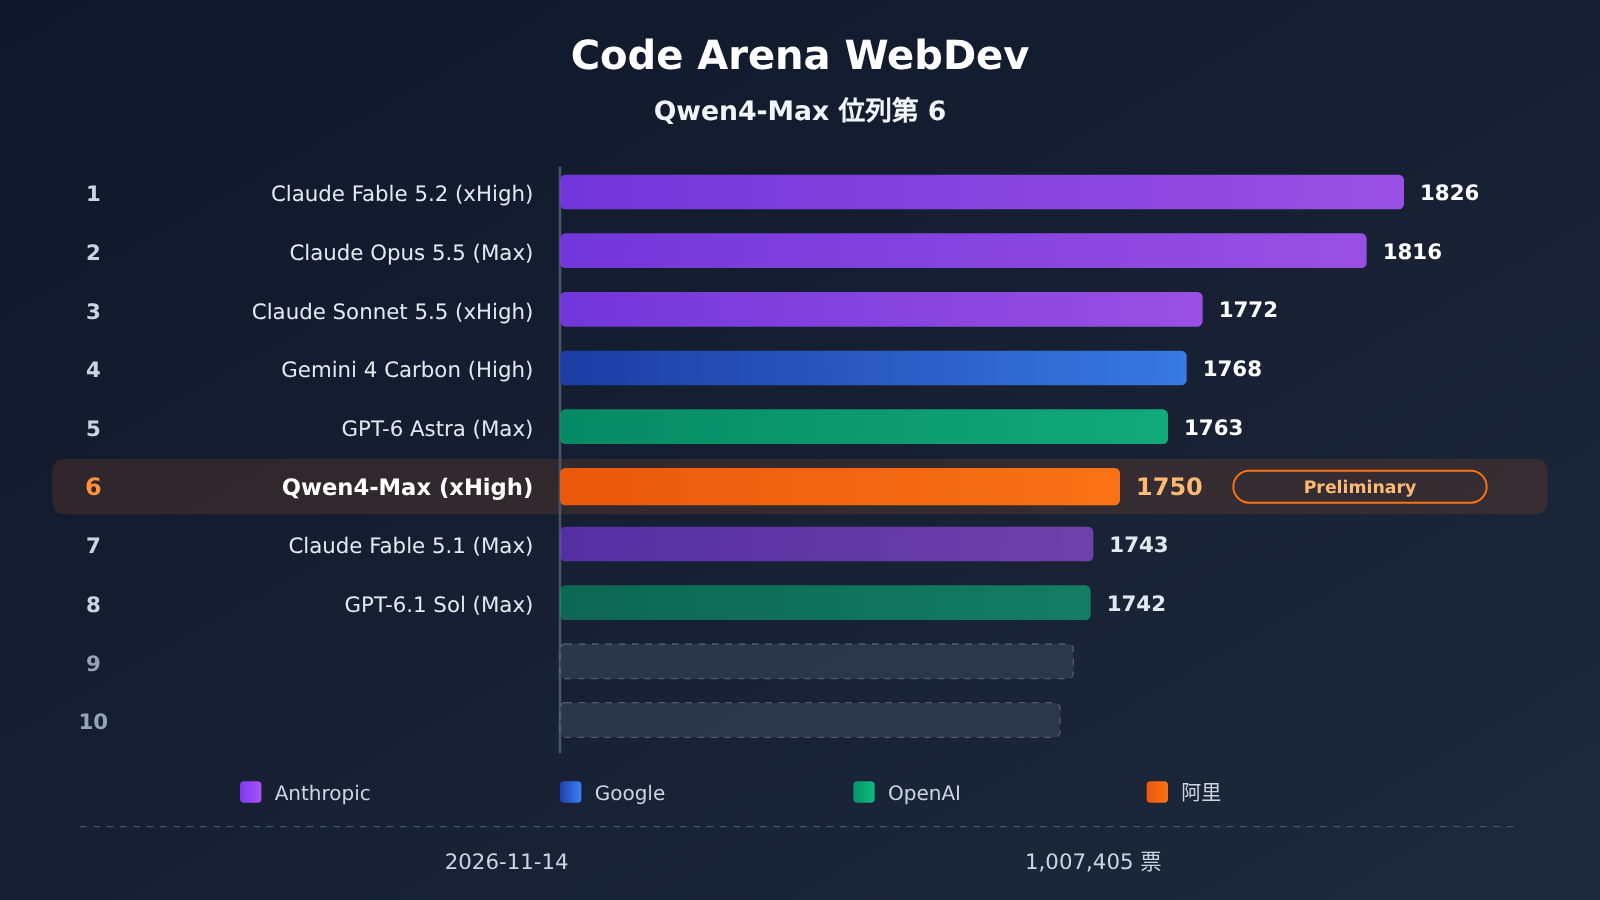
先说结论:在 arena.ai 的 Code Arena WebDev 榜(Overall 分类,页面标注 2026-11-14)上,Qwen4-Max (xHigh) 以 1750 分排在第 6。这是国产模型第一次挤进这张榜的前六,也是前六里唯一一个非美国实验室的模型。
这不是把第 6 包装成第 1 的宣传稿。 Qwen4-Max 在榜上带有 Preliminary 标记,只有 1,814 票,名次还会动。阿里同一张官方图里,它在 Terminal-Bench 和 ProgramBench 上仍明显落后 Opus 5.5 与 GPT-6 Astra。
核心价值:读完本文,你会拿到一份可以自己点开核对的榜单元数据,并明白 Qwen4-Max 的第 6 名该怎么用、不该怎么用。
Qwen4-Max Code Arena WebDev 第 6 核心要点
在讨论名次之前,先把榜单的元数据摆出来。任何关于“第几名”的说法,都应该先核对日期、票数和参评模型数,否则很难判断名次是否站得住。
| 要点 | 数据(同榜公开数据) | 怎么读 |
|---|---|---|
| 榜单与分类 | arena.ai Code Arena WebDev,Overall | 只代表网页开发类盲测偏好 |
| 页面日期 | 2026-11-14 | 名次随投票持续变化 |
| 总票数 / 模型数 | 1,007,405 票 / 159 个模型 | 样本量大,但单模型票数差异很大 |
| Qwen4-Max 名次与分数 | 第 6,1750 分 | 前六唯一非美国实验室模型 |
| Qwen4-Max 票数与标记 | 1,814 票,Preliminary | 仍处于初步评估阶段 |
| 单任务成本 P50 | $4.18 | 榜上统计的中位数,不是模型单价 |
Qwen4-Max 榜单口径详解
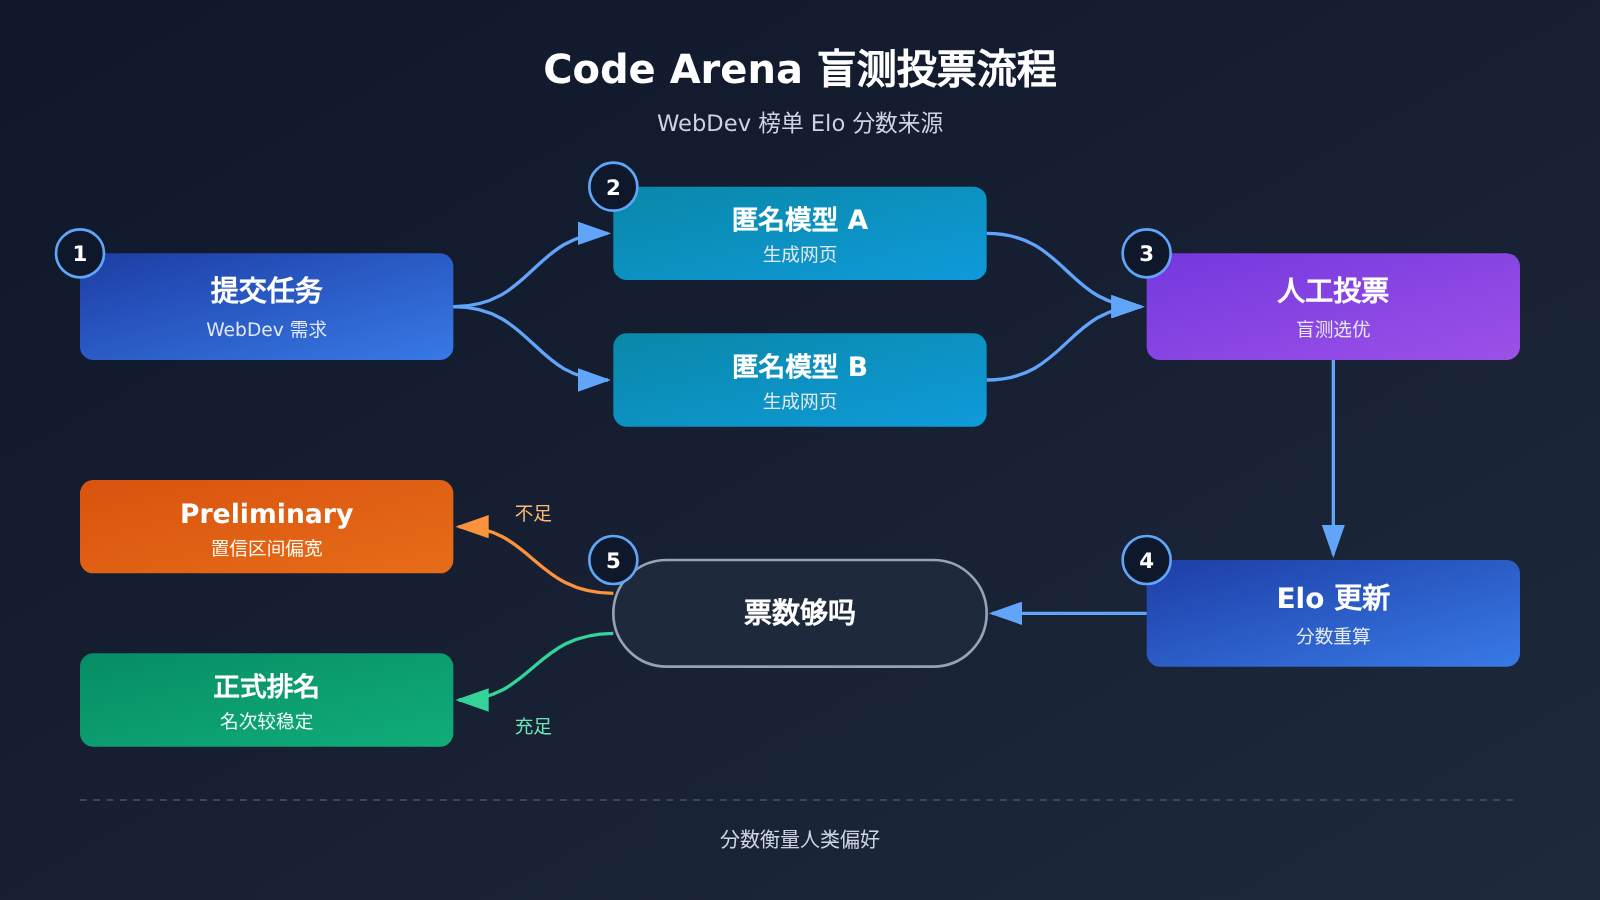
Code Arena 的 Elo 分数来自盲测人工投票:用户给出同一个网页开发任务,看两个匿名模型的产出,再投票选更好的一方。分数反映的是“在人类评审眼里谁做的网页更好”,它衡量的是偏好,而不是一份综合生产力总分。
Preliminary 标记的含义也要读懂。它说明该模型参与对战的次数还不够多,置信区间偏宽。同榜第 4 名的 Gemini 4 Carbon (High) 也带着这个标记,所以第 4 到第 6 这一段,未来几周出现位置交换并不意外。
Code Arena WebDev 前六是谁:Qwen4-Max 的对手格局
把前十完整列出来,能更直观地看到 Qwen4-Max 所处的位置。前五被三家美国实验室占满,其中 Anthropic 一家就拿了三席。
| 排名 | 模型 | 分数 | 所属实验室 | 备注 |
|---|---|---|---|---|
| 1 | Claude Fable 5.2 (xHigh) | 1826 | Anthropic | 榜首 |
| 2 | Claude Opus 5.5 (Max) | 1816 | Anthropic | 单任务 P50 $8.99 |
| 3 | Claude Sonnet 5.5 (xHigh) | 1772 | Anthropic | — |
| 4 | Gemini 4 Carbon (High) | 1768 | Preliminary | |
| 5 | GPT-6 Astra (Max) | 1763 | OpenAI | 单任务 P50 $9.43 |
| 6 | Qwen4-Max (xHigh) | 1750 | 阿里 | Preliminary,1,814 票 |
| 7 | Claude Fable 5.1 (Max) | 1743 | Anthropic | — |
| 8 | GPT-6.1 Sol (Max) | 1742 | OpenAI | — |
| 9 | Muse Wonder Full (Max) | 1724 | — | — |
| 10 | Claude Sonnet 5.5 (High) | 1716 | Anthropic | — |
前五格局对 Qwen4-Max 意味着什么
前六中 Anthropic 占 3 席(Fable 5.2、Opus 5.5、Sonnet 5.5),Google 和 OpenAI 各 1 席,阿里 1 席。换句话说,Qwen4-Max 是在三家头部实验室的旗舰之间“挤”出了一个位置,而不是在一个松散的榜上捡到名次。
另一个值得注意的细节是,第 6 到第 8 名非常密集:1750、1743、1742,三者相差不到 10 分。Qwen4-Max 领先 Claude Fable 5.1 和 GPT-6.1 Sol 的幅度,小于它落后 GPT-6 Astra 的 13 分。名次的稳定性,要等票数涨上去之后再看。
Qwen4-Max 在国产模型里的位置
如果只看国产阵营,Qwen4-Max 的领先就比较明显了。它是国产模型中唯一一个进入前十的,第二名要到第 13 位才出现。
| 国产排名 | 模型 | 分数 | 榜单名次 | 与 Qwen4-Max 差距 |
|---|---|---|---|---|
| 1 | Qwen4-Max (xHigh) | 1750 | 第 6 | — |
| 2 | Kimi K3.1 Pro (Max) | 1686 | 第 13 | −64 |
| 3 | Qwen3.8-Max (0902) | 1676 | 第 16 | −74 |
| 4 | Qwen3.8-Max | 1670 | 第 18 | −80 |
| 5 | Ernie 5.5 Flash Preview | 1668 | 第 18 | −82 |
| 6 | DeepSeek-V4.1-Flash-20261017 (Max) | 1661 | 第 19 | −89 |
| 7 | Kimi K3 (Max) | 1658 | 第 20 | −92 |
| 8 | MiMo-V2.6-Flash | 1639 | 第 26 | −111 |
| 9 | Hy4 preview | 1632 | 第 27 | −118 |
| 10 | GLM-5.3 (Max) | 1622 | 第 31 | −128 |
| 11 | DeepSeek-V4.1-Flash-20260910 | 1621 | 第 33 | −129 |
国产内部差距的两层含义
第一层是代际跃升。Qwen4-Max 比自家上一代 Qwen3.8-Max (0902) 高 74 分,名次从第 16 跳到第 6。在同一个榜、同一套投票机制下,这个提升幅度比较可观。
第二层是与国产第二名的距离。Qwen4-Max 比 Kimi K3.1 Pro 高 64 分,这个差距接近它落后 Opus 5.5 的 66 分。也就是说,Qwen4-Max 目前站在国产阵营和全球头部之间的中间位置:往下拉开了国产对手,往上离榜首还有一段路。
需要提醒的是,国产第 2 到第 7 名挤在 1686 到 1658 之间,分差很小。用这张榜给这几家排先后,意义不大。
Qwen4-Max 跟全球头部差多少
Code Arena WebDev 上的分差
把 Qwen4-Max 与头部模型的分差列出来,并按通用 Elo 公式(400 分尺度)粗估“对战胜率”,可以帮助理解这些分差的实际含义。arena 的具体统计方法可能与标准 Elo 有出入,下列胜率只作直觉参考:
- 对第 5 名 GPT-6 Astra:1750 vs 1763,差 13 分,粗估对战胜率约 48%,基本属于势均力敌。
- 对第 2 名 Opus 5.5:差 66 分,粗估对战胜率约 41%。
- 对第 1 名 Fable 5.2:差 76 分,粗估对战胜率约 39%。
- 对国产第二 Kimi K3.1 Pro:领先 64 分,粗估对战胜率约 59%。
整张榜的分数范围是 1071 到 1826。在这个尺度上,Qwen4-Max 与榜首的 76 分差距不算大,但也说明在网页开发偏好上,Anthropic 的头部模型依然更受评审青睐。
同图其他基准:Elo 高不等于终端任务强
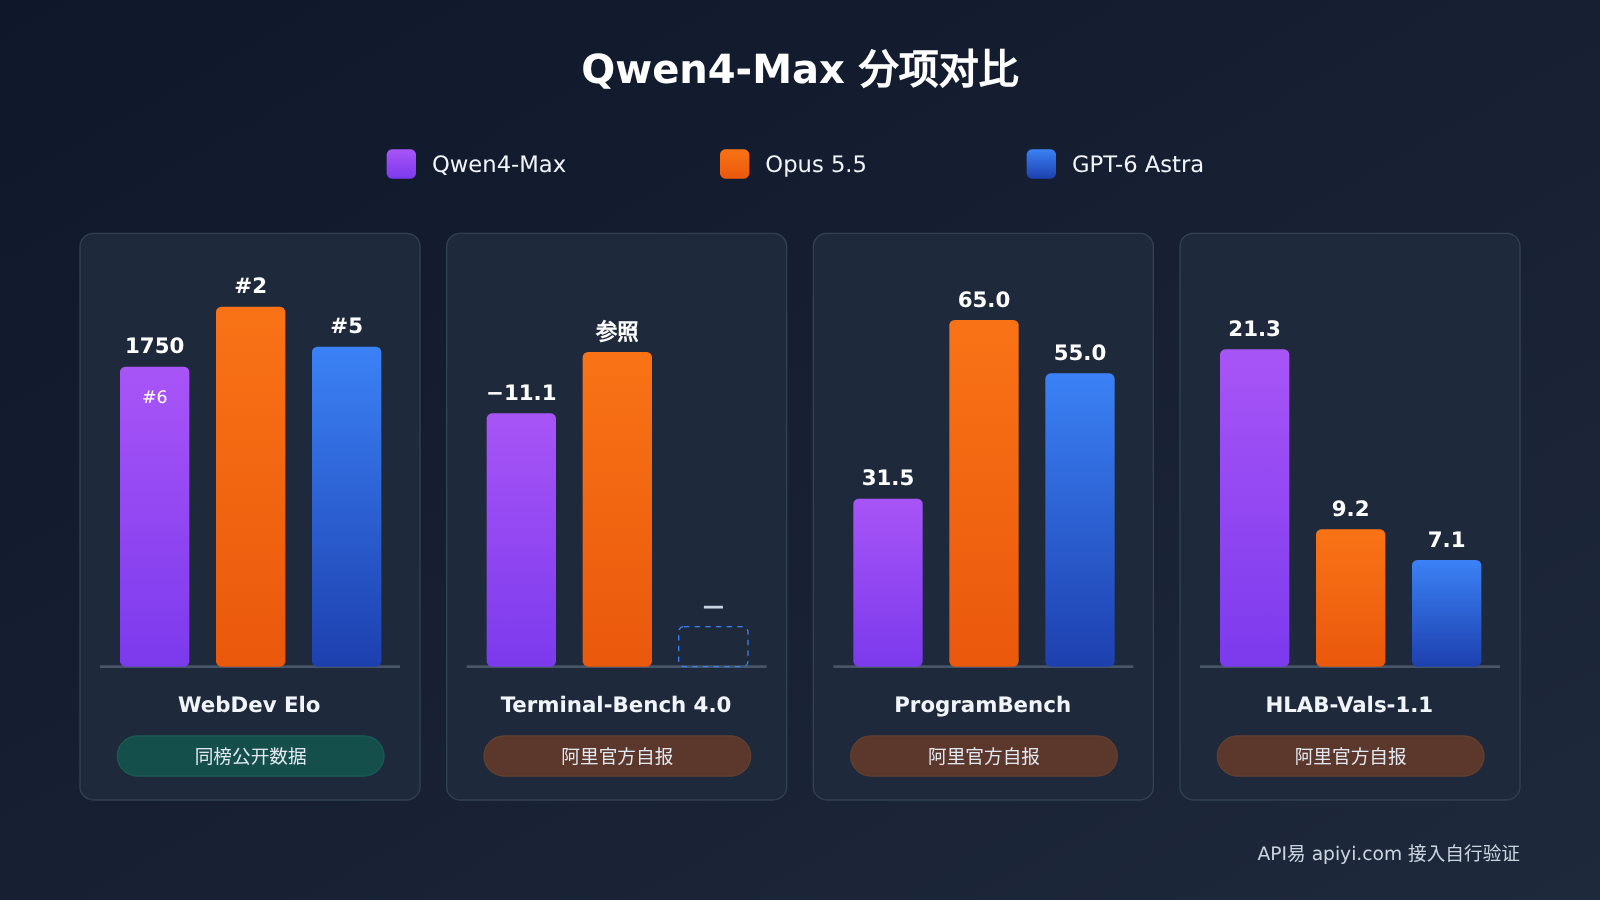
阿里发布 Qwen4-Max 时用的是一张多基准同图。以下数据均为阿里官方自报,并非 arena 榜单数据,也不是第三方复现结果。
| 基准(官方自报) | Qwen4-Max | Opus 5.5 | GPT-6 Astra | 其他 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 48.5 | 59.6 | 59.1 | Kimi 67.2 |
| ProgramBench | 31.5 | 65.0 | 55.0 | — |
| JobBench | 68.5 | 75.4 | — | — |
| HLAB-Vals-1.1 | 21.3 | 9.2 | 7.1 | — |
| AA-Briefcase v1.1 Elo | 1686 | 1801 | 1569 | — |
这张表能说明一件关键的事:Qwen4-Max 在网页开发盲测里分数很高,但在终端操作类和工程编程类基准上差距仍然明显。Terminal-Bench 4.0 上,它比 Opus 5.5 低 11.1 分,图中 Kimi 模型的 67.2 甚至更高;ProgramBench 上,它的 31.5 还不到 Opus 5.5 的一半。
它也有明显领先的项目。HLAB-Vals-1.1 上 Qwen4-Max 拿到 21.3,远高于 Opus 5.5 的 9.2 和 GPT-6 Astra 的 7.1;AA-Briefcase 上它也高于 GPT-6 Astra。所以更准确的描述是:Qwen4-Max 的能力分布与头部模型不同,而不是“全面接近”。
Qwen4-Max 的票数与成本怎么读
票数:1,814 票意味着什么
名次能不能站稳,很大程度取决于票数。Qwen4-Max 的 1,814 票,在约 100 万总票数中占比不到 0.2%,与同榜几个国产模型相比也少很多。
| 模型 | 名次 | 票数 | 单任务成本 P50 | 状态 |
|---|---|---|---|---|
| Qwen4-Max (xHigh) | 第 6 | 1,814 | $4.18 | Preliminary |
| Kimi K3.1 Pro (Max) | 第 13 | 5,215 | $0.89 | — |
| Qwen3.8-Max (0902) | 第 16 | 23,030 | $1.91 | — |
| Claude Opus 5.5 (Max) | 第 2 | 同榜公开数据 | $8.99 | — |
| GPT-6 Astra (Max) | 第 5 | 同榜公开数据 | $9.43 | — |
Qwen3.8-Max 的票数是 Qwen4-Max 的约 12.7 倍,它的分数更接近“稳定值”。Qwen4-Max 的 1750 分目前更像一个早期读数,后续可能上调也可能下调。引用这个名次时,最好同时写出“Preliminary、1,814 票、2026-11-14”这三个限定。
单任务成本 P50:不是模型单价
榜上的单任务成本 P50 是指在该榜任务上,单次任务花费的中位数。它受模型输出长度、推理强度档位(如 xHigh、Max)影响很大,不能当作模型的每百万 tokens 单价来比较。
按这个口径,Qwen4-Max 的 $4.18 约为 Opus 5.5($8.99)的 46%、GPT-6 Astra($9.43)的 44%,但约是 Kimi K3.1 Pro($0.89)的 4.7 倍、上一代 Qwen3.8-Max($1.91)的 2.2 倍。如果你的场景对单次成本敏感,Kimi K3.1 Pro 用约五分之一的成本拿到了 1686 分,这同样值得纳入评估。
Qwen4-Max 官方价与 API易 现价
以下为每 1M tokens 价格,取数日期为 2026-11-16:
- Qwen4-Max 官方价:输入 $1.5,输出 $4.5,缓存读 $0.075。
- API易 在售 Qwen 旗舰
qwen3.8-max:输入 $1.65,输出 $4.95,缓存读 $0.20625。
需要说明,API易 目前尚未上架 qwen4-max,我们会尽快上架这个模型。两者属于不同型号,上面的价格不能直接横向比较,实际可用型号与价格请以 API易 apiyi.com 平台型号列表为准。
复核榜单、对价格、换接入点的三步
读完一张榜,开发者通常会做三件事:核对名次、核对价格、把模型接进自己的项目试一试。建议按下面的顺序来:
- 复核榜单:打开 arena.ai 的 Code Arena WebDev 页面,确认日期、票数和 Preliminary 标记是否有变化。
- 对价格:在 API易 apiyi.com 的型号列表中查看当前在售的 Qwen 型号与实时价格,确认
qwen4-max是否已上架。 - 换接入点:在现有 OpenAI 兼容 SDK 中,把 base_url 改为
https://api.apiyi.com/v1,模型 ID 先填qwen3.8-max,待新型号上架后再切换为qwen4-max做对照。
🚀 快速上手建议:如果你想在自己的 WebDev 任务上验证 Qwen 系列与 Claude、GPT、Gemini 的差距,可以通过 API易 apiyi.com 用一个 API Key 统一调用多家模型,新用户有免费测试额度,适合先跑一批小样本再决定选型。
Qwen4-Max 优缺点分析
Qwen4-Max 的优势
- 网页开发偏好分领先国产阵营:1750 分,比国产第二高 64 分,比上一代高 74 分。
- 与头部的部分差距已经很小:距第 5 名 GPT-6 Astra 仅 13 分,与第 7、8 名几乎持平。
- 单任务成本低于头部旗舰:P50 $4.18,不到 Opus 5.5 和 GPT-6 Astra 的一半。
- 部分基准有独特优势:HLAB-Vals-1.1 官方自报分数明显领先 Opus 5.5 与 GPT-6 Astra。
Qwen4-Max 的局限
- 名次尚未稳定:Preliminary 标记加 1,814 票,引用时需要注明限定条件。
- 终端与工程编程类基准落后:Terminal-Bench 4.0 与 ProgramBench 上明显低于 Opus 5.5 和 GPT-6 Astra,做 Agent 或命令行自动化时需要单独评估。
- 单任务成本高于部分国产模型:比 Kimi K3.1 Pro 和 Qwen3.8-Max 贵不少,成本敏感场景未必划算。
什么时候不该只看 Code Arena WebDev 榜
如果你的主要场景是终端操作、长链路代码修改或多步 Agent 任务,只看 WebDev Elo 就会高估 Qwen4-Max 的实际表现,此时 Terminal-Bench 一类的基准更贴近需求。同样,如果预算是硬约束,应该把单任务成本与分数一起看,而不是只追名次。这张榜最适合回答的问题是:“在人类评审眼里,谁做出的网页更好。”
常见问题 FAQ
Q1: Qwen4-Max 在 Code Arena WebDev 榜第 6 是真名次吗?
是榜单页面上显示的真实名次(2026-11-14,Overall 分类,1750 分)。但它带有 Preliminary 标记,只有 1,814 票,后续名次仍可能变化,引用时建议注明这些条件。
Q2: Qwen4-Max 和 GPT-6 Astra、Opus 5.5 差多少?
在 Code Arena WebDev 上,Qwen4-Max 比 GPT-6 Astra 低 13 分,比 Opus 5.5 低 66 分,比榜首 Fable 5.2 低 76 分。但在阿里官方自报的 Terminal-Bench 4.0 和 ProgramBench 上,它与这两个模型的差距明显更大。
Q3: Qwen4-Max 在国产模型里领先多少?
它是唯一进入前十的国产模型,比国产第二 Kimi K3.1 Pro(第 13,1686 分)高 64 分,比自家上一代 Qwen3.8-Max (0902) 高 74 分。
Q4: Qwen4-Max 最适合哪些场景?
从这张榜的口径看,它更适合网页前端生成、落地页与交互原型这类 WebDev 任务。终端自动化、大型工程级代码修改等场景,建议参考终端类基准并自行跑样本验证。
Q5: 如何通过 API 调用 Qwen 系列模型做对比测试?
可以在 API易 apiyi.com 注册并获取 API Key,在 OpenAI 兼容 SDK 中将 base_url 设为 `https://api.apiyi.com/v1`,模型 ID 填 `qwen3.8-max`。`qwen4-max` 目前暂未上架,我们会尽快上架,上架后改一个模型 ID 即可切换对照。
Q6: 单任务成本 $4.18 是 Qwen4-Max 的价格吗?
不是。$4.18 是榜单统计的单任务成本中位数(P50),受输出长度和推理档位影响。模型单价应看每 1M tokens 的输入、输出和缓存读价格,实时价格可在 API易 apiyi.com 型号列表中核对。
Qwen4-Max Code Arena WebDev 核心要点 Key Takeaways
- 名次:2026-11-14 榜单第 6,1750 分,国产首次进入前六。
- 格局:前五被 Anthropic 三席、Google 一席、OpenAI 一席占满。
- 稳定性:Preliminary 标记加 1,814 票,名次仍会变动。
- 国产差距:领先 Kimi K3.1 Pro 64 分,领先上一代 74 分。
- 能力边界:Terminal-Bench 与 ProgramBench 官方自报仍落后头部。
- 成本口径:P50 $4.18 是单任务中位数,不是模型单价。
- 上手方式:可先在 API易 用
qwen3.8-max搭好对比流程,待新型号上架再切换。
总结
Qwen4-Max 在 Code Arena WebDev 榜上的表现可以概括为三点:
- 第一次进前六:1750 分,前六中唯一非美国实验室模型,离第 5 名只差 13 分。
- 名次尚是早期读数:Preliminary、1,814 票,引用时要写清日期和票数。
- Elo 不等于全面强:官方自报的终端类与工程编程基准上,仍落后 Opus 5.5 与 GPT-6 Astra。
如果你在做选型,建议把这张榜当作“网页开发偏好”的一个参考维度,再结合自己的任务样本和成本预算做判断。推荐通过 API易 apiyi.com 用统一接口把候选模型放在同一批任务上对比,用自己的数据给出结论。
📚 参考资料
- arena.ai Code Arena WebDev 榜:本文名次、分数、票数与单任务成本的来源
- 链接:
arena.ai -
说明: 页面标注 2026-11-14,Overall 分类,可自行核对最新名次与 Preliminary 标记
-
阿里 Qwen4-Max 官方发布图:Terminal-Bench 4.0、ProgramBench 等基准分数来源
- 链接: 以 Qwen 官方发布渠道为准
- 说明: 文中相关数据均为官方自报,非第三方复现
作者: APIYI 技术团队
技术交流: 欢迎在 API易 网站首页联系我们,型号上架与接入说明可访问 docs.apiyi.com 文档中心


