
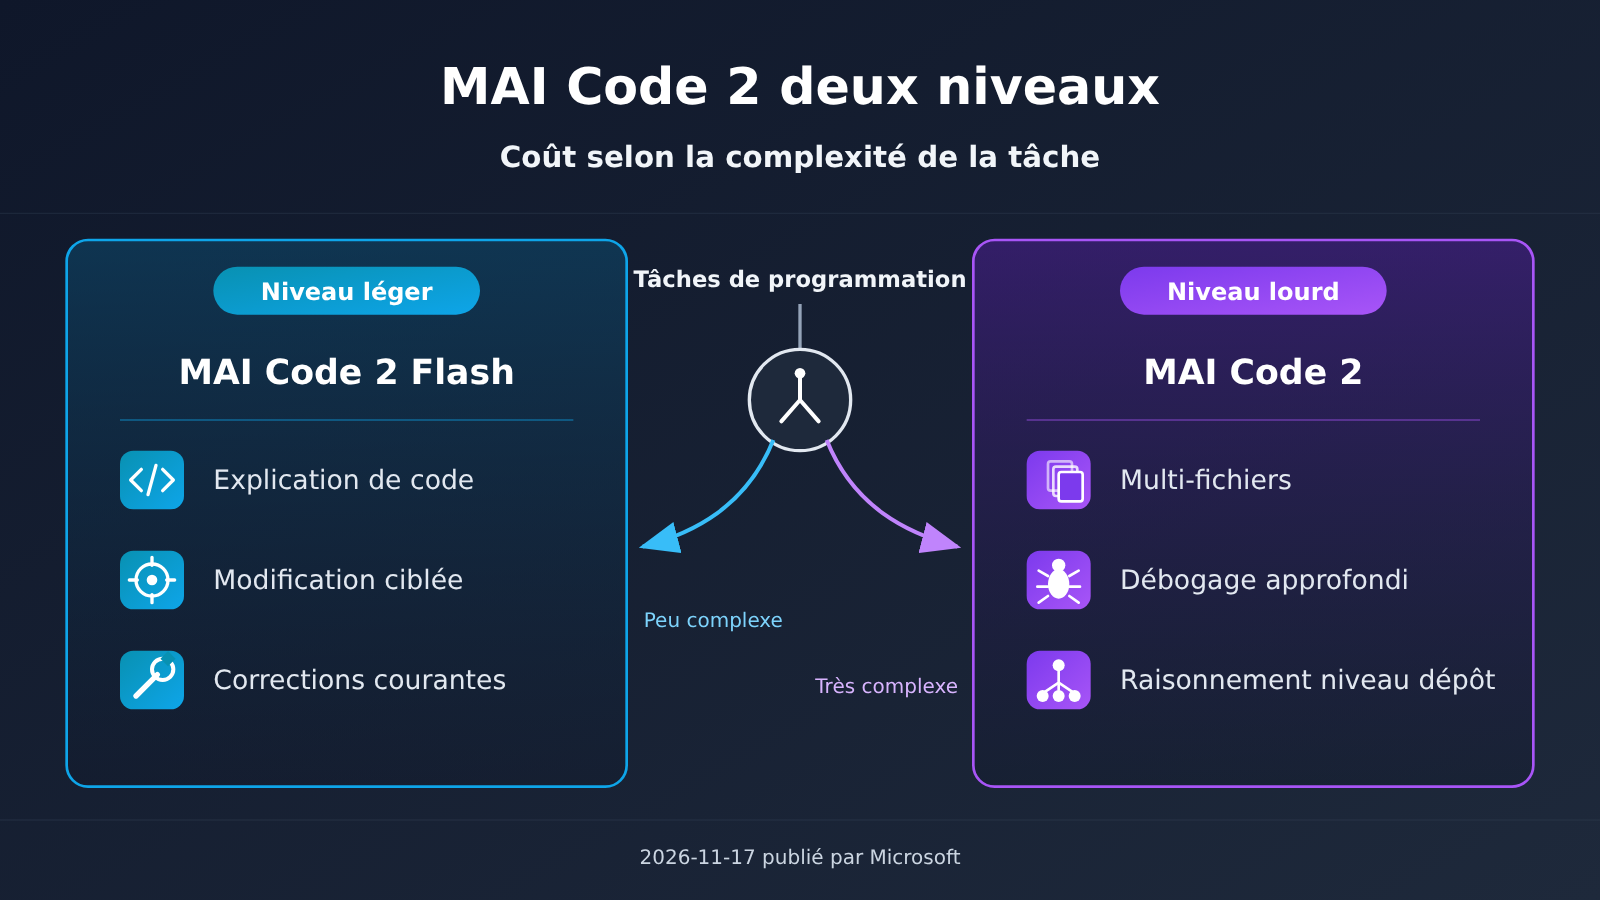
Microsoft propose des modèles distincts pour l’ingénierie complexe et pour les tâches quotidiennes à haute fréquence. Notre analyse : cela offre aux entreprises une nouvelle option pour répartir les coûts selon la complexité des tâches. Le 17 novembre 2026, Microsoft a publié MAI Code 2 et MAI Code 2 Flash. Le premier cible les modifications multi-fichiers, le débogage approfondi et le raisonnement à l’échelle du dépôt ; le second s’adresse à l’explication de code, aux modifications ciblées, aux corrections courantes et aux itérations à haute fréquence.
La conclusion centrale de cet article est la suivante : lorsqu’elles évaluent une IA de programmation, les entreprises ne devraient pas se contenter de regarder quel modèle est « le plus puissant ». La question plus importante est de savoir quelles tâches peuvent être confiées au niveau léger, lesquelles doivent être escaladées vers le niveau lourd, et combien coûte réellement chaque fusion réussie. Précisons que le processus de classification des tâches décrit ci-dessous est une recommandation de la rédaction ; il ne s’agit pas d’une garantie de routage automatique déjà proposée par Microsoft.
Ce que cet article va vous apprendre
- Les différences de positionnement entre MAI Code 2 et MAI Code 2 Flash, ainsi que les canaux où ils sont déjà disponibles et ceux qui restent en statut « bientôt disponible ».
- Quelles spécifications sont publiées dans la fiche modèle, et quelles informations relèvent des déclarations du fournisseur sans validation indépendante à ce jour.
- Comment les entreprises peuvent s’inspirer de l’approche à deux niveaux pour bâtir leur propre processus de classification des tâches de programmation, puis mesurer les résultats avec le taux de réussite, le taux de reprise et le coût par fusion.
- Les points à vérifier avant un pilote en matière de résidence des données et d’autorisations, ainsi que plusieurs surinterprétations fréquentes.
Index d’analyse de MAI Code 2
La première partie, « Faits objectifs », présente successivement le positionnement des deux niveaux, les canaux de disponibilité, les spécifications de la fiche modèle, un cas d’usage en entreprise et la relation avec MAI Work Flash ; les sources sont les documents publics de Microsoft et la documentation tarifaire de GitHub. La deuxième partie, « Analyse et interprétation », exprime le point de vue de la rédaction : elle explique d’abord la logique commerciale derrière le double niveau, puis propose cinq étapes — tenir un registre des tâches, définir un routage par défaut, établir des règles d’escalade, prévoir une validation humaine et calculer les indicateurs — et discute enfin des points à vérifier lors d’un pilote ainsi que des interprétations erronées à éviter.
À savoir : les concepts clés pour comprendre la double sortie de MAI Code 2
| Concept | Brève explication |
|---|---|
| MAI Code 2 | Le modèle de programmation lourd de Microsoft, positionné pour le travail multi-fichiers, le débogage approfondi et le raisonnement à l’échelle du dépôt |
| MAI Code 2 Flash | La version légère de la même gamme, positionnée pour l’explication de code, les modifications ciblées, les corrections courantes et les itérations à haute fréquence |
| MAI Work Flash | Un modèle dérivé, encore optimisé à partir de Code 2 Flash, au service de scénarios bureautiques et de données comme M365 et FabricIQ |
| Foundry | La plateforme de Microsoft destinée aux entreprises pour le développement de modèles et d’applications d’IA ; Flash y est proposé sous forme de préversion à accès limité |
| Limited-access preview | Préversion à accès limité : il faut en faire la demande ou remplir certaines conditions pour y accéder, ce qui ne signifie pas une ouverture générale |
| Fenêtre de contexte | Le nombre total de tokens qu’un modèle peut traiter en une seule fois ; la fiche du modèle indique 1.05M |
| Raisonnement à l’échelle du dépôt | Comprendre la structure et les dépendances de l’ensemble du dépôt de code avant de modifier, plutôt que de se limiter à un seul fichier |
| Routage de modèles | La stratégie qui consiste à répartir les requêtes entre différents modèles selon les caractéristiques de la tâche, et qui peut être mise en œuvre par des règles manuelles ou par un programme |
| Taux de reprise | La proportion de productions de l’IA renvoyées et devant être modifiées à nouveau ; c’est un indicateur clé pour mesurer l’efficacité réelle |
| Résidence des données | La zone géographique où les données sont stockées et traitées, ce qui touche aux exigences de conformité |
Aperçu des impacts de la publication en deux niveaux de MAI Code 2
- Responsables techniques en entreprise : les critères d’achat et d’évaluation passent de « choisir le modèle le plus puissant » à « attribuer des niveaux différents selon les tâches ». Il faut donc préparer une classification des tâches et une méthodologie de calcul des coûts.
- Développeurs qui utilisent GitHub Copilot : les deux modèles sont déjà disponibles dans Copilot. Au quotidien, vous pouvez basculer activement d’un modèle à l’autre selon la taille de la tâche, mais l’éventail réellement accessible dépend de la politique de votre organisation.
- Équipes qui construisent des applications sur Foundry : pour l’instant, seul Flash est proposé sous forme d’aperçu limité. Il faut d’abord vérifier l’éligibilité à l’accès, et mieux vaut ne pas planifier sur la base d’une disponibilité générale.
- Développeurs dépendant de plateformes tierces : dans le communiqué, les canaux OpenRouter, Vercel, Hermes, OpenCode, Kilo et autres sont indiqués comme « bientôt disponibles ». Ne les intégrez pas à un plan de production avant leur ouverture effective.
- Équipes conformité et sécurité : un modèle supplémentaire, c’est un ensemble supplémentaire de flux de données et de périmètres d’autorisation. Il faut boucler la vérification avant le pilote.
1. Faits objectifs : ce que MAI Code 2 et Flash ont publié
Cette partie se limite aux informations contenues dans les documents publics de Microsoft. Les éléments relatifs aux performances et aux cas d’usage proviennent de publications ou de reprises du fournisseur ; il ne s’agit pas d’évaluations indépendantes, et notre équipe n’a pas non plus réalisé de tests réels sur ces deux modèles.
1.1 Le positionnement à deux niveaux de MAI Code 2 : à quoi servent respectivement Code 2 et Flash
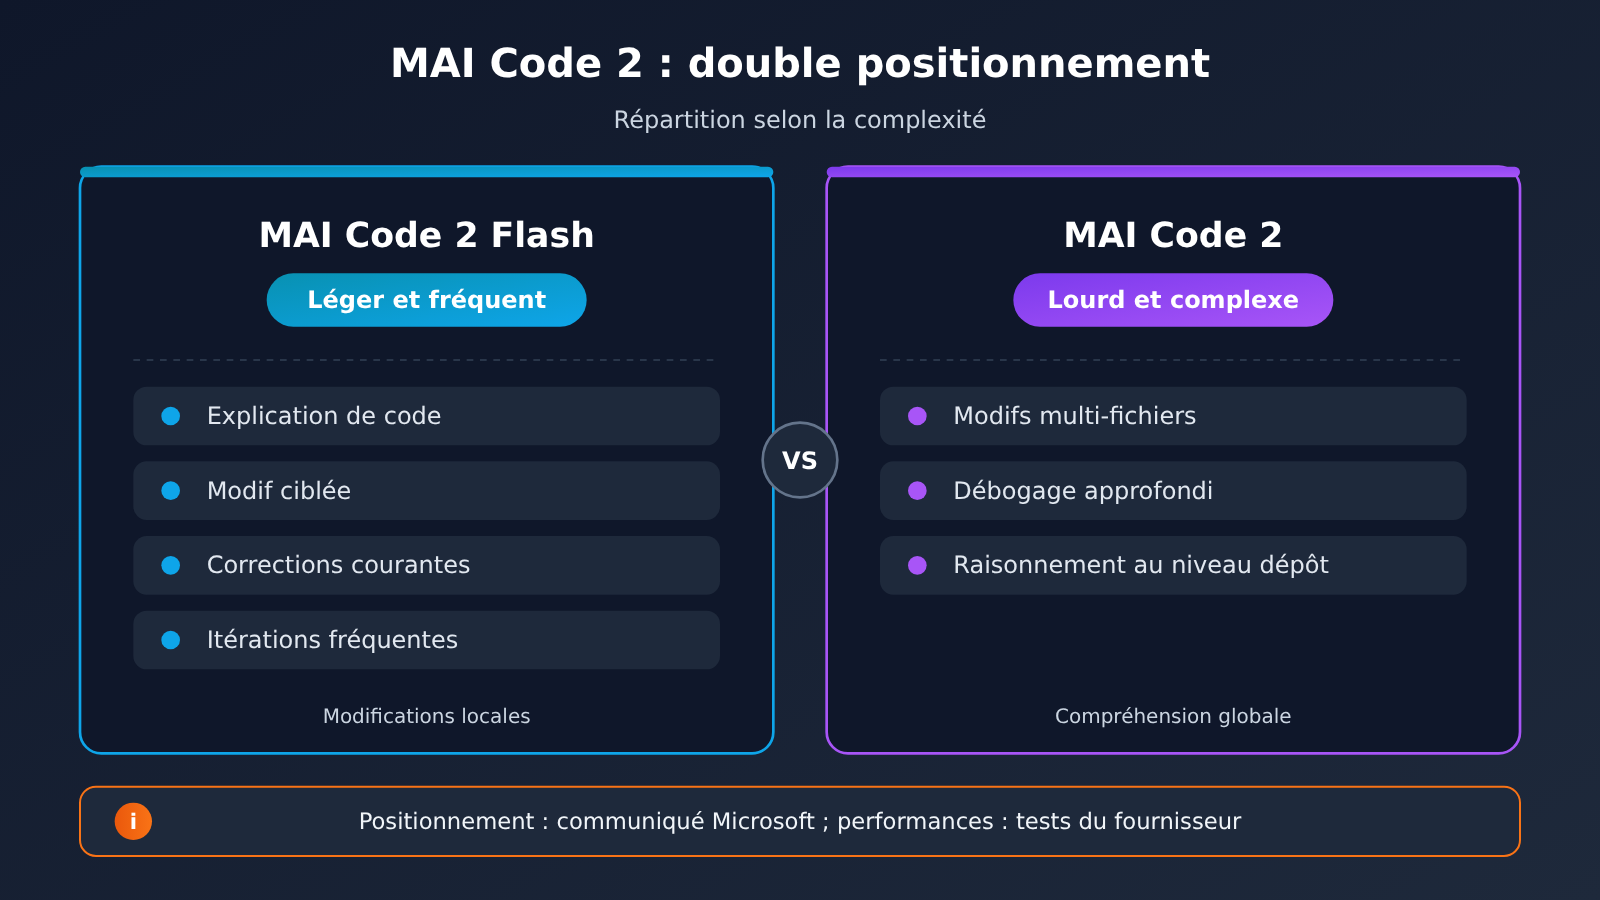
Microsoft a plutôt bien précisé la répartition des rôles dans son communiqué de lancement : la version lourde se charge des tâches d’ingénierie complexes qui demandent une compréhension globale, tandis que la version légère est là pour les tâches quotidiennes, fréquentes, locales et rapides.
| Dimension | MAI Code 2 | MAI Code 2 Flash |
|---|---|---|
| Positionnement officiel | Modifications multi-fichiers, débogage approfondi, raisonnement à l’échelle du dépôt | Explication de code, modifications ciblées, corrections courantes, itérations à haute fréquence |
| Caractéristiques des tâches | Nombreuses dépendances entre fichiers, nécessité de comprendre la structure d’ensemble | Périmètre bien délimité, modifications concentrées sur une zone locale |
| Recommandation de choix (notre analyse) | Évaluer d’abord la justesse entre fichiers | Évaluer d’abord la qualité des tâches locales et la vitesse de réponse |
| Nature de l’évaluation | Évaluation fournie par l’éditeur | Évaluation fournie par l’éditeur |
1.2 Canaux de distribution et état de disponibilité de MAI Code 2
La disponibilité est le point le plus facile à mal interpréter. D’après le communiqué de presse de Microsoft et le blog Azure AI Foundry, voici l’état de chaque canal :
| Canal | MAI Code 2 | MAI Code 2 Flash | État |
|---|---|---|---|
| GitHub Copilot | Disponible | Disponible | En ligne |
| Microsoft Foundry | Non répertorié comme disponible | Aperçu à accès restreint | Demande d’habilitation nécessaire |
| OpenRouter, Vercel, Hermes, OpenCode, Kilo | Bientôt disponible | Bientôt disponible | Le communiqué indique « soon », ce qui ne signifie pas que tout est déjà ouvert à tous |
1.3 Spécifications de la fiche modèle de MAI Code 2
Microsoft a également publié les fiches modèle des deux modèles. Voici les spécifications publiques confirmées à ce jour :
- Les modalités d’entrée sont le texte et l’image, la modalité de sortie est le texte.
- La fenêtre de contexte du modèle est de 1.05M tokens, avec une limite d’entrée de 922k et une limite de sortie de 128k.
- Il s’agit là des spécifications de la fiche modèle, et non d’un engagement sur les quotas disponibles à chaque point d’entrée produit. En pratique, il faut vérifier séparément les limites propres à chaque produit. Par exemple, le contexte réellement exploitable dans un plugin d’IDE donné peut être inférieur à la valeur indiquée sur la fiche modèle.
En ce qui concerne le nombre total de paramètres, les documents publics présentent des versions divergentes ; cet article ne les retient pas et ne les cite pas.
1.4 Cas de personnalisation entreprise MAI Code 2 et MAI Work Flash
Sur la page modèle de MAI Code 2, Microsoft évoque des scénarios de modèles personnalisés pour deux entreprises, AT&T et Woven by Toyota. Il s’agit de proposés rapportés par le fournisseur, qui décrivent des usages personnalisés propres à des entreprises données : on ne peut pas en conclure que « toutes les tâches d’entreprise obtiendront le même résultat ».
Un autre point mérite d’être mentionné séparément : MAI Work Flash. Le communiqué de presse le présente comme un modèle dérivé, optimisé à partir de Code 2 Flash, au service de M365 et FabricIQ. Par conséquent, les résultats de MAI Work Flash dans les scénarios bureautiques ne peuvent pas être cités directement comme ceux de la version de base Code 2 Flash.
1.5 Pour établir un budget, distinguer tarifs promotionnels et coûts à long terme
La documentation tarifaire de GitHub Copilot liste les tarifs en dollars par million de tokens ci-dessous, dans l’ordre entrée / entrée mise en cache / sortie :
| Modèle | Tarif promotionnel | Tarif standard à compter du 17 mai 2027 |
|---|---|---|
| MAI Code 2 | 0,50/0,025/2,50 | 1,00/0,05/5,00 |
| MAI Code 2 Flash | 0,05/0,005/0,25 | 0,10/0,01/0,50 |
Microsoft ne précise pas le fuseau horaire exact de cette date. Il s’agit ici de la grille tarifaire de Copilot, qui ne peut pas être reprise telle quelle comme tarif de Foundry ou d’une plateforme tierce. Les arguments de coût relatif dans le communiqué de Microsoft reposent sur le tarif promotionnel à 50 % et sur une configuration d’évaluation précise ; pour un budget d’entreprise à long terme, il faut aussi intégrer le tarif standard, les tentatives en cas d’échec et le retraitement manuel.
2. Analyse et interprétation : la stratification des tâches d’entreprise derrière les deux niveaux de MAI Code 2
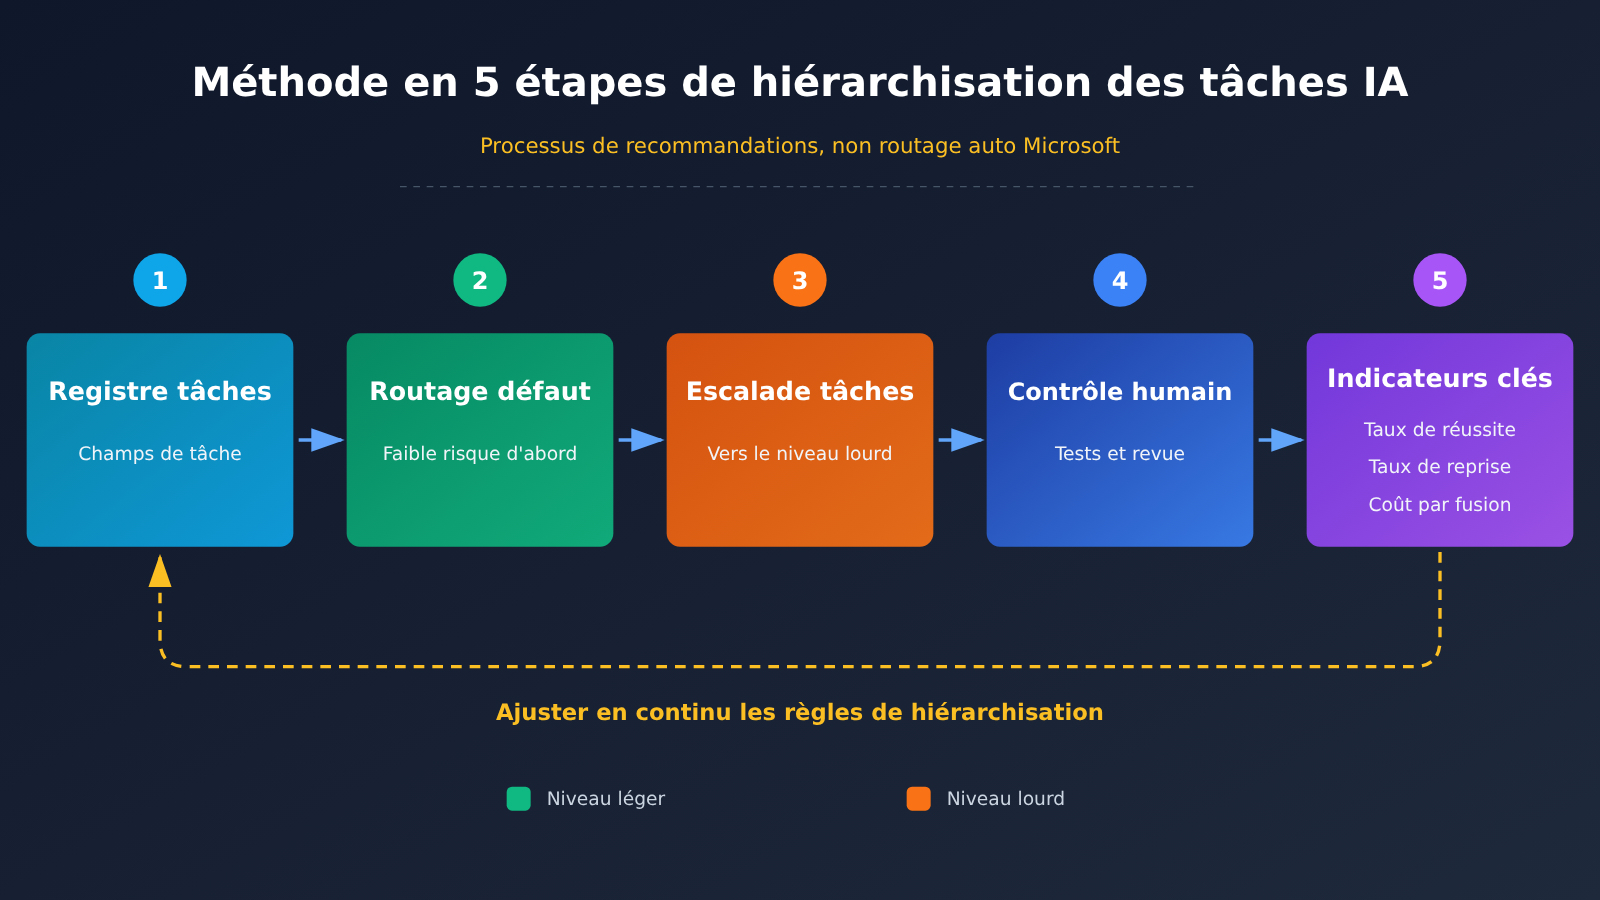
Ce qui suit est l’analyse et les recommandations de la rédaction ; cela ne représente pas la position officielle de Microsoft. Le texte ci-dessous ne décrit pas la fonction de routage automatique des produits Microsoft : les règles de répartition, d’escalade et de validation proposées ici à l’échelle de l’entreprise doivent être conçues et vérifiées séparément.
2.1 Pourquoi MAI Code 2 est scindé en deux niveaux : la concurrence se déplace du classement général vers la répartition des coûts
Une demande d’entreprise peut très bien contenir à la fois « refactoriser tout le module » et « expliquer une fonction ». La répartition doit donc être calculée à partir du registre de suivi de l’équipe, et non en partant du principe que la majorité des tâches sont simples. Si l’on confie systématiquement les tâches simples à un grand modèle, on risque d’augmenter inutilement les coûts — la latence réelle restant à mesurer. À l’inverse, si tout passe par un modèle léger, les tâches complexes échouent facilement et entraînent des reprises à répétition.
La sortie en deux niveaux met justement ce compromis sur la table : le fournisseur ne se contente plus de vanter le plafond d’un modèle unique, il propose un couple aux rôles bien répartis. Pour l’entreprise, ce qui fait réellement la différence, c’est la capacité à confier la bonne tâche au bon niveau et à en mesurer les résultats en continu. Ce jugement s’appuie sur le positionnement officiel décrit en 1.1 ; quant à l’ampleur réelle de l’écart de coût, chaque équipe devra la vérifier avec ses propres données.
2.2 Première étape : établir un registre des tâches pour les modèles bi-palier de type MAI Code 2
Ne vous précipitez pas pour brancher le modèle : consacrez d’abord deux à quatre semaines à consigner les tâches de programmation que l’équipe confie réellement à l’IA. Le registre n’a pas besoin d’être compliqué — l’essentiel est d’y consigner les champs qui permettent d’évaluer la complexité :
| Champ du registre | Contenu consigné | Sert à déterminer |
|---|---|---|
| Type de tâche | Explication, correction, nouvelle fonctionnalité, refactorisation, débogage | Première répartition par palier |
| Nombre de fichiers concernés | Un seul fichier ou plusieurs fichiers | Besoin d’une compréhension au niveau du dépôt |
| Erreur reproductible | Journal d’erreurs ou cas de test disponible | Profondeur du débogage |
| Mode de validation | Tests unitaires réussis, revue manuelle, observation en production | Coût de validation |
| Résultat | Réussi du premier coup, nombre de reprises, abandon | Le palier était-il bien choisi |
Avec un tel registre, les règles de stratification ultérieures reposent sur des données, et non sur une ligne tracée à l’intuition.
2.3 Deuxième étape : définir un routage par défaut à faible coût
Je conseille de ne faire démarrer sur le palier léger que les tâches à faible risque, au périmètre bien délimité et dont les conditions de validation sont suffisantes. Le nombre de fichiers peut servir d’indice, mais il ne détermine pas le risque à lui seul : la modification de l’authentification, des paiements ou de la configuration de production au sein d’un seul fichier peut elle aussi nécessiter un passage direct au palier supérieur et une revue manuelle renforcée.
On peut d’abord rédiger une table de routage manuel plutôt que de brancher immédiatement un agent automatique : les tâches d’explication de code et de suggestions sans effet de bord passent d’abord par le palier léger ; les modifications inter-modules et les débogages dont la cause racine reste inconnue vont au palier complexe ; les tâches touchant à des informations secrètes, à des droits de production ou à des frontières de sécurité passent d’abord par une validation du responsable. Cet article ne réalise aucun test d’intégration et ne garantit pas que des tiers prennent déjà en charge ces deux modèles.
2.4 Troisième étape : définir des règles d’escalade pour les tâches complexes
Le routage par défaut ne règle qu’une seule question : « par quel chemin commencer ». Il faut encore préciser quand changer de niveau. Je recommande deux types de déclencheurs :
- Escalade préventive : lorsque le registre des tâches indique que la tâche touche plusieurs fichiers, exige une compréhension à l’échelle du dépôt ou un débogage approfondi, on la confie directement au niveau lourd.
- Escalade a posteriori : si la sortie du niveau léger échoue aux tests, ou si la même tâche est reprise plus que le nombre de fois convenu, on bascule automatiquement ou manuellement vers le niveau lourd pour réessayer.
Pour chaque tentative, enregistrez l’identifiant de la tâche, le modèle, la consommation, le résultat de la validation et la raison de l’escalade. La nouvelle tentative doit inclure les informations d’échec du tour précédent, avec un plafond de tentatives ou un budget maximal ; au-delà, on passe à un traitement manuel plutôt que de boucler à l’infini. Ne validez pas le succès sur la simple présence d’un nom de fonction dans la sortie ou sur un texte du type « tests réussis » : exécutez des tests fiables et vérifiez les modifications réellement apportées.
2.5 Quatrième étape : la validation humaine reste indispensable
Quel que soit le niveau du modèle, le résultat doit toujours passer par une revue humaine avant d’être fusionné. Je suggère d’adapter l’intensité de la validation au niveau de la tâche : pour les modifications ciblées du niveau léger, l’essentiel sera la réussite des tests plus une relecture rapide ; pour les changements multi-fichiers du niveau lourd, un ingénieur senior devra examiner les dépendances et les effets de bord potentiels. Aussi bons soient les scores des évaluations des fournisseurs, ils ne remplacent jamais la validation dans votre propre base de code.
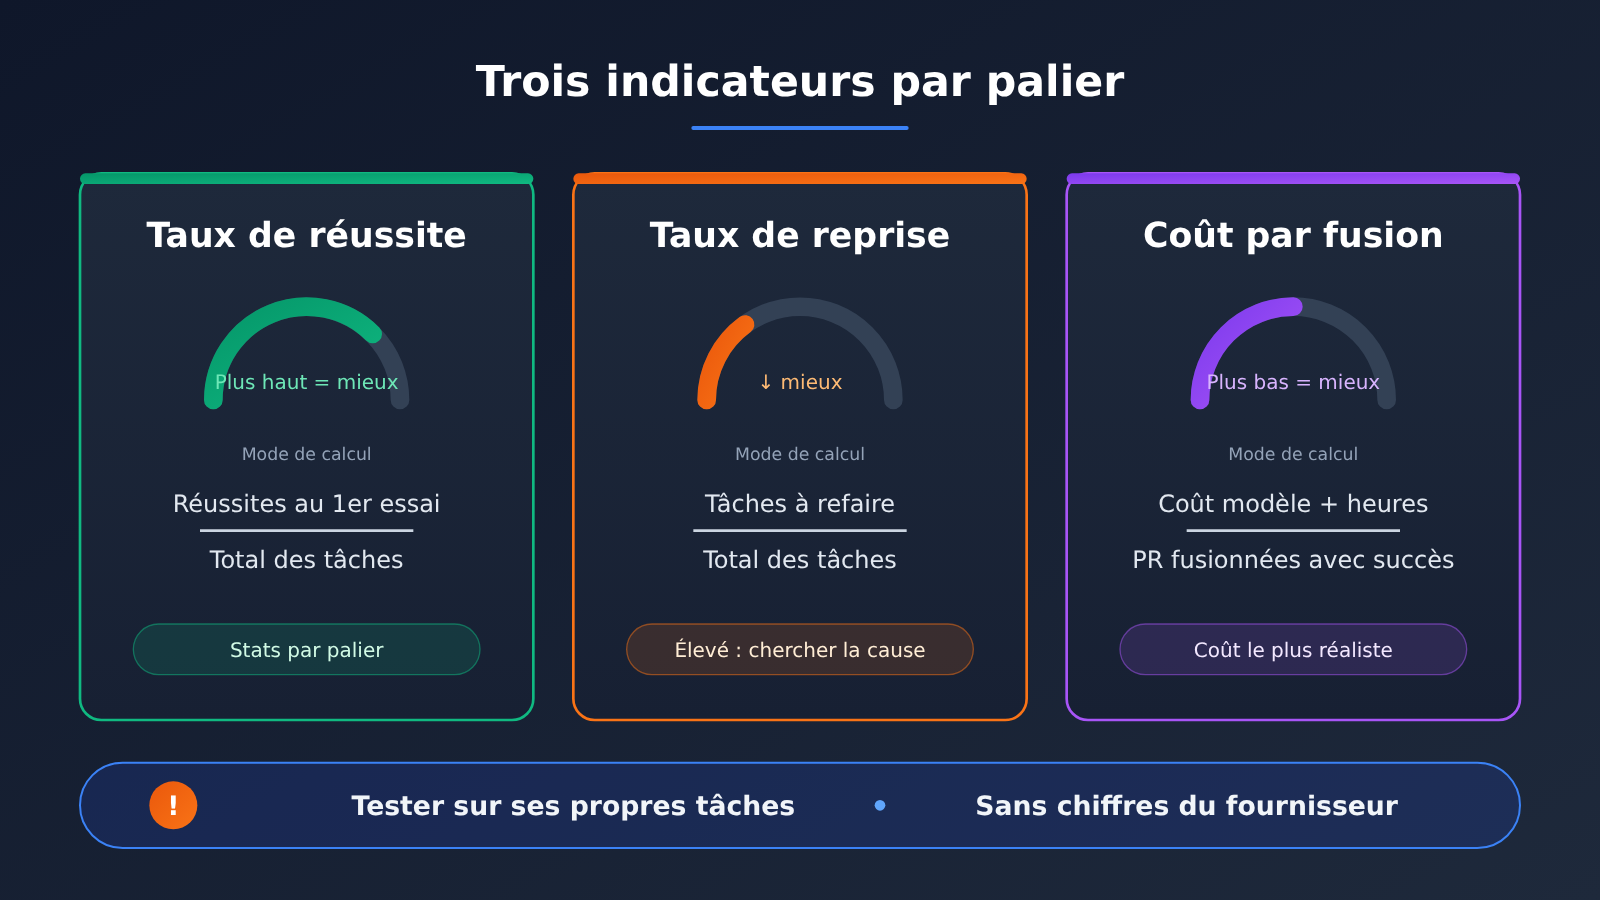
2.6 Cinquième étape : mesurer l’effet de la stratification de MAI Code 2 avec le taux de réussite, le taux de reprise et le coût par fusion
Se fier uniquement au prix unitaire des tokens peut conduire à une conclusion erronée : le palier léger coûte moins cher par invocation, mais s’il faut reprendre trois fois, le coût total peut au contraire être plus élevé. Je vous conseille de faire le calcul avec les trois indicateurs suivants :
| Indicateur | Mode de calcul | Description |
|---|---|---|
| Taux de réussite | Nombre de tâches validées du premier coup ÷ nombre total de tâches | À calculer séparément par palier et par type de tâche |
| Taux de reprise | Nombre de tâches renvoyées pour reprise ÷ nombre total de tâches | Lorsque le taux de reprise est élevé, examiner en même temps le découpage par palier, les informations manquantes et la définition de la validation |
| Coût par fusion | (Coût d’invocation du modèle + valorisation du temps de revue humaine et de reprise) ÷ nombre de PR fusionnées avec succès | L’indicateur le plus proche du coût réel pour l’activité |
Ces trois indicateurs doivent être mesurés sur vos propres tâches, et non repris directement des « pourcentages d’amélioration de l’efficacité » fournis par les éditeurs ou les médias. Selon les bases de code, les langages et les critères de validation, les résultats peuvent varier considérablement.
2.7 Vérification avant le pilote : résidence des données et permissions pour MAI Code 2
Chaque niveau de modèle supplémentaire ajoute un flux de données supplémentaire. Avant le pilote, il est recommandé de vérifier au minimum les points suivants :
- Résidence des données : confirmez si la zone de traitement des données du canal utilisé (Copilot, Foundry ou une plateforme tierce) satisfait aux exigences de conformité de votre secteur et de votre région. Flash sur Foundry est en phase de préversion limitée, et les conditions de la préversion peuvent différer de celles de la version officielle.
- Permissions d’accès au code : l’inférence au niveau du dépôt signifie que le modèle peut lire un éventail plus large de code. Il convient de limiter les dépôts et répertoires accessibles, et d’exclure les contenus sensibles tels que les clés et les fichiers de configuration.
- Politiques de l’organisation : la possibilité de changer de modèle dans Copilot, et les modèles disponibles pour ce changement, dépendent des paramètres de l’administrateur de l’organisation ; il faut le confirmer à l’avance.
- Journaux d’audit : assurez-vous que le modèle utilisé, l’initiateur et la portée des entrées de chaque appel sont traçables, afin de pouvoir faire un retour d’expérience a posteriori.
2.8 Trois choses à ne pas surinterpréter à propos de MAI Code 2
- Le routage produit n’équivaut pas au processus de gouvernance d’entreprise décrit ici. Même si le produit utilisé propose une sélection automatique du modèle, il faut vérifier indépendamment les règles de routage, les seuils d’acceptation et les permissions, sans considérer que la méthode en cinq étapes de cet article est déjà automatiquement mise en œuvre.
- Cela ne signifie pas que Microsoft abandonne sa collaboration avec OpenAI. Le lancement d’un modèle de programmation maison ne permet pas de conclure que Microsoft renonce aux modèles OpenAI, et les documents publics existants ne soutiennent pas cette inférence.
- Cela ne signifie pas que les évaluations du fournisseur sont directement réutilisables. Les données de performance et les cas d’entreprise proviennent tous de Microsoft ; AT&T et Woven by Toyota relèvent de scénarios sur mesure spécifiques, et MAI Work Flash est un modèle dérivé optimisé séparément. Leurs résultats ne peuvent pas être transposés directement à vos tâches.
2.9 Les signaux à surveiller pour la suite de MAI Code 2
Ce qui suit relève de l’observation prospective et devra être confirmé par les faits. Premièrement, le moment où des canaux comme OpenRouter seront réellement ouverts, ainsi que le mode de facturation appliqué après l’ouverture. Deuxièmement, le moment où Flash sur Foundry sortira de la prévisualisation restreinte, et si la version lourde arrivera elle aussi dans Foundry. Troisièmement, l’écart entre la limite de contexte au niveau produit et les 1,05 M annoncés dans la carte de modèle, car cela influence directement la capacité à faire tenir en une seule fois une tâche à l’échelle d’un dépôt.
Le signal envoyé par cette publication en deux versions est très simple : la valeur de l’IA de programmation ne réside pas dans le fait d’appeler systématiquement le modèle le plus puissant, mais dans la recherche d’un point d’équilibre entre coût et qualité pour chaque type de tâche. Commencer par bien répertorier les tâches, puis laisser les données décider de la ligne de partage, est bien plus fiable que de courir après une place dans un classement général. Comme le dit le Livre des Entretiens (Wei Ling Gong) : « Pour bien faire son travail, il faut d’abord affûter ses outils. »
Références
- Microsoft AI : article de présentation de MAI Code 2 et Flash
- Microsoft Foundry : choix des modèles et personnalisation en entreprise
- Cartes de modèle officielles de MAI Code 2 et Flash
- Microsoft AI : exemples de personnalisation en entreprise
- GitHub : tarifs des modèles Copilot et dates de promotion


