
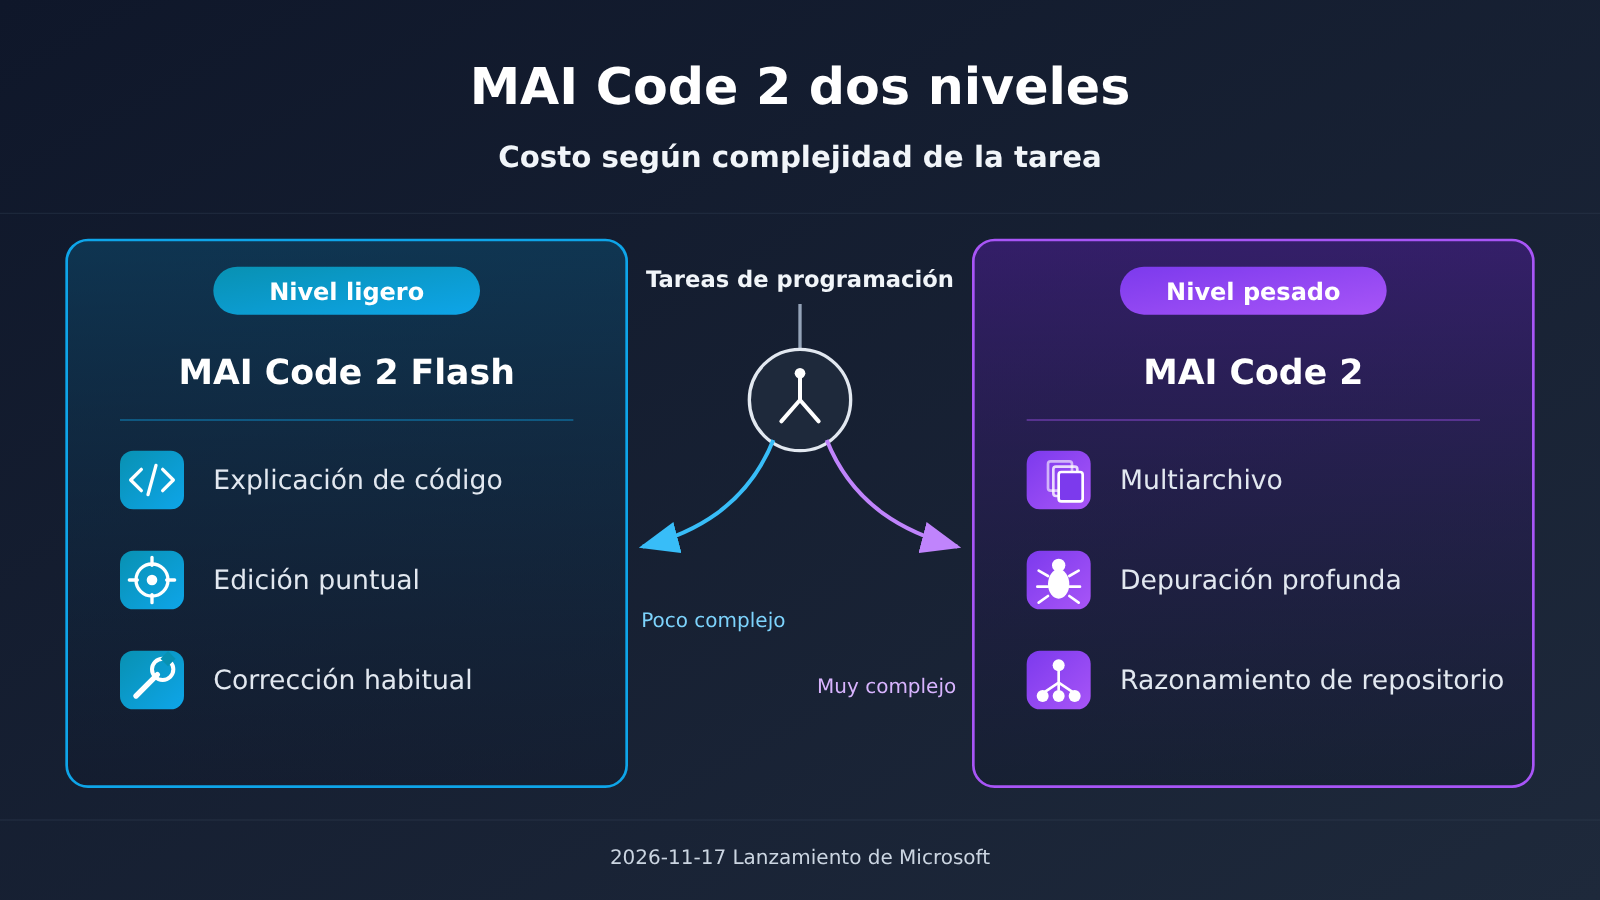
Microsoft ofrece modelos distintos para ingeniería compleja y para tareas cotidianas de alta frecuencia. La tesis de este artículo es que esto brinda a las empresas una nueva opción para asignar costos en función de la complejidad de las tareas. El 17 de noviembre de 2026, Microsoft presentó MAI Code 2 y MAI Code 2 Flash. El primero está orientado a modificaciones en varios archivos, depuración profunda y razonamiento a nivel de repositorio; el segundo, a explicación de código, cambios puntuales, correcciones rutinarias e iteraciones de alta frecuencia.
La conclusión central de este artículo es que, al evaluar IA para programación, las empresas no deberían fijarse solo en qué modelo es «el más potente». La pregunta más importante es qué tareas se pueden delegar al nivel ligero, cuáles deben escalarse al nivel pesado y cuánto cuesta realmente cada merge exitoso. Cabe aclarar que el flujo de segmentación de tareas que se describe abajo es una recomendación de la redacción, no una garantía de enrutamiento automático que Microsoft ya ofrezca.
Qué aprenderá al terminar este artículo
- Las diferencias de posicionamiento entre MAI Code 2 y MAI Code 2 Flash, y en qué canales están disponibles actualmente y cuáles siguen en estado «próximamente».
- Qué especificaciones revela la ficha del modelo y qué información corresponde a afirmaciones del proveedor que aún no han sido verificadas de forma independiente.
- Cómo las empresas pueden tomar prestada la idea de «dos niveles» para construir su propio flujo de segmentación de tareas de programación y medir resultados con tasa de éxito, tasa de retrabajo y costo por merge.
- Qué aspectos relacionados con residencia de datos y permisos deben revisarse antes de un piloto, y varias interpretaciones excesivas que conviene evitar.
Índice de análisis de MAI Code 2
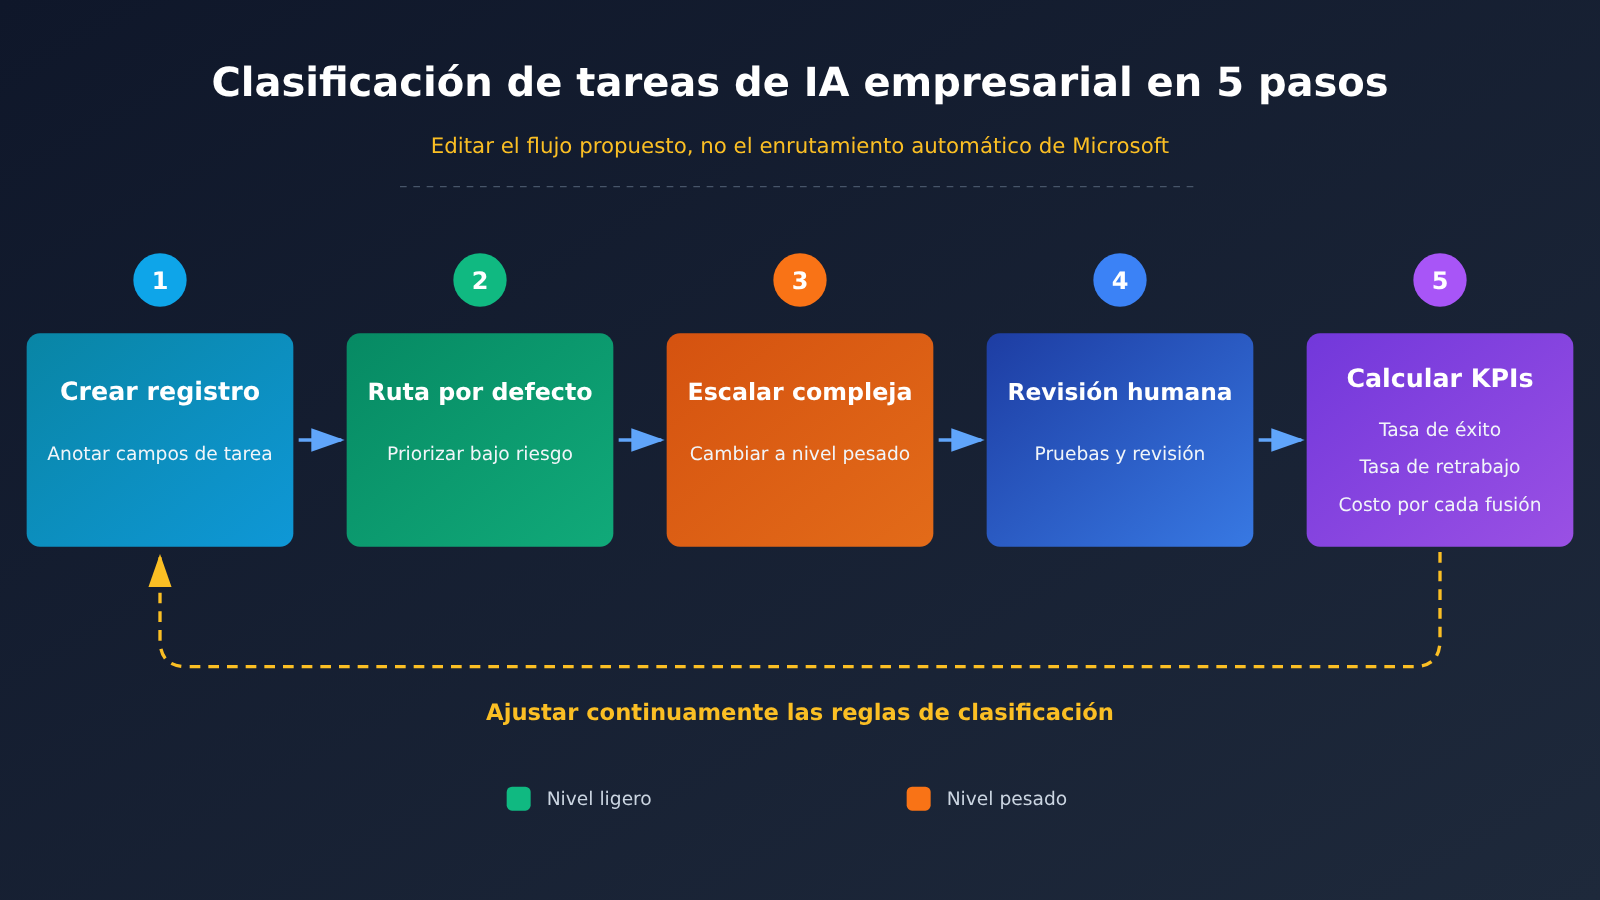
La primera parte, «Hechos objetivos», ordena sucesivamente el posicionamiento de dos niveles, los canales disponibles, las especificaciones de la ficha del modelo, el caso empresarial y su relación con MAI Work Flash; las fuentes son los materiales públicos de Microsoft y la documentación de precios de GitHub. La segunda parte, «Análisis y juicio», recoge la opinión de la redacción: primero explica la lógica comercial detrás de los dos niveles; después propone cinco pasos —crear un registro de tareas, enrutamiento predeterminado, reglas de escalamiento, aceptación humana y cálculo de métricas—; y por último aborda los puntos de verificación del piloto y los malentendidos que hay que evitar.
To Know: conceptos clave para entender el lanzamiento de las dos variantes de MAI Code 2
| Concepto | Explicación breve |
|---|---|
| MAI Code 2 | El modelo de programación pesado de Microsoft, orientado a múltiples archivos, depuración profunda y razonamiento a nivel de repositorio |
| MAI Code 2 Flash | La variante ligera de la misma familia, orientada a explicación de código, modificaciones puntuales, correcciones rutinarias e iteración de alta frecuencia |
| MAI Work Flash | Un modelo derivado que optimiza aún más Code 2 Flash, orientado a escenarios de ofimática y datos como M365 y FabricIQ |
| Foundry | La plataforma de Microsoft para el desarrollo empresarial de modelos y aplicaciones de IA, donde Flash se ofrece en forma de vista previa de acceso limitado |
| Vista previa de acceso limitado | Requiere solicitar acceso o cumplir ciertos requisitos para poder usarla; no equivale a una disponibilidad totalmente abierta |
| Ventana de contexto | El total de tokens que el modelo puede procesar en una sola vez; la ficha del modelo indica 1.05M |
| Razonamiento a nivel de repositorio | Entender la estructura y las dependencias de todo el código base antes de modificar, en lugar de fijarse solo en un archivo individual |
| Enrutamiento de modelos | La estrategia de asignar las solicitudes a distintos modelos según las características de la tarea, implementable mediante reglas manuales o por programa |
| Tasa de retrabajo | La proporción de resultados de IA devueltos que necesitan corrección adicional; es un indicador clave para medir la eficiencia real |
| Residencia de datos | La región geográfica donde se almacenan y procesan los datos, relacionada con los requisitos de cumplimiento |
Panorama rápido del impacto del lanzamiento de MAI Code 2 en dos niveles
- Responsables técnicos de empresas: la dimensión de compra y evaluación pasa de «elegir el modelo más potente» a «asignar un nivel distinto a cada tarea», por lo que hay que preparar la clasificación de tareas y los criterios de cálculo de costes.
- Desarrolladores que usan GitHub Copilot: los dos modelos ya están disponibles en Copilot y, en el día a día, se puede cambiar de nivel según el tamaño de la tarea; no obstante, el alcance concreto de lo disponible depende de la política de cada organización.
- Equipos que construyen aplicaciones en Foundry: por ahora solo Flash está disponible como vista previa restringida, así que primero hay que confirmar la elegibilidad de acceso y no conviene planificar como si estuviera disponible de forma general.
- Desarrolladores que dependen de plataformas de terceros: en la nota de prensa, canales como OpenRouter, Vercel, Hermes, OpenCode y Kilo aparecen marcados como «próximamente», por lo que no deberían incluirse en un plan de producción antes de que estén realmente disponibles.
- Equipos de cumplimiento y seguridad: cada modelo adicional implica un nuevo conjunto de flujos de datos y límites de permisos, así que hay que completar la verificación antes del piloto.
1. Los hechos: qué han publicado MAI Code 2 y Flash
Esta sección recoge únicamente información de materiales públicos de Microsoft. Los datos de rendimiento y los casos prácticos provienen de comunicados del fabricante o de referencias a estos, no son evaluaciones independientes, y nuestro equipo tampoco ha realizado pruebas reales con estos dos modelos.
1.1 Posicionamiento de las dos variantes de MAI Code 2: qué cubre Code 2 y qué cubre Flash
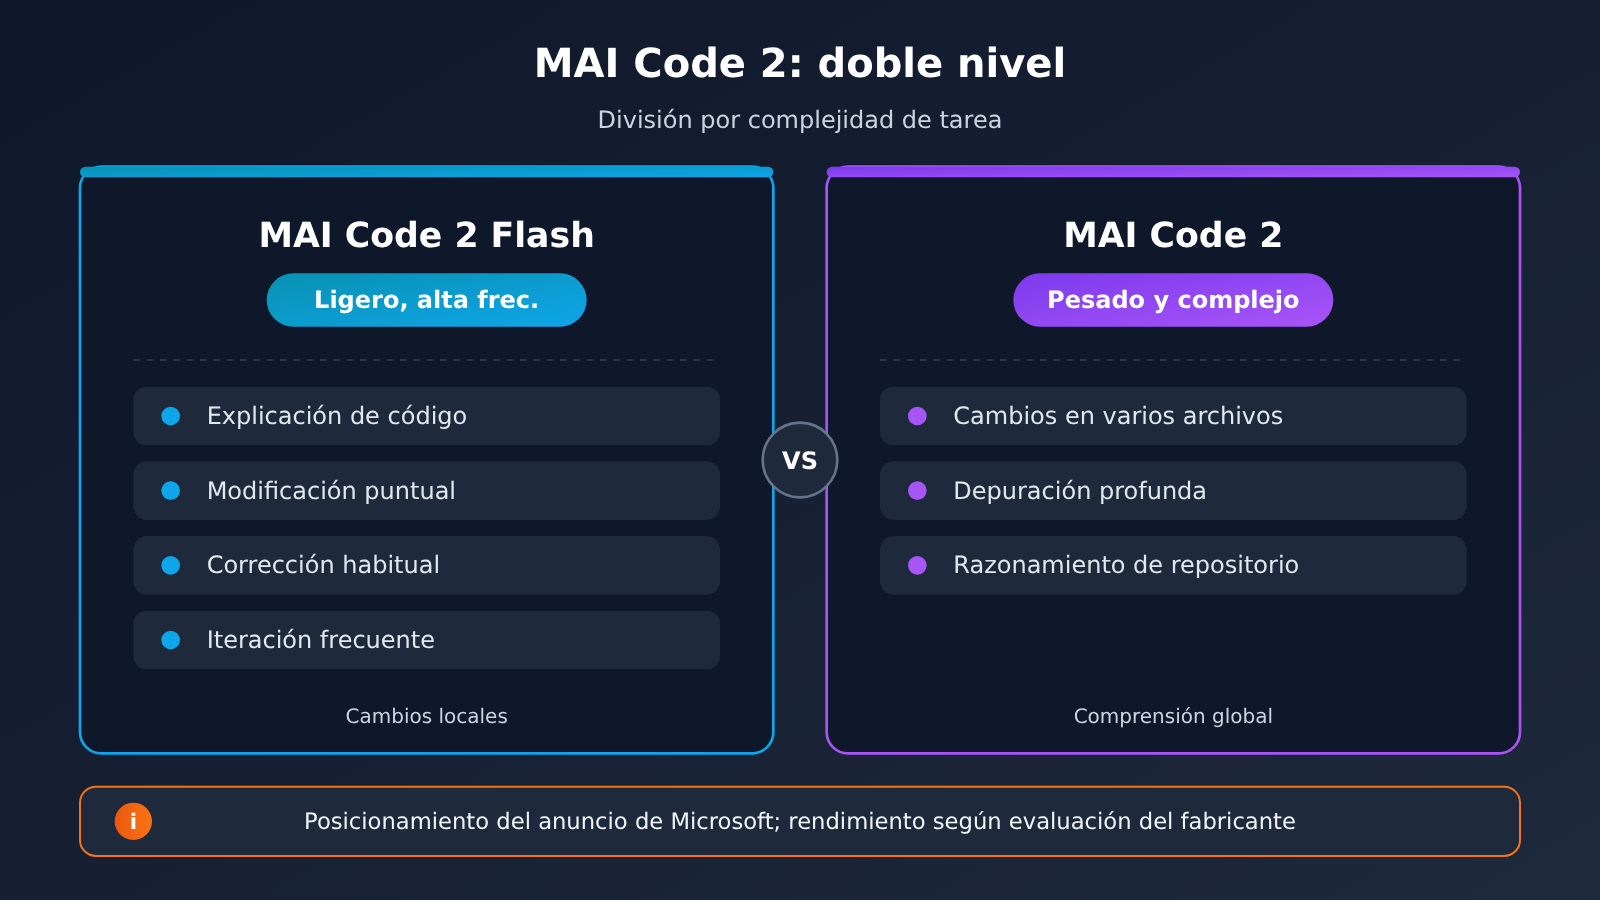
En su nota de lanzamiento, Microsoft deja bastante clara la división de tareas entre ambos modelos: la variante pesada se encarga de tareas de ingeniería complejas que requieren una comprensión global; la variante ligera se ocupa de tareas cotidianas de alta frecuencia, locales y de ritmo rápido.
| Dimensión | MAI Code 2 | MAI Code 2 Flash |
|---|---|---|
| Posicionamiento oficial | Modificación de múltiples archivos, depuración profunda, razonamiento a nivel de repositorio | Explicación de código, modificaciones puntuales, correcciones rutinarias, iteración de alta frecuencia |
| Características de la tarea | Muchas dependencias entre archivos; requiere entender la estructura global | Alcance bien definido; los cambios se concentran en partes locales |
| Recomendación de selección (criterio de este artículo) | Evaluar primero la corrección entre archivos | Evaluar primero la calidad de las tareas locales y la velocidad de respuesta |
| Naturaleza de la evaluación | Evaluación del fabricante | Evaluación del fabricante |
1.2 Canales de lanzamiento y disponibilidad de MAI Code 2
La disponibilidad es la parte que más fácilmente se malinterpreta. Según la nota de prensa de Microsoft y el blog de Azure AI Foundry, el estado de cada canal es el siguiente:
| Canal | MAI Code 2 | MAI Code 2 Flash | Descripción del estado |
|---|---|---|---|
| GitHub Copilot | Disponible | Disponible | Ya lanzado |
| Microsoft Foundry | No figura como disponible | Vista previa con acceso limitado | Requiere solicitud de elegibilidad |
| OpenRouter, Vercel, Hermes, OpenCode, Kilo | Próximamente | Próximamente | La nota de prensa lo marca como «soon»; no significa que ya esté totalmente abierto |
1.3 Especificaciones de la ficha del modelo MAI Code 2
Microsoft publicó al mismo tiempo las fichas de los dos modelos. Las especificaciones públicas que podemos confirmar por ahora son las siguientes:
- La modalidad de entrada es texto e imagen; la de salida, texto.
- La ventana de contexto del modelo es de 1.05M tokens, con un límite de entrada de 922k y un límite de salida de 128k.
- Lo anterior son especificaciones de la ficha del modelo, no una promesa de cuota disponible en cada punto de entrada del producto. Al usarlo, hay que consultar por separado las limitaciones concretas de cada producto. Por ejemplo, la ventana de contexto disponible en un plugin de IDE puede ser menor que la cifra de la ficha del modelo.
En cuanto al número total de parámetros, hay inconsistencias entre versiones en los materiales públicos; este artículo no las toma como válidas ni las cita.
1.4 Casos de personalización empresarial de MAI Code 2 y MAI Work Flash
En la página del modelo MAI Code 2, Microsoft menciona dos escenarios de modelos personalizados para empresas: AT&T y Woven by Toyota. Se trata de declaraciones del fabricante que describen usos de personalización concretos de empresas específicas, y no deben generalizarse como «todas las tareas empresariales obtendrán el mismo resultado».
Otra información que conviene explicar por separado es MAI Work Flash. El comunicado de prensa afirma que es un modelo derivado optimizado adicionalmente a partir de Code 2 Flash, al servicio de M365 y FabricIQ. Por lo tanto, los resultados de MAI Work Flash en escenarios de oficina no deben citarse directamente como resultados de la versión base Code 2 Flash.
1.5 Al elaborar el presupuesto, hay que distinguir entre tarifas promocionales y costes a largo plazo
La documentación de precios de GitHub Copilot enumera las tarifas en dólares por millón de tokens que aparecen a continuación, en el orden entrada/entrada en caché/salida:
| Modelo | Tarifa promocional | Tarifa regular a partir del 17 de mayo de 2027 |
|---|---|---|
| MAI Code 2 | 0.50/0.025/2.50 | 1.00/0.05/5.00 |
| MAI Code 2 Flash | 0.05/0.005/0.25 | 0.10/0.01/0.50 |
La documentación oficial no especifica la zona horaria concreta de esa fecha. Esto corresponde a los criterios de facturación de Copilot y no debe tomarse directamente como una cotización de Foundry o de plataformas de terceros. La publicidad sobre costes relativos en el comunicado de prensa de Microsoft utiliza el precio promocional del 50 % y una configuración de evaluación específica; el presupuesto empresarial a largo plazo debería calcular también el precio regular, los reintentos fallidos y el retrabajo manual.
2. Análisis y criterios: la segmentación de tareas empresariales detrás de las dos variantes de MAI Code 2
Lo siguiente recoge el análisis y las recomendaciones de la redacción; no representa la postura oficial de Microsoft. El texto no describe la función de enrutamiento automático de los productos de Microsoft; las reglas empresariales de derivación, escalado y aceptación que aquí se proponen deben diseñarse y validarse por separado.
2.1 Por qué MAI Code 2 se divide en dos variantes: el punto de competencia pasa del ranking general a la asignación de costes
Las solicitudes empresariales pueden incluir a la vez tareas como «refactorizar todo un módulo» y «explicar una función»; esos porcentajes deben salir del registro de tareas del equipo, no se puede dar por sentado que la mayoría son tareas simples. Si incluso las tareas simples se encomiendan siempre al Modelo de Lenguaje Grande, es posible sumar costes innecesarios, y la latencia real sigue siendo algo que hay que medir. Y si se deja todo al modelo ligero, las tareas complejas fallan con facilidad y generan retrabajos repetidos.
El lanzamiento en dos variantes pone, en la práctica, ese compromiso sobre la mesa: el fabricante ya no se limita a destacar el techo de un único modelo, sino que ofrece una pareja con roles bien definidos. Para las empresas, lo que realmente marca la diferencia es poder asignar la tarea adecuada a la variante adecuada y seguir calculando los resultados de forma continua. Este juicio se apoya en el posicionamiento oficial de la sección 1.1; cuánto es en realidad la brecha de costes debe verificarlo cada equipo con sus propios datos.
2.2 Paso 1: crear un registro de tareas para los modelos de doble nivel del tipo MAI Code 2
No te apresures a conectar modelos. Dedica primero de dos a cuatro semanas a registrar las tareas de programación que el equipo entrega realmente a la IA. El registro no tiene que ser complicado: lo clave es anotar los campos que permitan juzgar la complejidad:
| Campo del registro | Qué registrar | Para decidir |
|---|---|---|
| Tipo de tarea | Explicación, corrección, nueva funcionalidad, refactorización, depuración | Clasificación inicial |
| Número de archivos implicados | Un solo archivo o varios | Si se necesita comprensión a nivel de repositorio |
| ¿Hay un error reproducible? | Registro de errores o caso de prueba | Profundidad de la depuración |
| Forma de aceptación | Pruebas unitarias superadas, revisión manual, observación tras el despliegue | Costo de aceptación |
| Resultado | Aprobado a la primera, retrabajo varias veces, abandonado | Si el nivel elegido fue el correcto |
Con el registro, las reglas de estratificación posteriores tendrán una base, en lugar de trazar líneas según la intuición.
2.3 Paso 2: definir un enrutamiento predeterminado de bajo costo
Se recomienda que solo las tareas de bajo riesgo, alcance claro y condiciones de aceptación suficientes empiecen por el nivel ligero. El número de archivos puede servir como pista, pero no puede determinar el riesgo por sí solo: un cambio en autenticación, pagos o configuración de producción dentro de un solo archivo también podría requerir escalar directamente y reforzar la revisión manual.
Mejor escribir primero una tabla de triaje manual, en lugar de conectar de inmediato un agente automático: las tareas de explicación de código y sugerencias sin efectos secundarios empiezan por el nivel ligero; los cambios entre módulos y la depuración con causa raíz desconocida pasan al nivel complejo; las tareas que implican información secreta, permisos de producción o límites de seguridad pasan primero por revisión del responsable. Este artículo no realizó pruebas de integración y tampoco garantiza que ningún tercero ya dé soporte a estos dos modelos.
2.4 Tercer paso: definir reglas de escalado para tareas complejas
El enrutamiento predeterminado solo resuelve «por qué camino empezar»; también hay que definir claramente cuándo escalar. Se recomienda usar dos tipos de conditions de activación:
- Escalado previo: cuando el registro muestra que la tarea implica múltiples archivos, requiere comprensión a nivel de repositorio o depuración profunda, se asigna directamente al nivel pesado.
- Escalado posterior: cuando el resultado del nivel ligero no pasa las pruebas, o la misma tarea se retrabaja más veces de las acordadas, se cambia automática o manualmente al nivel pesado para reintentar.
Registra, para cada intento, el identificador de la tarea, el modelo, el uso, el resultado de aceptación y el motivo del escalado. Al reintentar, conviene incluir la información de fallo de la ronda anterior y establecer un límite de intentos o de presupuesto; si se supera el límite, se deriva a revisión humana y no se entra en un bucle infinito. No basta con determinar el éxito porque la salida contiene nombres de funciones o el texto «pruebas superadas»: hay que ejecutar pruebas confiables y verificar los cambios reales.
2.5 Cuarto paso: la aceptación humana no se puede omitir
Sea cual sea el nivel del modelo, el resultado final debe pasar por revisión humana antes de fusionarse. Se recomienda establecer distintas intensidades de aceptación según el nivel de la tarea: para cambios puntuales del nivel ligero, basta con que pasen las pruebas y una revisión rápida; para cambios en múltiples archivos del nivel pesado, se necesita que un ingeniero senior revise dependencias y posibles efectos secundarios. Por muy buenos que sean los resultados de las evaluaciones del proveedor, no pueden sustituir la aceptación dentro de tu propia base de código.
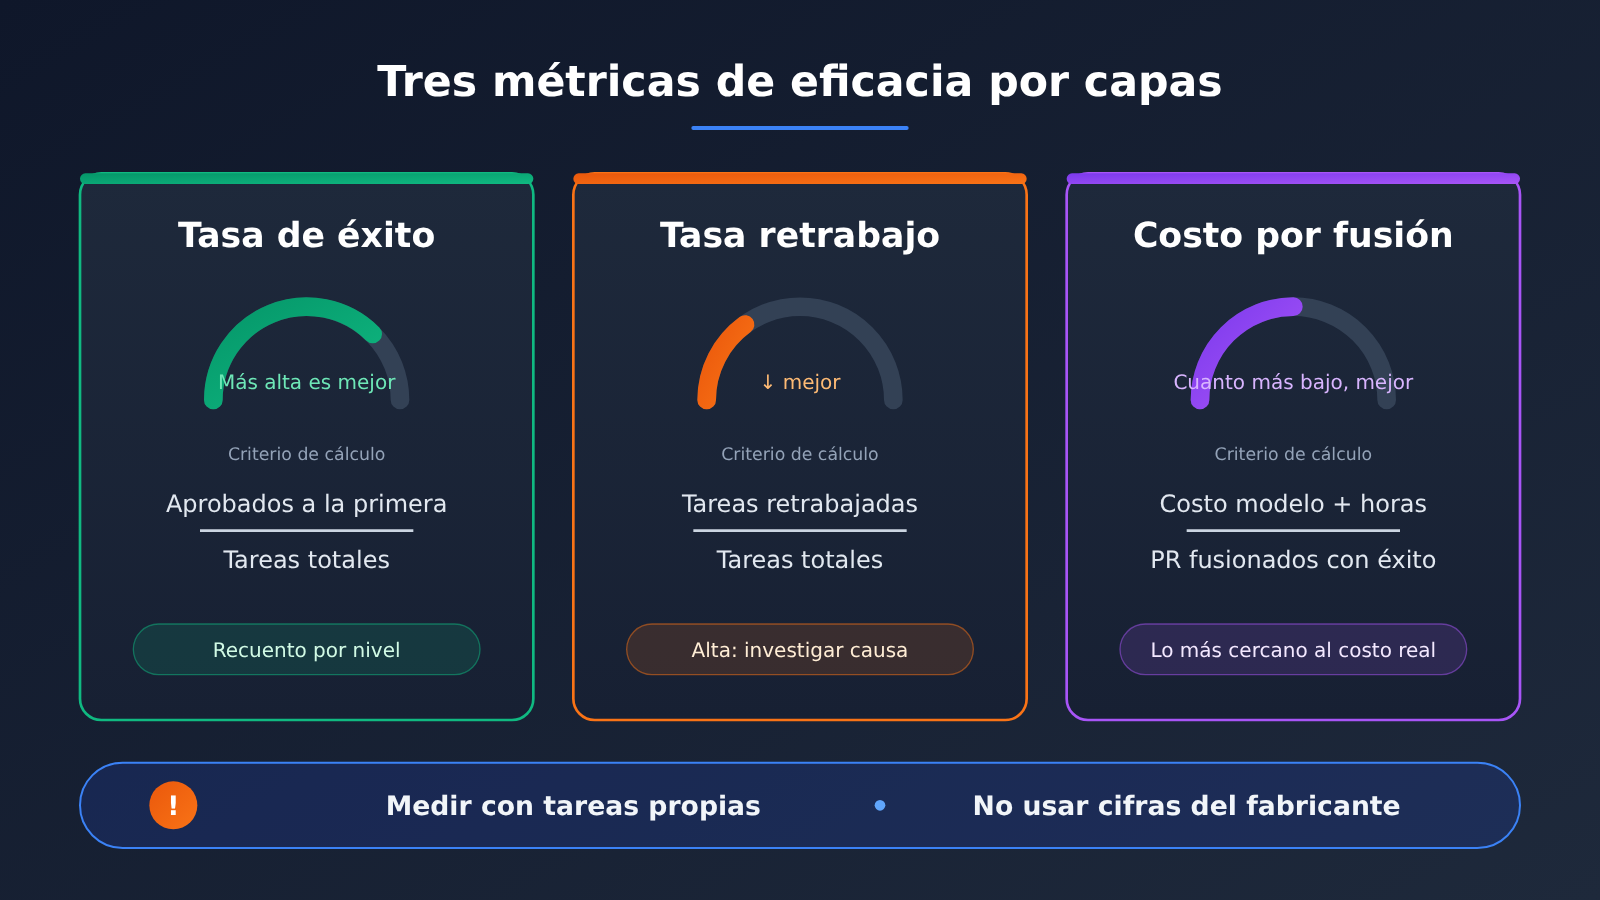
2.6 Paso 5: medir el efecto de la estratificación de MAI Code 2 con la tasa de éxito, la tasa de retrabajo y el costo por fusión
Mirar solo el precio unitario de los tokens puede llevar a conclusiones equivocadas: el nivel ligero es más barato por operación, pero si hay que rehacer tres veces, el costo total puede acabar siendo mayor. Se recomienda hacer el cálculo con estos tres indicadores:
| Métrica | Criterio de cálculo | Descripción |
|---|---|---|
| Tasa de éxito | Número de tareas aprobadas a la primera ÷ número total de tareas | Calcular por separado según el nivel y el tipo de tarea |
| Tasa de retrabajo | Número de tareas devueltas para rehacer ÷ número total de tareas | Cuando la tasa de retrabajo es alta, revisar también la estratificación, la falta de materiales y la definición de aceptación |
| Costo por fusión | (Costo de invocación del modelo + horas de revisión manual y retrabajo convertidas) ÷ número de PR fusionados con éxito | Es lo más cercano al costo real del negocio |
Estos tres indicadores deben medirse sobre tus propias tareas; no conviene aplicar directamente los “porcentajes de mejora de eficiencia” que dan los proveedores o los medios. En distintos repositorios de código, distintos lenguajes y distintos criterios de aceptación, los resultados pueden variar mucho.
2.7 Verificación antes del piloto: residencia de datos y permisos de MAI Code 2
Cada nível de modelo adicional que se incorpora implica otro conjunto de flujos de datos. Antes del piloto, se recomienda verificar al menos lo siguiente:
- Residencia de datos: confirmar si la región de procesamiento de datos del canal utilizado (Copilot, Foundry o plataformas de terceros) cumple los requisitos normativos de tu sector y región. Flash en Foundry está en fase de vista previa restringida, y las condiciones de esa fase pueden diferir de las de la versión oficial.
- Permisos de acceso al código: la inferencia a nivel de repositorio implica que el modelo puede leer una gama más amplia de código. Conviene limitar los repositorios y directorios a los que puede acceder, y excluir contenidos sensibles como claves, archivos de configuración y similares.
- Políticas de la organización: que se pueda cambiar de modelo en Copilot y qué modelos se pueden cambiar depende de la configuración del administrador de la organización; hay que confirmarlo de antemano.
- Registros de auditoría: garantizar que el modelo, la persona que realiza la invocación y el alcance de la entrada de cada invocación sean rastreables, para poder revisar lo ocurrido después.
2.8 Tres cosas que no conviene sobreinterpretar sobre MAI Code 2
- El enrutamiento del producto no equivale al proceso de gobernanza empresarial descrito en este artículo. Aunque el producto utilizado ofrezca selección automática de modelos, también hay que verificar por separado las reglas de enrutamiento, los umbrales de aceptación y los permisos; no se puede asumir que el método de cinco pasos de este artículo ya esté implementado automáticamente.
- No significa que Microsoft renuncie a la colaboración con OpenAI. El lanzamiento de un modelo de programación propio no permite concluir que Microsoft esté abandonando los modelos de OpenAI, y los materiales públicos disponibles tampoco respaldan esa conclusión.
- No significa que las evaluaciones del fabricante se puedan reutilizar directamente. Tanto los datos de rendimiento como los casos empresariales provienen de Microsoft; AT&T y Woven by Toyota corresponden a escenarios personalizados específicos, y MAI Work Flash es un modelo derivado optimizado por separado. Sus resultados no se pueden trasladar directamente a tus tareas.
2.9 Señales a las que conviene prestar atención tras MAI Code 2
Las siguientes son observaciones predictivas, a la espera de verificarse con los hechos. Primera: cuándo se abrirán realmente canales como OpenRouter y cómo será el sistema de facturación una vez abiertos. Segunda: cuándo terminará la vista previa restringida de Flash en Foundry y si la versión pesada también llegará a Foundry. Tercera: cuánto se distancia el límite de contexto a nivel de producto de los 1.05M indicados en la ficha del modelo, algo que incide directamente en si las tareas a nivel de repositorio caben de una sola vez en el contexto.
El mensaje que deja este lanzamiento de dos versiones es muy simple: el valor de la IA para programación no está en invocar siempre el modelo más potente, sino en encontrar el punto de equilibrio entre costo y calidad para cada tipo de tarea. Registrar claramente las tareas primero y dejar que los datos definan la línea divisoria resulta más fiable que perseguir cualquier puesto en una clasificación general. Como dice el pasaje «Duke Ling of Wei» de las Analectas de Confucio: «Quien quiera hacer bien su trabajo, primero debe afilar sus herramientas.»
Referencias
- Microsoft AI: anuncio de MAI Code 2 y Flash
- Microsoft Foundry: selección de modelos y personalización empresarial
- Ficha oficial de los modelos MAI Code 2 y Flash
- Microsoft AI: casos de personalización empresarial
- GitHub: precios de modelos de Copilot y fechas de promoción


