
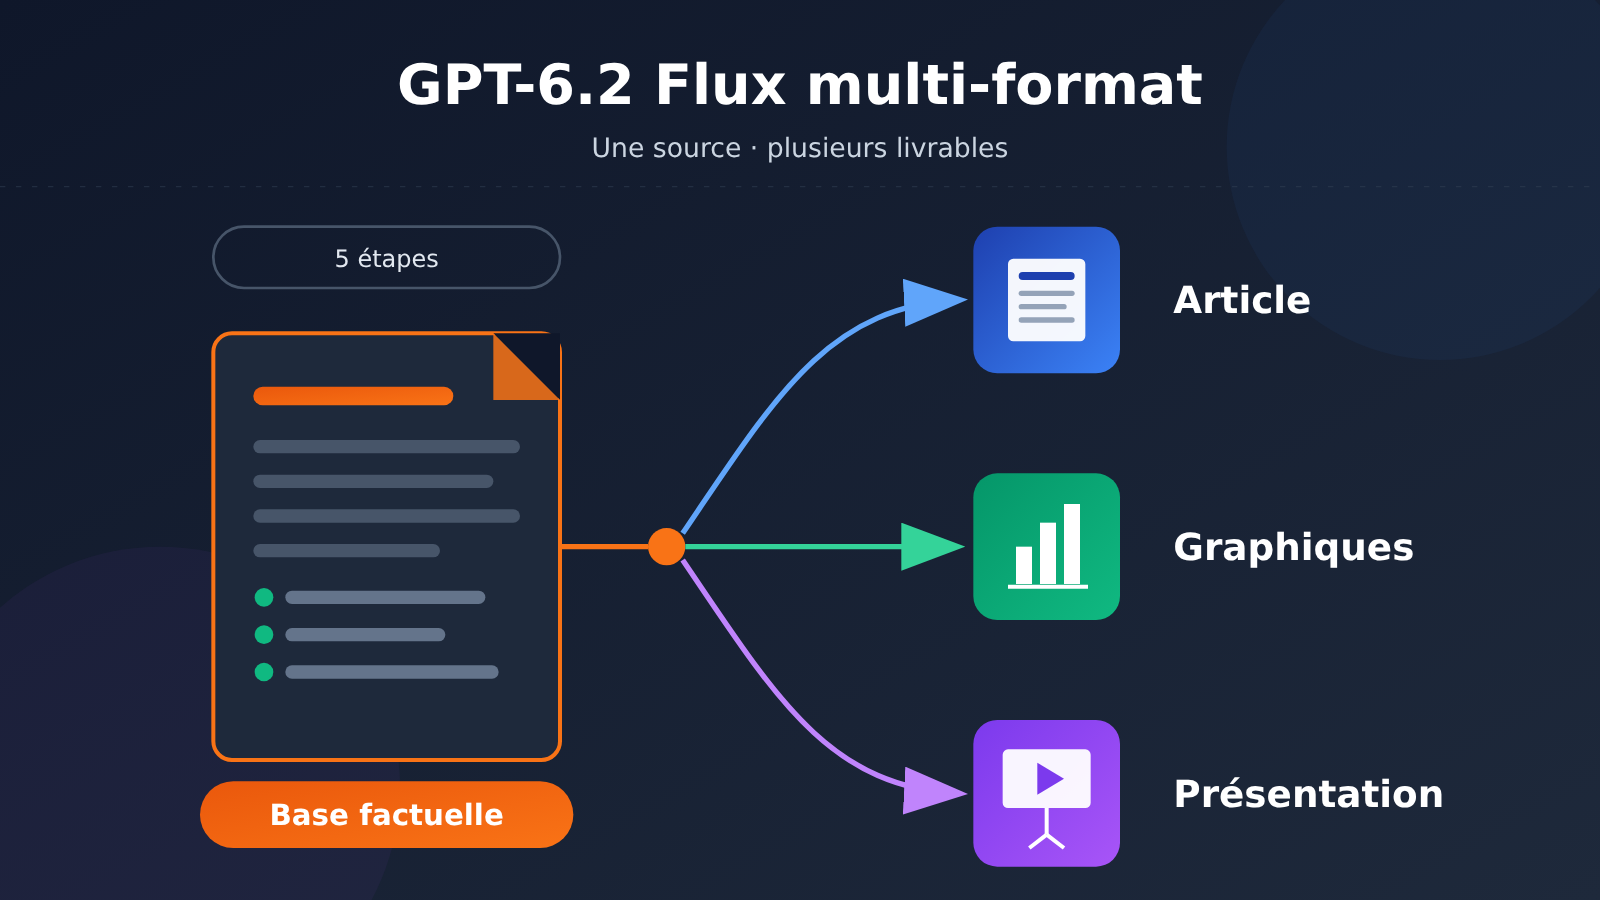
Une même source peut donner lieu à un article, des graphiques et une présentation, à condition de disposer d’abord d’une base factuelle vérifiée. L’approche la plus fiable consiste d’abord à vérifier les sources, puis à générer différents livrables selon l’objectif du lecteur. OpenAI a publié GPT-6.2 Astra et Sol le 17 novembre 2026. La page de lancement officielle mentionne la capacité à suivre des gabarits, ainsi qu’à traiter des documents, des diapositives et des feuilles de calcul. Mais pour que ces capacités deviennent des livrables fiables, il faut encore un environnement d’outils, une organisation des sources et une vérification point par point.
Ce que vous apprendrez à la lecture
- Quels faits relatifs au travail multiformat sont confirmés par la page de lancement officielle de GPT-6.2 Astra et Sol, et lesquels ne sont que des retours clients.
- Pourquoi la « production de livrables multiformats » dépend de l’environnement d’outils, et non du fait que le modèle produirait directement les fichiers.
- Une méthode de travail qui part d’une base factuelle vérifiée et se ramifie en article, graphiques et diapositives selon l’objectif du lecteur.
- Ce qu’il faut vérifier pour chaque type de livrable, et comment maintenir la cohérence des versions entre plusieurs livrables.
Sommaire de cet article
La suite commence par un tableau des concepts et un aperçu des impacts pour poser les bases, puis la partie « Faits objectifs » reprend point par point les informations de la page de lancement et de la page d’aide de GPT-6.2, en indiquant la source et la nature. La partie « Analyse et jugements » contient des recommandations éditoriales : 5 étapes et une liste de risques autour du flux de travail multiformat de GPT-6.2, à lire en priorité pour les lecteurs qui s’apprêtent à intégrer l’IA dans leur processus de production de contenu.
GPT-6.2 Flux de travail multiformat — To Know : explication des concepts
Ces notions reviendront plusieurs fois par la suite ; un tableau unique suffit à les poser dès maintenant.
| Concept | Explication rapide |
|---|---|
| GPT-6.2 Astra / Sol | Deux modèles publiés par OpenAI le 17/11/2026 ; cet article s’appuie sur la page officielle de lancement, la documentation du modèle et la page d’aide |
| Respect du gabarit | Capacité du modèle à organiser sa sortie selon la mise en page, la structure ou le format demandés ; la page de lancement en fait l’un des points clés |
| Environnement d’outils | Programme ou fonctionnalité produit qui, en dehors du modèle, se charge de générer, de rendre et d’enregistrer les fichiers — par exemple un éditeur de documents ou un moteur de rendu de diapositives |
| Base factuelle | Méthode de travail proposée dans cet article : consigner un par un les faits, sources, dates, unités et incertitudes tirés de la documentation, sous forme de liste structurée |
| Livraison multiformat | Processus consistant à produire, à partir d’une même source, des livrables de formes différentes : articles, graphiques, présentations, etc. |
| Ouverture par étapes | Le nouveau modèle n’est pas mis en ligne simultanément sur toutes les entrées ; il est déployé progressivement selon les canaux produits et les catégories d’utilisateurs |
GPT-6.2 Flux de travail multiformat — aperçu de l’impact
Cette sortie n’affecte pas les différents publics de la même manière ; le tableau ci-dessous ne recense que les différences étayées.
| Public | Impact principal | Points à surveiller |
|---|---|---|
| Créateurs de contenu | Le respect des gabarits et les capacités documentaires mis en avant par l’éditeur pourraient rendre la réutilisation d’un même texte plus fluide | Le Chat standard n’est pas disponible dans cette vague ; vérifiez l’entrée que vous utilisez |
| Travailleurs du savoir | Les tâches de type note de synthèse, tableur et diaporama sont explicitement citées sur la page de lancement | Les fichiers finis dépendent de l’environnement d’outils et ne doivent pas être considérés comme une sortie native du modèle |
| Développeurs | L’API est publiée ; l’accès au compte et les limites font foi sur la plateforme officielle | Le modèle produit du texte ; la génération de fichiers exige de mettre en place soi-même la chaîne de rendu |
| Managers d’équipe | Peut repenser le processus collaboratif « une source, plusieurs livrables » | La cohérence des chiffres et des citations entre les différents livrables reste à contrôler manuellement |
1. Faits objectifs : que montrent réellement les exemples officiels
Date de vérification : 18 novembre 2026. Les cas ci-dessous proviennent de la page d’annonce d’OpenAI ; il ne s’agit pas de tests réalisés par l’auteur de cet article.
1.1 Deux catégories de cas de livraison officiels et traçables
| Cas officiel | Entrée et exigences | Livrable présenté | Enseignements pour un travail multi-format |
|---|---|---|---|
| Classeur financier d’Alderfen Field Systems | États financiers, hypothèses opérationnelles et données de marché d’une entreprise fictive du secteur agritech | Classeur Excel modifiable de prévisions et de valorisation | Les chiffres, les hypothèses et les relations de calcul doivent rester traçables |
| Proposition de produits dérivés d’équipe sur le thème des animaux | Modèle de présentation public d’OpenAI et exigences de conception de quatre équipes | Diapositives de proposition thématique, fichiers de conception vectorielle et instructions de production | Un même projet peut produire des livrables distincts, les uns destinés à la discussion, les autres à l’exécution |
OpenAI cite également les retours d’IMC sur un brief et une infographie. Il s’agit de témoignages clients, à ne pas considérer comme des résultats de test de cet article. Ces démonstrations correspondent à des tâches différentes ; il ne s’agit pas d’une expérience complète consistant à « générer d’un seul clic un article, des graphiques et un PPT à partir d’un même document ».
1.2 Capacités de fichiers et points d’entrée produit
La documentation du modèle GPT-6.2 Astra indique des entrées texte et image, ainsi que des sorties texte. La génération de fichiers modifiables nécessite encore les outils fournis par le produit, ou un programme de génération et de rendu de fichiers mis en place par le développeur ; une réponse textuelle unique ne constitue pas un fichier validé.
La page d’aide Work et Codex précise que ce déploiement progressif n’inclut pas le sélecteur de modèles Chat standard. L’annonce de lancement confirme en parallèle que l’API propose désormais deux nouveaux modèles. Avant utilisation, vérifiez séparément les autorisations de compte et les capacités d’outils du produit concerné.
2. Analyse et évaluation : 5 étapes pour transformer une source en article, graphique et présentation
Le contenu ci-dessous relève de suggestions éditoriales et non d’une communication officielle. Cet article ne fait pas réellement appel à GPT-6.2 pour produire un ensemble complet d’œuvres ; les exemples ci-dessous ne font que démontrer la logique d’organisation et ne représentent aucun résultat réellement généré. Pour éviter d’inventer des chiffres, nous utilisons directement la source « Lancement de GPT-6.2 » elle-même comme exemple de structure.
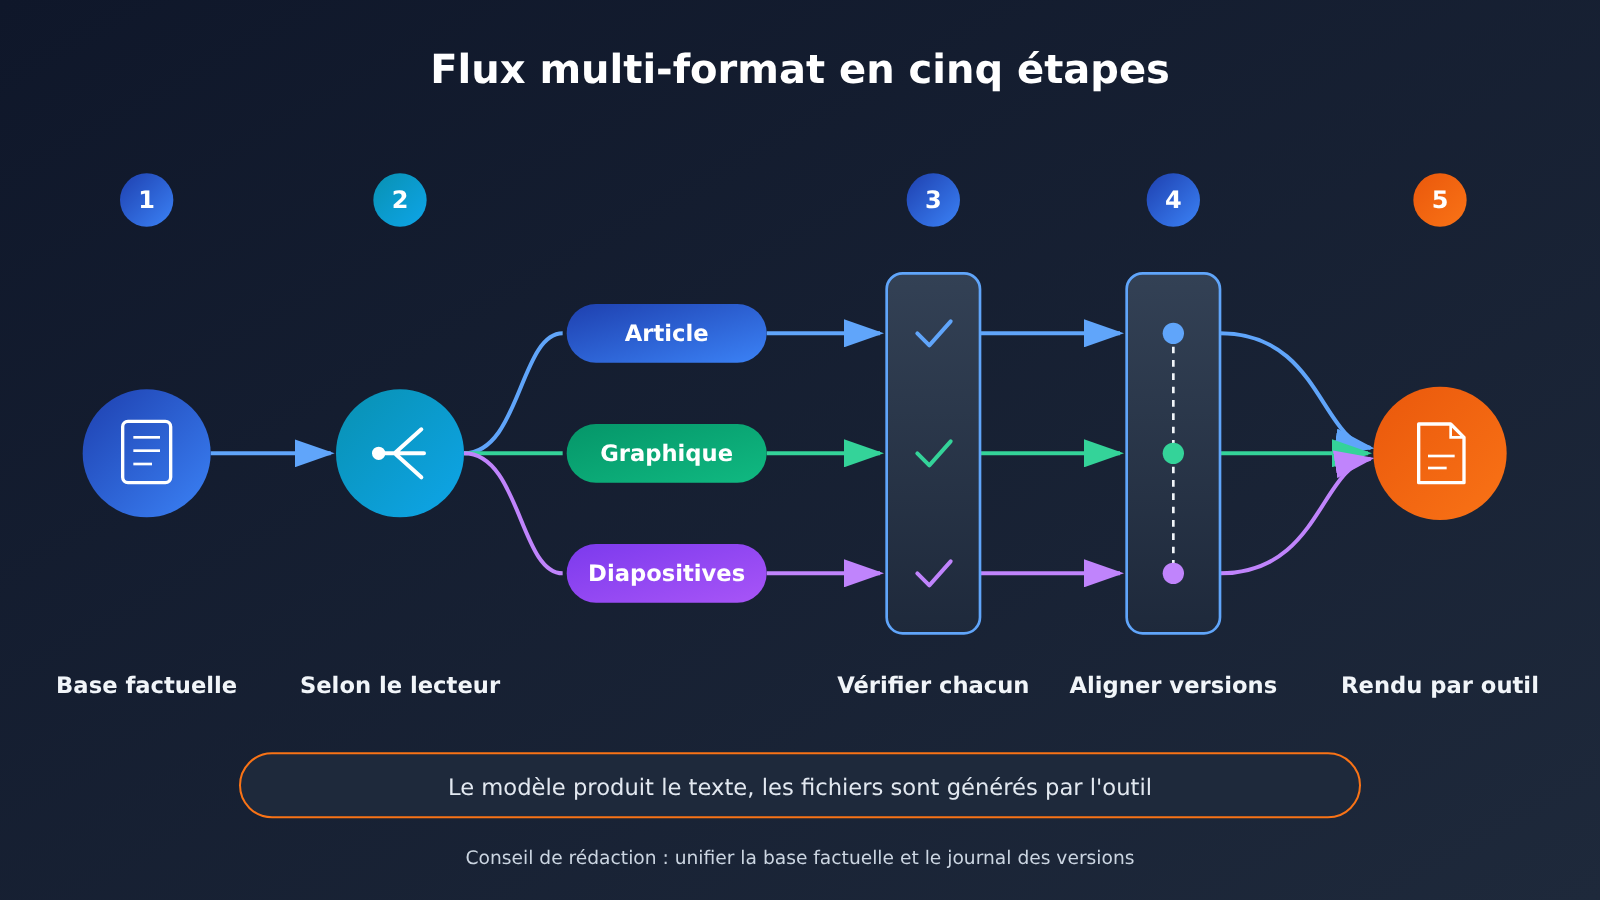
2.1 Établir la base factuelle d’un flux de travail multiformat GPT-6.2
Quand des productions multiformat contiennent des erreurs, ce n’est souvent pas un problème de rédaction, mais plutôt le fait que les faits source n’ont pas été figés. Nous recommandons de décomposer d’abord la source en faits élémentaires, en enregistrant pour chacun l’origine, la date, l’unité et l’incertitude. Une fois la base factuelle fixée, toutes les productions ultérieures y puisent leur matière, au lieu de retourner chacune fouiller la source originale.
| Fait | Source | Date | Unité | Incertitude |
|---|---|---|---|---|
| OpenAI lance GPT-6.2 Astra et Sol | Page de lancement officielle | 2026-11-17 | Aucune | Faible |
| La communication mentionne le respect des modèles et les capacités documents/diapositives/tableaux | Page de lancement officielle | 2026-11-17 | Aucune | Description promotionnelle, l’efficacité doit être vérifiée par soi-même |
| Retour d’IMC sur le briefing et l’infographie | Cité dans la page de lancement | 2026-11-17 | Aucune | Retour d’un seul client, non extrapolable |
| Le Chat ordinaire n’est pas encore disponible cette fois | Page d’aide | Vérifié le 2026-11-18 | Aucune | Susceptible d’évoluer ultérieurement |
| Work/Codex déployés progressivement, API déjà publiée | Page d’aide et annonce de lancement | Vérifié le 2026-11-18 | Aucune | La date d’ouverture pour chaque compte est incertaine |
Dans cet exemple, la colonne « Unité » vaut toujours « Aucune », mais dans une source contenant des prix, des volumes d’utilisateurs ou des données de performance, c’est précisément le champ où les erreurs sont les plus fréquentes lors de la transcription vers un graphique. La colonne « Incertitude », elle, détermine si un fait donné peut ou non figurer sur la page de conclusions des diapositives.
2.2 Décliner le contenu en article, graphique et présentation selon l’objectif du lecteur
Un même brouillon peut s’adresser à des publics différents, et les choix à faire ne seront pas les mêmes. Les lecteurs d’un article acceptent de suivre le raisonnement ; ceux d’un graphique veulent seulement saisir rapidement les relations entre les données ; le public d’une présentation a besoin d’une conclusion claire par diapositive.
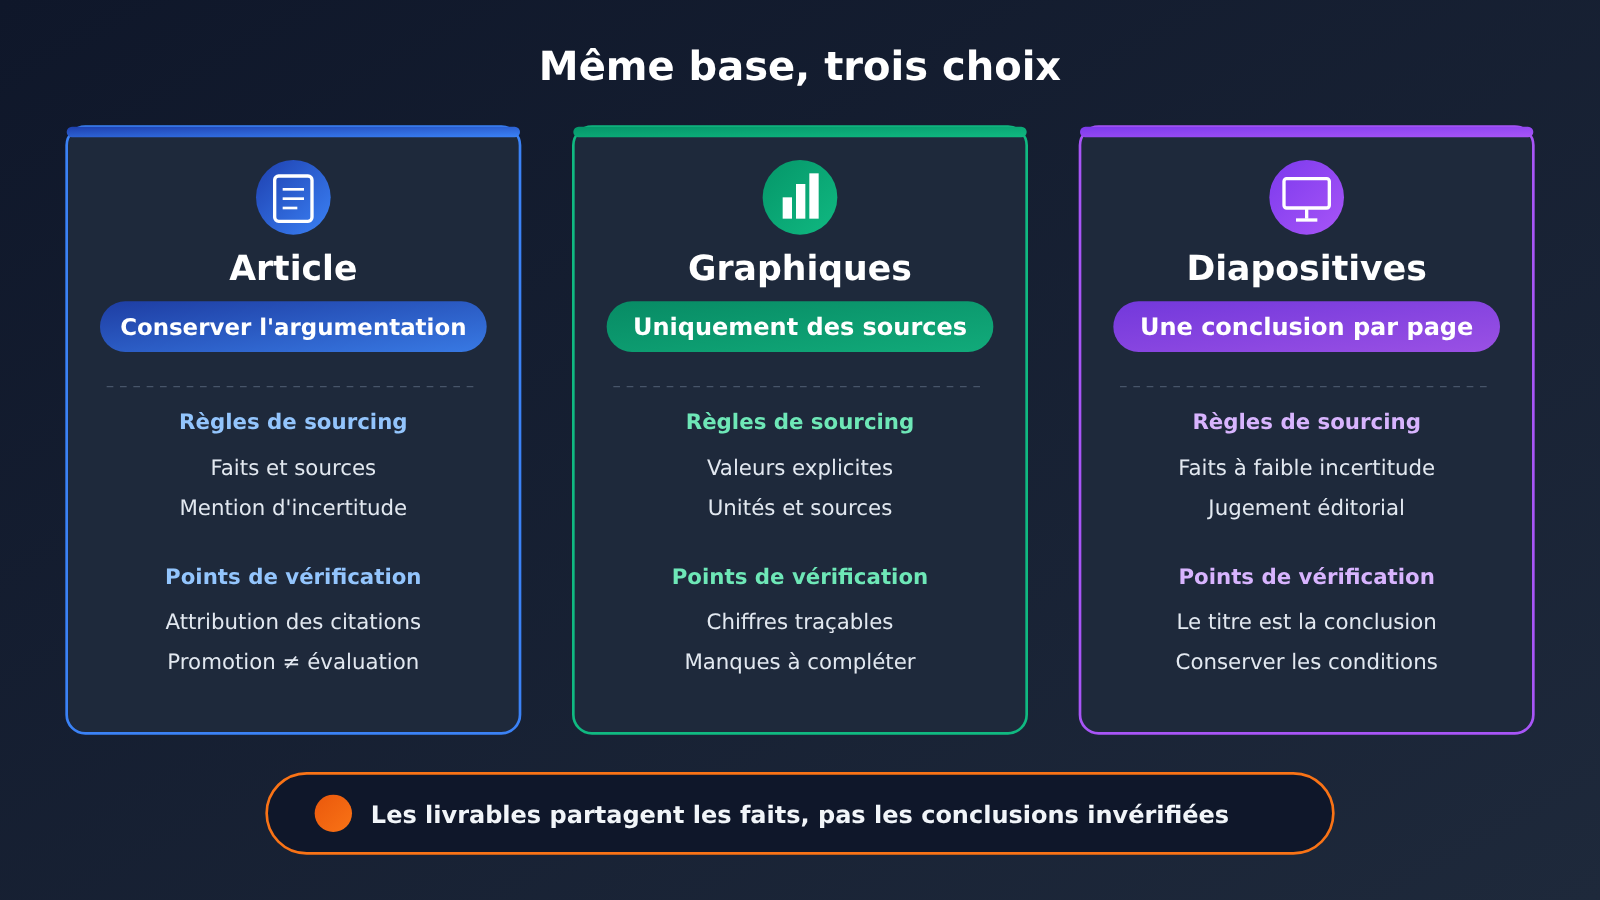
| Livrable | Principe clé | Ce que l’on reprend du brouillon | Risques courants |
|---|---|---|---|
| Article | Conserver l’argumentation | Faits + sources + explication des incertitudes | Transformer un discours promotionnel en conclusion d’évaluation |
| Graphique | Ne présenter que des données sourcées | Les entrées avec une valeur numérique, une unité et une source explicites | Inventer des chiffres « plausibles » quand les données manquent |
| Diapositives | Une conclusion par diapositive | Faits à faible incertitude + jugement éditorial | Perdre les conditions limitatives lors de la compression |
Prenons le brouillon d’exemple de cet article : il ne contient aucun fait numérique. Il n’est donc pas adapté à un graphique de données et se prête mieux à une frise chronologique ou à un schéma de l’état d’ouverture des canaux. Ce point est essentiel : si l’on impose au modèle de « faire un graphique comparatif », on risque de l’inciter à ajouter des chiffres qui n’existent pas dans les documents.
Conseil éditorial : précisez dans l’invite « n’utilisez que les éléments du brouillon ; signalez les données manquantes comme à compléter », et conservez la liste des sources pour chaque livrable.
2.3 Vérifier séparément les chiffres, les citations et la mise en page dans les sorties de GPT-6.2
Les trois types de livrables n’ont pas les mêmes points de contrôle : mieux vaut les traiter séparément plutôt que de se contenter d’un survol global en se disant « ça a l’air bon ».
- Vérification des chiffres : chaque valeur présente dans un graphique doit pouvoir être retrouvée dans le document de référence, avec la même unité et la même date.
- Vérification des citations : toute mention des retours IMC dans l’article doit conserver l’attribution « retours clients cités sur la page de publication ».
- Vérification de la mise en page : le titre de la diapositive doit-il être la conclusion elle-même ? Les éléments du gabarit sont-ils correctement respectés ? La capacité à suivre le gabarit, mise en avant par l’éditeur, est justement ce qu’il faut contrôler concrètement ici.
- Vérification des cas limites : aucun livrable ne doit contenir de formulation du type « déjà disponible dans le Chat standard », qui contredirait la page d’aide.
2.4 Aligner les versions entre articles, graphiques et présentations
Le piège le plus sournois du travail multi-format, c’est la dérive de version : on retouche une formulation dans l’article, et la présentation reste bloquée sur l’ancienne version. La bonne pratique : attribuer un numéro de version au document de référence et noter, dans chaque livrable, la version de ce document sur laquelle il repose. Quand l’état de disponibilité indiqué sur la page d’aide évolue, il suffit de modifier le document de référence, puis de vérifier par numéro de version quels livrables doivent être mis à jour.
2.5 Générer les fichiers, puis vérifier le rendu réel de la livraison
Quand vous disposez d’un environnement de développement, vous pouvez d’abord demander au modèle de renvoyer le corps de l’article, les spécifications des graphiques et le plan page par page, puis confier le tout aux outils de traitement de texte, de dessin et de présentation. Avec Work, précisez clairement que vous attendez des fichiers modifiables, en indiquant le modèle, la police et le format de page. Le processus décrit ici est une recommandation : aucune invocation ni génération de pièce jointe n’a été effectuée.
Consigne de tâche à copier-coller :
N’utilisez que les faits vérifiés figurant dans le document de base en pièce jointe. Commencez par lister les informations manquantes, puis préparez séparément : un article qui conserve les arguments et les sources ; un plan de graphiques n’utilisant que les données disponibles ; un plan de présentation avec une conclusion par diapositive. En l’absence de données numériques, utilisez un diagramme de relations plutôt que d’inventer un histogramme. Tous les livrables doivent mentionner la version du document de base. Une fois les fichiers terminés, signalez ce qui n’a pas pu être vérifié, et ne présentez pas les parties inachevées comme terminées.
Une fois les fichiers générés, refaites une passe de validation : ouvrez le document pour vérifier les paragraphes et la pagination, ouvrez les graphiques pour contrôler les axes et les étiquettes, et passez chaque diapositive en revue pour détecter les débordements, les chevauchements et les polices manquantes. Vérifier les données sources ne remplace pas ces contrôles après rendu.
2.6 Risques et critères d’acceptation
Quand on transpose les descriptions officielles des capacités dans les processus d’une équipe, plusieurs types de risques méritent d’être inscrits à l’avance dans les règles.
- Confusion entre communication et évaluation : les descriptions de capacités de la page de lancement et les retours IMC ne sont pas des évaluations indépendantes ; dans les contenus externes, mieux vaut ne pas les présenter comme « déjà prouvés ».
- Mauvaise interprétation des canaux : le Chat standard n’est pas disponible dans cette vague ; si les membres de l’équipe passent par des points d’entrée différents, ils n’obtiennent pas forcément le même modèle.
- Mauvaise interprétation des capacités de fichiers : le modèle produit du texte ; la qualité du fichier dépend largement de l’outil de rendu et du modèle de document.
- Risque de complétion de chiffres : quand les données manquent, demander la génération de graphiques est le meilleur moyen d’introduire des chiffres sans source.
- Risque de péremption : un déploiement par phases signifie que l’état évolue ; les informations de disponibilité dans le document de base doivent indiquer la date de vérification.
Les créateurs de contenu peuvent d’abord figer le document de base et les citations ; les travailleurs du savoir peuvent tester la mise en page réelle avec les modèles de leur propre entreprise ; les développeurs doivent séparer l’invocation du modèle, la génération de fichiers et la validation en étapes indépendantes. Je recommande de suivre les résultats du pilote avec trois indicateurs : le nombre de corrections de faits, le nombre de reprises de mise en page, et le fait que le fichier modifiable final passe ou non la validation. C’est ainsi que l’on peut juger si le nouveau modèle améliore réellement son propre travail, plutôt que de simplement multiplier les livrables.
Les capacités des modèles progressent, mais l’ordre « figer d’abord les faits, puis bifurquer selon les lecteurs, enfin vérifier point par point » ne changera pas à cause du modèle. Plus l’outil est puissant, plus il faut une méthode claire d’organisation des informations pour le maîtriser — comme le dit le proverbe : « Pour bien faire son ouvrage, il faut d’abord affûter ses outils » (Entretiens de Confucius, Livre XV, Wei Ling Gong).


