
Anmerkung des Autors: Ein Multi-Projekt-Agent braucht unabhängige Kontexte, dauerhaft gespeicherte Zustände, Aufgabenplanung und Wiederaufnahmemechanismen – nur so lässt sich paralleles Arbeiten nachvollziehbar und ohne gegenseitige Störung umsetzen.
Ob ein KI-Assistent mehrere Projekte gleichzeitig voranbringen kann, hängt an vier Dingen: Jede Arbeit hat ihren eigenen Kontext, der Ausführungszustand wird dauerhaft gespeichert, ein Scheduler übernimmt zentral Priorisierung und Nebenläufigkeit, und nach einer Unterbrechung lässt sich die Arbeit aus einem Checkpoint wieder aufnehmen. Mehrere Modelle gleichzeitig aufzurufen ist nicht schwer – schwer ist es, dafür zu sorgen, dass jeder dieser Aufrufe weiß, was er gerade tut. Das am 29. September 2026 von OpenAI veröffentlichte Dots folgt genau diesem Muster. Laut offizieller Dokumentation kann ein Dot mehrere Zuständigkeiten verwalten und Arbeit an Hintergrund-Agenten zur parallelen Bearbeitung auslagern. Jede neue Aufgabe erhält ihren eigenen Gesprächskontext und übernimmt nicht automatisch die gesamte bisherige Konversation zwischen Nutzer und Dot. Entwickler können mit Checkpointer, Store, Task-Queue und State-Machine ein vergleichbares Multi-Projekt-Managementsystem aufbauen.
Im Folgenden analysieren wir zunächst anhand der offiziellen Unterlagen die Multitasking- und Gedächtnismechanismen von Dots und entwerfen dann anhand eines durchgängigen Projektmanagement-Beispiels Schritt für Schritt eine vierstufige Aufgabenstruktur, die parallele Disposition, die Wiederaufnahme nach Unterbrechungen, die Ausführungsnachverfolgung und die Kostengrenzen. Die „zehn Projekte“ im Titel sind nur eine beispielhafte Beschreibung des Arbeitsmodus; weder Dots noch ein selbst gebautes System hat eine feste Zehn-Wege-Nebenläufigkeit, und unbegrenzt parallel geht es ebenfalls nicht. Der im Text gezeigte Code für den selbstgebauten Agenten ist ein Designentwurf; fiktive Laufzeitergebnisse sind ihm nicht beigefügt.
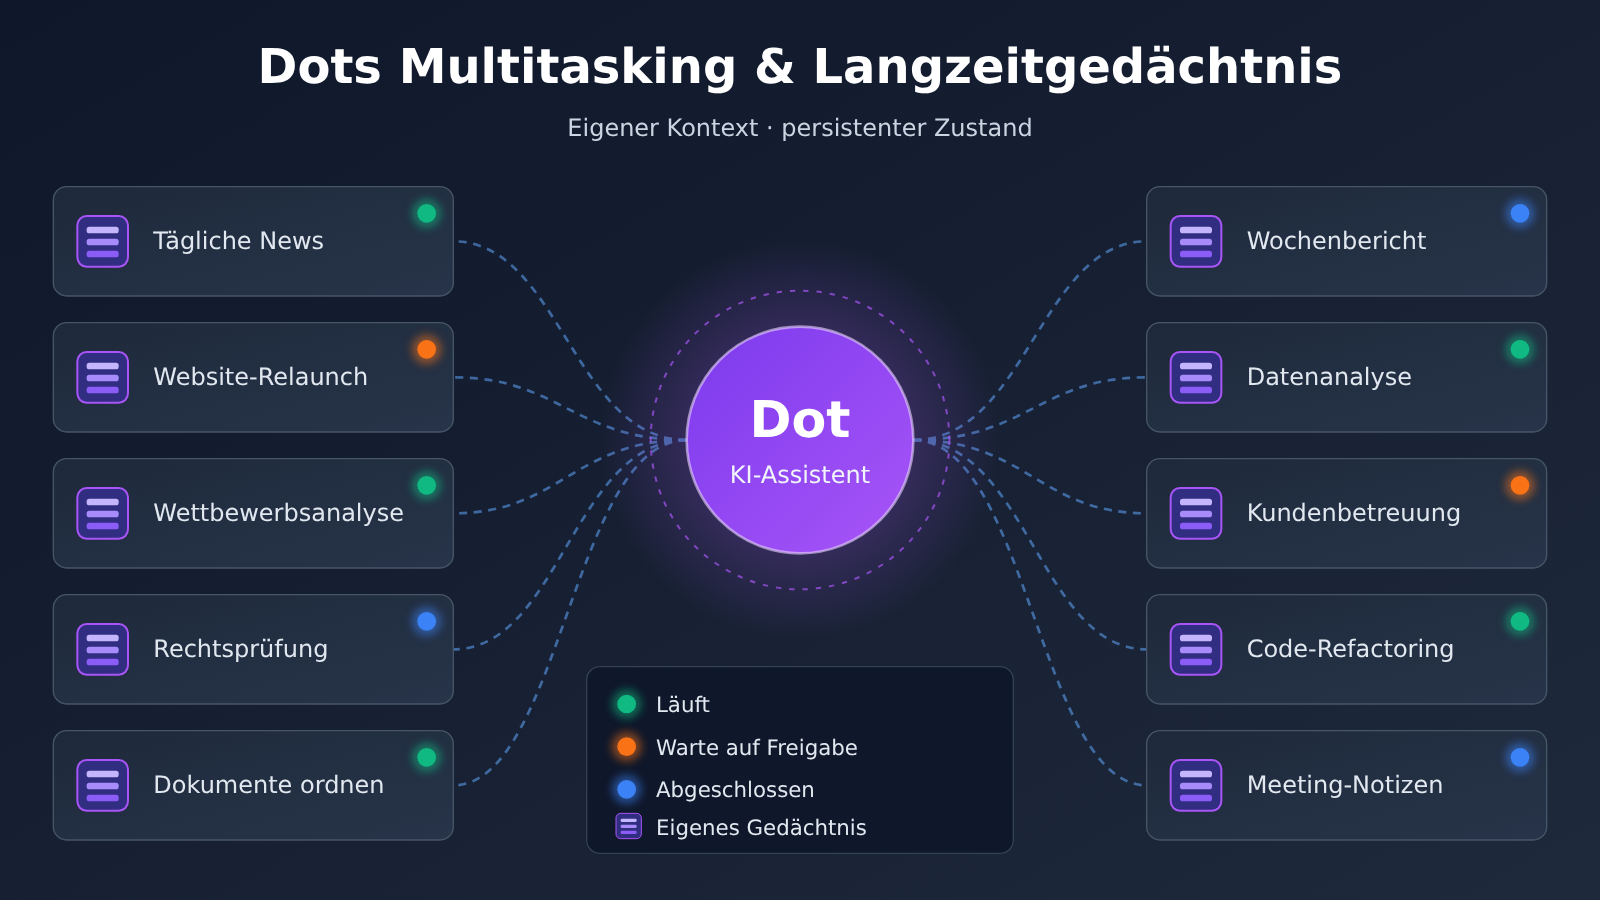
Wissenswertes: Begriffe zur Multitasking-Orchestrierung bei Dots
| Begriff | Erklärung |
|---|---|
| Workspace | Ein Arbeitsbereich zur Organisation von Projekten und Berechtigungen, der in der Regel einem Nutzer oder einem Team entspricht. |
| Project | Eine Projekteinheit, die Ziele, Materialien und die zugehörigen Aufgaben umfasst. |
| Task | Eine Arbeit mit klar definiertem Ziel, zum Beispiel „die heutigen OpenAI-News abrufen“. |
| Run | Ein einzelner tatsächlicher Ausführungsdatensatz einer Aufgabe; derselbe Task kann beliebig oft ausgeführt werden. |
| Hintergrund-Agent | Ein Ausführender, den Dot losschickt, um Teilaufgaben parallel zu bearbeiten, und der nach Abschluss an Dot Bericht erstattet. |
| Checkpointer | Eine Komponente, die Ausführungs-Checkpoints von Aufgaben speichert und für die Wiederaufnahme nach Unterbrechungen zuständig ist. |
| Store | Eine Speicherkomponente, die aufgabenübergreifende Langzeitinformationen speichert und den Projektkontext fortführt. |
| Zustandsmaschine | Ein Mechanismus, der die Phasenübergänge einer Aufgabe nach festen Regeln steuert, etwa ausstehend, in Ausführung oder auf Genehmigung wartend. |
| Parallelitätslimit | Die Obergrenze für gleichzeitig ausgeführte Aufgaben, begrenzt durch API-Kontingente, Serverressourcen und Kosten. |
| Tracing | Die Fähigkeit, Modellaufrufe, Tool-Aufrufe und Übergabeprozesse nachzuvollziehen und aufzuzeichnen. |
| Proactive Research | Eine rein lesende Hintergrundrecherche, die Dots in autorisierten Datenquellen durchführt, wenn keine neuen Nachrichten eingehen. |
1 Dots-Multitasking: Warum ein Dot mehrere Verantwortlichkeiten gleichzeitig übernehmen kann
1.1 Die offiziell von Dots kommunizierten Multi-Projekt-Fähigkeiten
Laut offizieller Positionierung ist Dots ein dauerhaft laufender persönlicher Agent. Er verfügt über einen eigenen Cloud-Computer und einen Browser und kann delegierte Arbeit auch dann weiterführen, wenn der Nutzer nicht mehr anwesend ist. Zum Multitasking listet die Dokumentation „Tasks and memory“ die folgenden Fähigkeiten auf:
- den Status mehrerer Arbeitsvorgänge gleichzeitig vorhalten und innerhalb derselben Unterhaltung zwischen Aufgaben wechseln;
- Nutzer können jederzeit Informationen ergänzen und Prioritäten anpassen;
- komplexe Aufgaben in mehrere Teile zerlegen und sie Hintergrund-Agenten zur parallelen Bearbeitung übergeben;
- eigenständige, sichtbare Aufgaben-Threads anlegen und anschließend die Ergebnisse der einzelnen Aufgaben einsammeln und zusammenfassen;
- bei Blockaden um Eingreifen des Nutzers bitten, während der Nutzer auch während laufender Hintergrundaufgaben weiterhin Nachrichten senden kann.
In Kombination rücken diese Fähigkeiten die Rolle von Dot näher an die eines Projektkoordinators. Dot entscheidet, was zuerst erledigt wird, was ausgelagert wird und was an den Nutzer zurückgeht; die konkrete Ausführung einer einzelnen Aufgabe können Hintergrund-Agenten, ChatGPT-Work-Aufgaben oder Codex-Aufgaben übernehmen.
1.2 Der Unterschied zwischen mehreren Unterhaltungen, mehreren Aufgaben und mehreren Agenten
Diese drei Konzepte werden oft vermischt, lösen aber jeweils unterschiedliche Probleme. Betrachten wir sie anhand eines einheitlichen Beispiels: Angenommen, im Workspace des Nutzers liegen drei Projekte – AI Radar (täglicher KI-Nachrichtenüberblick), Website (Website-Relaunch) und Research (Wettbewerbsanalyse).
| Modus | Funktionsweise | Ausprägung im Beispiel | Gelöstes Problem |
|---|---|---|---|
| Mehrere Unterhaltungen | Der Nutzer öffnet für jedes Projekt ein eigenes Chatfenster | Der Nutzer muss selbst im Kopf behalten, wie weit Research gediehen ist | Chatinhalte werden getrennt, der Fortschritt bleibt aber in menschlicher Hand |
| Mehrere Aufgaben | Ein Koordinator pflegt den Status mehrerer Aufgaben | Dot hält Fortschritt und Priorität der drei Projekte jeweils fest | Zentrale Steuerung und Statusverfolgung |
| Mehrere Agenten | Der Koordinator vergibt Teilaufgaben an mehrere Ausführende | Ein Hintergrund-Agent sammelt Material, ein anderer Ausführender schreibt den Bericht | Parallele Ausführung und Spezialisierung |
Dots legt alle drei Ebenen übereinander: Der Nutzer kommuniziert über einen einzigen Einstiegspunkt mit Dot, Dot pflegt mehrere Aufgaben und entsendet bei Bedarf Hintergrund-Agenten. Wer diesen Effekt mit einem selbstgebauten System nachbilden will, muss alle drei Ebenen umsetzen – mehrere Chatfenster allein reichen bei Weitem nicht aus.
1.3 Eine Parallelbeobachtung aus dem Erfahrungsbericht eines Nutzers
Ein Nutzer auf Reddit schilderte einen Test, den er über einen Tag hinweg durchführte. Er übergab Dot mehrere hundert PDFs und Tausende Seiten Dokumente zur Prüfung und ließ gleichzeitig eine juristische Rechercheaufgabe laufen. Er beobachtete drei gleichzeitig ablaufende Ausführungsprozesse: Der eigene Cloud-Computer von Dot bearbeitete Aufgabe A, ein von ihm verbundener Linux-Rechner bearbeitete Aufgabe B und ein weiterer Hintergrund-Recherche-Agent bearbeitete Aufgabe C. Er erwähnte außerdem, dass beim Start der eigenständigen juristischen Rechercheaufgabe die Ausführungsumgebung zeitweise nicht verfügbar war und die Auslieferung erst nach dem Verbinden des lokalen Rechners erfolgreich gelang.
Diese persönliche Beobachtung zeigt, dass der Cloud-Computer von Dot, der lokale Rechner und die Work-/Codex-Umgebungen unterschiedliche Ausführungsressourcen sind. Der Autor weist selbst darauf hin, dass er nicht geprüft hat, ob diese Pfade über eigenständige und unbegrenzte Kontingente verfügen. Der Test belegt also lediglich, dass Dots Arbeit auf verschiedene Umgebungen verteilen kann; daraus lässt sich nicht ableiten, dass jeder Pro-Nutzer denselben Parallelisierungsumfang erhält.
2 Dots Langzeitgedächtnis: Warum eine Aufgabe ein eigenes Gedächtnis braucht
2.1 Die Kontextgrenzen einer neuen Aufgabe
Die offizielle Dokumentation sagt es klar: Jede neue Aufgabe hat ihren eigenen Gesprächskontext und erhält nicht automatisch den gesamten Verlauf zwischen Dot und dem Nutzer. Dot kann vergangene ChatGPT-Gespräche durchsuchen, um Hintergrundinformationen zu finden – die abgerufenen Inhalte dienen dann ausschließlich als Kontext für die aktuelle Arbeit.
Dieses Design ist praxisnah. Würde jede Aufgabe die komplette Historie laden, könnte sich in den Wettbewerbsbericht des Research-Projekts die Diskussion über das Redesign des Website-Projekts mischen – und der Kontext würde mit jeder Runde länger und teurer. Langfristige Projekte brauchen eine explizite Verwaltung der Frage „Was sollte diese Aufgabe wissen?“, und das lässt sich mit einem einzigen, immer weiter wachsenden Chat-Protokoll nicht leisten.
2.2 Die vier Datenschichten des Dot-Gedächtnisses
Laut offiziellen Angaben stammt der Kontext von Dot aus vier verschiedenen Quellen:
- ChatGPT Memory: Dot kann relevante ChatGPT-Erinnerungen und aktuelle Gespräche lesen;
- Dots eigene Notizen: Hier sammeln sich Nutzerpräferenzen, Arbeitsgewohnheiten, Projektentscheidungen und langfristige Zuständigkeiten;
- Kontext der aktuellen Aufgabe: Anweisungen, Dateien, Abrufergebnisse und Ergebnisse von Tool-Ausführungen aus diesem Gespräch;
- Daten verbundener Apps: Dot liest Daten aus autorisierten Apps und kann durch eigene Recherche Erinnerungen aufbauen.
Diese Schichten haben jeweils einen anderen Lebenszyklus. ChatGPT Memory und die Dot-Notizen gehören unterschiedlichen Datenschichten an: Das Abschalten der ChatGPT-Memory-Freigabe löscht nicht automatisch die Informationen, die Dot bereits erfasst hat, und das Trennen eines Plugins stoppt lediglich neue Zugriffe. Stand 16. November 2026 können Nutzer die eigenständigen Erinnerungen von Dot noch nicht einzeln einsehen, ändern oder löschen; das Löschen von Dot startet die Löschung seines eigenen Kontexts. Wer für ein eigenes System eine Gedächtnisschicht entwirft, kann sich an dieser Aufteilung orientieren und zusätzlich eine Verwaltungsoberfläche ergänzen, in der Einträge einsehbar und löschbar sind.
3 Checkpointer und Store: die zwei Arten von Gedächtnis eines Multi-Task-Agenten
Die Persistenz-Dokumentation von LangGraph teilt das Gedächtnis eines Agenten in zwei Kategorien ein – eine Unterscheidung, die genau zu Dots’ „Task-Kontext“ und „Langzeitnotizen“ passt. Im Folgenden erkläre ich das weiterhin am Beispiel des monatlichen Wettbewerbsberichts aus dem Research-Projekt.
3.1 Checkpointer: sich merken, wie weit die Arbeit gediehen ist
Der Checkpointer speichert einen Ausführungs-Snapshot eines einzelnen Task-Threads: aktueller Schritt, bereits aufgerufene Tools, deren Rückgabewerte und welcher Schritt gerade auf eine menschliche Freigabe wartet. Im Beispiel hat der Monatsbericht-Task bereits die Preisseiten von 6 Wettbewerbern abgerufen und steht kurz vor der Analyse, als der Dienst neu startet. Dank des Checkpoints kann der Task beim Schritt „Analyse“ weiterlaufen – die bereits abgerufenen Daten müssen nicht erneut geholt werden.
Das Speichermedium entscheidet darüber, ob ein Checkpoint einen Neustart übersteht. Eine In-Memory-Implementierung eignet sich für Entwicklung und Tests, der Zustand geht beim Prozessneustart verloren; für lokale Persistenz lässt sich SQLite verwenden, für langfristig betriebene Dienste ist PostgreSQL die bessere Wahl. Checkpoints wachsen ständig weiter, daher braucht ein Produktivsystem zusätzlich eine Strategie zum Aufräumen alter Zustände.
3.2 Store: sich den Projektkontext merken
Der Store speichert Langzeitinformationen über Tasks und Sessions hinweg, zum Beispiel Nutzerpräferenzen, Projektkontext, frühere Entscheidungen und Wissen, das sich mehrere Tasks teilen. Im Beispiel gehören „Die Leserschaft des Berichts ist das Produktteam“, „Nur API-Preise und Funktionsupdates verfolgen“ und „Letzten Monat wurde entschieden, einen Wettbewerber mit eingestelltem Update nicht mehr zu beobachten“ allesamt in den Store. Legt man im nächsten Monat einen neuen Bericht-Task an, liest dieser diese Entscheidungen aus – der Nutzer muss sie nicht erneut mitteilen.
3.3 Aufgabenvergleich von Checkpointer und Store
| Dimension | Checkpointer | Store |
|---|---|---|
| Geltungsbereich | Ein einzelner Task-Thread | Mehrere Tasks, threadübergreifend |
| Gespeicherte Inhalte | Snapshot des Ausführungszustands | Langzeitinformationen und Fakten |
| Kernnutzen | Arbeit nach Unterbrechung fortsetzen | Projektkontext in neuen Tasks weiterführen |
| Beispielinhalte | „6 Preisseiten abgerufen, nächster Schritt: Analyse“ | „Die Leserschaft des Berichts ist das Produktteam“ |
| Lebenszyklus | Folgt dem Task-Zustand, kann nach Abschluss bereinigt werden | Bleibt gemäß Langzeitgedächtnis-Strategie erhalten und wird aktualisiert |
Beide haben klar getrennte Aufgaben, und keiner davon ist verzichtbar. Mit nur einem Checkpointer fühlt sich jeder neue Task an wie die Einarbeitung eines neuen Mitarbeiters; mit nur einem Store muss man nach jeder Unterbrechung wieder von vorn anfangen.
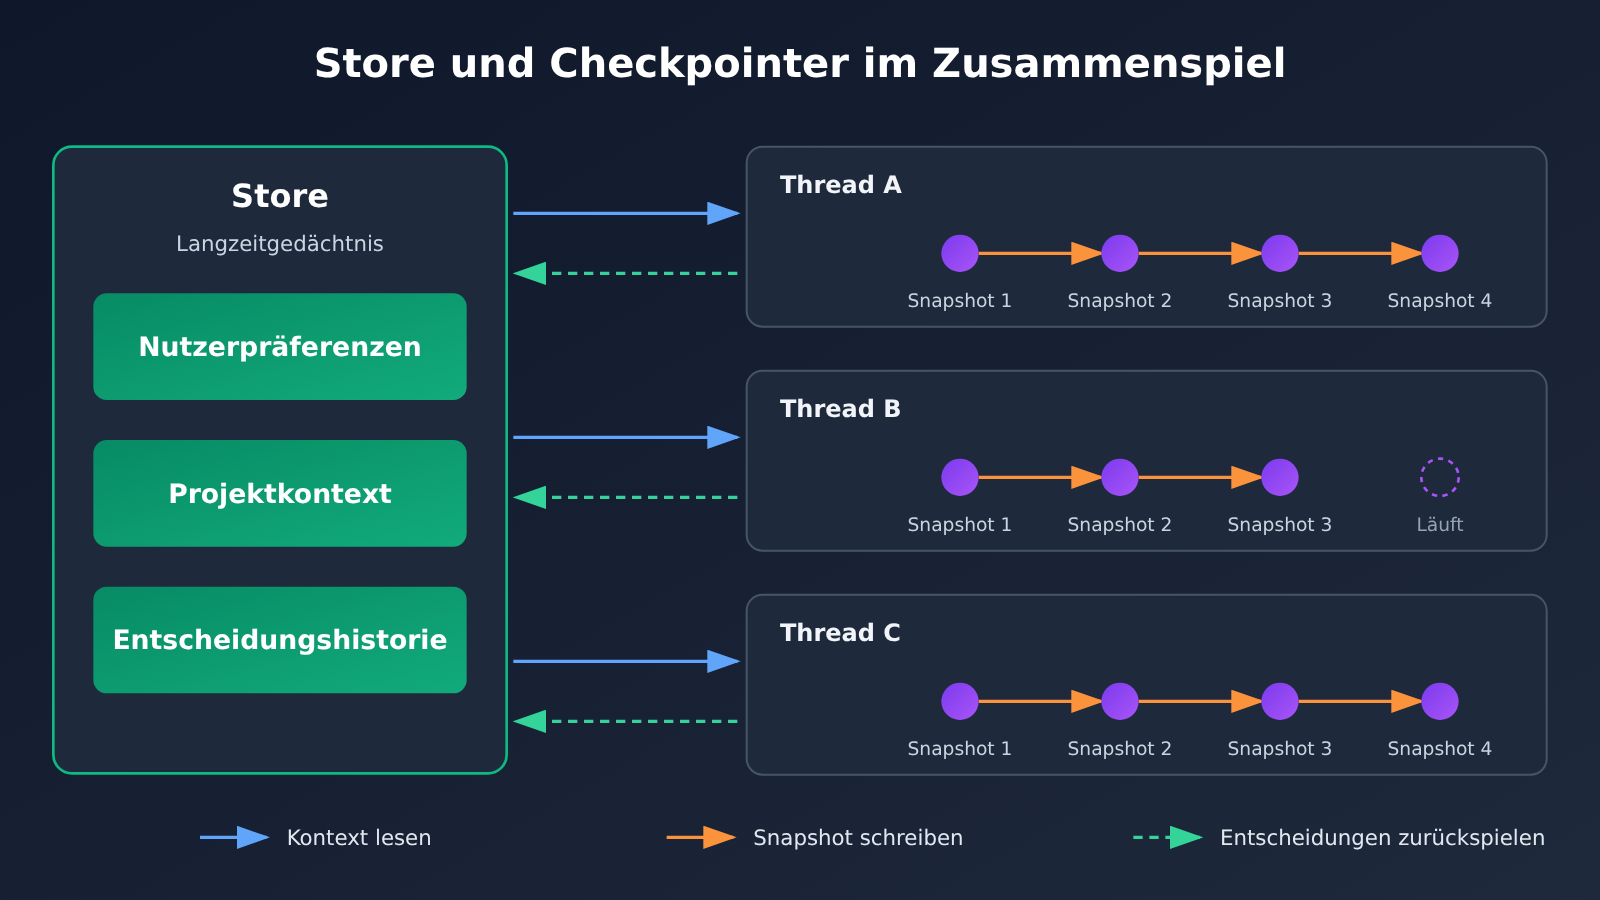
Der in der obigen Abbildung gezeigte Zyklus „Hintergrund lesen – Snapshot schreiben – Entscheidung zurückschreiben“ lässt sich direkt auf den Code in Abschnitt 6 abbilden. Der Beispielcode ruft das Modell über die OpenAI-kompatible Schnittstelle von APIYI apiyi.com auf; beim Modellwechsel muss lediglich der Modellname geändert werden.
4 Design eines Multi-Projekt-Task-Management-Systems: Workspace, Project, Task, Run
4.1 Vier-Ebenen-Struktur und unabhängige IDs
Für selbstgebaute Multi-Projekt-Agenten empfiehlt sich eine Vier-Ebenen-Struktur, bei der jede Ebene eine eigene ID besitzt:
| Ebene | Zweck | Beispiel |
|---|---|---|
| Workspace | Verwaltet den Arbeitsbereich und die Berechtigungen eines Nutzers | regulus |
| Project | Verwaltet Ziele und Materialien eines eigenständigen Projekts | AI Radar, Website, Research |
| Task | Verwaltet konkrete Aufgaben | Daily News, Monthly Report |
| Run | Protokolliert eine tatsächliche Ausführung | Ausführung von Daily News am 2026-11-16 um 09:00 |
Die zugehörige Baumstruktur sieht so aus:
Workspace: regulus
├── Project: AI Radar
│   ├── Task: Daily News
│   │   ├── Run: 2026-11-16
│   │   └── Run: 2026-11-17
│   └── Task: Topic Discovery
├── Project: Website
│   ├── Task: UI Improvement
│   └── Task: Bug Fix
└── Project: Research
    ├── Task: Competitor Analysis
    └── Task: Monthly Report
Die getrennte Aufzeichnung von Task und Run ist der entscheidende Punkt. Daily News läuft einmal täglich, und jeder Run hat seine eigenen Eingaben, Ausgaben, Laufzeiten und Status. Wenn etwas schiefgeht, lässt sich die Ursache genau auf eine bestimmte Ausführung an einem bestimmten Tag eingrenzen.
4.2 Zugriffsbereiche des Gedächtnisses und Projektisolierung
Wenn ein Agent mehrere Projekte verwaltet, dürfen die Dateien der einzelnen Projekte standardmäßig nicht gegenseitig lesbar sein. Es empfiehlt sich, die Zugriffsbereiche des Gedächtnisses nach Ebenen zu unterteilen:
- Allgemeine Nutzerpräferenzen (z. B. Berichte auf Chinesisch, Fazit zuerst): für alle autorisierten Projekte lesbar;
- Projektkontext (z. B. Zielgruppe und Beobachtungsumfang von Research): nur für die Aufgaben dieses Projekts lesbar;
- Aufzeichnungen einzelner Aufgaben: nur für die aktuelle Aufgabe und ausdrücklich autorisierte verwandte Aufgaben lesbar;
- Daten von Unternehmenskunden: nur für die jeweils freigegebenen Kundenprojekte lesbar;
- Sensible Zugangsdaten: in einem separaten sicheren Speicher ablegen, niemals in den Modellkontext übernehmen.
Wenn Materialien projektübergreifend geteilt werden, müssen Quelle und Autorisierungsumfang dokumentiert werden. Das deckt sich mit der Vorgehensweise von Dots: Laut offizieller Dokumentation speichert der Kontext von Dot keine Zugangsdaten, Bilder und Screenshots; die Berechtigungsgrenzen werden gemeinsam durch Plugin-Autorisierung und Custom Rules gesteuert.
5 Multi-Task-Scheduling: Wie Aufgaben parallel laufen, ohne sich gegenseitig zu stören
5.1 Scheduler und Agent-Inferenz trennen
Es empfiehlt sich, das „Wann“ und das „Wie“ auf zwei Komponenten zu verteilen. Der Scheduler kümmert sich um Startzeitpunkt, Projektauswahl, aktuelle Ausführungszahl, Priorität, Timeouts und Wiederholungsversuche; der Agent übernimmt das Verstehen der Aufgabe, das Festlegen der Schritte, die Auswahl der Werkzeuge, die Analyse der Ergebnisse und das Einreichen der Resultate. Auf diese Weise laufen die Scheduling-Regeln deterministisch, und das Modell befasst sich nur mit den Teilen, die tatsächlich Reasoning erfordern.
Für den technischen Aufbau bietet sich diese Kombination an: APScheduler für periodische Aufgaben, Celery als Hintergrund-Warteschlange, Redis für Nachrichten und kurzfristige Koordination, PostgreSQL für Projekt- und Ausführungsstatus sowie ein Framework wie LangGraph für Agent-Abläufe und persistente Zustände. Für kleine Prototypen reicht auch Pythons asyncio zusammen mit SQLite – der Code in Abschnitt 6 ist genau so aufgebaut.
5.2 Drei Arten der Parallelität
Ein Multi-Task-Agent kennt mindestens drei Formen der Parallelität:
- Unabhängige Aufgaben parallel: Die täglichen News von AI Radar und der Monatsbericht von Research hängen nicht voneinander ab und können gleichzeitig laufen;
- Teilaufgaben parallel: Ein Projekt wird in Teilaufgaben wie Materialsammlung und Faktenprüfung aufgeteilt, die getrennt voneinander bearbeitet werden;
- Modellrollen parallel: Verschiedene Modelle übernehmen unterschiedliche fachliche Aufgaben und werden am Ende zusammengeführt.
Die Einschränkungen, die darüber entscheiden, ob parallelisiert werden kann, sind API-Parallelitätslimits, Serverressourcen, Aufgabenabhängigkeiten, Konkurrenz beim Schreiben in die Datenbank, Modellkosten, Ergebniskonflikte und doppelte Ausführungen.
5.3 Beispiel: Materialsammlung, Datenanalyse, Berichtserstellung
Der Monatsbericht des Research-Projekts wird in drei Teilaufgaben aufgeteilt. Die Materialsammlung kann parallel zu den täglichen News von AI Radar laufen; die Datenanalyse hängt von den Ergebnissen der Materialsammlung ab und muss auf deren Abschluss warten; die Berichtserstellung hängt wiederum an den Analyseergebnissen und geht nach ihrem Abschluss in den Status „wartet auf Freigabe“ über – erst nach der Bestätigung durch den Nutzer gilt sie als geliefert.
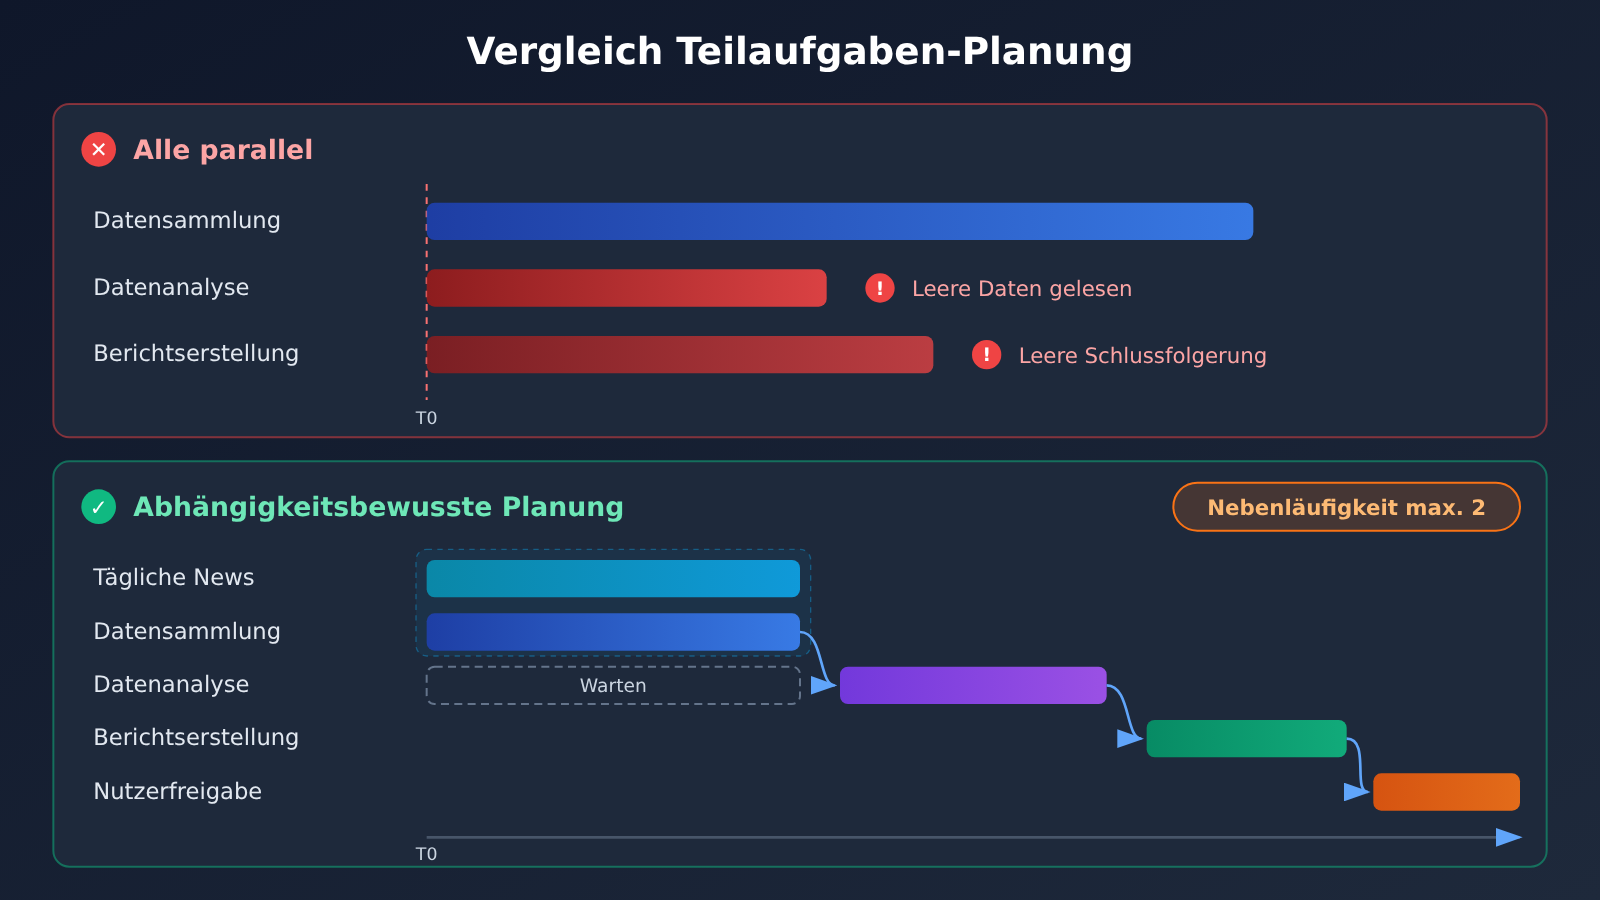
Alle drei Teilaufgaben gemeinsam zu starten wirkt schneller, doch die Datenanalyse kommt ohne Material zu leeren Schlussfolgerungen – und erfindet im schlimmsten Fall sogar Daten. Abhängigkeiten bestimmen, welche Aufgaben seriell laufen müssen, das Parallelitätslimit bestimmt, wie viele gleichzeitig laufen dürfen; beides gehört in den Scheduler. Überlässt man das dem Modell zur spontanen Entscheidung, geht das leicht schief.
5.4 Rollenverteilung der Modelle
| Teilaufgabe | Empfohlener Modelltyp | Begründung | Verfügbare Plattform |
|---|---|---|---|
| Materialsammlung und Zusammenfassung | Leichtes, schnelles Modell | Hohes Aufrufvolumen, kostenempfindlich | APIYI apiyi.com, offizielle API |
| Datenanalyse | Modell mit ausgeprägten Reasoning-Fähigkeiten | Erfordert mehrstufige Vergleiche und Berechnungen | APIYI apiyi.com, offizielle API |
| Berichtserstellung | Modell mit starker Textschreibfähigkeit | Hohe Anforderungen an Struktur und Ausdrucksqualität | APIYI apiyi.com, offizielle API |
| Faktenprüfung | Ein anderes Modell als das Schreibmodell | Kreuzvalidierung reduziert Fehler aus derselben Quelle | APIYI apiyi.com, offizielle API |
Welche Modelle konkret infrage kommen, richtet sich nach der aktuellen Modellliste der Plattform. Wenn ein Key mehrere Modelle anbindet, lässt sich die Rollenverteilung über die Konfiguration anpassen, ohne die Code-Struktur zu ändern.
6 Schnellstart: Mit einer einheitlichen Schnittstelle einen Multi-Task-Agent-Prototyp bauen
6.1 Minimalbeispiel: Aufgaben mit Projektkontext versehen
Der folgende Code zeigt den Kernpunkt: Vor der Ausführung einer Aufgabe wird aus dem Langzeitgedächtnis nur der Kontext des zugehörigen Projekts herausgeholt.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI-kompatible Schnittstelle
)

# Store: nach Projekt isolierter Langzeitkontext
project_memory = {
    "research": "读者:产品团队;只跟踪 API 价格与功能更新;报告结论先行",
    "ai-radar": "每日 09:00 汇总 OpenAI、Anthropic、Google 官方动态",
}

def run_task(project_id: str, goal: str) -> str:
    resp = client.chat.completions.create(
        model="gpt-4.1-mini",
        messages=[
            {"role": "system", "content": f"项目背景:{project_memory[project_id]}"},
            {"role": "user", "content": goal},
        ],
    )
    return resp.choices[0].message.content

print(run_task("research", "列出本月需要关注的竞品更新清单"))
6.2 Vollständiges Designkonzept: Zustandsmaschine, Checkpoints, Abhängigkeiten und Parallelität
Der folgende Code ist ein Designkonzept, das Store, Checkpoint, Zustandsmaschine, Abhängigkeitsplanung, Parallelitätsbegrenzung, Wiederholungsversuche, Timeouts und Ausführungsprotokolle abdeckt und zeigt, wie die einzelnen Komponenten zusammenarbeiten. Er wurde nicht in einer Produktionsumgebung verifiziert, und im Text werden auch keine fiktiven Laufzeitergebnisse angegeben.
Vollständigen Code des Designkonzepts anzeigen
Der folgende Code enthält die ins Deutsche übersetzten Kommentare und Docstrings; ausführbare Zeichenketten bleiben unverändert.
import asyncio, json, sqlite3, time, uuid
from dataclasses import dataclass, field
from enum import Enum
from openai import AsyncOpenAI

client = AsyncOpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche APIYI-Schnittstelle: ein Schlüssel für den Wechsel zwischen mehreren Modellen
)

class Status(str, Enum):
    PENDING = "pending"; RUNNING = "running"; WAITING = "waiting"
    APPROVAL = "approval"; COMPLETED = "completed"
    FAILED = "failed"; CANCELLED = "cancelled"; PAUSED = "paused"

db = sqlite3.connect("agent.db")
db.executescript("""
CREATE TABLE IF NOT EXISTS store(
  scope TEXT, key TEXT, value TEXT, source TEXT, PRIMARY KEY(scope, key));
CREATE TABLE IF NOT EXISTS checkpoint(
  run_id TEXT, task_id TEXT, step TEXT, state TEXT, ts REAL);
CREATE TABLE IF NOT EXISTS runs(
  run_id TEXT PRIMARY KEY, workspace_id TEXT, project_id TEXT, task_id TEXT,
  model_id TEXT, input_tokens INT, output_tokens INT,
  duration REAL, retry_count INT, final_status TEXT);
""")

def store_get(scopes: list[str]) -> str:
    """Liest nur die autorisierten Scopes: user und project:<id>"""
    marks = ",".join("?" * len(scopes))
    rows = db.execute(f"SELECT key, value FROM store WHERE scope IN ({marks})", scopes)
    return "\n".join(f"- {k}: {v}" for k, v in rows)

def save_checkpoint(run_id, task_id, step, state):
    db.execute("INSERT INTO checkpoint VALUES (?,?,?,?,?)",
               (run_id, task_id, step, json.dumps(state, ensure_ascii=False), time.time()))
    db.commit()

def log_run(run_id, task, usage, duration, retries, status):
    db.execute("INSERT OR REPLACE INTO runs VALUES (?,?,?,?,?,?,?,?,?,?)",
               (run_id, "regulus", task.project_id, task.task_id, task.model,
                getattr(usage, "prompt_tokens", 0), getattr(usage, "completion_tokens", 0),
                duration, retries, status.value))
    db.commit()

@dataclass
class Task:
    task_id: str
    project_id: str
    goal: str
    model: str
    depends_on: list[str] = field(default_factory=list)
    needs_approval: bool = False

async def run_task(task: Task, done: dict, sem: asyncio.Semaphore,
                   max_retry: int = 2, timeout: int = 120):
    run_id = f"run-{uuid.uuid4().hex[:8]}"
    background = store_get(["user", f"project:{task.project_id}"])
    upstream = "\n\n".join(done[d] for d in task.depends_on)
    messages = [
        {"role": "system", "content": f"长期背景:\n{background}"},
        {"role": "user", "content": f"{task.goal}\n\n上游结果:\n{upstream or '无'}"},
    ]
    async with sem:  # Nebenläufigkeitsbegrenzung
        for attempt in range(max_retry + 1):
            start = time.time()
            save_checkpoint(run_id, task.task_id, f"attempt-{attempt}", messages)
            try:
                resp = await asyncio.wait_for(
                    client.chat.completions.create(model=task.model, messages=messages),
                    timeout)
                output = resp.choices[0].message.content
                status = Status.APPROVAL if task.needs_approval else Status.COMPLETED
                log_run(run_id, task, resp.usage, time.time() - start, attempt, status)
                save_checkpoint(run_id, task.task_id, status.value, {"output": output})
                if status == Status.COMPLETED:
                    done[task.task_id] = output
                return
            except Exception as e:  # Timeout oder API-Fehler: Wiederholung nach exponentiellem Backoff
                save_checkpoint(run_id, task.task_id, "error", {"error": str(e)})
                await asyncio.sleep(2 ** attempt)
        log_run(run_id, task, None, 0, max_retry, Status.FAILED)

async def schedule(tasks: list[Task], max_concurrency: int = 2) -> dict:
    sem = asyncio.Semaphore(max_concurrency)
    done: dict[str, str] = {}
    pending = {t.task_id: t for t in tasks}
    while pending:
        ready = [t for t in pending.values() if all(d in done for d in t.depends_on)]
        if not ready:  # Vorgelagerte Aufgabe fehlgeschlagen, Genehmigung ausstehend oder zirkuläre Abhängigkeit
            print("阻塞任务:", list(pending))
            break
        await asyncio.gather(*(run_task(t, done, sem) for t in ready))
        for t in ready:
            pending.pop(t.task_id)
    return done

tasks = [
    Task("daily-news", "ai-radar", "汇总今日 AI 官方动态", "gpt-4.1-mini"),
    Task("collect", "research", "收集本月竞品 API 价格与功能变更", "gpt-4.1-mini"),
    Task("analyze", "research", "对比变更并归纳趋势", "gpt-4.1", depends_on=["collect"]),
    Task("report", "research", "生成月度竞品报告", "gpt-4.1",
         depends_on=["analyze"], needs_approval=True),
]
asyncio.run(schedule(tasks))
Der Code enthält mehrere Stellen, die dem zuvor beschriebenen Design entsprechen. store_get liest nur den user und den aktuellen Projektbereich und sorgt so für Projektisolierung; die checkpoint-Tabelle protokolliert jeden Schritt pro Run, zusammen mit der runs-Tabelle werden Token und Endzustand festgehalten; schedule entscheidet anhand der Abhängigkeiten über die serielle Reihenfolge und begrenzt die Parallelität mit einem Semaphore. Ein reales System muss zusätzlich Tool-Aufrufe, Freigabe-Callbacks und Wiederaufnahme-Einstiegspunkte ergänzen.
🚀 Schnellstart: In der Prototyp-Phase empfiehlt es sich, über APIYI apiyi.com ein kostenloses Testguthaben zu beziehen und mit demselben Key den drei Rollen Sammeln, Analysieren und Schreiben jeweils unterschiedliche Modelle zuzuweisen. Vergleichen Sie Wirkung und Kosten, bevor Sie die Aufgabenteilung festlegen.
7 Wie Multi-Task-Agenten Unterbrechungen, Fehler und manuelle Freigaben behandeln
7.1 Aufgaben-Zustandsmaschine
Der Aufgabenfortschritt sollte durch explizite Zustände festgehalten werden; was das Modell im Chat als Fortschritt beschreibt, dient nur als Referenz. Der empfohlene Hauptablauf ist Pending (ausstehend) → Running (in Ausführung) → Waiting (auf externe Bedingungen wartend) oder Approval (auf Freigabe wartend) → Completed (abgeschlossen), ergänzt um die drei Abschluss- bzw. Pausenzustände Failed, Cancelled und Paused. Jeder Zustandswechsel wird in die Datenbank geschrieben; der Scheduler trifft seine Entscheidungen ausschließlich anhand der in der Datenbank gespeicherten Zustände.
7.2 Wiederholung, Timeout und Pause/Wiederaufnahme
- Wiederholung (Retry): Bei API-Fehlern oder Timeouts mit exponentiellem Backoff erneut versuchen und
retry_countprotokollieren, um häufig fehlschlagende Schritte leichter zu erkennen; - Timeout: Für jeden Run ein Ausführungszeitlimit setzen; bei Überschreitung auf Failed umstellen und einen Alarm auslösen, damit ein festgefahrener Task nicht dauerhaft einen Parallelitäts-Slot blockiert;
- Pause und Wiederaufnahme: Beim Pausieren einen Checkpoint speichern und bei der Wiederaufnahme vom letzten Checkpoint aus fortsetzen; bereits abgeschlossene Tool-Aufrufe müssen nicht erneut ausgeführt werden;
- Idempotenz: Bei Schritten mit Nebenwirkungen wie E-Mail-Versand oder Datenbankschreibvorgängen vor dem Retry prüfen, ob sie bereits ausgeführt wurden, um Doppelausführungen zu vermeiden.
In der offiziellen Dokumentation von Dots gibt es ein relevantes Detail: Einen laufenden Task stoppen und einen bereits angelegten wiederkehrenden Plan abbrechen sind zwei verschiedene Dinge. Wenn man ein Dot pausiert, können unabhängige Work-, Codex- und geplante Aufgaben weiterhin laufen. Ein selbst gebautes System sollte „diesen Run stoppen“, „Task pausieren“ und „wiederkehrenden Plan abbrechen“ als drei getrennte Operationen gestalten.
7.3 Manuelle Freigabe: Dots‘ Custom Rules als Referenz
Dots teilt mit Custom Rules das Verhalten in vier Stufen ein: ohne Rückfrage direkt ausführen, nach vorheriger Autorisierung ausführen, vor der Ausführung nachfragen, an den Benutzer zurückgeben. Operationen wie das Ändern eines Passworts oder das Überweisen von Geldern müssen vom Benutzer übernommen werden; das dauerhafte Löschen von Daten oder das Installieren von Software kann eine Bestätigung für jeden einzelnen Vorgang erfordern. Selbst eine Benutzerfreigabe kann zentrale Sicherheitsbeschränkungen nicht außer Kraft setzen.
Ein selbst gebautes System kann Tools entsprechend kennzeichnen. Nur-Lese-Recherche wird direkt ausgeführt; nach dem Fertigstellen eines Berichtsentwurfs geht es in den Approval-Zustand; externes Versenden, Bezahlen und Löschen gehen grundsätzlich an den Menschen. Die Beispiel-Report-Aufgabe ist mit needs_approval=True konfiguriert; nach der Generierung verharrt sie im Approval-Zustand und wird erst nach der Bestätigung durch den Benutzer auf Completed gesetzt.
8 Ausführungs-Tracing und Logging für Multi-Task-Agenten
Wenn mehrere Projekte parallel laufen, ist die häufigste Frage der Nutzer: „Was hat er eigentlich gemacht?“ Das Tracing im OpenAI Agents SDK kann festhalten, welcher Agent aufgerufen wurde, welches Modell zum Einsatz kam, welche Tool-Aufrufe stattgefunden haben, wo ein Handoff erfolgt ist, welche Sicherheitsprüfungen ausgelöst wurden und wie die Aufgabe schließlich beendet wurde.
Tracing eignet sich gut dazu, einen einzelnen Ausführungsablauf nachzuvollziehen. Für Statistiken auf Projektebene braucht man zusätzlich Business-Logs. Empfehlenswert ist, bei jedem Run mindestens project_id, task_id, run_id, model_id, input_tokens, output_tokens, tool_calls, duration, retry_count und final_status zu protokollieren. Mit diesen Feldern lassen sich Managementfragen beantworten wie „Wie viele Token hat das Research-Projekt diesen Monat verbraucht?“, „Welcher Schritt wurde am häufigsten wiederholt?“ oder „Bei welchem Modell laufen Analyseaufgaben am häufigsten in ein Timeout?“ Die Tabelle runs in Abschnitt 6 ist die minimale Umsetzung dieses Feldsatzes.
9 Kosten und Managementgrenzen von Multi-Task-Agenten
9.1 Kostenstruktur von Dots
Stand 16. November 2026 können Privatnutzer Dots über die drei Abonnementstufen ChatGPT Pro 100, Pro 200 und Pro 500 nutzen; die Monatsgebühren betragen 100, 200 bzw. 500 US-Dollar. In den offiziellen Dots-Hinweisen für persönliche Pro-Abonnements ist keine separate monatliche Dot-Gebühr angegeben. Über Dot delegierte ChatGPT Work- oder Codex-Aufgaben werden nach den Kontingenten und Regeln des jeweiligen Produkts abgerechnet; der Verbrauch hängt von Modell, Kontext, Reasoning, Tool-Aufrufen und Retrieval ab. Für die Nutzung von Pro durch Privatpersonen gelten außerdem Altersbeschränkungen (ab 18 Jahren) und regionale Beschränkungen; der Europäische Wirtschaftsraum, das Vereinigte Königreich und die Schweiz sind ausgeschlossen.
Für Enterprise-Workspaces gilt eine andere Abrechnung. Die aktuellen offiziellen Dokumente besagen, dass berechtigte Enterprise-Workspaces zwischen einem festen Satz je Arbeitsart und einer nutzungsbasierten Abrechnung wählen können; die Vorschauphase ist kostenlos, ab 18. November 2026 wird für aktivierte Dots abgerechnet; Aufgaben, die an Work oder Codex delegiert werden, werden separat berechnet. Die konkreten Beträge richten sich nach dem für den jeweiligen Workspace tatsächlich geltenden Angebot.
9.2 Kostenquellen selbst entwickelter Systeme
Die Kosten für selbst entwickelte Multi-Task-Agenten stammen hauptsächlich aus vier Bereichen:
- Wiederholtes Einlesen von Kontext: In jede Aufgabe wird der Projektkontext injiziert. Je länger der Kontext, desto mehr Eingabe-Token fallen bei jedem Aufruf an; die Inhalte im Store müssen regelmäßig bereinigt werden.
- Wiederholungen und Fehler: Eine fehlgeschlagene Analyseaufgabe schickt die vorgelagerten Daten noch einmal durch das Modell.
- Modellauswahl: Wenn alle Teilaufgaben mit dem stärksten Modell laufen, steigen die Kosten deutlich.
- Parallelitätskontingent: Die Rate-Limits der API bestimmen, wie viele parallele Aufrufe tatsächlich möglich sind.
9.3 Parallelität und effektive Arbeit
Parallelität und effektive Arbeit sind zwei verschiedene Dinge. Aufgaben vorzeitig zu starten, deren Abhängigkeiten noch nicht erfüllt sind, produziert nur unbrauchbare Ergebnisse; widersprüchliche Schlussfolgerungen müssen manuell zusammengeführt werden; und wenn fehlerhafte Daten aus einem Projekt über das gemeinsame Gedächtnis in ein anderes Projekt gelangen, wird die Nacharbeit teurer. Sinnvoll ist es, zuerst Projektisolierung und korrekte Abhängigkeiten sicherzustellen und dann das Parallelitätslimit anhand der Monitoring-Daten schrittweise zu erhöhen.
10 Häufig gestellte Fragen (FAQ)
F1: Was ist das Multi-Task-Scheduling von Dots?
Ein Dot verwaltet gleichzeitig mehrere Verantwortungsbereiche. Nutzer können Aufgaben wechseln und Prioritäten anpassen; Dot zerlegt komplexe Arbeit und übergibt sie zur parallelen Bearbeitung an Hintergrund-Agenten, fasst die Ergebnisse zusammen und übergibt sie bei Entscheidungsbedarf wieder an den Nutzer.
F2: Merkt sich das Langzeitgedächtnis von Dots alle bisherigen Gespräche?
Nein, es wird nicht alles geladen. Neue Aufgaben haben ihren eigenen Gesprächskontext; Dot arbeitet mit ChatGPT Memory, eigenen Notizen, dem aktuellen Aufgabenkontext und Daten aus verbundenen Apps und ruft vergangene Gespräche bei Bedarf ab.
F3: Können Checkpointer und Store einander ersetzen?
Beide haben unterschiedliche Zuständigkeiten. Der Checkpointer speichert einen Ausführungs-Snapshot einer einzelnen Aufgabe zur Wiederaufnahme nach einer Unterbrechung; der Store speichert projektübergreifenden Projektkontext und Entscheidungen, damit neue Aufgaben den Kontext fortführen. Für langfristige Projekte braucht man beides.
F4: Wie viele Aufgaben kann Dots gleichzeitig parallel ausführen?
Offizielle Angaben nennen keine feste Parallelitätszahl. Dots unterstützt Parallelität, Ausführungsumgebung und Nutzungskontingent haben jedoch Grenzen. Ein Reddit-Nutzer berichtet, drei Ausführungsprozesse gleichzeitig laufen gesehen zu haben – das ist lediglich ein persönliches Testergebnis.
F5: Wie kann ein selbst gebauter Multi-Projekt-Agent schnell verschiedene Modelle aufrufen?
Man kann eine OpenAI-kompatible Aggregationsschnittstelle verwenden. Nach der Registrierung bei APIYI apiyi.com erhält man einen API Key und ein kostenloses Testkontingent; setzt man die `base_url` im Code dieses Artikels auf `https://api.apiyi.com/v1`, lassen sich mit demselben Code verschiedenen Unteraufgaben Modelle wie GPT, Claude, Gemini usw. zuweisen.
F6: Wie lassen sich die Modellkosten eines Multi-Task-Agenten kontrollieren?
Modelle nach Rolle zuweisen: leichte Modelle für die Materialsammlung, stärkere Modelle für Analyse und Schreiben; den Projektkontext im Store straffen; mit der `runs`-Tabelle die Token pro Projekt zählen. Über APIYI apiyi.com wird nach Verbrauch abgerechnet, sodass man zunächst klein testen und dann das Kontingent festlegen kann.
F7: Worauf sollte man bei Dots und selbst gebauten Systemen in puncto Sicherheit achten?
Agenten können Aufgaben missverstehen, Materialien falsch einschätzen oder Opfer einer Prompt Injection werden; offiziell heißt es auch, dass bestehende Schutzmaßnahmen nicht alle Risiken beseitigen können. Bei Vorgängen rund um Konten, Geld oder das Senden nach außen sollte eine manuelle Freigabe vorgeschaltet werden; sensible Zugangsdaten gehören nicht in den Modellkontext.
11 Dots: Multitasking-Scheduling und Langzeitgedächtnis – die wichtigsten Erkenntnisse
- Der Kern der Herausforderung: Bei Multi-Task-Agenten kommt es auf unabhängige Kontexte, persistente Zustände, Scheduling und Wiederaufnahme an.
- Der Dots-Mechanismus: Ein Dot koordiniert mehrere Vorgänge, Hintergrund-Agenten führen parallel aus, und die Kontexte neuer Aufgaben sind voneinander unabhängig.
- Zwei Arten von Gedächtnis: Der Checkpointer ist für die Wiederaufnahme der Ausführung zuständig, der Store für die Fortführung des Projektkontexts.
- Vier Ebenen: Workspace, Project, Task und Run haben jeweils eigene IDs, Projekte sind voneinander isoliert.
- Scheduling-Prinzipien: Abhängigkeiten entscheiden über die Serialisierung, das Nebenläufigkeitslimit über den Umfang – die Regeln gehören in den Scheduler.
- Nachvollziehbarkeit: Jeder Run protokolliert Modell, Token, Laufzeit, Anzahl der Wiederholungsversuche und Endzustand.
- Einstieg: Über die einheitliche Schnittstelle von APIYI apiyi.com lassen sich verschiedenen Teilaufgaben unterschiedliche Modelle zuweisen.
12 Fazit
Dots zeigt eine Produktform, in der ein persönlicher Agent mehrere langfristige Projekte verwaltet: dauerhaft im Betrieb, Aufgabenkontexte unabhängig voneinander, Gedächtnis in Ebenen gespeichert, Hintergrund-Agenten parallel ausgeführt, risikoreiche Operationen zurück an den Nutzer gegeben. Seine Fähigkeit, mit mehreren Projekten umzugehen, baut auf Zustandsverwaltung auf – allein durch eine höhere Parallelität ist das nicht zu erreichen.
Beim Nachbau eines ähnlichen Systems kann man in der Reihenfolge dieses Artikels vorgehen: Zuerst mit der Vier-Ebenen-Struktur und der Scope-Aufteilung die Projektisolierung umsetzen, dann mit Store und Checkpointer getrennt das „Sich an den Hintergrund erinnern“ und das „Wiederaufnehmen können“ lösen, danach mit dem Scheduler Abhängigkeiten und Nebenläufigkeit verwalten und schließlich mit Zustandsmaschine, Freigaben und Ausführungslogs jeden Schritt kontrollierbar und nachprüfbar machen. In der Prototypenphase empfiehlt es sich, über APIYI apiyi.com schnell zu prüfen, wie sich verschiedene Modelle in den einzelnen Rollen schlagen, und dann anhand der Logdaten die Aufgabenverteilung und die Nebenläufigkeit anzupassen.
Referenzen
- OpenAI: Introducing dots: Produktankündigung
- Link:
openai.com/index/introducing-dots - Beschreibung: Produktpositionierung, Cloud-Computer und Ausführung mehrerer Projekte
- ChatGPT Learn: Tasks and memory: Dokumentation zu Dots-Aufgaben und -Gedächtnis
- Link:
learn.chatgpt.com/docs/dots/tasks-and-memory - Beschreibung: Hintergrund-Agent, unabhängiger Kontext pro Aufgabe, proaktive Recherche
- OpenAI Help Center: Dots privacy, security, and safety FAQs: Hinweise zu Datenschutz und Sicherheit
- Link:
help.openai.com/en/articles/20001529-dots-privacy-security-and-safety-faqs - Beschreibung: Berechtigungen, Genehmigungen, Löschen von Erinnerungen und Datenaufbewahrung
- ChatGPT Learn: Dots admin guide: Verwaltung und Abrechnung in der Enterprise-Version
- Link:
learn.chatgpt.com/docs/enterprise/dots-admin-guide - Beschreibung: Abrechnungsmodell für Enterprise-Arbeitsbereiche und Datum des Abrechnungsstarts
- About ChatGPT Pro tiers: Erläuterung der Pro-Abonnementstufen
- Link:
help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers - Beschreibung: Preise und Kontingentregeln für Pro 100, 200 und 500
- LangGraph Persistence-Dokumentation: Checkpointer und Store
- Link:
github.com/langchain-ai/docs/blob/main/src/oss/langgraph/persistence.mdx - Beschreibung: Abgrenzung zwischen kurzfristigem Ausführungsstatus und langfristigem Gedächtnis
- OpenAI Agents SDK: Tracing und Workflows
- Link:
developers.openai.com/api/docs/guides/agents/sdk - Beschreibung: Nachverfolgung und Debugging des Agent-Ausführungsprozesses
Autor: APIYI-Team
Fachlicher Austausch: Sie erreichen uns gerne über die Startseite von APIYI auf apiyi.com; weitere Integrationsunterlagen finden Sie im Dokumentationszentrum unter docs.apiyi.com


