
Nota do autor: agentes multiprojeto precisam de contexto independente, estado persistente, agendamento de tarefas e mecanismos de recuperação. Só com trabalho paralelo é possível manter tudo rastreável e sem interferência entre as partes.
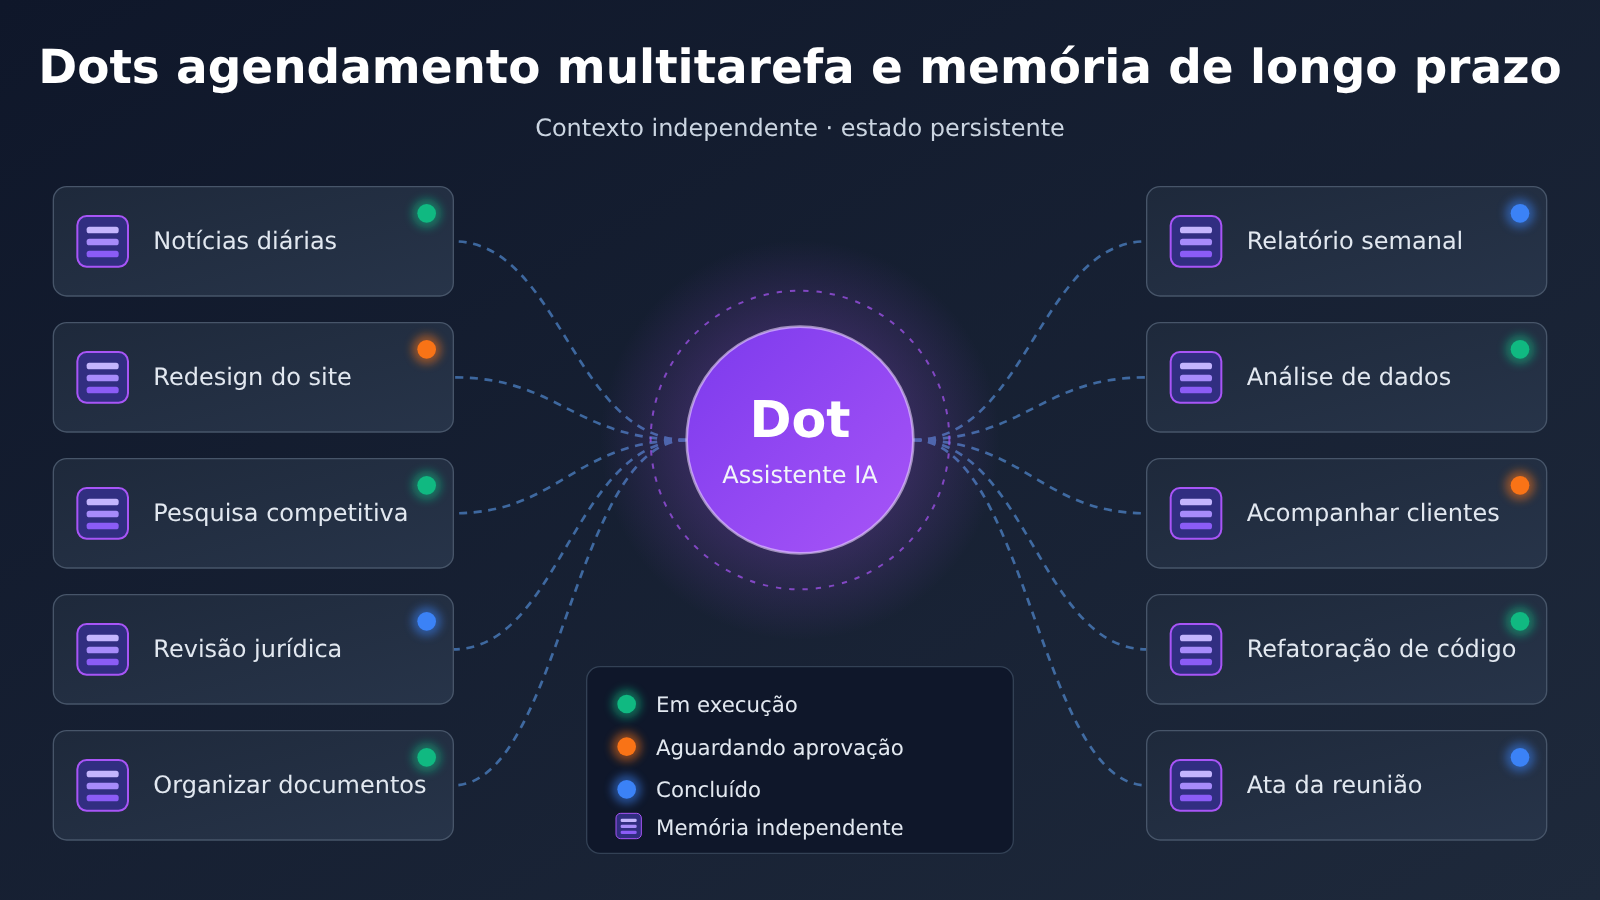
Um assistente de IA consegue tocar vários projetos ao mesmo tempo? O ponto central está em quatro coisas: cada trabalho tem contexto próprio, o estado de execução é persistido, um agendador organiza prioridades e concorrência de forma centralizada e, após uma interrupção, é possível retomar a partir de um ponto de verificação. Chamar vários modelos ao mesmo tempo não é difícil; o difícil é fazer cada uma dessas chamadas lembrar o que está fazendo. O Dots, lançado pela OpenAI em 29 de setembro de 2026, adota esse modelo. A documentação oficial explica que um Dot pode manter vários itens de responsabilidade e distribuir o trabalho entre agentes em segundo plano para processamento paralelo. Cada nova tarefa tem seu próprio contexto de conversa e não recebe automaticamente todo o histórico de diálogo entre o usuário e o Dot. Desenvolvedores podem usar Checkpointer, Store, filas de tarefas e máquinas de estado para montar um sistema semelhante de gestão de múltiplos projetos.
A seguir, com base nos materiais oficiais, vamos destrinchar os mecanismos de multitarefa e memória do Dots. Depois, com um exemplo de gestão de projetos que atravessa o texto inteiro, vamos projetar em sequência uma estrutura de tarefas em quatro camadas, o agendamento paralelo, a recuperação após interrupção, o rastreamento de execução e os limites de custo. O “dez projetos” do título é só uma forma ilustrativa de descrever o padrão de trabalho; nem o Dots nem um sistema construído por conta própria têm concorrência fixa de dez vias, e também não dá para paralelizar sem limite. O código do agente próprio mostrado no artigo é uma proposta de design e não traz resultados de execução inventados.
Para saber: terminologia relacionada ao agendamento de múltiplas tarefas do Dots
| Termo | Explicação |
|---|---|
| Workspace | Espaço de trabalho que organiza projetos e permissões, geralmente correspondendo a um usuário ou a uma equipe. |
| Project | Unidade de projeto que contém objetivos, materiais e tarefas relacionadas. |
| Task | Uma tarefa com objetivo claro, por exemplo “pesquisar as notícias de hoje sobre a OpenAI”. |
| Run | Registro de uma execução real de uma tarefa; uma mesma Task pode ser executada muitas vezes. |
| Agente em segundo plano | Executor que o Dot envia para tratar subtarefas em paralelo e que, ao terminar, reporta ao Dot. |
| Checkpointer | Componente que salva os checkpoints da execução de uma tarefa e é responsável por retomar após uma interrupção. |
| Store | Componente de armazenamento que guarda informações de longo prazo entre tarefas e é responsável por dar continuidade ao contexto do projeto. |
| Máquina de estados | Mecanismo que gerencia, segundo regras, as transições entre as fases de uma tarefa, como aguardando execução, em execução e aguardando aprovação. |
| Limite de concorrência | Número máximo de tarefas executadas simultaneamente, sujeito à cota da API, aos recursos do servidor e ao custo. |
| Tracing | Capacidade de rastreamento que registra invocações do modelo, chamadas de ferramentas e o processo de transferência de controle. |
| Pesquisa proativa | Pesquisa de fundo somente leitura que o Dots realiza em fontes de dados autorizadas quando não há novas mensagens. |
1 Orquestração multitarefa do Dots: por que um único Dot consegue assumir várias responsabilidades
1.1 As capacidades multiprojeto que o Dots divulga oficialmente
Segundo o posicionamento oficial, o Dots é um agente pessoal residente. Ele tem seu próprio computador na nuvem e um navegador, e continua avançando no trabalho delegado mesmo depois que o usuário sai. No campo da multitarefa, a documentação Tasks and memory lista as seguintes capacidades:
- manter o estado de vários itens de trabalho ao mesmo tempo e alternar entre tarefas na mesma conversa;
- o usuário pode acrescentar informações e ajustar prioridades a qualquer momento;
- dividir uma tarefa complexa em várias partes e entregá-las a agentes em segundo plano para processamento paralelo;
- criar threads de tarefa visíveis e independentes, depois coletar os resultados de cada tarefa e consolidá-los;
- pedir a intervenção do usuário quando o trabalho fica bloqueado; enquanto as tarefas em segundo plano rodam, o usuário ainda pode continuar enviando mensagens.
Somadas, essas capacidades fazem o papel do Dot se aproximar mais de um coordenador de projeto. Ele decide o que fazer primeiro, o que desmembrar e o que devolver ao usuário; a execução concreta de cada tarefa individual pode ficar a cargo de agentes em segundo plano, de tarefas do ChatGPT Work ou de tarefas do Codex.
1.2 A diferença entre múltiplas conversas, multitarefa e múltiplos agentes
Esses três conceitos são frequentemente confundidos, mas cada um resolve um problema diferente. Para usar um exemplo único: imagine que o espaço de trabalho do usuário tenha três projetos — AI Radar (um boletim diário de notícias de IA), Website (redesign do site) e Research (pesquisa de concorrentes).
| Modo | Como funciona | No exemplo | Problema que resolve |
|---|---|---|---|
| Múltiplas conversas | O usuário abre uma janela de chat para cada projeto | O próprio usuário lembra até onde o Research chegou | Isola o conteúdo das conversas; o progresso continua sendo gerenciado pela pessoa |
| Multitarefa | Um coordenador mantém o estado de várias tarefas | O Dot registra o progresso e a prioridade de cada um dos três projetos | Agendamento unificado e rastreamento de estado |
| Múltiplos agentes | O coordenador distribui subtarefas para vários executores | Um agente em segundo plano coleta materiais e outro executor escreve o relatório | Execução paralela e divisão especializada do trabalho |
O Dots empilha as três coisas: o usuário conversa com o Dot em um único ponto de entrada, o Dot mantém várias tarefas e despacha agentes em segundo plano conforme a necessidade. Para reproduzir esse efeito em um sistema próprio, é preciso implementar as três camadas — abrir vários chats, sozinho, está longe de ser suficiente.
1.3 O paralelismo observado e relatado por um usuário
Um usuário no Reddit relatou um teste que fez ao longo de um dia. Ele entregou ao Dot centenas de PDFs e milhares de páginas de documentos para revisão, enquanto rodava uma tarefa de pesquisa jurídica. Ele observou três processos de execução simultâneos: o computador na nuvem do próprio Dot cuidava da tarefa A, um computador Linux ao qual ele se conectou cuidava da tarefa B, e outro agente de pesquisa em segundo plano cuidava da tarefa C. Ele também mencionou que, ao iniciar uma tarefa independente de pesquisa jurídica, esbarrou em um ambiente de execução indisponível, e só conseguiu despachar a tarefa depois de conectar o computador local.
Essa observação pessoal mostra que o computador na nuvem do Dot, o computador local e os ambientes Work/Codex são recursos de execução diferentes. O próprio autor também observa que não verificou se esses caminhos têm cotas independentes e ilimitadas. Portanto, esse teste só demonstra que o Dots consegue despachar trabalho para ambientes diferentes; não é possível concluir a partir dele que todo usuário Pro terá o mesmo nível de paralelismo.
2 Memória de longo prazo do Dots: por que uma tarefa precisa de memória própria
2.1 Os limites de contexto de uma nova tarefa
A documentação oficial é clara: cada nova tarefa tem seu próprio contexto de conversa e não recebe automaticamente todo o histórico de diálogo entre o Dot e o usuário. O Dot pode buscar conversas antigas do ChatGPT para encontrar contexto, mas o que ele encontra serve apenas como contexto para o trabalho atual.
Esse design é bem prático. Se toda tarefa carregasse todo o histórico, o relatório de concorrentes do projeto Research poderia se misturar com as discussões sobre o redesign do projeto Website, e o contexto ficaria cada vez mais longo e mais caro. Projetos de longo prazo exigem gerenciar explicitamente “o que esta tarefa precisa saber”, e isso não dá para resolver só com um registro de chat que cresce sem parar.
2.2 As quatro camadas de dados da memória do Dots
De acordo com os materiais oficiais, o contexto do Dot vem de quatro fontes diferentes:
- ChatGPT Memory: o Dot pode ler as memórias relevantes e as conversas recentes do ChatGPT;
- As próprias notas do Dot: acumulam preferências do usuário, hábitos de trabalho, decisões de projeto e compromissos de longo prazo;
- O contexto da tarefa atual: instruções, arquivos, resultados de busca e resultados de execução de ferramentas desta conversa;
- Dados de aplicativos conectados: o Dot lê dados de apps já autorizados e pode formar memória por meio de pesquisa ativa.
O ciclo de vida dessas camadas é bem diferente entre si. O ChatGPT Memory e as notas do Dot pertencem a camadas de dados distintas: desativar o compartilhamento do ChatGPT Memory não apaga automaticamente as informações que o Dot já obteve, e desconectar um plugin apenas interrompe novos acessos. Até 16 de novembro de 2026, o usuário ainda não consegue ver, editar ou excluir item por item a memória independente do Dot; excluir o Dot inicia a exclusão do seu próprio contexto. Ao projetar a camada de memória de um sistema próprio, dá para se inspirar nessa abordagem em camadas e, ao mesmo tempo, acrescentar uma interface de administração em que seja possível visualizar e excluir os dados.
3 Checkpointer e Store: as duas memórias de um Agent multitarefa
A documentação de persistência do LangGraph divide a memória do Agent em duas categorias, e essa divisão corresponde justamente ao “contexto da tarefa” e às “notas de longo prazo” do Dots. A seguir, continuamos usando como exemplo o relatório mensal de concorrência do projeto Research.
3.1 Checkpointer: lembrar até que passo o trabalho chegou
O Checkpointer guarda um snapshot da execução de uma única thread de tarefa, incluindo o passo atual, as ferramentas já chamadas, os resultados retornados por elas e qual passo está aguardando aprovação humana. No exemplo, a tarefa do relatório mensal já tinha terminado de raspar as páginas de preços de 6 concorrentes e estava prestes a iniciar a análise quando o serviço reiniciou. Com o checkpoint, a tarefa pode continuar a partir do passo de “análise”, sem precisar raspar de novo os dados já coletados.
O meio de armazenamento determina se o checkpoint sobrevive ao reinício. Implementações em memória servem para desenvolvimento e testes, mas o estado se perde quando o processo reinicia; para persistência local dá para usar SQLite, e serviços de implantação de longo prazo se dão melhor com PostgreSQL. Os checkpoints crescem continuamente, então sistemas em produção também precisam definir uma política de limpeza dos estados antigos.
3.2 Store: lembrar o contexto do projeto
O Store guarda informações de longo prazo que atravessam tarefas e sessões, como preferências do usuário, contexto do projeto, decisões históricas e conhecimento compartilhado entre várias tarefas. No exemplo, “os leitores do relatório são o time de produto”, “acompanhar apenas preços e atualizações de funcionalidades das APIs” e “no mês passado decidimos parar de acompanhar um concorrente que não atualiza mais” são todos conteúdos do Store. Quando um novo relatório for criado no mês seguinte, ele lerá essas decisões, e o usuário não precisará explicar tudo de novo.
3.3 Comparação de responsabilidades entre Checkpointer e Store
| Dimensão | Checkpointer | Store |
|---|---|---|
| Escopo | Uma única thread de tarefa | Múltiplas tarefas, entre threads |
| Conteúdo armazenado | Snapshot do estado de execução | Informações e fatos de longo prazo |
| Valor central | Retomar o trabalho após uma interrupção | Dar continuidade ao contexto do projeto em novas tarefas |
| Exemplo de conteúdo | “6 páginas de preços coletadas, próximo passo é analisar” | “Os leitores do relatório são o time de produto” |
| Ciclo de vida | Acompanha o estado da tarefa e pode ser limpo após a conclusão | Retido e atualizado conforme a política de memória de longo prazo |
Os dois têm papéis bem definidos e nenhum pode faltar. Só com o Checkpointer, cada nova tarefa é como contratar um funcionário novo; só com o Store, toda interrupção obriga a recomeçar do zero.
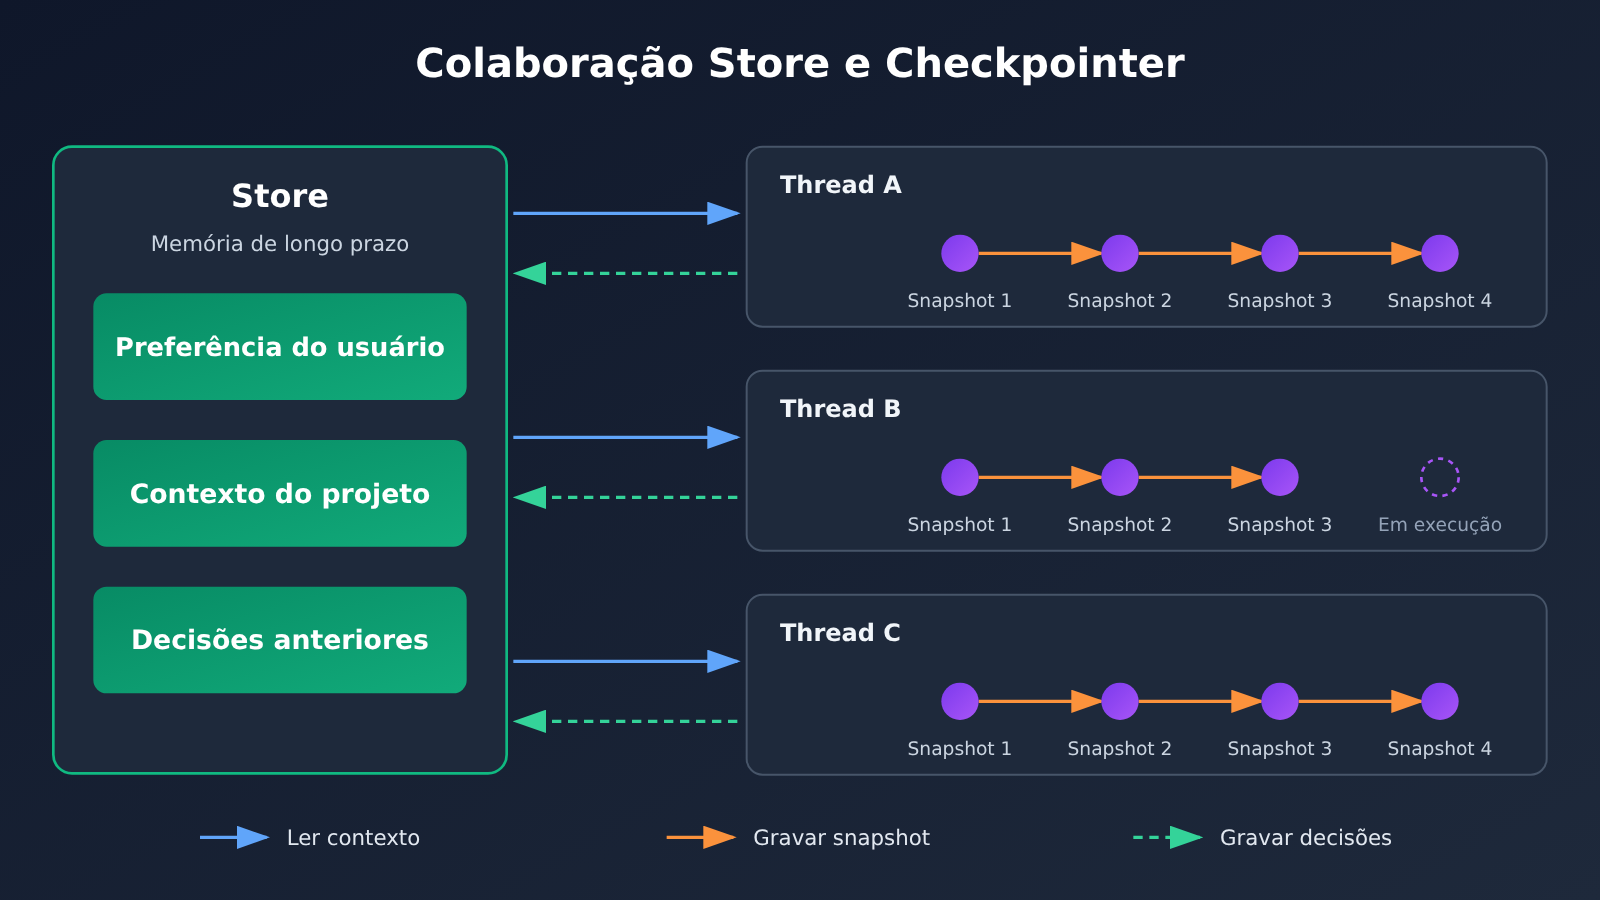
O ciclo “ler o contexto — gravar snapshot — escrever as decisões de volta” mostrado na imagem acima pode ser mapeado diretamente para o código da seção 6. O código de exemplo chama o modelo pela interface compatível com OpenAI do APIYI apiyi.com; para trocar de modelo, basta alterar o nome do modelo.
4 Design de sistema de gerenciamento de tarefas multiprojeto: Workspace, Project, Task e Run
4.1 Estrutura de quatro níveis e IDs independentes
Para um Agent multiprojeto desenvolvido internamente, recomenda-se usar uma estrutura de quatro níveis, com um ID independente em cada nível:
| Nível | Função | Exemplo |
|---|---|---|
| Workspace | Gerencia o workspace e as permissões de um usuário | regulus |
| Project | Gerencia os objetivos e materiais de projetos independentes | AI Radar, Website, Research |
| Task | Gerencia tarefas específicas | Daily News, Monthly Report |
| Run | Registra uma execução real | Execução do Daily News em 2026-11-16 09:00 |
A estrutura em árvore correspondente é a seguinte:
Workspace: regulus
├── Project: AI Radar
│   ├── Task: Daily News
│   │   ├── Run: 2026-11-16
│   │   └── Run: 2026-11-17
│   └── Task: Topic Discovery
├── Project: Website
│   ├── Task: UI Improvement
│   └── Task: Bug Fix
└── Project: Research
    ├── Task: Competitor Analysis
    └── Task: Monthly Report
Registrar Task e Run separadamente é fundamental. O Daily News é executado uma vez por dia. Cada Run tem suas próprias entradas, saídas, duração e status; se algo der errado, dá para identificar exatamente qual execução de qual dia.
4.2 Escopo de acesso à memória e isolamento de projetos
Quando um Agent gerencia vários projetos, por padrão os arquivos de cada projeto não podem ser lidos uns pelos outros. Recomenda-se dividir o escopo de acesso à memória por nível:
- Preferências gerais do usuário (por exemplo, relatórios em chinês, conclusão no início): todos os projetos autorizados podem acessar;
- Contexto do projeto (por exemplo, os leitores e o escopo de acompanhamento do Research): somente as tarefas desse projeto podem acessar;
- Registro de uma única tarefa: somente a tarefa atual e tarefas relacionadas com autorização explícita podem acessar;
- Dados de clientes corporativos: somente os projetos de clientes especificados podem acessar;
- Credenciais sensíveis: ficam em um armazenamento seguro separado e nunca entram no contexto do modelo.
Ao compartilhar materiais entre projetos, registre a origem e o escopo de autorização. Isso está alinhado com a abordagem do Dots: a documentação oficial afirma que o contexto do Dot não retém credenciais, imagens e capturas de tela, e os limites de permissão são controlados em conjunto pela autorização de plugins e pelas Custom Rules.
5 Orquestração de múltiplas tarefas: como rodar tarefas em paralelo sem que elas interfiram entre si
5.1 Separar o agendador da inferência do Agent
A recomendação é dividir o “quando fazer” e o “como fazer” entre dois componentes. O agendador cuida do momento de disparo, da seleção de projetos, do número de execuções ativas, da prioridade, dos timeouts e das retentativas; o Agent cuida de entender a tarefa, montar o passo a passo, escolher ferramentas, analisar os resultados e entregar o que foi produzido. Assim, as regras de agendamento rodam de forma determinística e o modelo fica responsável apenas pela parte que realmente exige raciocínio.
Como stack de referência, vale considerar esta combinação: APScheduler para gerenciar tarefas periódicas, Celery como fila de tarefas em background, Redis para mensagens e coordenação de curto prazo, PostgreSQL para guardar projetos e estados de execução, e um framework como LangGraph para gerenciar o fluxo do Agent e o estado persistido. Para um protótipo de pequeno porte, dá para rodar tudo com asyncio do Python mais SQLite — o código da seção 6 foi desenhado exatamente assim.
5.2 Três formas de paralelismo
Um Agent com múltiplas tarefas tem pelo menos três tipos de paralelismo:
- Tarefas independentes em paralelo: as notícias diárias do AI Radar e o relatório mensal do Research não dependem um do outro, então podem rodar ao mesmo tempo;
- Subtarefas em paralelo: um projeto é dividido em subtarefas como coleta de material e checagem de fatos, que avançam em frentes separadas;
- Papéis de modelo em paralelo: modelos diferentes cuidam de trabalhos especializados distintos, e no final tudo é consolidado.
As restrições que definem se é possível paralelizar incluem cota de concorrência da API, recursos de servidor, dependências entre tarefas, disputa por escrita no banco, custo de modelo, conflito de resultados e execução duplicada.
5.3 Exemplo: coleta de material, análise de dados e geração de relatório
O relatório mensal do projeto Research é dividido em três subtarefas. A coleta de material pode rodar em paralelo com as notícias diárias do AI Radar; a análise de dados depende do resultado da coleta, então precisa esperar ela terminar; a geração do relatório depende das conclusões da análise e, ao terminar, entra em estado de espera por aprovação — só é considerada entregue depois que o usuário confirma.
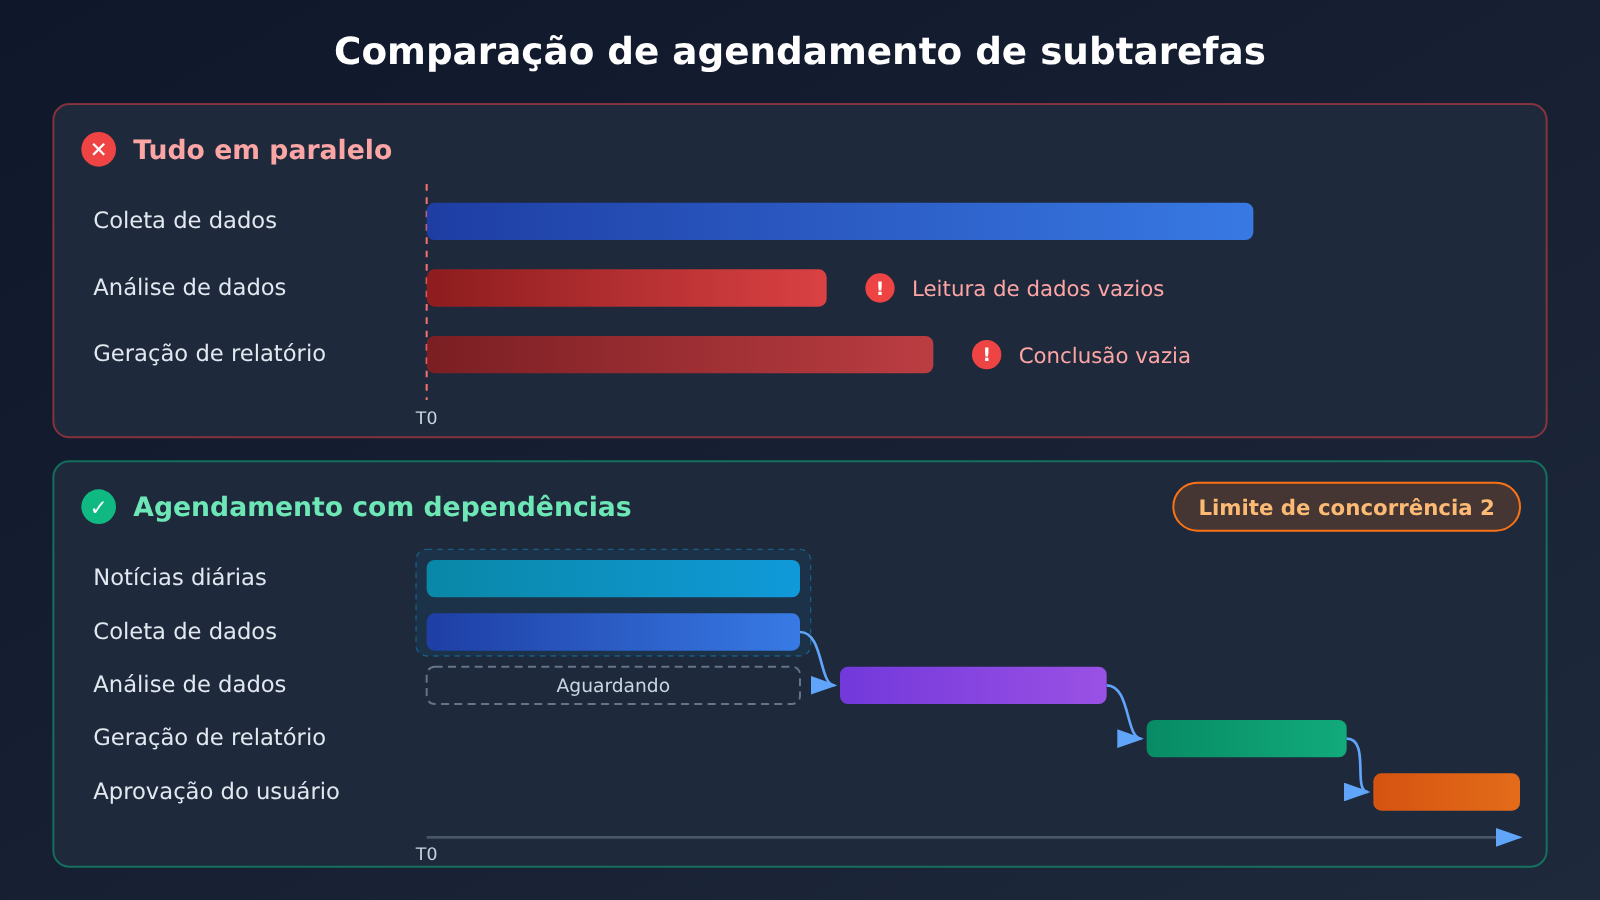
Disparar as três subtarefas juntas parece mais rápido, mas a análise de dados acaba gerando conclusões vazias por não ter material — ou pior, inventando dados por conta própria. As dependências definem quais tarefas precisam ser sequenciais, e o limite de concorrência define quantas podem rodar ao mesmo tempo; os dois precisam estar no agendador, porque deixar isso para o modelo julgar no calor do momento dá erro com facilidade.
5.4 Divisão de papéis entre modelos
| Subtarefa | Tipo de modelo recomendado | Motivo da escolha | Plataforma disponível |
|---|---|---|---|
| Coleta de material e resumo | Modelo leve e rápido | Volume alto de chamadas, sensível a custo | APIYI apiyi.com, API oficial |
| Análise de dados | Modelo com forte capacidade de raciocínio | Exige comparações e cálculos em várias etapas | APIYI apiyi.com, API oficial |
| Geração de relatório | Modelo com boa capacidade de redigir textos longos | Requer alta qualidade de estrutura e expressão | APIYI apiyi.com, API oficial |
| Checagem de fatos | Modelo diferente do modelo de redação | Validação cruzada, reduz erros de mesma origem | APIYI apiyi.com, API oficial |
Os modelos concretos devem seguir a lista atual de modelos da plataforma. Quando uma única chave API atende vários modelos, a divisão de papéis pode ser ajustada por configuração, sem mexer na estrutura do código.
6 Início rápido: monte um protótipo de Agent multitarefa com uma interface unificada
6.1 Exemplo mínimo: injetar o contexto do projeto na tarefa
O código abaixo demonstra o ponto mais central: antes da execução da tarefa, recuperar da memória de longo prazo apenas o contexto do projeto ao qual ela pertence.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI da APIYI
)

# Store: contexto de longo prazo isolado por projeto
project_memory = {
    "research": "读者:产品团队;只跟踪 API 价格与功能更新;报告结论先行",
    "ai-radar": "每日 09:00 汇总 OpenAI、Anthropic、Google 官方动态",
}

def run_task(project_id: str, goal: str) -> str:
    resp = client.chat.completions.create(
        model="gpt-4.1-mini",
        messages=[
            {"role": "system", "content": f"项目背景:{project_memory[project_id]}"},
            {"role": "user", "content": goal},
        ],
    )
    return resp.choices[0].message.content

print(run_task("research", "列出本月需要关注的竞品更新清单"))
6.2 Solução completa: máquina de estados, checkpoints, dependências e concorrência
O código a seguir é uma proposta de solução que abrange Store, Checkpoint, máquina de estados, agendamento de dependências, limites de concorrência, retentativas, timeouts e registro de execução, para mostrar como os componentes colaboram. Ele não foi validado em ambiente de produção, e o texto também não apresenta resultados de execução inventados.
Ver o código completo da solução
import asyncio, json, sqlite3, time, uuid
from dataclasses import dataclass, field
from enum import Enum
from openai import AsyncOpenAI

client = AsyncOpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada da APIYI: uma chave para alternar entre vários modelos
)

class Status(str, Enum):
    PENDING = "pending"; RUNNING = "running"; WAITING = "waiting"
    APPROVAL = "approval"; COMPLETED = "completed"
    FAILED = "failed"; CANCELLED = "cancelled"; PAUSED = "paused"

db = sqlite3.connect("agent.db")
db.executescript("""
CREATE TABLE IF NOT EXISTS store(
  scope TEXT, key TEXT, value TEXT, source TEXT, PRIMARY KEY(scope, key));
CREATE TABLE IF NOT EXISTS checkpoint(
  run_id TEXT, task_id TEXT, step TEXT, state TEXT, ts REAL);
CREATE TABLE IF NOT EXISTS runs(
  run_id TEXT PRIMARY KEY, workspace_id TEXT, project_id TEXT, task_id TEXT,
  model_id TEXT, input_tokens INT, output_tokens INT,
  duration REAL, retry_count INT, final_status TEXT);
""")

def store_get(scopes: list[str]) -> str:
    """Lê apenas os escopos autorizados: user e project:<id>"""
    marks = ",".join("?" * len(scopes))
    rows = db.execute(f"SELECT key, value FROM store WHERE scope IN ({marks})", scopes)
    return "\n".join(f"- {k}: {v}" for k, v in rows)

def save_checkpoint(run_id, task_id, step, state):
    db.execute("INSERT INTO checkpoint VALUES (?,?,?,?,?)",
               (run_id, task_id, step, json.dumps(state, ensure_ascii=False), time.time()))
    db.commit()

def log_run(run_id, task, usage, duration, retries, status):
    db.execute("INSERT OR REPLACE INTO runs VALUES (?,?,?,?,?,?,?,?,?,?)",
               (run_id, "regulus", task.project_id, task.task_id, task.model,
                getattr(usage, "prompt_tokens", 0), getattr(usage, "completion_tokens", 0),
                duration, retries, status.value))
    db.commit()

@dataclass
class Task:
    task_id: str
    project_id: str
    goal: str
    model: str
    depends_on: list[str] = field(default_factory=list)
    needs_approval: bool = False

async def run_task(task: Task, done: dict, sem: asyncio.Semaphore,
                   max_retry: int = 2, timeout: int = 120):
    run_id = f"run-{uuid.uuid4().hex[:8]}"
    background = store_get(["user", f"project:{task.project_id}"])
    upstream = "\n\n".join(done[d] for d in task.depends_on)
    messages = [
        {"role": "system", "content": f"长期背景:\n{background}"},
        {"role": "user", "content": f"{task.goal}\n\n上游结果:\n{upstream or '无'}"},
    ]
    async with sem:  # Limite de concorrência
        for attempt in range(max_retry + 1):
            start = time.time()
            save_checkpoint(run_id, task.task_id, f"attempt-{attempt}", messages)
            try:
                resp = await asyncio.wait_for(
                    client.chat.completions.create(model=task.model, messages=messages),
                    timeout)
                output = resp.choices[0].message.content
                status = Status.APPROVAL if task.needs_approval else Status.COMPLETED
                log_run(run_id, task, resp.usage, time.time() - start, attempt, status)
                save_checkpoint(run_id, task.task_id, status.value, {"output": output})
                if status == Status.COMPLETED:
                    done[task.task_id] = output
                return
            except Exception as e:  # Timeout ou erro de API: retry com backoff exponencial
                save_checkpoint(run_id, task.task_id, "error", {"error": str(e)})
                await asyncio.sleep(2 ** attempt)
        log_run(run_id, task, None, 0, max_retry, Status.FAILED)

async def schedule(tasks: list[Task], max_concurrency: int = 2) -> dict:
    sem = asyncio.Semaphore(max_concurrency)
    done: dict[str, str] = {}
    pending = {t.task_id: t for t in tasks}
    while pending:
        ready = [t for t in pending.values() if all(d in done for d in t.depends_on)]
        if not ready:  # Tarefas predecessoras falharam, aguardando aprovação ou dependência circular
            print("阻塞任务:", list(pending))
            break
        await asyncio.gather(*(run_task(t, done, sem) for t in ready))
        for t in ready:
            pending.pop(t.task_id)
    return done

tasks = [
    Task("daily-news", "ai-radar", "汇总今日 AI 官方动态", "gpt-4.1-mini"),
    Task("collect", "research", "收集本月竞品 API 价格与功能变更", "gpt-4.1-mini"),
    Task("analyze", "research", "对比变更并归纳趋势", "gpt-4.1", depends_on=["collect"]),
    Task("report", "research", "生成月度竞品报告", "gpt-4.1",
         depends_on=["analyze"], needs_approval=True),
]
asyncio.run(schedule(tasks))
O código tem alguns pontos que refletem o design discutido anteriormente. O `store_get` lê apenas o `user` e o escopo do projeto atual, o que garante o isolamento entre projetos; a tabela `checkpoint` registra cada passo por run e, junto com a tabela `runs`, guarda os Tokens e o estado final; o `schedule` usa as relações de dependência para decidir o que roda em série e um semáforo para limitar a concorrência. Um sistema real ainda precisa incluir a invocação de ferramentas, os callbacks de aprovação e o ponto de entrada para retomada.
> 🚀 **Início rápido**: na fase de prototipagem, recomendamos obter créditos de teste gratuitos via APIYI apiyi.com e usar a mesma Key para configurar modelos diferentes nos três papéis — coleta, análise e redação — comparando resultados e custos antes de fechar a divisão de trabalho.
—
## 7 Como agentes multitarefa lidam com interrupções, falhas e aprovação humana
### 7.1 Máquina de estados da tarefa
O progresso da tarefa deve ser registrado por estados explícitos; o que o modelo descreve no chat serve apenas como referência. O fluxo principal recomendado é Pending (a executar) → Running (em execução) → Waiting (aguardando condição externa) ou Approval (aguardando aprovação) → Completed (concluída), com mais três estados de término ou pausa: Failed, Cancelled e Paused. Cada transição de estado é gravada no banco de dados, e o agendador toma decisões apenas com base nos estados registrados ali.
### 7.2 Retentativas, timeout e retomada após pausa
– **Retentativas**: em caso de erro de API ou timeout, retentar com backoff exponencial e registrar `retry_count`, para facilitar a identificação de etapas que falham com frequência;
– **Timeout**: definir um limite de execução para cada Run; ao estourar, mudar para Failed e emitir um alerta, evitando que uma tarefa travada ocupe uma vaga de concorrência por muito tempo;
– **Retomada após pausa**: salvar um checkpoint ao pausar e continuar a partir do último checkpoint ao retomar; as invocações de ferramentas já concluídas não precisam ser executadas de novo;
– **Idempotência**: em etapas com efeitos colaterais, como enviar e-mails ou escrever no banco de dados, verificar antes de retentar se a ação já foi executada, evitando operações duplicadas.
Há um detalhe relevante na documentação oficial do Dots: parar uma tarefa em execução e cancelar um plano periódico já criado são duas coisas diferentes, e, ao pausar um Dot, os Works independentes, o Codex e as tarefas agendadas também podem continuar rodando. Um sistema próprio deve projetar “parar este Run”, “pausar a Task” e “cancelar o plano periódico” como três operações independentes.
### 7.3 Aprovação humana: inspirada nas Custom Rules do Dots
O Dots usa as Custom Rules para dividir os comportamentos em quatro níveis: executar direto sem perguntar, executar após autorização prévia, perguntar antes de executar e devolver ao usuário. Operações como alterar senha ou transferir dinheiro precisam obrigatoriamente passar pelo usuário; excluir dados permanentemente ou instalar software pode exigir aprovação a cada vez. A aprovação do usuário não pode sobrepor as restrições de segurança essenciais.
Um sistema próprio pode seguir esse modelo e rotular as ferramentas. Consultas somente leitura são executadas direto; ao concluir a redação de um relatório, o processo entra em Approval; envio externo, pagamentos e exclusões são sempre entregues a uma pessoa. A tarefa de relatório do exemplo define `needs_approval=True`; depois de gerada, ela fica parada no estado de aprovação e só é gravada como Completed após a confirmação do usuário.
—
## 8 Rastreamento da execução de Agents multitarefa: Tracing e logs
Quando vários projetos rodam em paralelo, a pergunta que o usuário mais faz é “o que ele realmente fez”. O Tracing do OpenAI Agents SDK registra qual Agent foi chamado, qual modelo foi usado, quais chamadas de ferramenta ocorreram, onde houve handoff, quais verificações de segurança foram acionadas e como a tarefa terminou.
O Tracing é bom para reconstruir uma execução individual; estatísticas em nível de projeto precisam de logs de negócio complementares. Recomendo que cada Run registre pelo menos `project_id`, `task_id`, `run_id`, `model_id`, `input_tokens`, `output_tokens`, `tool_calls`, `duration`, `retry_count` e `final_status`. Com esses campos, já dá para responder perguntas de gestão como “quanto Token o projeto Research gastou este mês”, “qual etapa teve mais retentativas” e “qual modelo estoura mais o tempo em tarefas de análise”. A tabela `runs` da seção 6 é a implementação mínima desse conjunto de campos.
—
## 9 Custos e limites de gestão de Agents multitarefa
### 9.1 Estrutura de custos do Dots
Até 16 de novembro de 2026, usuários individuais podem usar o Dots por meio das assinaturas ChatGPT Pro 100, Pro 200 e Pro 500, com mensalidades de 100, 200 e 500 dólares, respectivamente. A documentação oficial não lista uma mensalidade separada de Dot nas instruções do Dots para o Pro individual. As tarefas ChatGPT Work ou Codex delegadas pelo Dot são calculadas conforme as cotas e regras do produto correspondente, e o consumo depende do modelo, do contexto, da inferência, das chamadas de ferramenta e da recuperação. O uso do Pro individual ainda tem restrições de idade (acima de 18 anos) e de região, excluindo o Espaço Econômico Europeu, o Reino Unido e a Suíça.
O modelo de cobrança dos workspaces corporativos é diferente. A documentação oficial atual diz que workspaces corporativos elegíveis podem optar por uma tarifa fixa por tipo de trabalho ou por cobrança conforme o uso; o período de prévia é gratuito, e a cobrança para os Dots já ativados começa em 18 de novembro de 2026; tarefas delegadas para Work ou Codex são cobradas à parte. Os valores específicos seguem a cotação efetivamente aplicável ao workspace.
### 9.2 De onde vêm os custos de um sistema próprio
Os custos de um Agent multitarefa construído internamente vêm principalmente de quatro pontos:
– **Leitura repetida de contexto**: cada tarefa injeta o contexto do projeto; quanto mais longo o contexto, mais Tokens de entrada a cada chamada, e o conteúdo no Store precisa ser enxugado periodicamente;
– **Retentativas e falhas**: uma tarefa de análise que falha reenvia todo o material upstream ao modelo mais uma vez;
– **Escolha de modelo**: usar o modelo mais forte em todas as subtarefas multiplica o custo;
– **Cota de concorrência**: os limites de taxa da API determinam quantas execuções paralelas efetivamente cabem.
### 9.3 Quantidade em paralelo vs. trabalho útil
Quantidade em paralelo e trabalho útil são coisas diferentes. Tarefas cujas dependências ainda não foram atendidas e que iniciam cedo só produzem resultados inúteis; conclusões conflitantes exigem trabalho humano de fusão; e dados errados de um projeto que passam pela memória compartilhada para outro geram custo de retrabalho ainda maior. O caminho razoável é primeiro garantir o isolamento dos projetos e as dependências corretas, e depois aumentar o teto de concorrência aos poucos, com base nos dados de monitoramento.
—
## 10 Perguntas Frequentes (FAQ)
P1: O que é o agendamento multitarefa do Dots?
Um único Dot mantém várias responsabilidades em paralelo. O usuário pode alternar entre tarefas e ajustar prioridades; o Dot divide o trabalho complexo e o envia para Agentes em segundo plano, que processam em paralelo e, em seguida, consolidam os resultados e os devolvem ao usuário quando é preciso tomar uma decisão.
P2: A memória de longo prazo do Dots guarda todo o histórico de conversas?
Não carrega tudo. Cada nova tarefa tem seu próprio contexto de conversa; o Dot trabalha com base no ChatGPT Memory, nas próprias anotações, no contexto atual da tarefa e nos dados dos aplicativos conectados, recuperando conversas anteriores apenas quando necessário.
P3: Checkpointer e Store podem substituir um ao outro?
As responsabilidades são diferentes. O Checkpointer salva snapshots de execução de uma tarefa individual, servindo para retomar após interrupções; o Store guarda o contexto do projeto e as decisões entre tarefas, para que novas tarefas continuem de onde as anteriores pararam. Em projetos de longo prazo, os dois são necessários.
P4: Quantas tarefas o Dots consegue executar em paralelo ao mesmo tempo?
O material oficial não divulga um número fixo de concorrência. O Dots oferece suporte a paralelismo, mas o ambiente de execução e a cota de uso têm limites. Usuários do Reddit relataram ter observado três processos em execução simultânea, mas isso é apenas o resultado de um teste individual.
P5: Como um Agente multi-projeto construído por conta própria pode invocar vários modelos rapidamente?
É possível usar uma interface agregadora compatível com OpenAI. Depois de se registrar no APIYI apiyi.com e obter a chave API e a cota gratuita de testes, basta definir o `base_url` do código deste artigo como `https://api.apiyi.com/v1` para configurar GPT, Claude, Gemini e outros modelos para diferentes subtarefas com o mesmo conjunto de código.
P6: Como controlar o custo de modelos em um Agente multitarefa?
Distribua os modelos por função: use modelos leve para coleta de informações e modelos mais poderosos para análise e redação; mantenha o contexto do projeto no Store enxuto; use a tabela runs para contabilizar os Tokens de cada projeto. Chamando por meio do APIYI apiyi.com com cobrança por uso, fica mais fácil testar em pequena escala antes de definir a cota.
P7: Quais cuidados de segurança devo ter com o Dots e com sistemas construídos por conta própria?
Os Agentes podem interpretar mal tarefas, avaliar mal materiais ou sofrer injeção de prompt (Prompt Injection), e a própria documentação oficial afirma que as proteções existentes não eliminam todos os riscos. Operações que envolvem contas, fundos ou envio externo devem passar por aprovação humana, e credenciais sensíveis não devem entrar no contexto do modelo.
—
## 11 Dots: agendamento multitarefa e memória de longo prazo — pontos-chave
– **Principal dificuldade**: o ponto central de um agente multitarefa está em contexto independente, estado persistente, agendamento e recuperação.
– **Mecanismo do Dots**: um único Dot coordena vários itens, agentes em segundo plano executam em paralelo e o contexto de novas tarefas é independente entre si.
– **Duas formas de memória**: o Checkpointer é responsável por retomar a execução, enquanto o Store é responsável por dar continuidade ao contexto do projeto.
– **Estrutura de quatro camadas**: Workspace, Project, Task e Run têm IDs independentes, e os projetos são isolados entre si.
– **Princípios de agendamento**: dependências determinam execução serial, o limite de concorrência determina a escala e as regras ficam gravadas no agendador.
– **Rastreabilidade**: cada Run registra modelo, tokens, tempo gasto, número de tentativas e estado final.
– **Como começar**: por meio da interface unificada da APIYI apiyi.com, configure modelos diferentes para subtarefas diferentes.
—
## 12 Resumo
O Dots mostra um formato de produto em que um agente pessoal gerencia vários projetos de longo prazo: execução permanente, contextos de tarefa independentes entre si, memória armazenada em camadas, agentes em segundo plano executando em paralelo e operações de alto risco devolvidas ao usuário. Sua capacidade multiprojeto se apoia no gerenciamento de estado — simplesmente aumentar a quantidade de execuções paralelas não dá conta disso.
Ao construir um sistema semelhante por conta própria, você pode seguir a ordem deste artigo: primeiro implemente o isolamento de projetos com a estrutura de quatro camadas e a divisão de escopos; depois use Store e Checkpointer para resolver, respectivamente, “lembrar do contexto” e “conseguir retomar”; em seguida use o agendador para gerenciar dependências e concorrência; e, por fim, use máquina de estados, aprovações e logs de execução para deixar cada etapa controlável e auditável. Na fase de protótipo, recomenda-se validar rapidamente, por meio da APIYI apiyi.com, o desempenho de modelos diferentes em cada papel — e então ajustar a divisão de trabalho e a concorrência com base nos dados dos logs.
—
## Referências
1. **OpenAI: Introducing dots**: anúncio de lançamento do produto
– Link: `openai.com/index/introducing-dots`
– Descrição: posicionamento do produto, computador na nuvem e execução de múltiplos projetos
2. **ChatGPT Learn: Tasks and memory**: documentação de tarefas e memória do Dots
– Link: `learn.chatgpt.com/docs/dots/tasks-and-memory`
– Descrição: agente em segundo plano, contexto independente por tarefa, pesquisa proativa
3. **OpenAI Help Center: Dots privacy, security, and safety FAQs**: notas sobre privacidade e segurança
– Link: `help.openai.com/en/articles/20001529-dots-privacy-security-and-safety-faqs`
– Descrição: permissões, aprovações, exclusão de memória e retenção de dados
4. **ChatGPT Learn: Dots admin guide**: gestão e cobrança da versão empresarial
– Link: `learn.chatgpt.com/docs/enterprise/dots-admin-guide`
– Descrição: forma de cobrança do workspace empresarial e data de início da cobrança
5. **About ChatGPT Pro tiers**: descrição dos níveis de assinatura Pro
– Link: `help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers`
– Descrição: preços e regras de cota do Pro 100, 200 e 500
6. **Documentação do LangGraph Persistence**: Checkpointer e Store
– Link: `github.com/langchain-ai/docs/blob/main/src/oss/langgraph/persistence.mdx`
– Descrição: a divisão entre estado de execução de curto prazo e memória de longo prazo
7. **OpenAI Agents SDK**: Tracing e fluxos de trabalho
– Link: `developers.openai.com/api/docs/guides/agents/sdk`
– Descrição: rastreamento e depuração do processo de execução do Agent
—
> **Autor**: Equipe técnica da APIYI
> **Contato técnico**: fale conosco pela página inicial do APIYI apiyi.com; mais materiais de integração estão disponíveis no centro de documentação docs.apiyi.com


