
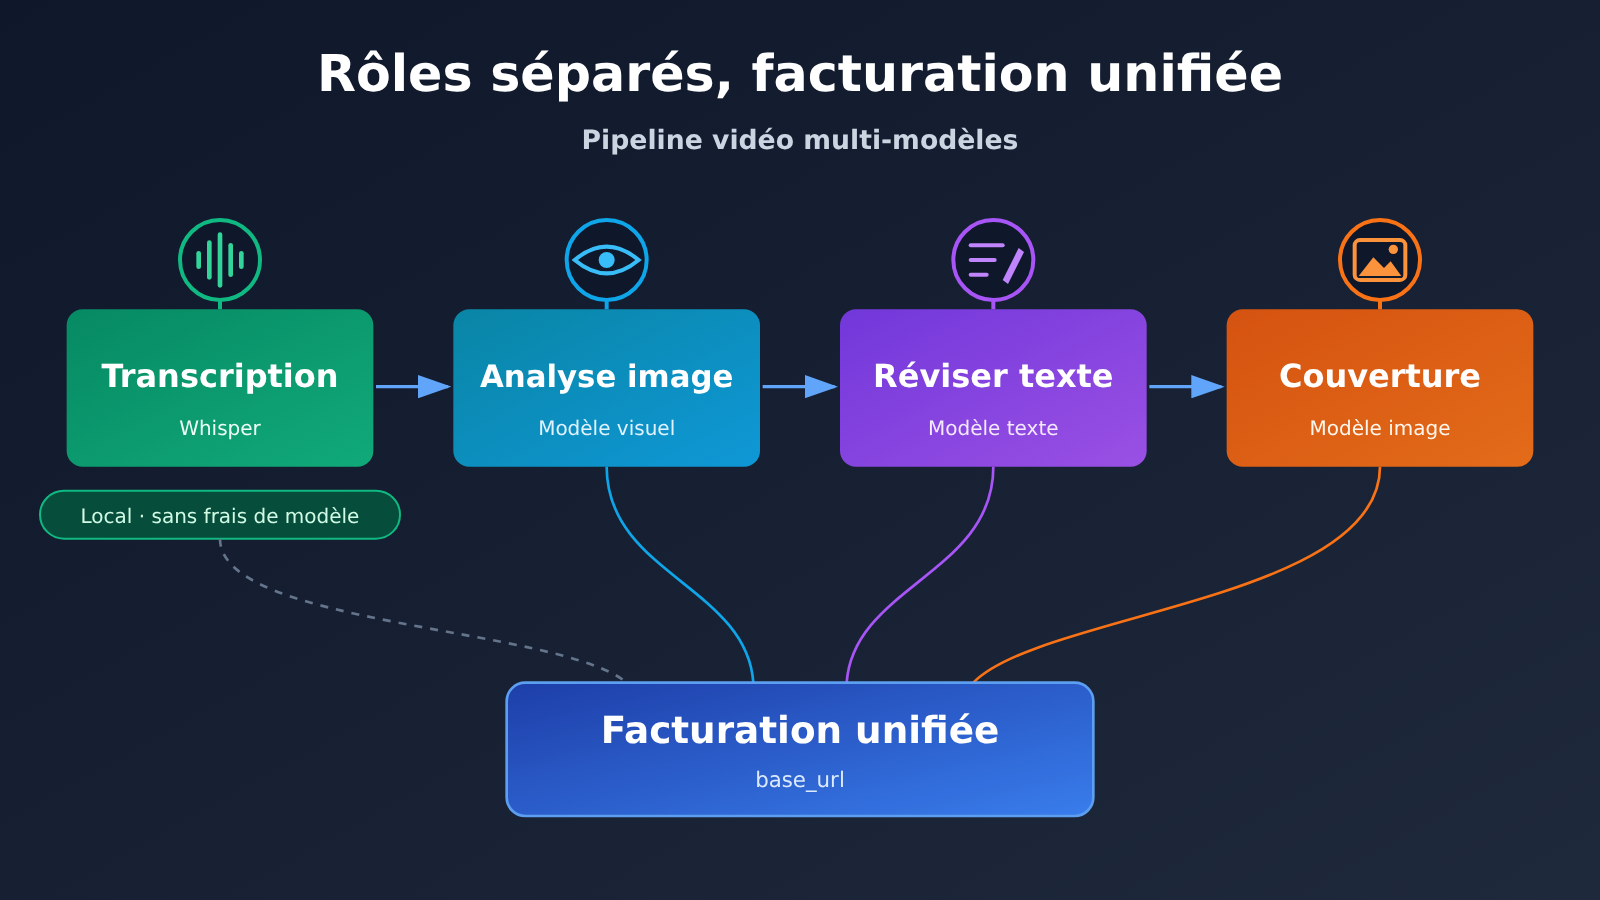
Note de l’auteur : pour produire une vidéo, il faut transcrire, analyser les images, créer la couverture, retoucher le texte. Chaque modèle peut avoir son rôle, mais il vaut mieux regrouper les étapes payantes derrière un même base_url, pour que la facturation reste cohérente.
Si vous avez déjà réalisé une vidéo longue de bout en bout, vous avez sûrement remarqué un phénomène : la transcription passe par un fournisseur, l’analyse visuelle par un autre, la couverture par un troisième, et la réécriture du titre et du texte ouvre encore une autre fenêtre. Prises séparément, chaque étape semble raisonnable ; au moment de faire les comptes en fin de mois, on se retrouve avec quatre ou cinq factures établies selon des logiques différentes : certaines au token, d’autres à la tâche, d’autres encore avec un abonnement mélangé. Cet article défend une idée : répartition des tâches conservée, facturation centralisée. Il faut d’abord distinguer ce qui peut rester en local de ce qui génère réellement des coûts, puis concentrer les étapes payantes dans un même point d’entrée d’appel.
Il ne s’agit pas de vous inciter à n’utiliser qu’un seul modèle. Chaque étape a naturellement son modèle adapté ; ce qu’il faut unifier, c’est l’entrée de facturation et la méthode de rapprochement, pas le modèle en soi.
Valeur concrète : à la fin de cet article, vous disposerez d’un tableau de répartition « local / payant » pour votre pipeline vidéo, d’une comparaison des modèles et des prix vérifiée au 2026-11-20, ainsi que de la marche à suivre pour basculer les étapes payantes vers un même base_url.
Les points essentiels pour faire appel à plusieurs modèles sur une seule vidéo
Le point de départ de cette discussion, c’est une compétence de montage vidéo rapportée par MindStudio le 19 novembre 2026. L’auteur raconte avoir dépensé environ 2,71 dollars pour produire une longue vidéo avec un pipeline multimodal avancé. Il faut être clair : ce chiffre est celui de l’auteur, il passe par OpenRouter, ce n’est ni une facture APIYI ni une mesure faite dans le cadre de cet article. Son intérêt est indicatif : le coût modèle d’une vidéo peut être maintenu à un niveau très bas, à condition de savoir à quelles étapes part l’argent.
| Point clé | Explication | Valeur |
|---|---|---|
| Séparer d’abord le local et le payant | La transcription peut se faire avec Whisper en local, sans frais de modèle | Une facture en moins, et moins de données qui sortent |
| Regrouper les étapes payantes | Analyse des images, retouche du texte, génération de la couverture passent par le même base_url | Toute la consommation visible depuis un seul back-office |
| Changer de modèle en ne modifiant que l’ID | L’interface est compatible OpenAI, il suffit de changer le champ model pour basculer |
La répartition peut être ajustée à tout moment, sans réécrire le code |
| Compter séparément à l’appel et au token | La couverture est facturée à l’appel, le texte et la vision au token | Une base d’estimation budgétaire claire |
| Noter à part les étapes hors catalogue | Le clonage vocal n’est pas au catalogue d’APIYI | Pas d’erreur de calcul lors du rapprochement |
Le détail des points clés de la répartition dans le pipeline vidéo
Le premier point, c’est la « répartition » elle-même. Analyser les images d’une vidéo et comprendre le contenu des plans demande un modèle doté d’une forte compréhension multimodale et capable de gérer une longue fenêtre de contexte ; générer une couverture demande un modèle de génération d’images ; retoucher un texte est plus sensible à la qualité rédactionnelle et au coût. Vouloir tout imposer à un seul modèle revient souvent à dégrader la qualité sur un maillon, ou à faire grimper le coût sur un autre. La répartition est donc logique ; le problème vient seulement du fait que chaque fournisseur exige l’ouverture d’un compte, un rechargement et une facturation séparés.
Le deuxième point, c’est le « regroupement ». APIYI (apiyi.com) est une plateforme d’agrégation d’API de grands modèles de langage : une seule clé API permet d’appeler les principaux modèles comme OpenAI, Claude ou Gemini, avec une interface compatible OpenAI et une facturation à l’usage. Pour un pipeline vidéo, cela signifie que les étapes payantes — analyse des images, retouche du texte, génération de la couverture — peuvent partager une même clé et un même base_url, la consommation étant consignée au même endroit. Quand on change de modèle, on modifie l’ID du modèle, on ne change ni de fournisseur ni de SDK.
Prise en main rapide : plusieurs modèles pour une seule vidéo
Étape 1 : diviser le pipeline vidéo en deux parties, local et payant
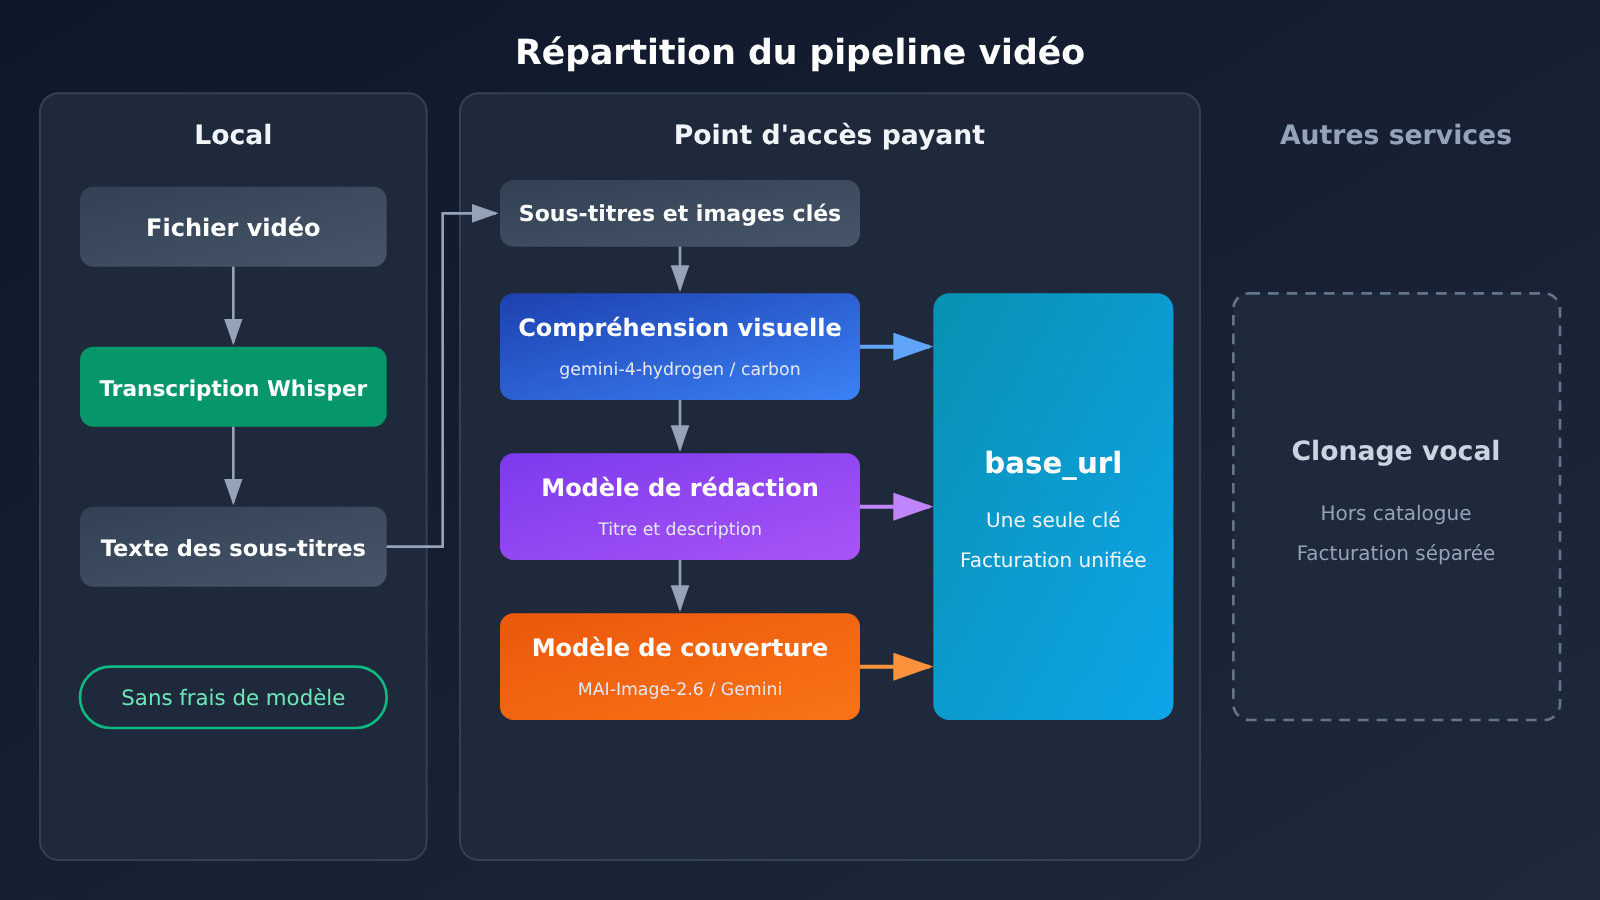
Avant de brancher les API, commencez par lister clairement la nature tarifaire de chaque étape. Le tableau ci-dessous montre comment découper un pipeline vidéo long typique ; vous pouvez ajouter ou retirer des lignes selon votre propre processus.
| Étape | Emplacement d’exécution recommandé | Génère des frais de modèle | Base de facturation |
|---|---|---|---|
| Transcription audio | Whisper local | Non | Utilise seulement la puissance de la machine locale |
| Montage, assemblage, export | Outil de montage local | Non | Aucun |
| Analyser les images, comprendre les plans | Point d’entrée API unifié | Oui | Selon les tokens d’entrée / de sortie |
| Modifier le titre, rédiger la description | Point d’entrée API unifié | Oui | Selon les tokens d’entrée / de sortie |
| Générer la miniature | Point d’entrée API unifié | Oui | À l’appel |
| Clonage vocal | Autre service | Oui | Absent du catalogue APIYI, comptabilité séparée |
Une fois le découpage fait, il ne reste que trois étapes payantes à centraliser. La transcription reste en local : aucun frais de modèle, et l’audio original n’a pas besoin d’être téléversé. Si vous avez vraiment besoin du clonage vocal, ce sera une facture à part — à provisionner séparément dans le budget, sans l’intégrer au point d’entrée unifié.
Étape 2 : confirmer le modèle et le prix
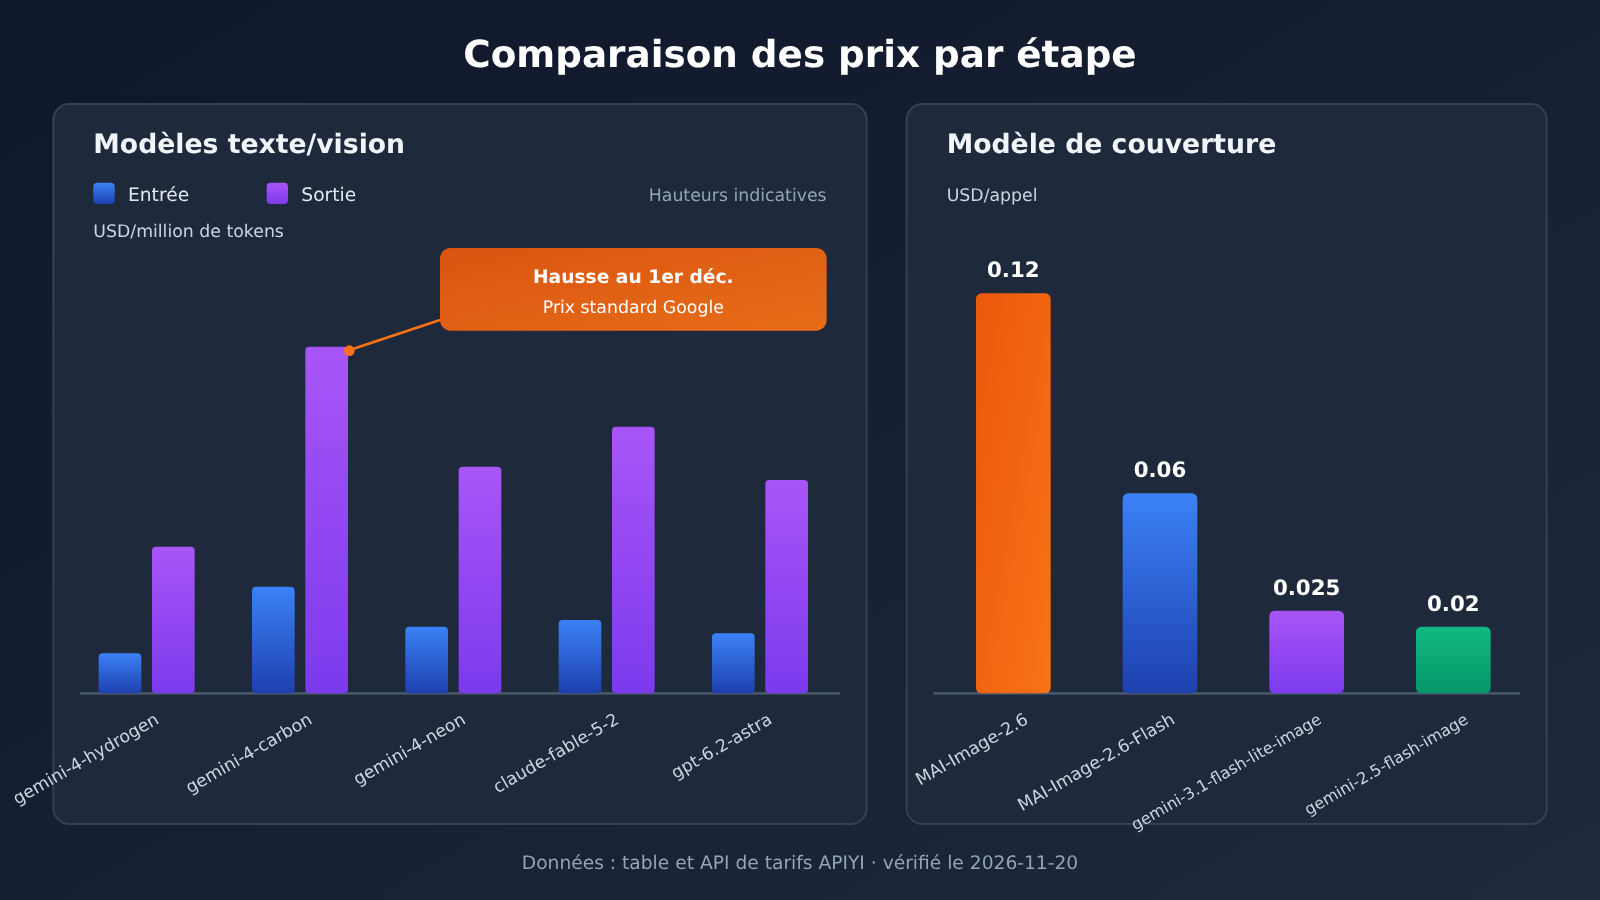
Ensuite, on vérifie les modèles et on compare les tarifs. Les prix ci-dessous ont été vérifiés le 2026-11-20. Ils proviennent du tableau récapitulatif des modèles d’APIYI, docs.apiyi.com/models.md (cette version a été mise à jour le 2026-11-19 à 10:59, UTC+8), ainsi que de l’interface de tarification api.apiyi.com/api/pricing (version shell-api-modelmak-v1). Dans l’interface de tarification, lorsque model_ratio vaut 1, cela correspond à 2 USD par million de tokens en entrée ; vous pouvez vous en servir pour faire vos propres conversions.
| ID du modèle | Entrée (USD / million de tokens) | Sortie | Lecture du cache | Étape adaptée |
|---|---|---|---|---|
gemini-4-hydrogen |
1.5 | 7.5 | 0.075 | Analyse d’image, retouche de texte, orienté coût |
gemini-4-carbon |
2 | 10 | 0.1 | Analyse d’image, retouche de texte, prix de lancement jusqu’au 2026-11-30 |
gemini-4-argon |
2 | 10 | 0.1 | Tâches de texte et de compréhension |
gemini-4-neon |
3 | 15 | 0.15 | Option de repli lorsque des capacités plus fortes sont nécessaires |
claude-fable-5-2 / claude-fable-5-2-thinking |
8 | 40 | 0.2 | Peaufinage de longs textes, réécriture complexe |
gpt-6.2-astra |
8 (16 au-delà de 272000 tokens) | 40 | 0.4 | Tâches de texte exigeantes |
Deux points méritent une attention particulière. Les valeurs 2 / 10 / 0.1 de gemini-4-carbon correspondent au prix de lancement de Google valable jusqu’au 2026-11-30. À partir du 1er décembre, le tarif standard de Google sera de 4 en entrée et 20 en sortie : le coût doublera. Il faudra donc revérifier avant de lancer des traitements par lots sur la durée. Pour gpt-6.2-astra, au-delà de 272000 tokens, le tableau général indique 16 en entrée, tandis que l’interface de tarification donne aussi, pour cette tranche, 60 en sortie et 0.8 en lecture du cache. En cas d’écart entre les deux sources, fiez-vous à la facturation réellement appliquée lors de vos appels. gemini-4-neon n’apparaît pas dans cette version du tableau général, mais l’interface de tarification le référence ; après conversion, le résultat correspond au tarif Google.
L’étape de création de couverture est facturée à l’appel ; voici un tableau dédié :
| ID du modèle de couverture | Prix par appel (USD) | Cas d’usage |
|---|---|---|
MAI-Image-2.6 |
0.12 | Couverture principale, besoin de meilleure qualité |
MAI-Image-2.6-Flash |
0.06 | Essais de plusieurs versions |
gemini-3.1-flash-lite-image |
0.025 | Croquis en lot |
gemini-2.5-flash-image |
0.02 | Génération rapide à faible coût |
Attention : MAI-Image-2.7 n’existe pas encore ; ne l’inscrivez pas dans vos scripts comme un modèle appelable. Kling, Muse et gemini-4-flash-lite sont également absents du tableau général et de l’interface de tarification : excluez-les d’emblée lorsque vous planifiez votre pipeline.
Troisième étape : basculer les étapes payantes vers le même base_url
La modification est minime. Si vous utilisiez jusqu’ici le SDK officiel d’OpenAI, il suffit de changer deux choses :
- remplacer
api_keypar la clé générée dans la console APIYI ; - définir
base_urlsurhttps://api.apiyi.com/v1.
Ensuite, pour la requête d’analyse des images, indiquez model = gemini-4-hydrogen ; pour la réécriture des textes, claude-fable-5-2 ou continuez avec Gemini ; pour la génération de couverture, MAI-Image-2.6-Flash. Les trois étapes partagent un seul objet client, seule l’ID du modèle change. Les requêtes conversationnelles passent par /chat/completions compatible OpenAI ; pour les paramètres précis et le format de retour des modèles d’image, référez-vous à la documentation du modèle.
Voir la liste de configuration par étape
– **Client** : initialisé une seule fois, `base_url` inchangé, la clé placée dans une variable d’environnement, par exemple `APIYI_API_KEY`.
– **Analyse des images** : fournissez en entrée les captures des images clés et les sous-titres transcrits localement, avec `model` = `gemini-4-hydrogen` ; si le budget le permet ou si vous avez besoin d’une compréhension plus poussée, passez à `gemini-4-carbon`.
– **Réécriture des textes** : utilisez le résumé de plan produit à l’étape précédente comme contexte, avec `model` = `claude-fable-5-2` ; pour les scripts longs nécessitant un raisonnement en plusieurs étapes, utilisez `claude-fable-5-2-thinking`.
– **Génération de couverture** : commencez par `gemini-2.5-flash-image` pour produire quelques esquisses, puis une fois le visuel validé, générez la couverture finale avec `MAI-Image-2.6`.
– **Cache** : les sous-titres d’une même vidéo sont relus plusieurs fois par différentes étapes ; gardez autant que possible un préfixe identique pour les parties partagées afin de bénéficier du tarif de lecture en cache.
– **Journalisation** : consignez pour chaque requête l’ID du modèle et la consommation de tokens renvoyée, puis rapprochez-les chaque fin de mois de la consommation affichée dans la console.
🚀 Conseil pour démarrer vite : commencez par utiliser le quota d’essai gratuit réservé aux nouveaux utilisateurs sur APIYI apiyi.com, faites tourner une vidéo courte de bout en bout selon les trois étapes ci-dessus, notez la consommation réelle de tokens à chaque étape, puis décidez quel niveau de modèle utiliser pour les vidéos longues.
Étape 4 : estimer le budget d’une vidéo
Pour l’estimation, séparez le calcul au token et le calcul à la requête. Prenons un exemple hypothétique : si l’analyse des images et la réécriture du script consomment au total 1 million de tokens d’entrée et 100 000 tokens de sortie, avec gemini-4-hydrogen, cela fait 1,5 + 0,75, soit environ 2,25 dollars ; pour la couverture, 4 esquisses Flash et 1 visuel final donnent 4 × 0,06 + 0,12, soit 0,36 dollar. Les nombres de tokens ici ne sont que des valeurs hypothétiques pour la démonstration ; votre consommation réelle dépend de la durée de la vidéo, de la densité des captures d’images et du nombre de passes de réécriture du script.
L’intérêt de cette méthode d’estimation, c’est que chaque poste peut être rapproché ligne par ligne de la facturation du tableau de bord. À l’inverse, si les quatre étapes sont réparties entre quatre fournisseurs, les taux de change, les unités de facturation et les moments de prélèvement diffèrent : même si le total reste modeste, le rapprochement prend beaucoup de temps.
FAQ — Questions fréquentes
Q1 : Une vidéo fait appel à plusieurs modèles ; de quelles étapes parle-t-on exactement ?
En général, il y a quatre étapes : la transcription, l’analyse des images, la réécriture du texte et la génération de la miniature. Certains pipelines ajoutent aussi le doublage ou le clonage vocal. La transcription peut être réalisée en local avec Whisper, sans frais de modèle ; ce qui coûte réellement de l’argent, ce sont plutôt l’analyse des images, la génération de la miniature et la réécriture du texte.
Q2 : La répartition des tâches et le point d’entrée unique sont-ils contradictoires ? Ne serait-il pas plus simple de n’utiliser qu’un seul modèle ?
Non, ce n’est pas contradictoire. La répartition sert à faire correspondre qualité et coût, tandis que le point d’entrée unique sert à la facturation et au rapprochement comptable. Un seul modèle est certes plus simple, mais l’analyse des images, la rédaction de texte et la génération d’images ont des exigences de capacité très différentes : forcer l’unification est souvent contre-productif. La démarche la plus raisonnable consiste à choisir chaque modèle séparément, tout en gardant un seul point d’entrée pour les invocations.
Q3 : Les 2,71 dollars par longue vidéo peuvent-ils servir directement de budget ?
Mieux vaut ne pas les appliquer tels quels. Il s’agit d’un chiffre rapporté par l’auteur et relayé par MindStudio, via OpenRouter, et non de la facture APIYI : la combinaison de modèles, la durée de la vidéo et le nombre d’images extraites ne sont pas forcément identiques aux vôtres. La méthode la plus fiable consiste à refaire le calcul soi-même, à l’étape 4 de cet article, avec sa propre consommation de tokens et les tarifs unitaires actuels.
Q4 : Pour l’analyse des images, faut-il choisir gemini-4-hydrogen ou gemini-4-carbon ?
Si le budget prime, choisissez `gemini-4-hydrogen` : entrée à 1,5, sortie à 7,5 et lecture du cache à 0,075, c’est le tarif unitaire le plus bas de cette série. Si vous avez besoin d’une compréhension plus poussée, choisissez `gemini-4-carbon`, mais attention : ses tarifs 2 / 10 sont des prix de lancement valables jusqu’au 30 novembre 2026 ; à partir du 1er décembre, Google applique le tarif standard de 4 en entrée et 20 en sortie. Pensez donc à revérifier les prix avant un usage à long terme.
Q5 : Comment basculer un script existant vers le point d’entrée unifié ?
Inscrivez-vous sur APIYI (apiyi.com) et générez une clé API, remplacez le `base_url` du SDK par l’adresse d’appel de la plateforme, puis modifiez le champ `model` selon l’étape concernée. La structure de requête existante ne change pratiquement pas. Les nouveaux utilisateurs disposent en plus d’un quota d’essai gratuit, ce qui permet de valider toute la chaîne sur une courte vidéo.
Q6 : Le clonage vocal peut-il passer par ce point d’entrée ?
Non. Le clonage vocal n’est pas encore proposé sur APIYI ; si vous en avez besoin, il faudra passer par un autre service et le comptabiliser séparément. Lors de la planification budgétaire, mieux vaut l’inscrire sur une ligne dédiée pour éviter de le mélanger avec la consommation du point d’entrée unifié.
Q7 : Y a-t-il des limitations connues à anticiper ?
Quelques points : `MAI-Image-2.7` n’existe pas pour l’instant, et Kling, Muse ainsi que `gemini-4-flash-lite` sont introuvables aussi bien dans le tableau récapitulatif que dans l’API de tarification — ne les intégrez pas dans vos scripts. Au-delà de 272 000 tokens, le tarif unitaire de `gpt-6.2-astra` augmente, et les détails de la grille tarifaire diffèrent légèrement entre le tableau récapitulatif et l’API de tarification : c’est la facturation réelle qui fait foi. Les prix évoluent, donc avant de lancer un traitement par lots, mieux vaut revérifier une fois de plus le tableau des modèles du jour.
Points clés : faire appel à plusieurs modèles pour une même vidéo
- Décomposer avant de connecter : la transcription et le montage restent en local, on ne branche sur l’API que les étapes qui génèrent des coûts.
- Garder la répartition des rôles : pour analyser les images, réécrire le texte et générer la vignette, choisissez le modèle le plus adapté à chaque tâche, sans chercher à tout unifier.
- Un point d’entrée unique : les étapes payantes partagent une seule clé et un seul base_url ; changer de modèle revient à changer l’ID du modèle.
- Séparer les modes de facturation : le texte et la vision se comptent au token, la vignette à l’unité ; le budget se calcule en deux colonnes.
- Attention aux échéances : le prix de lancement de
gemini-4-carboncourt jusqu’au 2026-11-30, ensuite le tarif standard augmente. - Hors catalogue, à part : le clonage de voix ne passe pas par le point d’entrée unifié, il faut le comptabiliser séparément.
- Les chiffres externes ne sont qu’indicatifs : les 2,71 dollars sont une estimation donnée par l’auteur sur OpenRouter, pas la facture APIYI.
En résumé
Faire appel à plusieurs modèles pour une seule vidéo n’a rien de problématique en soi ; le problème, c’est que la facture finit par être éclatée et impossible à réconcilier. En résumé, trois points :
- Le local d’abord : la transcription passe par Whisper en local et le montage se fait en local ; ces deux étapes ne génèrent pas de frais de modèle.
- Un seul point de facturation : l’analyse des images, la réécriture du texte et la génération de la vignette passent par un même base_url, avec une répartition par ID de modèle.
- Calculer au prix du jour : estimez séparément la facturation au token et celle à l’unité, et revérifiez les prix et les modèles disponibles avant de lancer un lot.
Je conseille de faire tourner toute la chaîne sur une vidéo courte pour noter les usages réels de chaque étape, puis de passer à des vidéos longues. Pour cette validation, utilisez le quota d’essai gratuit sur APIYI apiyi.com : la répartition reste la même, et la facture se lit depuis un seul point d’entrée.
📚 Références
-
Tableau récapitulatif des modèles APIYI : aperçu des modèles et des prix unitaires
- Lien :
docs.apiyi.com/models.md - Remarque : source principale des prix de cet article, version mise à jour le 2026-11-19 à 10:59 (UTC+8)
- Lien :
-
API de tarification APIYI : tarification en temps réel convertie selon un ratio
- Lien :
api.apiyi.com/api/pricing - Remarque : version
shell-api-modelmak-v1,model_ratioà 1 correspond à 2 USD par million de tokens en entrée
- Lien :
-
Retranscription de la compétence de montage vidéo de MindStudio : publiée le 2026-11-19
- Remarque : l’affirmation selon laquelle une vidéo longue coûte 2,71 USD provient de la déclaration de l’auteur rapportée dans cet article, via OpenRouter
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site officiel APIYI ; pour plus de modèles et d’explications sur les appels, consultez le centre de documentation docs.apiyi.com


