
Nota do autor: para produzir um vídeo é preciso transcrever o áudio, analisar os quadros, gerar a capa e revisar o texto. Cada modelo pode cuidar da sua parte, mas o ideal é concentrar as etapas pagas no mesmo base_url — só assim a fatura fecha.
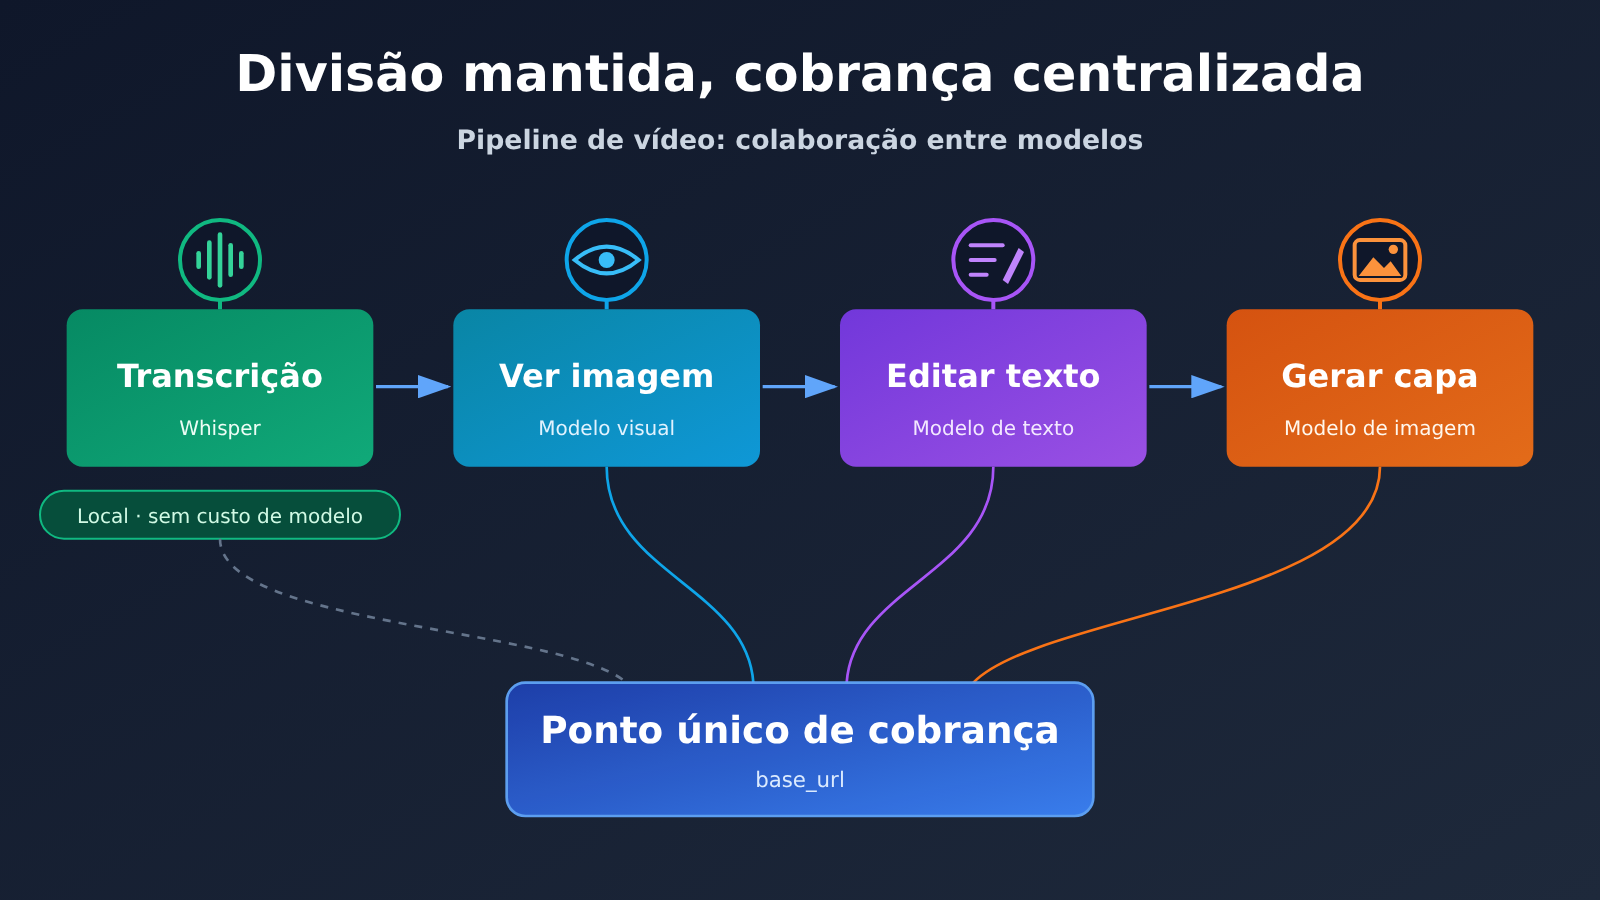
Se você já fez um vídeo longo do começo ao fim, provavelmente notou um padrão: a transcrição fica com um fornecedor, a análise dos quadros com outro, a capa com um terceiro e a revisão de títulos e textos abre mais uma janela. Cada etapa, vista isoladamente, faz sentido; no fim do mês, porém, você tem quatro ou cinco faturas com critérios completamente diferentes — algumas cobram por token, outras por requisição, outras ainda misturam assinatura. O que este artigo propõe é manter a divisão de trabalho e unificar a cobrança: primeiro identificar o que pode ficar local e o que realmente gera custo, depois concentrar as etapas pagas em uma única entrada de chamada.
Não é um convite para usar um único modelo. Etapas diferentes se dão melhor com modelos diferentes. O que precisa ser unificado é a entrada de cobrança e o critério de conciliação — não os modelos em si.
Valor central: ao terminar de ler, você terá uma tabela de separação “local / pago” do pipeline de vídeo, uma comparação de modelos e preços verificada em 2026-11-20, e o método para redirecionar as etapas pagas para o mesmo base_url.
Pontos centrais para usar vários modelos em um único vídeo
O ponto de partida desta discussão foi uma técnica de edição de vídeo compartilhada pelo MindStudio em 19/11/2026. Segundo o próprio autor, concluir um vídeo longo com um pipeline multimodal avançado custa cerca de US$ 2,71. É preciso deixar claro que esse número é a declaração do autor, obtido via OpenRouter, e não é a fatura da APIYI nem um resultado medido neste artigo. O valor de referência está no fato de que o custo de modelos por vídeo pode ficar em uma faixa bem baixa, desde que você saiba em quais etapas o dinheiro foi gasto.
| Ponto | Explicação | Benefício |
|---|---|---|
| Primeiro, separe o local do pago | A transcrição pode usar Whisper local, sem pagar taxa de modelo | Menos uma fatura e menos uma transferência de dados para fora |
| Concentre as etapas pagas | Análise visual, edição de texto e geração de capa usam o mesmo base_url |
Todo o consumo em um único painel |
| Troque o modelo apenas mudando o ID | A interface é compatível com OpenAI; ao trocar, altere o campo model |
A divisão de trabalho pode ser ajustada a qualquer momento sem reescrever o código |
| Calcule separadamente por chamada e por token | Capa por chamada; texto e visão por token | O critério de estimativa de orçamento fica claro |
| Registre à parte as etapas fora do catálogo | A clonagem de voz não está no catálogo da APIYI | Evita erro na conciliação |
Detalhes dos pontos-chave da divisão de trabalho no pipeline de vídeo
O primeiro ponto é a própria “divisão de trabalho”. Analisar as imagens do vídeo e entender o conteúdo das cenas exige um modelo com forte capacidade de compreensão multimodal e que consiga lidar com uma janela de contexto longa; gerar a capa exige um modelo de geração de imagens; editar o texto é mais sensível à qualidade da escrita e ao custo. Forçar todas essas tarefas em um único modelo geralmente faz a qualidade de alguma etapa cair ou o custo de outra ficar alto. Então a divisão faz sentido; o problema é que cada serviço exige abrir uma conta, recarregar e emitir uma fatura separada.
O segundo ponto é a “centralização”. APIYI apiyi.com é uma plataforma de agregação de APIs de Modelos de Linguagem Grande: com uma chave API, você invoca modelos populares como OpenAI, Claude e Gemini, com interface compatível com OpenAI e cobrança conforme o uso. Para o pipeline de vídeo, isso significa que as etapas pagas — análise visual, edição de texto e geração de capa — podem compartilhar uma única chave e um único base_url, com o consumo registrado em um só lugar. Ao trocar de modelo, você muda o ID do modelo, não o fornecedor nem o SDK.
Guia rápido para usar vários modelos em um único vídeo
Primeiro passo: divida o pipeline de vídeo em duas partes — local e paga
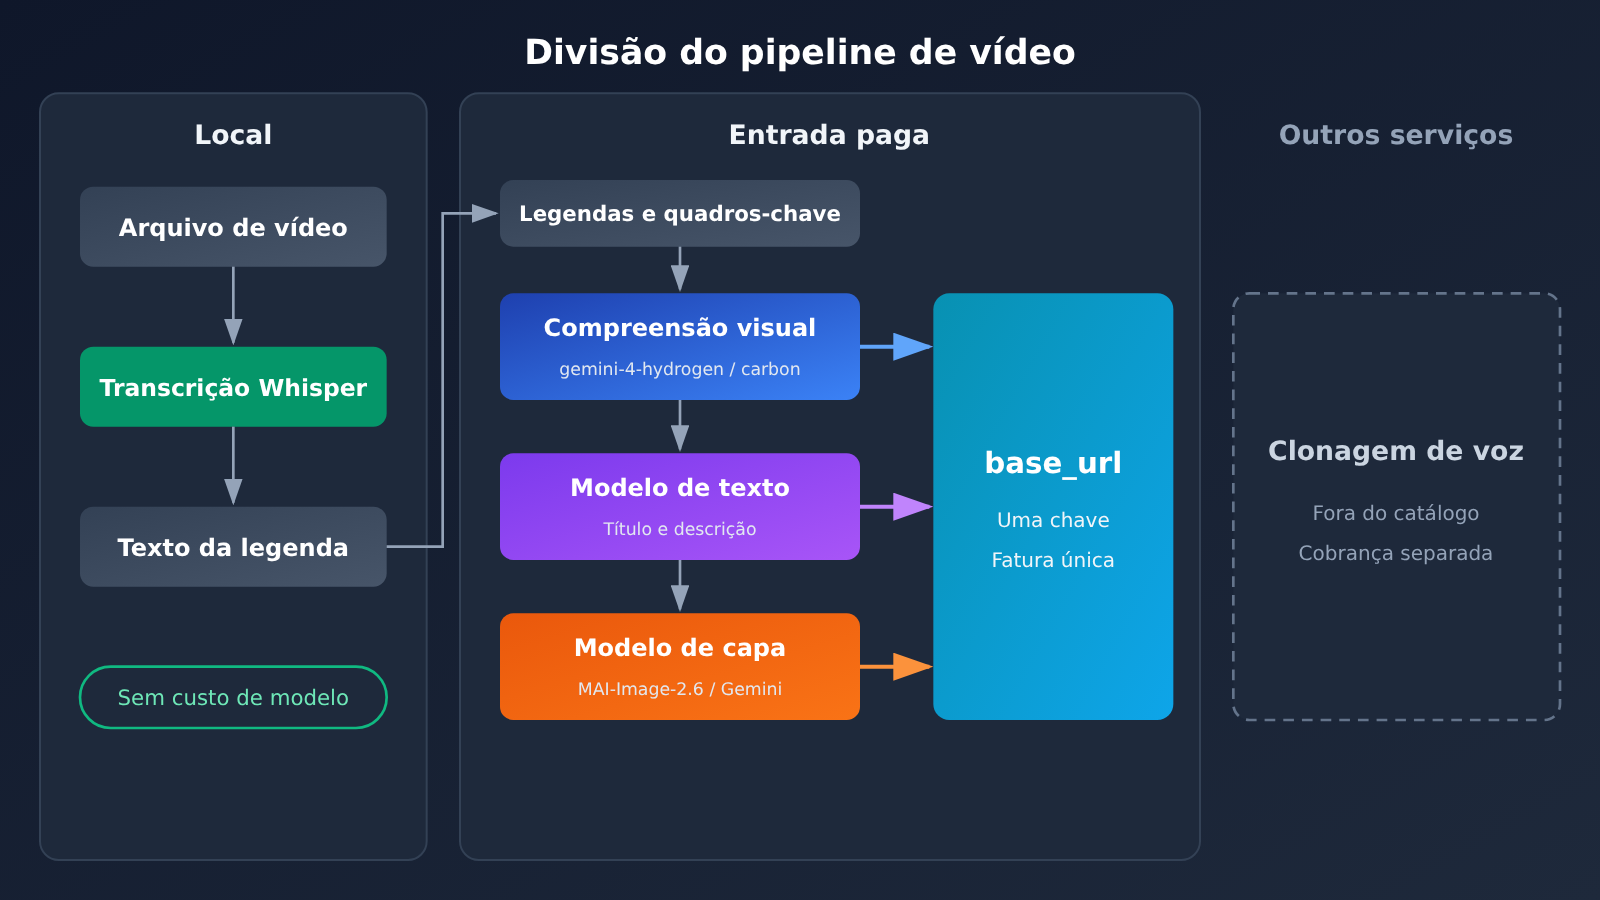
Antes de começar a integrar as APIs, deixe claro a natureza da cobrança de cada etapa. A tabela abaixo mostra como dividir um pipeline típico de vídeos longos; você pode adicionar ou remover etapas conforme o seu fluxo.
| Etapa | Onde faz sentido executar | Gera custo de modelo? | Critério de cobrança |
|---|---|---|---|
| Transcrição de áudio | Whisper local | Não | Consome apenas a capacidade de computação da máquina local |
| Edição, montagem e exportação | Ferramenta de edição local | Não | Nenhum |
| Análise das imagens e compreensão das cenas | Entrada unificada de API | Sim | Por token de entrada / saída |
| Alteração de títulos e criação de descrições | Entrada unificada de API | Sim | Por token de entrada / saída |
| Criação de capas | Entrada unificada de API | Sim | Por chamada |
| Clonagem de voz | Outro serviço | Sim | Não está no catálogo da APIYI; contabilize separadamente |
Com essa divisão, restam apenas três etapas pagas para centralizar. A transcrição fica no ambiente local: assim você não paga custo de modelo e também não precisa enviar o áudio original. Se você realmente precisar de clonagem de voz, ela será uma cobrança independente. Reserve um valor separado para isso no orçamento e não a inclua na entrada unificada.
Passo 2: confirmar o modelo e o preço
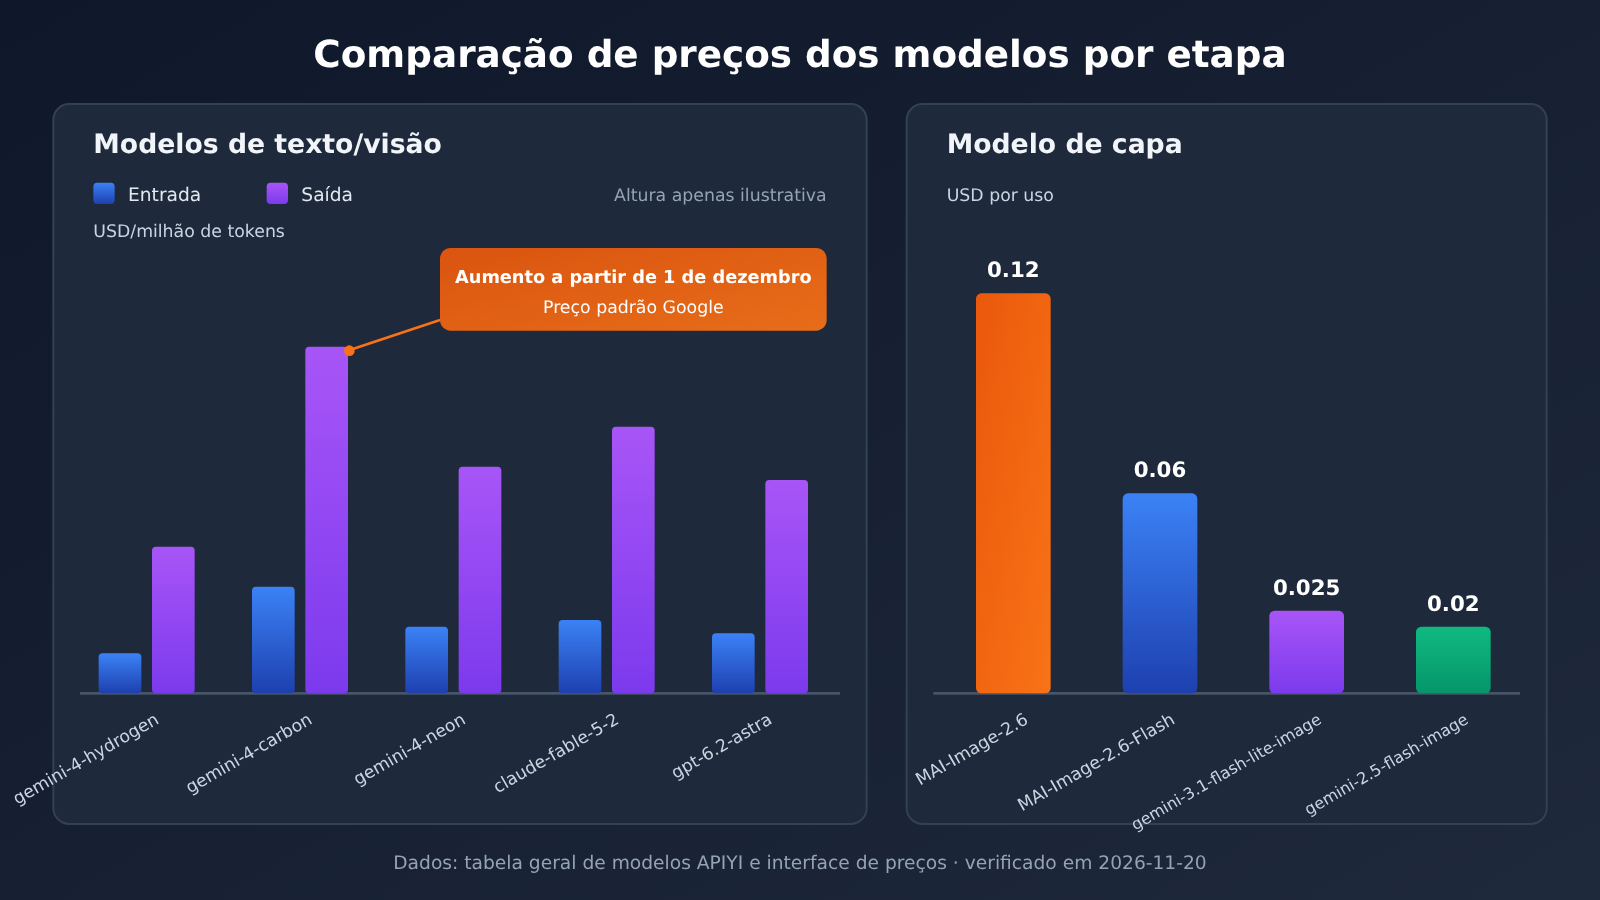
Agora vem a parte de conferir modelo e preço. Os valores abaixo foram verificados em 2026-11-20 e vêm da tabela geral de modelos da APIYI em docs.apiyi.com/models.md (essa versão foi atualizada em 2026-11-19 10:59, UTC+8) e do endpoint de preços api.apiyi.com/api/pricing (versão shell-api-modelmak-v1). Quando model_ratio é 1 no endpoint de preços, isso corresponde a entrada de 2 dólares por milhão de tokens; a partir daí você pode fazer a conversão.
| ID do modelo | Entrada (USD/milhão de tokens) | Saída | Leitura de cache | Etapa adequada |
|---|---|---|---|---|
gemini-4-hydrogen |
1.5 | 7.5 | 0.075 | Análise visual e edição de textos, opção mais econômica |
gemini-4-carbon |
2 | 10 | 0.1 | Análise visual e edição de textos; preço introdutório válido até 2026-11-30 |
gemini-4-argon |
2 | 10 | 0.1 | Tarefas de texto e compreensão |
gemini-4-neon |
3 | 15 | 0.15 | Alternativa quando for preciso mais capacidade |
claude-fable-5-2 / claude-fable-5-2-thinking |
8 | 40 | 0.2 | Refinamento de textos longos, reescritas complexas |
gpt-6.2-astra |
8 (acima de 272000 tokens, 16) | 40 | 0.4 | Tarefas de texto mais exigentes |
Há dois pontos que merecem atenção. O gemini-4-carbon está com 2 / 10 / 0.1, igual ao preço introdutório do Google válido até 2026-11-30; a partir de 1º de dezembro, o preço padrão do Google passa a ser entrada 4 e saída 20, e o custo dobra. Antes de rodar lotes por longos períodos, vale conferir de novo. No gpt-6.2-astra, acima de 272000 tokens, a tabela geral informa entrada 16; nessa faixa, o endpoint de preços também traz saída 60 e leitura de cache 0.8. Se os dois registros divergirem, vale a cobrança efetiva no backend no momento da sua chamada. O gemini-4-neon não aparece na tabela geral desta versão, mas consta no endpoint de preços; o resultado da conversão bate com o preço de tabela do Google.
A etapa de capa é cobrada por chamada, então ela fica em uma tabela separada:
| ID do modelo de capa | Preço por chamada (USD) | Cenário adequado |
|---|---|---|
MAI-Image-2.6 |
0.12 | Capa principal, quando é preciso mais qualidade |
MAI-Image-2.6-Flash |
0.06 | Testes de várias versões |
gemini-3.1-flash-lite-image |
0.025 | Esboços em lote |
gemini-2.5-flash-image |
0.02 | Geração rápida de imagens com baixo custo |
Atenção: o MAI-Image-2.7 ainda não existe, então não coloque no script como um modelo disponível para chamada. Kling, Muse e gemini-4-flash-lite também não aparecem nem na tabela geral nem no endpoint de preços; exclua-os diretamente ao planejar o pipeline.
Terceiro passo: apontar a etapa paga para o mesmo base_url
A mudança aqui é mínima. Se você já usava o SDK oficial da OpenAI, basta alterar dois pontos:
- Trocar a
api_keypela chave gerada no painel do APIYI; - Definir o
base_urlcomohttps://api.apiyi.com/v1.
Depois disso, na requisição que analisa as imagens, escreva model como gemini-4-hydrogen; na que reescreve o texto, use claude-fable-5-2 ou continue com o Gemini; e na que gera a capa, use MAI-Image-2.6-Flash. As três etapas compartilham um único objeto cliente — a diferença está apenas no ID do modelo. As requisições de conversa vão para o endpoint compatível com OpenAI /chat/completions. Já os parâmetros específicos e o formato de retorno dos modelos de imagem seguem o que está descrito na documentação do modelo.
Ver a lista de configuração por etapa
– **Cliente**: inicialize uma única vez, mantenha o `base_url` inalterado e coloque a chave em uma variável de ambiente, por exemplo `APIYI_API_KEY`.
– **Analisar as imagens**: envie como entrada o screenshot do quadro-chave junto com a legenda transcrita localmente, e defina `model` como `gemini-4-hydrogen`; se o orçamento permitir ou você precisar de compreensão mais forte, troque para `gemini-4-carbon`.
– **Reescrever o texto**: use o resumo de cenas gerado no passo anterior como contexto e escolha `model` como `claude-fable-5-2`; para roteiros longos que exigem raciocínio em várias etapas, use `claude-fable-5-2-thinking`.
– **Gerar a capa**: comece com `gemini-2.5-flash-image` para criar algumas versões de rascunho e, depois de definir a versão final, gere a capa oficial com `MAI-Image-2.6`.
– **Cache**: as legendas de um mesmo vídeo são lidas repetidamente por várias etapas; mantenha o prefixo das partes compartilhadas o mais consistente possível para acertar o cache e pagar o preço de leitura.
– **Logs**: registre o ID do modelo e o consumo de tokens retornado em cada requisição e, no fim do mês, confira item por item com o consumo mostrado no painel.
🚀 Sugestão para começar rápido: primeiro use a cota gratuita de teste para novos usuários no APIYI apiyi.com, rode um vídeo curto de ponta a ponta com os três passos acima, anote o consumo real de tokens em cada etapa e só então decida qual tier de modelo usar para vídeos longos.
Etapa 4: estimar o orçamento de um vídeo
Na hora de estimar, separe o cálculo por token do cálculo por chamada. Um exemplo hipotético: se analisar as imagens e revisar o texto consumir, no total, 1 milhão de tokens de entrada e 100 mil tokens de saída, usando o gemini-4-hydrogen, isso dá 1,5 + 0,75, ou seja, cerca de US$ 2,25; para a capa, gerar 4 versões de rascunho no Flash e 1 versão final fica em 4 × 0,06 + 0,12, isto é, US$ 0,36. Os números de tokens aqui são só valores hipotéticos para demonstrar; o seu consumo real depende da duração do vídeo, da densidade de capturas de quadros e do número de rodadas de revisão do texto.
A vantagem desse método de estimativa é que cada item pode ser conferido linha por linha com a fatura do painel administrativo. Já se os quatro estágios estiverem espalhados por quatro fornecedores diferentes, câmbio, unidades de cobrança e momentos de débito são todos distintos — mesmo que o total não seja grande, a conciliação dá bastante trabalho.
Perguntas frequentes (FAQ)
Q1: Um vídeo passa por vários modelos — quais são exatamente as etapas?
Normalmente são quatro: transcrição, análise visual, reescrita do roteiro e criação da capa. Alguns fluxos ainda incluem dublagem ou clonagem de voz. A transcrição pode ser feita localmente com Whisper, sem custo de modelo; o que de fato gera custo de modelo costuma ser a análise visual, a criação da capa e a reescrita do roteiro.
Q2: Dividir tarefas e centralizar a cobrança são coisas contraditórias? Não seria mais simples usar só um modelo?
Não são contraditórias. Dividir tarefas serve para casar qualidade com custo; centralizar serve para fechar e conciliar a fatura. Usar um único modelo é de fato mais simples, mas análise visual, redação de roteiro e geração de imagens exigem capacidades muito diferentes, e forçar tudo em um só modelo costuma sair caro. O mais sensato é escolher um modelo para cada etapa e manter uma única porta de entrada para as chamadas.
Q3: Dá para usar os 2,71 dólares por vídeo longo como orçamento?
Não recomendo aplicar direto. Esse é um número relatado pelo próprio autor e reproduzido pela MindStudio, obtido via OpenRouter — não é a fatura do APIYI — e a combinação de modelos, o tamanho do vídeo e a quantidade de frames extraídos podem não bater com o seu caso. O caminho mais seguro é refazer a conta conforme o passo 4 deste artigo, usando seu próprio consumo de tokens e o preço unitário vigente.
Q4: Para análise visual, escolho gemini-4-hydrogen ou gemini-4-carbon?
Se o orçamento é prioridade, vá de `gemini-4-hydrogen`: entrada 1,5, saída 7,5, leitura de cache 0,075 — o menor preço unitário do grupo. Quando precisar de compreensão mais forte, escolha `gemini-4-carbon`, mas atenção: os valores 2 / 10 são preço promocional válido até 2026-11-30, e a partir de 1º de dezembro o preço padrão do Google passa a ser entrada 4 e saída 20, então vale reavaliar o preço antes de usar em longo prazo.
Q5: Como migro meus scripts atuais para a porta de entrada unificada?
Crie sua conta no APIYI apiyi.com e gere uma API Key, troque o `base_url` do SDK pelo endereço de chamada da plataforma e depois ajuste o campo `model` conforme a etapa. A estrutura de requisição praticamente não muda, e novos usuários têm crédito de teste gratuito — dá para validar toda a pipeline primeiro com um vídeo curto.
Q6: A clonagem de voz também passa por essa mesma porta de entrada?
Não. A clonagem de voz ainda não está no catálogo do APIYI; se você precisar dessa etapa, será em outro serviço, com contabilidade separada. Na hora de planejar o orçamento, sugiro colocá-la como uma linha própria, para não misturar com o consumo da porta de entrada unificada.
Q7: Existe alguma limitação conhecida que devo evitar de antemão?
Alguns pontos: `MAI-Image-2.7` ainda não existe, e Kling, Muse e `gemini-4-flash-lite` não aparecem na tabela geral nem na interface de preços — não inclua esses nomes no script. O `gpt-6.2-astra` sobe de preço acima de 272000 tokens, e os detalhes de faixa na tabela geral e na interface de preços divergem um pouco; vale o que for efetivamente cobrado. Os preços mudam, então antes de rodar o lote é melhor conferir de novo na tabela geral do dia.
Pontos-chave para usar vários modelos em um único vídeo
- Primeiro separar, depois conectar: mantenha a transcrição e a edição no ambiente local; conecte à API apenas as etapas que geram custo.
- Divisão de trabalho preservada: escolha o modelo mais adequado para analisar as cenas, revisar o texto e gerar a capa; não é preciso usar o mesmo modelo para tudo.
- Ponto de entrada unificado: as etapas pagas compartilham uma única chave e o mesmo base_url; para trocar de modelo, altere apenas o ID do modelo.
- Bases de cálculo separadas: texto e visão são cobrados por token; a capa, por execução. Calcule o orçamento em duas colunas.
- Atenção à vigência: o preço introdutório do
gemini-4-carbonvale até 2026-11-30; depois disso, o preço padrão aumenta. - Fora do catálogo, linha separada: a clonagem de voz não está na entrada unificada e precisa ser contabilizada à parte.
- Números externos são apenas referência: os US$ 2,71 são uma declaração do autor no OpenRouter, não uma fatura da APIYI.
Resumo
Usar vários modelos em um único vídeo não é um problema em si; o problema é a fatura ficar fragmentada e não fechar. Resumindo, são três pontos:
- Prioridade ao local: use o Whisper local para transcrever e faça a edição localmente; essas duas etapas não geram custo de modelo.
- Pagamento centralizado: análise de cenas, revisão de texto e geração de capa passam por um único base_url, com divisão por ID do modelo.
- Calcule pelo preço do dia: estime separadamente por token e por execução; antes de rodar em lote, confira novamente os preços e os modelos disponíveis.
A sugestão é pegar primeiro um vídeo curto e rodar o pipeline inteiro de ponta a ponta, anotando o uso real de cada etapa, para depois ampliar para vídeos longos. Recomendo fazer essa validação na APIYI apiyi.com com a cota gratuita de teste; a divisão de trabalho continua a mesma e você só precisa olhar uma entrada para a fatura.
📚 Referências
-
Tabela geral de modelos da APIYI: visão geral de modelos e preços unitários
- Link:
docs.apiyi.com/models.md - Descrição: principal fonte dos preços deste artigo; esta versão foi atualizada em 2026-11-19 10:59 (UTC+8)
- Link:
-
API de preços da APIYI: preços em tempo real convertidos por multiplicador
- Link:
api.apiyi.com/api/pricing - Descrição: versão
shell-api-modelmak-v1;model_ratioigual a 1 corresponde a entrada de US$ 2 por milhão de tokens
- Link:
-
Transcrição do recurso de edição de vídeo do MindStudio: publicado em 2026-11-19
- Descrição: a afirmação de US$ 2.71 por um vídeo longo vem da declaração do próprio autor reproduzida nesse texto, usando o OpenRouter
Autor: equipe técnica da APIYI
Contato técnico: fique à vontade para falar conosco pela página inicial do site oficial da APIYI; para mais modelos e instruções de invocação, consulte a central de documentação em docs.apiyi.com


