
작성자 노트: 영상 하나를 만들려면 음성 전사, 화면 확인, 썸네일 제작, 대본 수정까지 거쳐야 해요. 모델은 각자 맡은 역할을 하면 되지만, 비용이 발생하는 단계는 가급적 같은 base_url로 모아야 청구서를 맞출 수 있어요.
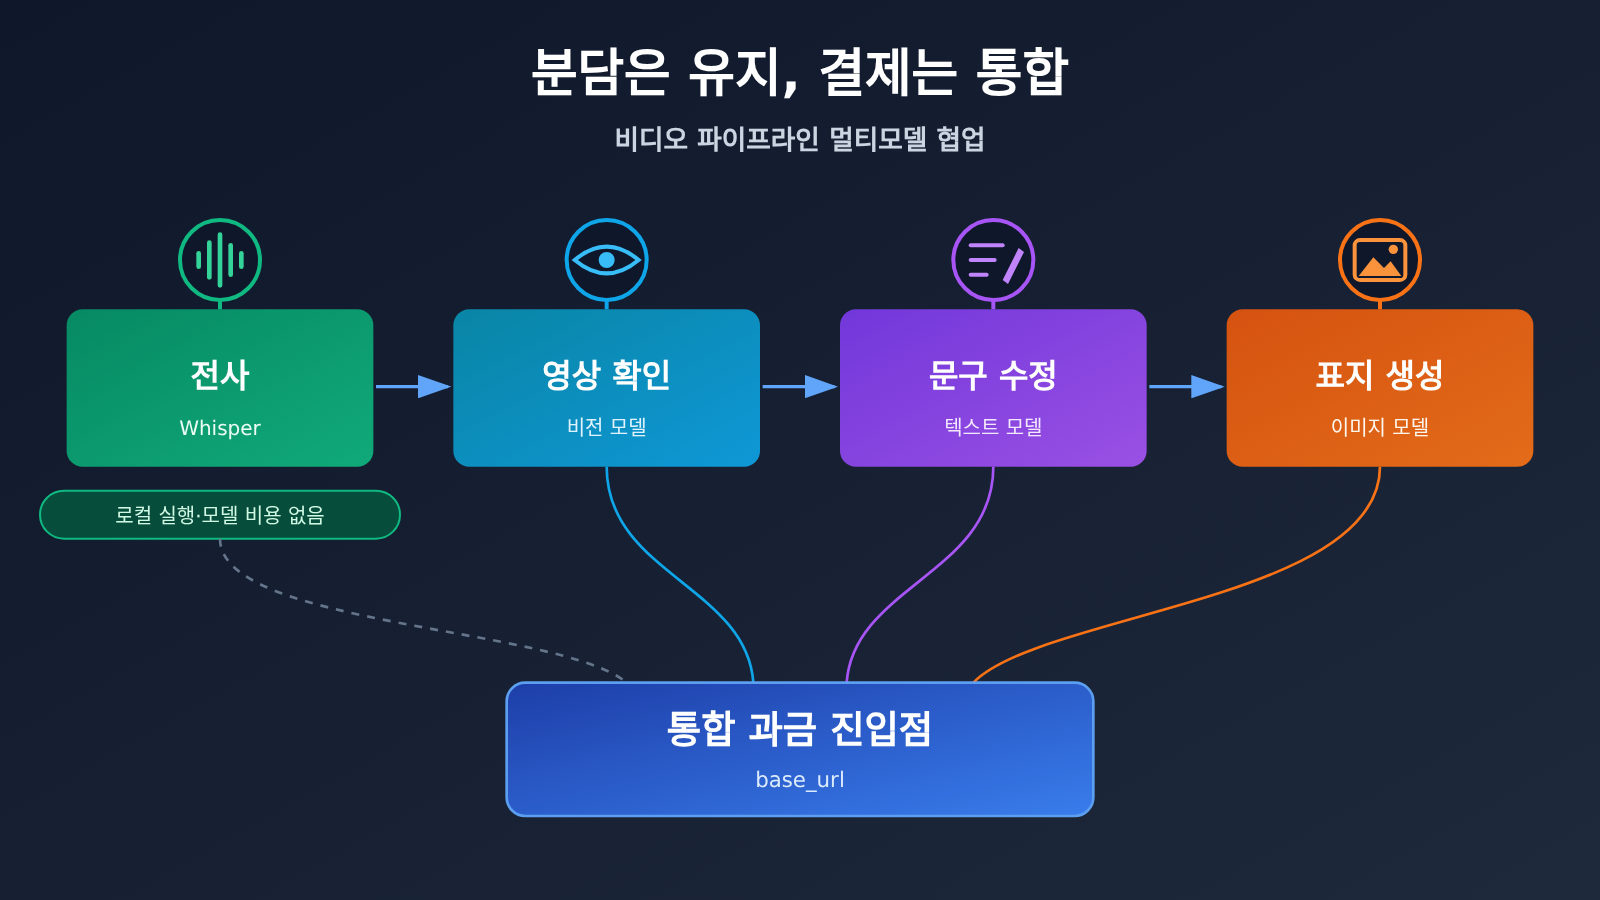
긴 영상을 하나 끝까지 만들어 본 적이 있다면, 대개 이런 현상을 발견하게 돼요. 전사는 A 서비스, 화면 확인은 B 서비스, 썸네일은 또 C 서비스, 제목과 대본 수정은 새 창을 하나 더 열어서 처리하게 되죠. 각 단계만 따로 보면 다 합리적이에요. 그런데 월말에 장부를 맞추면 기준이 서로 다른 청구서가 네다섯 장 쌓여 있어요. token 기준으로 매기는 것도 있고, 호출 횟수 기준도 있고, 구독이 섞여 있는 경우도 있고요. 이 글에서 말하려는 건 분업은 유지하고, 청구서는 한곳으로 모으기예요. 먼저 어느 단계가 로컬에 남을 수 있는지, 어디서 실제로 비용이 발생하는지 구분하고, 그다음 과금 단계를 같은 호출 진입점으로 모으는 거예요.
이건 모델 하나만 쓰라는 권유가 아니에요. 단계마다 원래 다른 모델이 더 잘 맞는 경우가 많아요. 진짜로 통일해야 하는 건 모델 자체가 아니라 과금 진입점과 정산 기준이에요.
핵심 가치: 이 글을 읽고 나면 영상 파이프라인의 ‘로컬 / 과금’ 분리표와, 2026-11-20 기준으로 확인한 모델·가격 대조표, 그리고 과금 단계를 같은 base_url로 옮기는 방법을 얻을 수 있어요.
영상 한 편에 여러 모델을 연결할 때의 핵심 포인트
이번 논의의 출발점은 MindStudio가 2026-11-19에 소개한 영상 편집 스킬이에요. 작성자는 고급 멀티모달 파이프라인으로 긴 영상 한 편을 만드는 데 약 2.71달러가 들었다고 밝혔어요. 분명히 해둘 점은, 이 숫자가 작성자 본인의 설명이며 OpenRouter를 거친 비용이라는 거예요. APIYI의 청구서도, 이 글의 측정 결과도 아니죠. 이 숫자의 참고 가치는 영상 한 편의 모델 비용을 아주 낮은 수준으로 유지할 수 있다는 점에 있어요. 물론 비용이 어느 단계에 쓰이는지 알고 있다는 전제가 필요하죠.
| 항목 | 설명 | 가치 |
|---|---|---|
| 로컬과 유료 작업을 먼저 분리 | 전사는 로컬 Whisper로 처리해 모델 비용을 내지 않아요 | 청구서가 하나 줄고, 외부로 전송되는 데이터도 줄어요 |
| 유료 단계를 한곳에 모으기 | 화면 보기, 대본 수정, 썸네일 생성이 같은 base_url을 사용 | 하나의 백엔드에서 모든 소비를 확인 |
| 모델 교체는 ID만 변경 | 인터페이스가 OpenAI와 호환되므로 전환할 때 model 필드만 바꿔요 |
역할 분담을 언제든 조정할 수 있고 코드를 다시 작성할 필요가 없어요 |
| 호출당·토큰당 비용 분리 | 썸네일은 호출당, 텍스트와 비전은 토큰당 | 예산 추정 기준이 명확 |
| 카탈로그 밖 단계는 별도 기록 | 음성 클로닝은 APIYI 카탈로그에 없어요 | 정산할 때 잘못 계산하지 않아요 |
영상 파이프라인 역할 분담의 핵심
첫 번째 포인트는 ‘분업’ 자체예요. 영상 화면을 보고 샷 내용을 이해하려면 멀티모달 이해 능력이 강하고 긴 컨텍스트를 처리할 수 있는 모델이 필요해요. 썸네일 생성에는 이미지 생성 모델이 필요하죠. 대본 수정은 작성 품질과 비용에 더 민감해요. 이 작업들을 억지로 하나의 모델에 몰아넣으면 어느 한 단계의 품질이 떨어지거나 비용이 높아지기 쉬워요. 그래서 분업 자체는 합리적이고, 문제는 각 공급사마다 계정을 따로 열고, 따로 충전하고, 따로 청구서를 받는 데서 생겨요.
두 번째 포인트는 ‘한곳으로 모으기’예요. APIYI(apiyi.com)는 대규모 언어 모델 API를 모아 제공하는 플랫폼으로, 하나의 API 키로 OpenAI, Claude, Gemini 같은 주류 모델을 호출할 수 있고 인터페이스는 OpenAI와 호환되며 사용량 기반으로 과금해요. 영상 파이프라인에서는 화면 보기, 대본 수정, 썸네일 생성 같은 유료 단계가 하나의 키, 하나의 base_url을 공유하고 사용량이 한곳에 통합 기록된다는 뜻이에요. 모델을 바꿀 때는 모델 ID만 바꾸면 되고, 공급사를 바꾸거나 SDK를 교체할 필요는 없어요.
영상 한 편에 여러 모델을 호출할 때 빠르게 시작하기
첫 번째 단계: 영상 파이프라인을 로컬과 유료로 나누기
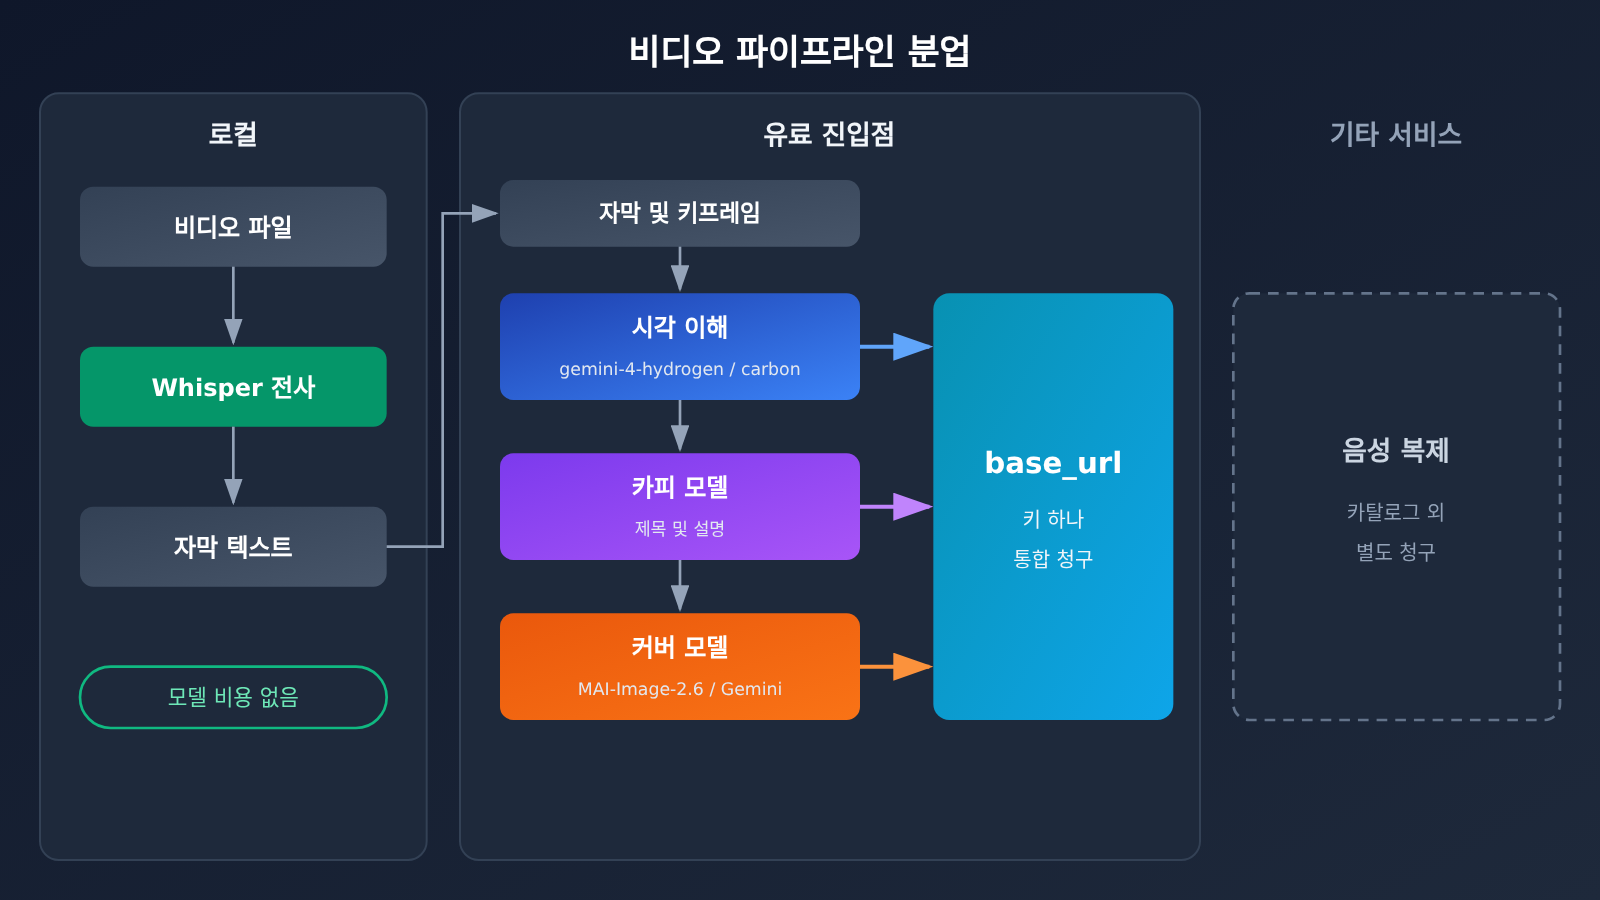
API를 연결하기 전에 각 단계의 과금 특성을 먼저 정리하세요. 아래 표는 긴 영상 파이프라인의 대표적인 분리 방식이며, 자신의 워크플로에 맞게 항목을 추가하거나 삭제할 수 있어요.
| 단계 | 권장 실행 위치 | 모델 비용 발생 여부 | 과금 기준 |
|---|---|---|---|
| 오디오 전사 | 로컬 Whisper | 아니요 | 로컬 연산력만 사용 |
| 편집, 이어 붙이기, 내보내기 | 로컬 편집 도구 | 아니요 | 없음 |
| 화면 확인, 장면 이해 | 통합 API 엔드포인트 | 예 | 입력 / 출력 토큰 기준 |
| 제목 수정, 소개 문구 작성 | 통합 API 엔드포인트 | 예 | 입력 / 출력 토큰 기준 |
| 커버 이미지 생성 | 통합 API 엔드포인트 | 예 | 호출당 |
| 음성 클론 | 기타 서비스 | 예 | APIYI 카탈로그에 없음, 별도 정산 |
이렇게 나누면 실제로 하나로 묶어 관리해야 할 유료 단계는 세 개뿐이에요. 전사는 로컬에서 처리하므로 모델 비용이 들지 않고, 원본 오디오를 업로드할 필요도 없어요. 음성 클론이 정말 필요하다면 이는 별도의 청구서가 되므로, 예산에서 따로 배정하고 통합 엔드포인트 비용에 포함하지 마세요.
2단계: 모델 확인 및 가격 확인
다음은 모델을 확인하고 가격을 비교하는 단계예요. 아래 가격은 2026-11-20 기준으로 확인한 것이며, 출처는 APIYI의 모델 총괄표 docs.apiyi.com/models.md(해당 버전은 2026-11-19 10:59 UTC+8에 업데이트됨)와 가격 책정 API api.apiyi.com/api/pricing(버전 shell-api-modelmak-v1)예요. 가격 책정 API에서 model_ratio가 1일 때 입력 2달러/백만 토큰에 해당하니, 이를 기준으로 직접 환산할 수 있어요.
| 모델 ID | 입력(달러/백만 토큰) | 출력 | 캐시 읽기 | 적합한 단계 |
|---|---|---|---|---|
gemini-4-hydrogen |
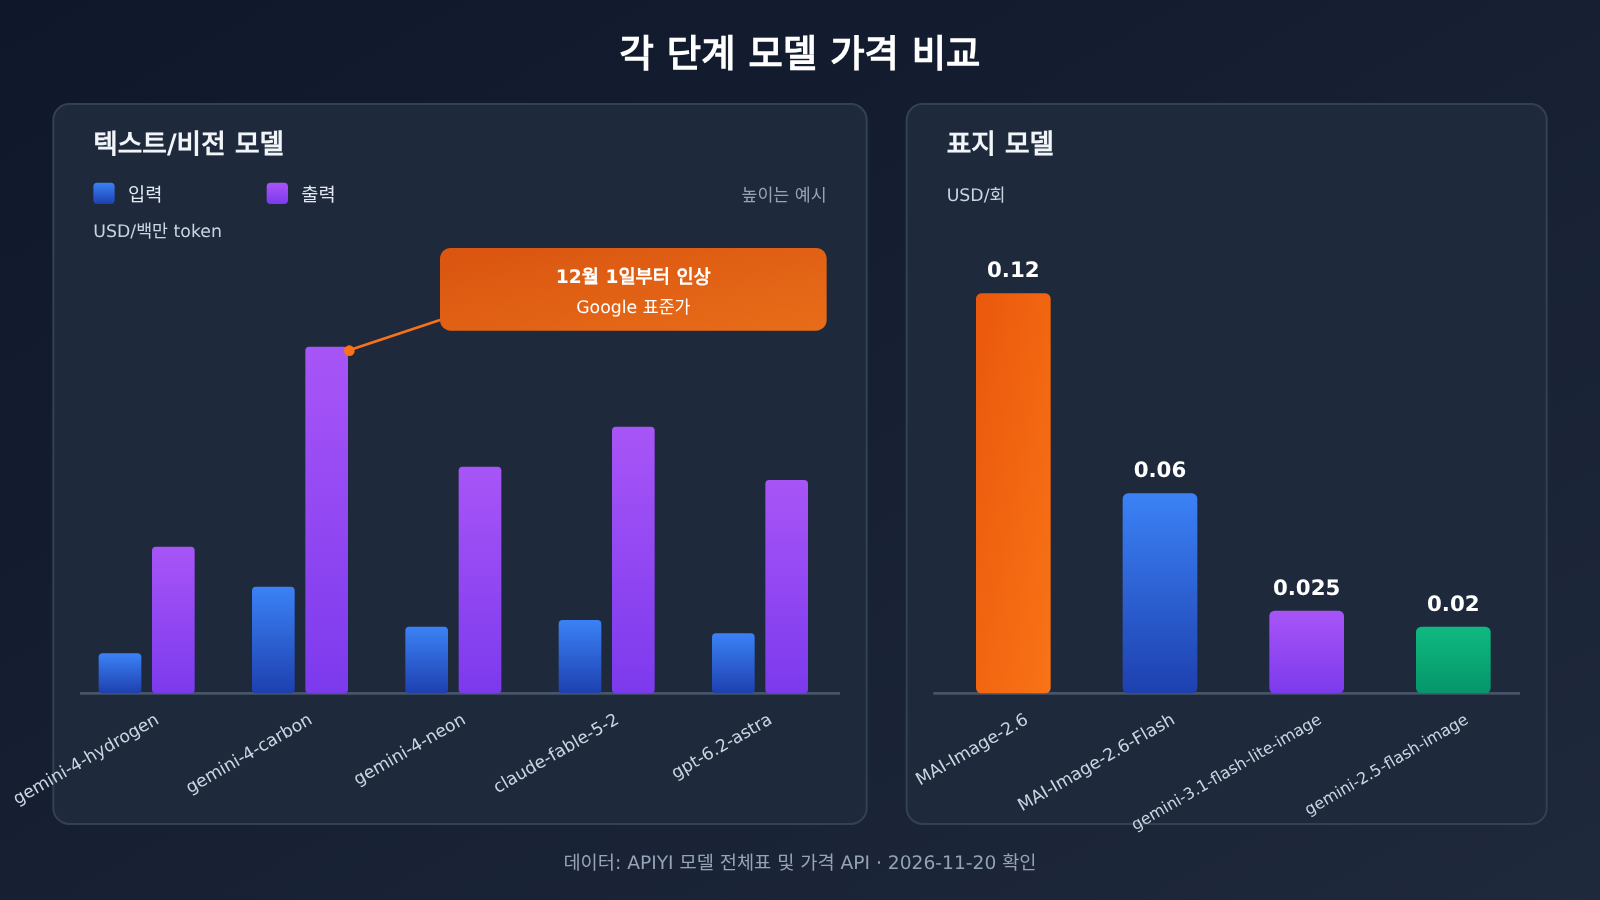
1.5 | 7.5 | 0.075 | 화면 확인, 문안 수정, 비용 우선 |
gemini-4-carbon |
2 | 10 | 0.1 | 화면 확인, 문안 수정, 도입가 2026-11-30까지 |
gemini-4-argon |
2 | 10 | 0.1 | 텍스트 및 이해형 작업 |
gemini-4-neon |
3 | 15 | 0.15 | 더 강한 성능이 필요할 때의 대안 |
claude-fable-5-2 / claude-fable-5-2-thinking |
8 | 40 | 0.2 | 긴 문안 다듬기, 복잡한 재작성 |
gpt-6.2-astra |
8(272000 token 초과 시 16) | 40 | 0.4 | 높은 요구사항의 텍스트 작업 |
특히 주의할 두 가지가 있어요. gemini-4-carbon의 2 / 10 / 0.1은 Google의 2026-11-30까지 적용되는 도입가와 일치해요. 12월 1일부터 Google 표준가는 입력 4, 출력 20이 되므로 그때부터 비용이 두 배로 뛰어요. 장기 배치 작업을 돌리기 전에 다시 확인해야 해요. gpt-6.2-astra는 272000 token을 넘으면 총괄표에는 입력 16으로 적혀 있지만, 가격 책정 API는 이 구간에서 출력 60, 캐시 읽기 0.8도 함께 제시해요. 두 기준이 다르니 실제 호출 시 백엔드에서 청구되는 금액을 기준으로 삼아야 해요. gemini-4-neon은 이번 버전 총괄표에는 없지만 가격 책정 API에는 기록이 있고, 환산 결과는 Google 표가와 일치해요.
표지(커버) 단계는 호출당 과금이라 별도 표로 정리했어요.
| 표지 모델 ID | 회당 가격(달러) | 적합한 시나리오 |
|---|---|---|
MAI-Image-2.6 |
0.12 | 메인 표지, 더 높은 품질이 필요할 때 |
MAI-Image-2.6-Flash |
0.06 | 여러 버전 시안 |
gemini-3.1-flash-lite-image |
0.025 | 대량 스케치 |
gemini-2.5-flash-image |
0.02 | 저비용 빠른 이미지 생성 |
주의할 점은 MAI-Image-2.7은 아직 없으니 스크립트에 호출 가능한 모델로 적으면 안 돼요. Kling, Muse, 그리고 gemini-4-flash-lite도 총괄표와 가격 책정 API에 없으니 파이프라인을 설계할 때 바로 제외하면 돼요.
3단계: 유료 단계를 동일한 base_url로 전환하기
이 단계에서 바꿀 것은 아주 적어요. 기존에 OpenAI 공식 SDK를 사용했다면 두 군데만 수정하면 됩니다:
api_key를 APIYI 백엔드에서 생성한 Key로 교체;base_url을https://api.apiyi.com/v1로 설정.
그다음 화면을 보는 요청에는 model을 gemini-4-hydrogen으로, 대본 수정 요청에는 claude-fable-5-2 또는 계속 Gemini를, 썸네일 생성에는 MAI-Image-2.6-Flash를 적으면 돼요. 세 단계가 클라이언트 객체 하나를 공유하고, 차이는 모델 ID뿐이에요. 대화형 요청은 OpenAI 호환 /chat/completions로 보내고, 이미지 모델의 구체적인 파라미터와 반환 형식은 모델 문서의 설명을 기준으로 하세요.
단계별 설정 체크리스트 보기
– **클라이언트**: 한 번만 초기화하고 `base_url`은 그대로 유지하며, Key는 환경 변수에 넣어요. 예: `APIYI_API_KEY`.
– **화면 보기**: 키프레임 스크린샷과 로컬에서 전사한 자막을 함께 입력으로 넣고, `model`은 `gemini-4-hydrogen`으로 설정해요. 예산이 넉넉하거나 더 강한 이해가 필요하면 `gemini-4-carbon`으로 바꿔요.
– **대본 수정**: 이전 단계에서 출력한 장면 요약을 컨텍스트로 넣고, `model`은 `claude-fable-5-2`를 선택해요. 여러 단계 추론이 필요한 긴 원고에는 `claude-fable-5-2-thinking`을 사용할 수 있어요.
– **썸네일 생성**: 먼저 `gemini-2.5-flash-image`로 초안 몇 개를 뽑고, 최종 확정 후 `MAI-Image-2.6`으로 정식 썸네일을 만들어요.
– **캐시**: 같은 영상의 자막은 여러 단계에서 반복해서 읽히니까, 공통 부분의 프리픽스를 최대한 일관되게 유지해서 캐시 읽기 요금이 적용되도록 해요.
– **로그**: 요청마다 모델 ID와 반환된 토큰 사용량을 기록하고, 월말에 백엔드 소비량과 항목별로 대조해요.
🚀 빠른 시작 제안: 먼저 APIYI apiyi.com에서 신규 사용자용 무료 테스트 크레딧으로 짧은 영상 하나를 위 세 단계대로 끝까지 실행해 보고, 각 단계의 실제 토큰 사용량을 기록한 뒤 긴 영상에 어떤 등급의 모델을 쓸지 결정하세요.
4단계: 영상 한 편의 예산 추정하기
추정할 때는 토큰 기준과 호출 횟수 기준을 나눠서 계산해요. 가상의 예를 하나 들어볼게요. 화면을 보고 문안을 수정하는 과정에서 입력 토큰 100만 개, 출력 토큰 10만 개를 소비했다면 gemini-4-hydrogen 기준으로 1.5 + 0.75, 약 2.25달러예요. 여기에 커버 이미지로 Flash 초안 4개와 최종본 1개를 만들면 4 × 0.06 + 0.12, 즉 0.36달러가 돼요. 여기서 든 토큰 수는 설명을 위한 가정값일 뿐이고, 실제 사용량은 영상 길이, 프레임 추출 밀도, 문안 수정 횟수에 따라 달라져요.
이 추정 방식의 장점은 각 항목을 백엔드 청구서와 한 줄씩 대조할 수 있다는 점이에요. 반대로 네 단계가 네 곳의 서비스에 흩어져 있다면 환율, 과금 단위, 결제 시점이 모두 달라서 총액이 크지 않더라도 대조 작업에 시간이 꽤 들거든요.
자주 묻는 질문(FAQ)
Q1: 영상 하나에 여러 모델을 쓴다는데, 정확히 어느 단계를 말하는 걸까요?
일반적으로 전사(스크립트 추출), 화면 확인, 대본 수정, 썸네일 생성 이렇게 네 단계이고, 일부 워크플로에는 음성 더빙이나 음성 클로닝까지 붙기도 해요. 이 가운데 전사는 로컬 Whisper로 처리할 수 있어서 모델 비용이 들지 않아요. 실제로 모델 비용이 발생하는 건 대개 화면 확인, 썸네일 생성, 대본 수정 단계입니다.
Q2: 역할 분담과 단일 진입점은 충돌하지 않나요? 모델 하나만 쓰는 게 더 간편하지 않을까요?
충돌하지 않아요. 역할 분담은 품질과 비용을 맞추기 위한 것이고, 단일 진입점은 청구서와 정산을 간편하게 하기 위한 거예요. 모델을 하나만 쓰면 확실히 편하지만, 화면 확인·대본 작성·이미지 생성이 요구하는 능력 차이가 워낙 커서 억지로 하나로 묶으면 오히려 손해를 보는 경우가 많아요. 모델은 각 단계에 맞게 따로 고르고, 호출 진입점만 하나로 유지하는 쪽이 더 합리적이에요.
Q3: 긴 영상 한 편에 2.71달러라는 숫자를 그대로 예산으로 잡아도 될까요?
그대로 적용하는 건 권장하지 않아요. 이건 MindStudio가 전한 작성자 본인의 언급 수치이고, OpenRouter를 사용한 결과라서 APIYI 청구서와는 다르고, 모델 조합이나 영상 길이, 프레임 추출 개수도 여러분의 환경과 같지 않을 수 있어요. 더 안전한 방법은 이 글의 4단계에 따라 본인의 토큰 사용량과 현재 단가로 다시 계산해 보는 거예요.
Q4: 화면 확인에는 gemini-4-hydrogen을 써야 할까요, gemini-4-carbon을 써야 할까요?
예산을 우선한다면 `gemini-4-hydrogen`을 선택하세요. 입력 1.5, 출력 7.5, 캐시 읽기 0.075로 이 조합에서 단가가 가장 낮아요. 더 강한 이해력이 필요하면 `gemini-4-carbon`을 선택하면 되는데, 여기서 2 / 10은 2026-11-30까지의 소개 가격이라는 점에 주의해야 해요. Google은 12월 1일부터 표준 가격을 입력 4, 출력 20으로 적용하니 장기간 사용 전에는 단가를 다시 확인하세요.
Q5: 기존 스크립트를 단일 진입점으로 바꾸려면 어떻게 해야 하나요?
APIYI apiyi.com에서 가입하고 API 키를 생성한 뒤, SDK의 `base_url`을 플랫폼 호출 주소로 바꾸고 각 단계에 맞춰 `model` 필드만 수정하면 돼요. 기존 요청 구조는 거의 손댈 필요가 없고, 신규 사용자에게는 무료 테스트 크레딧도 제공되니 짧은 영상 하나로 전체 파이프라인을 먼저 검증해 보세요.
Q6: 음성 클로닝도 이 진입점으로 함께 처리할 수 있나요?
안 돼요. 음성 클로닝은 현재 APIYI에서 제공하지 않으므로, 이 단계가 필요하다면 다른 서비스를 사용하고 별도로 비용을 기록해야 해요. 예산을 계획할 때는 단일 진입점 소비와 섞이지 않도록 독립된 항목으로 분리해 두는 걸 권장해요.
Q7: 미리 피해야 할 알려진 제약이 있나요?
몇 가지 있어요. `MAI-Image-2.7`은 현재 없고, Kling, Muse, `gemini-4-flash-lite`도 전체 목록 표와 가격 API에서 확인되지 않으니 스크립트에 넣지 마세요. `gpt-6.2-astra`는 272000 token을 넘으면 단가가 인상되며, 전체 목록 표와 가격 API의 구간 정보가 조금 다르니 실제 청구 금액을 기준으로 하는 게 안전해요. 가격은 변동될 수 있으니 배치 작업 전에는 당일 모델 전체 목록 표로 한 번 더 확인하는 게 좋아요.
하나의 영상에 여러 모델을 연결할 때의 핵심 포인트 Key Takeaways
- 먼저 나누고, 그다음 연결: 전사와 편집은 로컬에 두고, 비용이 발생하는 단계만 API에 연결해요.
- 역할 분담 유지: 화면 검토, 카피 수정, 표지 생성에 각각 가장 적합한 모델을 고르면 되고, 굳이 하나로 통일할 필요는 없어요.
- 진입점 일원화: 유료 단계는 하나의 Key와 base_url을 공유하고, 모델을 바꿀 때는 모델 ID만 바꿔요.
- 기준 분리: 텍스트와 비전은 token 기준으로, 표지는 건당 기준으로 계산하고, 예산은 두 칸으로 나눠 잡아요.
- 적용 기간 확인:
gemini-4-carbon소개가는 2026-11-30까지이고, 이후에는 표준가로 인상돼요. - 목록 외 항목은 별도 처리: 음성 복제는 통합 진입점에 포함되지 않으니 반드시 따로 회계 처리해야 해요.
- 외부 숫자는 참고용: 2.71달러는 작성자가 OpenRouter에서 직접 밝힌 값이며, APIYI 청구서가 아니에요.
정리
하나의 영상에 여러 모델을 연결하는 것 자체는 문제가 아니에요. 문제는 청구서가 쪼개져서 서로 맞지 않는다는 점이죠. 정리하면 세 가지예요.
- 로컬 우선: 전사는 로컬 Whisper로, 편집은 로컬에서 끝내요. 이 두 단계에서는 모델 비용이 발생하지 않아요.
- 비용 단계 일원화: 화면 검토, 카피 수정, 표지 생성은 하나의 base_url로 통일하고 모델 ID로 역할을 나눠요.
- 당일 가격으로 정산: token 기준과 건당 기준을 나눠 추정하고, 배치를 돌리기 전에 가격과 판매 중인 모델을 다시 확인해요.
짧은 영상 하나로 전체 파이프라인을 먼저 끝까지 돌려보고, 각 단계의 실제 사용량을 기록한 다음 긴 영상으로 확장하는 걸 권해요. APIYI(apiyi.com)에서 무료 테스트 크레딧으로 이번 검증을 마치기를 추천해요. 역할 분담은 그대로 두고, 청구서는 하나의 진입점만 보면 돼요.
📚 참고 자료
-
APIYI 모델 전체 목록 : 모델명과 단가 개요
- 링크:
docs.apiyi.com/models.md - 설명: 이 글 가격 정보의 주요 출처로, 해당 버전은 2026-11-19 10:59(UTC+8)에 업데이트되었습니다
- 링크:
-
APIYI 가격 API : 배율 기준으로 환산된 실시간 가격
- 링크:
api.apiyi.com/api/pricing - 설명: 버전
shell-api-modelmak-v1,model_ratio가 1일 때 입력 2달러/백만 token에 해당합니다
- 링크:
-
MindStudio 영상 편집 스킬 관련 인용 : 2026-11-19 공개
- 설명: 2.71달러로 롱폼 영상 한 편을 만든다는 내용은 해당 글에서 인용한 작성자 본인의 설명에서 나온 것으로, OpenRouter를 사용한 경우입니다
작성자: APIYI 기술팀
기술 문의: APIYI 공식 사이트 홈페이지에서 저희에게 연락해 주세요. 더 많은 모델명과 호출 설명은 docs.apiyi.com 문서 센터에서 확인하실 수 있습니다


