
Nota del autor: para producir un video hay que transcribir, revisar las imágenes, generar la portada y reescribir el guion; los modelos pueden repartirse el trabajo, pero conviene concentrar los pasos de pago en una misma base_url para que las cuentas cuadren.
Si alguna vez has sacado adelante un video largo de principio a fin, probablemente te habrás topado con un fenómeno recurrente: una empresa para transcribir, otra para analizar las imágenes, otra más para la portada, y aún otra ventana para reescribir el título y el guion. Cada paso, visto por separado, parece razonable; pero al hacer cuentas a fin de mes aparecen cuatro o cinco facturas con criterios distintos: unas cobran por token, otras por llamada, y otras mezclan suscripciones. De eso trata este artículo: mantener la división del trabajo y unificar la facturación; primero aclarar qué paso puede quedarse en local y cuál genera realmente costos, y después concentrar los pasos de pago en un mismo punto de entrada de llamadas.
Esto no es una invitación a usar un solo modelo. Cada etapa se presta naturalmente para modelos distintos; lo que de verdad hay que unificar es el punto de entrada de facturación y el criterio de conciliación, no el modelo en sí.
Valor principal: al terminar de leer tendrás una tabla que separa lo «local / de pago» en el pipeline de video, una comparativa de modelos y precios verificada el 2026-11-20, y el procedimiento para conmutar los pasos de pago a una misma base_url.
Puntos clave para usar varios modelos en un solo video
El punto de partida de esta conversación es una habilidad de edición de video que MindStudio mencionó el 19 de noviembre de 2026. Según el autor, completar un video largo con un pipeline multimodal avanzado cuesta aproximadamente 2.71 USD. Conviene aclarar que esta cifra es lo que afirma el propio autor, que pasó por OpenRouter; no es una factura de APIYI ni una medición de este artículo. Su valor de referencia está en que el costo de modelos por video puede mantenerse en un nivel muy bajo, siempre que sepas en qué pasos se gasta el dinero.
| Punto | Explicación | Valor |
|---|---|---|
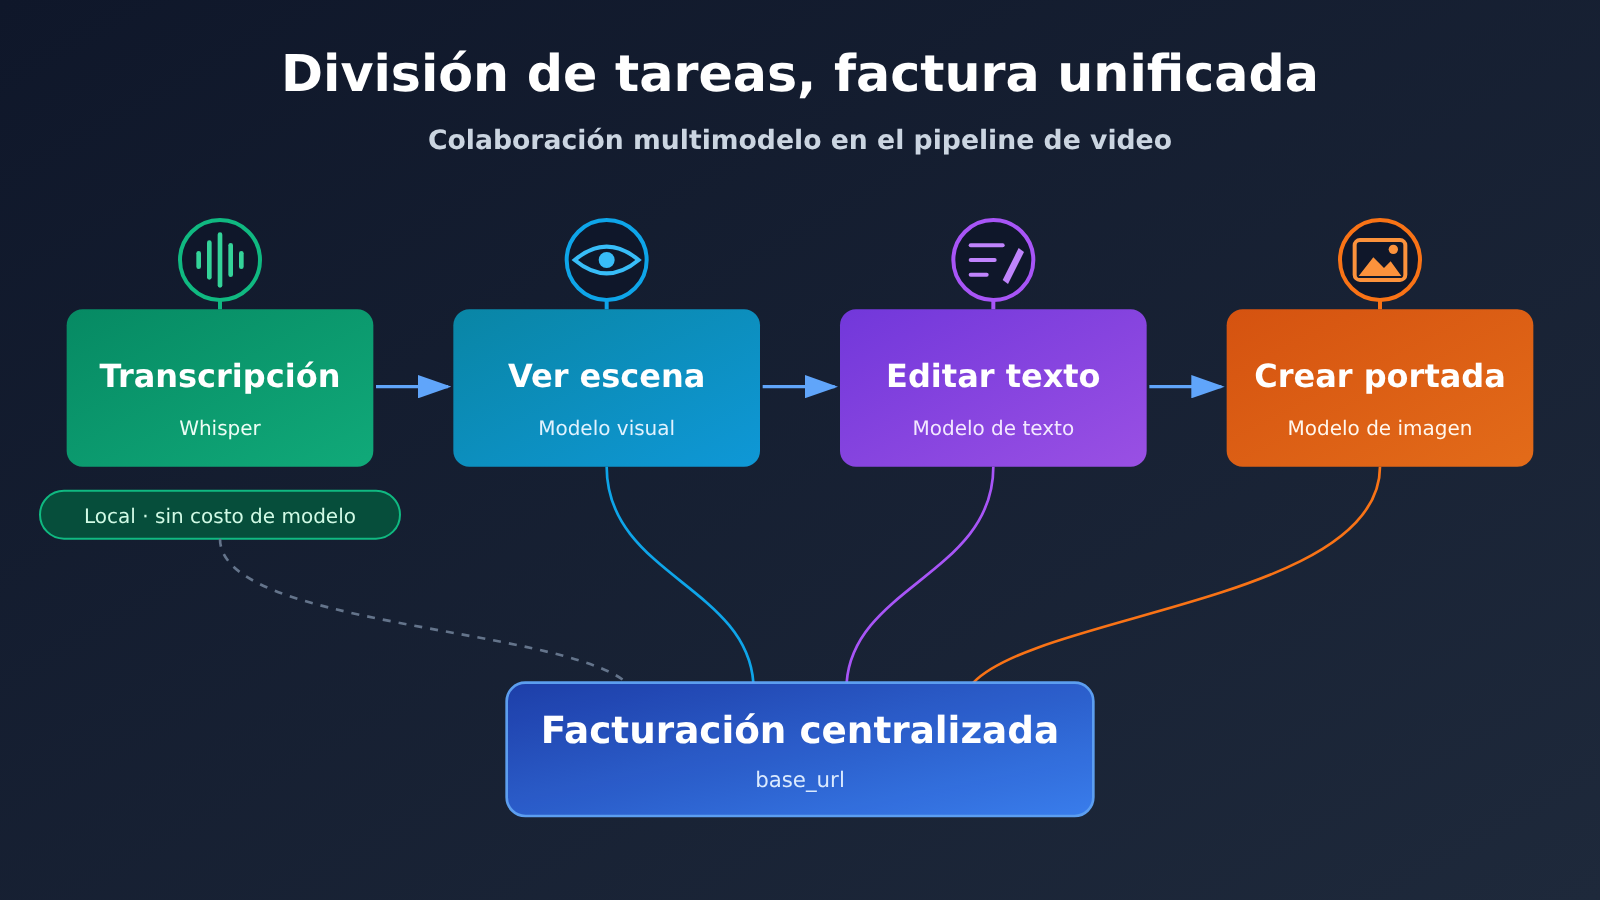
| Separa lo local de lo pago | La transcripción puede usar Whisper local, sin pagar modelo | Una factura menos y menos datos enviados al exterior |
| Concentra los pasos de pago | Ver las imágenes, editar el texto y generar la portada pasan por el mismo base_url | Todo el consumo visible desde un solo panel |
| Cambiar de modelo solo implica cambiar el ID | La interfaz es compatible con OpenAI; al cambiar, modifica el campo model |
Puedes reasignar tareas cuando quieras sin reescribir código |
| Calcular por llamada y por token por separado | La portada se cobra por llamada; el texto y la visión, por token | Criterio claro para estimar el presupuesto |
| Registrar aparte los pasos fuera del catálogo | La clonación de voz no está en el catálogo de APIYI | Evitas errores al conciliar cuentas |
Detalle de la división de tareas en el pipeline de video
El primer punto es la propia «división de tareas». Para mirar las imágenes de un video y entender el contenido de las tomas, hace falta un modelo con buena comprensión multimodal y capacidad para manejar contextos largos; generar la portada requiere un modelo de generación de imágenes; y editar el texto depende más de la calidad de redacción y del costo. Forzar todas estas tareas en un mismo modelo suele hacer que alguna parte pierda calidad o que alguna etapa salga más cara. Por eso la división tiene sentido; el problema aparece cuando cada proveedor exige abrir una cuenta, recargar por separado y tener su propia factura.
El segundo punto es «concentrar todo en un solo punto de entrada». APIYI apiyi.com es una plataforma de agregación de API para Modelos de Lenguaje Grande: con una sola clave API puedes invocar modelos populares como OpenAI, Claude y Gemini; la interfaz es compatible con OpenAI y el cobro es por uso. Para el pipeline de video, esto significa que los pasos de pago —mirar las imágenes, editar el texto y generar la portada— pueden compartir una sola clave y un solo base_url, con el consumo registrado en un único lugar. Cuando cambias de modelo, solo cambias el ID del modelo, no de proveedor ni de SDK.
Guía rápida para coordinar varios modelos en un mismo video
Primer paso: dividir el pipeline de video en dos partes, local y de pago
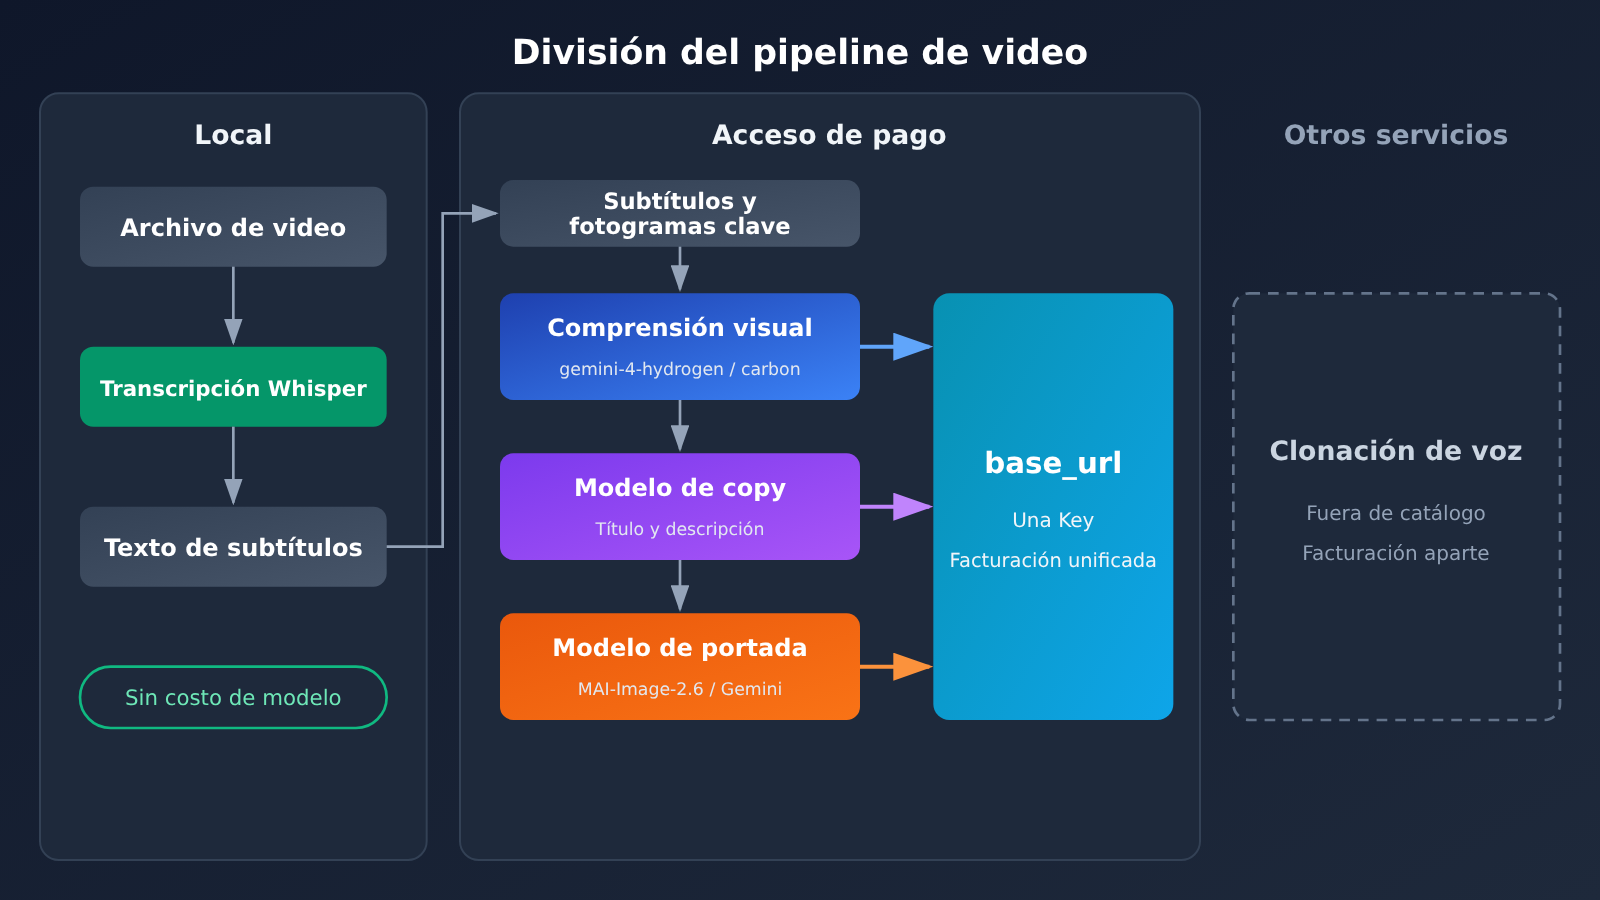
Antes de empezar a conectar APIs, conviene tener claro qué tipo de facturación genera cada etapa. La siguiente tabla muestra cómo se suele dividir un pipeline típico de video largo; puedes añadir o quitar etapas según tu propio flujo.
| Etapa | Dónde conviene ejecutarla | ¿Genera costo de modelo? | Base de facturación |
|---|---|---|---|
| Transcripción de audio | Whisper local | No | Solo consume cómputo del equipo local |
| Edición, unión y exportación | Herramienta de edición local | No | Ninguno |
| Analizar imágenes y entender planos | Entrada unificada de API | Sí | Por tokens de entrada/salida |
| Reescribir títulos y redactar descripciones | Entrada unificada de API | Sí | Por tokens de entrada/salida |
| Generar portada | Entrada unificada de API | Sí | Por operación |
| Clonación de voz | Otro servicio | Sí | No está en el catálogo de APIYI; se contabiliza aparte |
Con esta división, en realidad solo hay que consolidar tres etapas de pago. La transcripción se queda en local: no pagas tarifa de modelo y además no necesitas subir el audio original. Si realmente necesitas clonación de voz, será una factura independiente; resérvala por separado en el presupuesto y no la mezcles con la entrada unificada.
Paso 2: Confirmar modelo y precio
Ahora toca buscar el modelo y contrastar el precio. Los precios que siguen están verificados a fecha de 2026-11-20; la fuente es la tabla general de modelos de APIYI docs.apiyi.com/models.md (esa versión se actualizó el 2026-11-19 a las 10:59, UTC+8) y la interfaz de precios api.apiyi.com/api/pricing (versión shell-api-modelmak-v1). En la interfaz de precios, cuando model_ratio vale 1, equivale a 2 dólares por millón de tokens de entrada, así que a partir de ahí puedes hacer tus propias conversiones.
| ID del modelo | Entrada (USD/millón de tokens) | Salida | Lectura de caché | Etapa adecuada |
|---|---|---|---|---|
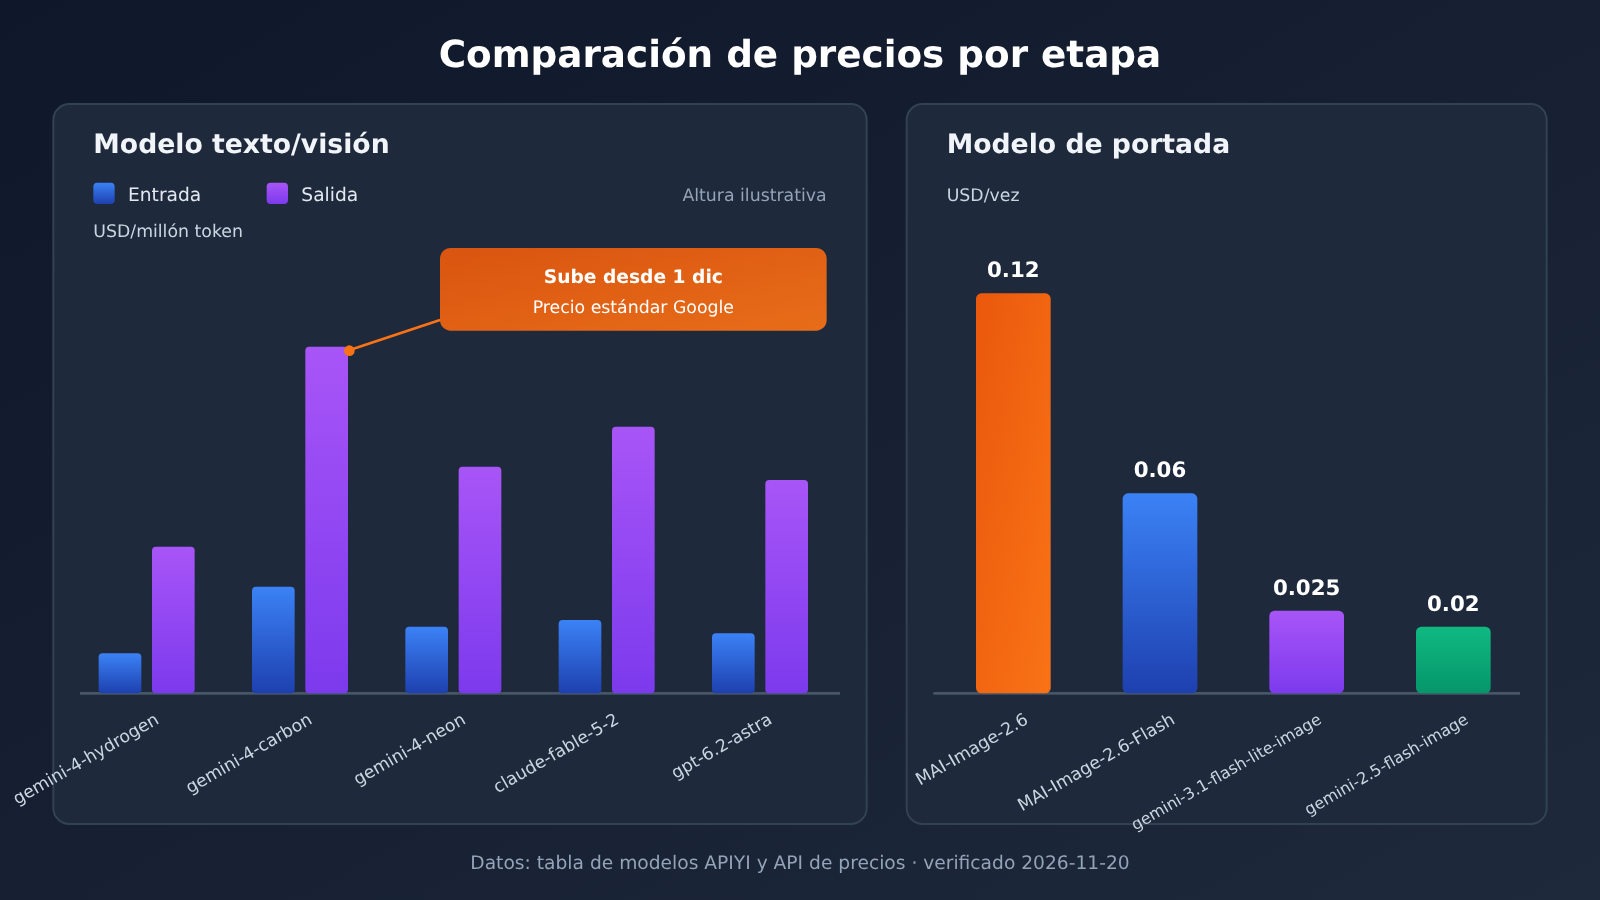
gemini-4-hydrogen |
1.5 | 7.5 | 0.075 | Revisar imagen y retocar textos, priorizando coste |
gemini-4-carbon |
2 | 10 | 0.1 | Revisar imagen y retocar textos; precio introductorio vigente hasta 2026-11-30 |
gemini-4-argon |
2 | 10 | 0.1 | Tareas de texto y comprensión |
gemini-4-neon |
3 | 15 | 0.15 | Alternativa cuando hace falta más capacidad |
claude-fable-5-2 / claude-fable-5-2-thinking |
8 | 40 | 0.2 | Pulido de textos largos, reescrituras complejas |
gpt-6.2-astra |
8 (16 si se superan 272000 tokens) | 40 | 0.4 | Tareas de texto de alta exigencia |
Hay dos puntos a los que conviene prestar especial atención. El 2 / 10 / 0.1 de gemini-4-carbon coincide con el precio introductorio de Google vigente hasta el 2026-11-30; a partir del 1 de diciembre, el precio estándar de Google será 4 de entrada y 20 de salida, así que el coste se duplicará, y antes de lanzar lotes de larga duración tocará volver a verificarlo. En gpt-6.2-astra, al superar los 272000 tokens la tabla general indica 16 de entrada, mientras que la interfaz de precios en ese tramo ofrece además 60 de salida y 0.8 de lectura de caché; para ambas cifras, lo que manda es el cargo real que aparezca en tu panel al hacer la llamada. gemini-4-neon no figura en esta versión de la tabla general, pero sí consta en la interfaz de precios, y el resultado de la conversión coincide con el precio de lista de Google.
La parte de portada se factura por llamada, así que la listamos aparte en su propia tabla:
| ID del modelo de portada | Precio por llamada (USD) | Escenario adecuado |
|---|---|---|
MAI-Image-2.6 |
0.12 | Portada principal, cuando se busca más calidad |
MAI-Image-2.6-Flash |
0.06 | Pruebas de varias versiones |
gemini-3.1-flash-lite-image |
0.025 | Bocetos en lote |
gemini-2.5-flash-image |
0.02 | Generación rápida de imágenes a bajo coste |
Ojo: MAI-Image-2.7 todavía no existe, no lo metas en el script como si fuera un modelo invocable. Kling, Muse y gemini-4-flash-lite tampoco aparecen en la tabla general ni en la interfaz de precios, así que descártalos directamente al planificar la pipeline.
Paso 3: Cambiar los pasos de pago al mismo base_url
Este paso implica muy pocos cambios. Si antes usabas el SDK oficial de OpenAI, solo tienes que modificar dos cosas:
- Sustituye
api_keypor la clave que generaste en la consola de APIYI; - Configura
base_urlcomohttps://api.apiyi.com/v1.
A partir de ahí, en las solicitudes de análisis visual, configura model como gemini-4-hydrogen; en las de reescritura de texto, usa claude-fable-5-2 o sigue con Gemini; y en las de generación de portadas, configura model como MAI-Image-2.6-Flash. Las tres etapas comparten un único objeto cliente; la única diferencia es el ID del modelo. Las solicitudes conversacionales pasan por /chat/completions, compatible con OpenAI; los parámetros específicos y el formato de respuesta de los modelos de imagen se rigen por lo que indique la documentación de cada modelo.
Consultar la configuración por etapa
– **Cliente**: inicialízalo una sola vez, mantén `base_url` sin cambios y guarda la clave en una variable de entorno, por ejemplo `APIYI_API_KEY`.
– **Análisis visual**: pasa como entrada tanto las capturas de fotogramas clave como los subtítulos transcritos localmente, y configura `model` como `gemini-4-hydrogen`; si tienes presupuesto holgado o necesitas una comprensión más potente, cambia a `gemini-4-carbon`.
– **Reescritura del texto**: usa el resumen de planos que generó el paso anterior como contexto y elige `model` `claude-fable-5-2`; para textos largos que requieren razonamiento en varios pasos, puedes usar `claude-fable-5-2-thinking`.
– **Generación de portadas**: primero usa `gemini-2.5-flash-image` para crear varias versiones de boceto; cuando tengas la versión definitiva, usa `MAI-Image-2.6` para la portada final.
– **Caché**: los subtítulos de un mismo video se leen repetidamente en varias etapas; intenta que las partes compartidas mantengan un prefijo consistente para aprovechar el precio de lectura desde caché.
– **Registro**: registra en cada solicitud el ID del modelo y el uso de tokens devuelto; a fin de mes, concilia esos datos con el consumo de la consola punto por punto.
🚀 Consejo para empezar rápido: primero, en APIYI apiyi.com, usa la cuota de prueba gratuita para usuarios nuevos, recorre por completo un video corto con los tres pasos anteriores y anota el uso real de tokens de cada etapa; luego decide qué nivel de modelo usar para videos largos.
Paso 4: Estimar el presupuesto de un video
Al estimar, conviene separar el cálculo por token del cálculo por uso. Pongamos un ejemplo hipotético: si revisar las imágenes y ajustar el texto consume en total 1 millón de tokens de entrada y 100 000 tokens de salida, usando gemini-4-hydrogen, serían 1.5 + 0.75, unos 2.25 dólares; para la portada, generar 4 bocetos con Flash y 1 imagen definitiva serían 4 × 0.06 + 0.12, es decir, 0.36 dólares. Las cifras de tokens aquí son solo valores hipotéticos para la demostración; tu consumo real dependerá de la duración del video, la densidad de capturas de fotogramas y el número de rondas de texto.
La ventaja de este método de estimación es que cada partida se puede conciliar línea por línea con la factura del panel de control. En cambio, si las cuatro etapas están repartidas entre cuatro proveedores, los tipos de cambio, las unidades de facturación y los momentos de cobro son distintos; aunque el total no sea grande, conciliar las cuentas lleva mucho tiempo.
Preguntas frecuentes (FAQ)
Q1: Cuando se usan varios modelos para un solo video, ¿a qué pasos exactamente se refiere?
Normalmente son cuatro: transcribir, analizar las imágenes, reescribir el texto y generar la miniatura. Algunos flujos añaden además doblaje o clonación de voz. La transcripción puede hacerse con Whisper local, sin pagar tarifas de modelo; lo que normalmente genera costes de modelo es analizar las imágenes, generar la miniatura y reescribir el texto.
Q2: ¿Entra en conflicto repartir tareas entre modelos y centralizar la facturación? ¿No sería más sencillo usar un solo modelo?
No entran en conflicto. Repartir tareas sirve para ajustar calidad y coste; centralizar sirve para la factura y la conciliación. Usar un solo modelo ciertamente simplifica, pero analizar imágenes, escribir texto y generar imágenes exigen capacidades muy distintas; forzar la uniformidad suele salir caro. Lo más razonable es elegir un modelo para cada tarea y mantener un único punto de entrada para las invocaciones.
Q3: ¿Puedo tomar directamente los 2.71 USD por video largo como presupuesto?
No conviene aplicarlo tal cual. Es una cifra que el propio autor declara y que MindStudio reproduce; proviene de OpenRouter, no de la factura de APIYI, y la combinación de modelos, la duración del video y el número de fotogramas extraídos también pueden diferir de los tuyos. Lo más prudente es seguir el cuarto paso de este artículo y recalcular con tu propio consumo de tokens y el precio unitario actual.
Q4: Para analizar imágenes, ¿debería elegir `gemini-4-hydrogen` o `gemini-4-carbon`?
Si el presupuesto manda, elige `gemini-4-hydrogen`: entrada 1.5, salida 7.5, lectura de caché 0.075; es el precio unitario más bajo del grupo. Si necesitas una comprensión más potente, elige `gemini-4-carbon`, pero ten en cuenta que su 2 / 10 es un precio de introducción válido hasta el 2026-11-30; a partir del 1 de diciembre, el precio estándar de Google será entrada 4 y salida 20, así que conviene revisar el precio antes de usarlo a largo plazo.
Q5: ¿Cómo migro mis scripts actuales al punto de entrada unificado?
Regístrate en APIYI (apiyi.com) y genera una clave API, cambia el `base_url` del SDK por la dirección de invocación de la plataforma y luego ajusta el campo `model` según cada etapa. La estructura de las solicitudes existentes apenas necesita cambios. Los nuevos usuarios además tienen una cuota de prueba gratuita, así que puedes validar todo el pipeline con un video corto.
Q6: ¿La clonación de voz también puede pasar por este punto de entrada?
No. La clonación de voz no está por ahora en el catálogo de APIYI; si necesitas este paso, tendrás que usar otro servicio y contabilizarlo aparte. Al planificar el presupuesto, te recomiendo ponerlo como una línea separada para que no se mezcle con el consumo del punto de entrada unificado.
Q7: ¿Hay limitaciones conocidas que deba evitar de antemano?
Hay varias: `MAI-Image-2.7` no existe por ahora; Kling, Muse y `gemini-4-flash-lite` tampoco aparecen en la tabla general de modelos ni en la API de precios, así que no los incluyas en tus scripts. El precio unitario de `gpt-6.2-astra` sube después de superar los 272000 tokens; la tabla general y la API de precios ofrecen detalles ligeramente distintos sobre los tramos, así que toma como referencia el cargo real. Los precios cambian; antes de ejecutar un lote, conviene volver a comprobar la tabla general de modelos del día.
Puntos clave para usar varios modelos en un solo video: lo esencial
- Separar primero, conectar después: la transcripción y la edición se quedan en local; solo conectamos a la API los pasos que generan gastos.
- Mantener el reparto de tareas: para revisar el metraje, retocar el guion y generar la portada, elegimos el modelo más adecuado en cada caso; no hay que forzar uno único.
- Un solo punto de entrada: los pasos de pago comparten la misma clave API y el mismo base_url; al cambiar de modelo solo se modifica el ID del modelo.
- Criterios separados: texto y visión se cobran por token, la portada por llamada; el presupuesto se calcula en dos columnas.
- Ojo con la vigencia: el precio de introducción de
gemini-4-carbonrige hasta el 2026-11-30; después el precio estándar sube. - Fuera del catálogo, aparte: la clonación de voz no está dentro del punto de entrada unificado y hay que registrarla por separado.
- Las cifras externas son solo referencia: los 2.71 dólares son lo que el autor declara en OpenRouter, no la factura de APIYI.
Resumen
Que un solo video requiera varios modelos no es un problema en sí; el problema es que la factura queda desglosada y no cuadra. Después de ordenar todo, quedan tres puntos:
- Local primero: la transcripción con Whisper en local y la edición también en local; estos dos pasos no generan gasto de modelo.
- Un solo punto de pago: revisar el metraje, retocar el guion y generar la portada pasan todos por el mismo base_url, repartidos por ID de modelo.
- Calcular con el precio del día: estimar por separado lo que va por token y lo que va por llamada, y volver a revisar precios y modelos disponibles antes de lanzar el lote.
Te sugiero empezar con un video corto para dejar funcionando toda la tubería, anotar el consumo real de cada etapa y luego escalar a videos largos. Recomiendo hacer esta validación en APIYI apiyi.com con los créditos de prueba gratuitos: el reparto de tareas sigue igual y la factura se revisa en un solo punto de entrada.
📚 Referencias
-
Tabla general de modelos de APIYI: resumen de modelos y precios unitarios
- Enlace:
docs.apiyi.com/models.md - Descripción: principal fuente de precios de este artículo; esta versión se actualizó el 2026-11-19 a las 10:59 (UTC+8)
- Enlace:
-
Interfaz de precios de APIYI: precios en tiempo real convertidos por multiplicador
- Enlace:
api.apiyi.com/api/pricing - Descripción: versión
shell-api-modelmak-v1;model_ratioigual a 1 corresponde a una entrada de 2 USD por millón de tokens
- Enlace:
-
Reseña de la skill de edición de video de MindStudio: publicada el 2026-11-19
- Descripción: la afirmación de 2,71 USD por un video largo proviene de la declaración del propio autor reseñada en ese artículo, usando OpenRouter
Autor: equipo técnico de APIYI
Comunicación técnica: no dudes en contactarnos desde la página principal del sitio web oficial de APIYI; para consultar más modelos e instrucciones de invocación, visita el centro de documentación en docs.apiyi.com


