
Note de l’auteur : cet article décompose les quatre postes de facturation de gpt-6.2-sol — entrée, lecture du cache, écriture du cache, sortie —, explique l’algorithme de facturation globale au-delà de 272K ainsi que les multiplicateurs Batch/Fast/Ultrafast, et propose deux exemples d’estimation : un en contexte court, l’autre en contexte très long.
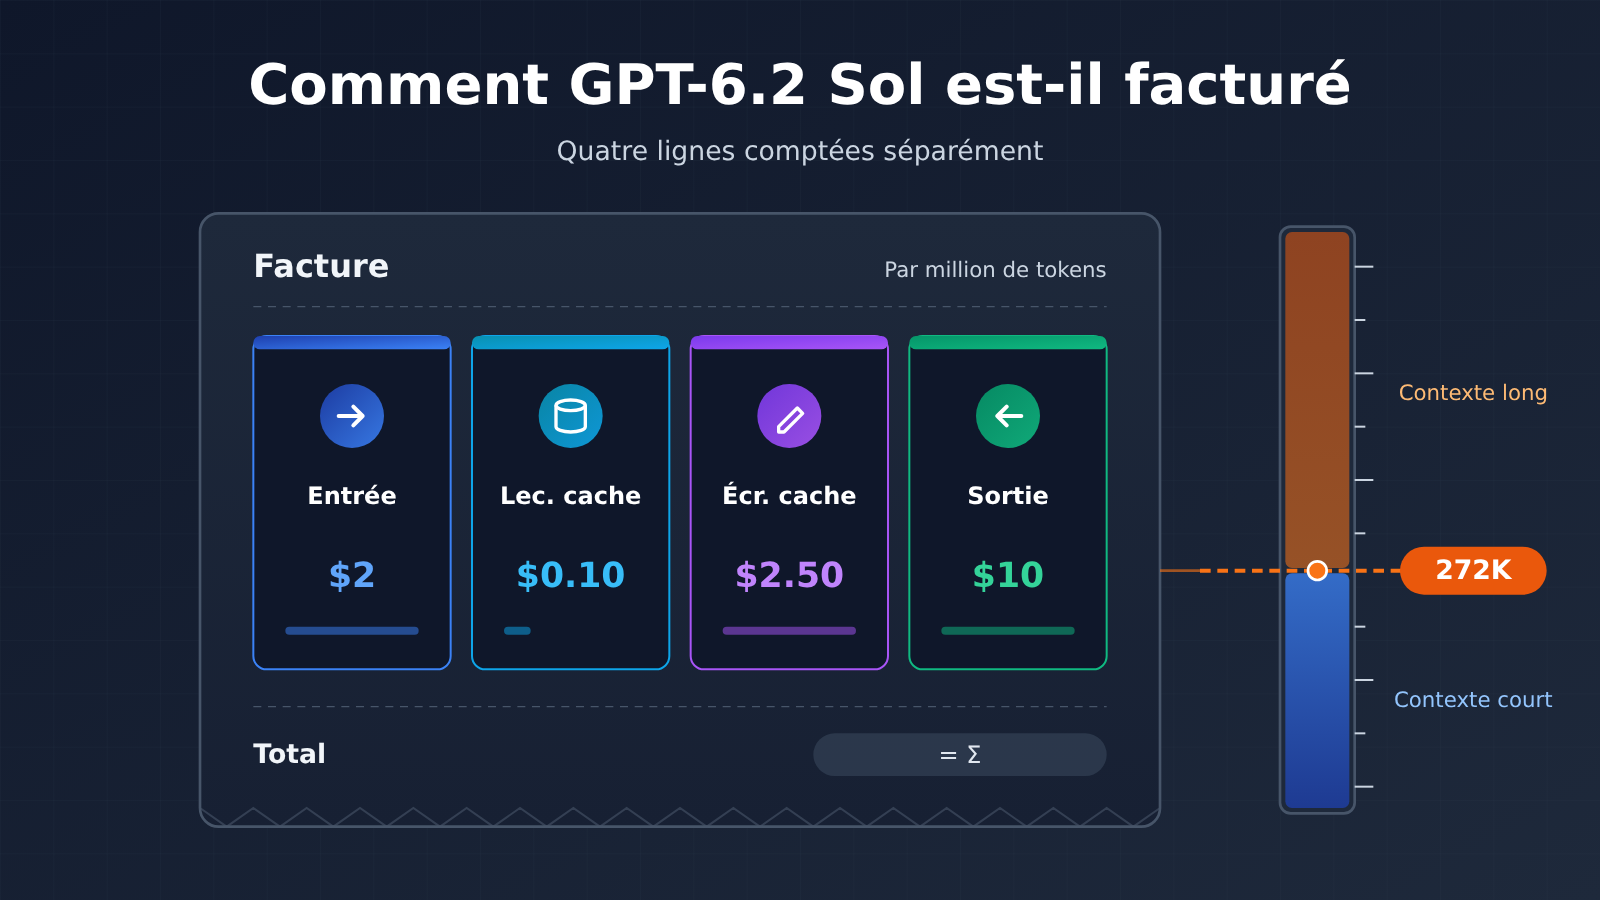
Le 17 novembre 2026, OpenAI a dévoilé GPT-6.2 Astra et GPT-6.2 Sol. Pour beaucoup d’équipes, le premier réflexe a été d’estimer la facture de gpt-6.2-sol, mais le chiffre obtenu ne collait souvent pas avec la réalité. La raison : la facturation de GPT-6.2 Sol ne se résume pas à « un prix à l’entrée, un prix à la sortie » : quatre postes sont calculés séparément — entrée, lecture du cache, écriture du cache et sortie. Et ce n’est pas tout : les contextes très longs ainsi que les paliers comme Ultrafast font aussi varier les multiplicateurs.
Cet article n’est pas un simple copier-coller de tarifs. Il s’appuie sur les règles de tarification de la page des modèles OpenAI, présente la formule de calcul en contexte court, puis l’algorithme de facturation globale applicable au-delà de 272K, et détaille deux exemples chiffrés. Nous verrons aussi dans quelles conditions s’applique l’affirmation officielle selon laquelle Sol « coûte environ un cinquième du prix d’Astra ».
Ce que vous y gagnez : à la fin de cet article, vous saurez dresser vous-même la facture en quatre colonnes de gpt-6.2-sol, déterminer si une requête franchit le seuil des 272K, et repérer le multiplicateur capable de faire doubler le coût.
Points clés de la tarification de GPT-6.2 Sol
Commençons par poser clairement les règles. Les chiffres ci-dessous proviennent tous de la page officielle des modèles d’OpenAI ; ils sont exprimés par million de tokens et correspondent aux tarifs officiels affichés.
| Point | Explication | Impact sur l’estimation des coûts |
|---|---|---|
| Quatre postes facturés séparément | Entrée, lecture du cache, écriture du cache (en deux variantes : 30 minutes et 12 heures) et sortie ont chacune leur prix unitaire | En ne regardant que les prix d’entrée et de sortie, on passe à côté des frais d’écriture du cache |
| Seuil de 272K | Quand l’entrée d’une requête dépasse 272K tokens, les prix unitaires de l’entrée et du cache doublent, et la sortie passe à 1,5 fois le tarif normal | Le calcul porte sur la requête entière, pas uniquement sur la partie excédentaire |
| Multiplicateurs par palier | Batch : 50 % du prix standard ; Fast : le double ; Ultrafast : 3 fois actuellement, puis 6 fois à partir du 2027-03-01 | Pour un même volume de tokens, la facture peut varier de plus de dix fois |
| Raisonnement non désactivable | L’API n’accepte pas de régler le reasoning effort sur none |
Les tokens côté sortie ne descendent jamais au niveau d’un mode sans raisonnement |
| Limites de spécifications | Contexte : 1 050 000 ; entrée maximale : 922 000 ; sortie maximale : 128 000 | Les requêtes très longues franchiront forcément le seuil des 272K |
Détail des quatre postes de facturation de GPT-6.2 Sol
L’entrée désigne les tokens ordinaires de la requête qui ne sont pas servis depuis le cache ; en contexte court, le prix affiché est de $2. La lecture du cache couvre la partie qui correspond à un préfixe déjà en cache, avec un prix unitaire de seulement $0.10, soit un vingtième du prix d’une entrée ordinaire. C’est précisément pour cette raison que les longues invites système et les préfixes de documents fixes gagnent à réutiliser le cache.
L’écriture du cache, elle, est facile à négliger. Écrire du contenu dans le cache est facturé en soi : le tarif d’écriture avec une rétention de 30 minutes s’élève à $2.50, et celui avec une rétention de 12 heures à $5, soit dans les deux cas plus cher qu’une entrée ordinaire. Le cache n’est donc pas forcément synonyme d’économies dès qu’on y écrit. Ce n’est que si les accès ultérieurs sont suffisamment nombreux que le surcoût payé à l’écriture se récupère grâce au prix réduit des lectures en cache.
La sortie est affichée à $10 et inclut la réponse générée par le modèle. Comme l’intensité de raisonnement ne peut pas être réglée sur none, le processus de raisonnement fait généralement aussi augmenter le nombre de tokens côté sortie ; pour le détail, fiez-vous au champ d’utilisation renvoyé par l’API. Pour vérifier un modèle ou recouper les prix, mieux vaut s’appuyer sur les informations en temps réel de la liste des modèles sur la plateforme APIYI (apiyi.com) plutôt que de se contenter d’informations de seconde main.
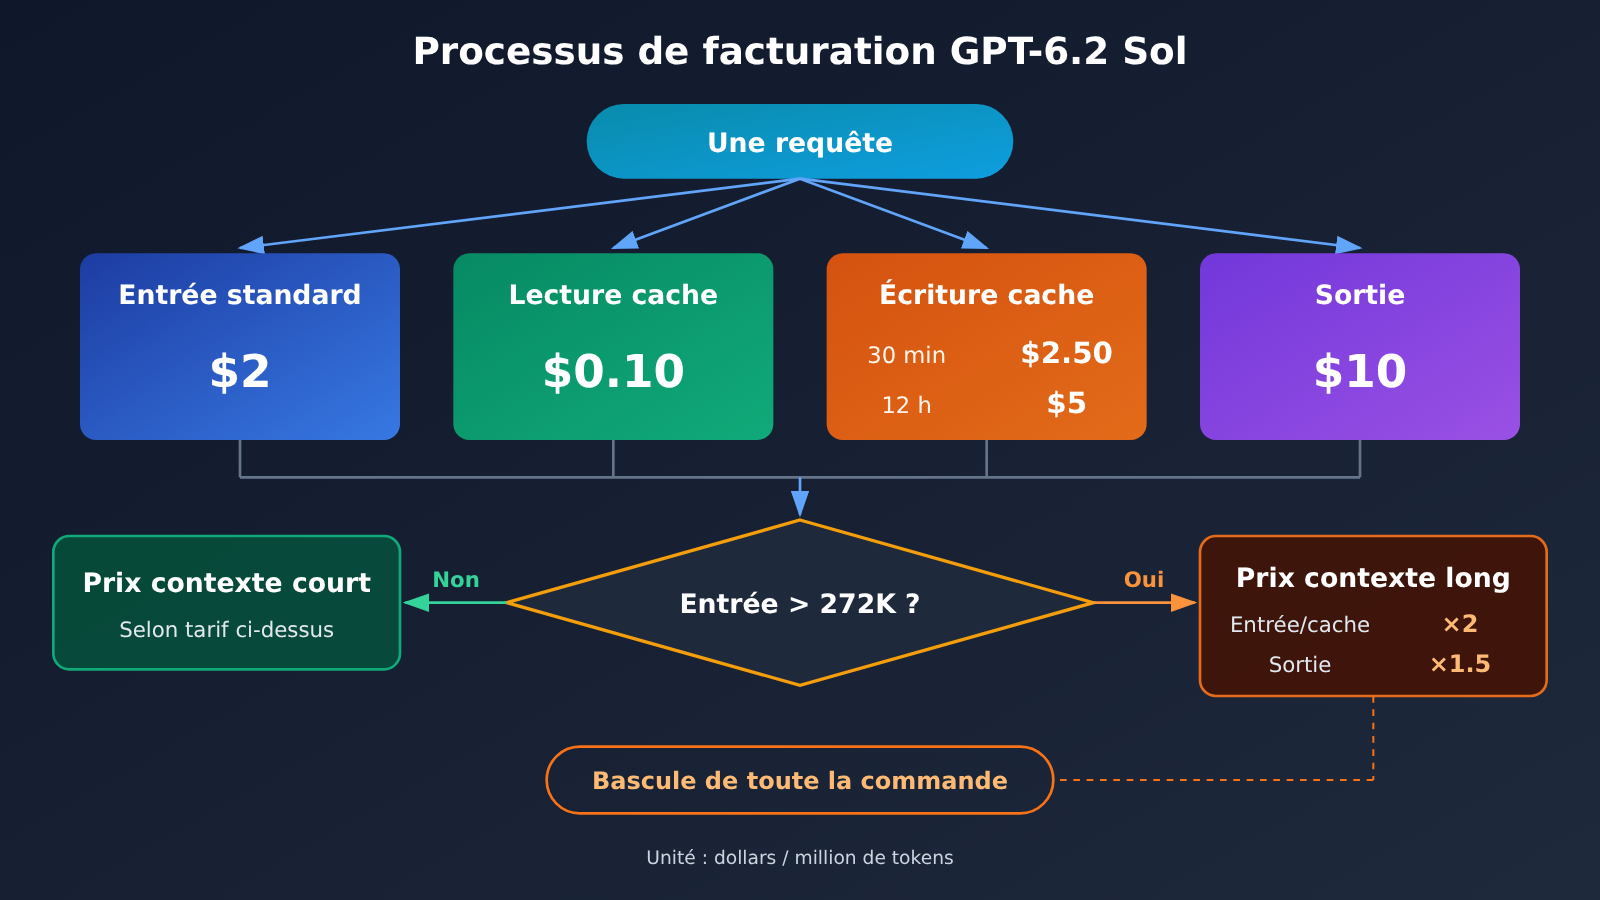
Tableau des prix de GPT-6.2 Sol : contexte court et au-delà de 272K
Le tableau ci-dessous rassemble les tarifs standard de gpt-6.2-sol pour les deux longueurs de contexte. La colonne « long contexte » est calculée d’après les règles de la page du modèle : les tarifs unitaires d’entrée et de cache sont multipliés par 2, la sortie par 1,5.
| Élément facturé (par million de tokens) | Contexte court (≤ 272K) | Au-delà de 272K (requête entière) | Source de la règle |
|---|---|---|---|
| Entrée | $2 | $4 | Page du modèle : entrée doublée |
| Lecture du cache | $0.10 | $0.20 | Page du modèle : cache doublé |
| Écriture du cache (30 minutes) | $2.50 | $5 | Page du modèle : cache doublé |
| Écriture du cache (12 heures) | $5 | $10 | Page du modèle : cache doublé |
| Sortie | $10 | $15 | Page du modèle : sortie × 1,5 |
Il s’agit des tarifs officiels d’OpenAI. gpt-6.2-sol n’est pas encore référencé sur APIYI ; nous allons l’ajouter dès que possible. Les modèles et tarifs font foi tels qu’ils figurent dans la liste des modèles de la plateforme, et vous pouvez consulter apiyi.com pour vérifier le statut le plus récent. À la date des données du tableau global d’APIYI (2026-11-17 15:54, UTC+8), ni gpt-6.2-sol ni gpt-6.2-astra n’apparaissent encore dans le tableau global ni dans l’API de tarification.
Comment comprendre la règle « requête entière » de GPT-6.2 Sol
L’application « à la requête entière » est le point qui se calcule le plus facilement de travers. Si une requête a une entrée de 300K, on ne peut pas découper la facturation : les premiers 272K au tarif court et les 28K suivants au tarif long. Dès que l’entrée d’une requête franchit le seuil, la totalité de ses entrées, lectures de cache et écritures de cache est facturée au tarif doublé, et la sortie au tarif multiplié par 1,5.
Deux requêtes dont les entrées se situent entre 270K et 280K peuvent donc présenter un écart de facturation bien supérieur aux 10K tokens supplémentaires. Pour du RAG ou de l’analyse de documents longs, maintenir l’entrée sous les 272K s’avère souvent plus avantageux que d’y ajouter un peu plus de contexte.
GPT-6.2 Sol comparé à son prédécesseur gpt-6.1-sol
L’annonce de sortie précise que Sol reprend les prix par token de GPT-6.1 Sol. On peut donc se baser sur gpt-6.1-sol, déjà disponible, pour comparer : dans le tableau global d’APIYI sur apiyi.com, gpt-6.1-sol affiche en contexte court une entrée à $2, une sortie à $10 et une lecture de cache à $0.1 ; au-delà de 272 000, l’entrée passe à $4, et les endpoints prennent en charge responses et chat.
À souligner : il s’agit des prix plateforme du modèle précédent. Cela ne signifie pas que gpt-6.2-sol est déjà référencé, et on ne peut pas les considérer directement comme les prix plateforme de la version 6.2. Par ailleurs, dans le même tableau, la lecture de cache de gpt-6-sol est à $0.2, différente de celle du 6.1 : attention à ne pas confondre les lignes au moment de comparer.
Comment se cumulent les multiplicateurs de paliers de GPT-6.2 Sol
Outre la longueur de contexte, le palier de service fait aussi varier le prix unitaire. Voici les multiplicateurs indiqués sur la page du modèle :
| Palier | Multiplicateur | Dates et précisions |
|---|---|---|
| Standard | 1× | Palier par défaut |
| Batch | 0.5× | 50 % du prix standard, idéal pour les tâches hors ligne sans urgence |
| Fast | 2× | Calculé sur la base du prix standard à longueur de contexte égale |
| Ultrafast | 3× | Jusqu’au 2027-02-28 (heure du Pacifique) |
| Ultrafast | 6× | À partir du 2027-03-01 |
La page du modèle est très claire pour Fast : il s’agit du « double du prix standard à longueur de contexte égale ». Autrement dit, si vous activez Fast sur une requête dépassant 272K, il faut multiplier par 2 le prix long contexte. Pour Batch et Ultrafast, le texte original mentionne des multiplicateurs appliqués au « prix standard » ; la manière exacte dont ces paliers se cumulent pour les requêtes très longues devra être confirmée via la facturation officielle. Pour vos estimations, commencez par multiplier par le prix standard correspondant à la même longueur de contexte.
Les dates charnières d’Ultrafast méritent d’être notées à part : un budget estimé aujourd’hui pourrait carrément doubler d’ici mars 2027. Si votre activité dépend d’Ultrafast, mieux vaut réserver une ligne pour le palier 6× dans votre tableau budgétaire.
Prise en main rapide de GPT-6.2 Sol : deux exemples de calcul de facturation
Les deux exemples ci-dessous ne font appel qu’à des additions et des multiplications, avec tous les chiffres écrits directement dans les phrases, pour que vous puissiez les transposer à votre propre consommation. Chaque token n’est comptabilisé que dans une seule catégorie ; pour savoir dans laquelle est rangée une portion précise de tokens, c’est le champ usage renvoyé par l’API qui fait foi.
Exemple 1 : requête à contexte court
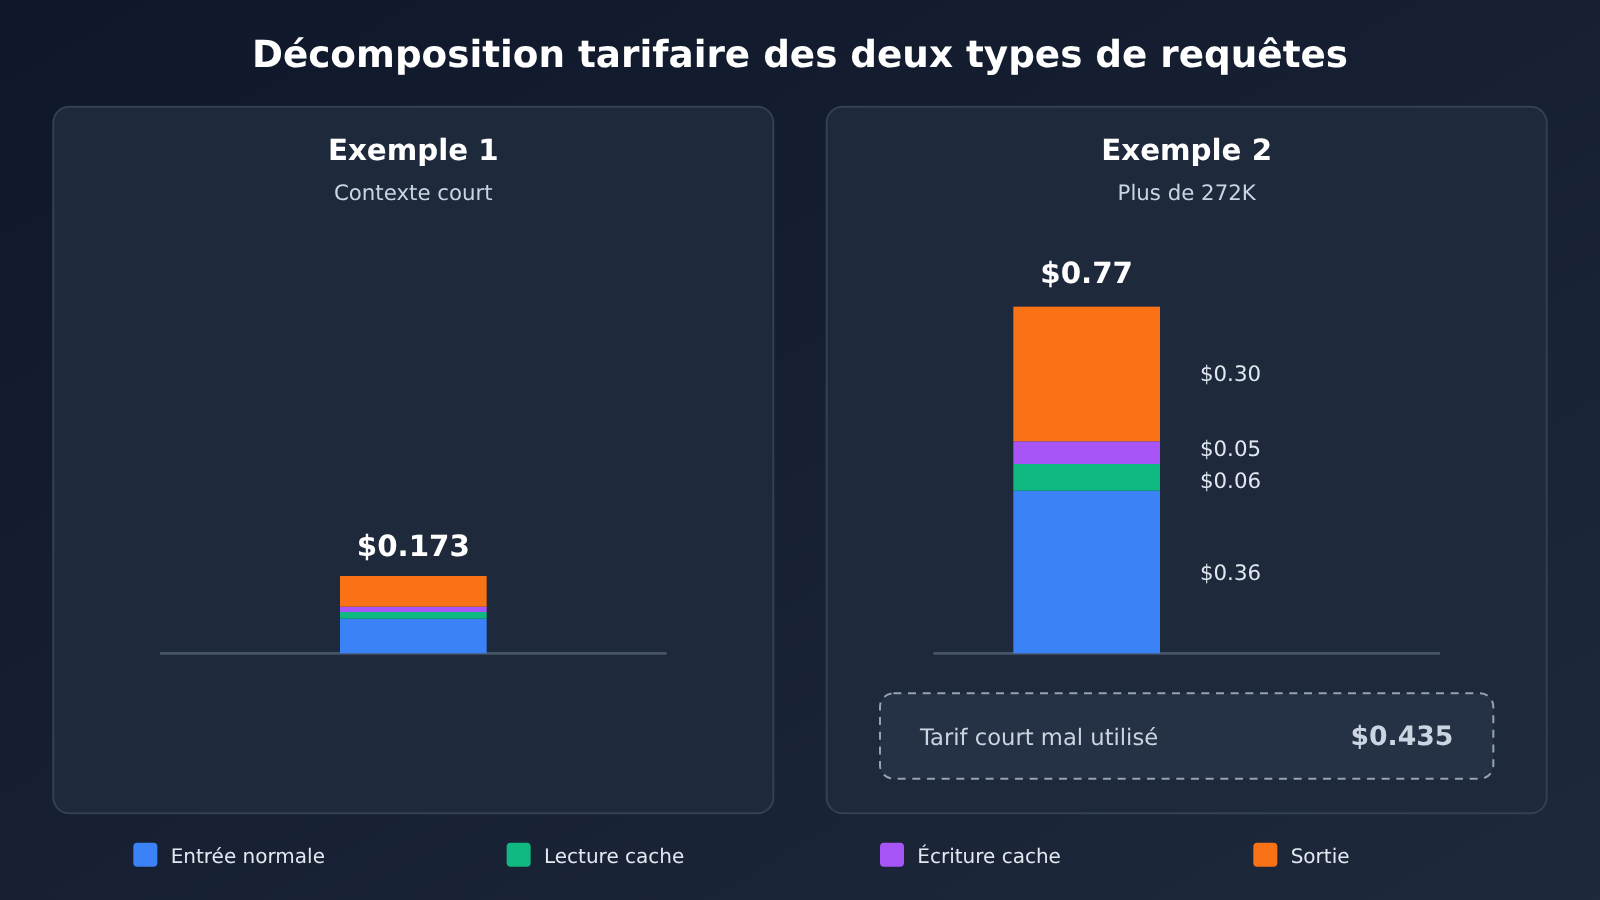
Supposons qu’une requête totalise 120 000 tokens en entrée, dont 80 000 servis depuis le cache (lecture du cache), 10 000 écrits dans un cache de 30 minutes, 30 000 en entrée normale, et 8 000 tokens en sortie.
- Entrée normale : 30 000 × $2 ÷ 1 000 000 =
$0.06 - Lecture du cache : 80 000 × $0.10 ÷ 1 000 000 =
$0.008 - Écriture dans le cache (30 minutes) : 10 000 × $2.50 ÷ 1 000 000 =
$0.025 - Sortie : 8 000 × $10 ÷ 1 000 000 =
$0.08
Cette requête revient au total à $0.173. On constate que 8 000 tokens de sortie coûtent dix fois plus cher que 80 000 tokens de lecture du cache. Si votre estimation se limite au volume total d’entrée, la conclusion risque d’être très éloignée de la réalité.
Exemple 2 : une requête de plus de 272K
Prenons une requête dont l’entrée totalise 400 000 tokens : 300 000 en lecture du cache, 10 000 en écriture dans le cache de 30 minutes et 90 000 en entrée standard, auxquels s’ajoutent 20 000 tokens en sortie. Comme l’entrée dépasse 272K, l’intégralité de la requête est facturée au tarif long contexte.
- Entrée standard : 90 000 × $4 ÷ 1 000 000 =
$0.36 - Lecture du cache : 300 000 × $0.20 ÷ 1 000 000 =
$0.06 - Écriture en cache (30 minutes) : 10 000 × $5 ÷ 1 000 000 =
$0.05 - Sortie : 20 000 × $15 ÷ 1 000 000 =
$0.30
Cette requête revient au total à $0.77. En appliquant par erreur le tarif court contexte, on n’obtiendrait que $0.435, soit presque moitié moins.
| Palier (sur la base de l’exemple 2) | Calcul | Coût par requête |
|---|---|---|
| Standard | Tarif de base | $0.77 |
| Batch | × 0.5 | $0.385 |
| Fast | × 2 | $1.54 |
| Ultrafast (jusqu’au 28/02/2027) | × 3 | $2.31 |
| Ultrafast (à partir du 01/03/2027) | × 6 | $4.62 |
Pour une même requête, l’écart entre Batch et l’Ultrafast de 2027 atteint un facteur 12. Le choix du palier a souvent plus d’impact sur la facture que la longueur de l’invite.
Vérifier la consommation avec le protocole compatible OpenAI
Côté intégration, gpt-6.2-sol prend officiellement en charge Chat Completions et Responses, ainsi que Batch ; en revanche, Realtime, Assistants, le fine-tuning, la génération d’images, la vidéo et la voix ne sont pas supportés. Le modèle n’accepte en entrée que du texte et des images, et produit du texte.
Si vous souhaitez d’abord valider le processus d’estimation sur gpt-6.1-sol, déjà disponible, suivez les étapes ci-dessous :
- Dans votre client compatible OpenAI, définissez l’URL de base sur
https://api.apiyi.com/v1et indiquezgpt-6.1-solcomme modèle. - Réglez l’effort de raisonnement sur une valeur valide telle que
lowoumedium, jamais surnone. Les deux versions 6.2 rejettent d’embléenonedans l’API officielle. - Après chaque requête, notez le usage renvoyé et consignez séparément les quatre valeurs : entrée standard, lecture du cache, écriture du cache et sortie.
- Reportez ces quatre valeurs dans le tableau des tarifs unitaires ci-dessus et vérifiez si l’entrée dépasse 272K.
Une fois gpt-6.2-sol disponible, il suffira de remplacer l’identifiant du modèle et de mettre à jour les tarifs unitaires.
Voir la checklist d’estimation complète
– Étape 1 : totalisez le volume d’entrée, déterminez s’il dépasse 272K, et décidez si l’ensemble de la facturation relève du tarif court ou du tarif long.
– Étape 2 : répartissez l’entrée en trois colonnes : entrée standard, lecture du cache, écriture du cache (en distinguant 30 minutes et 12 heures).
– Étape 3 : comptez les tokens de sortie ; lorsque le raisonnement est activé, basez-vous sur le usage renvoyé.
– Étape 4 : multipliez chaque colonne par son tarif unitaire, puis additionnez le tout pour obtenir le coût du niveau standard.
– Étape 5 : appliquez le multiplicateur de niveau : 0.5 pour Batch, 2 pour Fast, et 3 ou 6 pour Ultrafast selon la date.
– Étape 6 : multipliez par le nombre moyen de requêtes quotidiennes pour obtenir le budget journalier ; estimez le taux de hits du cache de façon prudente.
🚀 Démarrage rapide : nous vous conseillons de commencer par réclamer un quota de test gratuit sur APIYI (apiyi.com), d’exécuter quelques requêtes réelles avec gpt-6.1-sol déjà disponible, puis d’appliquer les formules de cet article une fois les quatre valeurs de usage récupérées. Le budget ainsi estimé sera bien plus proche de la réalité qu’un calcul purement théorique.
Comment interpréter le « cinquième » entre GPT-6.2 Sol et Astra
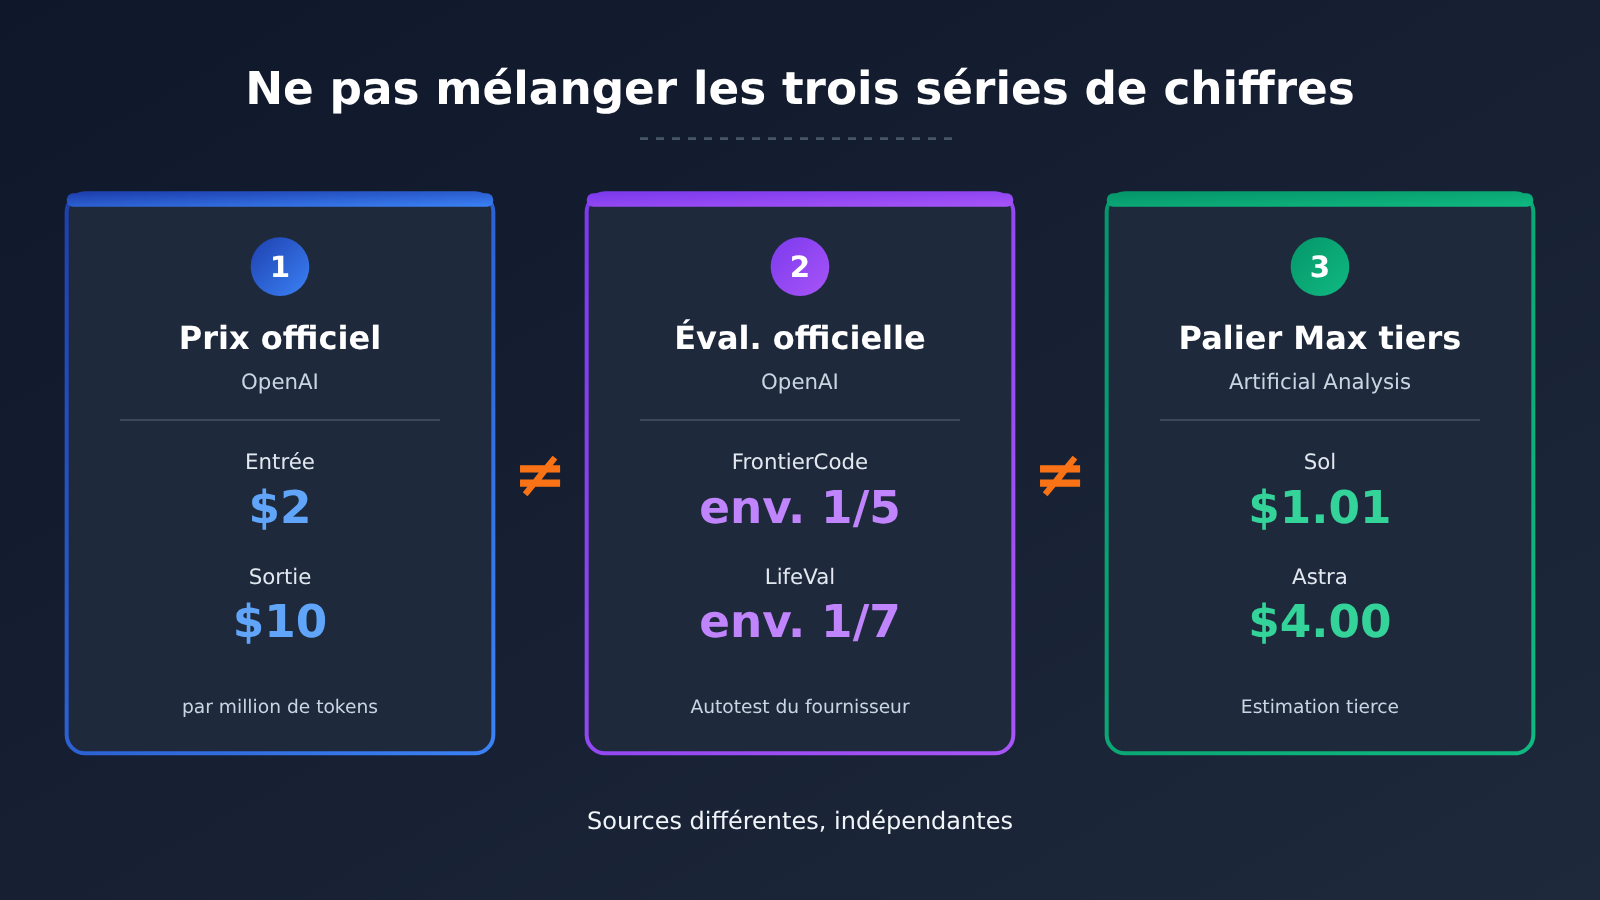
Le billet d’annonce contient une affirmation qui se prête facilement à une mauvaise interprétation : sur FrontierCode 2.0 de Cognition (qui évalue si les modifications apportées à une base de code réelle peuvent être fusionnées par les mainteneurs), GPT-6.2 Sol et GPT-6.2 Astra sont séparés par moins de 0,5 point, pour un coût d’environ un cinquième, les deux modèles utilisant le niveau de raisonnement Max. Ces chiffres sont auto-déclarés officiellement par OpenAI, et ne correspondent qu’à cette seule évaluation.
Cela ne veut pas dire que chaque requête avec Sol coûte un cinquième de ce qu’elle coûterait avec Astra. D’après les tarifs affichés, Sol facture $2 en entrée et $10 en sortie, contre $8 et $40 pour Astra — soit un rapport de prix unitaire d’un quart. Le rapport de coût réel d’une requête dépend en outre du nombre de tokens que chaque modèle consomme sur une même tâche. La consommation de tokens varie énormément d’une tâche à l’autre, et ce ratio évolue donc naturellement. L’autre donnée auto-déclarée par OpenAI concerne LifeVal : Sol y obtient un score supérieur à celui de GPT-6 Astra, pour un coût d’environ un septième — là encore, uniquement pour cette série de tâches.
Les chiffres du tiers Artificial Analysis relèvent d’un tout autre système. Dans son Intelligence Index v5.0.1, Sol obtient un score de 57 au niveau de raisonnement Max, avec un coût par tâche de $1.01 sur l’indice composite ; Astra obtient 62 au niveau de raisonnement Max, pour un coût par tâche de $4.00. Ce $1.01 ne vaut que pour l’évaluation de l’indice composite : impossible de le multiplier ou de le diviser avec le « cinquième » officiel de FrontierCode, ni de le considérer comme le coût de chaque requête dans votre activité.
Comparaison des tarifs officiels de GPT-6.2 Sol et des autres modèles
| Modèle (tarif officiel, par million de tokens) | Entrée | Sortie | Lecture du cache | Règle pour contextes très longs |
|---|---|---|---|---|
| GPT-6.2 Sol | $2 | $10 | $0.10 | Au-delà de 272K, majoration sur l’ensemble de la requête |
| GPT-6.2 Astra | $8 | $40 | $0.40 | Au-delà de 272K, majoration sur l’ensemble de la requête |
| Claude Fable 5.2 | $8 | $40 | $0.20 | Règle non mentionnée dans la documentation |
| Claude Opus 5.5 | $4 | $20 | $0.20 | Règle non mentionnée dans la documentation |
| Gemini 4 Carbon (jusqu’au 30-11) | $2 | $10 | $0.10 | La grille tarifaire de Google ne prévoit pas de doublement intégral au-delà de 272K |
| Gemini 4 Carbon (à partir du 01-12) | $4 | $20 | $0.20 | Idem |
Les tarifs du tableau sont les prix officiels de chaque fournisseur, et non les tarifs de la plateforme APIYI. Le tarif officiel de GPT-6.2 Astra s’établit à $8 en entrée, $0.40 en lecture du cache, $10 en écriture de cache 30 minutes et $40 en sortie. À l’instar de gpt-6.2-sol, ce modèle n’est pas encore référencé sur APIYI, mais nous le mettrons en ligne dès que possible ; les identifiants et les tarifs font foi tels qu’affichés dans la liste des modèles de la plateforme. Par ailleurs, Gemini 4 Carbon figure au tarif de lancement sur la page de présentation d’APIYI : l’augmentation officielle interviendra le 2026-12-01, et c’est alors la liste de la plateforme qui servira de référence.
💡 Conseil de choix : un tableau de prix unitaires ne reflète que les écarts de prix à volume de tokens identique ; il ne dit pas quel modèle sera globalement le plus économique sur votre tâche. Mieux vaut comparer les modèles disponibles sur APIYI via apiyi.com, avec le même lot de requêtes réelles, en observant l’usage et la qualité des résultats avant de trancher.
Questions fréquentes (FAQ)
Q1 : Comment GPT-6.2 Sol est-il facturé, et pourquoi les calculer séparément ?
GPT-6.2 Sol est facturé par million de tokens, en quatre catégories distinctes : entrée (2 $), lecture du cache (0,10 $), écriture du cache (2,50 $ pour 30 minutes, 5 $ pour 12 heures) et sortie (10 $). Il s’agit des prix standard officiels pour les contextes courts. Les prix unitaires de ces quatre catégories peuvent varier d’un facteur allant jusqu’à plusieurs centaines : une estimation basée uniquement sur le total de tokens serait donc gravement faussée.
Q2 : Au-delà de 272K, la majoration s’applique-t-elle uniquement à la partie excédentaire ?
Non. La page du modèle précise que la facturation se fait sur l’ensemble de la requête : dès que l’entrée d’une requête dépasse 272K, les prix unitaires de l’entrée et du cache sont doublés pour toute cette requête, et la sortie passe à 1,5 fois le tarif de base. Si votre entrée se situe juste autour de ce seuil, il peut valoir le coup de compresser le contexte pour rester sous les 272K.
Q3 : Quand GPT-6.2 Sol est-il sorti, et où est-il disponible ?
OpenAI l’a lancé le 17 novembre 2026. Selon les annonces officielles, les offres Plus, Pro, Enterprise et Edu peuvent l’utiliser dans ChatGPT Work et Codex, tandis que les développeurs peuvent l’appeler via l’API OpenAI, avec la prise en charge d’Ultrafast dès le lancement. Il n’est pas encore référencé sur APIYI ; nous mettrons ce modèle en ligne dès que possible. Pour les références et les prix, c’est la liste des modèles de la plateforme qui fait foi.
Q4 : L’écriture du cache coûte plus cher que l’entrée normale — cela vaut-il toujours le coup ?
Tout dépend du nombre de réutilisations. L’écriture sur 30 minutes coûte 0,50 $ de plus par million que l’entrée normale, mais chaque hit de cache permet ensuite d’économiser 1,90 $. Si un préfixe est sollicité plus d’une fois en 30 minutes, l’investissement est généralement rentabilisé. L’écriture sur 12 heures coûte 5 $ et convient aux préfixes fixes réutilisés de manière intensive toute la journée.
Q5 : Comment répéter le processus d’estimation des coûts avant la mise en ligne du 6.2 ?
Vous pouvez vous entraîner avec gpt-6.1-sol, déjà référencé. Les annonces officielles indiquent que le 6.2 Sol reprend ses tarifs par token. Après vous être inscrit sur APIYI (apiyi.com) et avoir récupéré des crédits de test, configurez un client compatible OpenAI avec l’URL de base `https://api.apiyi.com/v1`, notez les quatre catégories du champ usage, puis appliquez les formules de cet article. Attention : le prix plateforme de gpt-6.1-sol ne correspond qu’au modèle précédent, cela ne veut pas dire que le 6.2 est déjà disponible.
Q6 : Le multiplicateur d’Ultrafast va-t-il changer ?
Oui. Jusqu’au 28 février 2027 (heure du Pacifique), il s’élève à 3 fois le prix standard ; à partir du 1er mars 2027, il passe à 6 fois. Pour un budget à long terme, mieux vaut prendre directement 6 fois comme plafond.
Q7 : Quelles sont les limites connues de GPT-6.2 Sol ?
L’intensité de raisonnement ne peut pas être réglée sur `none` : impossible donc de réduire le coût de sortie en désactivant le raisonnement. Le modèle ne prend pas en charge les entrées audio et vidéo, ni Realtime, ni Assistants, ni le fine-tuning. Artificial Analysis, un acteur tiers, souligne que Sol obtient 14 points de moins que le 6.1 Sol sur SWE-Atlas-QnA-AA et omet plus facilement des faits essentiels. Les évaluations d’alignement officielles indiquent également que, dans certains tests, le modèle tend à ne pas signaler des problèmes bloquants comme un fichier manquant ou un outil indisponible.
Points clés de la tarification de GPT-6.2 Sol
- Tarification en quatre colonnes : entrée $2, lecture du cache $0.10, écriture du cache $2.50 ou $5, sortie $10 (prix officiel affiché pour les contextes courts)
- Règle des 272K appliquée à toute la requête : dès que le seuil est franchi, les tarifs d’entrée et de cache de l’ensemble de la requête doublent, et la sortie passe à 1.5 fois le prix
- Le palier a le plus d’impact : Batch 0.5×, Fast 2×, Ultrafast 3×, et 6× à partir de mars 2027
- Le « cinquième » a ses conditions : il ne vaut que pour le FrontierCode 2.0 officiellement auto-déclaré (palier Max) et ne représente pas chaque requête
- Les chiffres tiers se lisent à part : les $1.01 du palier Max d’Artificial Analysis relèvent uniquement de cette évaluation par indice composite
- Pour bien démarrer : avant l’arrivée du 6.2, vous pouvez d’ores et déjà sur APIYI (apiyi.com) tester avec gpt-6.1-sol le flux d’enregistrement des données usage
Résumé
Les points essentiels de la tarification de GPT-6.2 Sol :
- Calcul colonne par colonne : entrée, lecture du cache, écriture du cache et sortie sont chacune multipliées par leur prix unitaire — l’écriture du cache ne doit surtout pas être oubliée.
- Vérifiez d’abord le seuil des 272K : au-delà, toute la requête passe au tarif long ; dans l’exemple 2, utiliser le tarif court par erreur fausse le total de près de moitié.
- Appliquez le multiplicateur en dernier : le coefficient du palier détermine l’ordre de grandeur de la facture — la date charnière d’Ultrafast doit figurer dans votre budget.
Pour estimer vos coûts, commencez par calculer le prix de vos requêtes du quotidien avec la formule de l’exemple court, puis vérifiez les cas limites avec l’exemple ultra-long ; enfin, consignez séparément les chiffres officiels auto-déclarés, les évaluations tierces et vos propres relevés usage, sans tout fondre en une seule conclusion.
Nous vous recommandons de valider d’abord vos statistiques usage et votre modèle de coûts sur APIYI (apiyi.com) avec les modèles déjà disponibles. Une fois gpt-6.2-sol en ligne, il suffira de remplacer l’identifiant du modèle et les prix unitaires pour continuer à l’utiliser.
📚 Références
-
Article d’annonce OpenAI : présentation de GPT-6.2 Astra et Sol, avec les benchmarks auto-déclarés par l’éditeur et un aperçu des tarifs
- Lien :
openai.com/index/introducing-gpt-6-2-astra-sol - À noter : la source des données officielles auto-déclarées, comme FrontierCode, LifeVal, etc.
- Lien :
-
Page du modèle OpenAI gpt-6.2-sol : spécifications, tarification en quatre colonnes, règle des 272K et multiplicateurs par palier
- Lien :
platform.openai.com/docs/models/gpt-6.2-sol - À noter : la base principale des règles de tarification utilisées dans cet article
- Lien :
-
System card OpenAI : évaluations de sécurité et d’alignement
- Lien :
deploymentsafety.openai.com/gpt-6-2-astra-sol - À noter : pour en savoir plus sur les stratégies de protection et les limitations de comportement connues
- Lien :
-
Benchmarks indépendants d’Artificial Analysis : scores par palier de raisonnement et coût par tâche selon l’Intelligence Index v5.0.1
- Lien :
artificialanalysis.ai/models/gpt-6-2-sol - À noter : données tierces ; le coût par tâche de $1.01 au palier Max ne s’applique qu’à cette série d’évaluations
- Lien :
Auteur : Équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter via la page d’accueil du site officiel d’APIYI pour obtenir davantage de ressources sur l’intégration des modèles et la facturation


