
Anmerkung des Autors: Wir schlüsseln die vier Abrechnungsposten von gpt-6.2-sol auf – Eingabe, Cache-Lesen, Cache-Schreiben und Ausgabe –, erklären die Gesamtabrechnung für Anfragen über 272K sowie die Multiplikatoren für Batch/Fast/Ultrafast und zeigen an zwei Beispielen, wie Sie die Kosten bei kurzen und sehr langen Kontexten abschätzen.
OpenAI hat am 17. November 2026 GPT-6.2 Astra und GPT-6.2 Sol veröffentlicht. Für viele Teams steht an erster Stelle, die Rechnung für gpt-6.2-sol abzuschätzen – doch die ausgerechneten Zahlen weichen oft von den tatsächlichen Kosten ab. Der Grund: Die Abrechnung von GPT-6.2 Sol folgt nicht dem Schema „ein Preis für die Eingabe, ein Preis für die Ausgabe“ – stattdessen werden Eingabe, Cache-Lesen, Cache-Schreiben und Ausgabe als vier getrennte Posten verrechnet. Zudem verändern sehr lange Kontexte und Tarifstufen wie Ultrafast die Multiplikatoren.
Dies ist kein bloßes Abschreiben der Preisliste. Dieser Artikel richtet sich nach den Preisregeln auf der OpenAI-Modellseite, stellt die Berechnungsformel für kurze Kontexte vor, erklärt, wie die gesamte Anfrage abgerechnet wird, wenn der Kontext über 272K liegt, und rechnet zu beiden Fällen je ein Beispiel durch. Außerdem klären wir, unter welchen Bedingungen die offizielle Aussage entstanden ist, Sol koste „etwa ein Fünftel von Astra“.
Der Kernnutzen: Nach der Lektüre dieses Artikels können Sie für gpt-6.2-sol selbst eine Rechnung mit vier Spalten aufstellen, beurteilen, ob eine Anfrage die 272K-Grenze überschreitet, und erkennen, welcher Multiplikator die Kosten verdoppelt.
GPT-6.2 Sol: Kernpunkte der Preisgestaltung
Zuerst die Spielregeln: Alle folgenden Zahlen stammen von der offiziellen OpenAI-Modellseite, die Einheit ist der Preis pro 1 Million Token – es handelt sich um offizielle Listenpreise.
| Kernpunkt | Erläuterung | Auswirkung auf die Kostenschätzung |
|---|---|---|
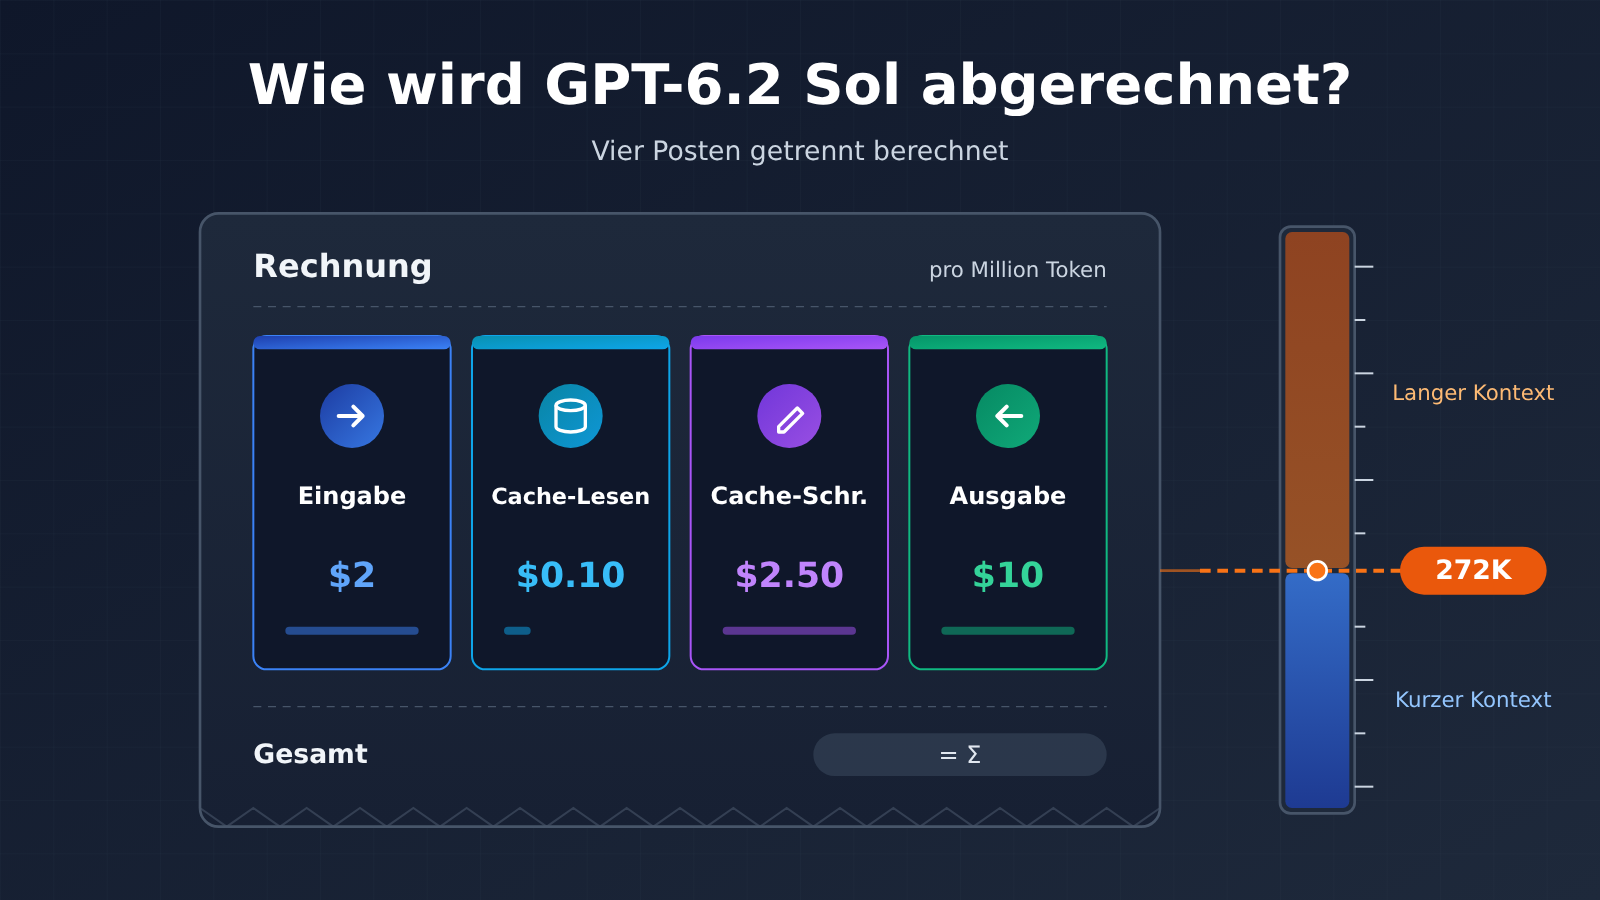
| Vier Posten getrennt rechnen | Eingabe, Cache-Lesezugriff, Cache-Schreibzugriff (in zwei Varianten: 30 Minuten und 12 Stunden) und Ausgabe haben jeweils eigene Preise | Wer nur auf die Ein- und Ausgabepreise schaut, übersieht die Kosten für den Cache-Schreibzugriff |
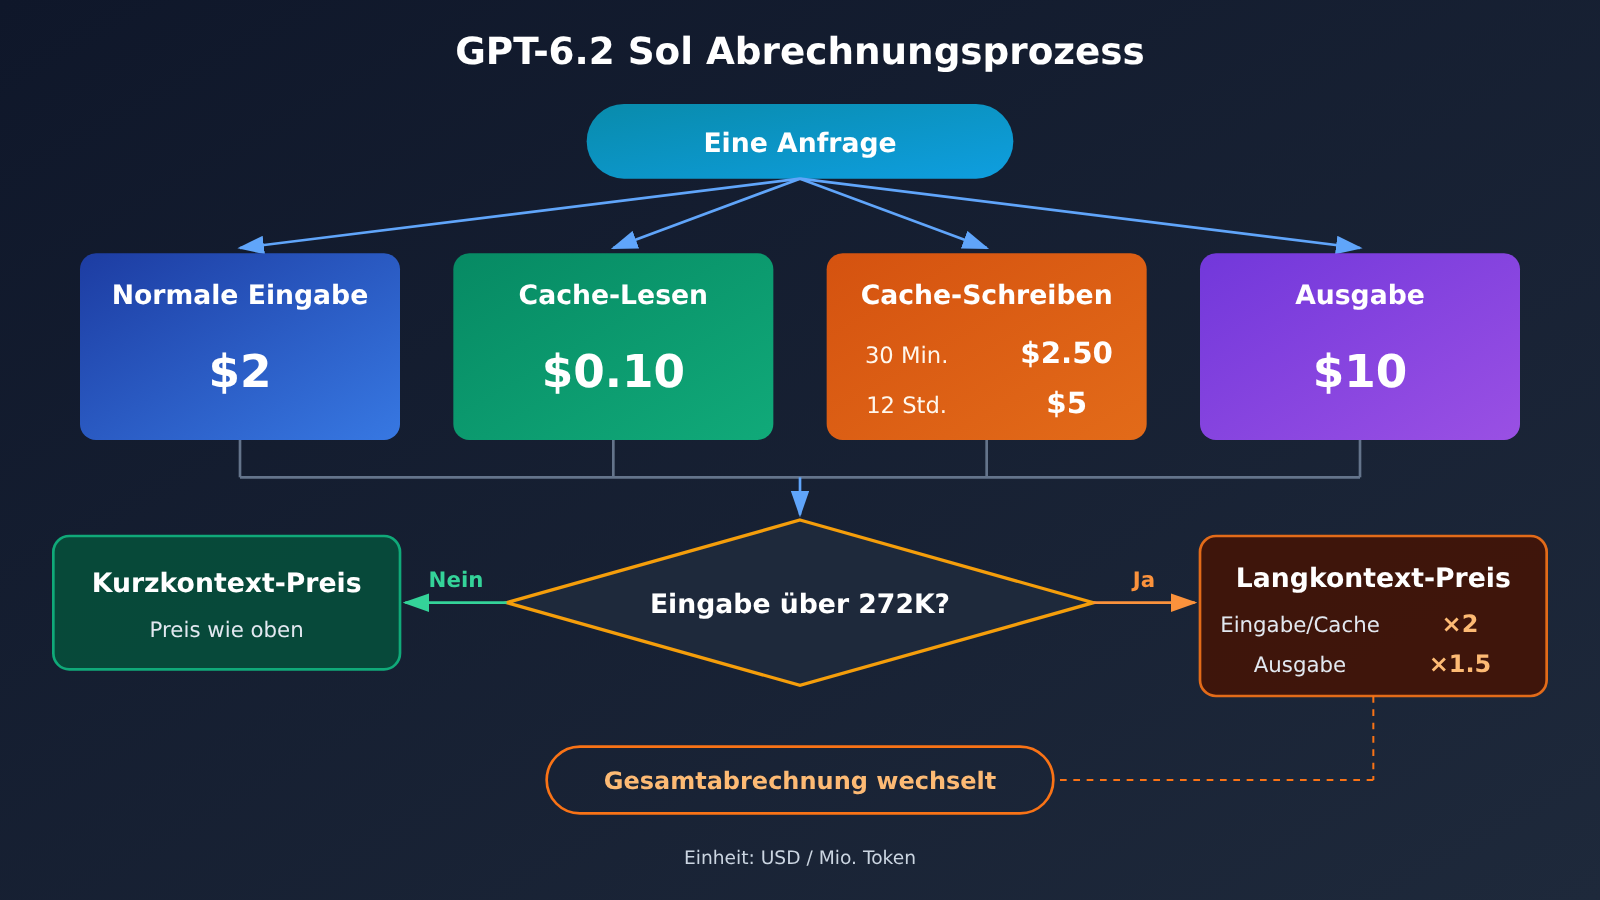
| 272K-Grenze | Übersteigt die Eingabe einer Anfrage 272K Token, verdoppeln sich die Preise für Eingabe und Cache, und die Ausgabe wird zum 1,5-Fachen berechnet | Die Berechnung erfolgt für die gesamte Anfrage, nicht nur für den übersteigenden Teil |
| Stufenfaktoren | Batch liegt bei 50 % des Standardpreises, Fast beim 2-Fachen, Ultrafast derzeit beim 3-Fachen und ab 2027-03-01 beim 6-Fachen | Bei gleicher Tokenmenge kann die Rechnung um mehr als das Zehnfache abweichen |
| Reasoning lässt sich nicht abschalten | Die API akzeptiert es nicht, den Reasoning Effort auf none zu setzen |
Die Token auf der Ausgabeseite sinken nicht auf ein Niveau ohne Reasoning |
| Spezifikationsgrenzen | Kontextfenster 1.050.000, maximale Eingabe 922.000, maximale Ausgabe 128.000 | Sehr lange Anfragen überschreiten zwangsläufig die 272K-Grenze |
Die vier Kostenposten von GPT-6.2 Sol im Detail
Eingabe meint die normalen Token der jeweiligen Anfrage, die keinen Cache-Treffer erzielen; der Listenpreis bei kurzem Kontext liegt bei $2. Cache-Lesezugriff betrifft die Teile, die einen bereits vorhandenen Cache-Präfix treffen; der Einheitspreis beträgt nur $0.10, also ein Zwanzigstel des normalen Eingabepreises. Genau deshalb eignen sich lange System-Eingabeaufforderungen und feste Dokumentpräfixe so gut für die Cache-Wiederverwendung.
Cache-Schreibzugriff wird leicht übersehen. Schon das Schreiben eines Inhalts in den Cache kostet Geld: Der Schreibpreis mit 30 Minuten Aufbewahrung liegt bei $2.50, der mit 12 Stunden bei $5 – beides teurer als die normale Eingabe. Ein Cache spart also nicht automatisch Geld, nur weil man ihn beschreibt. Erst wenn danach genug Cache-Treffer folgen, holt man die Mehrkosten des Schreibens über den günstigen Lesepreis wieder heraus.
Ausgabe ist mit $10 angesetzt und umfasst die vom Modell erzeugte Antwort. Da sich die Reasoning-Intensität nicht auf none stellen lässt, erhöht der Reasoning-Prozess in der Regel auch die Tokenzahl auf der Ausgabeseite; maßgeblich ist das Usage-Feld, das die API-Antwort zurückliefert. Wenn Sie Modelle nachschlagen und Preise abgleichen wollen, orientieren Sie sich an den Echtzeitangaben in der Modellliste der Plattform APIYI (apiyi.com) – und verlassen Sie sich nicht allein auf Angaben aus zweiter Hand.
GPT-6.2 Sol: Preistabelle für kurze Kontexte und über 272K
Die folgende Tabelle stellt die Standardpreise von gpt-6.2-sol bei zwei Kontextlängen gegenüber. Die Spalte für den langen Kontext wurde anhand der Regeln auf der Modellseite berechnet: Die Einzelpreise für Eingabe und Cache werden mit 2 multipliziert, die Ausgabe mit 1,5.
| Abrechnungsposten (pro 1 Million Token) | Kurzer Kontext (≤272K) | Über 272K (gesamte Anfrage) | Regelquelle |
|---|---|---|---|
| Eingabe | $2 | $4 | Modellseite: Eingabe verdoppelt |
| Cache-Lesen | $0.10 | $0.20 | Modellseite: Cache verdoppelt |
| Cache-Schreiben (30 Minuten) | $2.50 | $5 | Modellseite: Cache verdoppelt |
| Cache-Schreiben (12 Stunden) | $5 | $10 | Modellseite: Cache verdoppelt |
| Ausgabe | $10 | $15 | Modellseite: Ausgabe 1,5-fach |
Dies sind die offiziellen Listenpreise von OpenAI. gpt-6.2-sol ist bei APIYI noch nicht gelistet – wir werden dieses Modell so bald wie möglich anbieten. Modellbezeichnung und Preise richten sich nach der Modellliste der Plattform; den aktuellen Status finden Sie auf apiyi.com. Zum Stand der APIYI-Gesamtübersicht vom 2026-11-17, 15:54 Uhr (UTC+8), waren weder gpt-6.2-sol noch gpt-6.2-astra in der Gesamtübersicht oder in der Preis-API enthalten.
Die Regel für die gesamte Anfrage bei GPT-6.2 Sol verstehen
Der Punkt „gilt für die gesamte Anfrage“ wird am häufigsten falsch berechnet. Beträgt die Eingabe einer Anfrage 300K, dürfen Sie nicht die ersten 272K zum Kurzkontext-Preis und die restlichen 28K zum Langkontext-Preis abrechnen. Sobald die Eingabe einer Anfrage die Grenze überschreitet, werden sämtliche Eingaben, Cache-Lese- und Cache-Schreibvorgänge dieser Anfrage zum doppelten Preis berechnet und die Ausgabe zum 1,5-fachen Preis.
Deshalb unterscheiden sich zwei Anfragen mit 270K bzw. 280K Eingabe in der Rechnung weit mehr als nur durch die zusätzlichen 10K Token. Bei RAG oder der Analyse langer Dokumente lohnt es sich meistens mehr, die Eingabe unter 272K zu halten, als noch etwas mehr Kontext unterzubringen.
GPT-6.2 Sol im Vergleich zum Vorgängermodell gpt-6.1-sol
Laut Release-Ankündigung übernimmt Sol die API-Token-Preise von GPT-6.1 Sol. Zum Abgleich lässt sich das bereits gelistete gpt-6.1-sol heranziehen: In der APIYI-Gesamtübersicht auf apiyi.com liegt die Eingabe von gpt-6.1-sol im kurzen Kontext bei $2, die Ausgabe bei $10 und das Cache-Lesen bei $0.1; bei mehr als 272.000 Token kostet die Eingabe $4. Die Endpunkte unterstützen responses und chat.
Wichtig zu betonen: Dies sind die Plattformpreise des Vorgängermodells. Das bedeutet nicht, dass gpt-6.2-sol bereits gelistet ist, und die Werte lassen sich nicht direkt als Plattformpreise für 6.2 verwenden. Außerdem liegt das Cache-Lesen von gpt-6-sol in derselben Tabelle bei $0.2 – anders als bei 6.1. Achten Sie beim Vergleich darauf, nicht in die falsche Zeile zu schauen.
Wie sich die Stufen-Faktoren bei GPT-6.2 Sol überlagern
Neben der Kontextlänge hat auch die Servicestufe Einfluss auf den Preis. Die auf der Modellseite angegebenen Faktoren lauten:
| Stufe | Faktor | Zeitraum und Hinweise |
|---|---|---|
| Standard | 1× | Standardstufe (Voreinstellung) |
| Batch | 0,5× | 50 % des Standardpreises, ideal für zeitlich unkritische Offline-Aufgaben |
| Fast | 2× | Basis ist der Standardpreis derselben Kontextlänge |
| Ultrafast | 3× | bis 2027-02-28 (Pacific Time) |
| Ultrafast | 6× | ab 2027-03-01 |
Beim Fast-Tarif ist die Formulierung auf der Modellseite eindeutig: „das Doppelte des Standardpreises derselben Kontextlänge“. Das heißt, wer Anfragen jenseits von 272K mit Fast abwickelt, muss den Langkontext-Preis zusätzlich mit dem Faktor 2 multiplizieren. Bei Batch und Ultrafast steht im Originaltext dagegen nur, dass es sich um Faktoren des „Standardpreises“ handelt. Wie sich die Faktoren für sehr lange Anfragen in diesen beiden Stufen konkret überlagern, ist daraus nicht eindeutig ersichtlich – im Zweifel sollte man sich an der offiziellen Abrechnung orientieren. Für eine erste Schätzung bietet es sich an, vorerst vom Standardpreis derselben Kontextlänge auszugehen und diesen mit dem jeweiligen Faktor zu multiplizieren.
Die Stichtage beim Ultrafast-Tarif sollte man gesondert festhalten. Ein Budget, das auf den aktuellen Werten basiert, kann sich ab März 2027 schlagartig verdoppeln. Wer geschäftlich auf Ultrafast angewiesen ist, sollte in der Budgetplanung am besten gleich die Stufe mit Faktor 6 einplanen.
GPT-6.2 Sol Schnellstart: Zwei Rechenbeispiele zur Kostenabschätzung
Die folgenden beiden Beispiele kommen nur mit Addition und Multiplikation aus, und alle Zahlen stehen direkt im Fließtext, sodass Sie sie ohne Umwege auf Ihre eigene Nutzung übertragen können. Jedes Token wird dabei nur in genau eine Kategorie gezählt; welcher Kategorie ein bestimmter Teil der Token zugeordnet wird, entscheidet das usage-Feld, das die API zurückgibt.
Beispiel 1: Anfrage mit kurzem Kontext
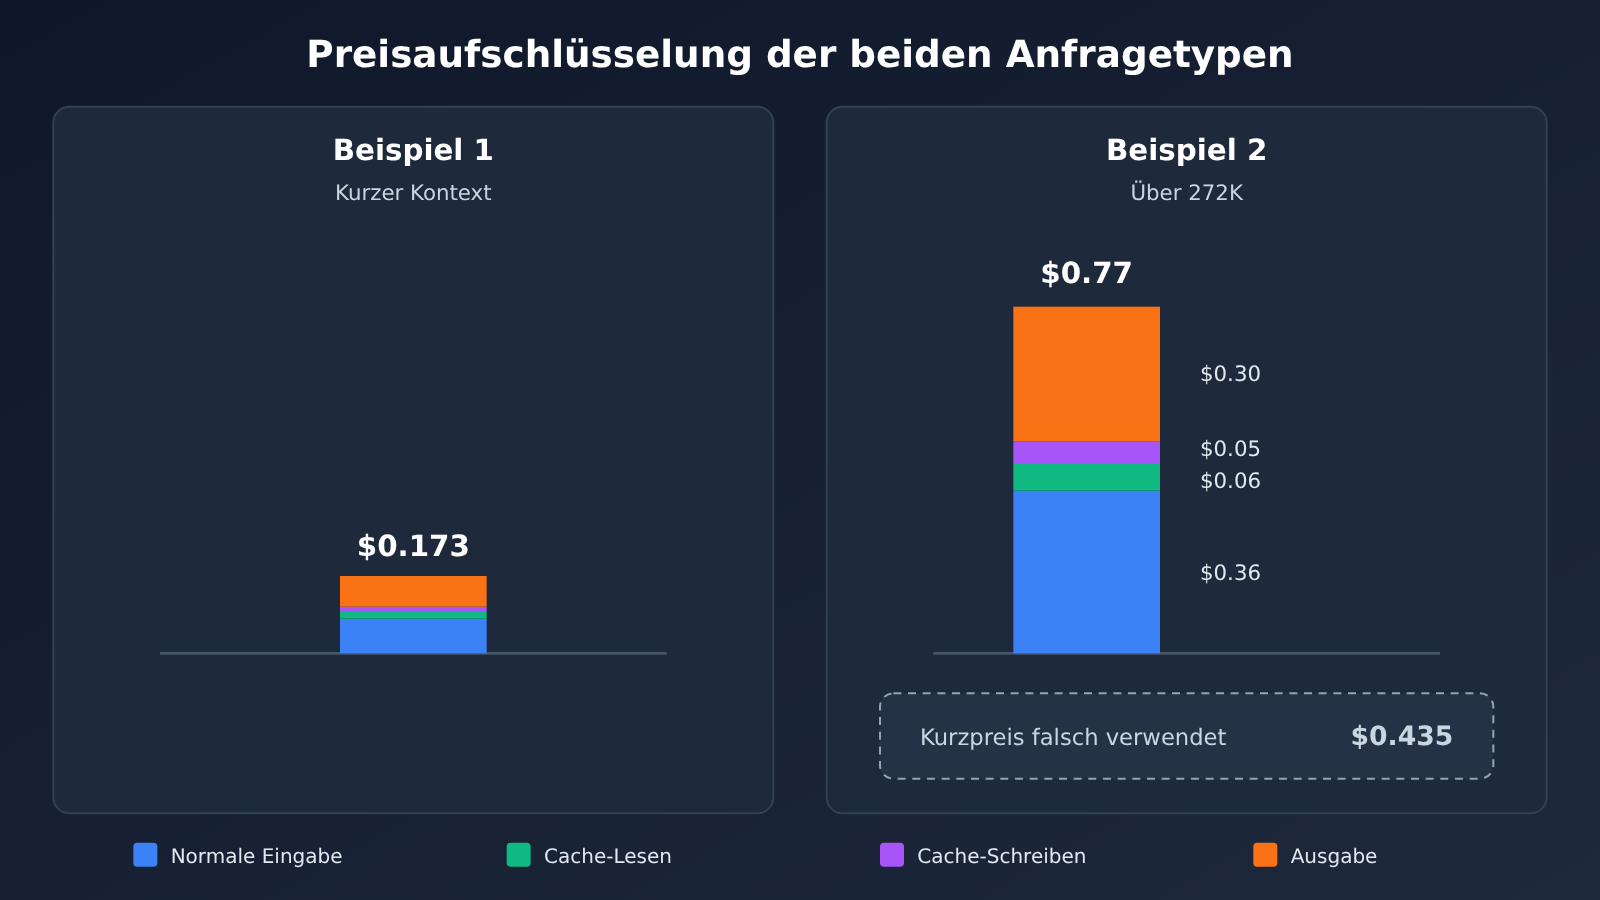
Angenommen, die Eingabe einer Anfrage umfasst insgesamt 120.000 Token: 80.000 davon werden aus dem Cache gelesen (Cache-Lesen), 10.000 werden in den 30-Minuten-Cache geschrieben, 30.000 sind normale Eingabe, und die Ausgabe beträgt 8.000 Token.
- Normale Eingabe: 30.000 × $2 ÷ 1.000.000 =
$0.06 - Cache-Lesen: 80.000 × $0.10 ÷ 1.000.000 =
$0.008 - Cache-Schreiben (30 Minuten): 10.000 × $2.50 ÷ 1.000.000 =
$0.025 - Ausgabe: 8.000 × $10 ÷ 1.000.000 =
$0.08
Insgesamt kostet diese Anfrage also $0.173. Dabei fällt auf: 8.000 Ausgabe-Token sind zehnmal so teuer wie 80.000 Cache-Lese-Token. Wenn Sie bei der Schätzung nur die Gesamtmenge der Eingabe betrachten, weicht Ihr Ergebnis stark ab.
Beispiel 2: Gesamte Anfrage über 272K
Angenommen, eine Anfrage enthält insgesamt 400.000 Token als Eingabe: 300.000 davon sind Cache-Lesezugriffe, 10.000 werden in den 30-Minuten-Cache geschrieben, 90.000 sind normale Eingaben, und die Ausgabe umfasst 20.000 Token. Da die Eingabe 272K übersteigt, wird die gesamte Anfrage zum Langkontext-Preis abgerechnet.
- Normale Eingabe: 90.000 × $4 ÷ 1.000.000 =
$0.36 - Cache-Lesezugriff: 300.000 × $0.20 ÷ 1.000.000 =
$0.06 - Cache-Schreibzugriff (30 Minuten): 10.000 × $5 ÷ 1.000.000 =
$0.05 - Ausgabe: 20.000 × $15 ÷ 1.000.000 =
$0.30
Insgesamt beläuft sich diese Anfrage damit auf $0.77. Würde man fälschlicherweise den Kurzkontext-Preis anwenden, käme nur $0.435 heraus – fast die Hälfte zu wenig.
| Tarifstufe (Basis: Beispiel 2) | Berechnung | Kosten pro Anfrage |
|---|---|---|
| Standard | Originalpreis | $0.77 |
| Batch | × 0.5 | $0.385 |
| Fast | × 2 | $1.54 |
| Ultrafast (bis 2027-02-28) | × 3 | $2.31 |
| Ultrafast (ab 2027-03-01) | × 6 | $4.62 |
Bei ein und derselben Anfrage liegen die Kosten zwischen Batch und dem Ultrafast-Tarif ab 2027 um den Faktor 12 auseinander. Die Wahl der Tarifstufe wirkt sich auf die Rechnung oft stärker aus als die Anpassung der Länge der Eingabeaufforderung.
Verbrauch über das OpenAI-kompatible Protokoll abgleichen
Bezüglich der Integration unterstützt gpt-6.2-sol offiziell Chat Completions und Responses sowie Batch; nicht unterstützt werden Realtime, Assistants, Fine-Tuning, Bilderzeugung, Video und Sprache. Das Modell nimmt nur Text und Bilder entgegen und gibt Text aus.
Wenn Sie den Kostenschätzungsablauf zunächst mit dem bereits verfügbaren gpt-6.1-sol durchtesten möchten, gehen Sie wie folgt vor:
- Setzen Sie in einem OpenAI-kompatiblen Client die Base URL auf
https://api.apiyi.com/v1und geben Sie als Modellgpt-6.1-solein. - Stellen Sie die Reasoning-Stärke auf gültige Werte wie
lowodermediumein, nicht aufnone. Die beiden 6.2-Modelle weisennonein der offiziellen API direkt zurück. - Notieren Sie nach jeder Anfrage den zurückgegebenen usage-Wert – halten Sie die vier Zahlen für normale Eingabe, Cache-Lesezugriff, Cache-Schreibzugriff und Ausgabe getrennt fest.
- Setzen Sie die vier Zahlen in die obige Preistabelle ein und prüfen Sie, ob die Eingabe 272K überschreitet.
Sobald gpt-6.2-sol verfügbar ist, müssen Sie nur die Modell-ID ersetzen und die Preise aktualisieren.
Vollständige Kostenschätzungs-Checkliste anzeigen
– Schritt 1: Erfassen Sie die Gesamteingabe und prüfen Sie, ob 272K überschritten wird, um festzulegen, ob für die gesamte Abrechnung der Kurzpreis oder der Langpreis gilt.
– Schritt 2: Teilen Sie die Eingabe in drei Spalten auf: normale Eingabe, Cache-Lesezugriff und Cache-Schreibzugriff (unterschieden nach 30 Minuten und 12 Stunden).
– Schritt 3: Erfassen Sie die Ausgabe-Tokens; bei aktiviertem Reasoning gilt der zurückgemeldete Verbrauch als maßgeblich.
– Schritt 4: Multiplizieren Sie jede der vier Spalten mit dem Einzelpreis und addieren Sie die Ergebnisse – das ergibt die Kosten der Standardstufe.
– Schritt 5: Multiplizieren Sie mit dem Stufenfaktor: Batch 0,5, Fast 2, Ultrafast je nach Datum 3 oder 6.
– Schritt 6: Multiplizieren Sie mit der durchschnittlichen Anzahl an Anfragen pro Tag, um das Tagesbudget zu erhalten; schätzen Sie die Cache-Trefferquote konservativ ein.
🚀 Schnellstart: Es empfiehlt sich, zuerst bei APIYI (apiyi.com) kostenloses Testguthaben abzurufen und mit dem bereits verfügbaren gpt-6.1-sol ein paar echte Anfragen auszuführen. Sobald Sie die vier usage-Spalten vorliegen haben, können Sie die Formeln aus diesem Artikel anwenden. So lässt sich das Budget realistischer abschätzen als durch rein theoretische Berechnungen.
Was hat es mit dem „Fünftel“ bei GPT-6.2 Sol und Astra auf sich?
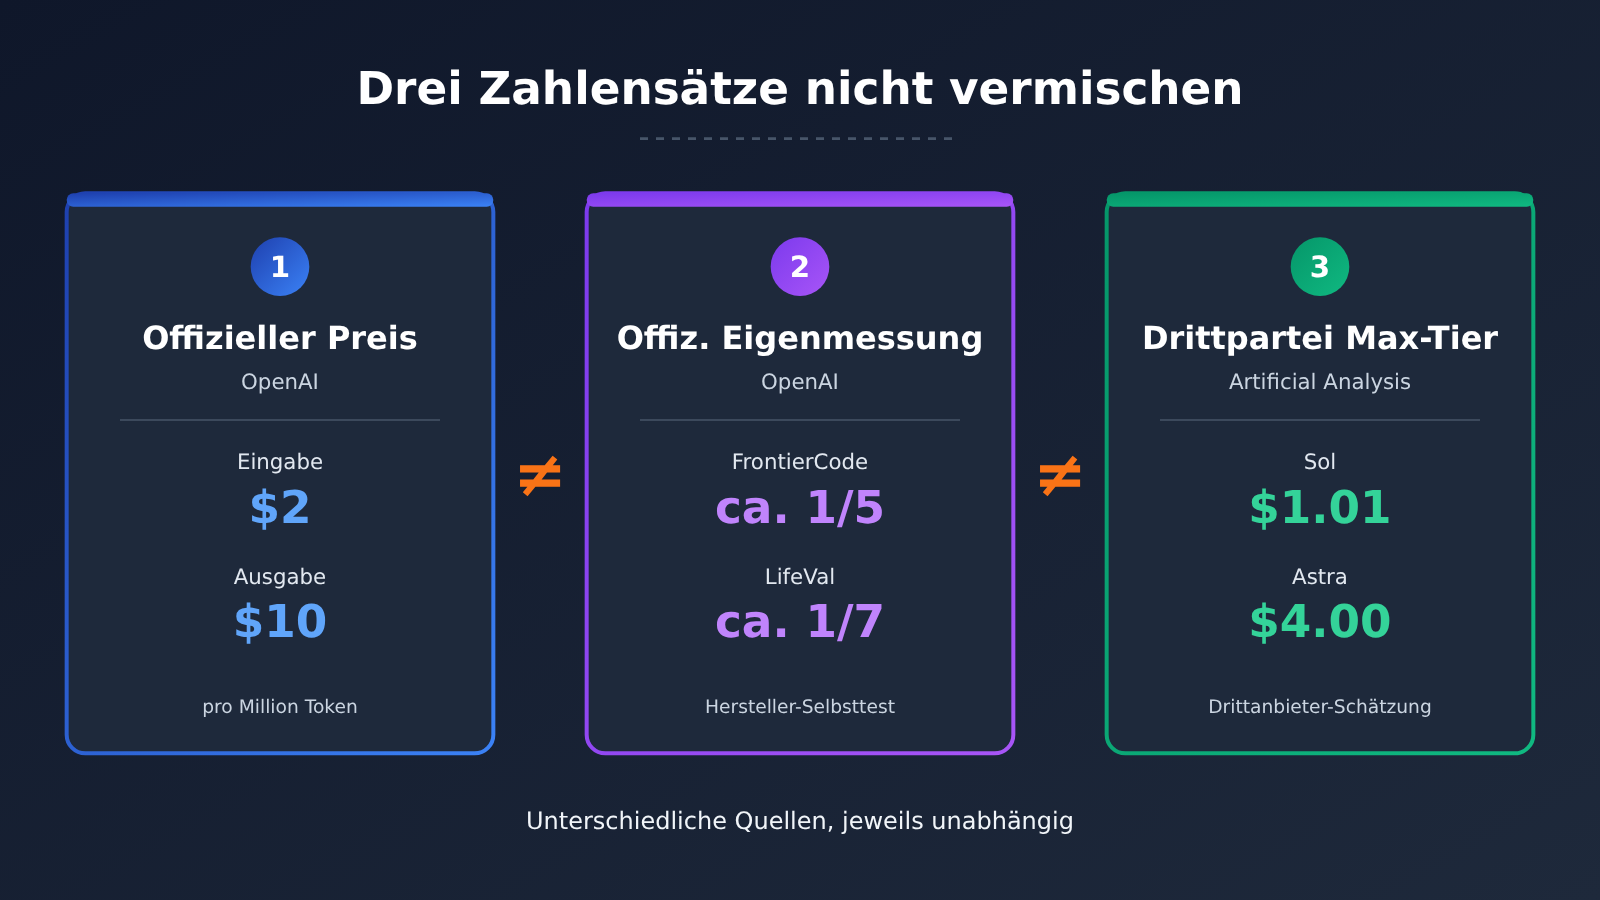
Im offiziellen Veröffentlichungsbeitrag steckt eine Aussage, die leicht missverstanden werden kann: Im FrontierCode 2.0-Benchmark von Cognition (er prüft, ob Änderungen an echten Codebasen von den Maintainern gemergt werden können) liegen GPT-6.2 Sol und GPT-6.2 Astra weniger als 0,5 Punkte auseinander, bei etwa einem Fünftel der Kosten – beide nutzen die Max-Reasoning-Stufe. Dabei handelt es sich um eine offizielle Selbstangabe von OpenAI, und sie bezieht sich nur auf diesen einen Benchmark.
Das heißt nicht, dass Sol bei jeder einzelnen Anfrage genau ein Fünftel von Astra kostet. Nach den Listenpreisen liegt Sol bei $2 für die Eingabe und $10 für die Ausgabe, Astra bei $8 beziehungsweise $40 – das Preisverhältnis beträgt ein Viertel. Das tatsächliche Kostenverhältnis pro Anfrage hängt zudem davon ab, wie viele Token beide Modelle für dieselbe Aufgabe verbrauchen. Der Token-Verbrauch unterscheidet sich je nach Aufgabe erheblich, das Verhältnis ändert sich also entsprechend. Eine weitere offizielle Selbstangabe betrifft LifeVal: Sol erzielt dort höhere Punktzahlen als GPT-6 Astra, bei etwa einem Siebtel der Kosten – auch das gilt nur für genau diese Aufgabensammlung.
Die Zahlen des Drittanbieters Artificial Analysis folgen wiederum einem eigenen System. In dessen Intelligence Index v5.0.1 erreicht Sol auf der Max-Reasoning-Stufe 57 Punkte, die Kosten pro Aufgabe im Gesamtindex betragen $1.01; Astra kommt auf der Max-Reasoning-Stufe auf 62 Punkte und liegt bei $4.00 pro Aufgabe. Diese $1.01 gehören ausschließlich zur Bewertung des Gesamtindex. Sie lassen sich weder mit dem offiziellen FrontierCode-„Fünftel“ multiplizieren noch dividieren – und taugen auch nicht als Kosten pro Anfrage im eigenen Betrieb.
GPT-6.2 Sol und andere Modelle: Vergleich der offiziellen Listenpreise
| Modell (offizielle Listenpreise, pro 1 Mio. Token) | Eingabe | Ausgabe | Cache-Lesezugriff | Regel bei sehr langem Kontext |
|---|---|---|---|---|
| GPT-6.2 Sol | $2 | $10 | $0.10 | Bei mehr als 272K Aufpreis auf die gesamte Abrechnung |
| GPT-6.2 Astra | $8 | $40 | $0.40 | Bei mehr als 272K Aufpreis auf die gesamte Abrechnung |
| Claude Fable 5.2 | $8 | $40 | $0.20 | In der Dokumentation nicht aufgeführt |
| Claude Opus 5.5 | $4 | $20 | $0.20 | In der Dokumentation nicht aufgeführt |
| Gemini 4 Carbon (bis 30.11.) | $2 | $10 | $0.10 | Google-Preisliste ohne Verdopplung der Gesamtabrechnung ab 272K |
| Gemini 4 Carbon (ab 01.12.) | $4 | $20 | $0.20 | Wie oben |
Alle Preise in der Tabelle sind die offiziellen Listenpreise der jeweiligen Hersteller, nicht die Plattformpreise von APIYI. Der offizielle Listenpreis von GPT-6.2 Astra liegt bei $8 für die Eingabe, $0.40 für Cache-Lesezugriffe, $10 für das Schreiben eines 30-Minuten-Caches und $40 für die Ausgabe. Genauso wie gpt-6.2-sol ist dieses Modell auf APIYI noch nicht gelistet – wir werden es so bald wie möglich verfügbar machen; maßgeblich für Modellbezeichnungen und Preise ist die Modellliste der Plattform. Außerdem ist Gemini 4 Carbon auf der APIYI-Infoseite mit einem Einführungspreis ausgewiesen; der Anbieter erhöht die Preise zum 01.12.2026 – ab dann gilt bitte ebenfalls die Plattformliste.
💡 Auswahlempfehlung: Eine Einzelpreistabelle zeigt nur Preisunterschiede bei gleicher Token-Menge – sie sagt nichts darüber aus, welches Modell für deine Aufgaben insgesamt günstiger ist. Am besten vergleichst du auf APIYI unter apiyi.com die bereits gelisteten Modelle mit denselben echten Anfragen, schaust dir usage und Ergebnisse an und triffst dann deine Entscheidung.
Häufig gestellte Fragen (FAQ)
Q1: Wie wird GPT-6.2 Sol abgerechnet – und warum getrennt?
GPT-6.2 Sol wird pro 1 Million Token in vier getrennten Positionen abgerechnet: Eingabe ($2), Cache-Lesen ($0.10), Cache-Schreiben ($2.50 für 30 Minuten, $5 für 12 Stunden) und Ausgabe ($10). Das sind die offiziellen Standardpreise für kurze Kontexte. Die Stückpreise der vier Positionen unterscheiden sich um mehr als das Hundertfache – wer nur mit der Gesamt-Tokenzahl rechnet, erhält stark verzerrte Ergebnisse.
Q2: Wird nach Überschreiten von 272K nur der übersteigende Teil teurer?
Nein. Auf der Modellseite ist ausdrücklich die Abrechnung über die gesamte Anfrage festgehalten: Sobald die Eingabe einer Anfrage 272K übersteigt, verdoppeln sich die Eingabe- und Cache-Stückpreise der gesamten Anfrage, und die Ausgabe wird mit dem 1,5-Fachen berechnet. Liegt die Eingabe knapp an der Grenze, lohnt es sich zu überlegen, den Kontext unter 272K zu drücken.
Q3: Wann wird GPT-6.2 Sol veröffentlicht und wo kann man es nutzen?
OpenAI hat es am 2026-11-17 veröffentlicht. Offiziellen Angaben zufolge können Plus-, Pro-, Enterprise- und Edu-Kunden das Modell in ChatGPT Work und Codex nutzen, Entwickler rufen es über die OpenAI API auf; Ultrafast wird ab Veröffentlichung unterstützt. Bei APIYI ist das Modell noch nicht gelistet – wir werden es so bald wie möglich anbieten. Für Modellname und Preis gilt die Modellliste der Plattform.
Q4: Das Cache-Schreiben ist teurer als die normale Eingabe – lohnt sich das trotzdem?
Das hängt von der Anzahl der Wiederverwendungen ab. Das 30-Minuten-Schreiben kostet pro Million $0.50 mehr als eine normale Eingabe, dafür spart jeder folgende Cache-Treffer $1.90. Wird ein Präfix innerhalb von 30 Minuten mehr als einmal getroffen, amortisiert sich das in der Regel. Das 12-Stunden-Schreiben kostet $5 und eignet sich für feste Präfixe, die den ganzen Tag über häufig wiederverwendet werden.
Q5: Wie lässt sich die Kostenschätzung üben, bevor 6.2 gelistet ist?
Zum Üben eignet sich das bereits verfügbare gpt-6.1-sol; laut offiziellen Angaben übernimmt 6.2 Sol dessen Token-Preise. Registrieren Sie sich auf apiyi.com bei APIYI und sichern Sie sich Testguthaben, setzen Sie dann in einem OpenAI-kompatiblen Client die Base URL auf `https://api.apiyi.com/v1`, notieren Sie die vier Usage-Positionen und wenden Sie die Formeln aus diesem Artikel an. Beachten Sie: Der Plattformpreis für gpt-6.1-sol ist nur der Preis des Vorgängermodells – das heißt nicht, dass 6.2 bereits gelistet ist.
Q6: Ändert sich der Multiplikator für Ultrafast?
Ja. Bis zum 2027-02-28 (Pazifische Zeit) gilt das 3-Fache des Standardpreises, ab dem 2027-03-01 das 6-Fache. Für die langfristige Budgetplanung empfiehlt es sich, gleich das 6-Fache als Obergrenze anzusetzen.
Q7: Welche bekannten Einschränkungen hat GPT-6.2 Sol?
Die Reasoning-Intensität lässt sich nicht auf `none` setzen, daher kann man die Ausgabekosten nicht durch Deaktivieren des Reasonings senken. Audio- und Videoeingaben werden nicht unterstützt, ebenso wenig Realtime, Assistants und Fine-Tuning. Der Drittanbieter Artificial Analysis weist darauf hin, dass Sol bei SWE-Atlas-QnA-AA 14 Punkte hinter 6.1 Sol liegt und wichtige Fakten leichter übersieht. Auch in den offiziellen Alignment-Bewertungen heißt es, dass das Modell in einigen Tests dazu neigt, blockierende Probleme wie fehlende Dateien oder nicht verfügbare Tools nicht zu melden.
GPT-6.2 Sol Preisgestaltung: Die wichtigsten Punkte auf einen Blick
- Vier getrennte Preispositionen: Eingabe $2, Cache-Lesen $0,10, Cache-Schreiben $2,50 oder $5, Ausgabe $10 (offizieller Listenpreis für kurzen Kontext)
- Die 272K-Regel gilt für die Gesamtanfrage: Sobald die Schwelle überschritten ist, verdoppeln sich Eingabe- und Cache-Preise für die gesamte Anfrage, und die Ausgabe wird mit Faktor 1,5 berechnet
- Die Preisstufen machen den größten Unterschied: Batch mit Faktor 0,5, Fast mit Faktor 2, Ultrafast mit Faktor 3 – ab März 2027 mit Faktor 6
- „Ein Fünftel“ gilt nicht pauschal: Es bezieht sich nur auf den offiziell selbst ausgewiesenen FrontierCode 2.0 (Max-Stufe) – nicht auf jede einzelne Anfrage
- Drittanbieter-Zahlen separat lesen: Die $1,01, die Artificial Analysis für die Max-Stufe ausweist, gehören ausschließlich zur Bewertung des Gesamtindex
- So starten Sie: Bevor 6.2 gelistet ist, lässt sich der Workflow für die usage-Erfassung vorab mit gpt-6.1-sol auf APIYI unter apiyi.com durchtesten
Zusammenfassung
Die Kernpunkte der GPT-6.2 Sol Preisgestaltung:
- Berechnung pro Position: Eingabe, Cache-Lesen, Cache-Schreiben und Ausgabe werden jeweils mit ihrem Einzelpreis multipliziert – Cache-Schreiben darf auf keinen Fall vergessen werden.
- Zuerst die 272K-Schwelle prüfen: Liegt die Anfrage darüber, gilt für die gesamte Anfrage der Langkontext-Preis. Würde man im zweiten Beispiel fälschlich den Kurzkontext-Preis ansetzen, läge das Ergebnis um fast die Hälfte zu niedrig.
- Zuletzt die Faktoren anwenden: Die Stufen-Multiplikatoren bestimmen die Größenordnung der Rechnung – das Stichdatum für den Ultrafast-Preisanstieg gehört fest ins Budget.
Für die Kostenschätzung empfiehlt sich dieses Vorgehen: Berechnen Sie zuerst mit der Formel aus dem Kurzbeispiel die Ausgaben für alltägliche Anfragen, prüfen Sie anschließend mit dem Extrembeispiel (sehr langer Kontext) die Grenzfälle, und dokumentieren Sie zum Schluss offizielle Selbstangaben, Drittanbieter-Bewertungen und Ihre eigenen usage-Daten getrennt voneinander – vermischen Sie sie nicht zu einem einzigen Fazit.
Empfehlung: Prüfen Sie zunächst auf APIYI unter apiyi.com mit bereits gelisteten Modellen, ob usage-Statistik und Kostenmodell sauber funktionieren. Sobald gpt-6.2-sol verfügbar ist, tauschen Sie einfach Modell-ID und Einzelpreise aus – die bestehende Einbindung läuft unverändert weiter.
📚 Referenzen
-
OpenAI-Ankündigungsbeitrag: Vorstellung von GPT-6.2 Astra und Sol, inklusive offiziell gemeldeter Benchmarks und Preisübersicht
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol - Hinweis: Quelle der offiziell gemeldeten Daten zu FrontierCode, LifeVal u. a.
- Link:
-
OpenAI-Modellseite gpt-6.2-sol: Spezifikationen, vierspaltige Preistabelle, 272K-Regel und Stufen-Multiplikatoren
- Link:
platform.openai.com/docs/models/gpt-6.2-sol - Hinweis: Wichtigste Grundlage für die Preisregeln in diesem Artikel
- Link:
-
OpenAI-Systemkarte: Sicherheits- und Alignment-Bewertungen
- Link:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Hinweis: Für Informationen zu Schutzmaßnahmen und bekannten Verhaltenseinschränkungen
- Link:
-
Unabhängige Bewertung von Artificial Analysis: Punktzahlen der einzelnen Reasoning-Stufen im Intelligence Index v5.0.1 sowie Kosten pro Aufgabe
- Link:
artificialanalysis.ai/models/gpt-6-2-sol - Hinweis: Daten aus dritter Hand; die Kosten pro Aufgabe in der Max-Stufe ($1.01) beziehen sich ausschließlich auf diese Benchmark-Suite
- Link:
Autor: APIYI-Technikteam
Technischer Austausch: Besuchen Sie uns gerne über die Startseite der APIYI-Website, um weitere Informationen zur Modellanbindung und Abrechnung zu erhalten


