
Note de l’auteur : la durée d’une tâche Codex dépend conjointement du modèle, de l’intensité de raisonnement, du chemin de service, de la boucle d’outils, du cache et du réseau ; un comparatif sur une même tâche avec un chronométrage par segment permet d’identifier le goulot d’étranglement.
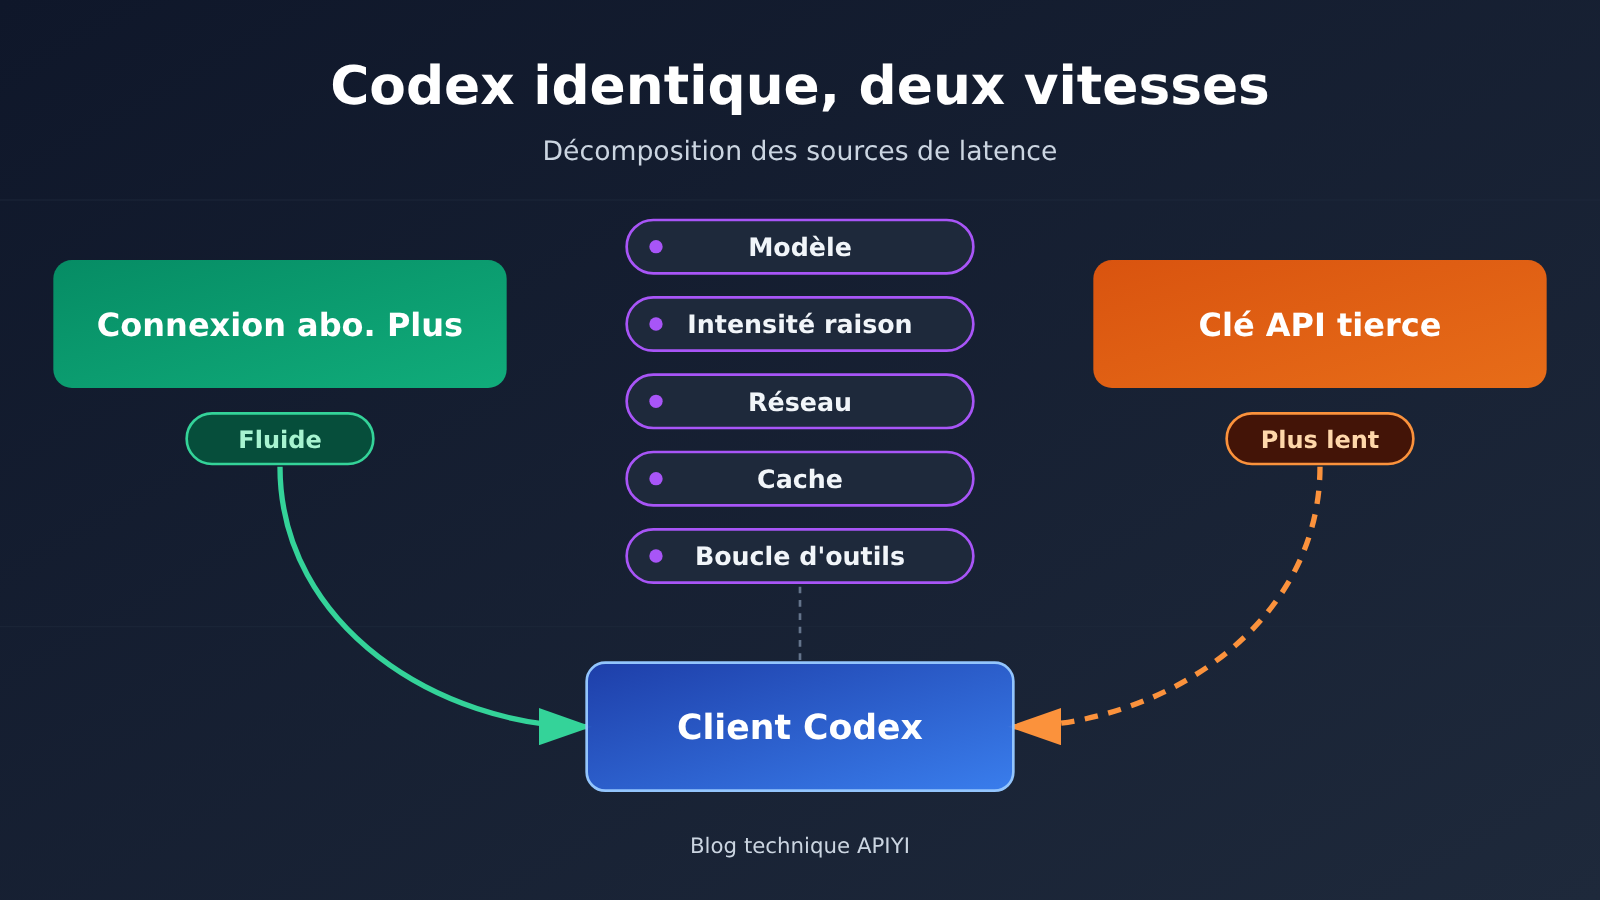
Un même Codex, fluide lorsqu’on se connecte avec ChatGPT Plus, devient plus lent après passage à une clé API tierce : la cause tient généralement au fait que les deux empruntent des chemins de service différents, et la boucle d’agent de Codex multiplie l’accumulation de la latence supplémentaire à chaque tour de requête. L’interface client est identique, mais le déploiement du modèle, le niveau de raisonnement, le protocole de transport, les hits de cache et le degré de compatibilité des événements d’outils peuvent tous varier. Trois secondes d’attente en plus par requête peuvent ajouter environ une minute à une tâche de programmation qui nécessite 20 appels séquentiels.
La suite décompose d’abord le fonctionnement de Codex et les deux chemins d’accès, puis détaille une à une les sources de latence d’une API tierce, en s’appuyant sur deux GitHub Issues publics comme cas d’espèce. Elle présente ensuite quatre indicateurs clés, trois séries de tests comparatifs et des optimisations classées par symptôme, pour vous aider à déterminer si votre Codex est lent à cause du modèle, du réseau, du cache ou de la boucle d’outils. Enfin, elle examine quels indicateurs, au moment de choisir une API tierce, reflètent mieux le coût réel que le prix unitaire.
À savoir : le vocabulaire pour comprendre les écarts de vitesse de Codex
| Terme | Explication |
|---|---|
| Codex Harness | Le cadre d’exécution de Codex, qui organise le modèle, les outils, le contexte et la boucle de tâches sur plusieurs tours. |
| Responses API | L’interface fournie par OpenAI, qui gère la sortie du modèle, les appels d’outils et l’état sur plusieurs tours ; Codex en dépend pour fonctionner. |
| TTFT | Time To First Token : le temps d’attente entre l’envoi de la requête et la réception du premier token de sortie. |
| TPS | Tokens Per Second : le nombre de tokens générés par seconde, qui reflète la vitesse de sortie continue. |
| Durée de bout en bout | Le temps total entre la soumission d’une tâche et son achèvement final, en incluant tous les appels au modèle et toutes les exécutions d’outils. |
| Intensité de raisonnement | Le niveau de profondeur de réflexion du modèle, par exemple low, medium, high ; plus le niveau est élevé, plus la sortie est généralement longue et le temps d’exécution important. |
| Appel d’outils (Tool Calling) | Le processus par lequel le modèle demande à un programme externe de lire un fichier, d’exécuter une commande, etc., puis reprend son raisonnement avec le résultat obtenu. |
| Cache d’invites (Prompt Caching) | Lorsque le préfixe d’entrée est répété et remplit les conditions requises, la réutilisation des calculs déjà effectués permet de réduire le temps de traitement. |
| SSE | Server-Sent Events : le serveur pousse en continu des événements via une connexion HTTP unidirectionnelle. |
| WebSocket | Un type de connexion bidirectionnelle persistante, où plusieurs tours de requêtes peuvent réutiliser la même connexion. |
| previous_response_id | Un paramètre de la Responses API qui référence la réponse du tour précédent ; combiné à une entrée incrémentale, il permet de réduire les transferts redondants. |
| Niveau de service | Les différentes options de traitement d’un même modèle, comme Standard et Fast, avec des vitesses et des prix qui varient. |
1 Pourquoi un même Codex peut-il afficher deux vitesses différentes ?
1.1 Connexion par abonnement Codex et clé API : deux chemins de service distincts
D’après la documentation d’authentification d’OpenAI, Codex CLI, les extensions IDE et l’application desktop acceptent deux modes de connexion : soit un compte ChatGPT, soit une clé API. La connexion ChatGPT puise dans les droits d’utilisation Codex inclus dans l’abonnement et dans les quotas correspondants ; la clé API, elle, suit la facturation à l’usage et les règles de limitation de débit du compte API. L’abonnement Plus, en soi, ne donne pas le droit d’appeler gratuitement n’importe quelle API OpenAI.
Quand vous branchez une clé API tierce, le client Codex se contente d’organiser la tâche : l’inférence réelle se déroule sur le service caché derrière cette interface. Le modèle effectivement appelé, le mode de facturation, le protocole de streaming et la qualité de service dépendent tous de l’interface tierce et de son implémentation côté backend. Résultat : même si le nom de modèle affiché dans le client est identique, cela prouve seulement que vous avez choisi le même nom — pas que les deux requêtes sont passées par le même déploiement de modèle, la même file de service et le même chemin de transmission.
1.2 La boucle Agent de Codex l’oblige à requêter le modèle encore et encore
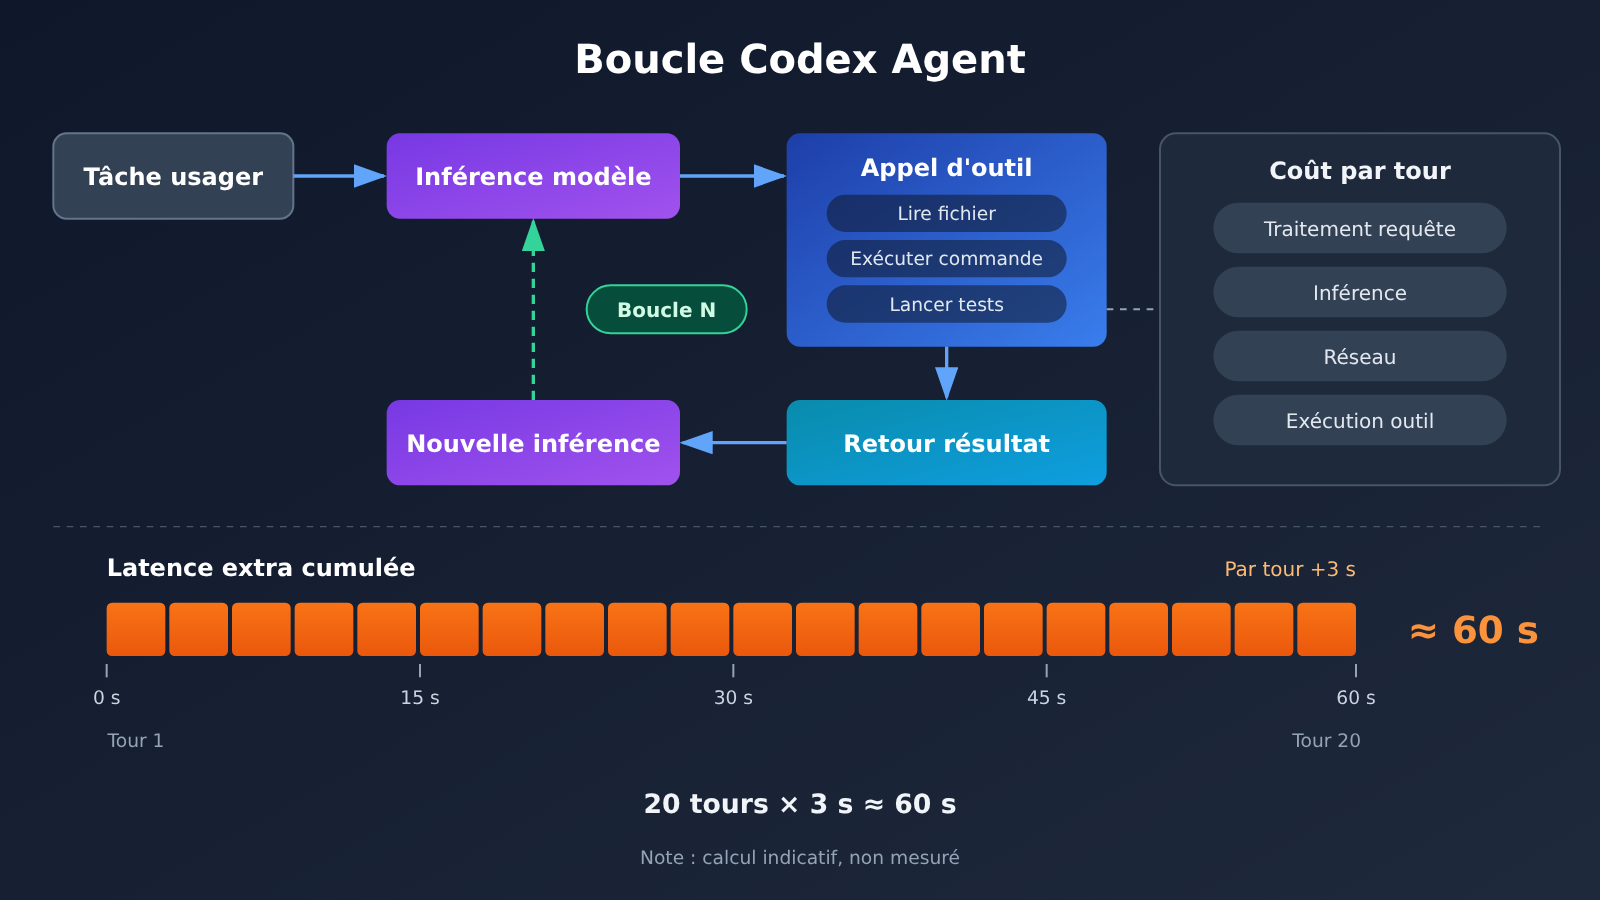
Dans « Codex as a platform », publié le 19 août 2026, OpenAI explique que l’Agent Harness open source de Codex est chargé de comprendre la tâche, de maintenir le contexte, d’explorer la base de code, d’appeler le shell, d’éditer des fichiers, de lancer des tests, et de gérer la reprise après échec, les approbations utilisateur et les limites d’exécution. C’est par nature un système en boucle : « inférence du modèle → exécution des outils → nouvelle inférence ».
Dans un article d’ingénierie du 22 avril 2026, OpenAI décrit le déroulé typique : l’utilisateur soumet une tâche de modification, le modèle décide quoi faire, Codex lit des fichiers ou exécute des commandes, les outils renvoient leurs résultats, le modèle réanalyse, puis continue d’appeler des outils, de modifier le code, de lancer les tests et de vérifier les résultats. Une tâche complexe peut comporter des dizaines d’allers-retours entre le modèle et les outils, et chaque aller-retour est une requête API complète.
2 D’où viennent les écarts de vitesse de Codex lorsqu’on le branche sur une API tierce ?
Commençons par un tableau qui résume les cinq sources de latence, puis nous les détaillerons une par une.
| Source de latence | Indicateurs principalement affectés | Manifestation typique | Priorité de diagnostic |
|---|---|---|---|
| Modèle et intensité de raisonnement | TPS, temps de raisonnement par tour | Sortie systématiquement lente, temps de réflexion long | Élevée |
| Niveau de service et routage | TTFT, amplitude des variations | Première réponse lente ou très irrégulière | Élevée |
| Passerelle et chemin réseau | Temps supplémentaire fixe par tour | Quelques secondes stables ajoutées à chaque appel | Moyenne |
| Protocole de transport (SSE / WebSocket) | Coût cumulé sur plusieurs tours, stabilité de la connexion | Tâches longues ralenties, coupures en cours de route | Moyenne |
| Cache et boucles d’outils | Temps de traitement des entrées, nombre de tours d’appel | Conversations longues nettement ralenties, trop de tours | Élevée |
2.1 Impact de la vitesse d’inférence et de l’intensité de raisonnement sur le temps d’exécution de Codex
Avant de comparer deux modes d’accès, il faut d’abord vérifier que l’ID réel du modèle, l’intensité de raisonnement, la version du modèle et le niveau de service sont bien identiques. L’intensité de raisonnement va de low à xhigh, max : plus le niveau est élevé, plus le modèle génère de contenu de réflexion et plus un tour prend du temps.
Le guide d’optimisation de la latence d’OpenAI classe le nombre de tokens de sortie parmi les variables clés qui influencent le temps d’inférence : dans certains cas, réduire les tokens de sortie d’environ 50 % peut aussi faire chuter la latence de génération de près de 50 % ; en revanche, réduire le texte d’entrée ordinaire a généralement un impact bien plus faible. Le niveau de service compte tout autant : le mode Fast d’OpenAI peut atteindre jusqu’à 2,5 fois la vitesse pour les modèles et les charges concernés, mais c’est une option payante qui ne s’applique qu’à certains modèles.
Autrement dit, même si l’abonnement et le côté tiers affichent le même modèle, il suffit que le niveau de raisonnement ou le niveau de service diffère pour que l’écart de vitesse saute aux yeux.
2.2 Impact du service proxy API, des chemins réseau et de WebSocket sur les tâches multi-tours
La chaîne de requêtes d’une API tierce est généralement plus longue : client → passerelle du fournisseur → nœud proxy → éventuelle liaison transfrontalière → service d’inférence final. Chaque saut supplémentaire ajoute un peu de latence fixe et de fluctuation réseau, et ces délais se cumulent tour après tour dans la boucle de l’Agent.
Le protocole de transport est une autre variable. L’API Responses traditionnelle passe le plus souvent par HTTP/SSE : à chaque tour, il faut réétablir la requête et transporter le contexte. Le mode WebSocket maintient une connexion persistante et, grâce à previous_response_id et aux entrées incrémentales, réduit les transferts et traitements redondants. Les données publiées officiellement par OpenAI sont les suivantes :
- Une vague d’optimisations de l’API fin 2025 a amélioré la latence du premier token de près de 45 %.
- Dans un workflow spécifique comportant plus de 20 appels d’outils, le mode WebSocket apporte jusqu’à environ 40 % d’accélération de bout en bout.
- L’intégration Vercel rapporte jusqu’à environ 40 % d’amélioration de la latence, le workflow multi-fichiers de Cline environ 39 % d’accélération, et les modèles OpenAI dans Cursor jusqu’à environ 30 % d’amélioration.
Ces chiffres proviennent de produits et de scénarios de test différents ; ce sont des valeurs plafond dans des workflows particuliers. Certaines passerelles compatibles n’implémentent que HTTP/SSE, ou ne prennent pas entièrement en charge le WebSocket et la gestion d’état incrémentale utilisés par Codex — ces intégrations ne bénéficient donc pas de ces gains.
2.3 Cache de contexte et nombre d’appels d’outils de Codex
Dans les tâches longues, l’historique des messages, les définitions d’outils et les contextes répétés peuvent occuper un grand nombre de tokens d’entrée. En cas de succès du cache d’invites, le temps de traitement de ce préfixe peut être réduit. La documentation OpenAI indique que GPT-5.6 et les séries suivantes prennent en charge de nouvelles fonctions d’écriture, de lecture et de contrôle TTL du cache.
Le problème, c’est que le cache dépend de la stabilité du préfixe de requête. Si la couche proxy réécrit le préfixe de requête, modifie l’ordre de définition des outils ou change les frontières du cache, la réutilisation du cache peut être affectée, ce qui oblige à retraiter de larges portions de contexte à chaque tour. Le nombre d’appels d’outils détermine directement le nombre de tours de requête : plus il y a de tours, plus les coûts de chaque tour sont amplifiés.
2.4 Pourquoi la première réponse de Codex est-elle normale alors que la suite reste lente ?
C’est la forme la plus fréquente de la question posée dans le titre. Le TTFT mesure seulement la rapidité d’arrivée du premier token, alors que la durée totale d’une tâche Codex est la somme de tous les tours. La durée totale peut s’écrire ainsi :
T_total = Σ(temps de traitement de la requête API + temps d’inférence du modèle + temps de transmission réseau + temps d’exécution des outils locaux + temps d’attente et de nouvelle tentative)
Une première réponse normale mais une lenteur globale vient généralement des situations suivantes : une vitesse de sortie continue (TPS) faible, où les réponses longues ralentissent chaque tour ; une nouvelle inférence du modèle après l’exécution des outils, chaque nouvelle inférence devant retraiter le contexte ; une connexion en streaming qui se coupe ou expire en cours de route, le client déclenchant une nouvelle tentative, et l’utilisateur a l’impression que « le modèle s’est arrêté ». Selon un calcul fondé sur le mécanisme, une tâche nécessitant 20 appels séquentiels au modèle, avec 3 secondes d’attente supplémentaires à chaque fois, verrait sa durée totale augmenter d’environ 60 secondes ; ce chiffre sert à illustrer l’effet cumulatif et non un résultat mesuré.
3 Quelles preuves les cas publics apportent-ils au problème de lenteur de Codex ?
Les deux cas ci-dessous proviennent de rapports d’utilisateurs du dépôt openai/codex. Il s’agit de journaux isolés d’un utilisateur unique, destinés à illustrer le mécanisme ; ils ne représentent pas un niveau généralisé du secteur.
3.1 Issue #60831 : une fluctuation d’environ sept fois du temps de réponse dans une même session
Dans l’Issue #60831, soumise en novembre 2026, le rapporteur a observé deux requêtes dans la même session, le même processus client et les mêmes réglages d’inférence : les corps de requête après compression faisaient tous deux environ 13,09 Mo, aucune compression de contexte n’a eu lieu entre les deux, et l’historique des images n’a pas changé non plus. La requête lente a mis 109,317 secondes entre la fin de la compression de la requête et la réception de l’en-tête de réponse HTTP, contre 15,637 secondes pour la rapide, soit un rapport d’environ 6,99.
Attention à la mesure : ces deux chiffres correspondent au temps « jusqu’à la réception de l’en-tête de réponse », donc à la phase de traitement côté service, et non à la durée totale d’achèvement de la tâche ; les deux requêtes empruntent par ailleurs le même chemin, ce qui n’a rien à voir avec une comparaison entre abonnement et tiers. Ce que cela montre, c’est que le temps de traitement côté serveur peut à lui seul varier fortement alors que la taille du contexte reste identique. Le rapport lui-même ne permet pas de déterminer quel maillon du service a créé le goulot d’étranglement.
3.2 Issue #44305 : une boucle d’outils fait exploser la durée d’une tâche en lecture seule
Dans l’Issue #44305, datée de septembre 2026, le rapporteur compare des tâches en lecture seule du même type : un autre agent a terminé en environ 10,6 secondes avec 3 lectures parallèles ; Codex, lui, a tourné 91,5 secondes avant d’expirer, sans fournir de réponse complète. Pendant ce temps, Codex a effectué environ 11 inférences de modèle et 11 appels d’outils, pour un total d’environ 295 042 tokens en entrée, dont environ 260 608 tokens d’entrée mis en cache.
Si l’on calcule à partir de ces chiffres, la part d’entrée en cache atteint environ 88,3 % : le cache fonctionne bien, mais les 11 tours de boucle exécutés en série font quand même exploser la durée par rapport à la solution en lecture parallèle. Les stratégies de travail des deux agents diffèrent en soi, et l’écart de temps ne peut pas être entièrement attribué à Codex ou au modèle ; cela illustre néanmoins clairement l’effet multiplicateur du nombre de tours d’appel et de l’exécution en série sur la durée totale.
Deux autres catégories de problèmes sont par ailleurs directement liées à l’accès via des tiers : l’Issue #33029 rapporte que, lorsque Codex Desktop utilise une interface compatible tierce, le point de terminaison du modèle fonctionne normalement, mais l’application de bureau continue d’appeler certains services auxiliaires de ChatGPT, et ces requêtes qui expirent ralentissent la réactivité de l’application ; les Issues #41340 et #42471 rapportent respectivement l’apparition de « stream disconnected before completion » sur des points de terminaison Responses tiers, et des événements d’appel d’outils reçus mais jamais entrés dans le flux d’exécution. Qu’un simple chat fonctionne, et qu’une boucle d’outils Codex complète fonctionne, ce sont deux niveaux d’exigence de compatibilité bien distincts.
4 Comment identifier où votre Codex est lent ?
4.1 Localiser les goulots d’étranglement de Codex avec quatre indicateurs clés
| Indicateur | Comment l’enregistrer | Problème révélé |
|---|---|---|
| TTFT | Temps d’attente jusqu’à la première sortie valide, à chaque requête | File d’attente, démarrage du modèle, premier paquet réseau |
| Durée de bout en bout | Temps total écoulé entre la soumission et la fin de la tâche | Expérience globale, c’est le critère de jugement final |
| Nombre d’appels au modèle / aux outils | Comptage des tours de raisonnement, du nombre d’appels aux outils et de leur temps d’exécution | Stratégie de l’Agent et amplification en série |
| Succès du cache | Entrée totale, lectures de cache, écritures de cache, tokens de sortie | Coût du retraitement répété du contexte |
En plus de ces quatre indicateurs, il est conseillé d’enregistrer aussi les TPS, les tokens d’entrée et de sortie d’une requête unique, le protocole utilisé (WebSocket ou SSE), ainsi que le nombre de 429, de 5xx, de délais dépassés et de nouvelles tentatives. Ces données auxiliaires vous aident à distinguer une véritable « lenteur » d’une « lenteur provoquée par des nouvelles tentatives après une erreur ».
4.2 Étapes d’exécution des trois tests comparatifs Codex
Le préalable à un test comparatif, c’est de contrôler les variables : garder identiques l’ID du modèle, l’intensité de raisonnement, la version de Codex, les fichiers du projet et la description de la tâche, puis dérouler chaque configuration une fois en session neuve et une fois en session longue, histoire d’identifier l’effet de la longueur du contexte.
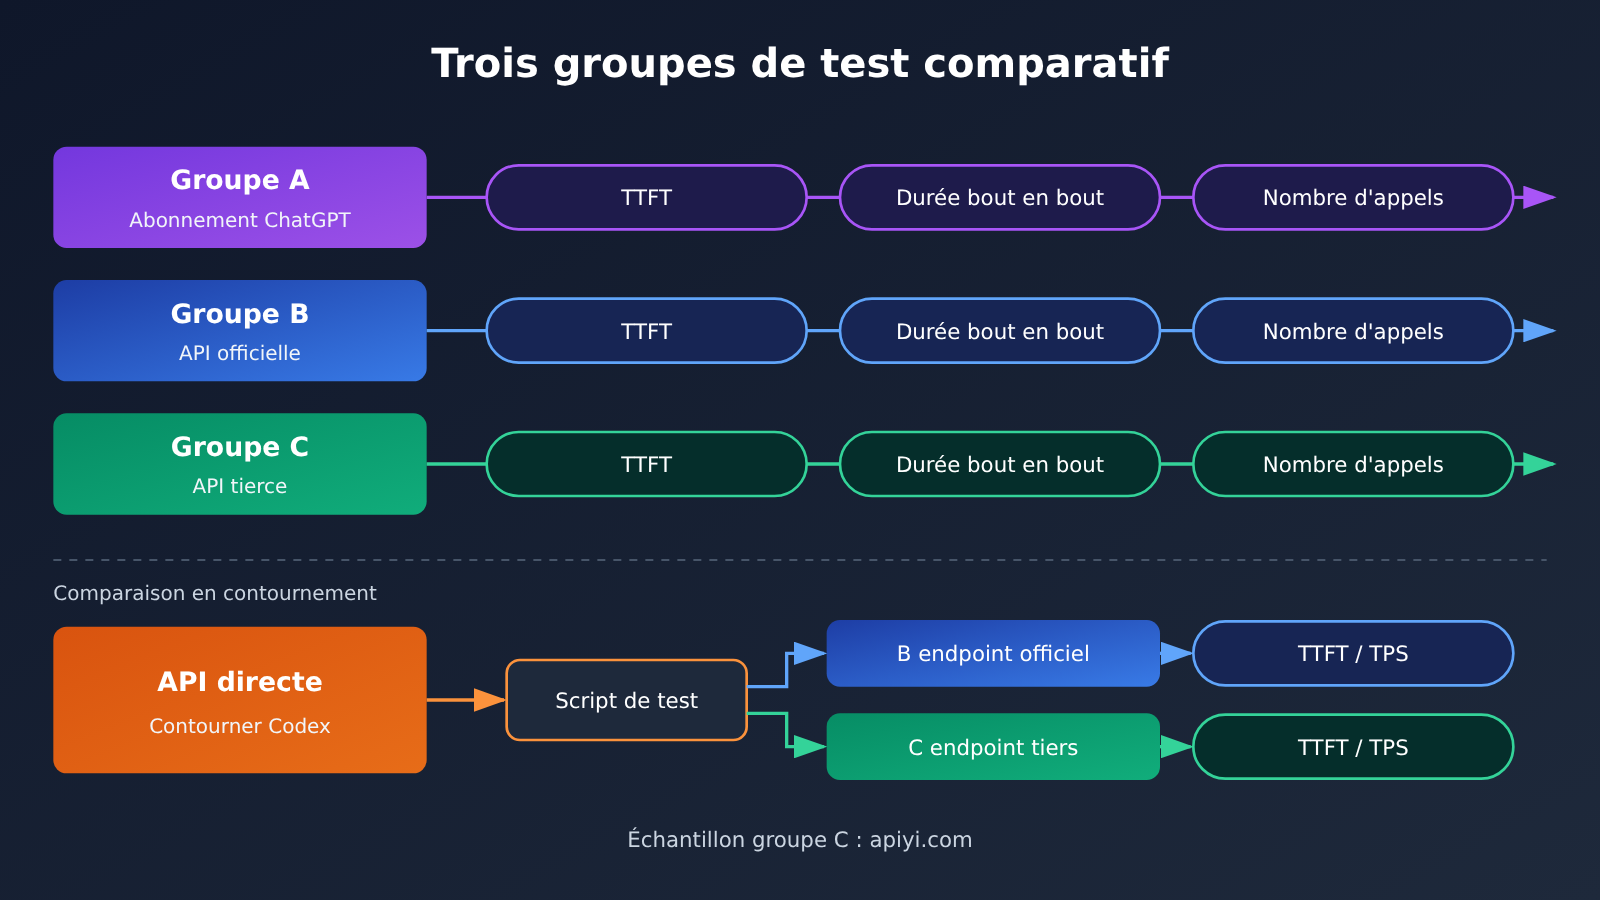
- Groupe A : se connecter à Codex avec un abonnement ChatGPT, exécuter la tâche standard, noter la durée de bout en bout et le nombre de tours d’appel.
- Groupe B : brancher Codex sur la clé API officielle du même modèle, exécuter la même tâche.
- Groupe C : brancher Codex sur une API compatible tierce, exécuter la même tâche.
- Groupe direct : pour les deux chemins B et C, court-circuiter Codex et envoyer la même requête unique via un script, en mesurant le TTFT et le TPS.
L’écart entre A et B traduit surtout la différence de service entre le chemin abonnement et le chemin API ; l’écart entre B et C traduit les différences de passerelle, de routage et de service d’inférence ; l’écart entre les résultats en direct et ceux obtenus dans Codex traduit le surcoût apporté par la boucle de l’agent, la compatibilité du protocole et le client. Pour chaque groupe, mieux vaut répéter plusieurs fois et prendre la médiane, pour ne pas transformer une fluctuation ponctuelle en conclusion.
Le script ci-dessous sert au test du « groupe direct » : il envoie une requête Responses en streaming et mesure le TTFT, la durée totale, les tokens de sortie et le TPS :
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée APIYI ; basculez vers l'adresse officielle pour la comparaison avec le groupe B
)

start = time.perf_counter()
ttft = None
stream = client.responses.create(
    model="YOUR_MODEL_ID",            # Garder le même ID de modèle que celui utilisé dans Codex
    reasoning={"effort": "medium"},   # Garder la même intensité de raisonnement que dans Codex
    input="阅读下面的函数并指出潜在 bug:def add(a, b): return a - b",
    stream=True,
)
usage = None
for event in stream:
    if event.type == "response.output_text.delta" and ttft is None:
        ttft = time.perf_counter() - start
    elif event.type == "response.completed":
        usage = event.response.usage

total = time.perf_counter() - start
out_tokens = usage.output_tokens if usage else 0
print(f"TTFT: {ttft:.2f}s | 总耗时: {total:.2f}s | 输出: {out_tokens} tokens")
if ttft and total > ttft:
    print(f"TPS: {out_tokens / (total - ttft):.1f} tokens/s")
Voir le script complet pour les tests répétés sur plusieurs tours et les statistiques de cache
import time
import statistics
from openai import OpenAI

ENDPOINTS = {
    "official": {"base_url": "https://api.openai.com/v1", "key": "OFFICIAL_KEY"},
    "apiyi": {"base_url": "https://api.apiyi.com/v1", "key": "APIYI_KEY"},  # endpoint APIYI
}
MODEL = "YOUR_MODEL_ID"
EFFORT = "medium"
# On utilise un long préfixe fixe pour simuler l'invite système et les définitions d'outils de Codex,
# histoire de mieux observer les hits de cache
PREFIX = "你是代码审查助手。项目规范如下:\n" + ("- 函数必须有类型注解。\n" * 300)
TASK = "检查这个函数:def add(a, b): return a - b"


def run_once(client):
    start = time.perf_counter()
    ttft, usage = None, None
    stream = client.responses.create(
        model=MODEL,
        reasoning={"effort": EFFORT},
        input=PREFIX + TASK,
        stream=True,
    )
    for event in stream:
        if event.type == "response.output_text.delta" and ttft is None:
            ttft = time.perf_counter() - start
        elif event.type == "response.completed":
            usage = event.response.usage
    total = time.perf_counter() - start
    cached = 0
    if usage and getattr(usage, "input_tokens_details", None):
        cached = usage.input_tokens_details.cached_tokens or 0
    return {
        "ttft": ttft or total,
        "total": total,
        "input": usage.input_tokens if usage else 0,
        "cached": cached,
        "output": usage.output_tokens if usage else 0,
    }


def bench(name, cfg, rounds=5):
    client = OpenAI(api_key=cfg["key"], base_url=cfg["base_url"])
    results, errors = [], 0
    for _ in range(rounds):
        try:
            results.append(run_once(client))
        except Exception as e:
            errors += 1
            print(f"[{name}] 请求失败: {e}")
    if not results:
        return
    med = lambda k: statistics.median(r[k] for r in results)
    hit = sum(r["cached"] for r in results) / max(sum(r["input"] for r in results), 1)
    print(
        f"[{name}] TTFT中位数 {med('ttft'):.2f}s | 总耗时中位数 {med('total'):.2f}s | "
        f"缓存命中率 {hit:.1%} | 失败 {errors}/{rounds}"
    )


for name, cfg in ENDPOINTS.items():
    bench(name, cfg)
Pour les tests du groupe C dans Codex, il faut configurer le point de terminaison tiers comme fournisseur de modèle. Voici la façon courante d’écrire le fichier ~/.codex/config.toml ; pour le nom exact des champs, fiez-vous à la documentation officielle de la version de Codex que vous utilisez :
model = "YOUR_MODEL_ID"
model_provider = "apiyi"
model_reasoning_effort = "medium"

[model_providers.apiyi]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
🚀 Démarrage rapide : pour le comparatif du groupe C, vous pouvez demander sur APIYI apiyi.com un crédit de test gratuit réservé aux nouveaux utilisateurs, puis utiliser la même clé pour basculer entre plusieurs modèles et exécuter le script ci-dessus avec chacun. Vous obtiendrez ainsi rapidement des données TTFT et de durée totale directement comparables.
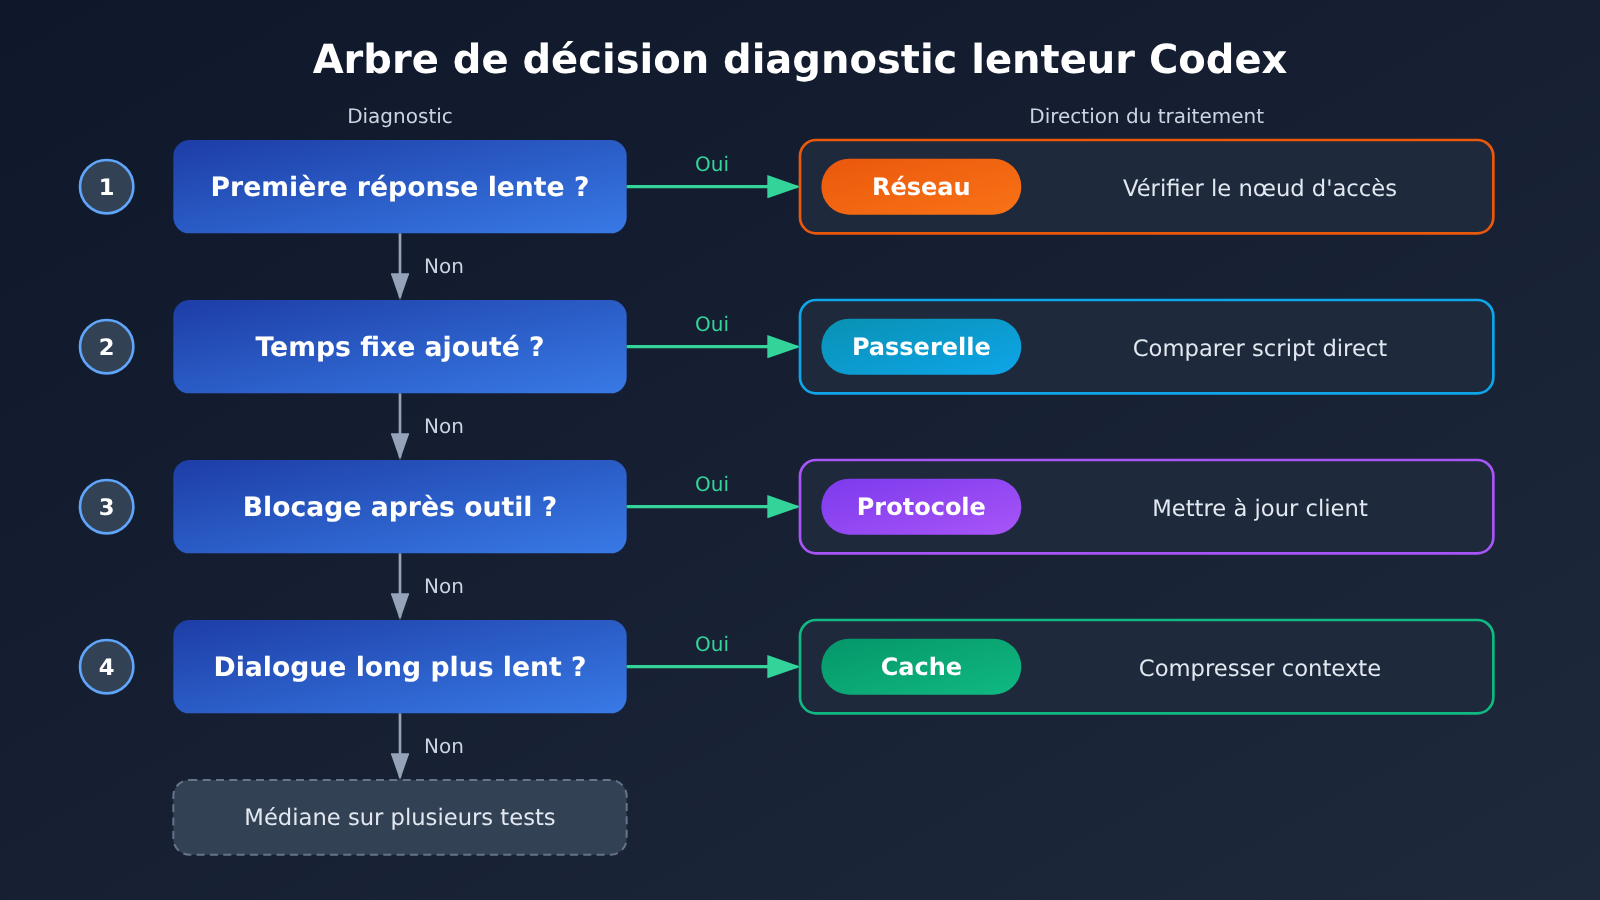
4.3 Plans d’optimisation de Codex selon le symptôme
| Symptôme | À vérifier en priorité | Traitement |
|---|---|---|
| Première réponse lente | File d’attente, démarrage du modèle, premier paquet réseau | Passer à un nœud d’accès plus proche, vérifier le niveau de service souscrit, comparer en évitant les heures de pointe |
| Première réponse rapide, puis ralentissement | TPS, nombre de tours d’outils, cache | Réduire l’intensité de raisonnement, limiter la longueur de sortie, contrôler le taux de réussite du cache |
| Chaque appel ajoute un temps constant | Chaîne du service proxy, requêtes supplémentaires | Comparer les groupes B et C avec un script en connexion directe pour localiser la surcharge de la passerelle |
| Blocage après un appel d’outil | Événements Responses, retour des outils | Vérifier s’il y a une coupure de flux ou une perte d’événements d’outil, mettre à jour la version du client |
| Une longue conversation est nettement plus lente qu’une nouvelle | Tokens d’historique, compression, cache | Ouvrir une nouvelle session au bon moment ou déclencher la compression du contexte, et observer l’évolution des lectures de cache |
| Vitesse en dents de scie | Charge du service, nouvelles tentatives, variations réseau | Compter les 429/5xx et les timeouts, répéter les tests et prendre la médiane |
| Lenteur générale sur desktop alors que l’API est normale | Requêtes des services auxiliaires de ChatGPT | Voir l’Issue #33029, vérifier si les requêtes auxiliaires expirent, et basculer sur le CLI si nécessaire |
L’optimisation au niveau du modèle suit la logique du guide OpenAI sur la latence : produire moins de tokens, réduire le contexte d’entrée, diminuer le nombre d’appels, traiter en parallèle les étapes indépendantes — et tout ce qu’un programme classique sait faire ne devrait pas être confié au modèle. Pour Codex, le levier le plus direct consiste à donner à la description de tâche un périmètre plus explicite, afin que l’Agent effectue moins de tours de lecture exploratoires.
5 Quels indicateurs sont plus importants que le prix unitaire lorsqu’on choisit une API tierce pour Codex ?
5.1 Passer du prix unitaire par token au coût d’achèvement d’une tâche
Dans le contexte de Codex, le vrai coût se mesure à l’échelle d’une tâche terminée. Une API au prix unitaire bas peut au final consommer davantage de tokens et de temps si son cache est peu efficace, si elle impose beaucoup de tours d’appel ou si elle subit fréquemment des coupures avec reprises. Pour l’évaluation, je vous conseille de regarder ensemble les éléments suivants : le taux de réussite des tâches, la durée de bout en bout, le total de tokens consommés par tâche (lectures depuis le cache incluses), ainsi que le surcoût dû aux échecs et aux nouvelles tentatives.
| Critère d’évaluation | Points à surveiller | Méthode de test | Plateformes utilisables |
|---|---|---|---|
| Identité et version du modèle | L’ID et la version du modèle sont-ils explicites, stables et disponibles ? | Vérifier les champs de modèle renvoyés et la documentation | APIYI apiyi.com, API officielle |
| Premier token et vitesse soutenue | Médiane et fluctuation du TTFT et du TPS | Tests répétés via un script en connexion directe | APIYI apiyi.com, API officielle |
| Temps d’achèvement d’un agent multi-tour | Durée totale d’une vraie tâche dans Codex | Test comparatif sur trois groupes | APIYI apiyi.com, API officielle |
| Compatibilité des protocoles | Prise en charge de Responses, WebSocket et des événements d’outils | Exécuter une tâche complète : lire des fichiers + modifier le code + lancer les tests | Selon la documentation du fournisseur |
| Prise en charge du cache | Les tokens lus depuis le cache sont-ils renvoyés correctement ? | Compter les champs de cache dans usage |
Selon la documentation du fournisseur |
| Stabilité et facturation | Taux d’échec, concurrence, transparence de la facturation | Consigner les 429/5xx et le détail de la facturation | Selon la documentation du fournisseur |
5.2 Évaluer une API tierce comme APIYI avec de vraies tâches
APIYI apiyi.com est une plateforme d’agrégation d’API de grands modèles de langage : une seule clé API permet d’appeler les principaux modèles OpenAI, Claude, Gemini, etc. Son interface est compatible avec le protocole OpenAI et la facturation se fait à l’usage. Dans le contexte de Codex, son intérêt tient surtout à la facilité de comparaison : avec la même configuration, on peut changer de modèle et de niveau, puis obtenir des données comparables sur votre propre projet.
Les différents fournisseurs tiers n’ont ni la même chaîne technique, ni le même support des protocoles, ni la même stabilité. L’évaluation doit donc s’appuyer sur des données de test concrètes et sur les conditions de service. Je vous conseille de choisir 2 à 3 tâches représentatives (par exemple une refactorisation multi-fichiers, une correction de bug avec tests), de les exécuter sur chaque mode d’accès en suivant la méthode de la section 4, puis de décider en tenant compte du taux de réussite et du total de tokens.
💡 Conseil pour choisir : commencez par éliminer avec un script en connexion directe les options dont le TTFT ou le TPS s’écarte manifestement, puis faites tourner les candidats restants dans Codex sur des tâches complètes. L’interface unifiée d’APIYI apiyi.com permet de comparer plusieurs modèles sans modifier la structure de votre code.
FAQ — Questions fréquentes
Q1 : D’où vient principalement l’écart de vitesse entre l’abonnement Codex et les API tierces ?
Il vient des différences sur l’ensemble du chemin de service : déploiement réel du modèle, intensité d’inférence, niveau de service, chaîne de passerelle, protocole de transport, taux de réussite du cache et degré de compatibilité avec les événements d’outils. La boucle Agent multi-tours de Codex accumule ces écarts à chaque tour, ce qui fait que l’écart sur la durée totale est souvent bien plus important que celui d’une seule requête.
Q2 : Le TTFT est normal, pourquoi les tâches Codex restent-elles lentes ?
Le TTFT ne mesure que le temps d’attente du premier token. Une tâche Codex comporte plusieurs tours d’inférence et d’appels d’outils ; le débit de sortie continu, la ré-inférence après exécution d’un outil, les échecs de cache et les tentatives de reprise en cours de route allongent la durée totale. Pour juger de l’expérience, il faut regarder la durée de bout en bout et le nombre de tours d’appel.
Q3 : Combien le mode WebSocket peut-il accélérer Codex ?
Les chiffres publiés par OpenAI indiquent que, dans un flux de travail spécifique avec plus de 20 appels d’outils, la vitesse de bout en bout peut augmenter d’environ 40 % au maximum. C’est le plafond d’un scénario particulier ; le gain réel dépend du nombre de tours de la tâche et du fait que le point d’accès prend en charge ou non, de manière complète, WebSocket et la gestion d’état incrémentale.
Q4 : Dans les longues conversations, Codex devient de plus en plus lent. Que faire ?
Commencez par noter, à chaque tour, le nombre total de tokens d’entrée et de tokens lus depuis le cache, pour vérifier que le cache fonctionne normalement. Si l’historique de contexte est trop long, démarrez une nouvelle session ou déclenchez une compression du contexte ; en parallèle, réduisez le périmètre de la tâche et le nombre de tours de lecture exploratoire de fichiers.
Q5 : Comment tester rapidement la performance réelle d’une API tierce dans Codex ?
1. Inscrivez-vous sur APIYI apiyi.com et récupérez une clé API ainsi qu’un quota d’essai gratuit ;
2. Utilisez le script de connexion directe de cet article pour mesurer le TTFT, le TPS et le taux de réussite du cache ;
3. Configurez Codex comme indiqué à la section 4.2, exécutez la même tâche que côté abonnement, puis comparez la durée de bout en bout et le nombre de tours d’appel.
Vous pourrez ainsi distinguer les différences dues au service d’inférence de celles apportées par la boucle Agent.
Q6 : Les données des Issues publiques représentent-elles les performances générales de Codex ?
Pas directement. Les Issues #60831 et #44305 sont toutes deux des journaux d’un seul utilisateur : la première mesure le temps jusqu’aux en-têtes de réponse HTTP, la seconde concerne une tâche en lecture seule qui a expiré. Leur intérêt est de montrer comment les variations côté serveur et une boucle d’outils séquentielle peuvent peser sur la durée ; pour obtenir une conclusion concrète, il faut la vérifier avec vos propres tâches de test.
L’essentiel sur les différences de vitesse de Codex
- Des chemins différents : la connexion par abonnement et la clé API empruntent des chemins de facturation et de service distincts ; un nom de modèle identique ne signifie pas un déploiement identique.
- Un effet d’amplification par la boucle : la boucle d’agent de Codex cumule les petites latences de chaque tour pour aboutir à un écart de durée totale bien visible.
- Des indicateurs par niveaux : le TTFT mesure la première réponse, tandis que la durée de bout en bout et le nombre de tours d’appel reflètent la véritable expérience.
- Le protocole compte : WebSocket apporte jusqu’à environ 40 % de gain de vitesse dans les scénarios d’appels d’outils en plusieurs tours, à condition que l’interface le prenne pleinement en charge.
- Le cache est à vérifier : la couche proxy API peut modifier le préfixe de requête et donc affecter le cache ; il faut comptabiliser les tokens lus depuis le cache.
- Des tests comparatifs : comparer trois groupes — abonnement, API officielle, API tierce — sur la même tâche, en ajoutant un test en connexion directe pour localiser le goulot d’étranglement.
- Choisir selon la tâche : tester en parallèle avec de vraies tâches sur des plateformes comme APIYI apiyi.com, en regardant le coût de réalisation de la tâche plutôt que le prix unitaire.
Conclusion
Qu’un même Codex affiche deux vitesses différentes s’explique par l’effet cumulé du chemin de service et de la boucle d’agent :
- Sur le plan du mécanisme : le modèle, l’intensité de raisonnement, le niveau de service, la passerelle, le protocole, le cache et la boucle d’outils déterminent ensemble la durée totale ; toute différence sur un seul tour se trouve amplifiée par les appels multiples.
- Sur le plan des preuves : les données officielles montrent que l’optimisation du protocole et du niveau de service apporte un gain de vitesse considérable ; les journaux des utilisateurs montrent que les variations côté serveur et les boucles séquentielles allongent nettement les tâches.
- Sur le plan de la méthode : enregistrer quatre indicateurs clés, réaliser trois groupes de comparaison plus un test en connexion directe, puis optimiser point par point selon les symptômes.
Lors du diagnostic, commencez par fixer le modèle et l’intensité de raisonnement, puis laissez parler les données. Si vous devez comparer plusieurs modèles et plusieurs modes d’accès, vous pouvez vous appuyer sur l’interface unifiée d’APIYI pour réduire au minimum le coût des tests.
📚 Références
- Codex as a platform: build on the open agent harness : OpenAI présente le rôle du Codex Agent Harness
- Lien :
developers.openai.com/blog/codex-as-a-platform -
Description : la base officielle pour comprendre le modèle multi-tours de Codex et la boucle d’outils
-
Documentation d’authentification de Codex : deux modes d’accès, connexion ChatGPT et clé API
- Lien :
learn.chatgpt.com/docs/auth?surface=cli -
Description : distinguer les avantages de l’abonnement de la facturation API et des règles de limitation de débit
-
Speeding up agentic workflows with WebSockets in the Responses API : article d’ingénierie OpenAI
- Lien :
openai.com/index/speeding-up-agentic-workflows-with-websockets -
Description : flux de la boucle d’agent et données d’accélération WebSocket
-
Documentation du mode WebSocket : le mode WebSocket de l’API Responses
- Lien :
developers.openai.com/api/docs/guides/websocket-mode -
Description : connexions persistantes, entrées incrémentales et cas d’usage
-
Guide Latency optimization : principes d’optimisation de la latence d’OpenAI
- Lien :
developers.openai.com/api/docs/guides/latency-optimization -
Description : pistes d’optimisation comme les tokens de sortie, le nombre d’appels et la parallélisation
-
Documentation du mode Fast : niveaux de service et périmètre d’accélération
- Lien :
developers.openai.com/api/docs/guides/fast-mode -
Description : variable de niveau de service à contrôler lors de la comparaison des vitesses
-
Documentation du prompt caching : écriture, lecture et TTL du cache
- Lien :
developers.openai.com/api/docs/guides/prompt-caching -
Description : statistiques et optimisation des hits de cache dans les longues conversations
-
Issues openai/codex #60831 / #44305 / #33029 / #41340 / #42471 : problèmes de latence et de compatibilité signalés par les utilisateurs
- Liens :
github.com/openai/codex/issues/60831,github.com/openai/codex/issues/44305,github.com/openai/codex/issues/33029 - Description : journaux de cas isolés concernant les fluctuations côté serveur, l’amplification de la boucle d’outils, les requêtes auxiliaires côté desktop et la compatibilité avec des protocoles tiers
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI apiyi.com pour partager vos expériences d’intégration de Codex et de tests de performance. Vous trouverez davantage de ressources dans le centre de documentation docs.apiyi.com


