
Nota del autor: este artículo desglosa por separado los resultados que OpenAI autoinforma y la puntuación agregada de terceros de GPT-6.2 Sol, y aclara sus avances en tareas cotidianas, sus retrocesos en agentes de programación y en precisión factual, además del precio de lista, las reglas de tarificación y las recomendaciones de selección de modelo.
OpenAI lanzó simultáneamente GPT-6.2 Astra y GPT-6.2 Sol el 17 de noviembre de 2026. De los dos, GPT-6.2 Sol mantiene el precio de lista de API de GPT-6.1 Sol, pero sus resultados en tareas cotidianas suben de forma clara, así que mucha gente lo fijará como modelo predeterminado sin pensarlo dos veces. La nota de lanzamiento oficial, la system card y la página del modelo ya están disponibles en línea, y ese mismo día Artificial Analysis publicó su puntuación agregada de terceros; no se trata de rumores.
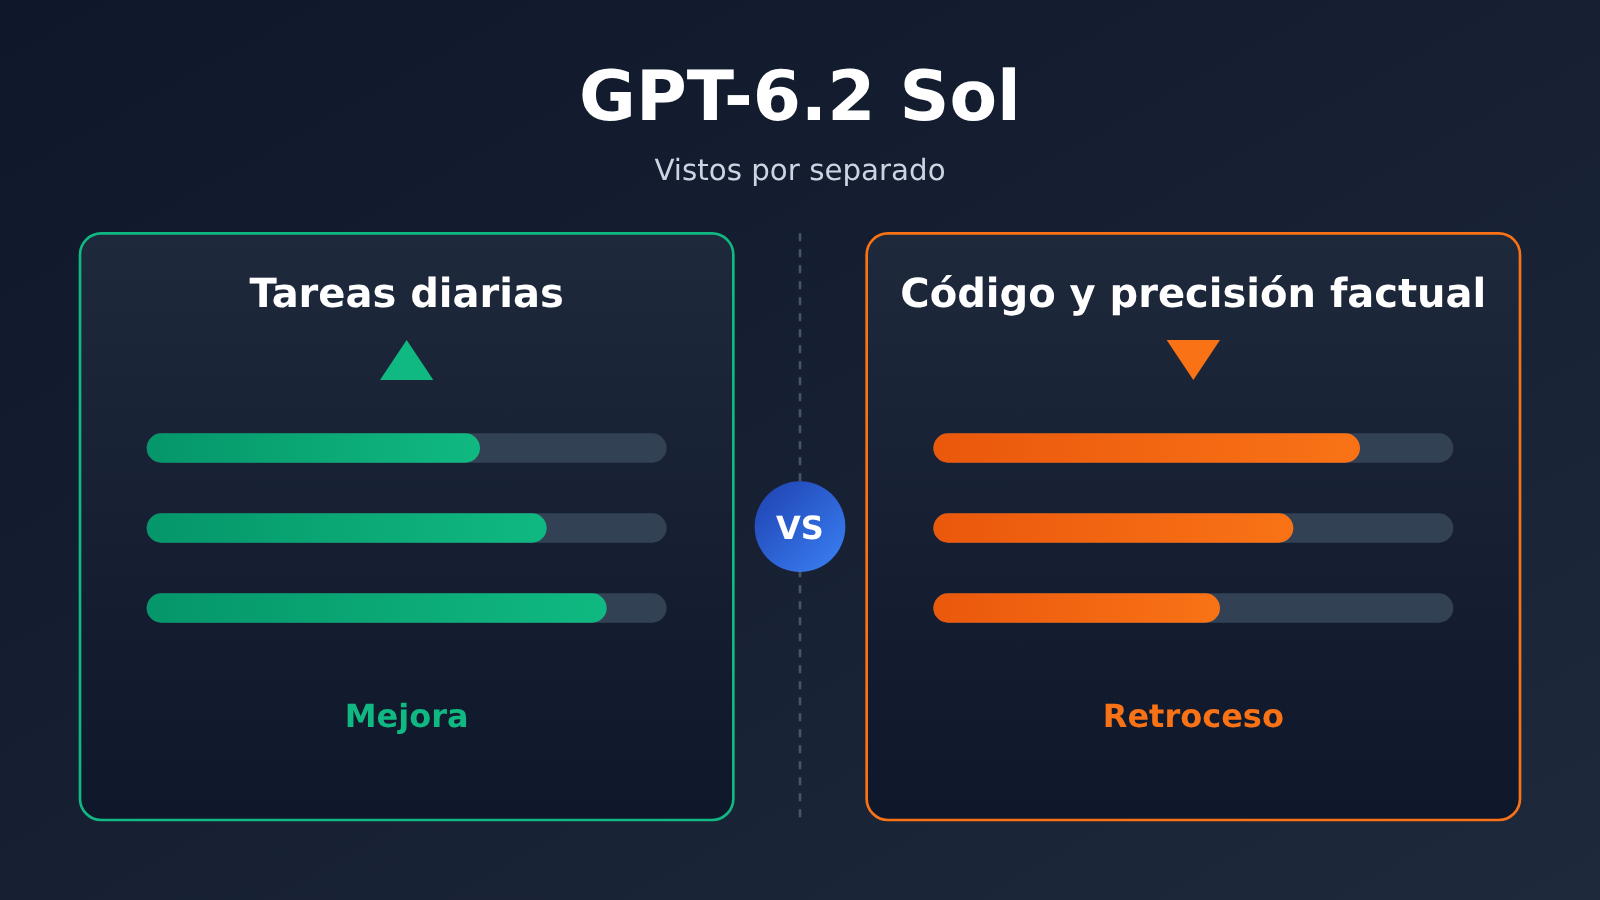
Este artículo no se limita a repetir los benchmarks oficiales. Aquí los números se separan en dos series —lo autoinformado por OpenAI y lo medido por terceros— y cada una habla por sí sola, sin fundirlas en una única conclusión. Las tareas cotidianas y la programación de GPT-6.2 Sol conviene mirarlas por separado: en las primeras hay progreso real; en la segunda, un indicador de terceros queda 3 puntos por debajo de la generación anterior.
Valor clave: al terminar de leer, podrás decidir si GPT-6.2 Sol encaja como modelo predeterminado y sabrás en qué escenarios no basta con fijarse solo en la puntuación agregada.
Puntos clave de GPT-6.2 Sol
Primero, una tabla de lectura rápida; luego desarrollamos cada punto uno por uno. Cada fila indica la fuente de los datos, y los resultados auto-reportados por OpenAI se separan de los de terceros.
| Punto clave | Descripción | Fuente de datos |
|---|---|---|
| Tareas diarias | Puntuación en LifeVal superior a GPT-6 Astra, con un costo de aproximadamente una séptima parte | Autoinforme oficial |
| Fusión de código | En FrontierCode 2.0 difiere de GPT-6.2 Astra por menos de 0.5 puntos, con un costo de aproximadamente una quinta parte; ambos en modo Max | Autoinforme oficial |
| Puntuación general | Intelligence Index v5.0.1: Max 57, Xhigh 56, High 55, Medium 53, Low 41 | Terceros: Artificial Analysis |
| Agente de codificación | Coding Agent Index 3 puntos por debajo de GPT-6.1 Sol, con mayor tendencia a omitir hechos clave | Terceros: Artificial Analysis |
| Tasa de alucinaciones | Tasa de alucinaciones de AA-Omniscience (Max): 55% | Terceros: Artificial Analysis |
| Precio de lista | Igual que GPT-6.1 Sol: $2 de entrada y $10 de salida (por cada millón de tokens) | Oficial de OpenAI |
Detalles clave de GPT-6.2 Sol
Lo más interesante de esta generación de GPT-6.2 Sol es que ofrece «el mismo precio, pero un mejor desempeño en el trabajo diario». Tanto LifeVal como GDPval v2, reportados oficialmente, apuntan en la misma dirección: Sol supera al buque insignia de la generación anterior, GPT-6 Astra, en tareas de oficina cotidianas, y a un costo mucho menor. Para quienes lo usan como modelo predeterminado, esta es la mejora más fácil de percibir.
Pero el otro lado de la moneda también hay que dejarlo claro. El Coding Agent Index de Artificial Analysis (terceros) muestra que GPT-6.2 Sol está 3 puntos por debajo de GPT-6.1 Sol, un rezago que proviene principalmente de una subprueba que evalúa preguntas y respuestas sobre bases de código. Además, la tasa de alucinaciones de AA-Omniscience alcanza el 55%. Así que «que la puntuación general haya subido» no significa que «todo sea más confiable», especialmente en escenarios donde omitir un solo hecho obliga a rehacer el trabajo.
Funciones principales y especificaciones de GPT-6.2 Sol
El ID de modelo de GPT-6.2 Sol es gpt-6.2-sol; acepta texto e imágenes como entrada, pero la salida es únicamente texto: no admite audio ni video. La ventana de contexto es de 1,050,000 tokens, con una entrada máxima de 922,000 y una salida máxima de 128,000; su corte de conocimiento es 2026-06-01, apenas posterior al de Astra (2026-05-18). La API no permite fijar el reasoning effort en none; el nivel más bajo disponible es Low.
La siguiente tabla compara las especificaciones oficiales y los precios de lista de Sol y Astra; los precios corresponden al tramo estándar de contexto corto, por cada 1 millón de tokens. Al verificar la disponibilidad en plataformas, consultamos el listado completo de modelos de APIYI (apiyi.com) (datos del 2026-11-17 15:54, UTC+8) y su endpoint público de precios, y ninguno de los dos modelos 6.2 aparecía todavía.
| Concepto | gpt-6.2-sol | gpt-6.2-astra |
|---|---|---|
| Entrada / lectura de caché / salida | $2 / $0.10 / $10 | $8 / $0.40 / $40 |
| Escritura de caché (30 minutos / 12 horas) | $2.50 / $5 | $10 / $20 |
| Contexto / salida máxima | 1,050,000 / 128,000 | 1,050,000 / 128,000 |
| Corte de conocimiento | 2026-06-01 | 2026-05-18 |
| Cambio de precios | Mantiene los precios de lista de GPT-6.1 Sol | Entrada y salida un 20% más económicas que en GPT-6 Astra; entrada en caché un 60% más económica |
| Plataformas disponibles | API de OpenAI; aún no disponible en APIYI (apiyi.com) | API de OpenAI; aún no disponible en APIYI (apiyi.com) |
Estos son los precios oficiales de OpenAI. En cuanto a gpt-6.2-sol y gpt-6.2-astra en APIYI: aún no están disponibles, pero los incorporaremos lo antes posible; el modelo y los precios definitivos son los que figuren en la lista de modelos de la plataforma.
Reglas de precios de GPT-6.2 Sol
La página del modelo detalla varias reglas de precios comunes a ambos modelos, y aquí es donde surgen las principales diferencias en la factura:
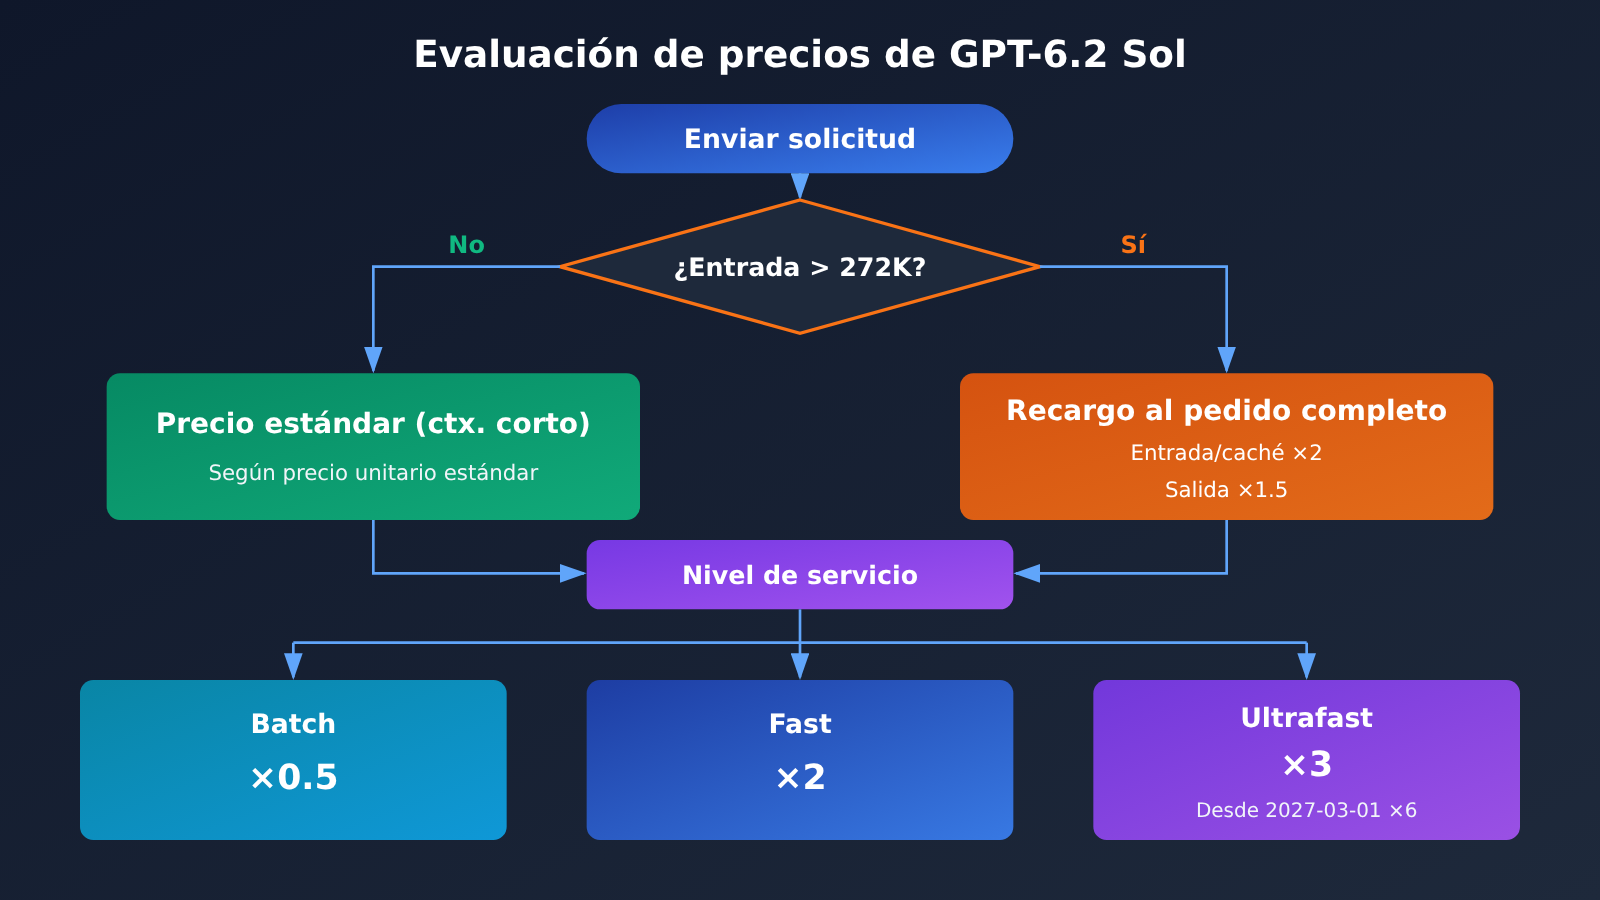
- Recargo por entrada larga aplicado a toda la solicitud: cuando la entrada de una sola solicitud supera los 272K tokens, los precios unitarios de entrada y de caché se duplican, la salida se cobra a 1,5 veces la tarifa de contexto corto, y toda la solicitud se factura con esas tarifas, no solo la parte que excede el límite.
- Batch: el 50% del precio estándar.
- Fast: el doble del precio estándar para la misma longitud de contexto.
- Ultrafast: 3 veces el precio estándar hasta el 2027-02-28 (hora del Pacífico); a partir del 2027-03-01 pasa a ser 6 veces.
En cuanto a los endpoints, se admiten Chat Completions, Responses y Batch, mientras que Realtime, Assistants, fine-tuning, generación de imágenes, video y voz no están disponibles. Es decir, GPT-6.2 Sol es un modelo de conversación y razonamiento con salida puramente textual, y su forma de integración es prácticamente idéntica a la de la generación anterior.
Datos de evaluación de GPT-6.2 Sol: tareas cotidianas
Esta sección se basa únicamente en cifras autoinformadas. El artículo de lanzamiento de OpenAI destaca principalmente dos resultados de Sol en tareas cotidianas; la tabla siguiente los recoge junto con el apartado de programación para facilitar la comparación, pero recuerda que todos fueron medidos y reportados por la propia empresa.
| Evaluación | Categoría | Resultado de GPT-6.2 Sol | Fuente |
|---|---|---|---|
| LifeVal | Tareas cotidianas (creada por la propia empresa) | Superior a GPT-6 Astra, con un costo de aproximadamente una séptima parte | Autoinforme oficial |
| GDPval v2 | Tareas laborales profesionales (interna de la empresa) | 5,3 puntos más que GPT-6.1 Sol | Autoinforme oficial |
| FrontierCode 2.0 | Si los cambios en repositorios de código reales llegan a fusionarse | Diferencia de menos de 0,5 puntos respecto a GPT-6.2 Astra, con un costo de aproximadamente una quinta parte, ambos en Max | Autoinforme oficial |
| AA-3D | Elo de evaluación ciega por humanos | 1259 (Astra 1318, Claude Fable 5.2 1271) | Cifra citada oficialmente |
LifeVal es un conjunto de tareas cotidianas creado por la propia OpenAI; según el artículo de lanzamiento, Sol obtuvo una puntuación más alta que GPT-6 Astra con un costo de aproximadamente una séptima parte del de este último. GDPval v2 es una evaluación interna oficial, y Sol superó a GPT-6.1 Sol por 5,3 puntos. En ninguno de los dos casos se publicaron puntuaciones absolutas, y este artículo no intenta estimarlas.
Estos dos resultados dejan clara una cosa: en labores cotidianas como escribir correos, organizar información, crear tablas o redactar documentos, GPT-6.2 Sol cuesta lo mismo que Sol pero entrega resultados cercanos, o incluso superiores, a los del buque insignia de la generación anterior. Dicho esto, un «conjunto de evaluación creado por la propia empresa» favorece naturalmente a sus propios modelos, así que lo más prudente es tomarlo como una señal de tendencia.
Datos de evaluación de GPT-6.2 Sol: programación
El apartado de programación es el que más conviene analizar por separado, porque la autoevaluación oficial y los datos de terceros apuntan en direcciones distintas. Además, cada uno evalúa tareas diferentes; a continuación los tratamos uno por uno, sin unificarlos en un solo veredicto.
Autoevaluación oficial: FrontierCode 2.0
FrontierCode 2.0 fue construido por Cognition y evalúa si los cambios que el modelo realiza en bases de código reales pueden ser fusionados por los mantenedores. Según los datos oficiales, GPT-6.2 Sol queda a menos de 0.5 puntos de GPT-6.2 Astra, con un costo de aproximadamente un quinto; en la comparación, ambos modelos usaron el nivel de razonamiento Max. Este resultado es una buena noticia para trabajos del tipo «hacer cambios pequeños de código y enviar PR».
Terceros: Coding Agent Index
El Coding Agent Index de Artificial Analysis utiliza el harness de Codex y el nivel de razonamiento Max. El resultado: Astra empató con GPT-6 Astra, mientras que GPT-6.2 Sol quedó 3 puntos por debajo de GPT-6.1 Sol. Según el artículo, la causa principal es la caída de 14 puntos en el subíndice SWE-Atlas-QnA-AA: el modelo tiende más a omitir hechos clave.
Al ver ambos resultados juntos, todo queda claro: FrontierCode 2.0 mide «si los cambios se pueden fusionar», mientras que SWE-Atlas-QnA-AA se inclina por «si las preguntas sobre la base de código se responden por completo». GPT-6.2 Sol está cerca de Astra en lo primero, pero en lo segundo retrocedió incluso respecto a la generación anterior de su propia familia. Si tu agente de programación tiene que responder constantemente preguntas como «¿dónde se llama esta función?» o «¿qué módulos afecta esta configuración?», no puedes fijarte solo en FrontierCode.
Puntuación compuesta de terceros y tasa de alucinación de GPT-6.2 Sol
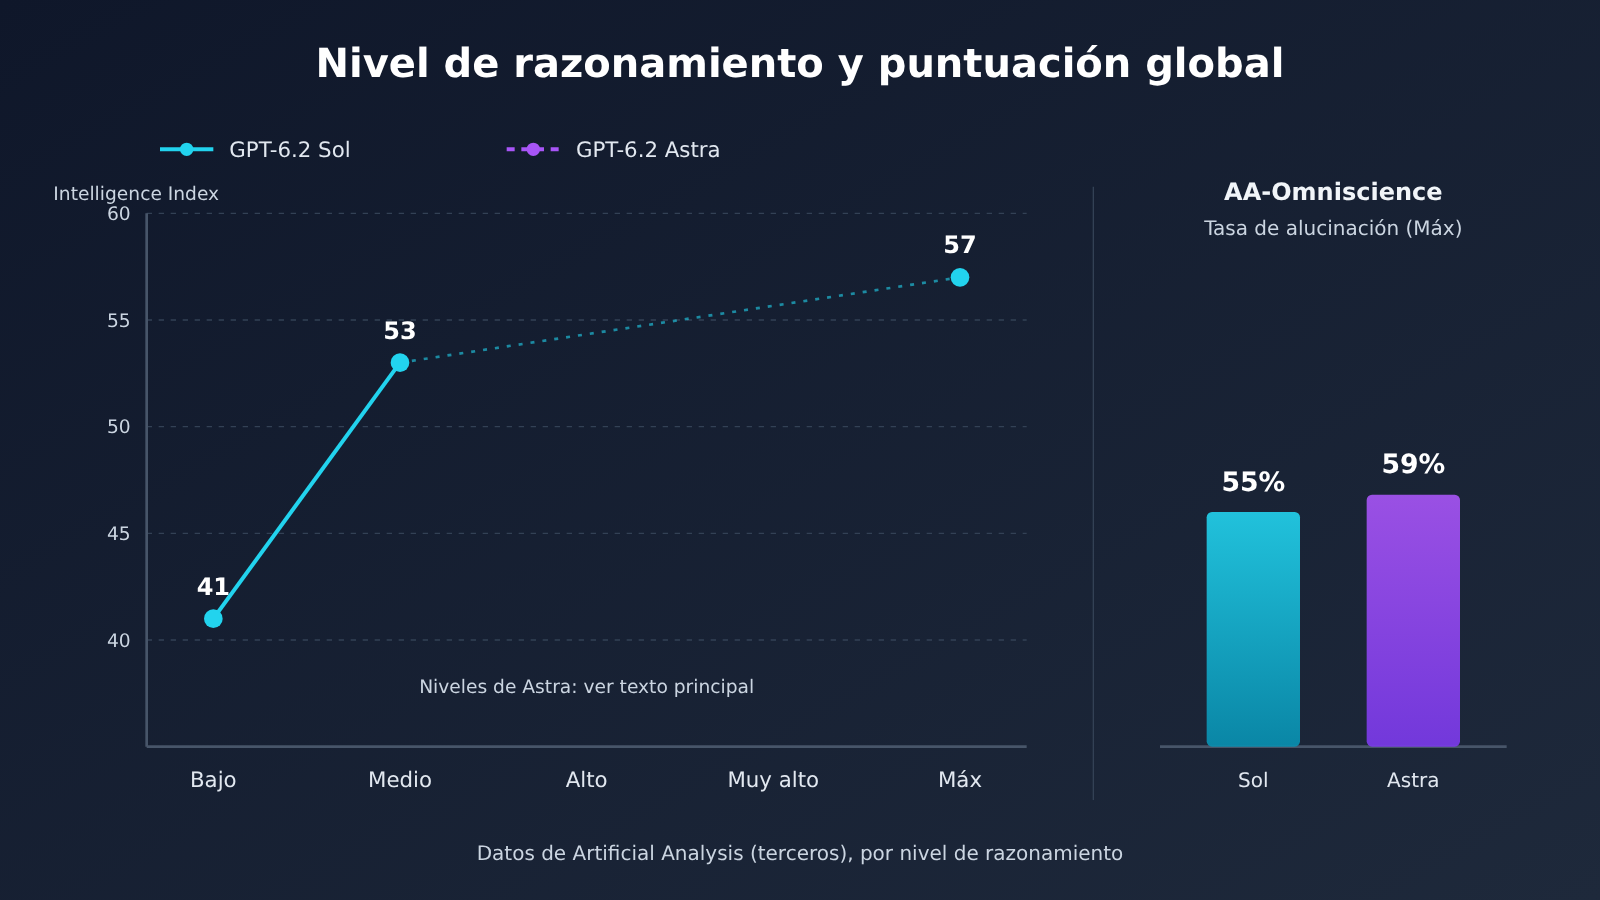
El Intelligence Index v5.0.1 de Artificial Analysis puntúa por separado para cada nivel de razonamiento. Todos los números de la tabla siguiente son de terceros y cada celda corresponde a un nivel de razonamiento: no compares el Max de Sol con el Medium de otro modelo.
| Nivel de razonamiento | GPT-6.2 Sol | GPT-6.2 Astra |
|---|---|---|
| Max | 57 | 62 |
| Xhigh | 56 | 62 |
| High | 55 | 60 |
| Medium | 53 | 57 |
| Low | 41 | 46 |
| Costo por tarea del índice compuesto (Max) | $1.01 | $4.00 |
En el mismo artículo, Claude Fable 5.2 encabeza la lista con 65 en su nivel más alto, Gemini 4 Carbon llega a 60 y Claude Opus 5.5 se queda en 59. El Max de GPT-6.2 Sol, con 57 puntos, supera al GPT-6.1 Sol por 2 puntos y empata con el GPT-6 Astra, pero con un costo por tarea de apenas el 15% del de este último. Es decir, Sol no supera a Astra en todos los frentes; su mérito es haber igualado al buque insignia de la generación anterior con un costo mucho menor.
La caída entre niveles de razonamiento también merece atención. Sol pierde 12 puntos al pasar del 53 en Medium al 41 en Low, y como la API no permite desactivar el razonamiento, Low ya es el nivel más bajo posible. Si en el uso diario lo dejas en Low por defecto para ahorrar, el modelo que obtienes ya no es ese de 57 puntos.
Tasa de alucinación de GPT-6.2 Sol
En la tasa de alucinación AA-Omniscience (Max), GPT-6.2 Sol registra un 55% y Astra un 59%. La cifra de Sol es algo más baja, pero ambas superan el 50%, lo que significa que cuando el modelo no está seguro sigue teniendo una tendencia bastante alta a dar respuestas erróneas con apariencia de certeza. Sumado al resultado mencionado antes, donde SWE-Atlas-QnA-AA queda 14 puntos por debajo, las tareas de preguntas y respuestas sensibles a los hechos requieren pasos adicionales de recuperación o verificación.
Clasificación de seguridad y disponibilidad de GPT-6.2 Sol
Según el marco de preparación de OpenAI, tanto GPT-6.2 Sol como Astra alcanzan el nivel «crítico» en ciberseguridad, mientras que en biología y química se sitúan en el nivel «alto». Oficialmente, solo se menciona que Astra alcanza el umbral alto de «auto-mejora de la IA»; de Sol no se dice nada al respecto. En consecuencia, las protecciones se vuelven más estrictas, y algunas solicitudes legítimas de investigación de vulnerabilidades también serán rechazadas, así que quienes trabajan en seguridad deberían estar preparados para ello.
El proyecto Daybreak, orientado a la defensa, ofrece por ahora la Alpha de GPT-6 Astra, GPT-6 Sol en Daybreak Blue y GPT-6 Cyber en Daybreak Red. OpenAI indica que trabajará para llevar la versión 6.2 a Daybreak, pero de momento todavía no está disponible. En cuanto a la alineación, la mayoría de las evaluaciones se sitúan cerca de las de GPT-6 Astra, con menos acciones inapropiadas en entornos laborales simulados; eso sí, dos pruebas muestran que tiende a pasar por alto problemas que bloquean el avance, como archivos faltantes o herramientas de búsqueda no disponibles. Tras añadir instrucciones en Codex, este tipo de omisiones se reducen de forma notable.
En cuanto a la disponibilidad, los planes Plus, Pro, Enterprise y Edu pueden usarlo desde hoy mismo en ChatGPT Work y Codex. Pro 500 puede activar Ultrafast para ambos modelos, y Pro 200 obtiene Ultrafast por primera vez, empezando por GPT-6.2 Sol; en los casos de Enterprise y Edu que cumplan los requisitos, el administrador del espacio de trabajo debe habilitarlo. Los desarrolladores disponen de la API de OpenAI, y ambos modelos son compatibles con Ultrafast desde su lanzamiento.
Análisis de ventajas y desventajas de GPT-6.2 Sol
Ventajas
- Gran relación calidad-precio en tareas cotidianas: según cifras oficiales, logra un LifeVal superior al de GPT-6 Astra con un costo aproximado de un séptimo, y en GDPval v2 supera a GPT-6.1 Sol en 5.3 puntos.
- Precio sin cambios: la tarifa de lista es idéntica a la de GPT-6.1 Sol, así que la actualización no encarece el precio unitario.
- Capacidad de fusión de código casi al nivel de Astra: los datos oficiales indican que en FrontierCode 2.0 la diferencia con Astra es de menos de 0.5 puntos, con un costo de alrededor de un quinto.
- Puntuación general a la altura del buque insignia anterior: en el Max de terceros alcanza 57, empatando con GPT-6 Astra, con un costo por tarea de cerca del 15% del de este.
Limitaciones
- Retroceso en agentes de codificación: en el Coding Agent Index de terceros queda 3 puntos por debajo de GPT-6.1 Sol, y 14 puntos por debajo en SWE-Atlas-QnA-AA. La solución pasa por añadir recuperación de información y verificación cruzada a las consultas sobre bases de código.
- Tasa de alucinaciones elevada: en AA-Omniscience la tasa de alucinaciones es del 55%; en tareas sensibles a los hechos conviene exigir citas o revisión manual.
- Caída notable en el nivel de razonamiento bajo: el nivel Low apenas llega a 41 y además no se puede desactivar el razonamiento, así que hay que sopesar bien al intentar reducir costos.
- Protecciones de seguridad más estrictas: algunas investigaciones legítimas de vulnerabilidades serán rechazadas, y Daybreak aún no está disponible para la versión 6.2.
Primeros pasos con GPT-6.2 Sol
La integración de GPT-6.2 Sol funciona igual que la de la generación anterior: puedes ir tanto por Chat Completions como por Responses, en el nombre del modelo pones gpt-6.2-sol, y para el nivel de razonamiento eliges uno entre Low y Max, sin pasar none. Si ya trabajas con una interfaz compatible con OpenAI, cambiar de modelo suele ser solo cuestión de ajustar un parámetro.
Cuando esté disponible en APIYI, basta con configurar el base_url del SDK de OpenAI como https://api.apiyi.com/v1, introducir tu clave API de APIYI y cambiar el model a gpt-6.2-sol; ten en cuenta que el nombre oficial es el que aparezca en la lista de modelos de la plataforma. Mientras tanto, el gpt-6.1-sol ya disponible en la plataforma está listado a $2 por entrada, $10 por salida y $0.1 por lectura de caché, con la entrada a $4 cuando supera los 272,000. Puedes usarlo para montar tu flujo de trabajo, pero no es el 6.2, y su precio tampoco debe tomarse como el del 6.2.
La elección del modelo se puede desglosar por tipo de tarea. La siguiente tabla resume las recomendaciones, y sus fundamentos provienen todos de los datos públicos comentados antes:
| Escenario de tarea | Recomendación | Fundamento |
|---|---|---|
| Tareas diarias de redacción, organización y trabajo de oficina | Puedes considerar GPT-6.2 Sol como opción predeterminada | Autoevaluación oficial en LifeVal y GDPval v2 |
| Cambios de código pequeños y envío de PR | GPT-6.2 Sol sirve; priorízalo si el costo pesa | Autoevaluación oficial en FrontierCode 2.0 |
| Preguntas sobre el repositorio y agentes de codificación de cadena larga | No te guíes solo por la puntuación global; compara primero en tu propio repositorio | El Coding Agent Index de terceros queda 3 puntos por debajo |
| Preguntas y respuestas donde omitir un hecho sale muy caro | Añade recuperación de información y verificación; si hace falta, cruza varios modelos | Tasa de alucinación según terceros del 55% |
| Entradas muy largas (más de 272K) | Estima primero el costo total tras aplicar el recargo | Reglas de precios de la página oficial del modelo |
🚀 Consejo para empezar: como predeterminado para el día a día puedes plantearte primero GPT-6.2 Sol, pero en preguntas y respuestas donde omitir un hecho es costoso no te fijes solo en la puntuación global. En APIYI (apiyi.com) puedes usar la misma clave API para comparar modelos disponibles como
gpt-6.1-sol,claude-opus-5-5ogemini-4-carbon; corre antes una ronda con tus propias tareas y, cuando el 6.2 esté disponible, intégralo para contrastar resultados.
Preguntas frecuentes (FAQ)
Q1: ¿Qué tipo de modelo es GPT-6.2 Sol?
GPT-6.2 Sol es la opción más económica de la serie 6.2 que OpenAI lanzó el 17 de noviembre de 2026, con el identificador de modelo `gpt-6.2-sol`. Acepta texto e imágenes como entrada y genera texto como salida, con una ventana de contexto de 1,050,000 tokens y una fecha de corte de conocimiento del 1 de junio de 2026. Su posicionamiento es el de un modelo de uso general con excelente relación calidad-precio, presentado al mismo tiempo que el más costoso GPT-6.2 Astra.
Q2: GPT-6.2 Sol frente a GPT-6.1 Sol: ¿en qué gana y en qué pierde?
El precio de lista es el mismo. Según los datos autoreportados por OpenAI, obtiene 5.3 puntos más en GDPval v2; el Intelligence Index de terceros le da 2 puntos más en el nivel Max, llegando a 57. Sin embargo, en el Coding Agent Index de terceros cae 3 puntos, sobre todo porque SWE-Atlas-QnA-AA baja 14 puntos, lo que lo hace más propenso a pasar por alto hechos clave. Las tareas cotidianas mejoran, pero las preguntas y respuestas sobre bases de código dentro de los agentes de codificación van hacia atrás.
Q3: ¿Es GPT-6.2 Sol mejor que GPT-6.2 Astra?
No se puede afirmar eso. En las puntuaciones globales de terceros, Astra supera a Sol en todos los niveles de razonamiento; en el nivel Max es 62 frente a 57. La ventaja de Sol está en el costo: según los datos autoreportados, en FrontierCode 2.0 la diferencia con Astra es de menos de 0.5 puntos, con un costo aproximado de una quinta parte, y el costo por tarea según terceros es de $1.01 frente a $4.00.
Q4: ¿Cuál es el precio oficial de GPT-6.2 Sol?
El precio oficial estándar de OpenAI para contextos cortos es de $2 por entrada, $0.10 por lectura de caché, $2.50 por escritura de caché de 30 minutos y $10 por salida (por cada millón de tokens); cuando la entrada supera los 272K, se aplica un recargo a toda la solicitud. APIYI: todavía no está disponible en la plataforma; lo publicaremos lo antes posible. El modelo y el precio definitivos se rigen por la lista de modelos de la plataforma.
Q5: Antes de que llegue la 6.2, ¿cómo hacer pruebas comparativas a través de la API?
Puedes montar el flujo con los modelos que ya están disponibles:
1. Regístrate en APIYI (apiyi.com) y obtén tu clave API y tu crédito de prueba gratuito
2. Usa la interfaz compatible con OpenAI para invocar modelos en catálogo como `gpt-6.1-sol` y `gpt-6-astra`
3. Cuando la 6.2 esté disponible, solo tendrás que cambiar el parámetro model para hacer la comparación A/B
Ten en cuenta que ni `gpt-6-sol` ni `gpt-6.1-sol` son la 6.2, y sus precios tampoco son intercambiables entre sí.
Q6: Gemini 4 Carbon cuesta lo mismo que Sol, ¿cuál conviene elegir?
El precio oficial estándar de Gemini 4 Carbon es de $2 por entrada y $10 por salida hasta el 30 de noviembre de 2026; a partir del 1 de diciembre de 2026 pasa a $4 / $20, con una puntuación global de terceros de 60 en su nivel más alto. El `gemini-4-carbon` en APIYI (apiyi.com) tiene ahora mismo un precio introductorio; después del 1 de diciembre, guíate por la lista de la plataforma. Soporta entrada de video y audio, pero no cuenta con el endpoint de Responses, así que al elegir, decide según el tipo de entrada y la interfaz que necesites.
Q7: ¿Se puede usar GPT-6.2 Sol para investigación de vulnerabilidades?
Alcanza el nivel «crítico» en ciberseguridad, con protecciones más estrictas; algunas solicitudes legítimas de investigación de vulnerabilidades pueden ser rechazadas. Daybreak, orientado a la defensa, todavía no tiene versión 6.2; OpenAI solo ha indicado que trabajará para incorporarlo.
Puntos clave de GPT-6.2 Sol
- Progreso notable en tareas cotidianas: el LifeVal autoinformado oficialmente supera al de GPT-6 Astra, con un costo de aproximadamente una séptima parte.
- El precio no cambia: el precio de lista es el mismo que el de GPT-6.1 Sol, $2 de entrada y $10 de salida.
- En código casi alcanza a Astra: la brecha en el FrontierCode 2.0 autoinformado oficialmente es de menos de 0,5 puntos.
- Puntuación global de terceros: Max 57, Xhigh 56, High 55, Medium 53, Low 41.
- Retroceso en agentes de codificación: el Coding Agent Index de terceros queda 3 puntos por debajo del de 6.1 Sol, con tendencia a omitir hechos.
- Tasa de alucinaciones del 55%: en preguntas y respuestas sensibles a los hechos es imprescindible añadir recuperación de información y verificación.
- Cómo empezar: antes de que 6.2 esté disponible, en APIYI (apiyi.com) puedes montar tu flujo de comparación con los modelos que ya están en el catálogo.
Resumen
Los puntos clave de GPT-6.2 Sol:
- Tareas cotidianas: tanto el LifeVal como el GDPval v2 autoinformados oficialmente muestran progreso; pagando el precio de Sol obtienes un rendimiento cotidiano cercano al del buque insignia de la generación anterior.
- El código hay que evaluarlo por separado: el FrontierCode 2.0 autoinformado se acerca a Astra, pero el Coding Agent Index de terceros queda 3 puntos por debajo del de GPT-6.1 Sol, y en preguntas sobre bases de código es más fácil que se escape algún hecho.
- La puntuación global no lo es todo: el Max de terceros de 57 iguala a GPT-6 Astra, pero la tasa de alucinaciones del 55% y los 41 puntos en el nivel Low te recuerdan que no conviene fijarse en un solo número.
Si tu trabajo diario gira en torno a la redacción, la organización y las tareas de oficina, GPT-6.2 Sol merece ser tu primera opción como modelo predeterminado; si dependes de un agente de codificación para responder preguntas sobre tu base de código, o si omitir un solo hecho te obliga a rehacer el trabajo, lo mejor es hacer primero una comparación con tus propias tareas. Te recomendamos comparar los modelos disponibles a través de APIYI (apiyi.com) usando la misma clave API, y cambiar y verificar cuando 6.2 se incorpore al catálogo.
📚 Referencias
-
Publicación de lanzamiento de OpenAI: presentación oficial y evaluaciones autoinformadas de GPT-6.2 Astra y Sol
- Enlace:
openai.com/index/introducing-gpt-6-2-astra-sol - Descripción: fuente de los resultados oficiales autoinformados en LifeVal, FrontierCode 2.0, GDPval v2 y otros benchmarks
- Enlace:
-
Página de modelos de OpenAI: especificaciones y precio de lista de gpt-6.2-sol
- Enlace:
platform.openai.com/docs/models/gpt-6.2-sol - Descripción: ventana de contexto, fecha de corte del conocimiento, recargo de 272K sobre el pedido completo y reglas de Batch, Fast y Ultrafast
- Enlace:
-
Tarjeta del sistema de OpenAI: clasificación de seguridad y evaluaciones de alineación
- Enlace:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Descripción: nivel «crítico» en ciberseguridad, nivel «alto» en biología y química, y descripción de las salvaguardas
- Enlace:
-
Artículo de evaluación de Artificial Analysis: puntuación agregada de terceros e índice de agente de codificación
- Enlace:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Descripción: Intelligence Index por nivel de razonamiento, Coding Agent Index y tasa de alucinaciones
- Enlace:
-
Página de modelos de Artificial Analysis: costo por tarea de GPT-6.2 Sol
- Enlace:
artificialanalysis.ai/models/gpt-6-2-sol - Descripción: datos de terceros como el costo por tarea del índice agregado
- Enlace:
-
Tabla maestra de modelos de APIYI: modelos disponibles en la plataforma y sus precios
- Enlace:
docs.apiyi.com/models.md - Descripción: verificar si el 6.2 ya está disponible y consultar los precios de los modelos publicados
- Enlace:
Autor: Equipo técnico de APIYI
Intercambio técnico: puedes contactarnos desde la página de inicio de APIYI; para más recursos, visita el centro de documentación en docs.apiyi.com


