
ملاحظة المؤلف: نفكك هنا النتائج الرسمية التي أعلنها GPT-6.2 Sol عن نفسه والدرجة المجمعة الواردة من طرف ثالث، ونوضح تقدمه في المهام اليومية، وتراجعه في وكلاء البرمجة ودقة الوقائع، إضافة إلى السعر المعلن وقواعد احتساب التكلفة وتوصيات اختيار النموذج.
أصدرت OpenAI في 17 نوفمبر 2026 كلاً من GPT-6.2 Astra وGPT-6.2 Sol في آنٍ واحد. ومن الجدير بالذكر أن GPT-6.2 Sol احتفظ بالسعر المعلن نفسه لواجهة API الذي كان ساريًا على GPT-6.1 Sol، لكن نتائجه في المهام اليومية ارتفعت بشكل ملحوظ، وسيميل كثير من المستخدمين إلى جعله نموذجهم الافتراضي دون تفكير. منشور الإصدار الرسمي وبطاقة النظام (System Card) وصفحة النموذج أصبحت جميعها متاحة الآن، كما نشرت Artificial Analysis درجتها المجمعة من طرف ثالث في اليوم نفسه؛ فالأمر ليس مجرد شائعة متداولة.
هذه ليست مقالة تكتفي بإعادة سرد نتائج الاختبارات الرسمية كما هي. في هذا المقال نقسّم الأرقام إلى مجموعتين منفصلتين: أرقام يصرّح بها المطور رسميًا وأرقام تقيسها أطراف خارجية، ونعرض كلًّا منهما على حدة دون دمجهما في استنتاج واحد. أداء GPT-6.2 Sol في المهام اليومية وأداؤه في البرمجة يجب فصلهما عن بعضهما: الأول يشهد تقدمًا حقيقيًا فعلًا، أما الثاني فقد تراجع فيه أحد مؤشرات الطرف الثالث بمقدار 3 نقاط مقارنة بالجيل السابق.
القيمة الأساسية: بعد قراءة هذه المقالة، ستتمكن من الحكم على مدى ملاءمة GPT-6.2 Sol ليكون نموذجك الافتراضي، وستعرف أيضًا السيناريوهات التي لا يصح فيها الاعتماد على الدرجة المجمعة وحدها.
النقاط الأساسية في GPT-6.2 Sol
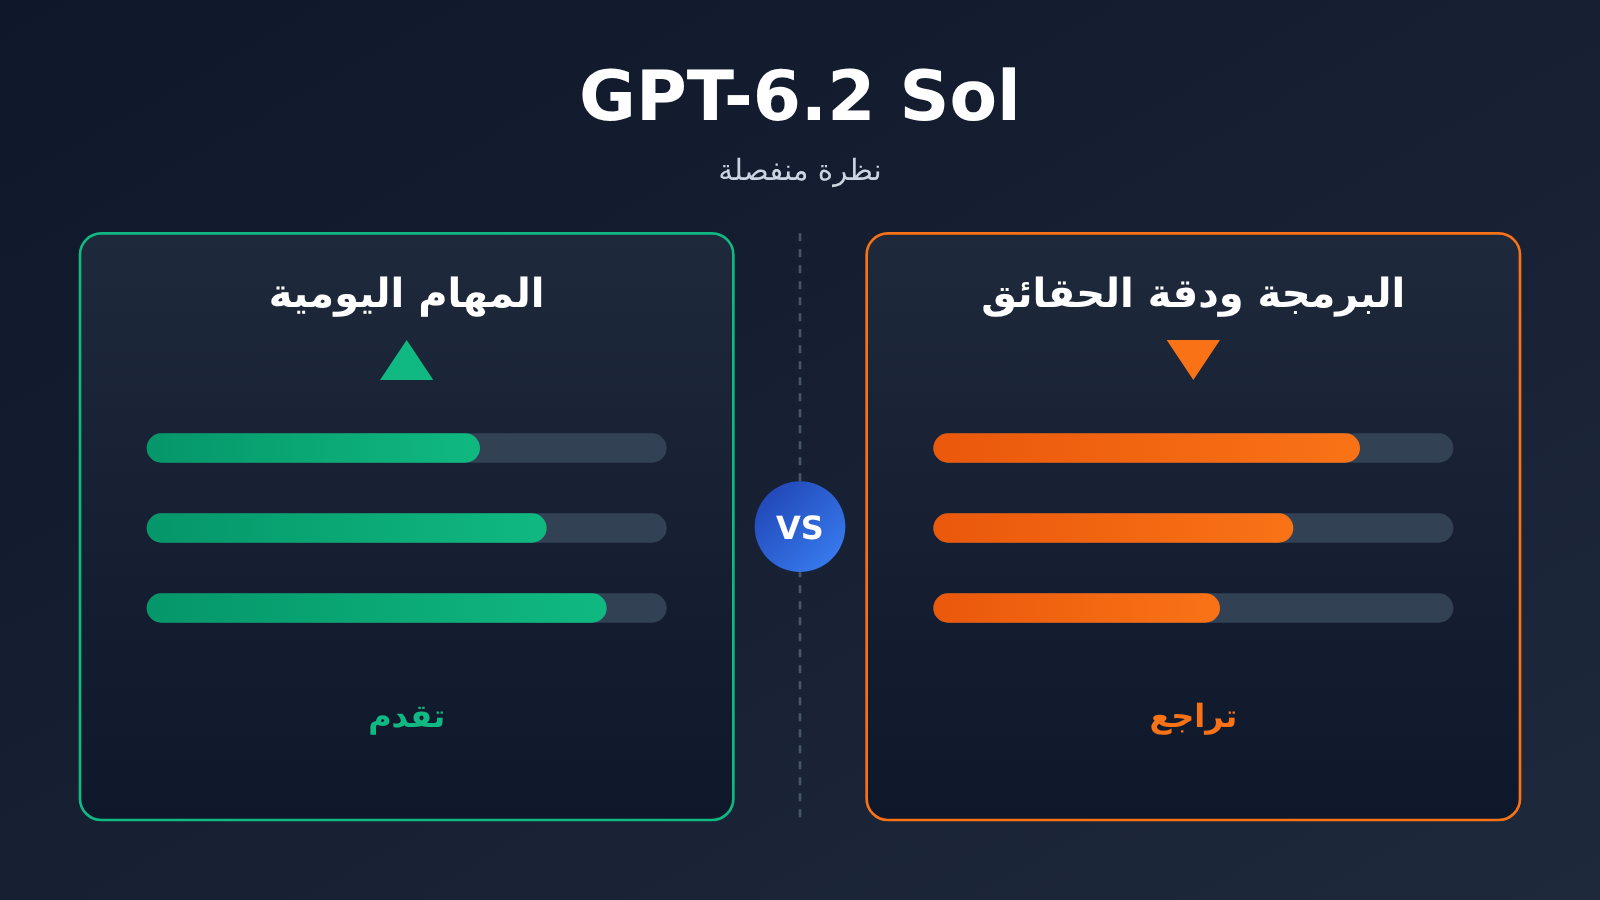
نبدأ بجدول مخصص للقراءة السريعة، ثم نفصّل كل بند فيما يلي. كل صف من الجدول يشير إلى مصدر الأرقام، مع الفصل بين ما أعلنته الشركة رسميًا ونتائج الأطراف الثالثة.
| النقطة | التوضيح | مصدر البيانات |
|---|---|---|
| المهام اليومية | درجة LifeVal أعلى من GPT-6 Astra، والتكلفة نحو السُّبع فقط | إعلان رسمي من الشركة |
| دمج الشيفرة البرمجية | على FrontierCode 2.0 الفارق عن GPT-6.2 Astra أقل من 0.5 نقطة، والتكلفة نحو الخُمس، وكلاهما بإعداد Max | إعلان رسمي من الشركة |
| الدرجة الإجمالية | مؤشر Intelligence Index v5.0.1: Max 57، Xhigh 56، High 55، Medium 53، Low 41 | طرف ثالث: Artificial Analysis |
| وكيل البرمجة | مؤشر Coding Agent Index أقل بثلاث نقاط من GPT-6.1 Sol، مع ميل أكبر لتفويت الحقائق الأساسية | طرف ثالث: Artificial Analysis |
| معدل الهلوسة | معدل الهلوسة وفق AA-Omniscience (بإعداد Max) يبلغ 55% | طرف ثالث: Artificial Analysis |
| السعر المعلن | مطابق لسعر GPT-6.1 Sol: $2 للإدخال و$10 للإخراج (لكل مليون token) | رسميًا من OpenAI |
تفصيل أهم النقاط في GPT-6.2 Sol
أبرز ما يميز جيل GPT-6.2 Sol هو فكرة «الأداء الأفضل في المهام اليومية بالسعر نفسه». تقييمات LifeVal وGDPval v2 المعلنة رسميًا من الشركة تشير جميعها إلى الاتجاه ذاته: Sol تفوّقت على الطراز الرائد للجيل السابق GPT-6 Astra في مهام العمل المكتبي اليومية، وبتكلفة أقل بكثير. هذا الجانب من التقدم هو الأسهل إدراكًا لمن يعتمده نموذجًا افتراضيًا في عمله اليومي.
لكن الوجه الآخر يستحق التوضيح كذلك. يُظهر مؤشر Coding Agent Index الصادر عن جهة Artificial Analysis (طرف ثالث) أن GPT-6.2 Sol أقل بثلاث نقاط من GPT-6.1 Sol، والسبب الرئيسي هو بند فرعي يختبر الإجابة عن أسئلة قواعد الشيفرة البرمجية. أما معدل الهلوسة وفق AA-Omniscience فيبلغ 55% أيضًا. لذلك فإن ارتفاع الدرجة الإجمالية لا يعني أن كل شيء أصبح أكثر ثباتًا، خصوصًا في السيناريوهات التي يعني فيها تفويت حقيقة واحدة إعادة العمل من جديد.
الميزات والمواصفات الأساسية لـ GPT-6.2 Sol
معرّف الطراز لـ GPT-6.2 Sol هو gpt-6.2-sol، ويدعم الإدخال النصوص والصور، بينما يقتصر الإخراج على النصوص فقط، دون دعم للصوت أو الفيديو. تبلغ نافذة السياق 1,050,000 توكن، بحد أقصى للإدخال 922,000 وبحد أقصى للإخراج 128,000، وتمتد معرفة النموذج حتى 2026-06-01، أي أحدث بقليل من Astra الذي يبلغ حد معرفته 2026-05-18. ولا تسمح واجهة API بضبط reasoning effort على none، إذ إن أدنى مستوى متاح هو Low.
يقارن الجدول التالي بين المواصفات الرسمية والأسعار المعلنة لكل من Sol وAstra، والأسعار وفق الشريط القياسي للسياق القصير، لكل مليون توكن. وعند التحقق من توفر النموذجين على المنصات، راجعنا القائمة الشاملة للطرازات على APIYI apiyi.com (اعتبارًا من 2026-11-17 الساعة 15:54 بتوقيت UTC+8) وواجهة التسعير العامة، ولم يظهر أيٌّ من طرازي 6.2 فيهما بعد.
| البند | gpt-6.2-sol | gpt-6.2-astra |
|---|---|---|
| الإدخال / قراءة الكاش / الإخراج | $2 / $0.10 / $10 | $8 / $0.40 / $40 |
| كتابة الكاش (30 دقيقة / 12 ساعة) | $2.50 / $5 | $10 / $20 |
| السياق / الحد الأقصى للإخراج | 1,050,000 / 128,000 | 1,050,000 / 128,000 |
| حد المعرفة | 2026-06-01 | 2026-05-18 |
| تغيّر الأسعار | نفس الأسعار المعلنة لـ GPT-6.1 Sol | الإدخال والإخراج أقل بنسبة 20% من GPT-6 Astra، والإدخال عبر الكاش أقل بنسبة 60% |
| المنصات المتاحة | واجهة OpenAI API؛ غير متوفر بعد على APIYI apiyi.com | واجهة OpenAI API؛ غير متوفر بعد على APIYI apiyi.com |
هذه هي الأسعار الرسمية المعلنة من OpenAI. أما وضع gpt-6.2-sol و gpt-6.2-astra على APIYI: غير متوفرين بعد، وسنعمل على إتاحة النموذجين في أقرب وقت ممكن؛ ويُرجى اعتماد قائمة الطرازات على المنصة مرجعًا نهائيًا للطرازات والأسعار.
قواعد التسعير الخاصة بـ GPT-6.2 Sol
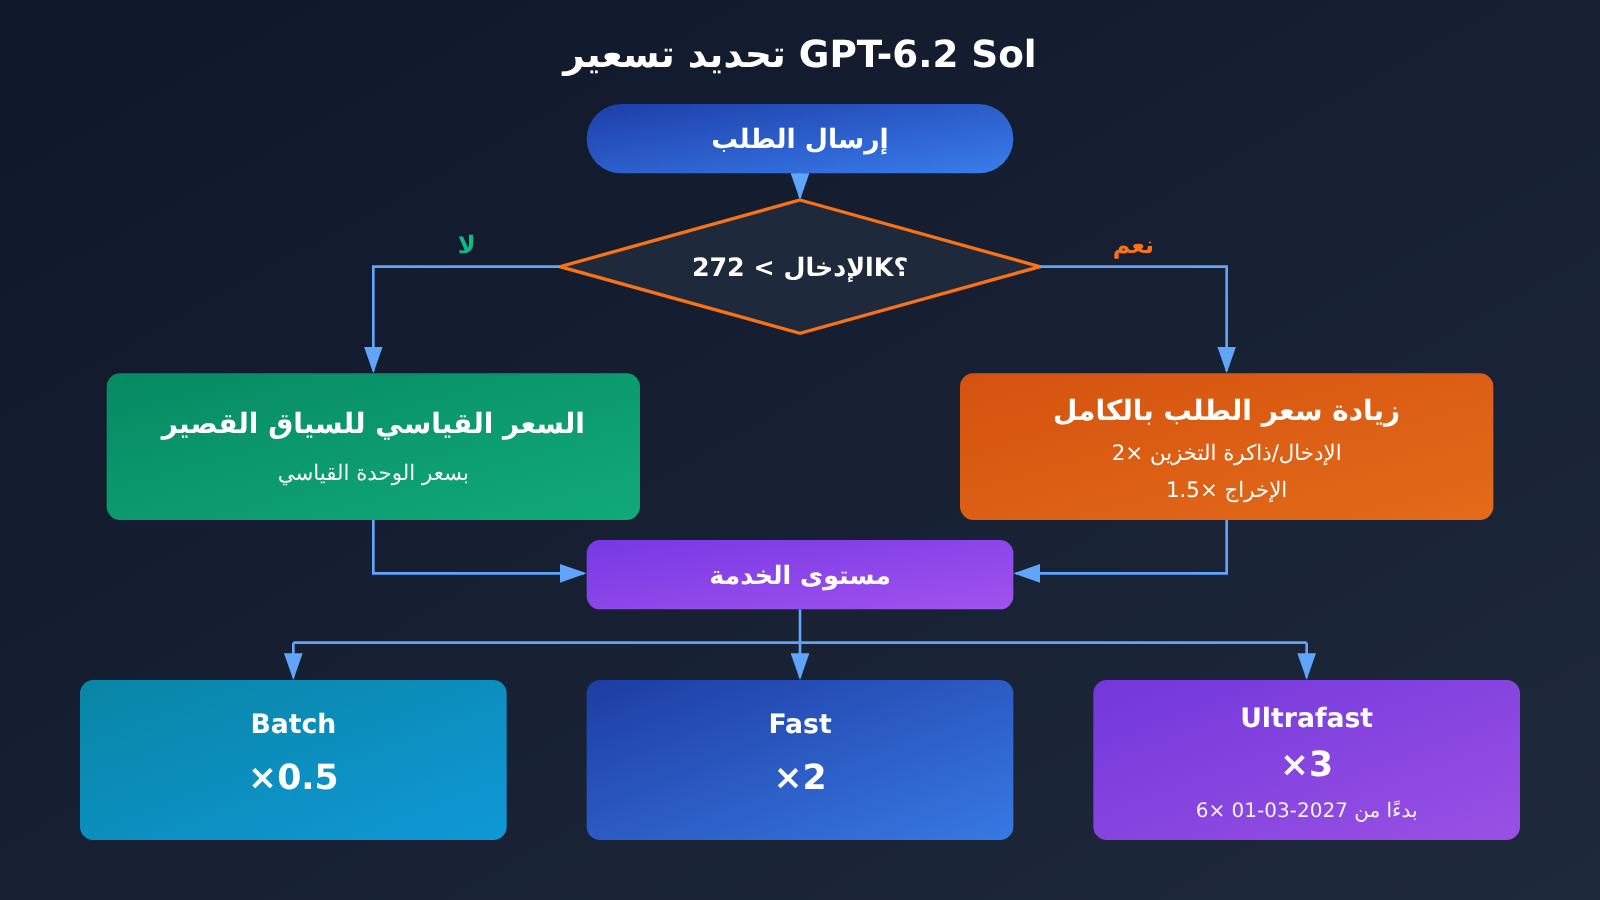
تذكر صفحة النموذج عدة قواعد تسعير تنطبق على الطرازين معًا، ومنها تنبع معظم فروقات الفاتورة:
- زيادة سعر الطلب الكامل عند الإدخال الطويل: إذا تجاوز إدخال الطلب الواحد 272K توكن، يتضاعف سعر الوحدة للإدخال وللكاش، ويصبح سعر الإخراج 1.5 ضعف سعر السياق القصير، ويُحتسب الطلب بأكمله بهذه الأسعار، وليس الجزء المتجاوز فقط.
- Batch: بنسبة 50% من السعر القياسي.
- Fast: ضعفا السعر القياسي لنفس طول السياق.
- Ultrafast: ثلاثة أضعاف السعر القياسي حتى 2027-02-28 (بتوقيت المحيط الهادئ)، ثم يرتفع إلى ستة أضعاف اعتبارًا من 2027-03-01.
أما نقاط النهاية، فيدعم النموذج Chat Completions وResponses وBatch، في حين لا يدعم Realtime ولا Assistants ولا الضبط الدقيق ولا توليد الصور ولا الفيديو ولا الصوت. بعبارة أخرى، GPT-6.2 Sol نموذج محادثة واستدلال بمخرجات نصية بحتة، وطريقة الربط به مماثلة إلى حد كبير لجيله السابق.
بيانات تقييم GPT-6.2 Sol: المهام اليومية
يقتصر هذا القسم على الأرقام التي أعلنتها الشركة عن نفسها. تذكر مقالة الإصدار من OpenAI نتيجتين رئيسيتين لـ Sol في المهام اليومية، وقد أدرجناها في الجدول التالي مع بنود البرمجة ليسهل المقارنة، لكن تذكّر أن جميعها اختبارات أجرتها الشركة وأعلنتها بنفسها.
| التقييم | الفئة | نتيجة GPT-6.2 Sol | المصدر |
|---|---|---|---|
| LifeVal | المهام اليومية (من إنشاء الشركة نفسها) | أعلى من GPT-6 Astra، بتكلفة تعادل تقريبًا السُبع | إعلان رسمي ذاتي |
| GDPval v2 | مهام العمل المهنية (داخلية رسمية) | أعلى من GPT-6.1 Sol بـ 5.3 نقطة | إعلان رسمي ذاتي |
| FrontierCode 2.0 | إمكانية دمج التغييرات في مستودعات الشيفرة الحقيقية | فرق أقل من 0.5 نقطة عن GPT-6.2 Astra، بتكلفة تقارب الخُمس، وبالوضع Max للطرفين | إعلان رسمي ذاتي |
| AA-3D | تقييم Elo أعمى بشري | 1259 (Astra: 1318، Claude Fable 5.2: 1271) | نقله المصدر الرسمي |
LifeVal هي مجموعة مهام يومية أنشأتها OpenAI بنفسها، ويذكر بيان الإصدار أن Sol حصل على درجات أعلى من GPT-6 Astra، بينما لا تتجاوز تكلفته نحو سُبع تكلفته. أما GDPval v2 فهو تقييم داخلي رسمي حقق فيه Sol درجات تتفوق على GPT-6.1 Sol بمقدار 5.3 نقطة. ولم تُعلن الدرجة المطلقة لأيٍّ من التقييمين، ولن تحاول هذه المقالة استنتاجها.
توضح هاتان النتيجتان أمرًا واحدًا: في المهام اليومية مثل كتابة رسائل البريد الإلكتروني وتنظيم المواد وإعداد الجداول وصياغة المستندات، يقدم GPT-6.2 Sol نتائج تقارب نتائج الجيل السابق الرائد بل وتتجاوزها أحيانًا، وكل ذلك بسعر Sol. لكن مجموعات التقييم التي تبنيها الشركة بنفسها تميل بطبيعتها إلى تفضيل نماذجها، لذا من الأأمن أن يتعامل القارئ معها بوصفها إشارة اتجاهية فقط.
بيانات تقييم GPT-6.2 Sol: البرمجة
في مجال البرمجة، تحتاج النتائج أكثر من أي مجال آخر إلى دراسة منفصلة، لأن ما أعلنته الشركة رسميًا عن نفسها وما تقدمه جهات التقييم المستقلة يشيران إلى اتجاهين مختلفين. كما أن المهام التي اختبرها كلٌّ منهما تختلف أيضًا؛ لذا سنتناول كلًّا منهما على حدة بدلًا من دمجهما في حكم واحد.
التقييم الرسمي الذاتي: FrontierCode 2.0
FrontierCode 2.0 طورته شركة Cognition، ويقيس ما إذا كانت التعديلات التي يجريها النموذج على مستودعات شيفرة برمجية حقيقية يمكن للمشرفين قبولها ودمجها. ووفقًا للتقييم الرسمي، يبلغ الفرق بين GPT-6.2 Sol وGPT-6.2 Astra أقل من 0.5 نقطة، مقابل تكلفة لا تتجاوز نحو الخُمس فقط، وقد استُخدم في المقارنة مستوى الاستدلال Max لدى الطرفين. تمثل هذه النتيجة خبرًا سارًّا لأعمال من نوع «إجراء تعديلات صغيرة على الشيفرة وتقديم طلبات الدمج (PR)».
التقييم المستقل: Coding Agent Index
يستخدم مؤشر Coding Agent Index الصادر عن Artificial Analysis بيئة Codex harness ومستوى الاستدلال Max. وجاءت النتيجة تعادلًا بين Astra وGPT-6 Astra، في حين سجّل GPT-6.2 Sol انخفاضًا بمقدار 3 نقاط عن GPT-6.1 Sol. ويذكر المقال أن السبب الرئيسي هو تراجع البند الفرعي SWE-Atlas-QnA-AA بـ 14 نقطة، إذ يُغفل النموذج الحقائق الأساسية بسهولة أكبر.
عند وضع الاثنين جنبًا إلى جنب تتضح الصورة: يقيس FrontierCode 2.0 ما إذا كان بالإمكان دمج التعديلات، بينما يميل SWE-Atlas-QnA-AA إلى قياس قدرة النموذج على الإجابة الشاملة عن الأسئلة المتعلقة بمستودع الشيفرة. يقترب GPT-6.2 Sol من Astra في الأول، لكنه في الثاني تراجع خطوة مقارنة بالجيل السابق من نماذج الشركة نفسها. فإذا كان وكيل البرمجة لديك يتولى الإجابة بكثافة عن أسئلة من نوع «أين تُستدعى هذه الدالة؟» أو «ما الوحدات التي يؤثر عليها هذا الإعداد؟»، فلا يصح أن تكتفي بالاطلاع على نتائج FrontierCode وحدها.
الدرجة الإجمالية ومعدل الهلوسة لـ GPT-6.2 Sol وفقًا لبيانات طرف ثالث
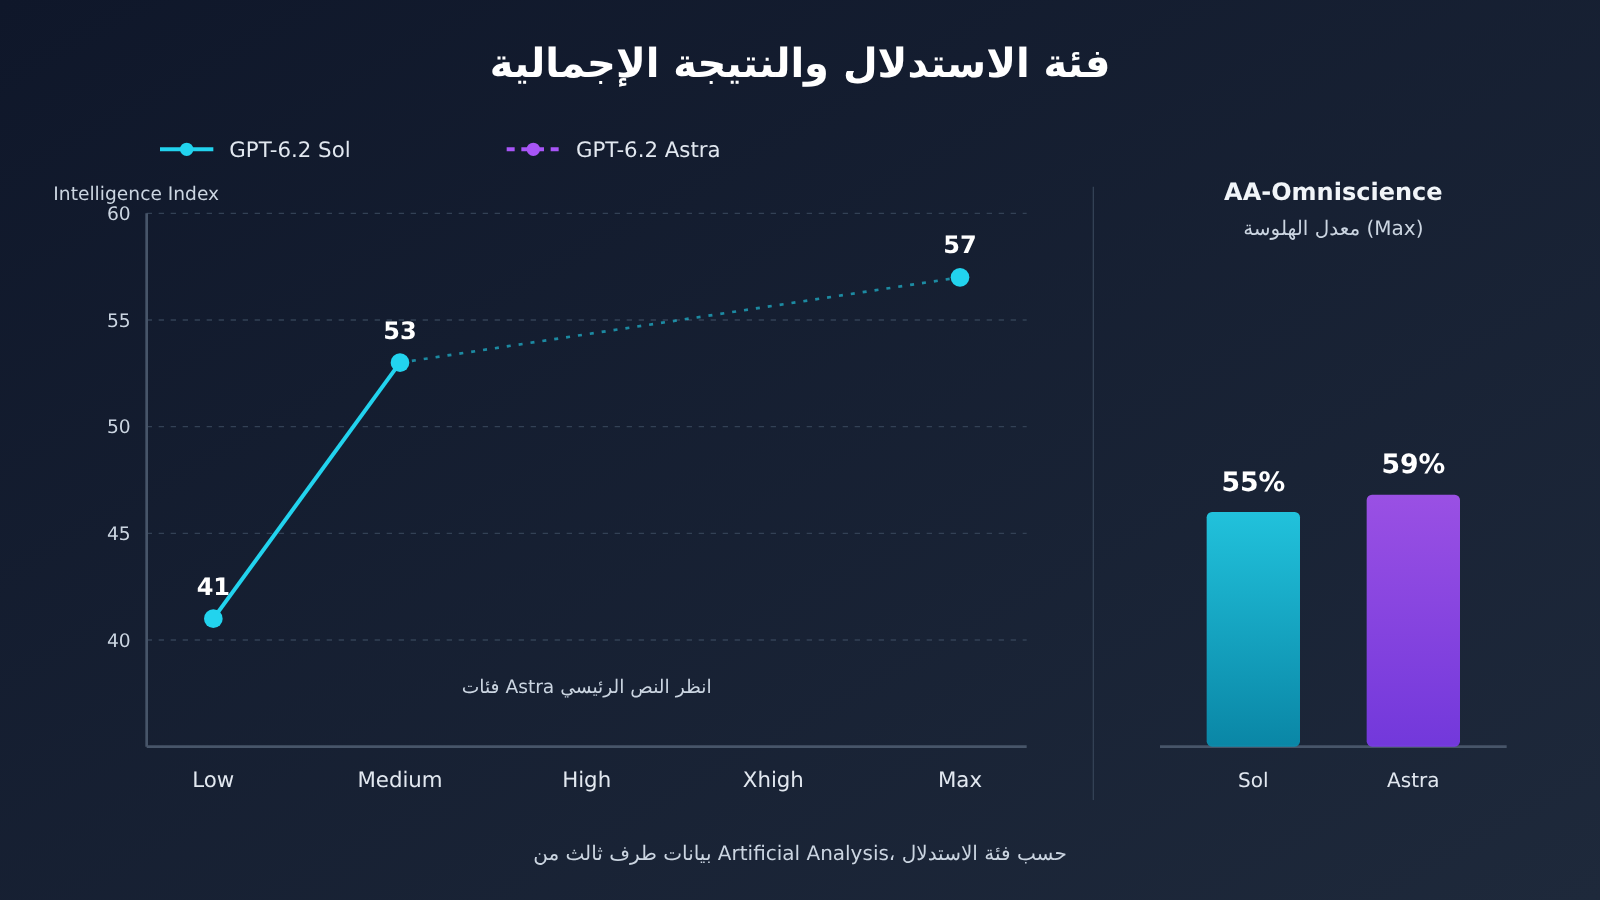
يمنح مؤشر Intelligence Index v5.0.1 من Artificial Analysis درجات منفصلة لكل مستوى استدلال. جميع الأرقام في الجدول أدناه من طرف ثالث، وكل خانة تقابل مستوى استدلال بعينه، فاحرص على ألا تقارن مستوى Max في Sol مع مستوى Medium في نموذج آخر.
| مستوى الاستدلال | GPT-6.2 Sol | GPT-6.2 Astra |
|---|---|---|
| Max | 57 | 62 |
| Xhigh | 56 | 62 |
| High | 55 | 60 |
| Medium | 53 | 57 |
| Low | 41 | 46 |
| تكلفة المهمة الواحدة وفق المؤشر الإجمالي (Max) | $1.01 | $4.00 |
في المقال نفسه، يتصدر Claude Fable 5.2 القائمة بدرجة 65 في أعلى مستوى، ويأتي Gemini 4 Carbon بدرجة 60، ثم Claude Opus 5.5 بدرجة 59. أما Max في GPT-6.2 Sol فقد بلغ 57، أعلى بدرجتين من GPT-6.1 Sol، ومعادلًا لـ GPT-6 Astra، لكن بتكلفة مهمة واحدة تبلغ نحو 15% فقط من تكلفة الأخير. إذاً Sol ليس أقوى من Astra في كل الجوانب، لكن نقطة قوته أنه «حقق مستوى الجيل السابق الرائد بتكلفة أقل».
يستحق الفارق بين مستويات الاستدلال الانتباه أيضًا. فـ Sol يتراجع من 53 عند Medium إلى 41 عند Low، أي بفقدان 12 درجة، في وقت لا يسمح فيه الـ API بإيقاف الاستدلال كليًا، وLow هي بالفعل أدنى مستوى متاح. فإن خفضت الإعداد الافتراضي اليومي إلى Low طلبًا للتوفير، فلن يكون النموذج الذي بين يديك هو ذاك الذي جمع 57 درجة.
معدل الهلوسة في GPT-6.2 Sol
على مؤشر AA-Omniscience لمعدل الهلوسة (عند Max)، تسجل GPT-6.2 Sol نسبة 55% مقابل 59% لـ Astra. رقم Sol أقل قليلًا، لكن كليهما يتجاوز نصف الحالات، وهذا يعني أنه حين لا يكون النموذج متأكدًا، يبقى ميله مرتفعًا نوعًا ما إلى تقديم إجابة خاطئة تبدو واثقة. وبالجمع مع نتيجة SWE-Atlas-QnA-AA الأدنى بـ 14 درجة المذكورة أعلاه، فإن الأسئلة الحساسة للحقائق تحتاج إلى خطوات إضافية من البحث أو التحقق.
التصنيف الأمني لـ GPT-6.2 Sol ونطاق توفره
وفقًا لإطار الاستعداد (Preparedness Framework) من OpenAI، وصل كل من GPT-6.2 Sol وAstra إلى مستوى “الحرج” في الأمن السيبراني، ومستوى “المرتفع” في مجالي الأحياء والكيمياء. وتشير الجهات الرسمية إلى أن Astra وحده بلغ العتبة العالية لـ”التحسين الذاتي للذكاء الاصطناعي”، دون أي إشارة إلى Sol في هذا الصدد. وعلى نحو مقابل، أصبحت الضمانات أكثر صرامة، وسيتم رفض بعض طلبات بحث الثغرات المشروعة أيضًا، لذا ينبغي للقراء العاملين في مجال الأمن أن يكونوا مستعدين لذلك.
أما مشروع Daybreak الموجَّه لجهات الدفاع، فيوفر حاليًا نسخة Alpha من GPT-6 Astra، وGPT-6 Sol على Daybreak Blue، وGPT-6 Cyber على Daybreak Red. وتؤكد OpenAI أنها ستعمل جاهدة لإدخال الإصدار 6.2 إلى Daybreak، لكن ذلك لم يتحقق بعد. وفيما يخص المواءمة، فإن معظم التقييمات تقترب من نتائج GPT-6 Astra، مع ارتكاب أفعال غير لائقة أقل في بيئات العمل المحاكاة؛ غير أن اختبارين أظهرا أنه أكثر ميلاً إلى تفويت الإبلاغ عن المشكلات التي تعيق سير العمل، مثل الملفات المفقودة أو تعذر استخدام أداة البحث، وقد انخفضت هذه الحالات بشكل ملحوظ بعد إضافة تعليمات لهذا الغرض في Codex.
أما عن نطاق التوفر، فيمكن لمشتركي Plus وPro وEnterprise وEdu استخدام النموذجين اعتبارًا من اليوم في ChatGPT Work وCodex. ويمكن لمشتركي Pro 500 تفعيل Ultrafast للنموذجين، فيما يحصل مشتركو Pro 200 على هذه الميزة لأول مرة، بدءًا من GPT-6.2 Sol؛ أما Enterprise وEdu المؤهلون فيحتاجون إلى أن يفعّلها مسؤول مساحة العمل. ويتوجه المطورون إلى OpenAI API، حيث يدعم كلا النموذجين Ultrafast منذ لحظة الإطلاق.
تحليل مزايا وعيوب GPT-6.2 Sol
المزايا
- فعالية عالية من حيث التكلفة في المهام اليومية: بحسب الأرقام الرسمية، تتفوق LifeVal على GPT-6 Astra بتكلفة تعادل السُّبْع تقريبًا، كما سجلت GDPval v2 نتيجة أعلى بـ 5.3 نقطة من GPT-6.1 Sol.
- السعر دون تغيير: السعر المعلن ذاته لـ GPT-6.1 Sol، والترقية لا تضيف شيئًا إلى تكلفة الوحدة.
- قدرات دمج الشيفرة تقترب من Astra: بحسب الأرقام الرسمية، لا يتجاوز الفارق في FrontierCode 2.0 عن Astra نصف نقطة، بينما تكلفته نحو الخُمُس فقط.
- اللحاق بالنتيجة الإجمالية للإصدار الرائد السابق: بحسب جهات خارجية، سجل 57 نقطة في اختبار Max، مساوياً بذلك GPT-6 Astra، بينما تكلفة المهمة الواحدة تعادل نحو 15% فقط من تكلفتها.
القيود
- تراجع أداء الوكيل البرمجي: بحسب قياسات جهات خارجية، سجل Coding Agent Index نتيجة أقل بـ 3 نقاط من GPT-6.1 Sol، فيما تراجع SWE-Atlas-QnA-AA بمقدار 14 نقطة. الحل المقترح هو إضافة آليات البحث والتدقيق المتقاطع عند الإجابة عن أسئلة قاعدة الشيفرة.
- معدل هلوسة مرتفع: يبلغ معدل الهلوسة في AA-Omniscience نسبة 55%، لذا تحتاج المهام الحساسة للحقائق إلى استشهادات أو مراجعة بشرية.
- تراجع ملحوظ في شريحة الاستدلال المنخفض: تحقق شريحة Low نتيجة 41 فقط، وفي المقابل لا يمكن إيقاف تشغيل الاستدلال، لذا عليك الموازنة بين الخيارات عند السعي لضغط التكلفة.
- القيود الأمنية أكثر صرامة: قد تُرفض بعض أبحاث الثغرات المشروعة، كما أن Daybreak غير متوفر بعد للإصدار 6.2.
بداية سريعة مع GPT-6.2 Sol
طريقة الربط مع GPT-6.2 Sol هي نفسها المعتمدة في الجيل السابق؛ يمكنك اعتماد Chat Completions أو Responses على حد سواء، مع تعبئة اسم الطراز gpt-6.2-sol، واختيار مستوى الاستدلال ضمن النطاق من Low إلى Max، وتجنب تمرير القيمة none. وإذا كنت تستخدم أصلًا واجهة متوافقة مع OpenAI، فغالبًا ما يقتصر تبديل الطراز على تعديل معامل واحد فقط.
بعد توفره على منصة APIYI، اضبط base_url في OpenAI SDK على القيمة https://api.apiyi.com/v1، وأدخل مفتاح API الخاص بـ APIYI، ثم غيّر قيمة model إلى gpt-6.2-sol، مع مراعاة أن اسم الطراز المعتمد هو ما يظهر في قائمة الطرازات على المنصة. وحتى ذلك الحين، يُعرض على المنصة الطراز gpt-6.1-sol بسعر $2 للإدخال و$10 للإخراج و$0.1 لقراءة الكاش، بينما يرتفع سعر الإدخال إلى $4 عند تجاوز 272,000 إدخال؛ يمكنك الاعتماد عليه لبناء سير العمل مبدئيًا، لكنه ليس الإصدار 6.2، ولا يصح اعتبار أسعاره أسعارًا لـ 6.2.
يمكن تقسيم اختيار الطراز حسب نوع المهمة، والجدول التالي يعرض التوصيات المقترحة استنادًا إلى البيانات العامة الواردة في ما سبق:
| سيناريو المهمة | التوصية | الأساس |
|---|---|---|
| مهام الكتابة والتنظيم والأعمال المكتبية اليومية | يمكن اعتبار GPT-6.2 Sol الخيار الافتراضي في البداية | أرقام LifeVal وGDPval v2 المعلنة رسميًا |
| التعديلات البرمجية الصغيرة وتقديم PR | GPT-6.2 Sol مناسب، ويُفضَّل عند الحساسية للتكلفة | أرقام FrontierCode 2.0 المعلنة رسميًا |
| الأسئلة حول مستودعات الكود ووكلاء البرمجة طويلي السلسلة | لا تكتفِ بالدرجة الإجمالية، وقارن أولًا على مستودعاتك الخاصة | انخفاض بمقدار 3 نقاط في Coding Agent Index وفق تقييم طرف ثالث |
| أسئلة وأجوبة يكون فيها إغفال حقيقة واحدة مكلفًا للغاية | أضف البحث والتحقق، وعند الحاجة اعتمد على التحقق المتقاطع عبر عدة نماذج | معدل هلوسة 55% وفق تقييم طرف ثالث |
| المدخلات فائقة الطول (أكثر من 272K) | قدّر أولًا التكلفة بعد احتساب السعر الإضافي على الطلب بالكامل | قواعد التسعير في صفحة النموذج الرسمية |
🚀 نصيحة للبدء: يمكنك اعتبار GPT-6.2 Sol خيارًا افتراضيًا للمهام اليومية، لكن في أسئلة وأجوبة تكون تكلفة إغفال الحقائق فيها مرتفعة فلا تكتفِ بالدرجة الإجمالية. يمكنك على APIYI عبر apiyi.com استخدام المفتاح نفسه لمقارنة الطرازات المتوفرة مثل
gpt-6.1-solوclaude-opus-5-5وgemini-4-carbon، وشغّل جولة اختبار على مهامك أولًا، ثم قم بالربط به للمقارنة بعد توفر الإصدار 6.2.
الأسئلة الشائعة (FAQ)
س1: ما موقع نموذج GPT-6.2 Sol؟
GPT-6.2 Sol هو الخيار الأقل سعرًا في سلسلة 6.2 التي أطلقتها OpenAI بتاريخ 2026-11-17، ومعرّف الطراز الخاص به `gpt-6.2-sol`، ويستقبل النصوص والصور كمدخلات وينتج نصوصًا كمخرجات، وتبلغ نافذة السياق لديه 1,050,000 رمز (token)، وحد المعرفة لديه 2026-06-01. يتمثل موقعه في كونه نموذجًا عامًا عالي الجودة مقابل التكلفة، وقد صدر في الوقت نفسه مع GPT-6.2 Astra الأعلى سعرًا.
س2: فيمَ يتفوق GPT-6.2 Sol على GPT-6.1 Sol وفيمَ يقل عنه؟
الأسعار المعلنة متطابقة. حسب الأرقام الرسمية المعلنة ذاتيًا، يتفوق بـ 5.3 نقطة في GDPval v2؛ وفي مؤشر Intelligence Index من جهة خارجية يتفوق في فئة Max بـ 2 نقطة ليصل إلى 57. لكنه يتأخر بـ 3 نقاط في مؤشر Coding Agent Index الخارجي، ويعود السبب الرئيسي إلى انخفاض درجته في SWE-Atlas-QnA-AA بـ 14 نقطة، ما يجعله أكثر عرضة لإغفال الحقائق الأساسية. الأداء في المهام اليومية يتحسن، بينما يتراجع في الإجابة على الأسئلة حول مستودعات الأكواد ضمن وكلاء البرمجة.
س3: هل GPT-6.2 Sol أفضل من GPT-6.2 Astra؟
لا يمكن القول ذلك. في الدرجات الشاملة من الجهات الخارجية، تتفوق Astra في جميع فئات الاستدلال، حيث تسجل 62 مقابل 57 في فئة Max. أما ميزة Sol فهي التكلفة: وفقًا للأرقام الرسمية المعلنة ذاتيًا، الفارق في FrontierCode 2.0 بينه وبين Astra أقل من 0.5 نقطة، وتكلفتها نحو الخُمس، بينما تكلفة المهمة الواحدة وفق الجهات الخارجية هي $1.01 مقابل $4.00.
س4: ما هو السعر الرسمي لـ GPT-6.2 Sol؟
السعر الرسمي القياسي للسياق القصير من OpenAI هو: $2 للمدخلات، و$0.10 لقراءة الذاكرة المؤقتة (cache)، و$2.50 لكتابة الذاكرة المؤقتة لمدة 30 دقيقة، و$10 للمخرجات (لكل مليون رمز token)، مع زيادة على الفاتورة بأكملها عند تجاوز المدخلات 272K. APIYI: النموذج غير متوفر على المنصة بعد، وسنعمل على إدراجه في أقرب وقت ممكن؛ يُرجى اعتماد قائمة الطرز على المنصة كمرجع للطرز والأسعار.
س5: قبل إدراج إصدار 6.2 على المنصة، كيف يمكن إجراء اختبارات مقارنة عبر الـ API؟
يمكنك أولًا إعداد سير العمل باستخدام الطرز المتوفرة حاليًا على المنصة:
1. سجّل في APIYI على apiyi.com واحصل على مفتاح API ورصيد اختبار مجاني
2. استخدم واجهة متوافقة مع OpenAI لاستدعاء الطرز المتوفرة مثل `gpt-6.1-sol` و`gpt-6-astra`
3. بعد إدراج 6.2، عدّل فقط معامل model لإجراء اختبار A/B مقارن
لاحظ أن كلاً من `gpt-6-sol` و`gpt-6.1-sol` ليسا 6.2، ولا يمكن استبدال أسعارهما ببعضهما.
س6: سعر Gemini 4 Carbon نفسه سعر Sol، فكيف أختار بينهما؟
السعر الرسمي القياسي لـ Gemini 4 Carbon حتى 2026-11-30 هو $2 للمدخلات و$10 للمخرجات، ومنذ 2026-12-01 يصبح $4 / $20، وأعلى درجة شاملة من الجهات الخارجية هي 60. أما الطراز `gemini-4-carbon` على APIYI apiyi.com فهو معروض حاليًا بسعر تعريفي، وبعد 1 ديسمبر يُرجى اعتماد قائمة المنصة كمرجع. يدعم هذا الطراز مدخلات الفيديو والصوت، لكنه لا يوفر نقطة نهاية Responses، فعند الاختيار اعتمد على نوع المدخلات والواجهة المطلوبة.
س7: هل يمكن استخدام GPT-6.2 Sol في أبحاث الثغرات الأمنية؟
بلغ النموذج المستوى “الحرج” في تصنيف الأمن السيبراني، ما يعني ضوابط أمان أكثر صرامة، وسيتم رفض بعض طلبات أبحاث الثغرات حتى لو كانت مشروعة. أما أداة Daybreak الموجّهة للمدافعين فلم يتوفر فيها الإصدار 6.2 حتى الآن، واكتفت الجهات الرسمية بالإشارة إلى أنها تعمل على إضافته.
النقاط الأساسية في GPT-6.2 Sol (Key Takeaways)
- تقدم واضح في المهام اليومية: الأرقام الرسمية المعلنة ذاتيًا في LifeVal أعلى من GPT-6 Astra، وبتكلفة تعادل السُّبع تقريبًا.
- الأسعار لم تتغير: السعر المعلن مطابق تمامًا لـ GPT-6.1 Sol، أي 2 دولار للمدخلات و10 دولارات للمخرجات.
- اقتراب من Astra في الدمج البرمجي: الفارق في النتائج الرسمية المعلنة ذاتيًا على FrontierCode 2.0 أقل من 0.5 نقطة.
- النتيجة الإجمالية من أطراف ثالثة: Max 57، وXhigh 56، وHigh 55، وMedium 53، وLow 41.
- تراجع في وكلاء البرمجة: مؤشر Coding Agent Index من أطراف ثالثة أقل بـ 3 نقاط من 6.1 Sol، مع ميل أكبر لإغفال الحقائق.
- معدل الهلوسة 55%: الأسئلة والإجابات الحساسة للحقائق تستلزم بالضرورة إضافة آليات استرجاع ومراجعة.
- طريقة البدء: قبل توفر 6.2 على المنصة، يمكنك عبر APIYI على apiyi.com بناء سير عمل مقارن مسبقًا باستخدام النماذج المتاحة حاليًا.
الملخص
النقاط الأساسية في GPT-6.2 Sol:
- المهام اليومية: تُظهر النتائج المُبلَّغ عنها ذاتيًا رسميًا في LifeVal وGDPval v2 تحسنًا، إذ تحصل على أداء يومي يقترب من النموذج الرائد في الجيل السابق مقابل سعر Sol.
- تقييم البرمجة يجب أن يكون منفصلًا: نتائج FrontierCode 2.0 المُبلَّغ عنها رسميًا تقترب من مستوى Astra، لكن مؤشر Coding Agent Index من طرف ثالث يقل بـ 3 نقاط عن GPT-6.1 Sol، كما أن الإجابة عن أسئلة قاعدة الشيفرة أكثر عرضة لإغفال الحقائق.
- الدرجة الإجمالية ليست كل شيء: نتيجة Max البالغة 57 من طرف ثالث تُعادل GPT-6 Astra، لكن معدل الهلوسة البالغ 55% ودرجة 41 في فئة Low يذكّرانك بألا تكتفِ برقم واحد فقط.
إذا تتمحور أعمالك اليومية أساسًا حول الكتابة والتنظيم والمهام المكتبية، فإن GPT-6.2 Sol يستحق أن يكون أول خيار تفكر فيه كنموذج افتراضي؛ أما إذا كنت تعتمد على وكيل برمجة للإجابة عن أسئلة قاعدة الشيفرة، أو كان إغفال حقيقة واحدة كفيل بإجبارك على إعادة العمل، فننصحك بإجراء اختبار مقارن على مهامك الخاصة أولًا. نوصي بمقارنة النماذج المتوفرة عبر APIYI على apiyi.com باستخدام المفتاح نفسه، ثم التبديل والتحقق بعد طرح الإصدار 6.2.
📚 المراجع
-
منشور إصدار OpenAI: التعريف الرسمي بـ GPT-6.2 Astra وSol والتقييمات المُبلَّغ عنها ذاتيًا
- الرابط:
openai.com/index/introducing-gpt-6-2-astra-sol - الوصف: مصدر النتائج الرسمية المُبلَّغ عنها ذاتيًا مثل LifeVal وFrontierCode 2.0 وGDPval v2
- الرابط:
-
صفحة نموذج OpenAI: مواصفات gpt-6.2-sol وسعره المعلن
- الرابط:
platform.openai.com/docs/models/gpt-6.2-sol - الوصف: نافذة السياق، وتاريخ قطع المعرفة، ورسوم الإضافة على الطلب الكامل بقيمة 272K، وقواعد Batch وFast وUltrafast
- الرابط:
-
بطاقة نظام OpenAI: تصنيف مستويات الأمان وتقييمات المواءمة
- الرابط:
deploymentsafety.openai.com/gpt-6-2-astra-sol - الوصف: مستوى “حرج” في الأمن السيبراني، ومستوى “مرتفع” في المجالات الحيوية والكيميائية، وتفاصيل إجراءات الوقاية
- الرابط:
-
مقال تقييم Artificial Analysis: الدرجة الإجمالية ومؤشر وكلاء البرمجة من طرف ثالث
- الرابط:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - الوصف: مؤشر Intelligence Index لكل فئة استدلال، ومؤشر Coding Agent Index، ومعدل الهلوسة
- الرابط:
-
صفحة النموذج على Artificial Analysis: تكلفة المهمة الواحدة لـ GPT-6.2 Sol
- الرابط:
artificialanalysis.ai/models/gpt-6-2-sol - الوصف: بيانات من طرف ثالث مثل تكلفة المهمة الواحدة في المؤشر الإجمالي
- الرابط:
-
الجدول الشامل لنماذج APIYI: النماذج المتوفرة على المنصة وأسعارها
- الرابط:
docs.apiyi.com/models.md - الوصف: التحقق من توفر الإصدار 6.2 وأسعار النماذج المعروضة
- الرابط:
الكاتب: الفريق التقني في APIYI
التواصل التقني: يسعدنا تواصلك عبر الصفحة الرئيسية لموقع APIYI، ويمكنك الاطلاع على مزيد من الموارد في مركز التوثيق docs.apiyi.com


