
Nota do autor: vamos separar as notas auto-reportadas oficialmente pelo GPT-6.2 Sol e a pontuação consolidada de terceiros, deixando claros os avanços dele em tarefas do dia a dia, o recuo em agentes de codificação e em precisão factual, além do preço de tabela, das regras de cobrança e das recomendações de escolha de modelo.
A OpenAI lançou o GPT-6.2 Astra e o GPT-6.2 Sol no mesmo dia, 17/11/2026. Entre eles, o GPT-6.2 Sol mantém o preço de tabela de API do GPT-6.1 Sol, mas com resultados claramente melhores em tarefas do dia a dia — muita gente já vai configurá-lo como modelo padrão de cara. O comunicado oficial, o system card e a página do modelo já estão no ar, e a Artificial Analysis publicou no mesmo dia sua pontuação consolidada de terceiros. Ou seja: nada de boato de internet.
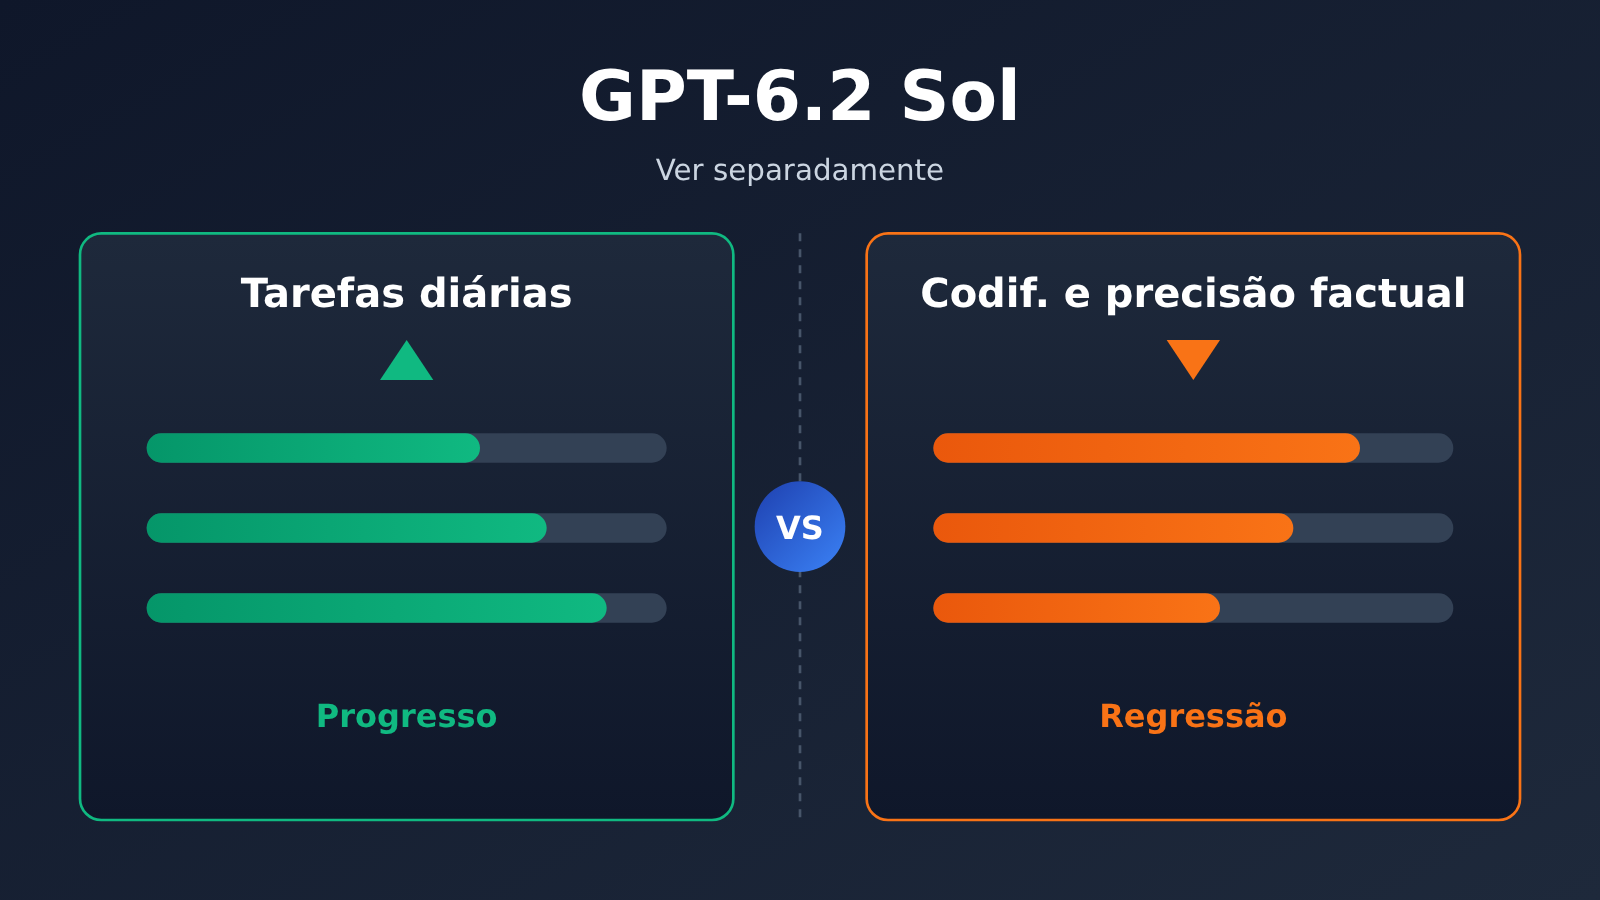
Este não é mais um texto repetindo os benchmarks oficiais. Aqui, os números ficam divididos em duas trilhas separadas — o que a OpenAI reporta sobre o próprio modelo e o que os terceiros mediram —, cada uma falando por si, sem misturar tudo num veredito único. No GPT-6.2 Sol, tarefas do dia a dia e codificação precisam ser lados em separado: no primeiro, o avanço é real; no segundo, um indicador de terceiros ficou 3 pontos abaixo da geração anterior.
Valor central: ao final da leitura, você saberá decidir se o GPT-6.2 Sol merece ser seu modelo padrão — e em quais cenários a pontuação consolidada, sozinha, não conta a história toda.
Pontos-chave do GPT-6.2 Sol
Primeiro, uma tabela de leitura rápida; em seguida, cada item é detalhado. Cada linha da tabela indica a origem dos números, com os resultados auto-reportados oficialmente e os de terceiros anotados separadamente.
| Ponto-chave | Descrição | Fonte dos dados |
|---|---|---|
| Tarefas do dia a dia | Pontuação no LifeVal acima da do GPT-6 Astra, com cerca de um sétimo do custo | Auto-reportado oficialmente |
| Mesclagem de código | No FrontierCode 2.0, diferença de menos de 0,5 ponto em relação ao GPT-6.2 Astra, com cerca de um quinto do custo; ambos no modo Max | Auto-reportado oficialmente |
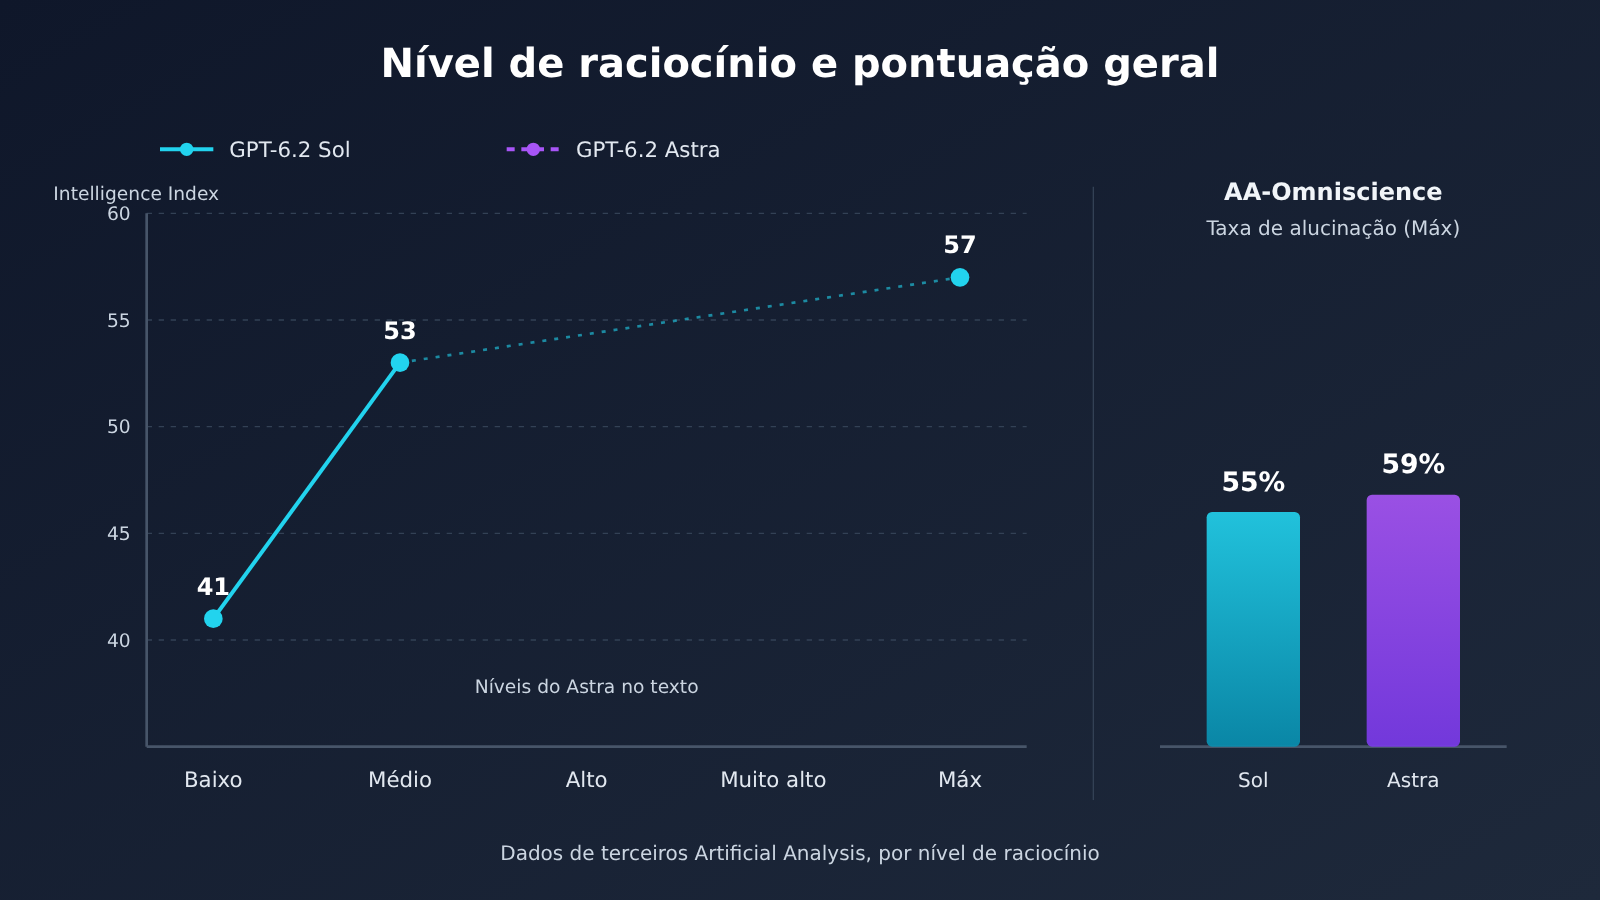
| Pontuação geral | Intelligence Index v5.0.1: Max 57, Xhigh 56, High 55, Medium 53, Low 41 | Artificial Analysis (terceiros) |
| Agente de codificação | Coding Agent Index 3 pontos abaixo do GPT-6.1 Sol, com maior chance de omitir fatos essenciais | Artificial Analysis (terceiros) |
| Taxa de alucinação | Taxa de alucinação no AA-Omniscience (Max) de 55% | Artificial Analysis (terceiros) |
| Preço de tabela | Igual ao do GPT-6.1 Sol: $2 de entrada, $10 de saída (por 1 milhão de tokens) | OpenAI (oficial) |
Os pontos-chave do GPT-6.2 Sol em detalhes
O maior destaque desta geração do GPT-6.2 Sol é “pelo mesmo preço, fazer melhor o trabalho do dia a dia”. Os resultados auto-reportados no LifeVal e no GDPval v2 apontam na mesma direção: o Sol já supera o carro-chefe da geração anterior, o GPT-6 Astra, em tarefas rotineiras de escritório, e ainda custa bem menos. Para quem o usa como modelo padrão, é essa parte do avanço que fica mais fácil de perceber.
O outro lado também precisa ficar claro. O Coding Agent Index da Artificial Analysis (terceira parte) mostra que o GPT-6.2 Sol fica 3 pontos abaixo do GPT-6.1 Sol, com o principal arrasto vindo de um subitem que avalia perguntas e respostas sobre bases de código. A taxa de alucinação no AA-Omniscience também chega a 55%. Ou seja, “a pontuação geral subiu” não significa “tudo ficou mais estável”, especialmente em cenários em que deixar passar um único fato obriga a refazer o trabalho.
Funcionalidades principais e especificações do GPT-6.2 Sol
O ID do modelo do GPT-6.2 Sol é gpt-6.2-sol; a entrada aceita texto e imagens, enquanto a saída é somente texto, sem suporte a áudio e vídeo. A janela de contexto é de 1.050.000 tokens, com entrada máxima de 922.000, saída máxima de 128.000 e corte de conhecimento em 2026-06-01, um pouco mais recente que o do Astra (2026-05-18). A API não permite definir o reasoning effort como none; o nível mais baixo disponível é Low.
A tabela abaixo compara as especificações oficiais e os preços de tabela do Sol e do Astra; os valores se referem à faixa padrão de contexto curto, por 1 milhão de tokens. Para verificar a disponibilidade nas plataformas, consultamos a tabela geral de modelos da APIYI (apiyi.com), com dados de 2026-11-17 15:54 (UTC+8), e a interface pública de preços — nenhum dos dois modelos 6.2 aparecia ainda.
| Item | gpt-6.2-sol | gpt-6.2-astra |
|---|---|---|
| Entrada / leitura de cache / saída | $2 / $0.10 / $10 | $8 / $0.40 / $40 |
| Escrita de cache (30 minutos / 12 horas) | $2.50 / $5 | $10 / $20 |
| Contexto / saída máxima | 1.050.000 / 128.000 | 1.050.000 / 128.000 |
| Corte de conhecimento | 2026-06-01 | 2026-05-18 |
| Variação de preço | Mantém o preço de tabela do GPT-6.1 Sol | Entrada e saída 20% mais baratas que as do GPT-6 Astra; entrada em cache, 60% mais barata |
| Plataformas disponíveis | API da OpenAI; APIYI (apiyi.com) ainda não disponível | API da OpenAI; APIYI (apiyi.com) ainda não disponível |
Os valores acima são os preços oficiais da OpenAI. gpt-6.2-sol e gpt-6.2-astra na APIYI: ainda não disponíveis — vamos listar esses modelos o quanto antes; quanto a modelos e preços, vale o que estiver na lista de modelos da plataforma.
Regras de precificação do GPT-6.2 Sol
A página do modelo traz algumas regras de precificação que valem para os dois modelos — e é aí que surgem as principais diferenças na fatura:
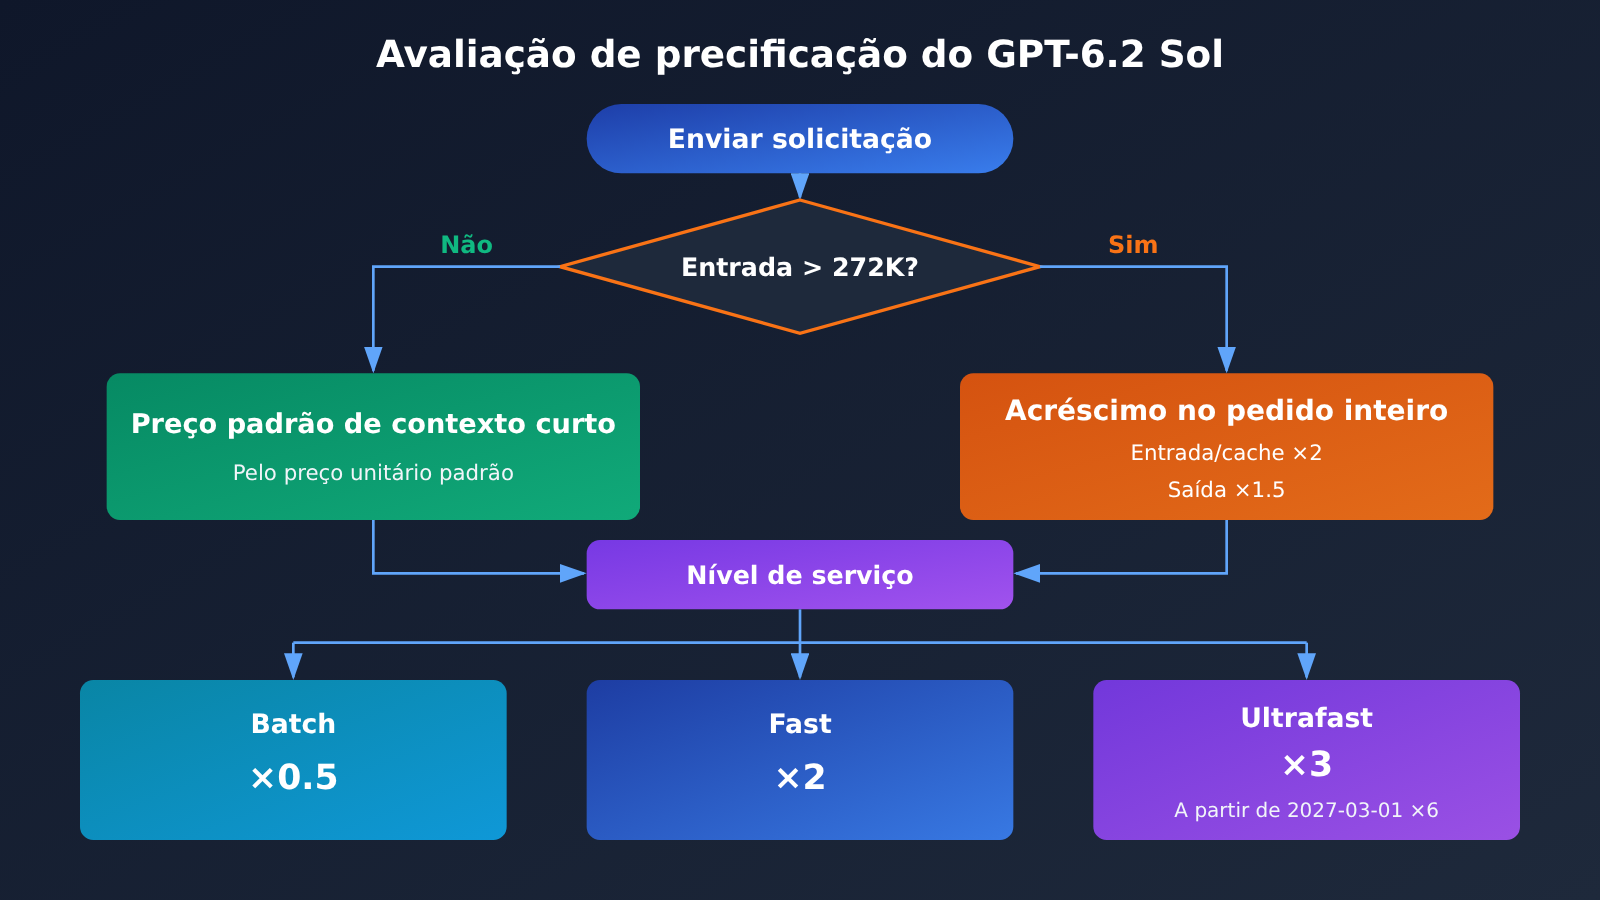
- Entradas longas com acréscimo no pedido inteiro: quando a entrada de uma única requisição passa de 272K tokens, o preço unitário de entrada e de cache dobra e a saída é cobrada a 1,5x o valor de contexto curto — e o pedido inteiro é calculado com esses preços, não apenas a parte que excede o limite.
- Batch: 50% do preço padrão.
- Fast: 2x o preço padrão para o mesmo comprimento de contexto.
- Ultrafast: 3x o preço padrão até 2027-02-28 (horário do Pacífico); a partir de 2027-03-01, passa a 6x.
Quanto aos endpoints, Chat Completions, Responses e Batch são suportados, enquanto Realtime, Assistants, fine-tuning, geração de imagens, vídeo e voz não são. Ou seja, o GPT-6.2 Sol é um modelo de conversa e raciocínio com saída apenas em texto, e a forma de integração é praticamente igual à da geração anterior.
Dados de avaliação do GPT-6.2 Sol: tarefas do dia a dia
Esta seção usa apenas os números reportados oficialmente. No anúncio de lançamento, a OpenAI apresenta dois resultados principais do Sol em tarefas do dia a dia. A tabela abaixo os lista junto com o item de programação, para facilitar a comparação — mas vale lembrar: todos foram testados e reportados pela própria OpenAI.
| Avaliação | Categoria | Resultado do GPT-6.2 Sol | Fonte |
|---|---|---|---|
| LifeVal | Tarefas do dia a dia (conjunto criado pela própria OpenAI) | Acima do GPT-6 Astra, com custo de cerca de um sétimo | Reportado pela própria OpenAI |
| GDPval v2 | Tarefas profissionais de trabalho (avaliação interna oficial) | 5,3 pontos acima do GPT-6.1 Sol | Reportado pela própria OpenAI |
| FrontierCode 2.0 | Se alterações em repositórios de código reais são mescladas | Diferença de menos de 0,5 ponto em relação ao GPT-6.2 Astra, com custo de cerca de um quinto, ambos no modo Max | Reportado pela própria OpenAI |
| AA-3D | Elo em avaliação às cegas por humanos | 1259 (Astra 1318, Claude Fable 5.2 1271) | Repassado pela OpenAI |
O LifeVal é um conjunto de tarefas do dia a dia criado pela própria OpenAI; segundo o anúncio, o Sol pontuou acima do GPT-6 Astra, com custo de cerca de um sétimo deste. O GDPval v2 é uma avaliação interna oficial, na qual o Sol ficou 5,3 pontos acima do GPT-6.1 Sol. Nenhum dos dois divulgou a pontuação absoluta, e este artigo não vai fazer estimativas por conta própria.
Esses dois resultados mostram uma coisa: em tarefas cotidianas como escrever e-mails, organizar informações, montar planilhas e redigir documentos, o GPT-6.2 Sol custa o preço de um modelo Sol, mas entrega resultados que chegam perto — ou até superam — os do carro-chefe da geração anterior. Ainda assim, um “conjunto de avaliação criado pela própria OpenAI” naturalmente favorece os modelos da casa; é mais prudente tratar esses números como um sinal de direção.
Dados de avaliação do GPT-6.2 Sol: codificação
No quesito codificação, é preciso olhar as coisas separadamente, porque os números autoavaliados oficialmente e os dados de terceiros apontam para direções diferentes. Além disso, cada um testa tarefas distintas — então vamos tratar de cada um em separado, sem fundir tudo num único veredito.
Autoavaliação oficial: FrontierCode 2.0
O FrontierCode 2.0 foi construído pela Cognition e testa se as mudanças que o modelo faz em bases de código reais conseguem ser mescladas pelos mantenedores. Segundo a autoavaliação oficial, o GPT-6.2 Sol fica menos de 0,5 ponto atrás do GPT-6.2 Astra, com cerca de um quinto do custo; na comparação, ambos usaram o nível de raciocínio Max. Esse resultado é uma boa notícia para trabalhos do tipo “pequenas alterações no código e abertura de PRs”.
Terceiros: Coding Agent Index
O Coding Agent Index da Artificial Analysis usa o harness do Codex e o nível de raciocínio Max. O resultado: o Astra ficou empatado com o GPT-6 Astra, enquanto o GPT-6.2 Sol ficou 3 pontos abaixo do GPT-6.1 Sol. De acordo com o artigo, a causa principal foi a queda de 14 pontos no subitem SWE-Atlas-QnA-AA — o modelo deixa passar fatos essenciais com mais facilidade.
Colocando os dois lado a lado, fica claro: o FrontierCode 2.0 mede se “a mudança consegue ser integrada”, enquanto o SWE-Atlas-QnA-AA pende para “se é possível responder por completo às perguntas sobre a base de código”. O GPT-6.2 Sol se aproxima do Astra na primeira e, na segunda, recuou até em relação à geração anterior da própria família. Se o seu agente de codificação precisa responder a muitas perguntas do tipo “onde esta função é chamada?” ou “quais módulos esta configuração afeta?”, não dá para olhar só o FrontierCode.
Pontuação composta de terceiros e taxa de alucinação do GPT-6.2 Sol
O Intelligence Index v5.0.1 da Artificial Analysis atribui notas separadas por nível de raciocínio. Todos os números da tabela abaixo são de terceiros, e cada célula corresponde a um nível de raciocínio — não compare o Max do Sol com o Medium dos outros.
| Nível de raciocínio | GPT-6.2 Sol | GPT-6.2 Astra |
|---|---|---|
| Max | 57 | 62 |
| Xhigh | 56 | 62 |
| High | 55 | 60 |
| Medium | 53 | 57 |
| Low | 41 | 46 |
| Custo por tarefa do índice composto (Max) | $1.01 | $4.00 |
No mesmo artigo, o Claude Fable 5.2 lidera com 65 no nível máximo, o Gemini 4 Carbon chega a 60 e o Claude Opus 5.5 a 59. O Max de 57 do GPT-6.2 Sol fica 2 pontos acima do GPT-6.1 Sol, empata com o GPT-6 Astra e custa cerca de 15% do valor deste por tarefa. Ou seja, o Sol não é superior ao Astra em tudo — o ponto forte dele é alcançar o flagship da geração anterior com um custo bem menor.
A diferença entre os níveis de raciocínio também merece atenção. O Sol cai 12 pontos do Medium (53) para o Low (41), e como a API não permite desativar o raciocínio, o Low já é o nível mais baixo disponível. Se no dia a dia a configuração padrão for rebaixada para o Low para economizar, o modelo que você recebe não é mais aquele dos 57 pontos.
Taxa de alucinação do GPT-6.2 Sol
Na taxa de alucinação AA-Omniscience (Max), o GPT-6.2 Sol registra 55% e o Astra, 59%. O número do Sol é um pouco menor, mas ambos ficam acima da metade — o que significa que, quando o modelo está inseguro, ele ainda tem uma tendência considerável de dar respostas erradas com aparência de certeza. Somando isso ao resultado 14 pontos abaixo no SWE-Atlas-QnA-AA mencionado acima, perguntas e respostas sensíveis a fatos exigem etapas extras de recuperação ou verificação de informações.
Classificação de segurança e disponibilidade do GPT-6.2 Sol
Segundo a estrutura de preparação da OpenAI (Preparedness Framework), tanto o GPT-6.2 Sol quanto o Astra alcançaram o nível “crítico” em segurança cibernética, e “alto” em biologia e química. Oficialmente, a empresa citou apenas o Astra como tendo atingido o limite alto de “autoaprimoramento de IA” — nada foi dito sobre o Sol. Em consequência, as proteções ficaram mais rígidas, e até algumas solicitações legítimas de pesquisa de vulnerabilidades serão recusadas, então quem trabalha com segurança já deve se preparar para isso.
O projeto Daybreak, voltado para o lado defensivo, oferece atualmente o Alpha do GPT-6 Astra, o GPT-6 Sol no Daybreak Blue e o GPT-6 Cyber no Daybreak Red. A OpenAI afirma que vai se esforçar para trazer a versão 6.2 para o Daybreak, mas, por enquanto, isso ainda não está disponível. Em termos de alinhamento, a maioria das avaliações ficou próxima à do GPT-6 Astra, com menos ações inadequadas em simulações de ambiente profissional; porém, dois testes mostraram que ele tende a deixar passar mais problemas que bloqueiam o andamento do trabalho, como arquivos ausentes ou ferramentas de busca indisponíveis — no Codex, ao adicionar instruções, esse tipo de omissão diminuiu consideravelmente.
Quanto à disponibilidade, os planos Plus, Pro, Enterprise e Edu já podem usar o modelo no ChatGPT Work e no Codex a partir de hoje. O Pro 500 pode ativar o Ultrafast para os dois modelos, e o Pro 200 recebe o Ultrafast pela primeira vez, começando pelo GPT-6.2 Sol; nas categorias Enterprise e Edu elegíveis, é preciso que o administrador do workspace ative o recurso. Já os desenvolvedores podem acessar via API da OpenAI — ambos os modelos suportam Ultrafast desde o lançamento.
Análise de prós e contras do GPT-6.2 Sol
Vantagens
- Ótimo custo-benefício em tarefas do dia a dia: segundo os números auto-reportados oficialmente, o LifeVal fica acima do GPT-6 Astra, com cerca de um sétimo do custo; no GDPval v2, marca 5,3 pontos a mais que o GPT-6.1 Sol.
- Preço inalterado: o preço de tabela é o mesmo do GPT-6.1 Sol — a atualização não aumenta o preço unitário.
- Capacidade de merge de código próxima à do Astra: de acordo com a divulgação oficial, a diferença no FrontierCode 2.0 para o Astra é inferior a 0,5 ponto, com cerca de um quinto do custo.
- Pontuação geral alcança o carro-chefe da geração anterior: nos benchmarks de terceiros, fez 57 no Max, empatando com o GPT-6 Astra, com custo por tarefa de cerca de 15% do custo do Astra.
Limitações
- Agentes de codificação regrediram: no Coding Agent Index de terceiros, fica 3 pontos abaixo do GPT-6.1 Sol, e 14 pontos abaixo no SWE-Atlas-QnA-AA. A saída é adicionar recuperação (retrieval) e verificação cruzada às perguntas e respostas sobre a base de código.
- Taxa de alucinação elevada: no AA-Omniscience, a taxa de alucinação chega a 55% — tarefas sensíveis a fatos pedem citações ou revisão humana.
- Queda acentuada na faixa de raciocínio baixa: na faixa Low, a pontuação é de apenas 41, e não dá para desligar o raciocínio — é preciso pesar bem na hora de cortar custos.
- Proteções de segurança mais rígidas: parte da pesquisa legítima de vulnerabilidades pode ser recusada, e o Daybreak ainda não tem 6.2.
Primeiros Passos com o GPT-6.2 Sol
A forma de integração do GPT-6.2 Sol é a mesma da geração anterior: dá para usar tanto o Chat Completions quanto o Responses. Basta preencher o nome do modelo como gpt-6.2-sol, escolher um nível de raciocínio de Low a Max e não passar none. Se você já trabalha com uma interface compatível com OpenAI, trocar de modelo geralmente se resume a alterar um único parâmetro.
Depois que ele estiver disponível na APIYI, basta definir o base_url do SDK da OpenAI como https://api.apiyi.com/v1, inserir a chave API da APIYI e mudar o model para gpt-6.2-sol — o nome do modelo deve sempre seguir a lista de modelos da plataforma. Até lá, o gpt-6.1-sol, já disponível na plataforma, está precificado em $2 para entrada, $10 para saída e $0.1 para leitura de cache; acima de 272.000 de entrada, o preço da entrada passa a ser $4. Dá para usá-lo desde já para montar o fluxo de trabalho, mas ele não é o 6.2 — e os preços dele não devem ser tomados como os do 6.2.
A escolha do modelo pode ser pensada por tipo de tarefa. A tabela abaixo resume as sugestões, com justificativas baseadas nos dados públicos apresentados anteriormente:
| Cenário de tarefa | Recomendação | Justificativa |
|---|---|---|
| Tarefas do dia a dia: escrita, organização e escritório | Considere o GPT-6.2 Sol como padrão inicial | Resultados oficiais autodeclarados em LifeVal e GDPval v2 |
| Pequenas alterações de código, envio de PRs | O GPT-6.2 Sol atende; priorize-o quando o custo pesa | Resultados oficiais autodeclarados no FrontierCode 2.0 |
| Dúvidas sobre o código-base, agentes de codificação em fluxos longos | Não olhe só a pontuação agregada; compare primeiro no seu próprio repositório | 3 pontos a menos no Coding Agent Index de terceiros |
| Perguntas em que deixar passar um fato custa caro | Acrescente recuperação de informações e verificação, cruzando vários modelos quando necessário | Taxa de alucinação de 55% em avaliações de terceiros |
| Entradas muito longas (acima de 272K) | Calcule antes o custo já com o acréscimo aplicado ao pedido inteiro | Regras de precificação na página oficial do modelo |
🚀 Sugestão para começar: no dia a dia, vale considerar o GPT-6.2 Sol como padrão, mas em perguntas em que errar um fato custa caro não fique só na pontuação agregada. Na APIYI (apiyi.com), use a mesma chave API para comparar os modelos já disponíveis, como
gpt-6.1-sol,claude-opus-5-5egemini-4-carbon, rode um ciclo de testes nas suas próprias tarefas e, quando o 6.2 estiver no ar, integre-o para comparar.
Perguntas Frequentes (FAQ)
Q1: Qual é o posicionamento do GPT-6.2 Sol?
O GPT-6.2 Sol é a opção mais barata da série 6.2 lançada pela OpenAI em 2026-11-17, com o ID de modelo `gpt-6.2-sol`: aceita entrada de texto e imagem, gera saída de texto, tem janela de contexto de 1.050.000 tokens e base de conhecimento com corte em 2026-06-01. Seu posicionamento é o de um modelo de uso geral com excelente custo-benefício, lançado na mesma época que o GPT-6.2 Astra, mais caro.
Q2: Quais são os pontos fortes e fracos do GPT-6.2 Sol em relação ao GPT-6.1 Sol?
Os preços de tabela são os mesmos. No GDPval v2, segundo o auto-relato oficial, são 5.3 pontos a mais; no Intelligence Index de terceiros, na faixa Max, são 2 pontos a mais, chegando a 57. Porém, no Coding Agent Index de terceiros, são 3 pontos a menos — principalmente porque o SWE-Atlas-QnA-AA cai 14 pontos, o que facilita deixar fatos importantes de fora. Nas tarefas do dia a dia, o modelo evoluiu; já nas perguntas e respostas sobre bases de código dentro de agentes de programação, regrediu.
Q3: O GPT-6.2 Sol é melhor que o GPT-6.2 Astra?
Não dá para afirmar isso. Nas pontuações gerais de terceiros, o Astra é superior em todas as faixas de raciocínio — na faixa Max, são 62 contra 57. A vantagem do Sol está no custo: segundo o auto-relato oficial, no FrontierCode 2.0 a diferença para o Astra é de menos de 0.5 pontos, com um custo de aproximadamente um quinto; já o custo por tarefa medido por terceiros é de $1.01 contra $4.00.
Q4: Qual é o preço oficial do GPT-6.2 Sol?
Na tabela oficial da OpenAI para contexto curto, os preços padrão são: entrada $2, leitura de cache $0.10, gravação de cache de 30 minutos $2.50 e saída $10 (por 1 milhão de tokens); quando a entrada ultrapassa 272K, é aplicado um acréscimo sobre o valor total. APIYI: por enquanto, o modelo ainda não está disponível na nossa plataforma — vamos adicioná-lo o quanto antes; os nomes de modelos e os preços válidos são os da lista de modelos da plataforma.
Q5: Antes de a 6.2 ficar disponível, como fazer testes comparativos via API?
Você já pode montar o fluxo usando modelos que já estão listados:
1. Crie uma conta na APIYI (apiyi.com) e obtenha a chave API e créditos de teste gratuitos
2. Use a interface compatível com a OpenAI para chamar modelos já disponíveis, como `gpt-6.1-sol` e `gpt-6-astra`
3. Quando a 6.2 for adicionada, basta alterar o parâmetro `model` para rodar o comparativo A/B
Atenção: nem `gpt-6-sol` nem `gpt-6.1-sol` são a versão 6.2, e os preços de um não valem para o outro.
Q6: O Gemini 4 Carbon tem o mesmo preço do Sol — como escolher?
O preço oficial de tabela do Gemini 4 Carbon é de entrada $2 e saída $10 até 2026-11-30; a partir de 2026-12-01 passa a ser $4 / $20, e a pontuação geral de terceiros na faixa mais alta é 60. Na APIYI (apiyi.com), o `gemini-4-carbon` está atualmente listado com preço promocional de lançamento; após 2026-12-01, vale o que estiver na lista da plataforma. Ele aceita entrada de vídeo e áudio, mas não oferece o endpoint Responses — na hora de decidir, considere o tipo de entrada e a interface de que você precisa.
Q7: Dá para usar o GPT-6.2 Sol em pesquisa de vulnerabilidades?
Ele atingiu a classificação “crítica” em segurança cibernética, e as salvaguardas ficaram mais rigorosas — parte das solicitações legítimas de pesquisa de vulnerabilidades pode ser recusada. Para o lado defensivo, o Daybreak ainda não conta com a 6.2; oficialmente, a OpenAI apenas afirmou que fará esforços para incorporá-la.
Pontos-Chave do GPT-6.2 Sol (Key Takeaways)
- Progresso notável em tarefas do dia a dia: o LifeVal autodeclarado oficialmente fica acima do GPT-6 Astra, com custo de cerca de um sétimo.
- Preço inalterado: o preço de tabela é o mesmo do GPT-6.1 Sol, $2 na entrada e $10 na saída.
- Mesclagem de código quase no nível da Astra: no FrontierCode 2.0 autodeclarado oficialmente, a diferença é inferior a 0,5 ponto.
- Pontuação agregada de terceiros: Max 57, Xhigh 56, High 55, Medium 53, Low 41.
- Recuo nos agentes de codificação: o Coding Agent Index de terceiros fica 3 pontos abaixo do 6.1 Sol, com tendência a omitir fatos.
- Taxa de alucinação de 55%: em perguntas e respostas sensíveis a fatos, é indispensável adicionar recuperação de informações e revisão.
- Como começar: antes de o 6.2 ficar disponível, você já pode montar um fluxo de comparação na APIYI (apiyi.com) usando os modelos disponíveis.
Resumo
Os pontos-chave do GPT-6.2 Sol:
- Tarefas do dia a dia: o LifeVal e o GDPval v2 autodeclarados oficialmente mostram progresso, entregando um desempenho diário próximo ao do carro-chefe da geração anterior pelo preço do Sol.
- Codificação exige uma leitura separada: o FrontierCode 2.0 autodeclarado fica próximo da Astra, mas o Coding Agent Index de terceiros está 3 pontos abaixo do GPT-6.1 Sol, e perguntas e respostas sobre bases de código tendem a omitir mais fatos.
- A pontuação agregada não é tudo: o Max de terceiros em 57 empata com o GPT-6 Astra, mas a taxa de alucinação de 55% e os 41 pontos na faixa Low lembram que você não deve se guiar por um único número.
Se o seu trabalho do dia a dia é centrado em escrita, organização e tarefas de escritório, vale considerar o GPT-6.2 Sol primeiro como modelo padrão; se você depende de agentes de codificação para responder perguntas sobre a base de código, ou um único fato perdido já significa retrabalho, o ideal é rodar um comparativo nas suas próprias tarefas antes. Recomendo usar a APIYI (apiyi.com) para comparar os modelos disponíveis com a mesma chave API e, depois que o 6.2 for lançado, fazer a troca e validar.
📚 Referências
-
Post de lançamento da OpenAI: apresentação oficial e avaliações autoinformadas de GPT-6.2 Astra e Sol
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol - Descrição: fonte das pontuações oficiais autoinformadas em LifeVal, FrontierCode 2.0, GDPval v2 e outros benchmarks
- Link:
-
Página de modelos da OpenAI: especificações e preço de tabela do gpt-6.2-sol
- Link:
platform.openai.com/docs/models/gpt-6.2-sol - Descrição: janela de contexto, data de corte do conhecimento, sobretaxa de 272K aplicada ao pedido inteiro e regras de Batch, Fast e Ultrafast
- Link:
-
System card da OpenAI: classificação de segurança e avaliações de alinhamento
- Link:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Descrição: nível “crítico” em cibersegurança, nível “alto” em risco biológico-químico e detalhes das salvaguardas
- Link:
-
Artigo de avaliação da Artificial Analysis: pontuação geral de terceiros e índice de agentes de codificação
- Link:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Descrição: Intelligence Index por nível de raciocínio, Coding Agent Index e taxa de alucinação
- Link:
-
Página de modelos da Artificial Analysis: custo por tarefa do GPT-6.2 Sol
- Link:
artificialanalysis.ai/models/gpt-6-2-sol - Descrição: dados de terceiros, como o custo por tarefa do índice geral
- Link:
-
Tabela geral de modelos da APIYI: modelos disponíveis na plataforma e preços
- Link:
docs.apiyi.com/models.md - Descrição: conferir se o 6.2 já está disponível e os preços de tabela dos modelos em oferta
- Link:
Autor: Equipe Técnica da APIYI
Intercâmbio técnico: fique à vontade para entrar em contato conosco pela página inicial do site da APIYI; para mais materiais, acesse a central de documentação em docs.apiyi.com


