
Anmerkung des Autors: Wir betrachten die offiziellen Selbstangaben von GPT-6.2 Sol und den Gesamtscore unabhängiger Dritter getrennt voneinander und klären, wo das Modell bei Alltagsaufgaben zugelegt hat, wo es bei Coding-Agenten und faktischer Genauigkeit nachgelassen hat – und dazu den Listenpreis, die Abrechnungsregeln und Empfehlungen zur Modellwahl.
OpenAI hat am 17. November 2026 GPT-6.2 Astra und GPT-6.2 Sol gleichzeitig veröffentlicht. GPT-6.2 Sol übernimmt den API-Listenpreis von GPT-6.1 Sol, liegt bei Alltagsaufgaben aber spürbar höher – viele werden es daher beiläufig als Standardmodell einstellen. Die offizielle Release-Ankündigung, die System Card und die Modellseite sind bereits online, und auch Artificial Analysis hat noch am selben Tag einen unabhängigen Gesamtscore vorgelegt. Das ist kein Gerücht.
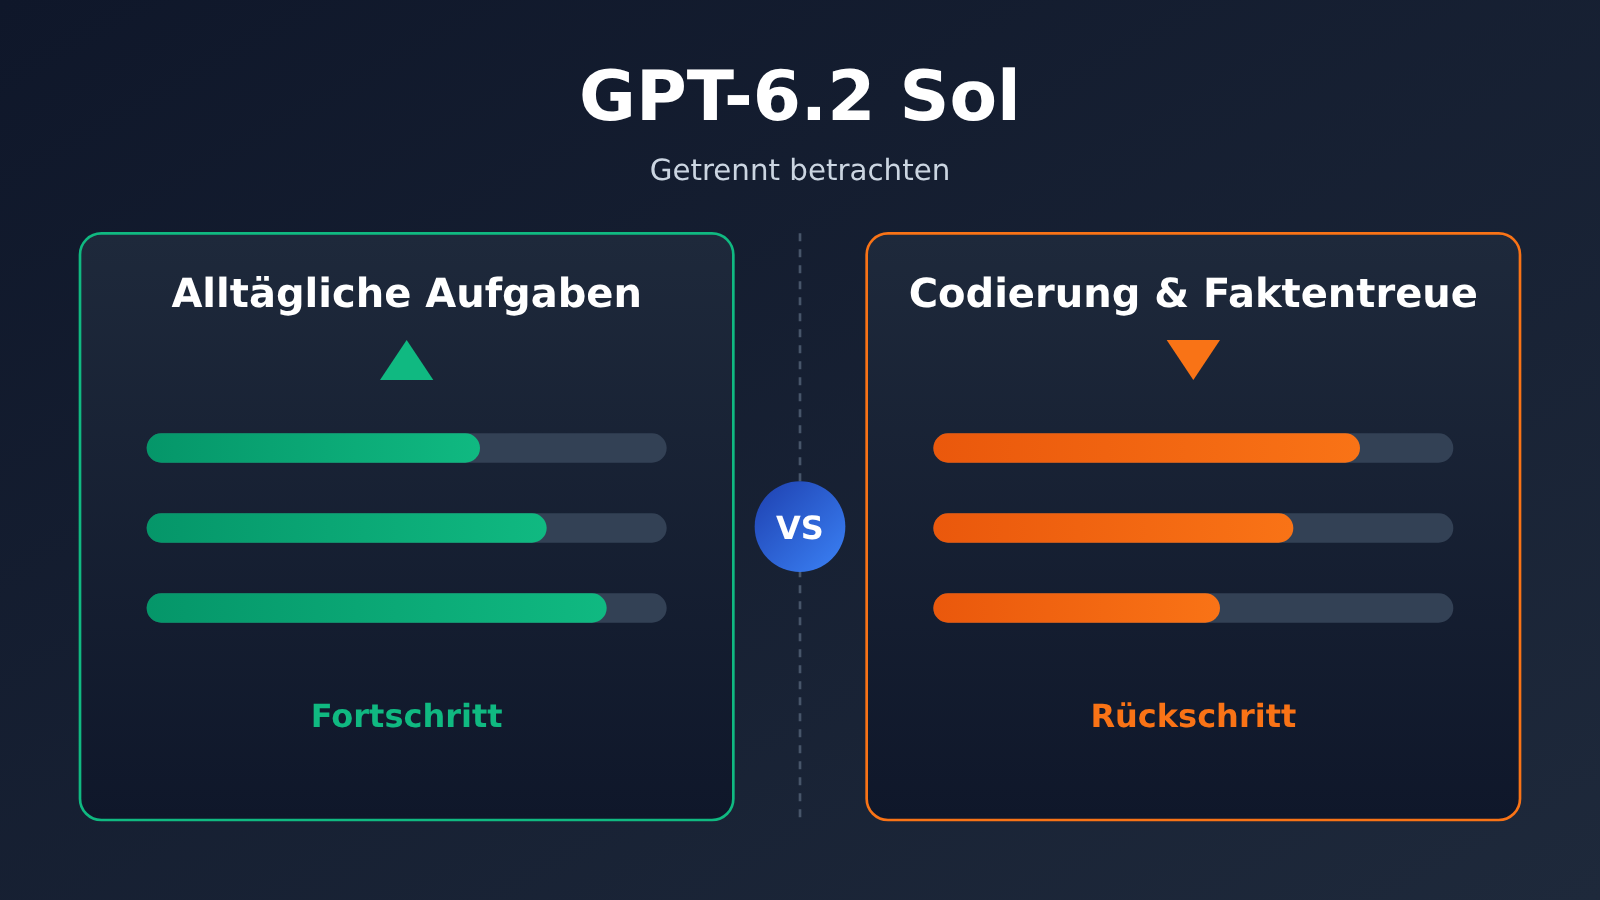
Das hier ist kein Artikel, der die offiziellen Benchmarks einfach nachplappert. Dieser Text trennt die Zahlen in zwei Stränge – offizielle Selbstangaben und unabhängige Messungen –, lässt beide für sich sprechen und rechnet sie nicht zu einem Gesamtergebnis zusammen. Bei GPT-6.2 Sol solltest du Alltagsaufgaben und Coding getrennt betrachten: Ersteres verbessert sich tatsächlich, bei Letzterem ist ein unabhängiger Indikator gegenüber der Vorgängergeneration um 3 Punkte gefallen.
Was du mitnimmst: Nach diesem Artikel kannst du einschätzen, ob GPT-6.2 Sol als Standardmodell taugt – und weißt, in welchen Szenarien der Gesamtscore allein nicht reicht.
Die Kernpunkte von GPT-6.2 Sol Sol
Zuerst eine Tabelle für den Schnellüberblick, im Folgenden werden die Punkte einzeln ausgeführt. In jeder Zeile ist die Quelle der Zahlen angegeben – offizielle Selbstangaben und Ergebnisse von Drittanbietern sind getrennt aufgeführt.
| Punkt | Erläuterung | Datenquelle |
|---|---|---|
| Alltagsaufgaben | LifeVal-Wert höher als bei GPT-6 Astra, bei etwa einem Siebtel der Kosten | Offizielle Selbstangabe |
| Code-Merging | FrontierCode 2.0: weniger als 0,5 Punkte Abstand zu GPT-6.2 Astra, bei etwa einem Fünftel der Kosten, beide auf Max | Offizielle Selbstangabe |
| Gesamtwert | Intelligence Index v5.0.1: Max 57, Xhigh 56, High 55, Medium 53, Low 41 | Artificial Analysis (Drittanbieter) |
| Coding-Agent | Coding Agent Index 3 Punkte unter GPT-6.1 Sol, lässt leichter entscheidende Fakten aus | Artificial Analysis (Drittanbieter) |
| Halluzinationsrate | AA-Omniscience-Halluzinationsrate (Max): 55 % | Artificial Analysis (Drittanbieter) |
| Listenpreis | identisch mit GPT-6.1 Sol: $2 für die Eingabe, $10 für die Ausgabe (pro 1 Million Token) | OpenAI (offiziell) |
GPT-6.2 Sol Sol im Detail
Der größte Blickfang dieser Generation von GPT-6.2 Sol ist: „Zum selben Preis werden Alltagsaufgaben besser erledigt“. Die offiziell berichteten Werte für LifeVal und GDPval v2 deuten beide in dieselbe Richtung: Bei alltäglichen Büroaufgaben liegt Sol inzwischen vor dem Flaggschiff der letzten Generation, GPT-6 Astra – und das zu deutlich niedrigeren Kosten. Wer es als Standardmodell einsetzt, spürt diesen Fortschritt am unmittelbarsten.
Die Kehrseite darf aber ebenso wenig fehlen. Der Coding Agent Index des Drittanbieters Artificial Analysis zeigt: GPT-6.2 Sol liegt 3 Punkte unter GPT-6.1 Sol. Hauptgrund ist ein Untertest, der Frage-Antwort-Aufgaben zu Codebasen prüft. Die Halluzinationsrate von AA-Omniscience liegt zudem bei 55 %. Ein gestiegener Gesamtwert bedeutet also nicht, dass „alles stabiler läuft“ – besonders in Szenarien, in denen ein einziges übersehenes Faktum Nacharbeit nach sich zieht.
Kernfunktionen und Spezifikationen von GPT-6.2 Sol
Die Modell-ID von GPT-6.2 Sol lautet gpt-6.2-sol; Eingaben können aus Text und Bildern bestehen, ausgegeben wird ausschließlich Text – Audio und Video werden nicht unterstützt. Das Kontextfenster umfasst 1.050.000 Token, davon maximal 922.000 als Eingabe und 128.000 als Ausgabe; der Wissensstand reicht bis zum 1. Juni 2026 und liegt damit etwas über dem von Astra (18. Mai 2026). Über die API lässt sich der reasoning effort nicht auf none setzen – die niedrigste verfügbare Stufe ist Low.
Die folgende Tabelle stellt die offiziellen Spezifikationen und Listenpreise von Sol und Astra gegenüber; die Preise gelten für die Standardstufe bei kurzem Kontext, jeweils pro 1 Million Token. Um zu prüfen, welche Modelle auf den Plattformen gelistet sind, haben wir die Gesamtmodelliste von APIYI apiyi.com (Datenstand: 2026-11-17 15:54, UTC+8) sowie die öffentlich zugängliche Preis-Schnittstelle abgeglichen – beide 6.2-Modelle waren dort noch nicht zu finden.
| Position | gpt-6.2-sol | gpt-6.2-astra |
|---|---|---|
| Eingabe / Cache-Lesen / Ausgabe | $2 / $0.10 / $10 | $8 / $0.40 / $40 |
| Cache-Schreiben (30 Minuten / 12 Stunden) | $2.50 / $5 | $10 / $20 |
| Kontextfenster / maximale Ausgabe | 1.050.000 / 128.000 | 1.050.000 / 128.000 |
| Wissensstand | 2026-06-01 | 2026-05-18 |
| Preisänderung | Übernimmt die Listenpreise von GPT-6.1 Sol | Eingabe und Ausgabe 20 % niedriger als bei GPT-6 Astra, Cache-Eingabe 60 % niedriger |
| Verfügbare Plattformen | OpenAI API; bei APIYI apiyi.com noch nicht gelistet | OpenAI API; bei APIYI apiyi.com noch nicht gelistet |
Dies sind die offiziellen Listenpreise von OpenAI. gpt-6.2-sol und gpt-6.2-astra sind bei APIYI derzeit noch nicht gelistet – wir werden diese Modelle so bald wie möglich verfügbar machen; maßgeblich für Modell und Preis ist jeweils die Modelliste auf der Plattform.
Abrechnungsregeln für GPT-6.2 Sol
Auf der Modellseite sind einige Abrechnungsregeln dokumentiert, die für beide Modelle gelten. Die größten Unterschiede auf der Rechnung entstehen genau hier:
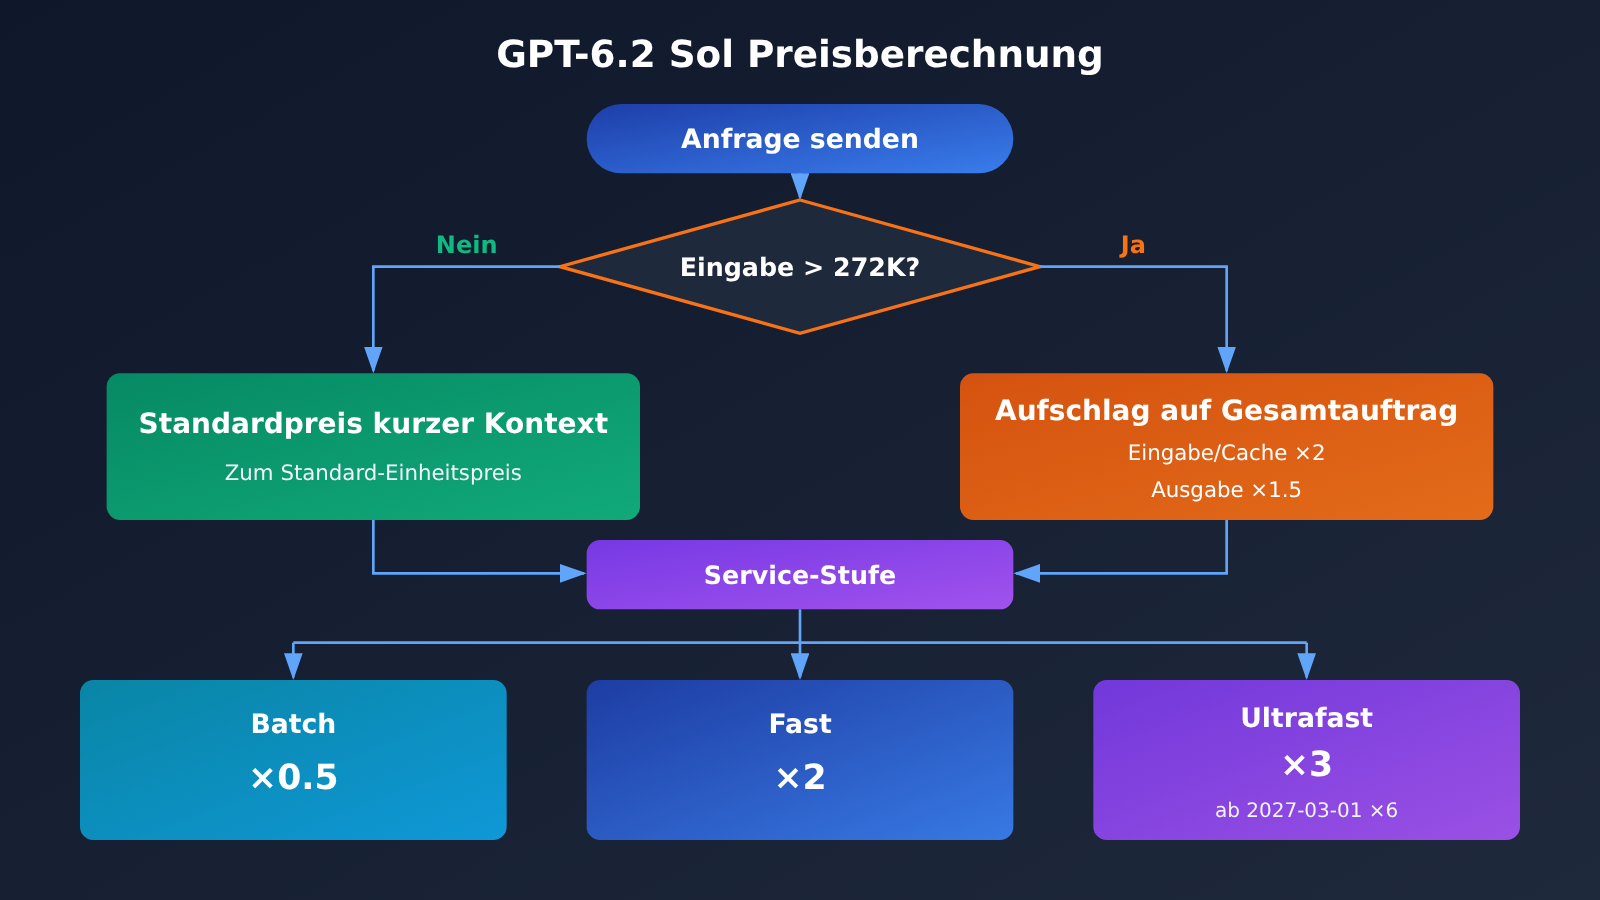
- Aufschlag bei langen Eingaben: Übersteigt die Eingabe einer einzelnen Anfrage 272K Token, verdoppeln sich die Einheitspreise für Eingabe und Cache, und die Ausgabe wird mit dem 1,5-Fachen des Kurzkontext-Preises berechnet. Wichtig: Die gesamte Anfrage wird zu diesen Preisen abgerechnet, nicht nur der übersteigende Teil.
- Batch: 50 % des Standardpreises.
- Fast: das Doppelte des Standardpreises bei gleicher Kontextlänge.
- Ultrafast: bis zum 28. Februar 2027 (Pazifikzeit) das Dreifache des Standardpreises, ab dem 1. März 2027 dann das Sechsfache.
Bezüglich der Endpunkte werden Chat Completions, Responses und Batch unterstützt, während Realtime, Assistants, Fine-Tuning, Bilderzeugung, Video und Sprache nicht unterstützt werden. GPT-6.2 Sol ist also ein Konversations- und Reasoning-Modell mit reiner Textausgabe; die Anbindung erfolgt im Wesentlichen genauso wie beim Vorgängermodell.
GPT-6.2 Sol: Bewertungsdaten für alltägliche Aufgaben
Dieser Abschnitt stützt sich ausschließlich auf offiziell selbst gemeldete Zahlen. In der offiziellen Ankündigung von OpenAI gibt es im Wesentlichen zwei Ergebnisse für Sol bei alltäglichen Aufgaben. Die folgende Tabelle listet sie zusammen mit dem Coding-Ergebnis auf, um den Vergleich zu erleichtern – beachten Sie aber, dass OpenAI alle diese Werte selbst getestet und selbst gemeldet hat.
| Benchmark | Kategorie | GPT-6.2 Sol Ergebnis | Quelle |
|---|---|---|---|
| LifeVal | Alltägliche Aufgaben (offiziell selbst erstellt) | höher als GPT-6 Astra, Kosten etwa ein Siebtel | offizielle Eigenangabe |
| GDPval v2 | Berufliche Arbeitsaufgaben (offiziell intern) | 5,3 Punkte höher als GPT-6.1 Sol | offizielle Eigenangabe |
| FrontierCode 2.0 | Merge-Erfolg bei Änderungen an echten Codebasen | weniger als 0,5 Punkte Unterschied zu GPT-6.2 Astra, Kosten etwa ein Fünftel, beide mit Max | offizielle Eigenangabe |
| AA-3D | Elo aus Blindbewertung durch Menschen | 1259 (Astra 1318, Claude Fable 5.2 1271) | offizielle Weitergabe |
LifeVal ist ein von OpenAI selbst zusammengestellter Datensatz für alltägliche Aufgaben. Laut der Ankündigung schneidet Sol besser ab als GPT-6 Astra – bei etwa einem Siebtel der Kosten. GDPval v2 ist ein offizieller interner Benchmark, bei dem Sol 5,3 Punkte höher liegt als GPT-6.1 Sol. Für beide Tests wurden keine absoluten Punktzahlen veröffentlicht, und dieser Artikel rechnet sie auch nicht hoch.
Diese beiden Ergebnisse zeigen eines: Bei alltäglichen Arbeiten wie E-Mails schreiben, Unterlagen sortieren, Tabellen erstellen oder Dokumente entwerfen liefert GPT-6.2 Sol zum Sol-Preis Ergebnisse, die an die des Vorgänger-Flaggschiffs heranreichen oder es sogar übertreffen. Allerdings passt ein „offiziell selbst erstellter Benchmark“ naturgemäß besser zum eigenen Modell – Leser sollten solche Werte daher eher als Richtungsanzeige verstehen.
Benchmark-Daten zu GPT-6.2 Sol: Coding
Beim Coding ist ein getrennter Blick besonders wichtig, denn die offiziellen Selbstauskünfte und die Werte von Drittanbietern zeigen in unterschiedliche Richtungen. Auch die getesteten Aufgaben unterscheiden sich. Deshalb behandeln wir beide Quellen hier nacheinander, statt daraus ein einziges Urteil zu machen.
Offizielle Selbstauskunft: FrontierCode 2.0
FrontierCode 2.0 wurde von Cognition entwickelt und prüft, ob Änderungen, die ein Modell in echten Codebasen vornimmt, von den Maintainern gemerged werden. Laut offiziellen Angaben liegen GPT-6.2 Sol und GPT-6.2 Astra weniger als 0,5 Punkte auseinander – bei etwa einem Fünftel der Kosten; beim Vergleich nutzten beide die Max-Inferenzstufe. Für Aufgaben wie „in kleinen Schritten Code anpassen und PRs einreichen“ ist das eine gute Nachricht.
Drittanbieter: Coding Agent Index
Der Coding Agent Index von Artificial Analysis verwendet den Codex harness und ebenfalls die Max-Inferenzstufe. Das Ergebnis: Astra liegt gleichauf mit GPT-6 Astra, während GPT-6.2 Sol 3 Punkte hinter GPT-6.1 Sol zurückfällt. Als Hauptgrund nennt der Artikel die Teilwertung SWE-Atlas-QnA-AA, die um 14 Punkte schwächer ausfällt – das Modell übersieht dabei leichter zentrale Fakten.
Legt man beide Ergebnisse nebeneinander, wird das Bild klar: FrontierCode 2.0 misst, ob sich Änderungen einpflegen lassen, während es bei SWE-Atlas-QnA-AA eher darum geht, ob Fragen zur Codebasis vollständig beantwortet werden. GPT-6.2 Sol liegt beim Ersteren nahe an Astra, beim Letzteren aber sogar hinter der eigenen Vorgängergeneration zurück. Wenn Ihr Coding-Agent viele Fragen wie „Wo wird diese Funktion aufgerufen?“ oder „Welche Module sind von dieser Konfiguration betroffen?“ beantworten muss, reicht ein Blick auf FrontierCode allein nicht aus.
GPT-6.2 Sol: Drittanbieter-Gesamtwertung und Halluzinationsrate
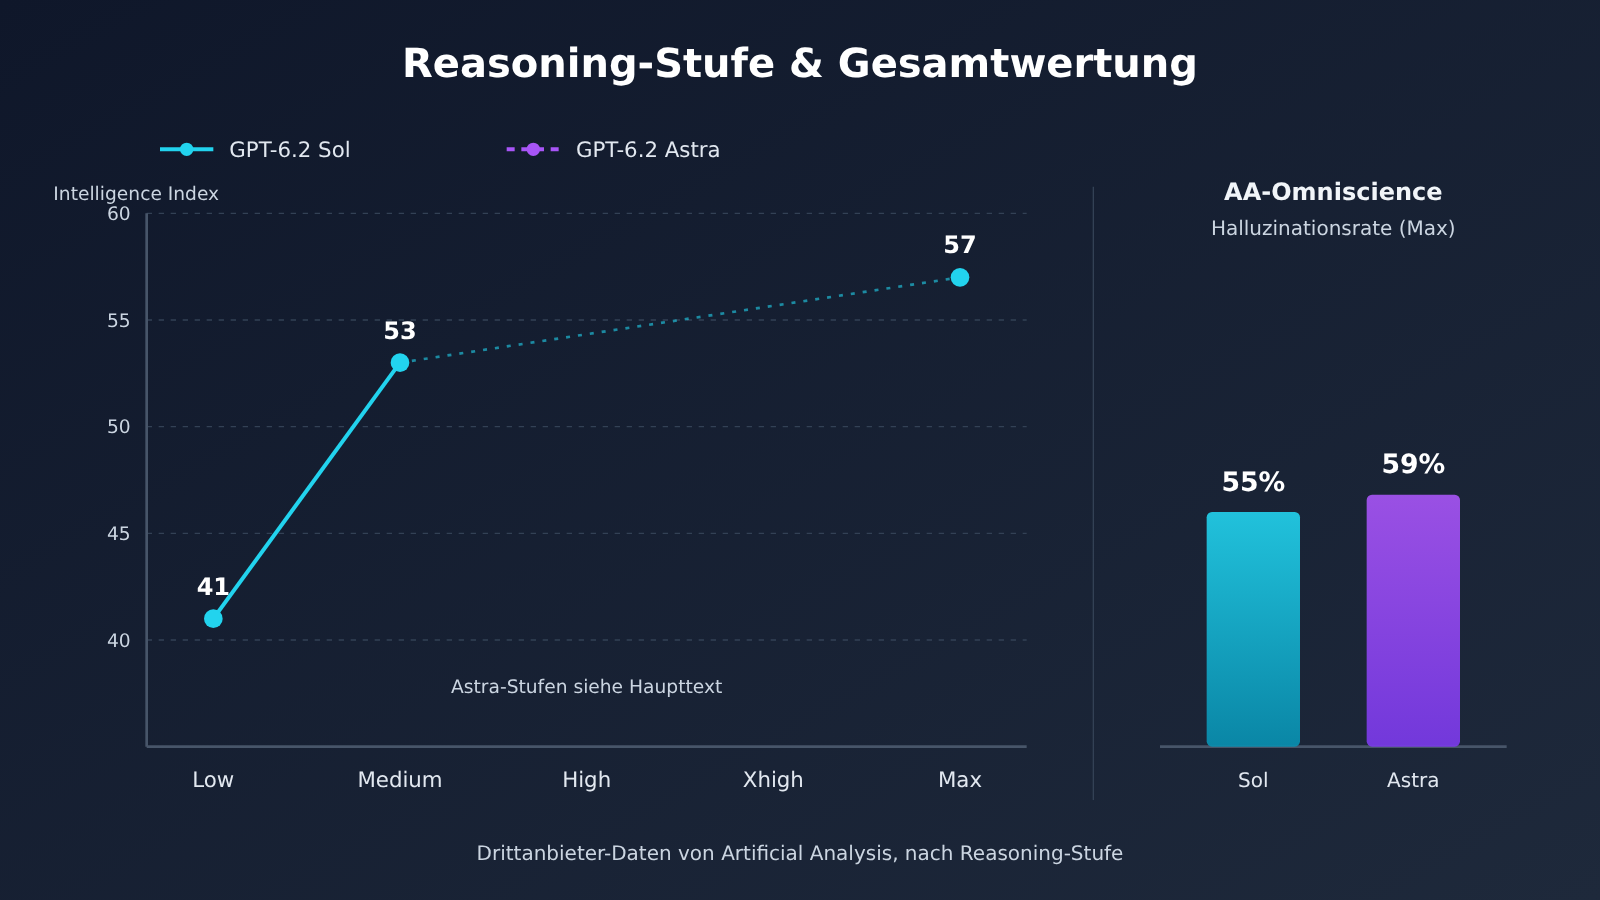
Der Intelligence Index v5.0.1 von Artificial Analysis vergibt seine Punktzahlen getrennt nach Reasoning-Stufe. Sämtliche Zahlen in der folgenden Tabelle stammen von Drittanbietern, und jede Zelle entspricht genau einer Reasoning-Stufe – vergleichen Sie also nicht Sols Max-Wert mit dem Medium-Wert eines anderen Modells.
| Reasoning-Stufe | GPT-6.2 Sol | GPT-6.2 Astra |
|---|---|---|
| Max | 57 | 62 |
| Xhigh | 56 | 62 |
| High | 55 | 60 |
| Medium | 53 | 57 |
| Low | 41 | 46 |
| Kosten pro Einzelaufgabe im Gesamtindex (Max) | $1.01 | $4.00 |
Im selben Artikel belegt Claude Fable 5.2 mit 65 Punkten auf der höchsten Stufe Platz eins, Gemini 4 Carbon erreicht dort 60 Punkte und Claude Opus 5.5 59 Punkte. GPT-6.2 Sol kommt bei Max auf 57 Punkte – zwei Punkte mehr als GPT-6.1 Sol und auf Augenhöhe mit GPT-6 Astra, bei nur rund 15 % der Einzelkosten von GPT-6 Astra pro Aufgabe. Sol ist also nicht in jeder Hinsicht stärker als Astra; seine Stärke liegt darin, „mit geringeren Kosten mit dem Flaggschiff der vorherigen Generation gleichzuziehen“.
Der Leistungsabfall über die Reasoning-Stufen hinweg ist ebenfalls bemerkenswert: Sol verliert von Medium (53) auf Low (41) 12 Punkte, und da die API das Deaktivieren des Reasoning nicht erlaubt, ist Low bereits die unterste Stufe. Wer im Alltag aus Kostengründen standardmäßig auf Low herunterstuft, erhält schlicht nicht mehr das Modell mit den 57 Punkten.
Die Halluzinationsrate von GPT-6.2 Sol
Bei der AA-Omniscience-Halluzinationsrate (Max) liegt GPT-6.2 Sol bei 55 %, Astra bei 59 %. Der Wert von Sol ist zwar etwas niedriger, doch beide liegen über der Hälfte. Das bedeutet: Wenn sich das Modell unsicher ist, neigt es weiterhin stark dazu, Antworten zu liefern, die sicher klingen – und trotzdem falsch sind. In Kombination mit dem oben genannten Ergebnis, dass SWE-Atlas-QnA-AA um 14 Punkte niedriger ausfällt, brauchen faktenempfindliche Frage-Antwort-Aufgaben daher zusätzliche Retrieval- oder Verifikationsschritte.
Sicherheitsklassifizierung und Verfügbarkeit von GPT-6.2 Sol
Nach dem Preparedness-Framework von OpenAI erreichen GPT-6.2 Sol und Astra beide die Stufe „kritisch“ bei Cybersicherheit sowie „hoch” bei Biologie und Chemie. Offiziell wird nur Astra dafür genannt, den hohen Schwellenwert bei „KI-Selbstverbesserung“ zu erreichen – Sol nicht. Dementsprechend sind die Schutzmechanismen strenger geworden: Auch legitime Anfragen zur Schwachstellenforschung können abgelehnt werden. Leser, die im Sicherheitsbereich tätig sind, sollten sich darauf einstellen.
Das auf Verteidiger ausgerichtete Daybreak-Projekt bietet derzeit die Alpha von GPT-6 Astra, GPT-6 Sol auf Daybreak Blue und GPT-6 Cyber auf Daybreak Red. Offiziell heißt es, man arbeite daran, Version 6.2 ebenfalls in Daybreak anzubieten – aktuell ist das aber noch nicht der Fall. Beim Alignment liegen die meisten Bewertungen nahe an GPT-6 Astra, mit weniger unangemessenen Handlungen in simulierten Arbeitssituationen. Allerdings zeigen zwei Tests, dass blockierende Probleme wie fehlende Dateien oder nicht verfügbare Suchtools leichter übersehen werden. Nach ergänzenden Anweisungen in Codex nehmen solche Auslassungen deutlich ab.
Zur Verfügbarkeit: Plus-, Pro-, Enterprise- und Edu-Kunden können beide Modelle ab sofort in ChatGPT Work und Codex nutzen. Pro 500 kann Ultrafast für beide Modelle aktivieren, Pro 200 erhält erstmals Ultrafast – zunächst mit GPT-6.2 Sol. Bei berechtigten Enterprise- und Edu-Konten muss die Workspace-Administration Ultrafast einschalten. Entwickler greifen über die OpenAI API zu; beide Modelle unterstützen Ultrafast ab Veröffentlichung.
Vor- und Nachteile von GPT-6.2 Sol
Stärken
- Gutes Preis-Leistungs-Verhältnis im Alltag: Laut offiziellen Eigenangaben liegt LifeVal über dem von GPT-6 Astra – bei etwa einem Siebtel der Kosten. Bei GDPval v2 liegt das Modell 5,3 Punkte über GPT-6.1 Sol.
- Preise bleiben stabil: Der Listenpreis entspricht dem von GPT-6.1 Sol, das Upgrade verteuert den Stückpreis nicht.
- Code-Merging nah an Astra: Offiziellen Angaben zufolge liegt FrontierCode 2.0 weniger als 0,5 Punkte hinter Astra – bei rund einem Fünftel der Kosten.
- Gesamtwert auf Niveau des Vorgänger-Flaggschiffs: Im unabhängigen Benchmark Max erreicht das Modell 57 Punkte, gleichauf mit GPT-6 Astra – bei etwa 15 % der Kosten, die GPT-6 Astra pro Aufgabe verursacht.
Einschränkungen
- Rückschritt bei Coding-Agenten: Im unabhängigen Coding Agent Index liegt das Modell 3 Punkte unter GPT-6.1 Sol, bei SWE-Atlas-QnA-AA sogar 14 Punkte darunter. Lösungsansatz: Frage-Antwort-Systeme für Codebasen um Retrieval und Gegenprüfung erweitern.
- Erhöhte Halluzinationsrate: Bei AA-Omniscience liegt die Halluzinationsrate bei 55 % – faktenkritische Aufgaben sollten daher Quellenangaben oder eine manuelle Prüfung vorsehen.
- Deutliche Einbußen in der niedrigen Inferenzstufe: Die Stufe „Low“ erreicht nur 41, und die Inferenz lässt sich nicht deaktivieren – wer die Kosten drücken will, muss hier abwägen.
- Strengere Sicherheitsfilter: Einige legitime Schwachstellenforschungen werden abgelehnt; für Daybreak liegen derzeit keine 6.2-Ergebnisse vor.
GPT-6.2 Sol: Schneller Einstieg
Die Anbindung von GPT-6.2 Sol erfolgt genauso wie beim Vorgängermodell: Sowohl über Chat Completions als auch über Responses ist es erreichbar, als Modellnamen tragen Sie gpt-6.2-sol ein, und bei der Reasoning-Stufe wählen Sie eine Stufe von Low bis Max — übergeben Sie niemals none. Wenn Sie bereits eine OpenAI-kompatible Schnittstelle nutzen, ist der Modellwechsel meist nur eine Frage eines einzigen Parameters.
Sobald es auf APIYI gelistet ist, setzen Sie die base_url des OpenAI SDK auf https://api.apiyi.com/v1, hinterlegen Sie Ihren APIYI-Schlüssel und ändern Sie model auf gpt-6.2-sol — maßgeblich für den Modellnamen ist die Modellliste der Plattform. Für das bereits gelistete gpt-6.1-sol gelten bis dahin Preise von $2 für Eingaben, $10 für Ausgaben und $0,1 für Cache-Lesezugriffe; bei Eingaben über 272.000 liegt der Eingabepreis bei $4. Damit lässt sich der Workflow schon jetzt aufbauen, aber es ist nicht 6.2, und diese Preise dürfen nicht als 6.2-Preise verstanden werden.
Die Modellauswahl lässt sich nach Aufgabentyp aufschlüsseln. Die folgende Tabelle zeigt empfohlene Herangehensweisen; die Grundlagen stammen ausnahmslos aus den weiter oben genannten öffentlichen Daten:
| Aufgabenszenario | Empfehlung | Grundlage |
|---|---|---|
| Alltägliche Aufgaben wie Schreiben, Ordnen und Büroarbeit | GPT-6.2 Sol vorerst als Standard in Betracht ziehen | Offiziell selbst berichtete LifeVal- und GDPval-v2-Werte |
| Kleine Code-Änderungen, Einreichen von PRs | GPT-6.2 Sol ist geeignet, bei Kostenbewusstsein erste Wahl | Offiziell selbst berichtete FrontierCode-2.0-Werte |
| Codebase-Fragen, Coding-Agenten mit langen Ablaufketten | Nicht nur auf den Gesamtwert schauen, sondern zuerst im eigenen Repository vergleichen | Coding Agent Index von Drittanbietern: 3 Punkte niedriger |
| Q&A, bei denen ein übersehener Fakt teuer zu stehen kommt | Retrieval und Verifikation ergänzen, nötigenfalls mehrere Modelle kreuzprüfen | Halluzinationsrate von Drittanbietern: 55 % |
| Sehr lange Eingaben (über 272K) | Zuerst die Kosten nach dem Aufschlag auf die Gesamtabrechnung abschätzen | Preisregeln auf der offiziellen Modellseite |
🚀 Einstiegsempfehlung: Für den Alltag können Sie zunächst GPT-6.2 Sol als Standard in Betracht ziehen, aber bei Q&A-Aufgaben, bei denen fehlende Fakten teuer zu stehen kommen, sollten Sie nicht nur auf den Gesamtwert schauen. Auf APIYI unter apiyi.com können Sie mit demselben API-Schlüssel die gelisteten Modelle wie
gpt-6.1-sol,claude-opus-5-5undgemini-4-carbonvergleichen — führen Sie zuerst eine Runde mit Ihren eigenen Aufgaben durch und binden Sie 6.2 nach dessen Listung als Vergleichsmodell ein.
Häufige Fragen (FAQ)
Q1: Welche Positionierung hat GPT-6.2 Sol?
GPT-6.2 Sol ist das günstigere Modell der 6.2-Serie, die OpenAI am 17. November 2026 veröffentlicht hat. Die Modell-ID lautet `gpt-6.2-sol`; es verarbeitet Text- und Bildeingaben und gibt Text aus, bietet ein Kontextfenster von 1.050.000 Token und einen Wissensstand bis zum 1. Juni 2026. Es positioniert sich als Universalmodell mit gutem Preis-Leistungs-Verhältnis und erschien zeitgleich mit dem teureren GPT-6.2 Astra.
Q2: Wo ist GPT-6.2 Sol im Vergleich zu GPT-6.1 Sol stärker, wo schwächer?
Die Listenpreise sind identisch. Laut offiziellen Selbstangaben liegt der GDPval-v2-Wert 5,3 Punkte höher; im Intelligence Index eines Drittanbieters liegt das Modell in der Max-Stufe 2 Punkte höher, nämlich bei 57. Beim Coding Agent Index von Drittanbietern fällt es dagegen 3 Punkte niedriger aus – Hauptgrund ist SWE-Atlas-QnA-AA mit 14 Punkten weniger, wodurch wichtige Fakten leichter übersehen werden. Bei alltäglichen Aufgaben macht das Modell Fortschritte, beim Codebase-Q&A in Coding-Agenten geht es dagegen zurück.
Q3: Ist GPT-6.2 Sol besser als GPT-6.2 Astra?
So pauschal lässt sich das nicht sagen. Bei den Gesamtwertungen von Drittanbietern liegt Astra in jeder Reasoning-Stufe vorn; in der Max-Stufe lautet das Ergebnis 62 zu 57. Die Stärke von Sol sind die Kosten: Laut offiziellen Angaben liegt FrontierCode 2.0 weniger als 0,5 Punkte von Astra entfernt, bei rund einem Fünftel der Kosten; die Kosten pro Aufgabe nach Drittanbieter-Messung betragen $1,01 gegenüber $4,00.
Q4: Wie hoch sind die offiziellen Preise für GPT-6.2 Sol?
Die offiziellen OpenAI-Standardpreise für kurze Kontexte liegen bei $2 für die Eingabe, $0,10 für das Lesen aus dem Cache, $2,50 für das Schreiben in den 30-Minuten-Cache und $10 für die Ausgabe (jeweils pro 1 Million Token); ab über 272K Eingabe-Tokens erhöht sich der Gesamtpreis. APIYI: Das Modell ist noch nicht gelistet – wir werden es so schnell wie möglich verfügbar machen. Modellname und Preise richten sich nach der Modellliste der Plattform.
Q5: Wie lässt sich vor dem Listing der 6.2-Modelle schon jetzt ein Vergleichstest über die API aufbauen?
Sie können den Workflow bereits mit den gelisteten Modellen aufsetzen:
1. Registrieren Sie sich auf APIYI (apiyi.com) und holen Sie sich einen API-Schlüssel sowie kostenloses Testguthaben
2. Rufen Sie gelistete Modelle wie `gpt-6.1-sol` und `gpt-6-astra` über die OpenAI-kompatible Schnittstelle auf
3. Sobald 6.2 gelistet ist, ändern Sie für den A/B-Vergleich nur den Parameter `model`
Beachten Sie: Weder `gpt-6-sol` noch `gpt-6.1-sol` sind 6.2-Modelle, und ihre Preise lassen sich auch nicht gegenseitig ersetzen.
Q6: Gemini 4 Carbon kostet genauso viel wie Sol – wie wählt man richtig?
Die offiziellen Standardpreise für Gemini 4 Carbon gelten bis zum 30. November 2026: $2 für die Eingabe und $10 für die Ausgabe; ab dem 1. Dezember 2026 werden daraus $4 / $20. Der Drittanbieter-Gesamtwert liegt in der höchsten Stufe bei 60 Punkten. `gemini-4-carbon` auf APIYI (apiyi.com) ist derzeit zum Einführungspreis gelistet; nach dem 1. Dezember gilt die Plattformliste als maßgeblich. Das Modell unterstützt Video- und Audioeingaben, bietet aber keinen Responses-Endpunkt – bei der Auswahl entscheiden daher Eingabetyp und Schnittstelle.
Q7: Kann man GPT-6.2 Sol für Vulnerability Research einsetzen?
Es erreicht bei der Cybersicherheit die Stufe „kritisch“ – der Schutz ist strenger, und einige legitime Anfragen zur Schwachstellenforschung werden abgelehnt. Daybreak, das sich an die Verteidigerseite richtet, ist derzeit noch nicht in Version 6.2 verfügbar; offiziell heißt es nur, man arbeite an einer Einführung.
GPT-6.2 Sol: Die wichtigsten Punkte (Key Takeaways)
- Deutliche Fortschritte bei alltäglichen Aufgaben: Offiziellen Eigenangaben zufolge liegt LifeVal über GPT-6 Astra – bei rund einem Siebtel der Kosten.
- Unveränderte Preise: Der Listenpreis entspricht GPT-6.1 Sol – Eingabe $2, Ausgabe $10.
- Beim Code-Merging nahe an Astra: Offiziellen Angaben zufolge beträgt der Abstand bei FrontierCode 2.0 weniger als 0,5 Punkte.
- Gesamtwertung durch Drittanbieter: Max 57, Xhigh 56, High 55, Medium 53, Low 41.
- Rückschritt bei Coding-Agenten: Der Coding Agent Index von Drittanbietern liegt 3 Punkte unter 6.1 Sol; dabei gehen leicht Fakten verloren.
- Halluzinationsrate von 55 %: Bei faktsensiblen Frage-Antwort-Aufgaben sind Retrieval und Überprüfung unverzichtbar.
- Einstieg: Bis die 6.2 verfügbar ist, lässt sich über APIYI (apiyi.com) mit den bereits gelisteten Modellen ein Vergleichs-Workflow aufbauen.
Zusammenfassung
Die wichtigsten Punkte zu GPT-6.2 Sol:
- Alltägliche Aufgaben: Die offiziell selbst berichteten Benchmarks LifeVal und GDPval v2 zeigen Fortschritte – zum Preis von Sol erhält man eine Alltagsleistung, die nahe an das Flaggschiff der vorherigen Generation heranreicht.
- Codierung differenziert betrachten: Der offiziell selbst berichtete FrontierCode 2.0 liegt nahe an Astra, doch der Coding Agent Index von Drittanbietern liegt 3 Punkte unter GPT-6.1 Sol – und bei Fragen zur Codebase gehen Fakten leichter verloren.
- Der Gesamtscore ist nicht alles: Der Drittanbieter-Score von 57 (Max) zieht mit GPT-6 Astra gleich, aber eine Halluzinationsrate von 55 % und 41 Punkte in der Low-Stufe mahnen, nicht nur auf eine einzige Zahl zu schauen.
Wenn Ihr Arbeitsalltag überwiegend aus Schreiben, Strukturieren und Bürotätigkeiten besteht, lohnt es sich, GPT-6.2 Sol zunächst als Standardmodell in Betracht zu ziehen. Wenn Sie sich beim Beantworten von Fragen zur Codebase auf Coding-Agenten verlassen oder ein einzelnes übersehenes Fakt Nacharbeit bedeutet, empfehlen wir, zuerst Vergleichstests mit Ihren eigenen Aufgaben durchzuführen. Wir raten dazu, über APIYI (apiyi.com) mit demselben API-Schlüssel die gelisteten Modelle zu vergleichen und nach dem Listing von 6.2 umzuschalten und zu verifizieren.
📚 Referenzen
-
OpenAI-Ankündigung: Offizielle Vorstellung und selbst berichtete Benchmarks von GPT-6.2 Astra und Sol
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol - Hinweis: Quelle der offiziell selbst berichteten Ergebnisse wie LifeVal, FrontierCode 2.0 und GDPval v2
- Link:
-
OpenAI-Modellseite: Spezifikationen und Listenpreis von gpt-6.2-sol
- Link:
platform.openai.com/docs/models/gpt-6.2-sol - Hinweis: Kontextfenster, Wissens-Cutoff, der 272K-Zuschlag auf Gesamtaufträge sowie die Regeln für Batch, Fast und Ultrafast
- Link:
-
OpenAI-Systemkarte: Sicherheitsklassifizierung und Alignment-Bewertung
- Link:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Hinweis: Einstufung „kritisch“ für Cybersicherheit, „hoch“ für Biochemie sowie Erläuterungen zu den Schutzmaßnahmen
- Link:
-
Artificial-Analysis-Bewertungsartikel: Gesamtscore von Drittanbietern und Coding-Agent-Index
- Link:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Hinweis: Intelligence Index je Inferenzstufe, Coding Agent Index und Halluzinationsrate
- Link:
-
Artificial-Analysis-Modellseite: Einzelkosten pro Aufgabe für GPT-6.2 Sol
- Link:
artificialanalysis.ai/models/gpt-6-2-sol - Hinweis: Drittanbieter-Daten wie die Kosten pro Einzelaufgabe im Gesamtindex
- Link:
-
APIYI-Modellübersicht: Auf der Plattform verfügbare Modelle und Preise
- Link:
docs.apiyi.com/models.md - Hinweis: Hier prüfen Sie, ob 6.2 bereits gelistet ist, und sehen die Listenpreise der verfügbaren Modelle
- Link:
Autor: APIYI-Technikteam
Technischer Austausch: Besuchen Sie uns gerne auf der Startseite der APIYI-Website. Weitere Materialien finden Sie im Dokumentationszentrum unter docs.apiyi.com


