
Nota del autor: ¿qué indicadores de fiabilidad conviene revisar al elegir un servicio proxy o de agregación de API de IA para producción? Aquí encontrarás 10 indicadores clave, un proceso de validación de 7 días y una tabla de evaluación.
Muchos equipos empiezan a usar un servicio proxy o de agregación de API de IA porque «funciona y es barato». Los problemas aparecen cuando llega a producción: aumentan los errores 429 en horas pico, la salida en streaming se interrumpe, los tokens facturados no coinciden con los registros propios o el comportamiento del modelo cambia de un día para otro. En este artículo reunimos los 10 indicadores de fiabilidad que debes revisar al elegir un servicio proxy o de agregación de API de IA para producción, junto con un proceso de validación de 7 días.
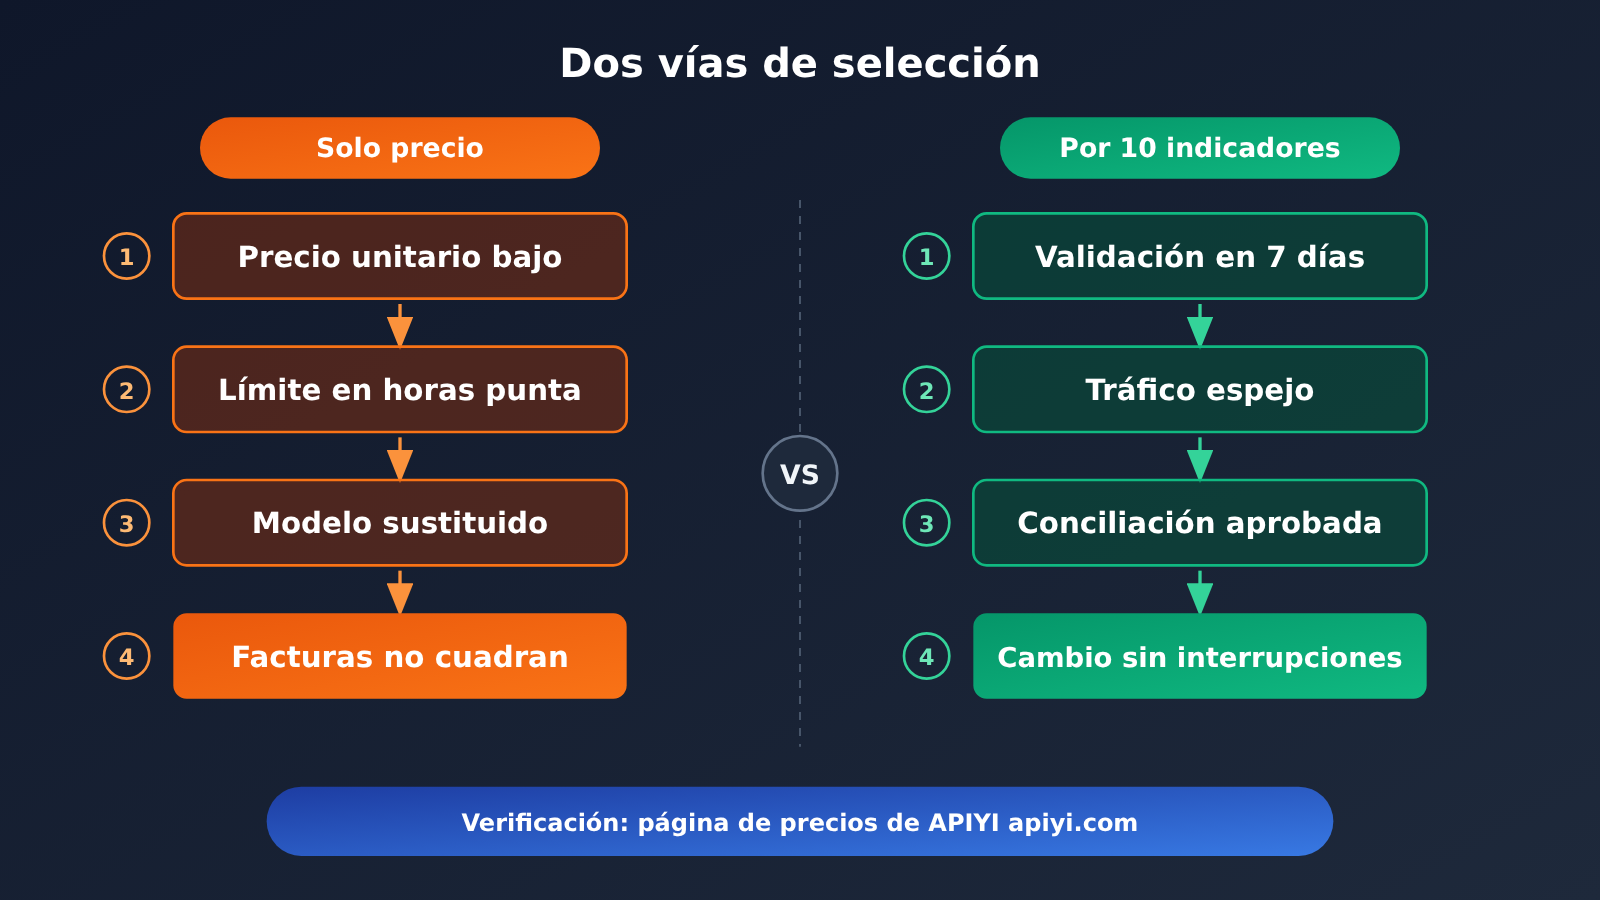
Este no es otro artículo para comparar precios y elegir la opción más barata. Nos centramos en una sola pregunta: ¿puede un servicio proxy o de agregación de API de IA soportar tu tráfico en producción y, cuando surgen problemas, permite detectarlos, explicarlos y obtener una compensación?
Qué te llevarás: una lista de comprobación práctica para evaluar la fiabilidad de un servicio proxy de API de IA y decidir, con datos, si una plataforma es adecuada para producción antes de firmar un contrato o redirigir el tráfico.
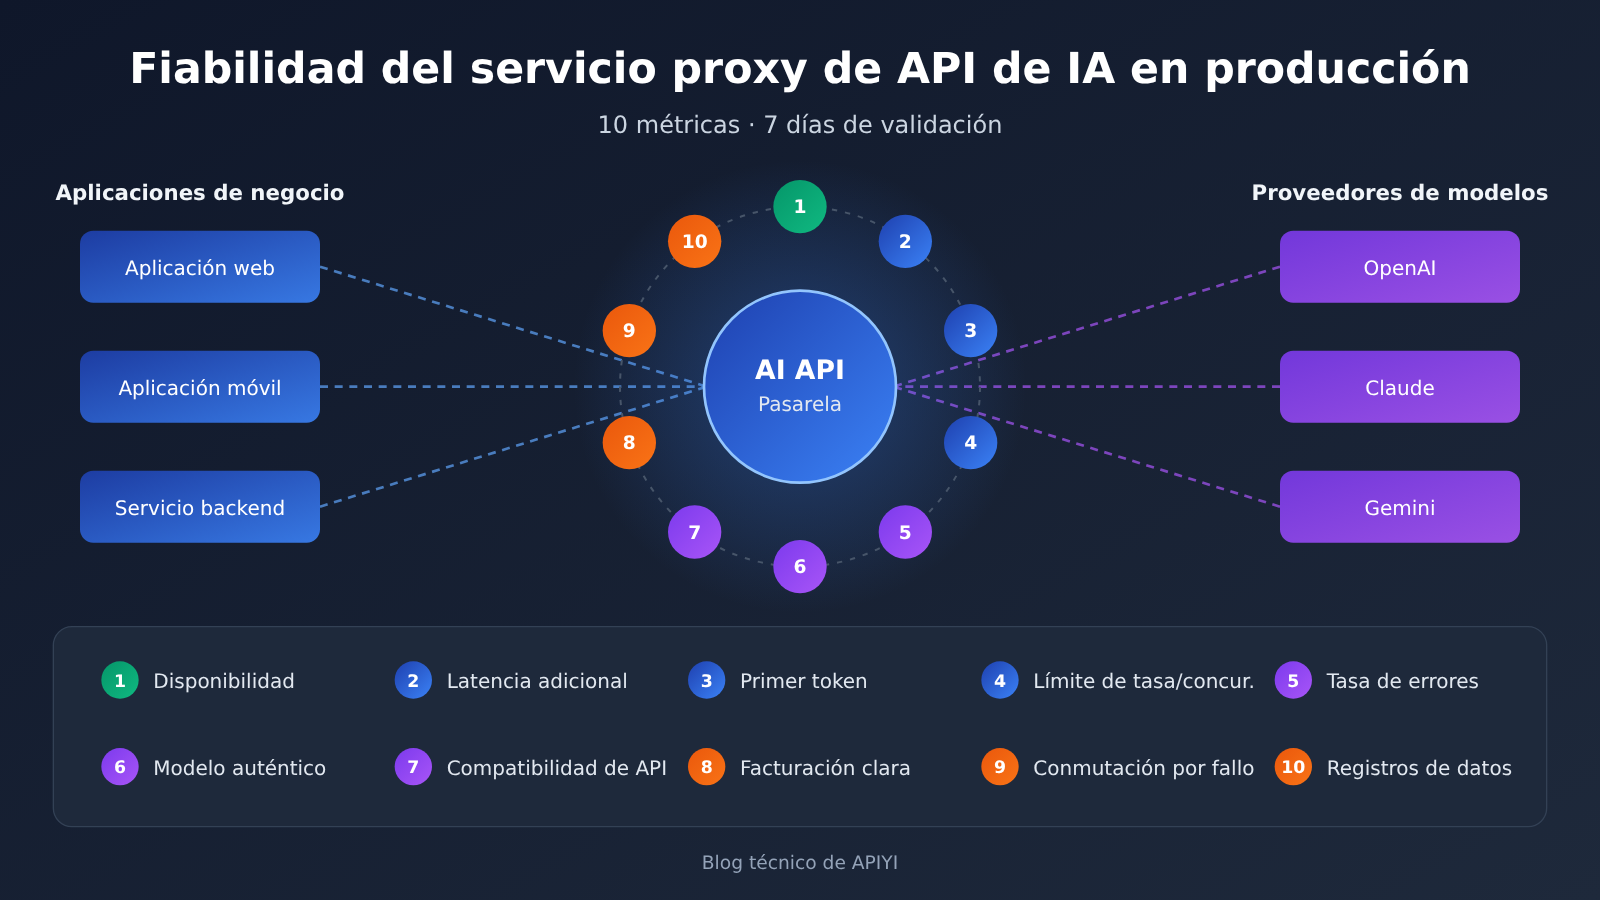
Aspectos clave de la fiabilidad de un servicio proxy y agregador de API de IA en producción
Antes de evaluar un servicio proxy y agregador de API de IA, conviene distinguir los distintos niveles de métricas. La fiabilidad no se limita a si el servicio está disponible: también incluye si la latencia es predecible, si los resultados son confiables y si se puede verificar la facturación. La siguiente tabla agrupa 10 métricas en cuatro categorías para facilitar el reparto de la evaluación.
| Categoría | Métricas principales | Qué revisar | Impacto en producción |
|---|---|---|---|
| Disponibilidad | Historial de incidentes, página de estado, compromisos de SLA | Frecuencia de incidentes, tiempo de recuperación y publicación de análisis posteriores | Determina si el servicio puede mantenerse en línea |
| Rendimiento | Latencia adicional, tiempo hasta el primer token, límites de tasa y concurrencia | Sobrecarga de la capa proxy y comportamiento en horas pico | Afecta directamente a la experiencia del usuario y a la tasa de tiempos de espera agotados |
| Consistencia | Autenticidad de la versión del modelo, compatibilidad de la interfaz, transparencia de los códigos de error | Si se sustituye el modelo y si la transmisión en tiempo real y las llamadas a herramientas funcionan de forma completa | Determina la calidad de los resultados y la estabilidad del código |
| Gobernanza | Transparencia de facturación, conmutación por error, políticas de datos y registros | Facturación verificable, redundancia entre proveedores y cumplimiento de privacidad | Determina si se puede usar el servicio con tranquilidad a largo plazo |
Métricas de disponibilidad de un servicio proxy de API de IA
La disponibilidad es el primer requisito al elegir un servicio proxy de API de IA para producción. No te fijes solo en el porcentaje que anuncia la plataforma: comprueba también si tiene una página de estado pública, si puedes consultar el historial de incidentes y si publica un análisis de cada uno. Una plataforma que comparte la cronología de sus incidentes suele inspirar más confianza que otra que solo promete «alta disponibilidad».
Las fuentes de terceros pueden servirte como referencia. Por ejemplo, el blog de Ofox.ai señala en una evaluación de OpenRouter para producción que la plataforma registró tres incidentes entre 2025 y 2026 y que añade aproximadamente entre 25 y 40 ms de latencia (fuente: Ofox.ai Blog, citado solo como referencia). El valor de estos datos no está en juzgar a una plataforma concreta, sino en recordar que cualquier capa proxy puede sufrir incidentes y añadir sobrecarga. Lo importante es si su magnitud es aceptable y si se comunica con transparencia.
Rendimiento y consistencia de un servicio agregador de API de IA
En cuanto al rendimiento, conviene dividir la latencia adicional de la capa proxy en dos partes: la sobrecarga fija de red y autenticación, y la sobrecarga variable causada por las colas en horas pico. La primera suele ser estable y medible; la segunda es la principal fuente de incidentes en producción. Por eso, haz las pruebas durante las horas de mayor actividad de tu propia aplicación, en lugar de sacar conclusiones tras una sola prueba de rendimiento de madrugada.
En cuanto a la consistencia, el riesgo más difícil de detectar es que se «sustituya» el modelo. Algunas plataformas pueden dirigir las solicitudes a un modelo más económico o a una versión cuantizada cuando escasea la capacidad del proveedor. La interfaz sigue devolviendo 200, pero la calidad de los resultados cae de forma notable. Comprueba que el campo model de la respuesta coincida con el de la solicitud y ejecuta periódicamente pruebas de regresión con un conjunto fijo de preguntas para detectar cambios bruscos en el estilo o la precisión de las respuestas.
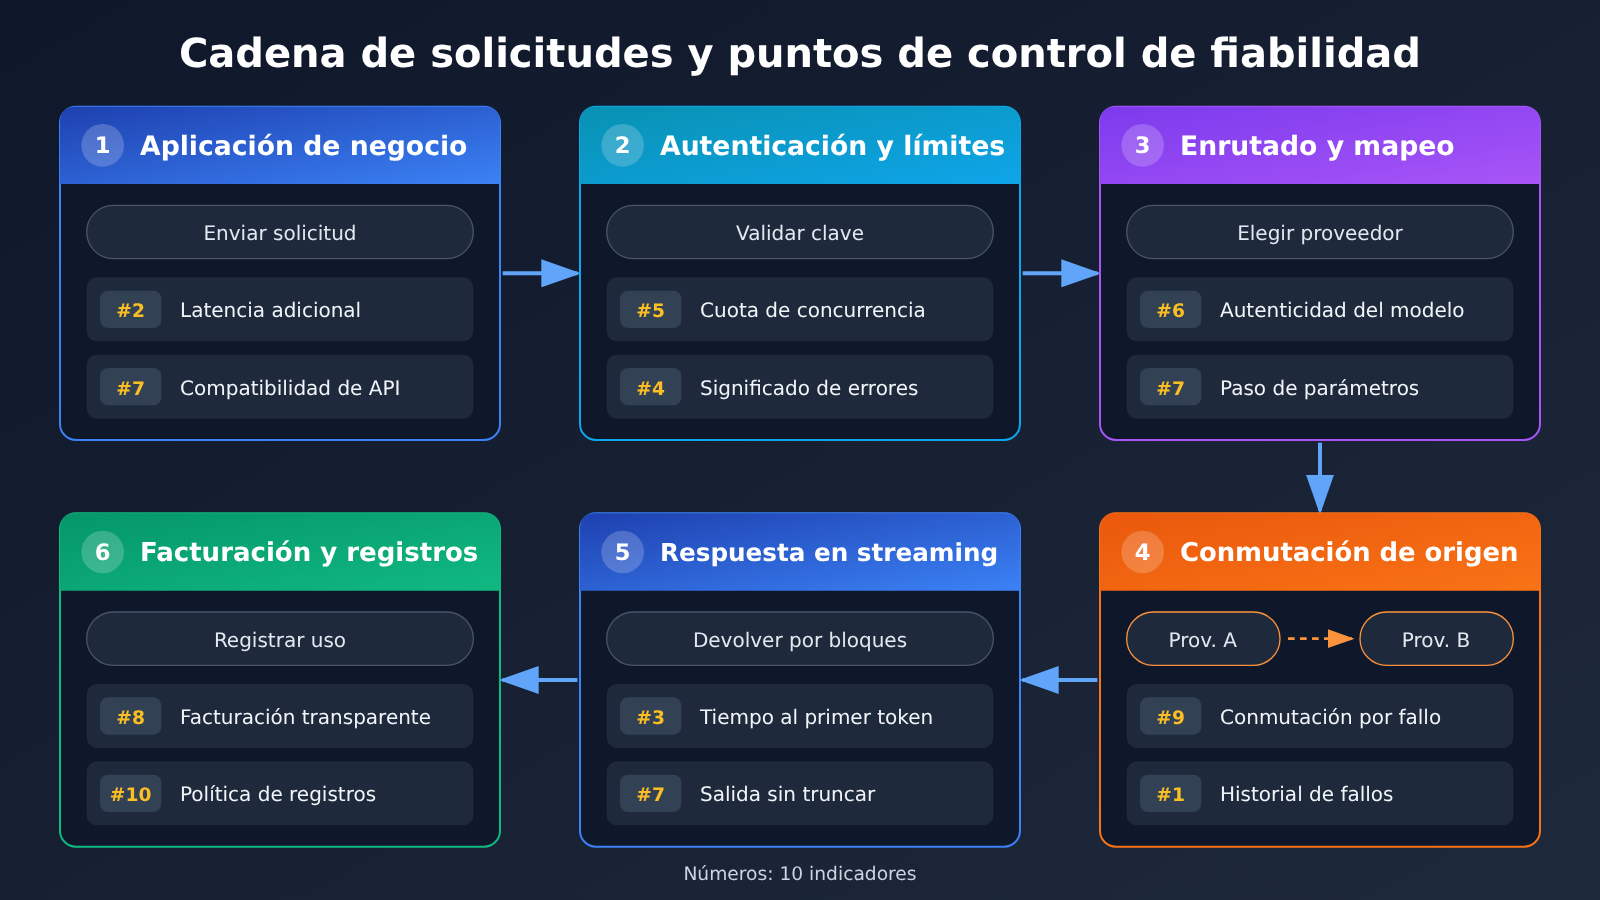
Revisión de 10 indicadores de fiabilidad para un servicio proxy de API de IA en producción
La siguiente tabla es la lista de comprobación central de este artículo. Cada punto incluye un método de verificación y un criterio recomendado. Puedes copiarla directamente en un documento de evaluación interna. Los criterios son orientativos: ajústalos según la tolerancia al riesgo de tu negocio.
| N.º | Indicador de fiabilidad | Método de verificación | Criterio recomendado |
|---|---|---|---|
| 1 | Historial de fallos y página de estado | Consulta la página de estado pública y los análisis de incidentes | Hay una página de estado y análisis de los fallos importantes |
| 2 | Latencia adicional | Compara la misma solicitud con conexión directa y a través del proxy | La sobrecarga fija es estable y no hay un deterioro notable en horas pico |
| 3 | Tiempo hasta el primer token | Registra el tiempo de llegada del primer paquete en solicitudes de streaming | Los percentiles son estables y la latencia de cola larga tiene una explicación |
| 4 | Tasa y códigos de error | Analiza la distribución de errores 4xx y 5xx | Los códigos tienen un significado claro y permiten distinguir problemas del proveedor de origen de los de la plataforma |
| 5 | Límites de frecuencia y cuotas de concurrencia | Aumenta la carga por etapas y observa cuándo aparecen errores 429 | Las cuotas son claras y se puede solicitar un aumento |
| 6 | Autenticidad de la versión del modelo | Comprueba el campo model y realiza pruebas de regresión con un conjunto fijo de preguntas | El modelo devuelto coincide con el solicitado y no hay desviaciones anómalas en las respuestas |
| 7 | Compatibilidad de la interfaz | Prueba el streaming, la llamada a herramientas, las funciones multimodales y la caché | Los parámetros habituales se transmiten íntegramente, sin descartarlos silenciosamente |
| 8 | Transparencia de la facturación | Compara tus estadísticas de tokens con la factura de la plataforma | Las diferencias son explicables y los criterios de facturación de la caché son públicos |
| 9 | Capacidad de conmutación por error | Revisa la estrategia de redundancia de los proveedores de origen y el mecanismo de conmutación | El fallo de un solo proveedor de origen no deja todo el servicio fuera de funcionamiento |
| 10 | Política de datos y registros | Lee las condiciones de privacidad y las explicaciones sobre retención de registros | Se especifica qué se conserva, durante cuánto tiempo y si se puede desactivar la retención |
Por qué la transparencia de facturación de un proxy de API de IA es un indicador de fiabilidad
Muchos consideran la facturación una cuestión de costos, pero en producción la falta de transparencia es, por sí sola, un riesgo para la fiabilidad. Un aumento repentino de la factura suele indicar que la caché no está funcionando, que han cambiado las reglas de conteo de tokens o que el cliente está realizando reintentos anómalos. Todos son problemas a nivel de sistema. El blog de Ofox.ai informó que Anthropic había confirmado límites de tasa en horas pico y dos errores de caché que podían multiplicar por 10 o 20 la factura de tokens (fuente: Ofox.ai Blog, citado solo como referencia). Esto demuestra que, incluso en los canales oficiales, conviene revisar la facturación por tu cuenta.
La misma fuente también menciona que algunas plataformas de agregación cobran comisiones por recarga, como el 5.5% de comisión sobre créditos de OpenRouter (fuente: Ofox.ai Blog, citado solo como referencia). Al evaluar un servicio proxy de API, conviene incluir las comisiones, el tipo de cambio, la recarga mínima y el precio de la caché en el cálculo del «precio unitario real», en lugar de fijarse solo en los precios de entrada y salida publicados.
Qué revisar en la compatibilidad de interfaces de un servicio de agregación de API de IA
Los problemas de compatibilidad no suelen aparecer en la fase de Hello World. Los escenarios que realmente pueden causar problemas son estos: el proxy corta una respuesta en streaming a mitad de camino, modifica la estructura de los parámetros de una llamada a herramientas, limita el tamaño de las imágenes de entrada o descarta sin avisar los campos de control de caché del formato de Anthropic. Te recomendamos enumerar todos los parámetros que usa tu aplicación y comprobarlos uno por uno mediante pruebas de regresión con solicitudes reales.
Si tu sistema usa tanto el formato de interfaz de OpenAI como el de Anthropic, comprueba especialmente que el servicio proxy de API admita ambos de forma nativa, en lugar de convertir las solicitudes de Anthropic al formato de OpenAI y luego de vuelta al original. Cuantas más conversiones de formato haya, mayor será la probabilidad de perder campos o encontrar comportamientos inconsistentes.
Guía rápida para usar un servicio proxy de API de IA en producción: validación en 7 días
Ya tienes la lista de comprobación; ahora toca validar. Recomendamos hacer una prueba con poco tráfico durante 7 días: así podrás cubrir tanto las horas pico de los días laborables como los patrones de tráfico del fin de semana. No necesitas herramientas complejas; basta con los registros y una hoja de cálculo.
| Fase | Tiempo | Acciones principales | Entregable |
|---|---|---|---|
| Preparación | Día 1 | Identificar los modelos, parámetros y QPS máximo que usa la aplicación; preparar un conjunto fijo de pruebas de regresión | Lista de parámetros y conjunto de pruebas |
| Regresión funcional | Día 2 | Probar uno por uno el streaming, las llamadas a herramientas, las funciones multimodales y los campos de caché | Lista de comprobación de compatibilidad |
| Prueba de carga | Día 3 | Aumentar la carga gradualmente hasta 1,5 veces el pico y registrar cuándo aparecen errores 429 y 5xx | Curvas de concurrencia y límites de tasa |
| Tráfico espejo | Días 4-6 | Copiar una pequeña parte de las solicitudes reales al servicio proxy de API y comparar con el flujo actual | Informe de latencia, tasa de errores y diferencias en las respuestas |
| Conciliación y revisión | Día 7 | Comparar el conteo propio de tokens con la factura de la plataforma y recopilar las 10 métricas | Conclusión de la evaluación y plan de migración |
Puntos clave para configurar el acceso a un servicio proxy de API de IA
Al integrar el servicio, procura cambiar solo la configuración, no el código. Si tu proyecto usa el SDK oficial de OpenAI, normalmente basta con cambiar el base_url por la dirección del servicio proxy de API y sustituir la api_key. Por ejemplo, con APIYI puedes configurar el base_url compatible con OpenAI como https://api.apiyi.com/v1 y usar como nombre de modelo el ID que aparece en la página de precios.
Si usas el SDK de Anthropic o herramientas como Claude Code, basadas en el formato de Anthropic, confirma que la plataforma ofrezca acceso en el formato nativo de Anthropic y configura la dirección base y las variables de entorno de la clave según la documentación. APIYI es compatible tanto con el formato de OpenAI como con el de Anthropic. Consulta las direcciones y los parámetros vigentes en docs.apiyi.com para evitar copiar direcciones antiguas de tutoriales de terceros.
Al integrar el servicio, conviene hacer también estas tres cosas:
- Configurar por separado los tiempos de espera y los reintentos: establece un tiempo de espera corto para la conexión y uno más largo para la lectura, según el modelo y la longitud de la respuesta. Reintenta solo ante errores 429 y 5xx, con una espera exponencial entre intentos.
- Registrar los campos clave: guarda el ID de solicitud, el nombre del modelo, los tokens de entrada y salida, el tiempo transcurrido y el código de estado de cada solicitud. Son la base para conciliar los cargos y resolver problemas.
- Mantener una vía de respaldo: conserva al menos una alternativa, ya sea otro servicio proxy de API o una conexión directa al proveedor oficial, y usa un ajuste de configuración para cambiar entre ellas.
🚀 Para empezar rápido: si quieres probar primero el proceso de 7 días descrito arriba con poco tráfico, puedes registrarte en APIYI apiyi.com y obtener crédito de prueba. La plataforma ofrece una interfaz API unificada, compatible con los formatos de OpenAI y Anthropic. Basta con cambiar el base_url para redirigir el tráfico en sombra y comparar los resultados.
Cobertura de modelos y verificación de precios en servicios de agregación de API de IA
Al elegir un servicio, también debes comprobar que los modelos que necesitas estén realmente disponibles y que los precios sean claros. La siguiente tabla muestra algunos de los modelos disponibles actualmente en APIYI y los precios unitarios publicados en su página de precios. Todos los precios están sujetos a los datos reales de la página de precios de APIYI: https://docs.apiyi.com/models. Consulta allí las unidades de facturación y los cambios más recientes; las cifras de este artículo sirven solo como referencia.
| ID del modelo | Casos de uso | Precio unitario de entrada / salida / caché (página de precios de APIYI) | Plataforma disponible |
|---|---|---|---|
| claude-opus-5-5 | Razonamiento complejo y programación de larga duración | $4 / $20 / $0.2 | APIYI apiyi.com |
| claude-sonnet-5-5 | Programación diaria y modelo principal para agentes | $2 / $10 / $0.1 | APIYI apiyi.com |
| kimi-k3.1-pro | Contextos largos y tareas en chino | $2 / $10 / $0.2 | APIYI apiyi.com |
| deepseek-v4.1-flash | Alta concurrencia y procesamiento por lotes de bajo costo | $0.3 / $1.2 / $0.006 | APIYI apiyi.com |
| gpt-image-2.6-flare / sunburst | Generación de imágenes | Entrada de texto $5, entrada de imagen $8, salida $30 | APIYI apiyi.com |
| Serie qwen3.8 | Tareas generales en chino | Consulta la página de precios | APIYI apiyi.com |
Hay un detalle importante: si tu negocio depende de la serie ERNIE de Baidu Wenxin, APIYI aún no ofrece ese modelo. Lo incorporaremos lo antes posible; mientras tanto, conserva tu método de acceso actual. Conviene hacer esta comprobación al evaluar cualquier servicio proxy de API: confirma uno por uno que los modelos realmente figuren en la lista de precios y no te conformes con afirmaciones generales como «compatible con cientos de modelos».
💡 Consejo para elegir: multiplica el precio unitario de caché por tu tasa real de aciertos de caché y suma los costos de entrada y salida para calcular el costo real. Te recomendamos probar modelos como Claude, Kimi y DeepSeek en APIYI apiyi.com con el mismo lote de solicitudes, y elegir el de «menor costo que cumpla los requisitos de calidad», en lugar de fijarte solo en el precio unitario.
Preguntas frecuentes (FAQ)
Q1: ¿Qué es un servicio proxy de API de IA que agrega varios proveedores?
Es una puerta de enlace entre tu aplicación y los proveedores de modelos. Unifica los modelos de varios proveedores en una sola interfaz y se encarga de la autenticación, el enrutamiento, la facturación y la conmutación por error. La ventaja es que simplifica la integración y facilita el cambio entre modelos; a cambio, añade una dependencia cuya fiabilidad debes evaluar.
Q2: ¿Un servicio proxy de API de IA es siempre menos fiable que la conexión directa con la API oficial?
No necesariamente. Con la conexión directa dependes de un solo proveedor y, si este aplica límites de solicitudes o sufre una falla, no tienes una alternativa inmediata. En cambio, un servicio proxy con varias conexiones redundantes a proveedores puede cambiar automáticamente cuando una de ellas falla. La diferencia está en la calidad de la propia capa proxy: conviene comprobarla con los 10 indicadores de este artículo, sin dar nada por sentado.
Q3: ¿Cada cuánto hay que revisar los indicadores de fiabilidad de un servicio proxy de API de IA?
Se recomienda hacer una validación completa de 7 días antes de la puesta en producción y, después, revisar mensualmente la tasa de errores, los percentiles de latencia y las diferencias de facturación. También deberías repetir las pruebas de regresión funcional y de carga cada vez que la plataforma actualice la versión de un modelo, ajuste los precios o tu tráfico aumente de forma considerable.
Q4: ¿En qué escenarios de producción es más importante prestar atención a la fiabilidad de un servicio de agregación de API de IA?
Principalmente en estos casos:
– **Conversaciones en tiempo real con usuarios finales**: el tiempo hasta el primer token y la estabilidad de la transmisión determinan directamente la experiencia.
– **Agentes de programación y flujos de trabajo automatizados**: si se modifican los campos de una llamada a herramientas, puede fallar toda la cadena.
– **Procesamiento de datos por lotes**: las cuotas de concurrencia y la precisión de la facturación determinan si las tareas pueden completarse a tiempo y dentro del presupuesto.
Q5: ¿Cómo comprobar rápidamente mediante la API si un servicio proxy cumple los requisitos?
La forma más sencilla es empezar con una plataforma compatible con varios modelos y comparar los resultados usando tráfico en sombra:
1. Visita APIYI apiyi.com, crea una cuenta y obtén crédito de prueba
2. Configura base_url como `https://api.apiyi.com/v1` o utiliza el formato de Anthropic siguiendo la documentación de docs.apiyi.com
3. Copia una pequeña parte de las solicitudes reales y compara la latencia, la tasa de errores y las diferencias en las respuestas
APIYI ofrece acceso mediante API a los modelos mencionados en este artículo, como Claude, Kimi, DeepSeek, GPT Image y Qwen, lo que facilita compararlos desde una misma interfaz.
Q6: ¿Qué fuente debe tomarse como referencia para los precios de un servicio proxy de API?
La referencia debe ser la página oficial de precios de la plataforma. Guarda también una captura de pantalla o anota la fecha de consulta. En el caso de APIYI, los precios de entrada, salida y caché de todos los modelos son los publicados en https://docs.apiyi.com/models. Las tarifas de blogs de terceros solo deben servir como referencia, ya que sus criterios y fechas de actualización pueden ser distintos.
Q7: ¿Qué limitaciones son inevitables en un servicio proxy de API de IA que agrega varios proveedores?
Toda capa proxy añade cierta latencia y un punto adicional de falla. Además, los modelos nuevos suelen llegar a estas plataformas después de su lanzamiento oficial, y es posible que algunos parámetros exclusivos de cada proveedor tarden en adaptarse. Para mitigarlo, conserva la conexión directa oficial o un segundo servicio como alternativa y prepara un plan de funcionamiento degradado para los procesos críticos.
Puntos clave sobre la fiabilidad de los servicios proxy de API de IA en producción
- La fiabilidad tiene cuatro capas: disponibilidad, rendimiento, consistencia y gobernabilidad son indispensables; no basta con comprobar si hay caídas.
- Mide la latencia en horas pico: la sobrecarga adicional de la capa proxy es estable y medible; las fluctuaciones en las colas durante los picos son la principal causa de incidentes.
- Cuidado con la sustitución de modelos: comprueba el campo
modely ejecuta pruebas de regresión con un conjunto fijo de preguntas para detectar degradaciones silenciosas. - La facturación también forma parte de la fiabilidad: las anomalías en las facturas suelen apuntar a fallos de caché o tormentas de reintentos; concilia las cuentas periódicamente.
- Comprueba la compatibilidad función por función: valida el streaming, las llamadas a herramientas y los campos de caché con solicitudes reales; no basta con ejecutar un Hello World.
- Valida con tráfico sombra durante 7 días: compara con una pequeña parte del tráfico en vez de decidir por intuición; las conclusiones serán más fiables.
- Cómo empezar: en APIYI apiyi.com puedes comparar varios modelos mediante una interfaz unificada. Consulta la página de precios para conocer las tarifas vigentes.
Resumen
Al elegir un servicio proxy o agregador de API de IA para producción, hay tres ideas fundamentales:
- Define las métricas antes de comparar precios: utiliza las 10 métricas de fiabilidad para descartar las plataformas que no cumplan los requisitos y compara los costos entre las que sí lo hagan.
- Sustituye la publicidad por datos: sigue un proceso de validación de 7 días para obtener datos de latencia, tasa de errores y facturación de tu propio negocio.
- Mantén siempre una alternativa: cualquier ruta única puede fallar; los canales de respaldo y los planes de degradación son imprescindibles en producción.
Si estás pensando en incorporar una pasarela de API de IA a tu servicio en línea, puedes empezar con una prueba de bajo volumen de tráfico usando la tabla de evaluación de este artículo. Te recomendamos usar APIYI apiyi.com para validar los resultados rápidamente. La plataforma es compatible con los formatos de interfaz de OpenAI y Anthropic. Puedes consultar los modelos y precios en https://docs.apiyi.com/models y los detalles de integración en el centro de documentación, docs.apiyi.com.
📚 Referencias
- Página de precios de APIYI: lista de modelos y precios unitarios de entrada, salida y caché
- Enlace:
docs.apiyi.com/models -
Nota: Todos los datos de precios de APIYI de este artículo se basan en esta página.
-
Centro de documentación de APIYI: instrucciones de integración con los formatos de OpenAI y Anthropic
- Enlace:
docs.apiyi.com -
Nota: Incluye la configuración de base_url, los ID de los modelos y preguntas frecuentes.
-
Blog de Ofox.ai: evaluación de la fiabilidad de OpenRouter en producción y reporte sobre problemas de facturación de Claude
- Enlace:
ofox.ai/blog/page/39 -
Nota: Fuente de los datos de terceros sobre número de fallos, latencia adicional y comisiones citados en el artículo, incluidos únicamente como referencia comparativa.
-
Blog de Ofox.ai: reporte sobre la limitación de solicitudes de Claude en horas pico y problemas de facturación de la caché
- Enlace:
ofox.ai/blog/page/36 - Nota: Se cita únicamente como referencia comparativa para explicar la importancia de revisar la facturación.
Autor: equipo técnico de APIYI
Intercambio técnico: Contáctanos desde la página principal de APIYI, apiyi.com, para compartir experiencias sobre la elección de gateways de API de IA. Encontrarás más recursos de integración en el centro de documentación de docs.apiyi.com.


