
作者注:文心5.5 Flash Base 开源权重已经可以下载。本文从架构参数、硬件门槛、使用目的和成本四个角度,帮你判断应该自己部署基座模型,还是按需调用 API。
2026 年 11 月 5 日,百度正式发布并开源 文心5.5 Flash Base(ERNIE-5.5-Flash-Base)。这是一款 280B 总参数、每个 token 激活 14B 的稀疏 MoE 基座模型,在多项基准上取得同尺寸 SOTA。权重已在 Hugging Face 提供 FP8 与 BF16 两个版本,vLLM 插件和 SGLang Cookbook 也同步发布,这次不是“只发论文不给权重”。
这不是又一篇跑分复述。很多团队看到“开源 + SOTA”就准备拉权重上线,却忽略了一个关键事实:这是一个未经中训练和后训练的 Base 模型。它擅长作为训练起点,不能拿来直接做聊天机器人。
核心价值:读完本文,你会清楚文心5.5 Flash Base 适合什么场景、自部署大致需要多少显存,以及在什么条件下按需调用 API 更划算。
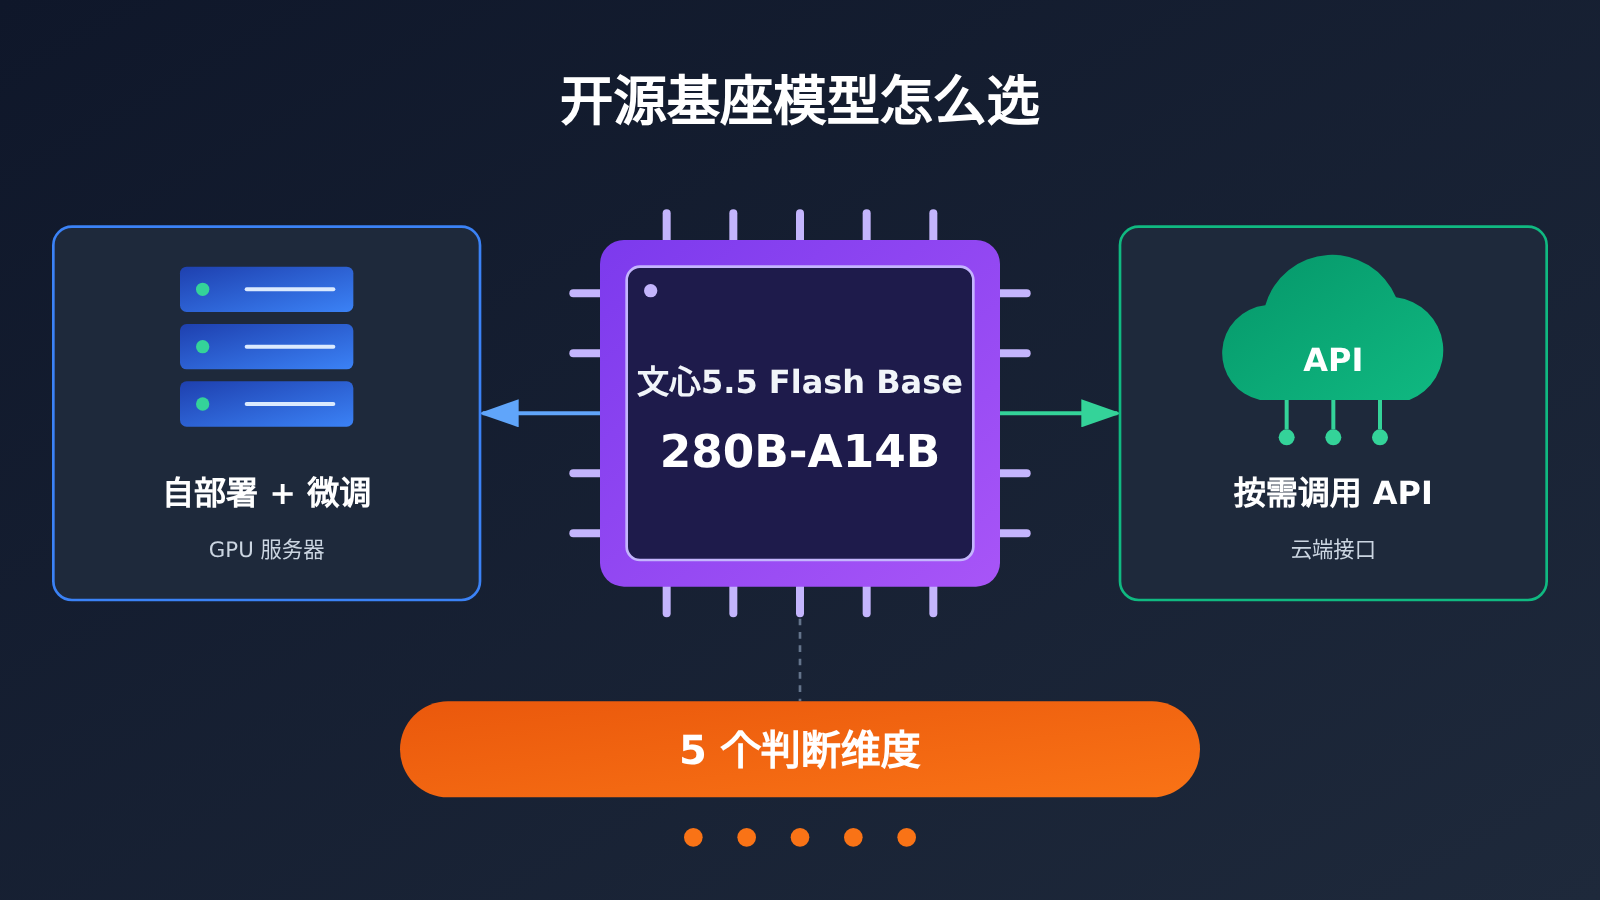
文心5.5 Flash Base 核心要点
先用一张表把这款模型最关键的信息梳理清楚。这些信息直接决定后面“部署还是调用”的判断。
| 要点 | 说明 | 对选型的影响 |
|---|---|---|
| 模型定位 | 预训练终点 Checkpoint,未做中训练与后训练 | 不能直接对话,适合继续训练 |
| 参数规模 | 280B 总参数,每 token 激活 14B | 推理计算量小,但权重显存占用按 280B 算 |
| 上下文 | 训练上下文 128K,微调与推理支持 1M tokens | 适合长文档、仓库级代码类领域适配 |
| 权重格式 | Hugging Face 提供 FP8 与 BF16 | FP8 能大幅降低部署门槛 |
| 生态支持 | vLLM 插件、SGLang Cookbook | 主流推理框架可直接接入 |
文心5.5 Flash Base 的“Base”意味着什么
Base 模型只学过“预测下一个 token”,没有学过“听懂指令并给出回答”。给它一个问题,它很可能续写出更多问题,而不是给出答案。百度官方的说法也很明确:开发者可以基于这一统一起点,继续做领域适配、指令微调、推理强化和 Agent 训练。
所以第一个判断维度很简单:如果你的目标是“用模型”,Base 不是你要的东西;如果你的目标是“训模型”,它才是好的起点。百度也透露,文心5.5 Flash 正式版将于近期发布,想直接用于对话的团队可以等正式版。
文心5.5 Flash Base 的同尺寸对手
百度公布的评测中,同台对比的模型包括 DeepSeek-V4-Flash-Base(284B-A13B)、Hy3-preview-Base(295B-A21B)和 MiMo-V2.5-Base(310B-A15B)。文心5.5 Flash Base 在推理、代码、学科能力和长上下文任务上表现突出。对于要做代码 Agent、长文档理解等领域微调的团队,这个底座值得放进候选名单。
文心5.5 Flash Base 如何工作:三项效率改造
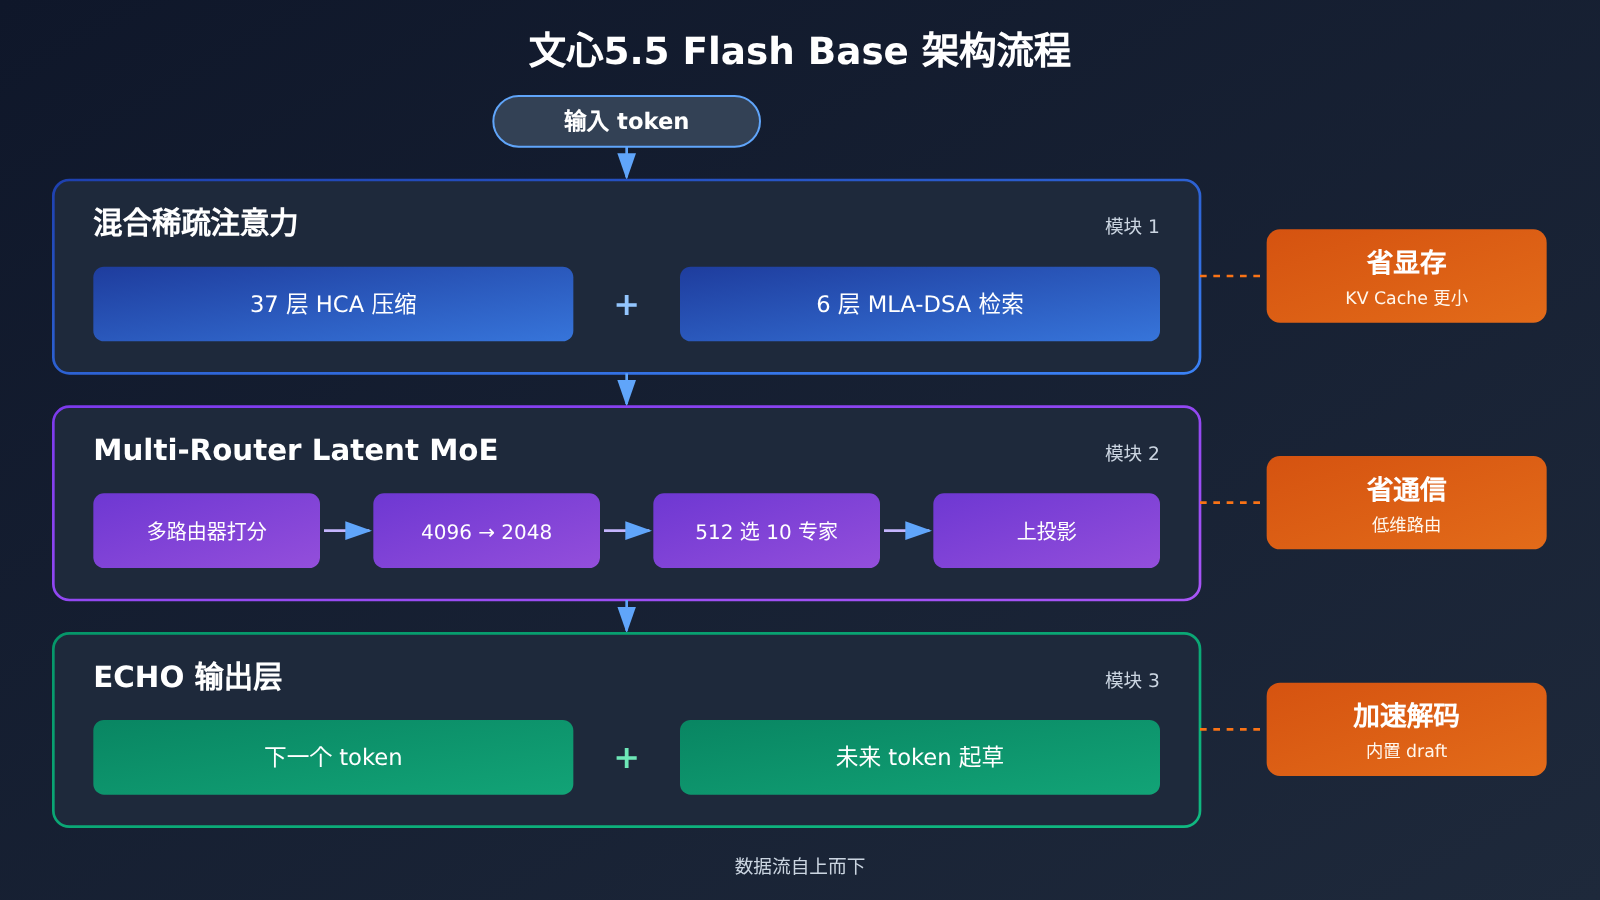
理解架构有助于估算部署成本。文心团队把“效率”作为预训练的设计变量,核心改造集中在注意力、专家路由和未来 token 预测三个环节。
| 模块 | 关键设计 | 部署侧收益 |
|---|---|---|
| 混合稀疏注意力 | 43 层中 37 层 HCA(每 128 token 压缩为一条缓存),6 层 MLA + DSA 稀疏检索 | KV Cache 大幅缩小,长上下文更省显存 |
| Multi-Router Latent MoE | 多个 Sigmoid 路由器共同打分,512 个路由专家选 10 + 1 个共享专家,专家在 2048 维隐空间计算 | 专家 FLOPs 与分发通信量约减半 |
| ECHO | 复用主干最后一层做未来 token 预测 | 可直接作为投机解码的内置 draft 模型,不增加参数 |
| 配套设计 | MultiMax 输出头、约 20 万词表的 R2L 分词器 | 数字与算术处理更稳 |
文心5.5 Flash Base 的 KV Cache 为什么省
传统模型每一层都要保存完整的 KV Cache,上下文越长显存越吃紧。文心5.5 Flash Base 让 37 层只看压缩后的“摘要”,只有 6 层逐 token 访问历史。这 6 层再用轻量 Indexer 挑出 Top-K 位置做精细计算。这意味着在 128K 甚至更长上下文下,KV Cache 的占用远低于同规模全注意力模型,对自部署团队来说是实打实的显存节省。
ECHO 对推理加速的意义
ECHO 在预训练时只多预测 1 个 token,作为 draft 模型却能连续向后起草多个 token,接受率高于同样方式训练的外挂 MTP 模块。自部署时如果推理框架支持这一投机解码路径,吞吐会有可观提升。这也是开源权重相对于 API 的一个优势:你可以完全掌控这类推理优化。
文心5.5 Flash Base 快速上手:自部署路径
如果你确定要基于这个底座做训练或私有化推理,下面是一条最短路径。全文不贴代码,关键参数用文字说明。
第一步:估算显存门槛
MoE 模型的计算量按激活参数算,但权重必须全部加载,显存按总参数 280B 计算。下表是按“每参数字节数 × 参数量”做的粗略估算,未计入 KV Cache、激活值和框架开销,实际以官方文档与自测为准。
| 权重版本 | 权重显存估算 | 部署建议(估算) | 适合用途 |
|---|---|---|---|
| FP8 | 约 280GB | 单机 8 卡 80GB 级 GPU,可留出 KV Cache 空间 | 推理评测、轻量服务 |
| BF16 | 约 560GB | 单机 8 卡大显存 GPU 或多机张量并行 | 精度敏感的评测与微调起点 |
| 全参微调 | 远高于推理(还需优化器状态与梯度) | 多机集群,需分布式训练框架 | 深度领域适配 |
| LoRA 类微调 | 介于推理与全参之间 | 视秩与序列长度而定 | 中小团队领域适配 |
第二步:选择推理框架并加载权重
官方同步提供了 vLLM 插件与 SGLang Cookbook,推荐优先按这两份材料操作。具体步骤如下:
- 从 Hugging Face 下载 FP8 或 BF16 权重,注意磁盘预留与权重显存相近的空间。
- 安装 vLLM 并加载官方插件,或按 SGLang Cookbook 配置启动参数。
- 张量并行规模与卡数保持一致(vLLM 中对应
tensor-parallel-size参数)。 - 先用 32K 左右的上下文长度跑通,再逐步放大,观察 KV Cache 占用。
- 用续写式 prompt 做冒烟测试,比如给一段代码开头让它补全,而不是直接提问。
第三步:明确训练目标
Base 权重上线之后,真正的工作才开始。常见方向有三类:用领域语料做继续预训练,用指令数据做 SFT,以及在 SFT 基础上做推理强化或 Agent 轨迹训练。文心在预训练阶段已经投入了 commit、issue、PR、CI 验证修复等代码数据,以及多跳问答类长文数据,因此代码工程和长文档两个方向的微调潜力最值得期待。
🎯 技术建议:在投入 GPU 做微调之前,建议先用现成的指令模型跑一遍业务评测集,确定“基线分数”。API易 apiyi.com 提供多家主流模型的统一接口,可以低成本拿到对照基线,再判断自训底座是否值得投入。
文心5.5 Flash Base 快速上手:按需调用 API 路径
需要先说清楚一个事实:API易 目前暂未上线文心 ERNIE 系列模型,包括文心5.5 Flash Base,我们会尽快上线。另外,Base 模型本身也不适合直接作为对话 API 使用,大多数业务更需要的是指令版或推理版。
如果你的需求是“马上把能力接入产品”,可以先用已上线的成熟模型搭起业务链路,等文心5.5 Flash 正式版上线后再做替换对比。API易 同时兼容 OpenAI 与 Anthropic 两种接口格式,切换模型只需修改 model 参数,不需要重写调用逻辑。
API易 已上线的可替代模型价格
以下价格均以 API易 价格页 docs.apiyi.com/models 的实际数据为准,单位为每百万 tokens 美元价格,调用前请以页面最新数据为准。
| 模型 | 输入 | 输出 | 缓存 | 适合场景 | 可用平台 |
|---|---|---|---|---|---|
| deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | 高并发、成本敏感任务 | API易 apiyi.com |
| kimi-k3.1-pro | $2 | $10 | $0.2 | 长上下文、中文场景 | API易 apiyi.com |
| claude-sonnet-5-5 | $2 | $10 | $0.1 | 编程与 Agent 主力 | API易 apiyi.com |
| claude-opus-5-5 | $4 | $20 | $0.2 | 复杂推理与高难任务 | API易 apiyi.com |
| 文心5.5 Flash Base / 正式版 | — | — | — | API易 目前暂未上线该模型 | 会尽快上线 |
此外,API易 还提供 qwen3.8 系列等国产模型,以及 gpt-image-2.6-flare、gpt-image-2.6-sunburst 图像模型(文本输入 $5、图片输入 $8、输出 $30,同样以价格页为准)。需要注意,表中的 deepseek-v4.1-flash 是可直接调用的指令模型,与参与评测对比的 DeepSeek-V4-Flash-Base 不是同一个东西。
接入方式说明
在 OpenAI 格式下,把 SDK 的 base_url 设置为 API易 文档中提供的接口地址,api_key 填入控制台生成的密钥即可。使用 Anthropic SDK 的项目同样可以直接接入。完整的接口地址、参数说明与示例请参考 API易 文档中心 docs.apiyi.com。
🚀 快速开始:推荐先在 API易 apiyi.com 用 deepseek-v4.1-flash 或 claude-sonnet-5-5 跑通业务原型。等文心5.5 Flash 正式版在平台上线后,只需改一个模型名就能做 A/B 对比。
文心5.5 Flash Base 自部署对比 API 调用:决策表
下面从 5 个维度给出明确建议,帮助你判断自己属于哪一类团队。
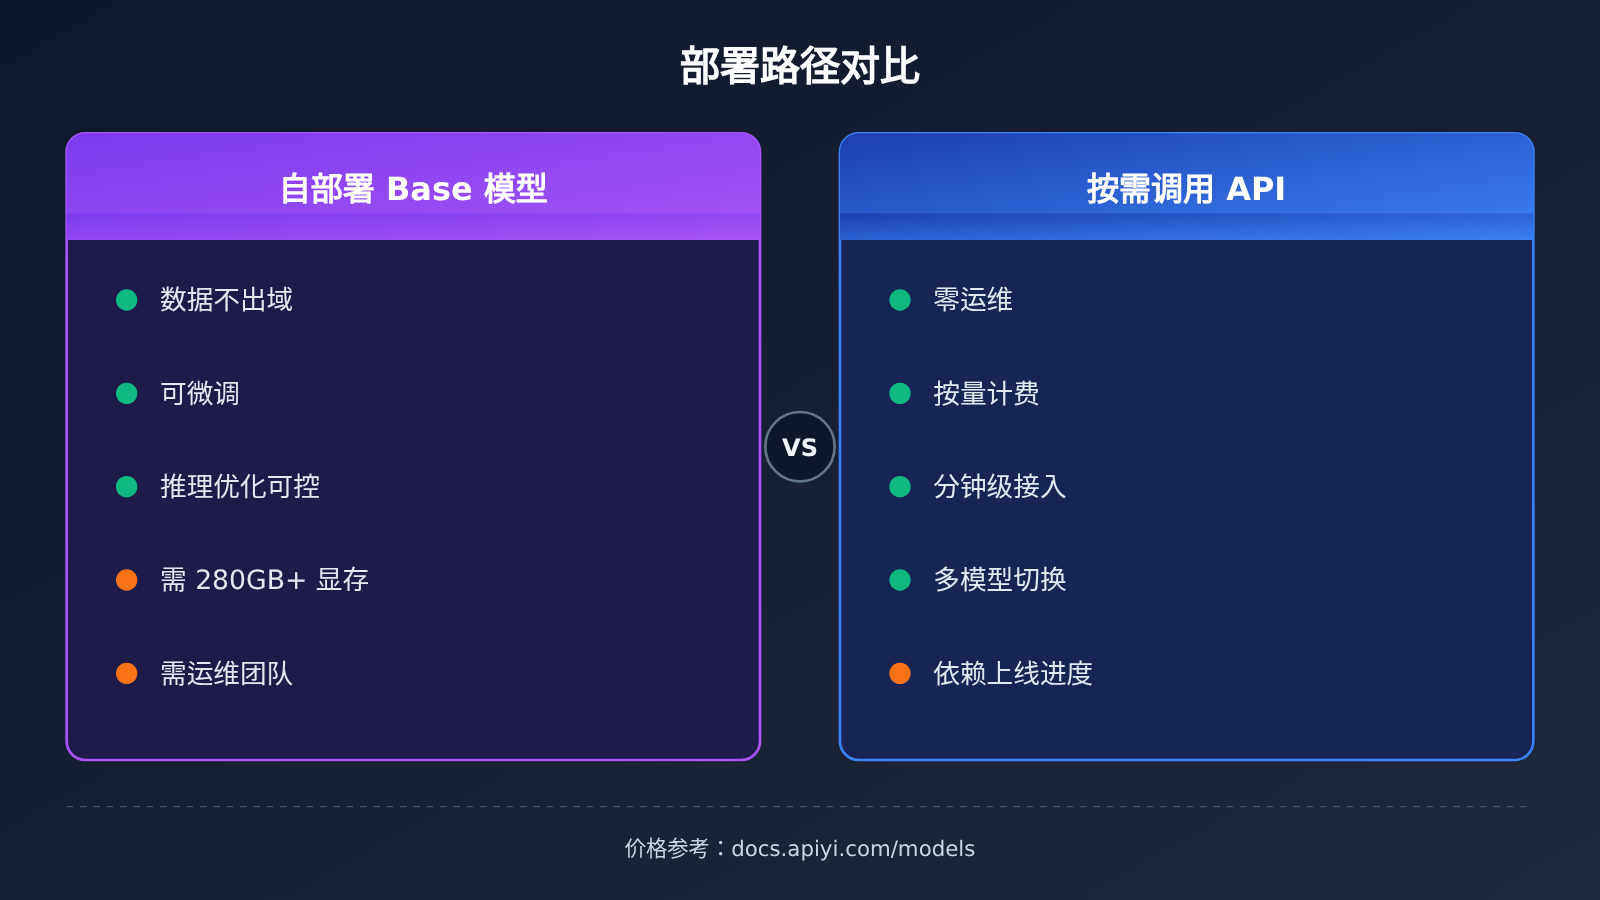
| 判断维度 | 选自部署 Base | 选按需调用 API |
|---|---|---|
| 使用目的 | 要做领域继续预训练、SFT、RL 或研究对照实验 | 要直接做问答、写作、编程助手等应用 |
| 数据合规 | 数据不能出内网,必须私有化 | 数据可走云端,接受服务商合规条款 |
| 调用规模 | 长期稳定高负载,GPU 利用率能保持高位 | 流量波动大,或日调用量有限 |
| 团队能力 | 有训练与推理运维工程师 | 以应用开发为主,不想维护集群 |
| 上线时间 | 可以接受数周到数月的训练周期 | 需要本周就上线 |
文心5.5 Flash Base 的两类典型用户
适合自部署的团队:例如金融、医疗、政企等有私有化要求的行业团队,手上有大量领域语料,目标是训出一个专属模型。这类团队选择文心5.5 Flash Base,看重的是它在代码和长上下文上的预训练底子,以及 HCA 架构带来的 KV Cache 节省。
适合调用 API 的团队:例如做 SaaS、内容工具、客服系统的应用团队,核心诉求是稳定、快速、按量付费。对他们来说,直接拿 Base 模型反而要多走一段训练的弯路。更合理的做法是先用成熟的指令模型上线,把精力放在产品上。
两条路径可以并行
很多团队其实是“混合模式”:线上业务调用 API 保证稳定,同时在内部用 Base 权重做实验,等自训模型在评测集上超过 API 基线后再逐步切流。这种方式风险最低,也能保证自研投入始终有明确的对照标准。
💡 选择建议:如果还拿不准,可以先算一笔账:把预估月调用量按 API易 价格页单价换算出月费,再和 GPU 租赁或折旧成本对比。通过 API易 apiyi.com 的统一接口小规模试跑一周,拿到真实 token 用量后再决策,会比凭感觉估算准确得多。
常见问题 FAQ
Q1:什么是文心5.5 Flash Base?
它是百度于 2026 年 11 月 5 日开源的基座模型,采用稀疏 MoE 架构,总参数 280B,每 token 激活 14B,在 33.5T tokens 上从零预训练。官方发布的是预训练终点权重,主要用于继续训练,而不是直接对话。
Q2:文心5.5 Flash Base 和 DeepSeek-V4-Flash-Base 有什么区别?
两者规模相近,后者为 284B-A13B。DeepSeek-V4-Flash-Base 同样是强力底座,但按百度公布的评测,文心5.5 Flash Base 在推理、代码、学科与长上下文上取得领先。架构上,文心采用 HCA 与 MLA 混合注意力,以及多路由器 MoE,更侧重压缩 KV Cache 和提升路由稳健性。
Q3:文心5.5 Flash 正式版什么时候发布?
百度表示正式版将于近期发布,但截至本文撰写时(2026 年 11 月 6 日)尚未给出具体日期。正式版会在 Base 基础上完成后训练,更适合直接接入应用。
Q4:文心5.5 Flash Base 最适合哪些场景?
主要适合以下几类场景:
– **仓库级代码模型训练**:预训练已包含 commit、PR、CI 修复等工程数据。
– **长文档领域模型**:如法律卷宗、研报的长上下文理解,微调与推理支持 1M tokens。
– **训练方法研究**:作为统一起点,对比不同 SFT、RL 策略的效果。
Q5:现在能通过 API 调用文心5.5 Flash Base 吗?
API易 目前暂未上线该模型,ERNIE 系列整体也还没有上线,我们会尽快上线。现阶段可以在 API易 apiyi.com 调用 deepseek-v4.1-flash、kimi-k3.1-pro、claude-sonnet-5-5 等已上线模型。平台兼容 OpenAI 与 Anthropic 接口格式,价格以 docs.apiyi.com/models 为准。
Q6:自部署文心5.5 Flash Base 有哪些限制?
一是显存门槛高,即使使用 FP8 权重,仅权重就约需 280GB。二是 Base 模型不能开箱即用,必须投入训练。三是长上下文推理仍需要为 KV Cache 预留空间。如果团队缺乏训练与运维经验,建议先走 API 路线。
Q7:中小团队能用文心5.5 Flash Base 做什么?
可以租用云端 GPU 跑 FP8 推理做能力评测,或用 LoRA 类方法做轻量领域适配。生产流量建议仍走 API,用 API易 apiyi.com 拿到的业务基线作为自训模型的对照标准。
文心5.5 Flash Base 核心要点 Key Takeaways
- 定位是训练起点:Base 未做后训练,适合微调与研究,不能直接对话。
- 算力按激活、显存按总量:激活仅 14B,但 FP8 权重仍约需 280GB 显存。
- 长上下文更省缓存:37 层 HCA 压缩加 6 层 MLA-DSA,KV Cache 显著缩小。
- 代码与长文底子扎实:适合做仓库级代码和长文档类领域模型。
- 生态已就绪:vLLM 插件与 SGLang Cookbook 同步发布,推理接入门槛低。
- API 暂未覆盖:API易 目前暂未上线文心系列,可先用已上线模型搭建业务基线。
总结
文心5.5 Flash Base 的选型核心要点:
- 先看目的:要训模型选自部署 Base,要用模型选 API 或等正式版。
- 再算门槛:FP8 约 280GB、BF16 约 560GB 的权重显存是硬约束。
- 最后算账:用真实调用量对比 API 月费与 GPU 成本,混合模式风险最低。
对于大多数应用团队,最务实的路径是先通过 API 把业务跑起来,再用开源 Base 做内部实验。推荐通过 API易 apiyi.com 用已上线模型快速搭建基线,接口说明见 docs.apiyi.com,价格以 docs.apiyi.com/models 为准。文心系列上线后,同一套代码改个模型名即可完成对比。
📚 参考资料
- 量子位 – 百度开源文心5.5 Flash Base 报道:模型发布与评测概况
- 链接:
qbitai.com/2026/11/507787.html -
说明:包含同尺寸基座对比与核心技术介绍
-
API易 文档中心:接口地址、OpenAI 与 Anthropic 兼容调用说明
- 链接:
docs.apiyi.com -
说明:接入前必读,包含参数与示例
-
API易 模型价格页:已上线模型的输入、输出与缓存单价
- 链接:
docs.apiyi.com/models - 说明:本文所有价格以此页实际数据为准
作者:APIYI 技术团队
技术交流:欢迎在 API易 apiyi.com 首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心


