
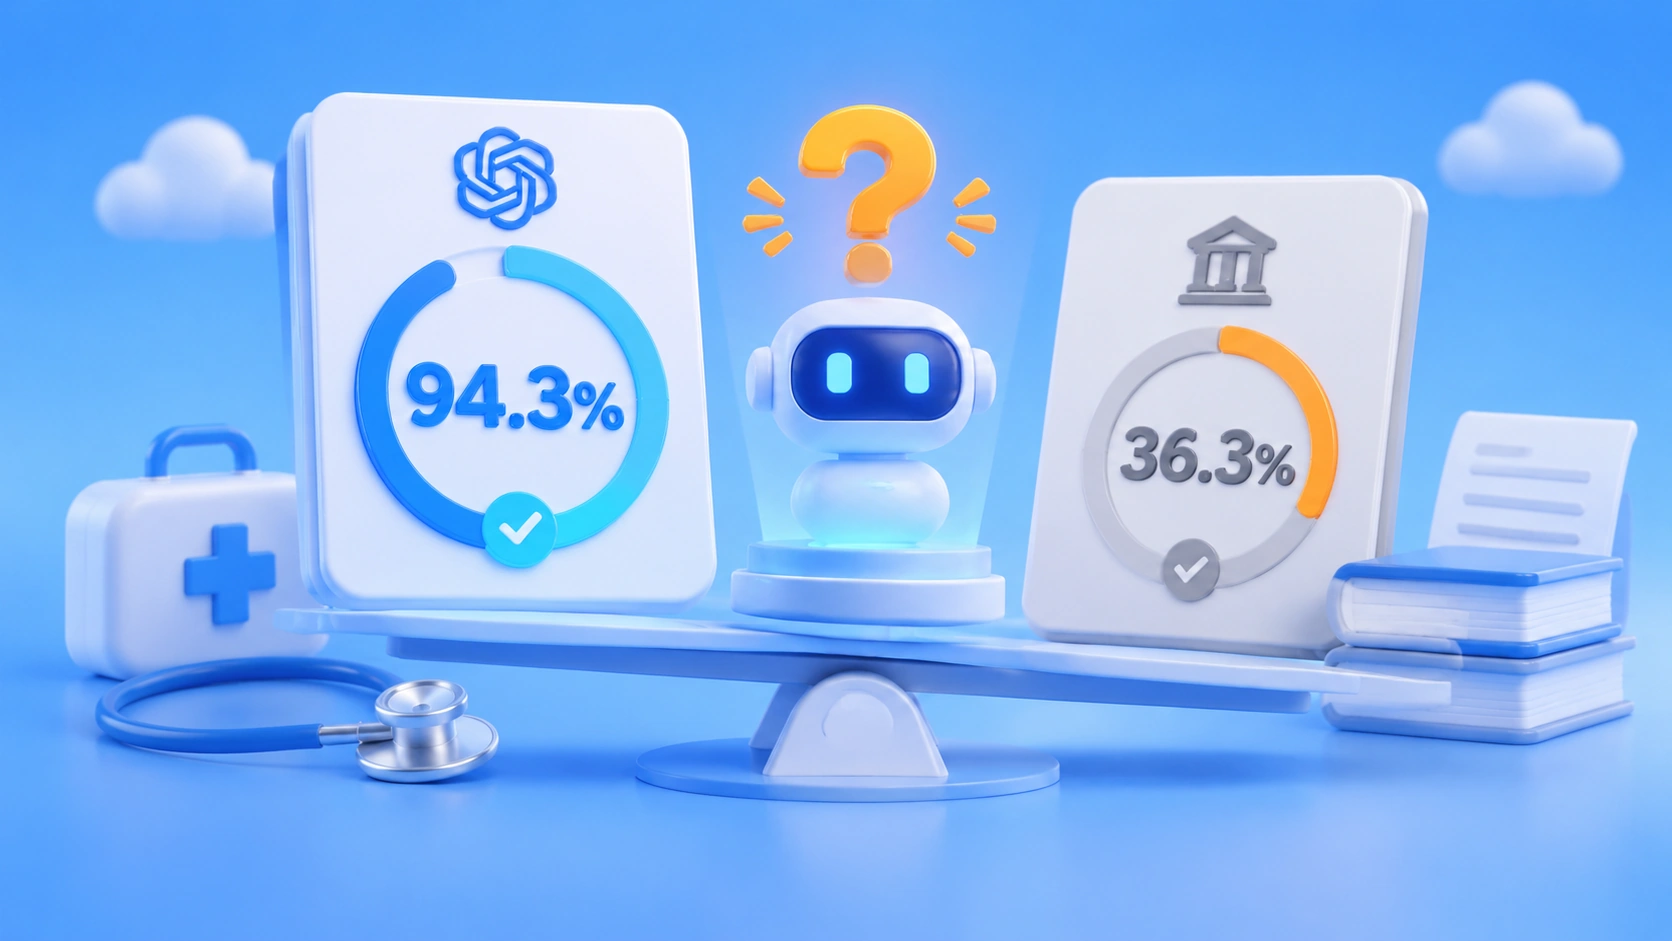
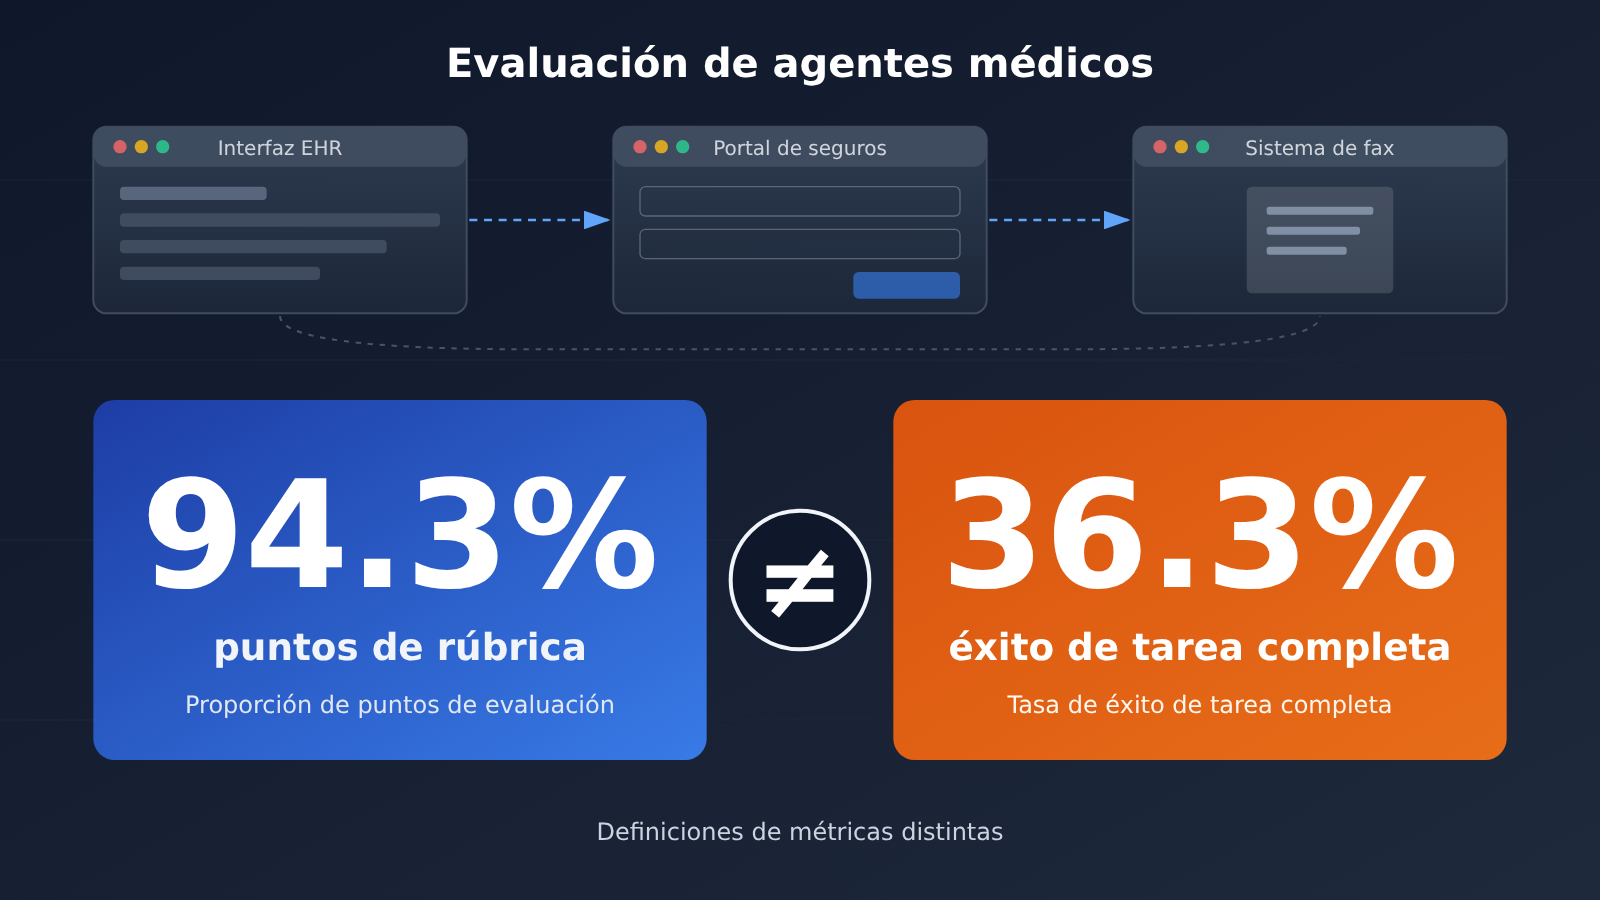
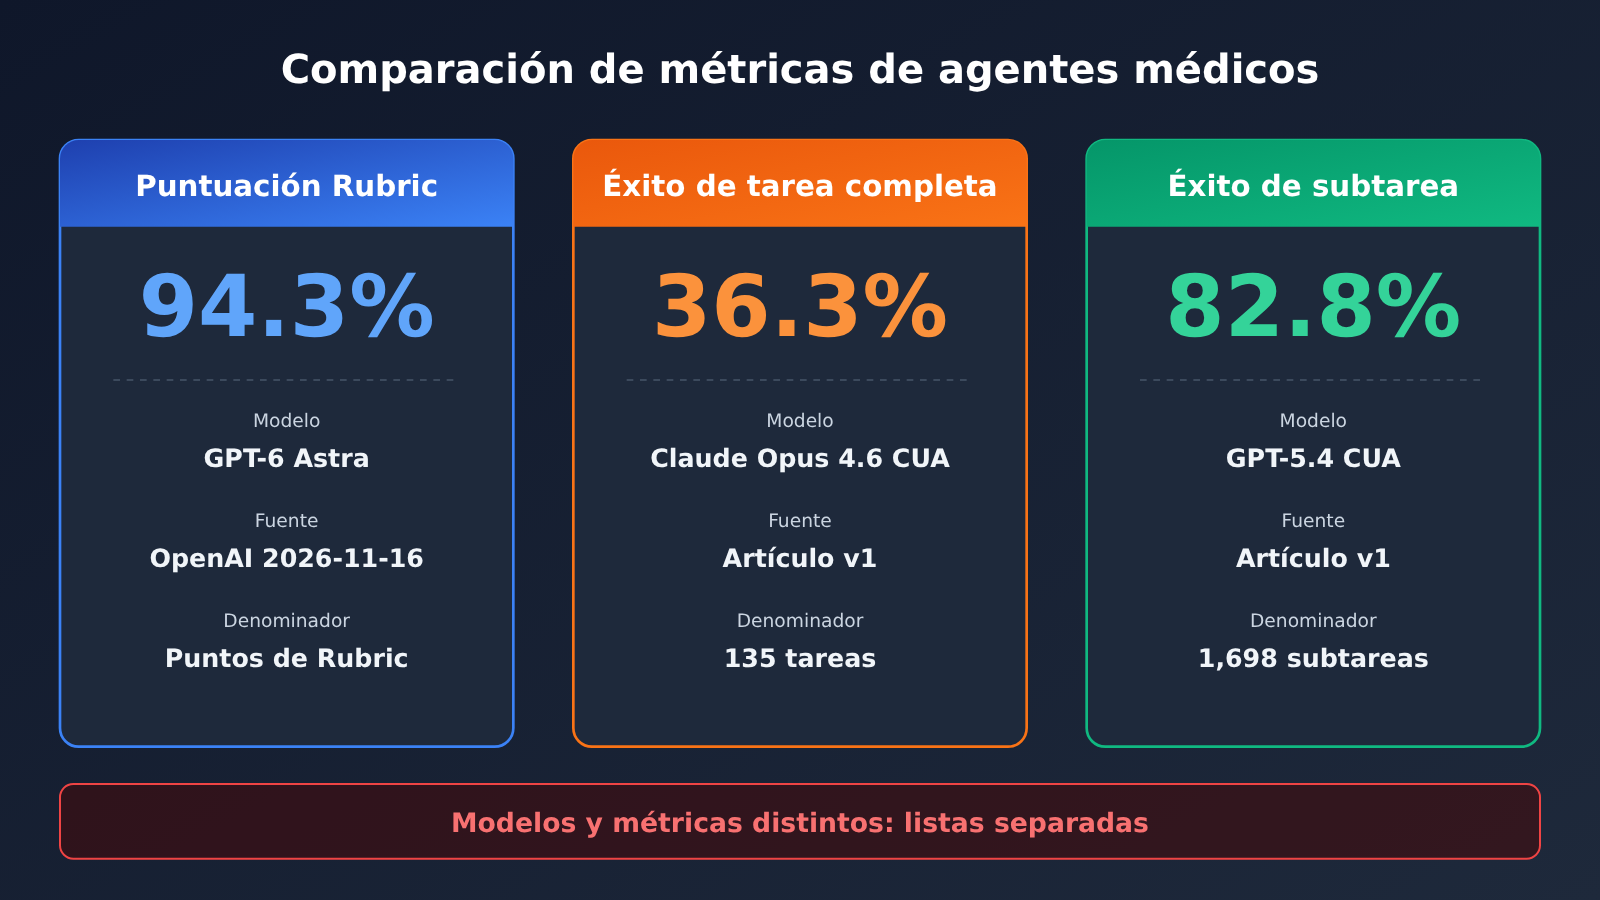
Un 94.3% no significa que el 94.3% de las tareas administrativas médicas se haya completado en su totalidad. El 94.3% de GPT-6 Astra que OpenAI anunció el 16 de noviembre de 2026 es la proporción de puntos de evaluación (rubric points) obtenidos en HealthAdminBench; el 36.3% de Claude Opus 4.6 CUA en el artículo del Shah Lab de Stanford es la tasa de éxito de tarea completa (full-task success). La primera métrica mide “cuántos puntos de evaluación se cumplieron”; la segunda, “cuántas tareas cumplieron todas las condiciones de éxito”. No son el mismo indicador y no pueden colocarse en la misma tabla de clasificación.
Un agente médico puede desempeñarse muy bien en operaciones puntuales como búsqueda de información, procesamiento de documentos o completar formularios, pero aun así no puede recorrer de forma estable un flujo de negocio que atraviesa varios sistemas. Para juzgar si un agente aporta valor en producción hay que considerar a la vez el desempeño en subtareas, la tasa de éxito de extremo a extremo, los tipos de error, el costo de ejecución y la intervención humana. Ninguna puntuación aislada basta.
¿Qué podrá aprender al leer este artículo?
- Qué mide cada uno de esos porcentajes, 94.3% y 36.3%, y por qué no se pueden comparar directamente
- Cómo se compone HealthAdminBench, de dónde provienen los puntos de evaluación y cuáles son sus dos mecanismos de validación
- Un conjunto de dimensiones de evaluación orientado a producción y transferible a otros agentes empresariales
Índice: la sección de hechos objetivos explica, en orden, por qué el resultado del 94.3% llamó la atención, qué mide exactamente HealthAdminBench, la diferencia entre el éxito en subtareas y el éxito de la tarea completa, las etapas en las que los agentes médicos fallan con más facilidad y por qué un mismo modelo puede rendir de forma distinta según el marco de ejecución. La sección de análisis y opinión, por su parte, examina cómo construir un marco de evaluación integral, cómo calcular los costos y qué decisiones deberían tomar las empresas al utilizarlos.
Lo que hay que saber: 7 conceptos para entender la evaluación de agentes médicos
| Concepto | Explicación breve |
|---|---|
| Computer Use | Capacidad de completar tareas observando la interfaz del software y simulando clics, entradas de texto, desplazamientos y otras operaciones |
| EHR | Sistema de historia clínica electrónica; el software central que usan los hospitales para almacenar la información clínica de los pacientes |
| MCP | Protocolo estándar para descubrir e invocar herramientas externas |
| RPA | Forma de automatización que ejecuta procesos repetitivos mediante reglas o scripts preconfigurados |
| Rubric points | Puntos de rúbrica que se obtienen conforme a las reglas de evaluación y que miden el grado de cumplimiento de requisitos parciales |
| Tasa de éxito de extremo a extremo | Proporción de tareas completas que cumplen todas las condiciones de éxito; si falla una condición clave, la tarea se considera fallida |
| Trace | Evidencia de traza que registra el proceso de ejecución, las acciones realizadas y el estado de la interfaz |
Impacto de la evaluación de agentes médicos: resumen rápido
- Desarrolladores y responsables técnicos: no basta con citar una única puntuación publicada por el proveedor para elegir una solución; hay que validar, según las tareas propias, el mecanismo de ejecución, la tasa de finalización de extremo a extremo y el costo total, incluidos capturas de pantalla, reintentos y entorno de ejecución.
- Instituciones médicas y responsables de flujos de trabajo: deben distinguir cuatro tipos de evidencia: demostraciones en entornos sintéticos, evaluaciones de benchmark, pilotos institucionales y casos en producción; además, al desplegar, deben aplicar aprobación humana, privilegios mínimos y auditoría de operaciones.
Hechos objetivos: la evaluación de agentes médicos que hay detrás del 94.3 % y el 36.3 %
¿Por qué llama la atención el resultado del 94.3 %?
El 16 de noviembre de 2026, OpenAI publicó avances sobre agentes de operación de computadora orientados a equipos médicos y dio a conocer varios conjuntos de datos de evaluación. Entre ellos, GPT-6 Astra obtuvo 94.3 % en HealthAdminBench y GPT-6 Luna llegó a 91.8 %, ambos evaluados con el máximo esfuerzo de razonamiento (maximum reasoning effort). OpenAI también informó que el costo por tarea de Luna es de 0.085 dólares, un 98 % menos que Astra.
Estas cifras resultan llamativas porque los resultados de HealthAdminBench que Stanford había publicado antes eran claramente más bajos. Conviene subrayarlo: el 94.3 % y el 91.8 % que publica OpenAI son proporciones de puntos de rúbrica (rubric points), no tasas independientes de éxito de la tarea completa. Los otros dos conjuntos de datos del mismo anuncio también provienen de etapas de evaluación distintas y tienen denominadores distintos:
| Indicador | Valor | Denominador/criterio | Lo que no representa |
|---|---|---|---|
| Puntuación en HealthAdminBench (Astra) | 94.3 % | Proporción de rubric points | Tasa de éxito de la tarea completa |
| Puntuación en HealthAdminBench (Luna) | 91.8 % | Proporción de rubric points | Tasa de éxito de la tarea completa |
| Seguridad en tareas clínicas (Astra) | 99 % | 325 tareas auditadas | Precisión del diagnóstico médico |
| Proporción de alta aprobación por parte de médicos (Astra) | 93 % | 646 evaluaciones de médicos | Tasa de éxito de tareas, y tampoco equivale a 646 médicos |
| Costo por tarea de Luna | $0.085 | Costo por tarea bajo condiciones de evaluación específicas | Precio de despliegue en producción |
Estos tres conjuntos de datos tienen denominadores diferentes y no se pueden fusionar en una única «precisión integral». Además, el cuerpo del anuncio de OpenAI no publica los resultados tarea por tarea, la configuración experimental completa, los intervalos de confianza ni todos los casos de fallo, así que por ahora no es posible verificar de forma independiente cómo se compone ese 94.3 %. El costo por tarea de Astra ronda los 4.25 dólares; se trata de una estimación deducida a partir de la reducción del 98 %, no de un precio publicado directamente por OpenAI.
¿Qué mide realmente HealthAdminBench?
HealthAdminBench fue propuesto por el Shah Lab de la Universidad de Stanford y evalúa específicamente el desempeño de agentes que operan computadoras en tareas administrativas de salud. Su versión pública ha cambiado con el tiempo: la página web del estudio inicial describía 70 tareas, 947 puntos de evaluación y 6 agentes; la versión 2604.09937v1 del artículo académico amplía la cifra a 135 tareas, 1,698 subtareas verificables y 7 configuraciones de modelos. Este texto se basa en esa versión del artículo; los datos de la página web inicial solo se usan como comparación histórica.
Los cuatro entornos GUI simulados de la versión del artículo son EHR, el portal de pagos de seguros A, el portal de pagos de seguros B y el portal de fax. Las 135 tareas se dividen en tres tipos de flujos de trabajo administrativos:
| Tipo de tarea | Cantidad | Contenido principal |
|---|---|---|
| Prior Authorization (preautorización) | 60 | Verificación de elegibilidad del seguro, recopilación de historiales médicos y envío de solicitudes de preautorización |
| Appeals and Denials Management (gestión de apelaciones y denegaciones) | 60 | Revisión de denegaciones, recopilación de documentación de respaldo, preparación y presentación de apelaciones |
| DME Order Processing (procesamiento de pedidos de equipos médicos) | 15 | Recopilación de documentación de equipos médicos, envío de pedidos y registro de resultados |
Los 1,698 puntos de evaluación se generan mediante dos mecanismos. 1,177 usan comprobaciones deterministas y validan el estado del sistema con herramientas estructuradas como JMESPath; por ejemplo, si se encontró al paciente correcto, si se completaron los campos especificados o si se generó el pedido correcto. El enfoque se parece al de las pruebas de software tradicionales. Los otros 521 se delegan a un LLM Judge, que evalúa principalmente si el contenido de la documentación es suficiente, si los materiales enviados cumplen los requisitos y otras partes difíciles de verificar directamente con reglas.
Todas las tareas usan datos sintéticos de pacientes, no registros reales de pacientes. Esto significa que el benchmark ofrece un entorno de prueba reproducible; no se prueba en sistemas de producción de hospitales reales ni se miden directamente los resultados de la atención al paciente.
¿Cuál es la diferencia entre el éxito de una subtarea y el éxito de la tarea completa?
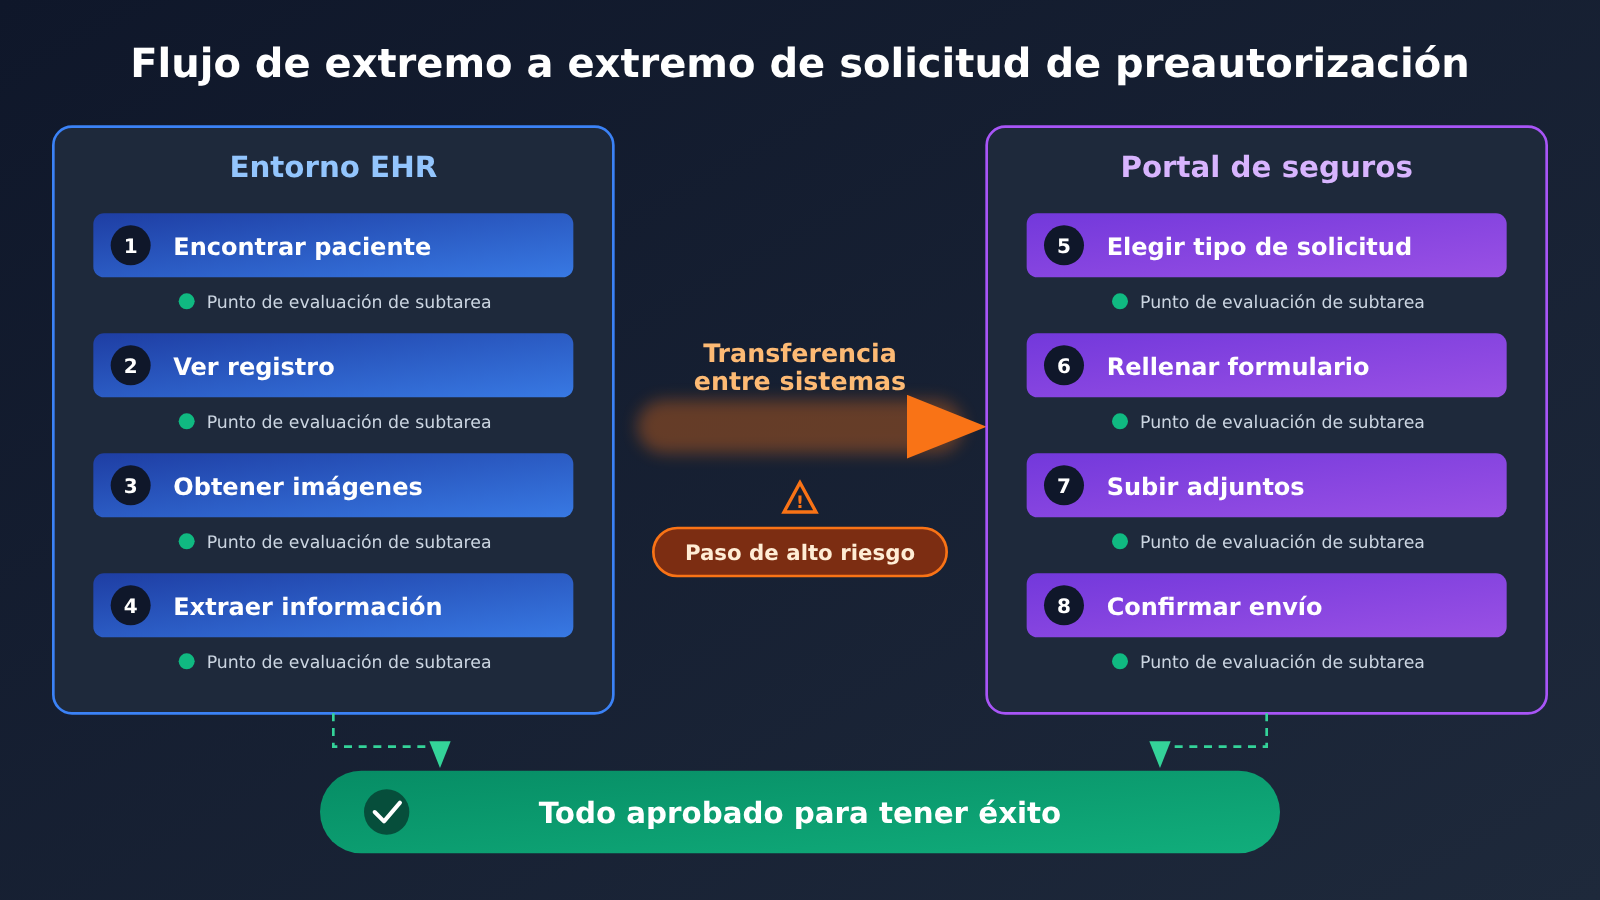
La forma más sencilla de ver la diferencia es con el flujo de una solicitud de autorización previa. Según los materiales de la investigación, una tarea de autorización previa puede pedirle al agente que complete, en orden:
- Encontrar al paciente correcto en el EHR
- Consultar el historial clínico del paciente
- Localizar los estudios de imagen y los materiales de tratamientos previos
- Determinar qué comprobantes necesita la solicitud de seguro
- Extraer del historial clínico la información necesaria
- Entrar al portal de pagos del seguro
- Elegir el tipo correcto de solicitud
- Completar el formulario de solicitud
- Adjuntar los documentos requeridos
- Enviar la solicitud y confirmar su estado
Estos diez pasos tienen una dependencia fuerte entre sí. Si te equivocas con el paciente en el paso 1, todo lo que hagas después, por bien hecho que esté, será incorrecto. Aunque los primeros nueve pasos sean correctos, si en el paso 9 olvidas adjuntar un archivo o en el paso 10 no envías de verdad la solicitud, la tarea completa se sigue considerando fallida. La tasa de éxito de subtareas mide “cuántos de los diez pasos se hicieron bien”; la tasa de éxito de tarea completa mide “si los diez pasos se hicieron correctamente”.
Los datos del artículo muestran claramente esta brecha: la tasa de éxito de subtareas de GPT-5.4 CUA es del 82.8%, mientras que la tasa de éxito de tarea completa de Claude Opus 4.6 CUA es del 36.3%. Estos dos números corresponden a modelos distintos, así que tampoco se pueden comparar directamente, pero juntos muestran un hecho: completar acciones locales y completar todo un flujo de negocio son dos capacidades distintas.
Investigaciones anteriores en la web también han reportado una brecha similar: la mejor tasa de éxito de tarea completa de Claude Opus 4.5 fue del 22.9%, y la tasa de éxito de subtareas de Gemini 3 fue del 76.4%. Como el tamaño de las tareas y las versiones son distintos, estas cifras solo sirven para observar tendencias; no se pueden poner en la misma clasificación que los resultados de la versión del artículo ni que los de OpenAI.
¿En qué etapas falla con más frecuencia el agente médico?
El estudio publica los resultados de dos configuraciones CUA por categoría de subtarea:
| Categoría de subtarea | Claude Opus 4.6 CUA | GPT-5.4 CUA |
|---|---|---|
| Recuperación de información | 96.5% | 96.1% |
| Redacción de documentos | 74.3% | 84.4% |
| Completar formularios | 88.9% | 84.9% |
| Resolución de tareas | 70.7% | 66.2% |
| Procesamiento de documentos | 92.3% | 94.3% |
| Razonamiento clínico | 61.3% | 77.0% |
Una advertencia especial: el 94.3% de GPT-5.4 CUA en procesamiento de documentos que aparece en la tabla coincide con el 94.3% de rubric points globales de GPT-6 Astra publicado por OpenAI solo por casualidad numérica; los modelos, las métricas y las fuentes son completamente distintos.
Por subtarea, la recuperación de información está cerca de saturarse, mientras que el razonamiento clínico, la resolución de tareas y la redacción de documentos son relativamente débiles. El estudio señala además que Document Handling (procesamiento de documentos) y Cross-system Data Transfer (transferencia de datos entre sistemas) son los principales problemas que provocan fallos de extremo a extremo. Una versión anterior publicada en la web informó que cinco de seis modelos tenían una precisión inferior al 20% en la subtarea de procesamiento de documentos, pero eso corresponde a una configuración de tareas de otra versión y no puede compararse directamente con la tabla anterior.
¿Por qué la transferencia entre sistemas es especialmente propensa a errores? En el proceso de autorización previa, la misma información debe leerse del EHR, conservarse en el contexto del agente y luego escribirse en otra estructura de formulario del portal de la aseguradora; además, los adjuntos pueden pasar por un portal de fax. Cada transferencia es una oportunidad de error, y un error en origen se copia tal cual al sistema downstream. Entre los riesgos que enumera el material de OpenAI también se incluyen “propagar información errónea de un sistema a otro” y “reportar incorrectamente que la tarea está completada cuando el estado del sistema no está claro”.
¿Por qué el mismo modelo puede comportarse de forma diferente según el framework de ejecución?
El artículo realizó experimentos de ablación sobre métodos de indicación y modos de observación, y encontró tres hallazgos principales:
- Proporcionar Portal Guidance (orientación para operar el portal) normalmente funciona mejor que dar solo la descripción de la tarea.
- El modo de observación mediante Accessibility Tree (árbol de accesibilidad) normalmente supera la observación basada únicamente en capturas de pantalla.
- Cuando la orientación para operar el portal se combina con información estructurada de la página, el rendimiento de extremo a extremo suele ser mejor.
El artículo también señala que los entornos de producción reales no necesariamente pueden proporcionar un Accessibility Tree completo. En otras palabras, el rendimiento del Agent no depende solo del modelo subyacente, sino también del framework de ejecución (Harness), la forma de observar la página, las indicaciones y la descripción de la tarea.
La documentación para desarrolladores de OpenAI también refleja diferencias en la ruta de ejecución. La guía oficial describe por separado ComputerToolset, BrowserToolset y el punto de entrada del navegador gestionado; para GPT-6 Astra, la documentación actual recomienda el enfoque Code Execution, es decir, que el modelo genere código como Playwright para operar la interfaz, mientras que Computer Tool sigue disponible como opción. La documentación también enfatiza que el hecho de que el modelo genere instrucciones de operación no significa que la operación ya haya tenido éxito: la aplicación debe ejecutarlas y luego verificar el resultado mediante una nueva captura de pantalla u otro método.
CUA Agent Kit, el proyecto de código abierto de CVS Health (Apache-2.0), ofrece otro enfoque de ingeniería. El mecanismo que expone su README es el siguiente: primero, un Computer-use Agent explora el flujo de trabajo y guarda capturas de pantalla, acciones y Trace como evidencia; después, Codex Skill convierte la trayectoria exitosa en código determinista, que pasa por revisión de ingenieros; las ejecuciones deterministas posteriores no requieren la clave del modelo. Esto separa “descubrir cómo hacerlo” y “hacerlo de forma repetible y estable” en dos problemas.
Análisis y juicio: cómo evaluar un agente médico realmente utilizable
¿Cómo evaluar un agente realmente utilizable?
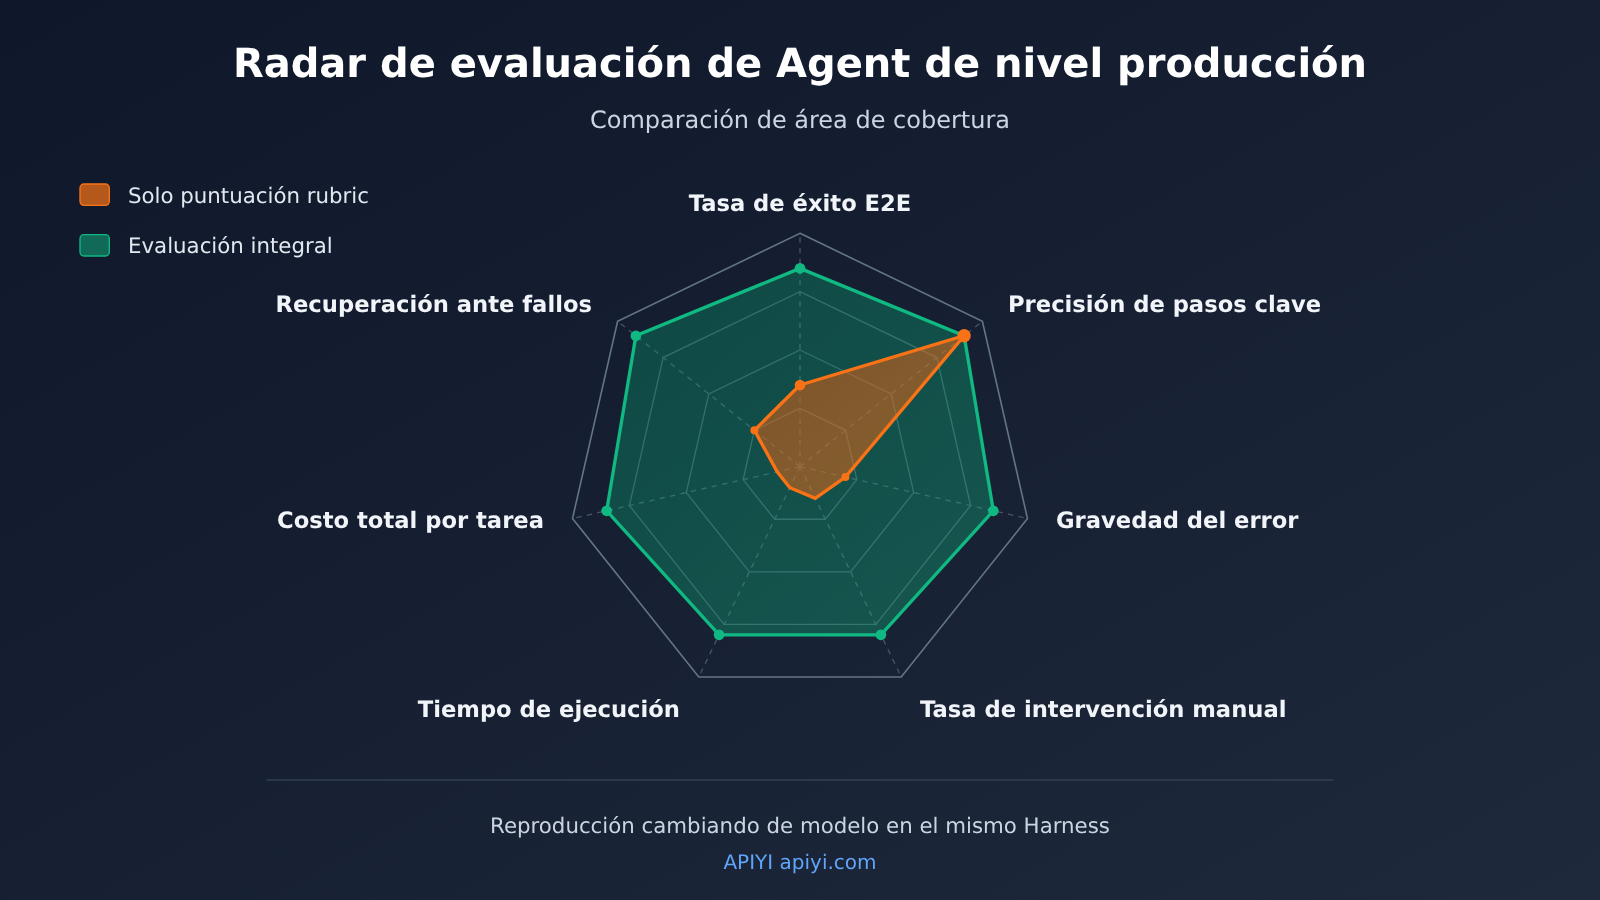
Lo siguiente es el juicio de este artículo, no un estándar oficial de ninguna institución. Consideramos que puntuaciones de rubric points como 94,3% sirven para responder «cuánto ha mejorado la capacidad específica del modelo», pero no bastan para responder «si se puede integrar en un flujo de producción». La última pregunta requiere un conjunto de métricas que se equilibran entre sí:
| Dimensión de evaluación | Qué mide | Por qué se necesita | Fuente de datos |
|---|---|---|---|
| Tasa de éxito de extremo a extremo | Proporción de tareas completas que cumplen todas las condiciones de éxito | El negocio solo valida el resultado final | Verificación del estado final del sistema |
| Precisión de los pasos clave | Tasa de acierto en nodos clave como seleccionar al paciente, enviar y subir adjuntos | Un error en un paso clave lo arruina todo | Comprobaciones deterministas |
| Gravedad del error | Si el fallo es una omisión recuperable o implica escribir datos incorrectos o enviar mensajes por error | Con la misma tasa de fallos, el riesgo puede variar enormemente | Revisión humana + etiquetas de clasificación |
| Tasa de intervención humana | Proporción que requiere intervención humana o aprobación de correcciones | Determina el ahorro real de mano de obra | Registro de aprobaciones |
| Tiempo de ejecución | Tiempo por tarea y tiempo de la cola larga | Afecta el rendimiento y las colas | Marcas de tiempo del trace |
| Costo total por tarea completa | Suma de modelo, capturas de pantalla, reintentos, entorno de ejecución y mantenimiento | El precio unitario por token no representa el costo real | Facturas + registros de ejecución |
| Capacidad de recuperación ante anomalías | Si puede detenerse o retroceder ante ambigüedades, tiempos de espera o cambios en la página | En escenarios médicos, debe «saber detenerse» | Pruebas de inyección de fallos |
El núcleo de este marco es informar por separado «cuántos pasos se hicieron bien» y «cuántas tareas se completaron», y luego corregir ambos con la gravedad del error y la tasa de intervención humana. La solución que presenta Ambience refleja precisamente la dimensión de «recuperación ante anomalías»: cuando hay ambigüedad en la historia clínica, el agente se detiene para consultar al médico y solo envía la solicitud de preautorización después de que el médico la apruebe. Esto es solo el esquema de gobernanza que muestra la empresa; no significa que todos los agentes médicos tengan la misma configuración por defecto.
El tamaño de la muestra y el número de repeticiones también deben hacerse públicos. Un estudio que compara RPA y agentes (DOI: 10.1080/23311975.2026.2724760) ejecutó 10 veces cada tecnología en los dos procesos P2 y P3, pero en P1 el agente se ejecutó solo una vez y falló, por lo que no se incluyó en el análisis estadístico posterior; el estudio utiliza una configuración de herramientas de 2025 y no puede tomarse como resultado directo de los modelos de 2026. Este ejemplo muestra que, al leer las conclusiones de una evaluación, primero hay que ver cuántas ejecuciones hay detrás de cada número y qué resultados quedaron excluidos.
Enfoques prácticos para evaluar Agentes médicos: ejecutar uno mismo con el mismo Harness
Para un equipo de desarrollo, el enfoque más práctico es fijar el marco de ejecución y, sobre su propio conjunto de tareas, medir al mismo tiempo dos conjuntos de métricas: las de subtarea y las de extremo a extremo. El ejemplo siguiente usa un LLM Judge para puntuar los materiales que entrega el Agent; la interfaz es compatible con el OpenAI SDK:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI, permite cambiar entre distintos modelos de juez
)

resp = client.chat.completions.create(
    model="YOUR_JUDGE_MODEL",
    messages=[
        {"role": "system", "content": "你是评测裁判,只输出 PASS 或 FAIL 及一句理由。"},
        {"role": "user", "content": "要求:附上影像报告与既往治疗记录。\n提交内容:<Agent 提交的材料摘要>"}
    ]
)
print(resp.choices[0].message.content)
Ver la implementación completa: calcular a la vez la tasa de éxito por subtarea y la de extremo a extremo
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class Subtask:
    name: str
    critical: bool          # Indica si es un paso crítico (si falla, toda la tarea falla)
    passed: bool = False

@dataclass
class TaskResult:
    task_id: str
    subtasks: list = field(default_factory=list)
    human_intervened: bool = False
    cost_usd: float = 0.0   # Ya incluye los Tokens de reintento, no volver a acumularlos

def llm_judge(requirement: str, submission: str, model: str) -> bool:
    """Usa un LLM Judge para subtareas difíciles de formalizar con reglas"""
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "只输出 PASS 或 FAIL。"},
            {"role": "user", "content": f"要求:{requirement}\n提交:{submission}"}
        ]
    )
    return resp.choices[0].message.content.strip().upper().startswith("PASS")

def summarize(results: list) -> dict:
    total_sub = sum(len(r.subtasks) for r in results)
    passed_sub = sum(s.passed for r in results for s in r.subtasks)
    full_success = sum(all(s.passed for s in r.subtasks) for r in results)
    critical_fail = sum(
        any(s.critical and not s.passed for s in r.subtasks) for r in results
    )
    n = len(results)
    return {
        "subtask_rate": passed_sub / total_sub,
        "end_to_end_rate": full_success / n,
        "critical_failure_rate": critical_fail / n,
        "human_intervention_rate": sum(r.human_intervened for r in results) / n,
        "avg_cost_usd": sum(r.cost_usd for r in results) / n,
    }
🎯 Recomendación técnica: conviene reportar en paralelo la puntuación por subtarea y la tasa de éxito de extremo a extremo, sobre el mismo Harness y el mismo lote de tareas. Gracias a la interfaz compatible con OpenAI de APIYI apiyi.com, puedes usar una sola clave API para alternar entre modelos como OpenAI, Claude o Gemini, ya sea como modelo de ejecución o como modelo de juez, lo que reduce las variables que introduce cada forma de integración.
Cálculo de costos y estratificación de modelos para agentes médicos
El precio unitario por token es solo el punto de partida. Según los precios Standard de contexto corto publicados por OpenAI el 17 de noviembre de 2026, GPT-6 Astra tiene precios de entrada, salida y entrada en caché de 10, 50 y 1 USD por millón de tokens, respectivamente; GPT-6 Luna, de 0,10, 0,50 y 0,01 USD. La velocidad de procesamiento, la longitud del contexto y la región también afectan la facturación real. Computer Use implica invocaciones de múltiples turnos, y cada captura de pantalla por turno cuenta como entrada visual; por eso, al calcular, conviene contabilizar por separado las entradas visuales y textuales y las salidas facturables de cada turno, y luego sumar las herramientas, el entorno de ejecución y el mantenimiento de ingeniería. Si los tokens consumidos por los reintentos ya están incluidos en el total, no hay que volver a sumarlos.
A juzgar por la diferencia entre 0,085 USD y unos 4,25 USD, la estratificación de modelos probablemente se convertirá en la norma: las tareas complejas que exigen un razonamiento sólido se encomendarán a modelos de alta capacidad; las tareas muy estructuradas y frecuentes, a modelos de bajo costo; y los flujos fijos que ya funcionan se consolidarán como código determinista, al estilo del enfoque de CVS. Cabe señalar que estos costos por tarea proceden de condiciones específicas de benchmark y no deben usarse como cotización para producción.
💰 Optimización de costos: antes de hacer una selección por niveles, conviene medir con un lote pequeño de tareas reales la tasa de éxito de extremo a extremo y el costo completo por tarea de cada modelo. APIYI apiyi.com aplica facturación por consumo y ofrece a los nuevos usuarios una cuota gratuita de prueba, ideal para completar este tipo de experimentos comparativos a bajo costo durante la fase de definición del proyecto.
Del Agent médico al Agent empresarial: un enfoque de evaluación transferible
La particularidad de la administración médica radica en su alto riesgo y su regulación estricta, pero los problemas que expone también están presentes en procesos empresariales como las reclamaciones de seguros, la conciliación financiera y los documentos de la cadena de suministro: múltiples sistemas, dependencias sólidas y traslado de datos entre sistemas. Nuestra conclusión es que los siguientes cuatro principios pueden transferirse directamente:
- Desglosar el informe: las puntuaciones de las subtareas y la tasa de éxito de extremo a extremo deben figurar por separado; nunca se debe usar la primera para sustituir la segunda.
- Etiquetar el nivel de evidencia: las demostraciones en entornos sintéticos, las autoevaluaciones de proveedores, los benchmarks de terceros, los pilotos empresariales y los casos de producción deben clasificarse por separado, sin mezclarlos.
- Fijar el Harness antes de comparar: en cuanto cambian el método de observación, la indicación o la guía del portal, los resultados dejan de ser comparables.
- La gobernanza tiene prioridad sobre las puntuaciones: el principio de mínimo privilegio, la aprobación humana de acciones críticas, la verificación del estado después de la operación, el registro completo de Trace y los mecanismos de parada ante anomalías deben establecerse como criterios de aceptación antes del lanzamiento.
Cuando se realiza un PoC dentro de la empresa, se puede etiquetar el conjunto de tareas según los “pasos críticos”, ejecutar primero una línea base de extremo a extremo y luego introducir gradualmente la guía del portal, la observación estructurada o la formalización en código, para observar la contribución real de cada cambio a la tasa de éxito completa. Si se necesita reproducir rápidamente el mismo lote de tareas entre varios modelos, se puede acceder de forma unificada a través de APIYI (apiyi.com), lo que reduce el costo de ingeniería de las comparaciones entre modelos.
Entre los desarrollos que vale la pena seguir de cerca se incluyen: si OpenAI hará públicos los resultados tarea por tarea y la configuración experimental detrás del 94.3%; si las versiones posteriores de HealthAdminBench publicarán, bajo el mismo criterio, la tasa de éxito en tareas completas de nuevos modelos; y si más instituciones podrán divulgar la tasa de intervención humana y los datos de clasificación de errores en entornos de producción reales. Antes de que aparezca esta información, cualquier afirmación de que “la administración médica ya puede automatizarse por completo” es una especulación.
El 94.3% demuestra un avance significativo del modelo en los puntos de evaluación, mientras que el 36.3% recuerda que la capacidad de completar de forma fiable un proceso de negocio debe comprobarse, en última instancia, con tareas completas, sistemas reales y supervisión humana. Como dice el proverbio inglés: “The proof of the pudding is in the eating.” (Para saber si el pudín está bueno, hay que comerlo; el efecto real se comprueba en la práctica.)
Referencias
- OpenAI: Advancing computer-use agents for healthcare teams: datos de evaluación como 94,3 %, 91,8 %, 99 % y 93 %, junto con casos de colaboración
- Enlace:
openai.com/index/advancing-computer-use-for-healthcare-teams/
- Enlace:
- Artículo HealthAdminBench 2604.09937v1: 135 tareas, 1.698 subtareas, resultados por apartado y experimentos de ablación
- Enlace:
arxiv.org/html/2604.09937v1
- Enlace:
- Página del proyecto HealthAdminBench y repositorio de código: entorno de referencia e implementación de la evaluación
- Enlace:
som-shahlab.github.io/health-admin-bench-website/ - Enlace:
github.com/som-shahlab/health-admin-bench
- Enlace:
- Página de investigación inicial del Stanford Shah Lab: versión histórica con 70 tareas y 947 puntos de puntuación
- Enlace:
shahlab.stanford.edu/doku.php?id=healthadminbench
- Enlace:
- Documentación para desarrolladores de OpenAI Computer Use y precios de la API: ruta de ejecución y precio Standard
- Enlace:
developers.openai.com/api/docs/guides/tools-computer-use - Enlace:
developers.openai.com/api/docs/pricing
- Enlace:
- CVS Health CUA Agent Kit: mecanismos de exploración, recopilación de evidencia, consolidación del código y revisión por parte de ingenieros
- Enlace:
github.com/cvs-health/cua-agent-kit
- Enlace:
- Estudio comparativo entre RPA y Agent: número de ejecuciones repetidas y aclaraciones sobre las excepciones P1
- Enlace:
doi.org/10.1080/23311975.2026.2724760
- Enlace:
- Cambridge Dictionary: definición del proverbio proof of the pudding is in the eating
- Enlace:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- Enlace:
Autor: equipo técnico de APIYI
Contacto técnico: te invitamos a visitar APIYI apiyi.com para conversar con nosotros sobre prácticas de evaluación de Agent; para más detalles de integración, puedes consultar el centro de documentación docs.apiyi.com


