
Nota del autor: los agentes que gestionan varios proyectos necesitan contexto independiente, estado persistente, planificación de tareas y mecanismos de recuperación. Solo así el trabajo en paralelo resulta trazable y cada tarea no interfiere con las demás.
Que un asistente de IA pueda avanzar varios proyectos a la vez depende de cuatro cosas: que cada trabajo tenga su propio contexto, que el estado de ejecución se conserve de forma persistente, que un planificador centralice prioridades y concurrencia, y que tras una interrupción se pueda reanudar desde un punto de control. Llamar a varios modelos al mismo tiempo no es lo complicado; lo complicado es que cada una de esas llamadas recuerde qué está haciendo. Dots, lanzado por OpenAI el 29 de septiembre de 2026, sigue este patrón. La documentación oficial indica que un Dot puede mantener varios frentes de trabajo y repartirlos entre agentes en segundo plano para procesarlos en paralelo. Cada tarea nueva tiene su propio contexto de conversación y no hereda automáticamente todo el historial entre el usuario y el Dot. Los desarrolladores pueden montar sistemas parecidos de gestión multiproyecto con Checkpointer, Store, colas de tareas y máquinas de estado.
A continuación, primero desglosamos, a partir de los materiales oficiales, el mecanismo multitarea y de memoria de Dots; después, con un ejemplo transversal de gestión de proyectos, diseñamos en orden una estructura de tareas en cuatro capas, planificación paralela, recuperación tras interrupciones, seguimiento de ejecución y límites de costos. Los “diez proyectos” del título son solo una forma de ilustrar el modo de trabajo: ni Dots ni un sistema propio tienen una concurrencia fija de diez flujos, ni pueden paralelizar de forma ilimitada. El código del agente propio que aparece en el artículo es una propuesta de diseño; no incluye resultados de ejecución inventados.
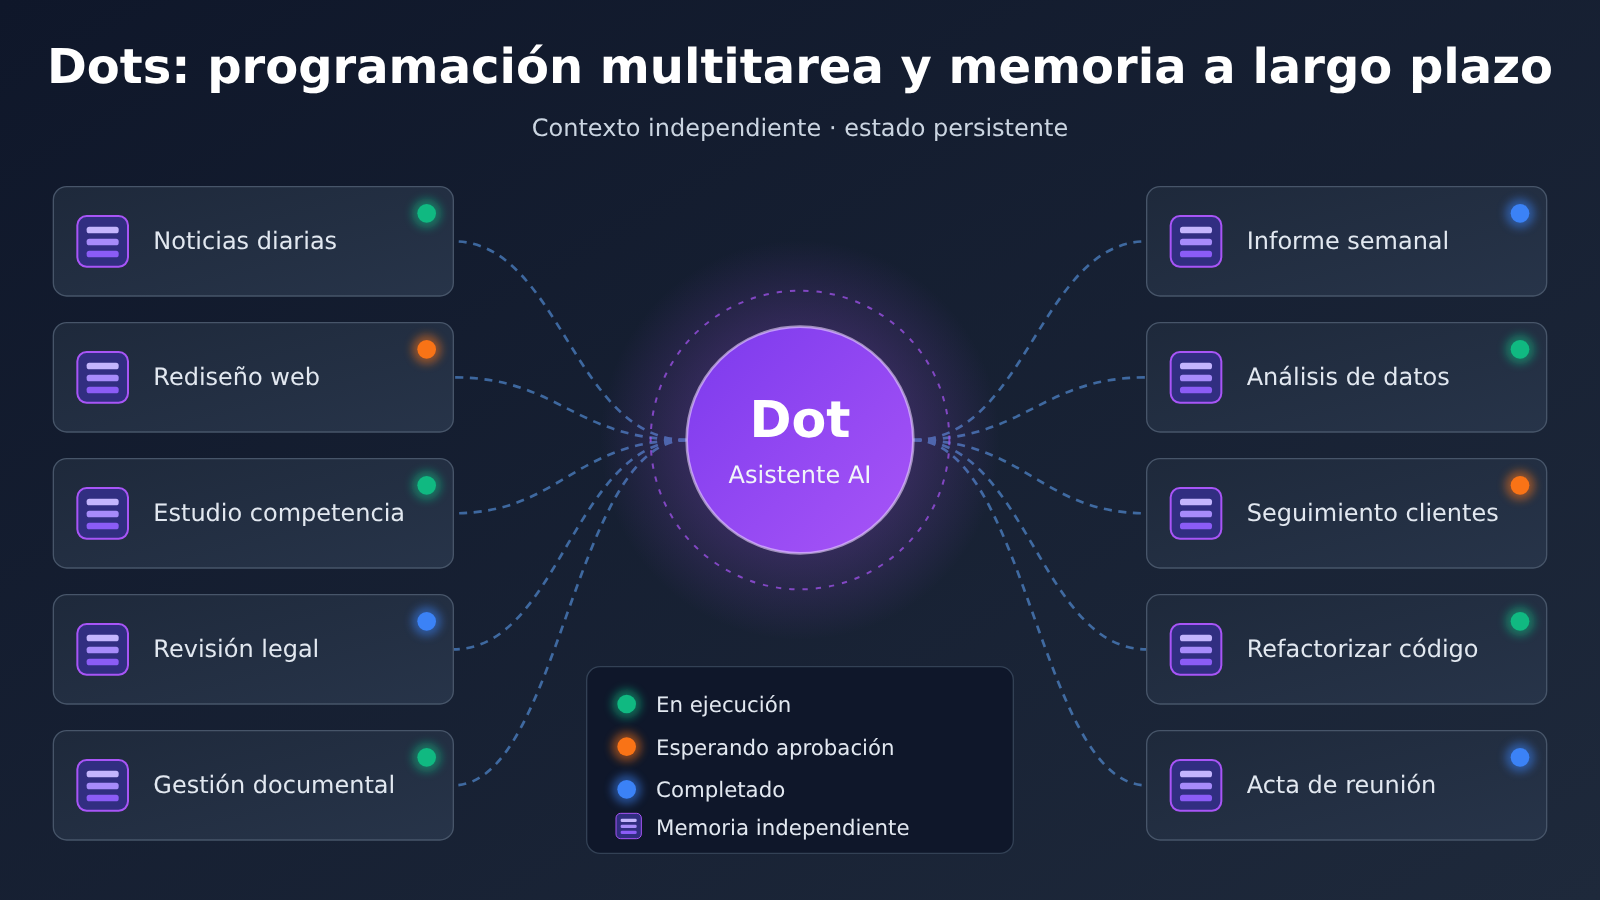
Para conocer: Terminología de la programación multitarea de Dots
| Término | Explicación |
|---|---|
| Workspace | Espacio de trabajo donde se organizan los proyectos y los permisos; normalmente corresponde a un usuario o a un equipo. |
| Project | Unidad de proyecto que agrupa objetivos, materiales y las tareas relacionadas. |
| Task | Un trabajo con un objetivo concreto, por ejemplo «consultar las noticias de OpenAI de hoy». |
| Run | El registro de una ejecución concreta de una tarea; un mismo Task puede ejecutarse muchas veces. |
| Agente en segundo plano | El agente que Dots envía para procesar subtareas en paralelo y que, al terminar, rinde cuentas a Dots. |
| Checkpointer | Componente que guarda los puntos de control de la ejecución de las tareas y se encarga de reanudarlas después de una interrupción. |
| Store | Componente de almacenamiento que conserva información de largo plazo entre tareas y se encarga de mantener el contexto del proyecto. |
| Máquina de estados | Mecanismo que gestiona, según reglas, las transiciones entre las distintas fases de una tarea, como pendiente de ejecución, en ejecución o esperando aprobación. |
| Límite de concurrencia | Número máximo de tareas que pueden ejecutarse a la vez; está sujeto a la cuota de API, a los recursos del servidor y a los costos. |
| Tracing | Capacidad de trazabilidad que registra las invocaciones del modelo, las llamadas a herramientas y el proceso de traspaso. |
| Proactive Research | Investigación de solo lectura en segundo plano que Dots realiza, cuando no hay mensajes nuevos, sobre las fuentes de información autorizadas. |
1 Orquestación multitarea de Dots: cómo un solo Dot puede asumir varias responsabilidades a la vez
1.1 Capacidades multiproyecto que Dots presenta oficialmente
Según la descripción oficial, Dots es un agente personal persistente. Dispone de su propia computadora en la nube y su propio navegador, y puede seguir avanzando en el trabajo delegado incluso cuando el usuario se ausenta. En cuanto a la multitarea, el documento Tasks and memory enumera las siguientes capacidades:
- Mantener simultáneamente el estado de varios asuntos de trabajo y cambiar de tarea dentro de la misma conversación.
- Permitir que el usuario añada información o ajuste prioridades en cualquier momento.
- Dividir tareas complejas en varias partes y entregarlas a agentes en segundo plano para que las procesen en paralelo.
- Crear hilos de tareas visibles e independientes, y luego recopilar y consolidar los resultados de cada tarea.
- Solicitar la intervención del usuario cuando el trabajo se bloquea; mientras las tareas en segundo plano se ejecutan, el usuario puede seguir enviando mensajes.
En conjunto, estas capacidades hacen que el papel de Dot se parezca más al de un coordinador de proyectos. Dot decide qué se hace primero, qué se delega y qué se devuelve al usuario; la ejecución concreta de cada tarea puede quedar a cargo de agentes en segundo plano, tareas de ChatGPT Work o tareas de Codex.
1.2 Diferencias entre múltiples conversaciones, multitarea y múltiples agentes
Estos tres conceptos se confunden a menudo, pero resuelven problemas distintos. Veámoslo con un ejemplo común: supongamos que el espacio de trabajo del usuario tiene tres proyectos: AI Radar (boletín diario de noticias de IA), Website (rediseño del sitio web) e Research (investigación de la competencia).
| Modo | Cómo funciona | Cómo se ve en el ejemplo | Problema que resuelve |
|---|---|---|---|
| Múltiples conversaciones | El usuario abre una ventana de chat para cada proyecto | El usuario debe recordar por su cuenta en qué punto quedó Research | Aísla el contenido del chat, pero el progreso sigue en manos de la persona |
| Multitarea | Un coordinador mantiene el estado de varias tareas | Dot registra el progreso y la prioridad de cada uno de los tres proyectos | Orquestación unificada y seguimiento del estado |
| Múltiples agentes | El coordinador distribuye subtareas entre varios ejecutores | Un agente en segundo plano recopila información y otro ejecutor redacta el informe | Ejecución en paralelo y división del trabajo por especialidad |
Dots combina las tres capas: el usuario se comunica con Dot desde un único punto de entrada, Dot mantiene múltiples tareas y, cuando hace falta, envía agentes en segundo plano. Para replicar este efecto con un sistema propio, hay que implementar las tres capacidades; abrir varias ventanas de chat dista mucho de ser suficiente.
1.3 Observaciones de paralelismo relatadas por un usuario
Un usuario de Reddit relató una prueba que hizo durante un día. Entregó a Dot cientos de PDF y miles de páginas de documentos para que los revisara, mientras ejecutaba en paralelo una tarea de investigación legal. Observó que había tres procesos de ejecución simultáneos: la propia computadora en la nube de Dot procesaba la tarea A, una computadora Linux que había conectado procesaba la tarea B y otro agente de investigación en segundo plano procesaba la tarea C. También mencionó que, al iniciar la tarea independiente de investigación legal, se encontró con que el entorno de ejecución no estaba disponible y que solo pudo despachar la tarea después de conectar su computadora local.
Esta observación personal indica que la computadora en la nube de Dot, la computadora local y los entornos Work/Codex son recursos de ejecución distintos. El propio autor señala que no verificó si esas rutas disponen de cuotas independientes e ilimitadas. Por tanto, esta prueba solo demuestra que Dots puede distribuir trabajo entre distintos entornos; no permite deducir que todos los usuarios Pro obtengan el mismo nivel de paralelismo.
2 Dots: memoria a largo plazo — por qué una tarea necesita memoria independiente
2.1 Los límites de contexto de una nueva tarea
La documentación oficial lo dice con claridad: cada tarea nueva tiene su propio contexto de conversación y no recibe automáticamente todo el historial de conversaciones entre Dot y el usuario. Dot puede buscar conversaciones pasadas de ChatGPT para encontrar contexto, pero ese contenido recuperado se usa únicamente como contexto para el trabajo actual.
Este diseño es muy práctico. Si cada tarea cargara todo el historial, un informe de competidores del proyecto Research podría mezclarse con las discusiones sobre el rediseño del proyecto Website, y el contexto se volvería cada vez más largo y más caro. Los proyectos de largo plazo necesitan gestionar de forma explícita «qué debería saber esta tarea»; depender solo de un historial de chat que no deja de crecer no permite lograrlo.
2.2 Las cuatro capas de datos de la memoria de Dots
Según la información oficial, el contexto de Dot proviene de cuatro fuentes distintas:
- ChatGPT Memory: Dot puede leer los recuerdos relevantes y las conversaciones recientes de ChatGPT;
- Las notas del propio Dot: acumulan preferencias del usuario, hábitos de trabajo, decisiones de proyecto y responsabilidades de largo plazo;
- Contexto de la tarea actual: las instrucciones, archivos, resultados de búsqueda y resultados de ejecución de herramientas de esta conversación;
- Datos de aplicaciones conectadas: Dot lee los datos de aplicaciones autorizadas y puede formar memoria mediante investigación proactiva.
Estas capas tienen ciclos de vida distintos. ChatGPT Memory y las notas de Dot pertenecen a capas de datos diferentes: desactivar el uso compartido de ChatGPT Memory no elimina automáticamente la información que Dot ya ha obtenido, y desconectar un complemento solo detiene nuevos accesos. A 16 de noviembre de 2026, los usuarios todavía no pueden revisar, modificar ni eliminar una por una la memoria independiente de Dot; eliminar Dot activa la eliminación de su propio contexto. Al diseñar la capa de memoria de un sistema propio, este enfoque por capas puede servir de referencia, añadiendo además una interfaz de gestión donde se pueda consultar y eliminar la información.
3 Checkpointer y Store: los dos tipos de memoria de un agente multitarea
La documentación de persistencia de LangGraph divide la memoria de un agente en dos categorías, una clasificación que encaja perfectamente con el “contexto de tarea” y las “notas a largo plazo” de Dots. A continuación seguimos usando como ejemplo el informe mensual de competidores del proyecto Research.
3.1 Checkpointer: recordar hasta qué paso se ha llegado
Checkpointer guarda una instantánea de ejecución de un hilo de tarea individual, que incluye el paso actual, las herramientas invocadas, los resultados devueltos por las herramientas y qué paso está esperando aprobación humana. En el ejemplo, la tarea del informe mensual ya había terminado de extraer las páginas de precios de 6 competidores y estaba a punto de analizarlas cuando se reinició el servicio. Gracias al checkpoint, la tarea puede continuar desde el paso “análisis” sin tener que volver a extraer los materiales ya obtenidos.
El medio de almacenamiento determina si los checkpoints sobreviven a un reinicio. Una implementación en memoria es adecuada para desarrollo y pruebas, pero el estado se pierde cuando el proceso se reinicia; para persistencia local se puede usar SQLite, mientras que los servicios desplegados a largo plazo encajan mejor con PostgreSQL. Los checkpoints crecen continuamente, por lo que los sistemas en producción también deben definir una política de limpieza para los estados antiguos.
3.2 Store: recordar el contexto del proyecto
Store guarda información a largo plazo que trasciende tareas y sesiones, como las preferencias del usuario, el contexto del proyecto, las decisiones históricas y el conocimiento compartido entre varias tareas. En el ejemplo, “los lectores del informe son el equipo de producto”, “solo se hace seguimiento a los precios de API y a las actualizaciones de funciones” y “el mes pasado se decidió dejar de seguir a un competidor que dejó de actualizarse” son todos contenidos de Store. Cuando el mes siguiente se crea una nueva tarea de informe, esta leerá esas decisiones, y el usuario no tendrá que volver a explicarlas.
3.3 Comparación de responsabilidades entre Checkpointer y Store
| Dimensión | Checkpointer | Store |
|---|---|---|
| Alcance | Un hilo de tarea individual | Varias tareas, entre hilos |
| Contenido almacenado | Instantánea del estado de ejecución | Información y hechos a largo plazo |
| Valor principal | Reanudar el trabajo tras una interrupción | Dar continuidad al contexto del proyecto en nuevas tareas |
| Contenido de ejemplo | “Se extrajeron las páginas de precios de 6 competidores; el siguiente paso es el análisis” | “Los lectores del informe son el equipo de producto” |
| Ciclo de vida | Sigue el estado de la tarea y puede limpiarse al completarse | Se conserva y actualiza según la estrategia de memoria a largo plazo |
Ambos tienen responsabilidades claras y ninguno es prescindible. Con solo Checkpointer, cada tarea nueva es como la incorporación de un empleado nuevo; con solo Store, cualquier interrupción de la tarea obliga a empezar de cero.
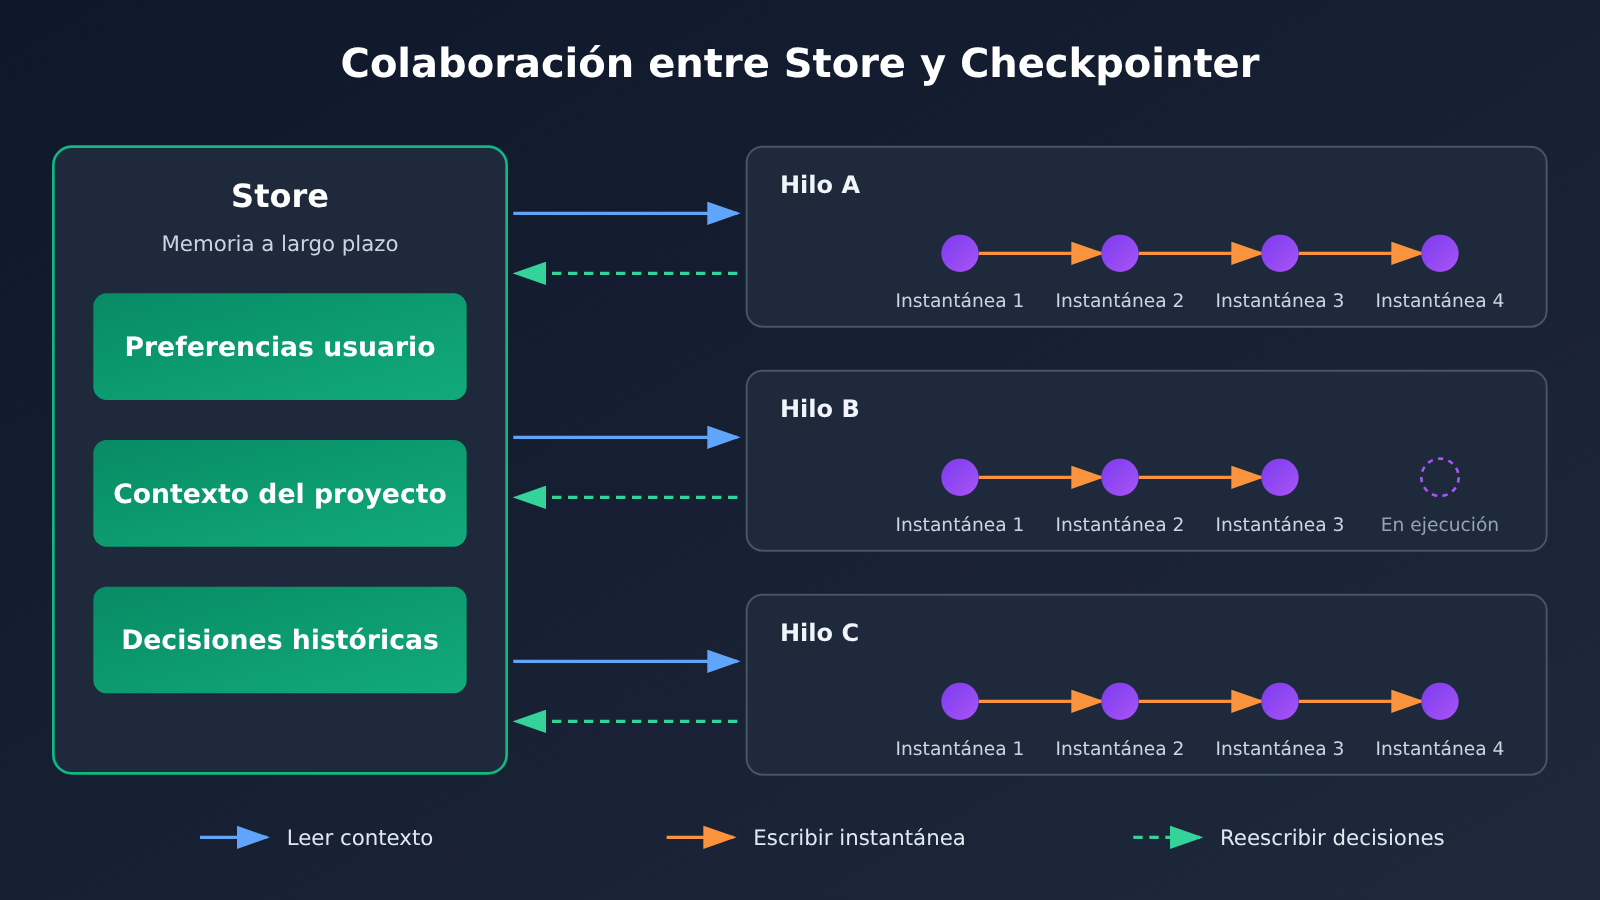
El ciclo “leer el contexto — escribir instantáneas — reescribir las decisiones” de la figura anterior se puede asignar directamente al código de la sección 6. El código de ejemplo invoca el modelo a través de la interfaz compatible con OpenAI de APIYI apiyi.com; para cambiar de modelo, solo hay que modificar el nombre del modelo.
4 Diseño de un sistema de gestión de tareas multiproyecto: Workspace, Project, Task, Run
4.1 Estructura de cuatro niveles e IDs independientes
Para un Agent multiproyecto autoalojado, se recomienda adoptar una estructura de cuatro niveles, donde cada nivel tiene su propio ID:
| Nivel | Función | Ejemplo |
|---|---|---|
| Workspace | Gestiona el espacio de trabajo y los permisos de un usuario | regulus |
| Project | Gestiona los objetivos y materiales de un proyecto independiente | AI Radar, Website, Research |
| Task | Gestiona tareas concretas | Daily News, Monthly Report |
| Run | Registra una ejecución real | Ejecución de Daily News el 2026-11-16 09:00 |
La estructura de árbol correspondiente queda así:
Workspace: regulus
├── Project: AI Radar
│   ├── Task: Daily News
│   │   ├── Run: 2026-11-16
│   │   └── Run: 2026-11-17
│   └── Task: Topic Discovery
├── Project: Website
│   ├── Task: UI Improvement
│   └── Task: Bug Fix
└── Project: Research
    ├── Task: Competitor Analysis
    └── Task: Monthly Report
Separar el registro de Task y Run es clave. Daily News se ejecuta una vez al día, y cada Run tiene sus propias entradas, salidas, tiempo de ejecución y estado; si surge algún problema, puedes localizar con precisión la ejecución concreta de un día determinado.
4.2 Alcance de acceso a la memoria y aislamiento entre proyectos
Cuando un Agent gestiona varios proyectos, los archivos de cada proyecto no pueden leerse entre sí de forma predeterminada. Se recomienda dividir el alcance de acceso a la memoria por niveles:
- Preferencias generales del usuario (por ejemplo, informes en chino, conclusión primero): legibles por todos los proyectos autorizados;
- Contexto del proyecto (por ejemplo, los lectores y el alcance de seguimiento de Research): legible solo por las tareas de ese proyecto;
- Registros de una tarea individual: legibles solo por la tarea actual y las tareas relacionadas autorizadas explícitamente;
- Materiales de clientes corporativos: legibles solo por el proyecto del cliente designado;
- Credenciales sensibles: se guardan en un almacenamiento seguro independiente y nunca entran en el contexto del modelo.
Al compartir materiales entre proyectos, hay que registrar la fuente y el alcance de la autorización. Esto coincide con el enfoque de Dots: la documentación oficial indica que el contexto de Dot no conserva credenciales, imágenes ni capturas de pantalla, y que los límites de permisos se controlan conjuntamente mediante la autorización de plugins y las Custom Rules.
5 Planificación de múltiples tareas: cómo ejecutar tareas en paralelo sin que se interfieran
5.1 Separar el planificador del razonamiento del agente
Conviene delegar el «cuándo hacerlo» y el «cómo hacerlo» a dos componentes distintos. El planificador se encarga del momento de inicio, la selección de proyectos, el número de ejecuciones en curso, la prioridad, los tiempos de espera y los reintentos; el agente se encarga de comprender la tarea, definir los pasos, elegir herramientas, analizar los resultados y entregar los productos finales. Así, las reglas de planificación pueden ejecutarse de forma determinista y el modelo solo se ocupa de la parte que requiere razonamiento.
Para la elección tecnológica, se puede tomar como referencia esta combinación: APScheduler gestiona las tareas periódicas, Celery actúa como cola de tareas en segundo plano, Redis se encarga de los mensajes y de la coordinación a corto plazo, PostgreSQL guarda el estado de los proyectos y de las ejecuciones, y frameworks como LangGraph gestionan el flujo del agente y el estado persistente. Para un prototipo a pequeña escala, asyncio de Python junto con SQLite también puede funcionar; el código de la sección 6 está diseñado precisamente así.
5.2 Tres formas de paralelismo
En un agente multitarea hay al menos tres formas de paralelismo:
- Paralelismo de tareas independientes: las noticias diarias de AI Radar y el informe mensual de Research no dependen entre sí, así que pueden ejecutarse al mismo tiempo;
- Paralelismo de subtareas: un proyecto se divide en subtareas como recopilación de información y verificación de hechos, que se ejecutan por separado;
- Paralelismo de roles de modelo: distintos modelos se encargan de diferentes tareas especializadas y, al final, los resultados se consolidan.
Las restricciones que determinan si las tareas pueden ejecutarse en paralelo incluyen la cuota de concurrencia de la API, los recursos del servidor, las dependencias entre tareas, la contención de escritura en la base de datos, el costo del modelo, los conflictos entre resultados y la ejecución duplicada.
5.3 Ejemplo: recopilación de información, análisis de datos y generación de informes
El informe mensual del proyecto Research se divide en tres subtareas. La recopilación de información puede ejecutarse en paralelo con las noticias diarias de AI Radar; el análisis de datos depende de los resultados de la recopilación, por lo que debe esperar a que esta termine; la generación del informe depende de las conclusiones del análisis y, una vez completada, pasa a un estado pendiente de aprobación, y solo se considera entregada cuando el usuario la confirma.
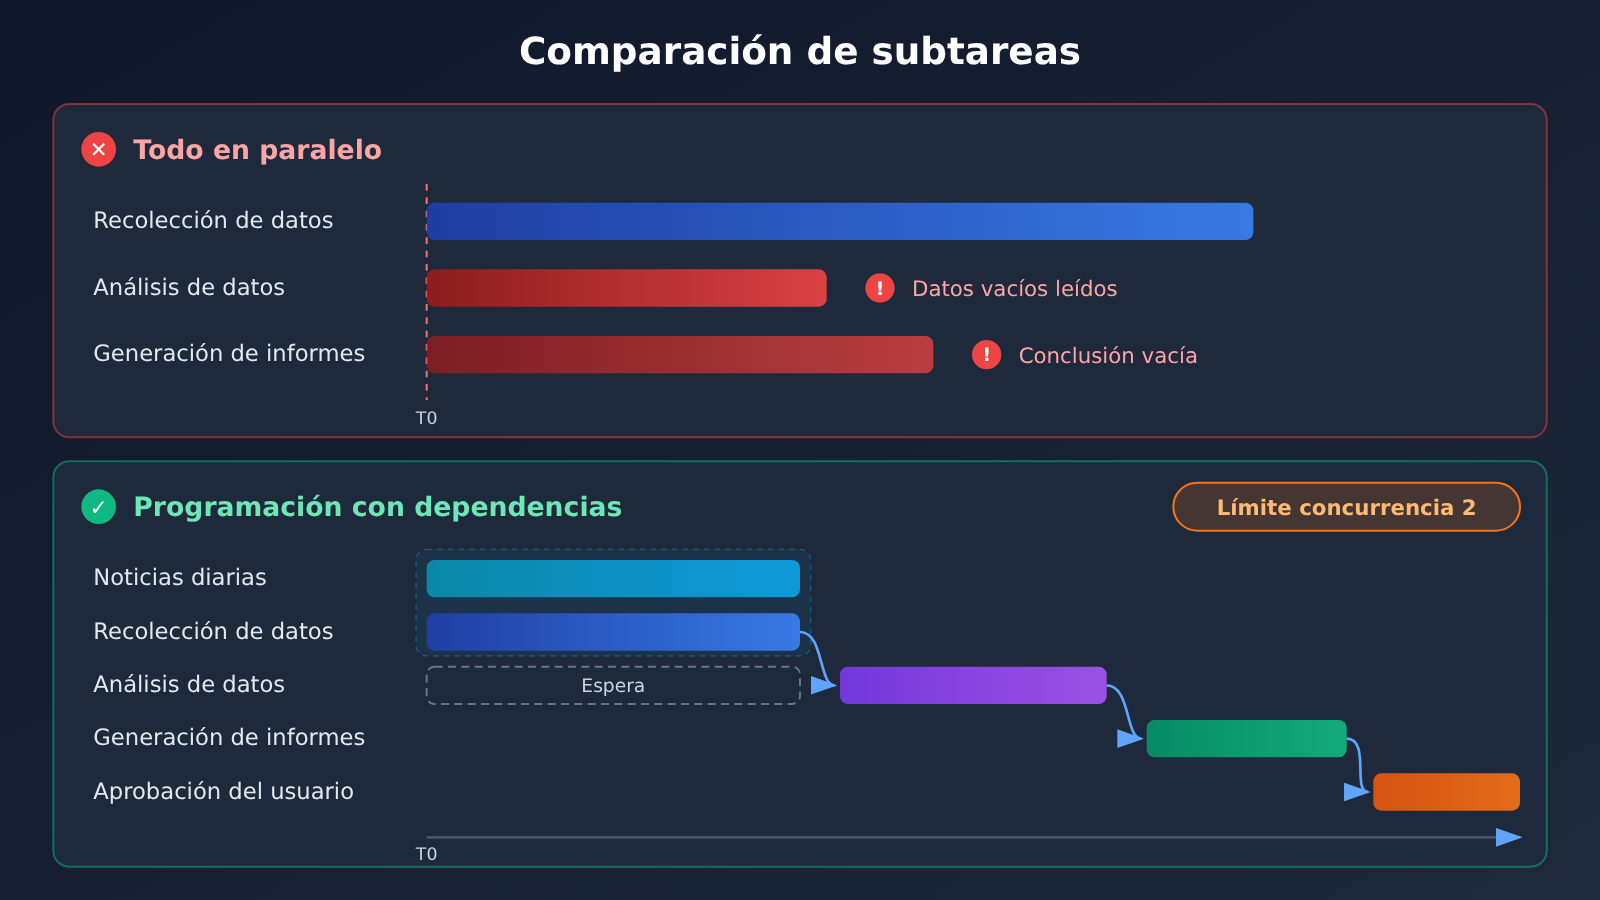
Lanzar las tres subtareas a la vez parece más rápido, pero el análisis de datos, al no recibir la información, puede generar conclusiones vacías o incluso inventar datos por su cuenta. Las dependencias determinan qué tareas deben ejecutarse en serie, y el límite de concurrencia determina cuántas pueden ejecutarse a la vez; ambos aspectos deberían incorporarse en el planificador, porque dejar que el modelo decida sobre la marcha es muy propenso a errores.
5.4 Asignación de roles entre modelos
| Subtarea | Tipo de modelo recomendado | Motivo de la elección | Plataforma disponible |
|---|---|---|---|
| Recopilación de información y resumen | Modelo ligero y rápido | Alto volumen de invocaciones y sensible al costo | APIYI apiyi.com, API oficial |
| Análisis de datos | Modelo con gran capacidad de razonamiento | Requiere comparaciones y cálculos de varios pasos | APIYI apiyi.com, API oficial |
| Generación de informes | Modelo con buena capacidad de redacción de textos largos | Altos requisitos de estructura y calidad de expresión | APIYI apiyi.com, API oficial |
| Verificación de hechos | Un modelo distinto del modelo de redacción | Validación cruzada para reducir errores de la misma fuente | APIYI apiyi.com, API oficial |
Los modelos concretos se eligen según la lista de modelos vigente en la plataforma. Cuando una misma clave API se conecta con varios modelos, la asignación de roles puede ajustarse mediante configuración, sin necesidad de modificar la estructura del código.
6 Primeros pasos: construir un prototipo de Agent multitarea con una interfaz unificada
6.1 Ejemplo minimalista: inyectar el contexto del proyecto en la tarea
El siguiente código muestra el punto más importante: antes de ejecutar la tarea, tomar de la memoria a largo plazo únicamente el contexto del proyecto al que pertenece.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

# Store: memoria a largo plazo aislada por proyecto
project_memory = {
    "research": "读者:产品团队;只跟踪 API 价格与功能更新;报告结论先行",
    "ai-radar": "每日 09:00 汇总 OpenAI、Anthropic、Google 官方动态",
}

def run_task(project_id: str, goal: str) -> str:
    resp = client.chat.completions.create(
        model="gpt-4.1-mini",
        messages=[
            {"role": "system", "content": f"项目背景:{project_memory[project_id]}"},
            {"role": "user", "content": goal},
        ],
    )
    return resp.choices[0].message.content

print(run_task("research", "列出本月需要关注的竞品更新清单"))
6.2 Diseño completo: máquina de estados, checkpoints, dependencias y concurrencia
El siguiente código es una propuesta de diseño que abarca Store, Checkpoint, la máquina de estados, la programación de dependencias, los límites de concurrencia, los reintentos, los tiempos de espera y el registro de ejecución, y sirve para mostrar cómo colaboran entre sí los distintos componentes. No ha sido validado en un entorno de producción, y el artículo tampoco presenta resultados de ejecución inventados.
Ver el código del diseño completo
import asyncio, json, sqlite3, time, uuid
from dataclasses import dataclass, field
from enum import Enum
from openai import AsyncOpenAI

client = AsyncOpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI: una sola clave para alternar entre varios modelos
)

class Status(str, Enum):
    PENDING = "pending"; RUNNING = "running"; WAITING = "waiting"
    APPROVAL = "approval"; COMPLETED = "completed"
    FAILED = "failed"; CANCELLED = "cancelled"; PAUSED = "paused"

db = sqlite3.connect("agent.db")
db.executescript("""
CREATE TABLE IF NOT EXISTS store(
  scope TEXT, key TEXT, value TEXT, source TEXT, PRIMARY KEY(scope, key));
CREATE TABLE IF NOT EXISTS checkpoint(
  run_id TEXT, task_id TEXT, step TEXT, state TEXT, ts REAL);
CREATE TABLE IF NOT EXISTS runs(
  run_id TEXT PRIMARY KEY, workspace_id TEXT, project_id TEXT, task_id TEXT,
  model_id TEXT, input_tokens INT, output_tokens INT,
  duration REAL, retry_count INT, final_status TEXT);
""")

def store_get(scopes: list[str]) -> str:
    """Solo lee los ámbitos autorizados: user y project:<id>"""
    marks = ",".join("?" * len(scopes))
    rows = db.execute(f"SELECT key, value FROM store WHERE scope IN ({marks})", scopes)
    return "\n".join(f"- {k}: {v}" for k, v in rows)

def save_checkpoint(run_id, task_id, step, state):
    db.execute("INSERT INTO checkpoint VALUES (?,?,?,?,?)",
               (run_id, task_id, step, json.dumps(state, ensure_ascii=False), time.time()))
    db.commit()

def log_run(run_id, task, usage, duration, retries, status):
    db.execute("INSERT OR REPLACE INTO runs VALUES (?,?,?,?,?,?,?,?,?,?)",
               (run_id, "regulus", task.project_id, task.task_id, task.model,
                getattr(usage, "prompt_tokens", 0), getattr(usage, "completion_tokens", 0),
                duration, retries, status.value))
    db.commit()

@dataclass
class Task:
    task_id: str
    project_id: str
    goal: str
    model: str
    depends_on: list[str] = field(default_factory=list)
    needs_approval: bool = False

async def run_task(task: Task, done: dict, sem: asyncio.Semaphore,
                   max_retry: int = 2, timeout: int = 120):
    run_id = f"run-{uuid.uuid4().hex[:8]}"
    background = store_get(["user", f"project:{task.project_id}"])
    upstream = "\n\n".join(done[d] for d in task.depends_on)
    messages = [
        {"role": "system", "content": f"长期背景:\n{background}"},
        {"role": "user", "content": f"{task.goal}\n\n上游结果:\n{upstream or '无'}"},
    ]
    async with sem:  # Límite de concurrencia
        for attempt in range(max_retry + 1):
            start = time.time()
            save_checkpoint(run_id, task.task_id, f"attempt-{attempt}", messages)
            try:
                resp = await asyncio.wait_for(
                    client.chat.completions.create(model=task.model, messages=messages),
                    timeout)
                output = resp.choices[0].message.content
                status = Status.APPROVAL if task.needs_approval else Status.COMPLETED
                log_run(run_id, task, resp.usage, time.time() - start, attempt, status)
                save_checkpoint(run_id, task.task_id, status.value, {"output": output})
                if status == Status.COMPLETED:
                    done[task.task_id] = output
                return
            except Exception as e:  # Timeout o error de API: reintentar con backoff exponencial
                save_checkpoint(run_id, task.task_id, "error", {"error": str(e)})
                await asyncio.sleep(2 ** attempt)
        log_run(run_id, task, None, 0, max_retry, Status.FAILED)

async def schedule(tasks: list[Task], max_concurrency: int = 2) -> dict:
    sem = asyncio.Semaphore(max_concurrency)
    done: dict[str, str] = {}
    pending = {t.task_id: t for t in tasks}
    while pending:
        ready = [t for t in pending.values() if all(d in done for d in t.depends_on)]
        if not ready:  # Tarea predecesora fallida, pendiente de aprobación o dependencia circular
            print("阻塞任务:", list(pending))
            break
        await asyncio.gather(*(run_task(t, done, sem) for t in ready))
        for t in ready:
            pending.pop(t.task_id)
    return done

tasks = [
    Task("daily-news", "ai-radar", "汇总今日 AI 官方动态", "gpt-4.1-mini"),
    Task("collect", "research", "收集本月竞品 API 价格与功能变更", "gpt-4.1-mini"),
    Task("analyze", "research", "对比变更并归纳趋势", "gpt-4.1", depends_on=["collect"]),
    Task("report", "research", "生成月度竞品报告", "gpt-4.1",
         depends_on=["analyze"], needs_approval=True),
]
asyncio.run(schedule(tasks))
El código incluye varios puntos que conectan con el diseño descrito antes. store_get lee únicamente el usuario y el ámbito del proyecto actual, lo que implementa el aislamiento entre proyectos; la tabla checkpoint registra cada paso por ejecución, mientras que la tabla runs guarda los tokens y el estado final; schedule usa las dependencias para decidir qué se ejecuta en serie y un semáforo para limitar la concurrencia. A un sistema real todavía le faltaría añadir llamadas a herramientas, callbacks de aprobación y un punto de entrada para la recuperación.
🚀 Inicio rápido: durante la fase de prototipo, te recomendamos obtener crédito de prueba gratuito a través de APIYI apiyi.com; usa la misma clave para configurar modelos distintos en los tres roles —recolección, análisis y redacción— y compara resultados y costos antes de decidir cómo repartir el trabajo.
7 Cómo un agente multitarea maneja interrupciones, fallos y aprobación humana
7.1 Máquina de estados de las tareas
El progreso de las tareas debe quedar registrado mediante estados explícitos; lo que el modelo describe en el chat sobre el progreso solo sirve como referencia. El flujo principal recomendado es Pending (pendiente de ejecución) → Running (en ejecución) → Waiting (esperando condiciones externas) o Approval (esperando aprobación) → Completed (completado), con otros tres estados de terminación o pausa: Failed, Cancelled y Paused. Cada transición de estado se escribe en la base de datos, y el planificador toma decisiones basándose únicamente en el estado almacenado allí.
7.2 Reintentos, timeouts y reanudación tras una pausa
- Reintentos: tras errores de API o timeouts, reintentar con retroceso exponencial y registrar
retry_count, para detectar pasos que fallan con frecuencia; - Timeouts: cada Run tiene un límite de ejecución; si se excede, pasa a Failed y se genera una alerta, evitando que una tarea bloqueada ocupe durante mucho tiempo un slot de concurrencia;
- Reanudación tras una pausa: guardar checkpoints al pausar y continuar desde el último checkpoint al reanudar; las llamadas a herramientas que ya se completaron no necesitan repetirse;
- Idempotencia: en pasos con efectos secundarios, como enviar correos o escribir en la base de datos, comprobar antes de reintentar si ya se ejecutaron, para evitar operaciones duplicadas.
En la documentación oficial de Dots hay un detalle relacionado: detener una tarea que está en ejecución y cancelar un plan periódico ya creado son dos cosas distintas. Al pausar un Dot, es posible que Work, Codex y las tareas programadas independientes sigan ejecutándose. Un sistema propio debería tratar «detener este Run», «pausar Task» y «cancelar el plan periódico» como tres operaciones independientes.
7.3 Aprobación humana: tomar como referencia Custom Rules de Dots
Dots usa Custom Rules para clasificar el comportamiento en cuatro niveles: ejecutar directamente sin preguntar, ejecutar después de una autorización previa, preguntar antes de ejecutar y devolver el control al usuario. Operaciones como cambiar la contraseña o transferir fondos deben pasar necesariamente al usuario; eliminar datos de forma permanente o instalar software puede exigir aprobación cada vez. Ni siquiera la aprobación del usuario puede pasar por alto las restricciones de seguridad básicas.
Un sistema propio puede etiquetar las herramientas siguiendo este mismo esquema. Las búsquedas de solo lectura se ejecutan directamente; cuando termina la redacción de un informe, se pasa a Approval; los envíos al exterior, los pagos y las eliminaciones se derivan siempre a una persona. En el ejemplo, la tarea de informe tiene needs_approval=True: tras generarse, se queda en estado de aprobación y solo pasa a Completed cuando el usuario lo confirma.
8 Seguimiento de ejecución de Agents multitarea: Tracing y logs
Cuando varios proyectos se ejecutan en paralelo, la pregunta más habitual de los usuarios es «¿qué ha hecho exactamente?». El Tracing de OpenAI Agents SDK permite registrar qué Agent se invocó, qué modelo se utilizó, qué llamadas a herramientas se produjeron, dónde hubo un handoff, qué comprobaciones de seguridad se activaron y cómo terminó finalmente la tarea.
Tracing es útil para reconstruir una ejecución concreta, pero las estadísticas a nivel de proyecto necesitan complementarse con logs de negocio. Se recomienda que cada Run registre como mínimo project_id, task_id, run_id, model_id, input_tokens, output_tokens, tool_calls, duration, retry_count y final_status. Con estos campos se pueden responder preguntas de gestión como «¿cuántos tokens ha gastado el proyecto Research este mes?», «qué paso se ha reintentado más» o «qué modelo de tareas de análisis suele agotar el tiempo de espera». La tabla runs de la sección 6 es la implementación mínima de este conjunto de campos.
9 Costes y límites de gestión de un Agent multitarea
9.1 Estructura de costes de Dots
A 16 de noviembre de 2026, los usuarios individuales pueden usar Dots mediante las tres suscripciones ChatGPT Pro 100, Pro 200 y Pro 500, con una cuota mensual de 100, 200 y 500 USD, respectivamente. La documentación oficial de Dots para Pro individual no incluye una tarifa mensual separada por Dot. Las tareas de ChatGPT Work o Codex que Dot delega se calculan según los límites y reglas del producto correspondiente; el consumo depende del modelo, el contexto, el razonamiento, las llamadas a herramientas y la recuperación de información. El uso de Pro individual también tiene restricciones de edad (mayores de 18 años) y de región; no incluye el Espacio Económico Europeo, Reino Unido ni Suiza.
La facturación de los espacios de trabajo empresariales funciona de otra manera. La documentación oficial vigente indica que los espacios de trabajo empresariales que cumplan los requisitos pueden elegir una tarifa fija por tipo de trabajo o facturación por uso; el periodo de vista previa es gratuito y, a partir del 18 de noviembre de 2026, se empezará a cobrar por los Dots ya activados; las tareas delegadas a Work o Codex se cobran aparte. Los importes concretos dependerán de la cotización aplicable al espacio de trabajo.
9.2 Fuentes de coste de un sistema propio
El coste de un Agent multitarea propio proviene principalmente de cuatro fuentes:
- Lectura repetida del contexto: cada tarea inyecta el contexto del proyecto; cuanto más largo sea el contexto, más tokens de entrada se consumen en cada llamada, y el contenido del Store debe condensarse periódicamente;
- Reintentos y fallos: una tarea de análisis fallida vuelve a enviar los materiales de origen al modelo;
- Selección del modelo: si todas las subtareas usan el modelo más potente, el coste se multiplica;
- Límite de concurrencia: los límites de velocidad de la API determinan el número real de ejecuciones paralelas disponibles.
9.3 Paralelismo y carga de trabajo efectiva
El grado de paralelismo y la carga de trabajo efectiva son cosas distintas. Iniciar antes tareas cuyas dependencias aún no se cumplen solo produce resultados inservibles; conclusiones contradictorias obligan a que alguien las fusione manualmente; y si los datos erróneos de un proyecto pasan a otro a través de la memoria compartida, el coste de rehacer el trabajo será aún mayor. Lo sensato es garantizar primero el aislamiento entre proyectos y que las dependencias sean correctas, y luego aumentar gradualmente el límite de concurrencia según los datos de monitorización.
10 Preguntas frecuentes (FAQ)
P1: ¿Qué es la orquestación multitarea de Dots?
Un Dot gestiona varias tareas bajo su responsabilidad al mismo tiempo. El usuario puede cambiar de tarea y ajustar prioridades; Dot divide el trabajo complejo entre agentes en segundo plano para que lo procesen en paralelo, reúne los resultados y se los devuelve al usuario cuando hace falta tomar una decisión.
P2: ¿La memoria a largo plazo de Dots recuerda todo el historial de conversaciones?
No se carga todo. Cada nueva tarea tiene su propio contexto de conversación; Dot se apoya en ChatGPT Memory, sus propias notas, el contexto de la tarea actual y los datos de las aplicaciones conectadas, y recupera conversaciones anteriores cuando es necesario.
P3: ¿Checkpointer y Store pueden sustituirse mutuamente?
Sus responsabilidades son distintas. Checkpointer guarda una instantánea de ejecución de una tarea individual para recuperarse tras una interrupción; Store guarda el contexto del proyecto y las decisiones que atraviesan tareas, para que las nuevas tareas mantengan la continuidad del contexto. En proyectos de largo plazo se necesitan ambos.
P4: ¿Cuántas tareas puede ejecutar Dots en paralelo a la vez?
La documentación oficial no publica un número fijo de concurrencia. Dots admite paralelismo, pero tanto el entorno de ejecución como la cuota de uso tienen límites. Un usuario de Reddit comentó que observó tres procesos de ejecución corriendo al mismo tiempo; eso es solo el resultado de su propia prueba.
P5: ¿Cómo puede un agente multiproyecto hecho a medida llamar rápidamente a varios modelos?
Puedes usar una API agregadora compatible con OpenAI. Regístrate en APIYI apiyi.com para obtener una clave API y una cuota de prueba gratuita; después configura el `base_url` del código de este artículo como `https://api.apiyi.com/v1` y podrás usar el mismo código para asignar modelos como GPT, Claude o Gemini a distintas subtareas.
P6: ¿Cómo controlar el gasto en modelos de un agente multitarea?
Asigna los modelos según el rol: usa un modelo ligero para recopilar información y uno más potente para el análisis y la redacción; reduce el contexto del proyecto en el Store; y usa la tabla runs para contar los tokens de cada proyecto. Con el pago por uso de APIYI apiyi.com, puedes probar primero a pequeña escala y luego decidir la cuota.
P7: ¿Qué aspectos de seguridad hay que tener en cuenta en Dots y en un sistema propio?
Un agente puede malinterpretar tareas, evaluar mal la información o sufrir Prompt Injection; la documentación oficial también señala que las protecciones actuales no eliminan todos los riesgos. Las operaciones que involucren cuentas, fondos o envíos al exterior deben tener aprobación humana, y las credenciales sensibles no deben entrar en el contexto del modelo.
11 Dots: Puntos clave sobre la orquestación de múltiples tareas y la memoria a largo plazo
- Dificultad principal: la clave de un agente multitarea está en contextos independientes, estado persistente, orquestación y recuperación.
- Mecanismo de Dots: un Dot coordina varios asuntos, los agentes en segundo plano se ejecutan en paralelo y los contextos de las nuevas tareas son independientes entre sí.
- Dos tipos de memoria: Checkpointer se encarga de restaurar la ejecución; Store se encarga de mantener el contexto del proyecto.
- Estructura de cuatro capas: Workspace, Project, Task y Run tienen IDs independientes, y los proyectos están aislados entre sí.
- Principios de orquestación: las dependencias determinan la ejecución en serie, el límite de concurrencia determina la escala y las reglas se definen en el orquestador.
- Trazabilidad: cada Run registra el modelo, los tokens, el tiempo de ejecución, el número de reintentos y el estado final.
- Primeros pasos: asigna modelos distintos a cada subtarea mediante la interfaz unificada de APIYI apiyi.com.
12 Resumen
Dots muestra una forma de producto en la que un agente personal gestiona varios proyectos a largo plazo: se ejecuta de forma permanente, los contextos de las tareas son independientes entre sí, la memoria se guarda por capas, los agentes en segundo plano se ejecutan en paralelo y las operaciones de alto riesgo se dejan en manos del usuario. Su capacidad multiproyecto se basa en la gestión del estado; no basta con aumentar simplemente el número de ejecuciones en paralelo.
Cuando construyas un sistema similar por tu cuenta, puedes implementarlo en el orden descrito en este artículo: primero, usa la estructura de cuatro capas y la separación por ámbitos para implementar el aislamiento de proyectos; después, usa Store y Checkpointer para resolver por separado «recordar el contexto» y «poder recuperarse»; luego, usa el orquestador para gestionar dependencias y concurrencia; por último, usa máquinas de estado, aprobaciones y registros de ejecución para que cada paso sea controlable y consultable. En la fase de prototipo, se recomienda validar rápidamente con APIYI apiyi.com el rendimiento de distintos modelos en cada rol, y luego ajustar la división de tareas y la concurrencia con los datos de los registros.
Referencias
- OpenAI: Introducing dots: anuncio de lanzamiento del producto
- Enlace:
openai.com/index/introducing-dots - Descripción: posicionamiento del producto, computadora en la nube y ejecución de múltiples proyectos
- ChatGPT Learn: Tasks and memory: documentación de tareas y memoria de Dots
- Enlace:
learn.chatgpt.com/docs/dots/tasks-and-memory - Descripción: agente en segundo plano, contexto independiente por tarea, investigación proactiva
- OpenAI Help Center: Dots privacy, security, and safety FAQs: notas sobre privacidad y seguridad
- Enlace:
help.openai.com/en/articles/20001529-dots-privacy-security-and-safety-faqs - Descripción: permisos, aprobaciones, eliminación de memoria y retención de datos
- ChatGPT Learn: Dots admin guide: gestión y facturación de la edición empresarial
- Enlace:
learn.chatgpt.com/docs/enterprise/dots-admin-guide - Descripción: método de facturación del espacio de trabajo empresarial y fecha de inicio de facturación
- About ChatGPT Pro tiers: descripción de los niveles de suscripción Pro
- Enlace:
help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers - Descripción: reglas de precios y cuotas de Pro 100, 200 y 500
- Documentación de LangGraph Persistence: Checkpointer y Store
- Enlace:
github.com/langchain-ai/docs/blob/main/src/oss/langgraph/persistence.mdx - Descripción: distinción entre estado de ejecución a corto plazo y memoria a largo plazo
- OpenAI Agents SDK: Tracing y flujos de trabajo
- Enlace:
developers.openai.com/api/docs/guides/agents/sdk - Descripción: seguimiento y depuración del proceso de ejecución de Agent
Autor: Equipo técnico de APIYI
Contacto técnico: Puede contactarnos en la página de inicio de APIYI apiyi.com; para más materiales de integración, visite el centro de documentación docs.apiyi.com


