
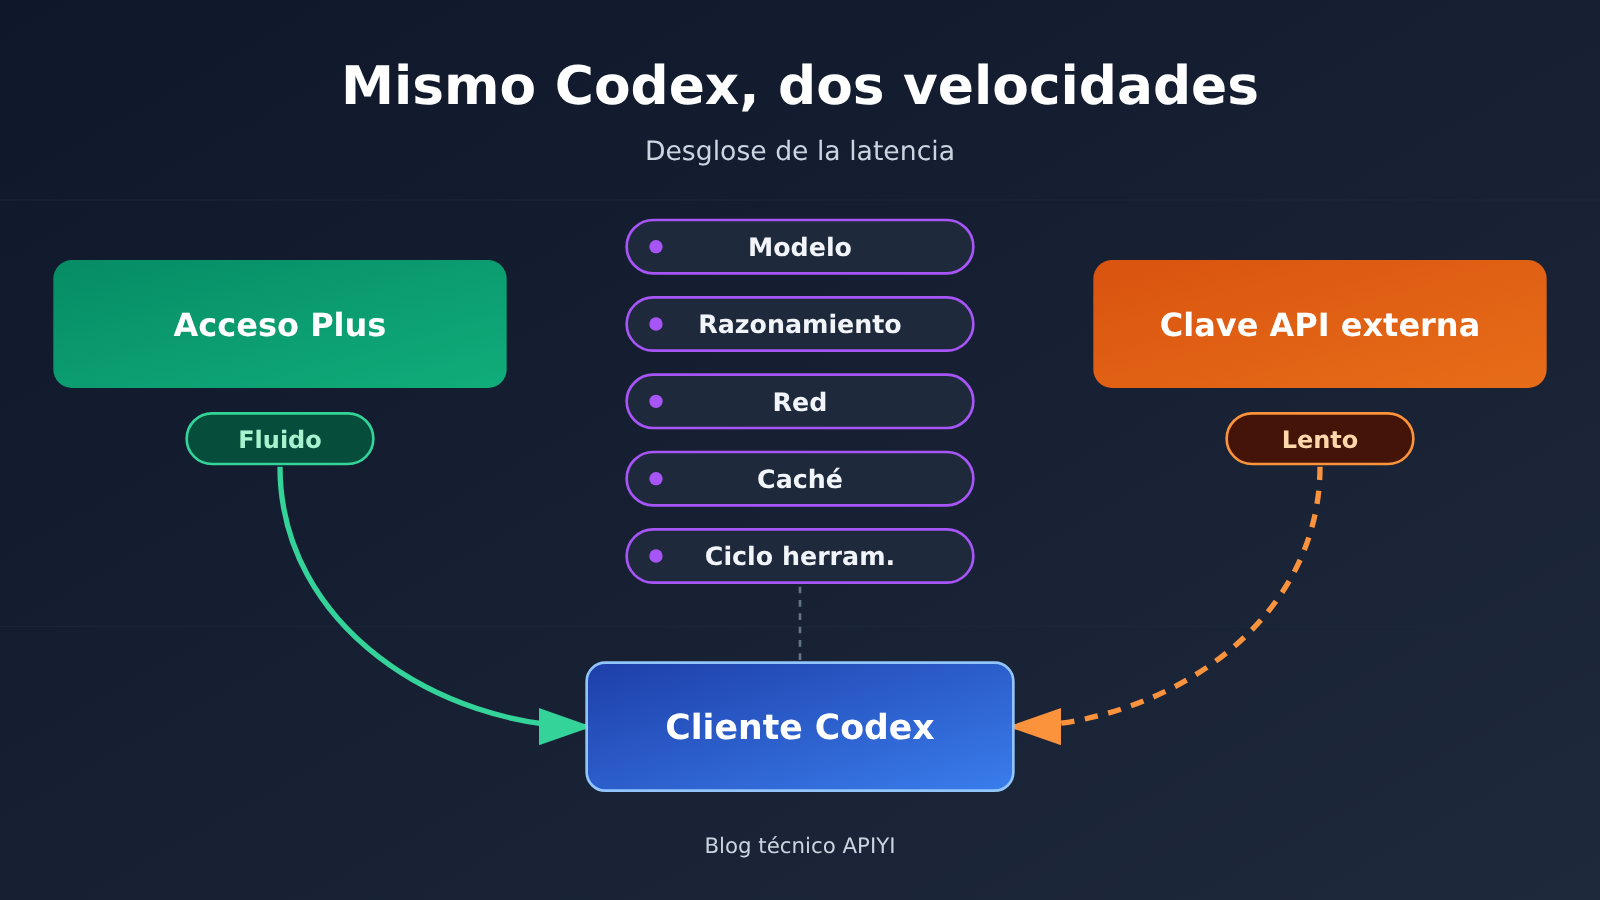
Nota del autor: el tiempo que tarda una tarea de Codex depende del modelo, la intensidad de razonamiento, la ruta de servicio, el bucle de herramientas, la caché y la red. Comparar la misma tarea bajo distintas condiciones y medir por segmentos permite localizar el cuello de botella.
El mismo Codex va fluido cuando se inicia sesión con ChatGPT Plus, pero se vuelve más lento al cambiar a una clave API de terceros. La razón normalmente está en que ambos recorren rutas de servicio distintas, y el bucle del agente de Codex multiplica y acumula la latencia adicional de cada ronda de solicitudes. La interfaz del cliente es la misma, pero el despliegue del modelo, el nivel de razonamiento, el protocolo de transporte, los aciertos de caché y el grado de compatibilidad de los eventos de herramientas pueden ser distintos. Si una solicitud tarda solo 3 segundos más, una tarea de programación que requiere 20 llamadas en serie podría tardar alrededor de 1 minuto más.
A continuación, primero desglosamos cómo funciona Codex y las dos rutas de acceso; después revisamos una por una las fuentes de latencia de las API de terceros y usamos dos GitHub Issues públicos como evidencia de casos. Luego presentamos cuatro métricas clave, tres grupos de pruebas comparativas y un plan de optimización clasificado por síntomas, para ayudarte a determinar si tu Codex va lento por el modelo, la red, la caché o el bucle de herramientas. Al final, analizamos qué métricas, al elegir una API de terceros, reflejan mejor el costo real que el precio unitario.
Para saber: terminología para entender las diferencias de velocidad de Codex
| Término | Explicación |
|---|---|
| Codex Harness | El marco de ejecución de Codex, responsable de organizar el modelo, las herramientas, el contexto y el ciclo de tareas de múltiples turnos. |
| Responses API | La interfaz proporcionada por OpenAI que permite la salida del modelo, la invocación de herramientas y la gestión de estado entre turnos. Codex depende de ella para funcionar. |
| TTFT | Time To First Token: el tiempo de espera desde que se envía la solicitud hasta que se recibe el primer token de salida. |
| TPS | Tokens Per Second: la cantidad de tokens generados por segundo, que refleja la velocidad de salida continua. |
| Tiempo de extremo a extremo | El tiempo total desde el envío de la tarea hasta su finalización, incluida todas las invocaciones del modelo y la ejecución de herramientas. |
| Intensidad de razonamiento | El nivel de profundidad con el que «piensa» el modelo, como low, medium o high. Cuanto más alto el nivel, normalmente más salida genera y más tiempo tarda. |
| Invocación de herramientas (Tool Calling) | El proceso mediante el cual el modelo solicita a programas externos que lean archivos, ejecuten comandos, etc., y luego usa el resultado para seguir razonando. |
| Caché de indicaciones (Prompt Caching) | Cuando un prefijo de entrada se repite y cumple las condiciones, se reutilizan cálculos ya realizados para reducir el tiempo de procesamiento. |
| SSE | Server-Sent Events: el servidor envía eventos de forma continua a través de una conexión HTTP unidireccional. |
| WebSocket | Un tipo de conexión bidireccional persistente que permite reutilizar la misma conexión para múltiples turnos de solicitudes. |
| previous_response_id | El parámetro de Responses API que referencia la respuesta del turno anterior. Junto con la entrada incremental, puede reducir la transmisión repetida. |
| Nivel de servicio | Diferentes opciones de procesamiento para un mismo modelo, como Standard y Fast, con velocidades y precios distintos. |
1 ¿Por qué el mismo Codex puede ir a dos velocidades distintas?
1.1 El inicio de sesión con suscripción de Codex y la clave API recorren rutas de servicio diferentes
Según la documentación de autenticación de OpenAI, Codex CLI, las extensiones de IDE y las aplicaciones de escritorio admiten dos formas de inicio de sesión: con una cuenta de ChatGPT o introduciendo una clave API. El inicio de sesión con ChatGPT consume los derechos de uso de Codex incluidos en la suscripción y sus límites correspondientes; la clave API se rige por las reglas de medición, facturación y limitación de velocidad de la cuenta API. La suscripción Plus tampoco incluye el derecho a llamar gratis a cualquier API de OpenAI.
Cuando conectas una clave API de terceros, el cliente de Codex solo se encarga de organizar la tarea; la inferencia real ocurre en el servicio que hay detrás de esa interfaz. El modelo que se invoca realmente, la forma de facturación, el protocolo de streaming y la calidad del servicio los determina la interfaz de terceros y la implementación de su backend. Por eso, que el nombre del modelo mostrado en el cliente sea el mismo solo indica que elegiste el mismo nombre; no confirma que las dos solicitudes pasaron por el mismo despliegue del modelo, la misma cola de servicio y la misma ruta de transmisión.
1.2 El bucle de agente de Codex hace que tenga que pedir el modelo una y otra vez
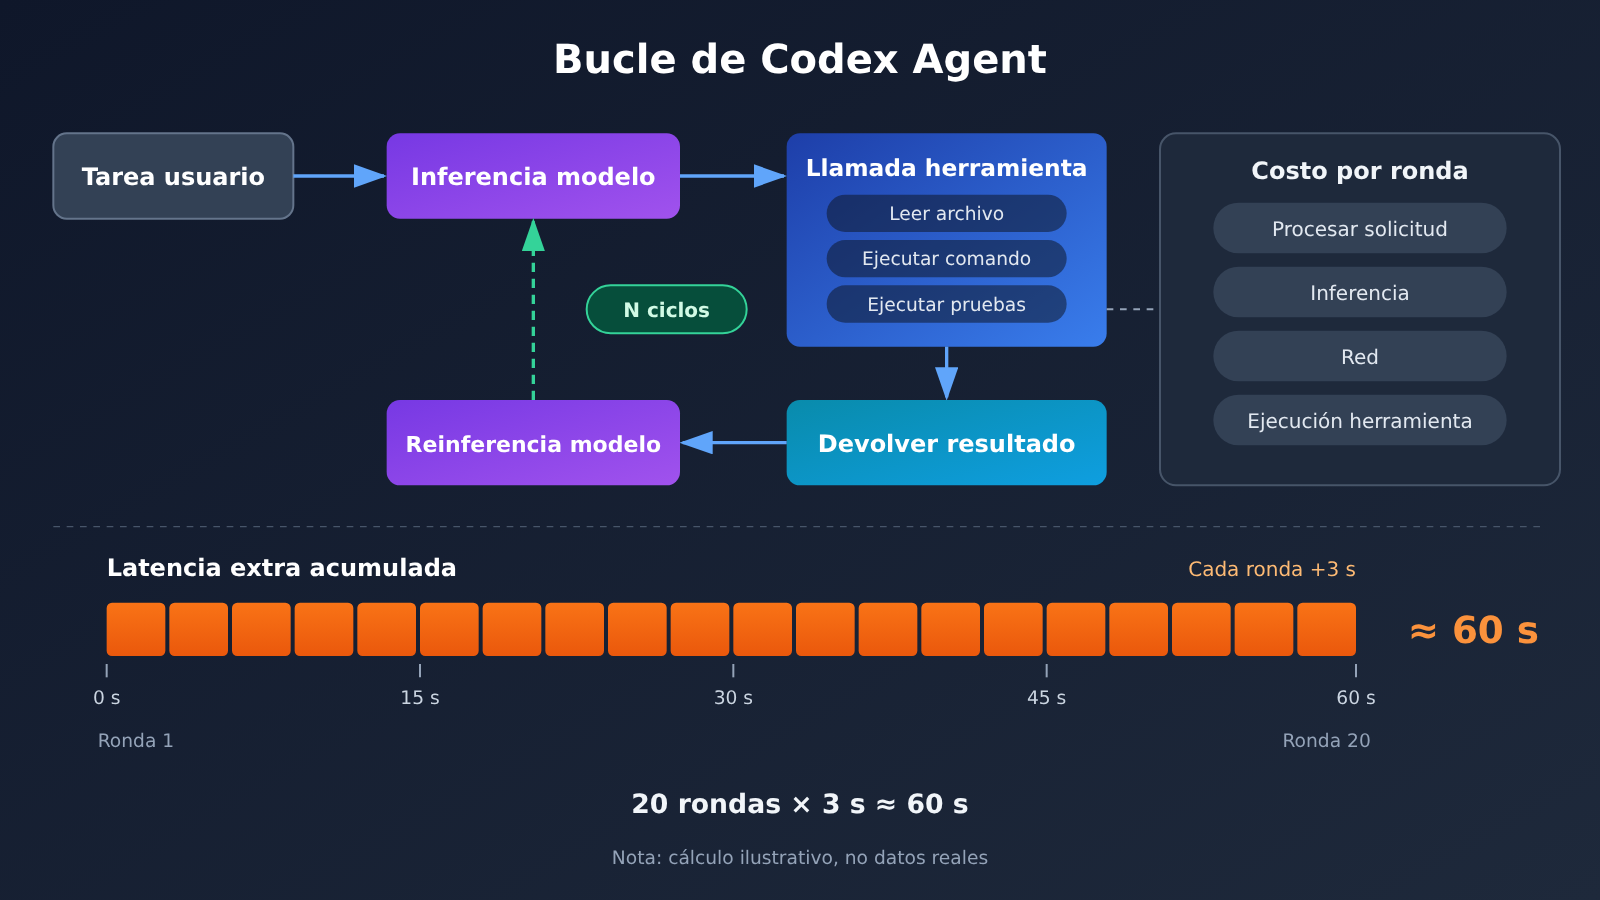
En «Codex as a platform», publicado por OpenAI el 19 de agosto de 2026, se explica que el Agent Harness de código abierto de Codex se encarga de entender la tarea, mantener el contexto, buscar en el repositorio de código, invocar el shell, editar archivos, ejecutar pruebas y gestionar la recuperación de fallos, la aprobación del usuario y los límites de ejecución. En esencia, es un sistema cíclico de «inferencia del modelo → ejecución de herramientas → nueva inferencia».
En un artículo técnico del 22 de abril de 2026, OpenAI describió el flujo típico: el usuario plantea una tarea de modificación, el modelo decide qué hay que hacer, Codex lee archivos o ejecuta comandos, la herramienta devuelve el resultado y el modelo vuelve a analizar; después sigue invocando herramientas, modificando código, ejecutando pruebas y revisando resultados. Una tarea compleja puede incluir decenas de idas y vueltas entre el modelo y las herramientas, y cada vuelta es una solicitud API completa.
2 ¿De dónde vienen las diferencias de velocidad al conectar Codex con una API de terceros?
Primero resumamos en una tabla las cinco fuentes de latencia y después las desglosamos una por una.
| Fuente de latencia | Métricas principalmente afectadas | Manifestación típica | Prioridad de diagnóstico |
|---|---|---|---|
| Modelo e intensidad de razonamiento | TPS, tiempo de inferencia por turno | Salida constantemente lenta, tiempo de pensamiento largo | Alta |
| Nivel de servicio y enrutamiento | TTFT, amplitud de fluctuación | Primera respuesta lenta o velocidad irregular | Alta |
| Gateway y ruta de red | Tiempo adicional fijo por turno | Unos segundos estables de más en cada llamada | Media |
| Protocolo de transporte (SSE / WebSocket) | Sobrecarga acumulada en varios turnos, estabilidad de conexión | Tareas largas lentas, cortes de flujo a mitad de camino | Media |
| Caché y bucle de herramientas | Tiempo de procesamiento de entrada, número de turnos de invocación | Conversaciones largas notablemente más lentas, demasiados turnos | Alta |
2.1 Impacto de la velocidad de inferencia y la intensidad de razonamiento del modelo en el tiempo de Codex
Antes de comparar las dos formas de acceso, primero hay que confirmar si el ID real del modelo, la intensidad de razonamiento, la versión del modelo y el nivel de servicio son consistentes. La intensidad de razonamiento va de low a xhigh, max; cuanto mayor sea el nivel, más contenido de pensamiento genera el modelo y más largo resulta el tiempo por turno.
La guía de optimización de latencia de OpenAI señala el número de tokens de salida como una variable clave que afecta el tiempo de inferencia: en algunos escenarios, reducir los tokens de salida en torno al 50% también puede hacer que la latencia de generación baje cerca del 50%; en cambio, reducir texto de entrada normal suele tener un impacto mucho menor. El nivel de servicio también importa: el modo Fast de OpenAI puede alcanzar hasta 2.5 veces la velocidad para los modelos y cargas aplicables, pero es una opción de nivel de pago y solo aplica a algunos modelos.
Esto significa que, aunque tanto el lado de la suscripción como el lado de terceros muestren el mismo modelo, basta con que difieran el nivel de razonamiento o el nivel de servicio para que la diferencia de velocidad sea evidente.
2.2 Servicio proxy de API, rutas de red e impacto de WebSocket en tareas multiturno
Las cadenas de solicitud de las interfaces de terceros suelen ser más largas: cliente → gateway del proveedor → nodo proxy → posible enlace transfronterizo → servicio de inferencia final. Cada salto adicional puede añadir algo de latencia fija y fluctuaciones de red, y esa latencia se acumula turno tras turno en el bucle del agente.
El protocolo de transporte es otra variable. La API Responses tradicional suele usar HTTP/SSE, y en cada turno hay que restablecer la solicitud y enviar el contexto. El modo WebSocket mantiene una conexión persistente y, con previous_response_id y entrada incremental, reduce la retransmisión y el procesamiento repetitivo. Los datos publicados oficialmente por OpenAI son los siguientes:
- Una optimización de la API a finales de 2025 mejoró la latencia del primer token en cerca del 45%.
- En flujos de trabajo específicos con más de 20 llamadas a herramientas, el modo WebSocket ofrece una aceleración de extremo a extremo de hasta aproximadamente el 40%.
- Las integraciones relacionadas con Vercel reportan una mejora de latencia de hasta aproximadamente el 40%; los flujos de trabajo multiarchivo de Cline reportan una aceleración de alrededor del 39%; y los modelos de OpenAI en Cursor reportan una mejora de hasta aproximadamente el 30%.
Estos datos provienen de distintos productos y escenarios de prueba, y representan valores máximos en flujos de trabajo concretos. Algunos gateways compatibles solo implementan HTTP/SSE o no admiten completamente WebSocket y la gestión de estado incremental que utiliza Codex; esas integraciones no obtienen este beneficio.
2.3 Caché de contexto y número de llamadas a herramientas de Codex
En tareas prolongadas, los mensajes del historial, las definiciones de herramientas y el contexto repetido acaban ocupando una gran cantidad de tokens de entrada. Cuando se acierta la caché de indicaciones, el tiempo de procesamiento de esa parte del prefijo se puede reducir. La documentación de OpenAI muestra que GPT-5.6 y las series posteriores admiten nueva escritura, lectura y control de TTL de la caché.
El problema es que la caché depende de la estabilidad del prefijo de la solicitud. Si la capa proxy reescribe el prefijo de la solicitud, ajusta el orden de definición de las herramientas o modifica los límites de la caché, puede afectar la reutilización de la caché y hacer que cada ronda vuelva a procesar grandes bloques de contexto. El número de llamadas a herramientas determina directamente el número de rondas de solicitud: cuantas más rondas, mayor será el factor que amplifica el costo de cada ronda individual.
2.4 ¿Por qué la primera respuesta de Codex es normal pero las siguientes siguen siendo lentas?
Esta es la forma más común del problema mencionado en el título. El TTFT solo mide si el primer token llega rápido, mientras que el tiempo total de una tarea de Codex es la suma de todas las rondas. El tiempo total se puede expresar como:
T_total = Σ (tiempo de procesamiento de la solicitud a la API + tiempo de inferencia del modelo + tiempo de transmisión en la red + tiempo de ejecución local de herramientas + tiempo de espera y reintentos)
Que la primera respuesta sea normal pero el conjunto sea lento suele deberse a los siguientes casos: velocidad de salida sostenida (TPS) baja, haciendo que las respuestas largas ralenticen cada ronda; después de que se completa la ejecución de la herramienta, el modelo vuelve a inferir, y cada nueva inferencia debe procesar de nuevo el contexto; la conexión en streaming se interrumpe a mitad de camino o expira, el cliente activa un reintento y el usuario ve que «el modelo se ha detenido». Haciendo el cálculo según el mecanismo, una tarea que requiera 20 llamadas seriales al modelo, esperando 3 segundos más en cada una, verá su tiempo total incrementado en unos 60 segundos; esta cifra sirve para ilustrar el efecto acumulativo y no es un resultado medido.
3 ¿Qué evidencia aportan los casos públicos sobre el problema de lentitud de Codex?
Los siguientes dos casos provienen de informes de usuarios en el repositorio openai/codex. Son registros de casos individuales de un solo usuario, que sirven para ilustrar el mecanismo y no representan el nivel general de la industria.
3.1 Issue #60831: fluctuación de aproximadamente siete veces en el tiempo de respuesta dentro de la misma sesión
En el Issue #60831, presentado en noviembre de 2026, la persona que reportó el problema observó dos solicitudes en la misma sesión, con el mismo proceso cliente y la misma configuración de razonamiento: ambos cuerpos de solicitud comprimidos eran de aproximadamente 13.09 MB, no se produjo compresión de contexto entre ambas y el historial de imágenes tampoco cambió. La solicitud lenta tardó 109.317 segundos desde que finalizó la compresión de la solicitud hasta que se recibieron los encabezados de respuesta HTTP; la rápida tardó 15.637 segundos. La proporción es de aproximadamente 6.99 veces.
Hay que tener en cuenta el criterio de medición: estas dos cifras miden el tiempo «hasta recibir los encabezados de respuesta», lo que corresponde a la fase de procesamiento del servicio, no a la duración total de la tarea; además, ambas solicitudes siguieron la misma ruta, por lo que no guarda relación con comparaciones entre suscripciones ni con terceros. Lo que muestra es que, cuando el tamaño del contexto permanece igual, el propio tiempo de procesamiento del servidor puede fluctuar considerablemente. El informe por sí solo no permite determinar qué parte concreta del servicio provocó el cuello de botella.
3.2 Issue #44305: el bucle de herramientas dispara el tiempo de una tarea de solo lectura
En el Issue #44305, de septiembre de 2026, la persona que reportó el problema comparó tareas de solo lectura similares: otro agente realizó 3 lecturas en paralelo y terminó en unos 10.6 segundos; Codex se ejecutó durante 91.5 segundos y agotó el tiempo de espera sin ofrecer una respuesta completa. Durante ese periodo, Codex realizó aproximadamente 11 inferencias del modelo y 11 llamadas a herramientas, con una entrada acumulada de unos 295,042 tokens, de los cuales aproximadamente 260,608 tokens eran entrada en caché.
Según estos números, la entrada en caché representa alrededor del 88.3%; la tasa de aciertos de caché era buena, pero el bucle serial de 11 rondas seguía haciendo que el tiempo superara con mucho la solución de lectura en paralelo. Las estrategias de trabajo de ambos agentes eran distintas, por lo que la diferencia de tiempo no puede atribuirse por completo a Codex ni al modelo; aun así, muestra claramente el efecto amplificador de las rondas de llamada y la ejecución serial sobre el tiempo total.
Además, hay otros dos tipos de problemas directamente relacionados con la integración de terceros: el Issue #33029 informa que, cuando Codex Desktop usa una interfaz compatible de terceros, el endpoint del modelo funciona correctamente, pero el cliente de escritorio sigue solicitando algunos servicios auxiliares de ChatGPT, y el tiempo de espera de esas solicitudes ralentiza la respuesta de la aplicación; los Issues #41340 y #42471 informan, respectivamente, de que el endpoint de Responses de terceros presenta «stream disconnected before completion» y de que los eventos de llamada a herramientas se reciben, pero no llegan al flujo de ejecución. Que un chat simple funcione y que el ciclo completo de herramientas de Codex funcione son dos niveles distintos de requisitos de compatibilidad.
4 ¿Cómo encontrar dónde es lento tu Codex?
4.1 Localizar el cuello de botella de Codex con cuatro métricas clave
| Métrica | Cómo registrarla | Problema que refleja |
|---|---|---|
| TTFT | Tiempo de espera hasta la primera salida válida de cada solicitud | Cola, arranque del modelo, primer paquete de red |
| Tiempo de extremo a extremo | Tiempo total desde el envío de la tarea hasta su finalización | Experiencia global, base para la valoración final |
| Número de invocaciones del modelo / de herramientas | Contabilizar rondas de inferencia, número de herramientas y tiempo de ejecución de estas | Estrategia del Agent y amplificación por serialización |
| Aciertos de caché | Tokens de entrada totales, lecturas de caché, escrituras de caché y salida | Coste por reprocesamiento del contexto |
Además de estas cuatro, conviene registrar también el TPS, los tokens de entrada y salida de cada solicitud, el protocolo utilizado (WebSocket o SSE), y el número de 429, 5xx, timeouts y reintentos. Estos datos auxiliares te ayudan a distinguir entre «lento» y «lento por reintentos tras un error».
4.2 Pasos de ejecución de las tres pruebas comparativas con Codex
El requisito previo de una prueba comparativa es controlar las variables: mantener iguales el ID del modelo, la intensidad de razonamiento, la versión de Codex, los archivos del proyecto y la descripción de la tarea, y ejecutar cada configuración dos veces, una en sesión nueva y otra en sesión larga, para detectar el efecto de la longitud del contexto.
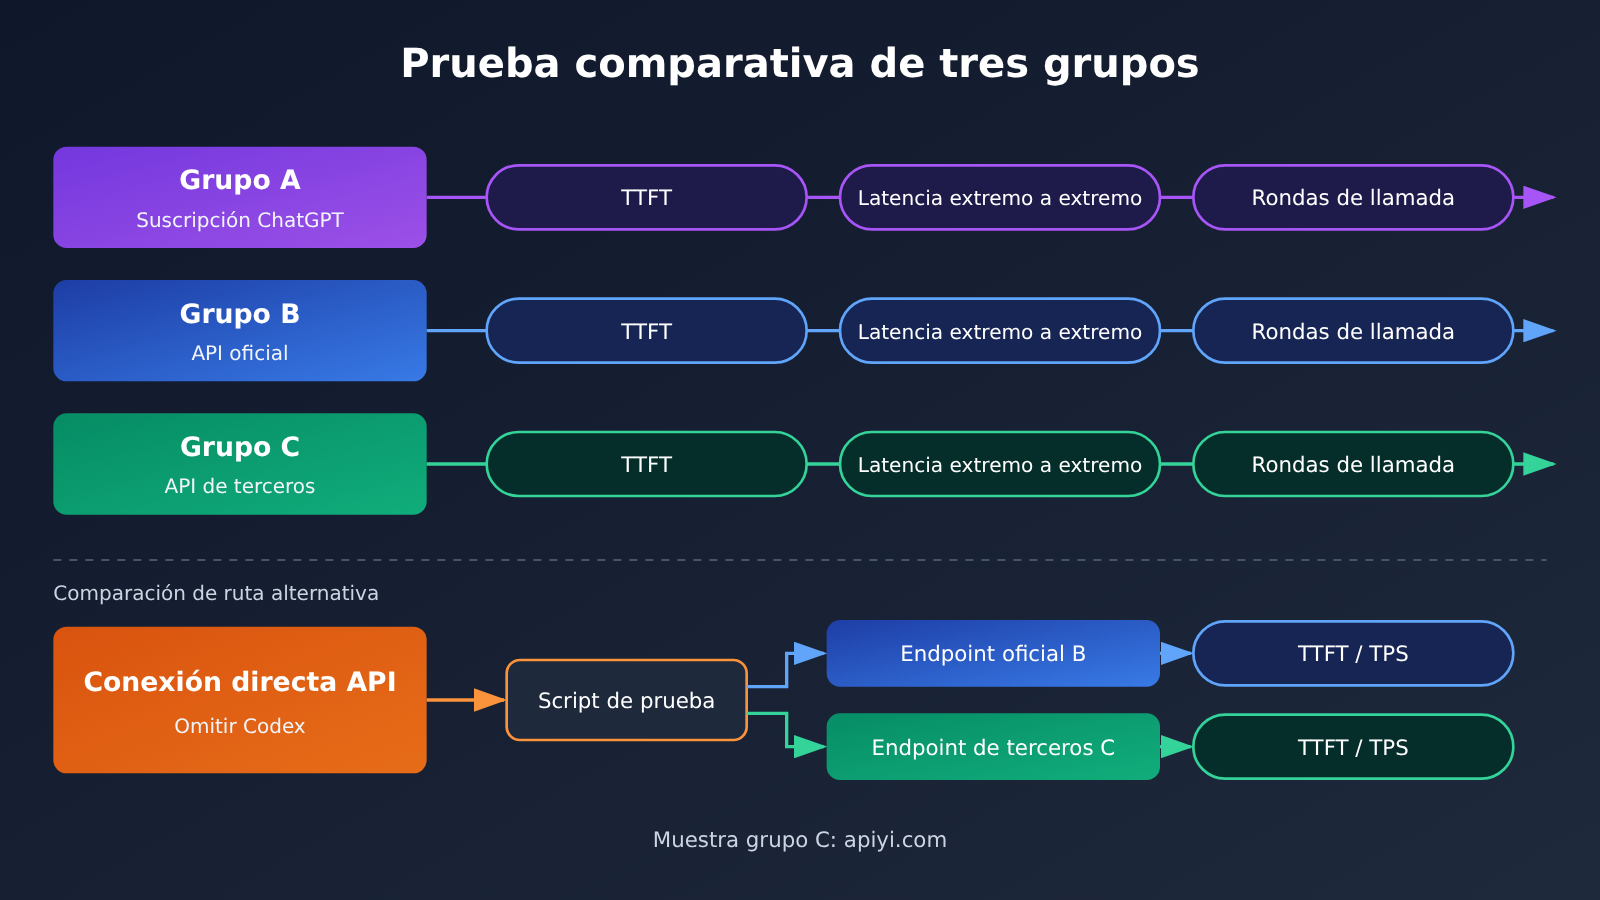
- Grupo A: iniciar sesión en Codex con la suscripción de ChatGPT, ejecutar la tarea estándar y registrar el tiempo de extremo a extremo y el número de turnos de invocación.
- Grupo B: conectar Codex mediante la clave API oficial del mismo modelo y ejecutar la misma tarea.
- Grupo C: conectar Codex mediante una API compatible de terceros y ejecutar la misma tarea.
- Grupo de conexión directa: para las rutas B y C, omitir Codex y enviar la misma solicitud única con un script, midiendo TTFT y TPS.
La diferencia entre A y B refleja principalmente las diferencias de servicio entre la ruta de suscripción y la ruta de API; la diferencia entre B y C refleja las diferencias de gateway, enrutamiento y servicio de inferencia; y la brecha entre los resultados de la conexión directa y los obtenidos dentro de Codex refleja el sobrecoste que aportan el bucle del Agent, la compatibilidad de protocolos y el cliente. En cada grupo se recomienda repetir varias veces y tomar la mediana, para no confundir una fluctuación puntual con una conclusión.
El siguiente script se usa para la prueba del «grupo de conexión directa»: mide el TTFT, el tiempo total, los tokens de salida y el TPS mediante una solicitud Responses en streaming:
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI; cambie a la dirección oficial para hacer la comparación del grupo B
)

start = time.perf_counter()
ttft = None
stream = client.responses.create(
    model="YOUR_MODEL_ID",            # Manténgalo igual al ID del modelo usado en Codex
    reasoning={"effort": "medium"},   # Mantenga la misma intensidad de razonamiento que en Codex
    input="阅读下面的函数并指出潜在 bug:def add(a, b): return a - b",
    stream=True,
)
usage = None
for event in stream:
    if event.type == "response.output_text.delta" and ttft is None:
        ttft = time.perf_counter() - start
    elif event.type == "response.completed":
        usage = event.response.usage

total = time.perf_counter() - start
out_tokens = usage.output_tokens if usage else 0
print(f"TTFT: {ttft:.2f}s | 总耗时: {total:.2f}s | 输出: {out_tokens} tokens")
if ttft and total > ttft:
    print(f"TPS: {out_tokens / (total - ttft):.1f} tokens/s")
Ver el script completo con pruebas repetidas de varios turnos y estadísticas de caché
import time
import statistics
from openai import OpenAI

ENDPOINTS = {
    "official": {"base_url": "https://api.openai.com/v1", "key": "OFFICIAL_KEY"},
    "apiyi": {"base_url": "https://api.apiyi.com/v1", "key": "APIYI_KEY"},  # Interfaz de APIYI
}
MODEL = "YOUR_MODEL_ID"
EFFORT = "medium"
# Usar un prefijo fijo largo para simular las instrucciones del sistema y las definiciones de herramientas de Codex, y así observar fácilmente los aciertos de caché
PREFIX = "你是代码审查助手。项目规范如下:\n" + ("- 函数必须有类型注解。\n" * 300)
TASK = "检查这个函数:def add(a, b): return a - b"


def run_once(client):
    start = time.perf_counter()
    ttft, usage = None, None
    stream = client.responses.create(
        model=MODEL,
        reasoning={"effort": EFFORT},
        input=PREFIX + TASK,
        stream=True,
    )
    for event in stream:
        if event.type == "response.output_text.delta" and ttft is None:
            ttft = time.perf_counter() - start
        elif event.type == "response.completed":
            usage = event.response.usage
    total = time.perf_counter() - start
    cached = 0
    if usage and getattr(usage, "input_tokens_details", None):
        cached = usage.input_tokens_details.cached_tokens or 0
    return {
        "ttft": ttft or total,
        "total": total,
        "input": usage.input_tokens if usage else 0,
        "cached": cached,
        "output": usage.output_tokens if usage else 0,
    }


def bench(name, cfg, rounds=5):
    client = OpenAI(api_key=cfg["key"], base_url=cfg["base_url"])
    results, errors = [], 0
    for _ in range(rounds):
        try:
            results.append(run_once(client))
        except Exception as e:
            errors += 1
            print(f"[{name}] 请求失败: {e}")
    if not results:
        return
    med = lambda k: statistics.median(r[k] for r in results)
    hit = sum(r["cached"] for r in results) / max(sum(r["input"] for r in results), 1)
    print(
        f"[{name}] TTFT中位数 {med('ttft'):.2f}s | 总耗时中位数 {med('total'):.2f}s | "
        f"缓存命中率 {hit:.1%} | 失败 {errors}/{rounds}"
    )


for name, cfg in ENDPOINTS.items():
    bench(name, cfg)
Al ejecutar las pruebas del grupo C dentro de Codex, es necesario configurar el endpoint de terceros como proveedor del modelo. A continuación se muestra una configuración habitual en ~/.codex/config.toml; para los nombres exactos de los campos, consulta la documentación oficial de la versión de Codex que estés usando:
model = "YOUR_MODEL_ID"
model_provider = "apiyi"
model_reasoning_effort = "medium"

[model_providers.apiyi]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
🚀 Inicio rápido: para la comparación del grupo C, puedes solicitar una cuota de prueba gratuita para nuevos usuarios en APIYI (apiyi.com), usar la misma clave para cambiar entre varios modelos y ejecutar el script anterior con cada uno, y obtener así rápidamente datos comparables de TTFT y tiempo total.
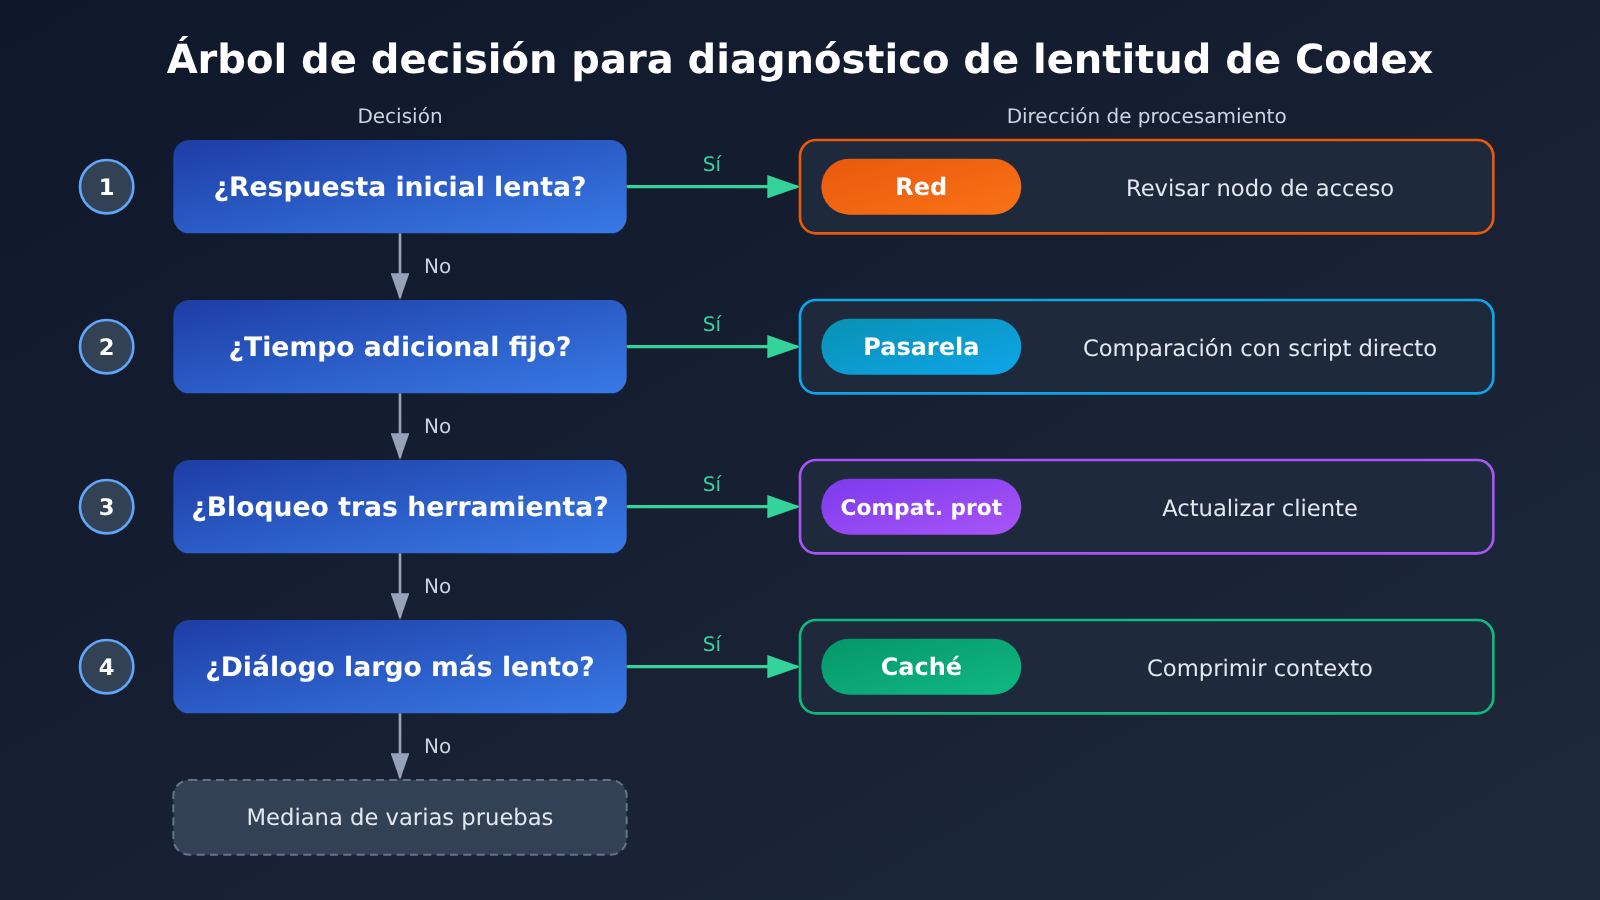
4.3 Planes de optimización de Codex según el síntoma
| Síntoma | Qué revisar primero | Cómo tratarlo |
|---|---|---|
| Primera respuesta lenta | Cola, arranque del modelo, primer paquete de red | Cambiar a un nodo de acceso más cercano, confirmar el nivel de servicio, comparar evitando horas punta |
| Primera respuesta rápida, luego lento | TPS, número de turnos con herramientas, caché | Reducir la intensidad de razonamiento, limitar la longitud de salida, comprobar la tasa de aciertos de caché |
| Tiempo constante añadido en cada llamada | Enlace del servicio proxy, peticiones extra | Comparar los grupos B y C con un script de conexión directa para localizar la sobrecarga de la pasarela |
| Se queda colgado después de una llamada a herramienta | Eventos de Responses, retorno de la herramienta | Comprobar si hay cortes de flujo o pérdida de eventos de herramienta, actualizar la versión del cliente |
| Conversación larga notablemente más lenta que una nueva | Tokens de historial, compresión, caché | Abrir una sesión nueva a tiempo o forzar la compresión de contexto, y observar los cambios en la lectura de caché |
| Velocidad irregular | Carga del servicio, reintentos, fluctuaciones de red | Contabilizar los 429/5xx y los tiempos de espera agotados, hacer varias pruebas y tomar la mediana |
| La app de escritorio va lenta en general, pero la API funciona bien | Peticiones de los servicios auxiliares de ChatGPT | Consultar el Issue #33029, comprobar si las peticiones auxiliares agotan el tiempo de espera y, si hace falta, pasarse a la CLI |
La optimización a nivel de modelo sigue la filosofía de la guía de latencia de OpenAI: reducir los tokens de salida, reducir el contexto de entrada, reducir el número de llamadas, procesar en paralelo los pasos independientes y no encargar al modelo lo que se puede resolver con un programa normal. En Codex, la vía más directa es delimitar con más precisión el alcance en la descripción de la tarea, para que el Agente haga menos turnos de lectura exploratoria.
5. ¿Qué métricas son más importantes que el precio unitario al elegir una API de terceros para Codex?
5.1 Pasar del precio unitario por token al costo de completar tareas
En el contexto de Codex, el costo real lo determina “completar una tarea”. Si una API tiene un precio unitario bajo, pero falla en los aciertos de caché, requiere muchas rondas de invocación y sufre cortes de conexión con reintentos frecuentes, al final consumirá más token y más tiempo. Al evaluar, conviene revisar juntas estas variables: tasa de éxito de la tarea, tiempo de extremo a extremo, total de token consumidos por tarea (incluida la lectura de caché) y el costo adicional por fallos y reintentos.
| Dimensión de evaluación | Aspectos a observar | Método de prueba | Plataforma disponible |
|---|---|---|---|
| Identidad y versión del modelo | Si el ID y la versión del modelo son claros, estables y están disponibles | Verificar los campos del modelo devueltos y la documentación | APIYI (apiyi.com), API oficial |
| Primer token y velocidad sostenida | Mediana y fluctuación de TTFT y TPS | Pruebas de varias rondas con script de conexión directa | APIYI (apiyi.com), API oficial |
| Tiempo de finalización de tareas de Agent en varios turnos | Tiempo total de tareas reales dentro de Codex | Pruebas comparativas en tres grupos | APIYI (apiyi.com), API oficial |
| Compatibilidad de protocolo | Soporte de Responses, WebSocket y eventos de herramientas | Ejecutar una tarea completa de lectura de archivos + modificación de código + pruebas | Según la documentación del proveedor |
| Soporte de caché | Si los token de lectura de caché se devuelven correctamente | Contar los campos de caché en usage | Según la documentación del proveedor |
| Estabilidad y facturación | Tasa de fallos, concurrencia, transparencia de facturación | Registrar 429/5xx y el detalle de la factura | Según la documentación del proveedor |
5.2 Evaluar con tareas reales interfaces de terceros como APIYI
APIYI (apiyi.com) es una plataforma de agregación de API para Modelos de Lenguaje Grande de IA. Con una sola clave API se pueden invocar modelos principales como OpenAI, Claude y Gemini; la interfaz es compatible con el protocolo OpenAI y la facturación es por consumo. Su valor en el contexto de Codex se nota sobre todo en la facilidad de comparar horizontalmente: con la misma configuración, puedes cambiar de modelo y de nivel para obtener datos comparables en tu propio proyecto.
Las rutas de conexión, el soporte de protocolos y la estabilidad varían entre proveedores externos; al evaluar, conviene basarse en datos de prueba concretos y en el acuerdo de servicio. Se recomienda elegir 2 o 3 tareas representativas (por ejemplo, una refactorización de varios archivos y una corrección de bug con pruebas), ejecutarlas por separado en cada modalidad de integración siguiendo el método de la sección 4, y luego decidir combinando la tasa de éxito y el total de token.
💡 Sugerencia de elección: primero descarta con un script de conexión directa las opciones cuyo TTFT y TPS se desvían claramente; después, pon a prueba las candidatas restantes con Codex en tareas completas. Con la interfaz unificada de APIYI (apiyi.com), puedes comparar varios modelos sin cambiar la estructura del código.
Preguntas frecuentes (FAQ)
P1: ¿De dónde viene principalmente la diferencia de velocidad entre la suscripción de Codex y las API de terceros?
Proviene de la diferencia global en la ruta de servicio: el despliegue real del modelo, la intensidad de inferencia, el nivel de servicio, la cadena del gateway, el protocolo de transporte, el acierto de caché y el grado de compatibilidad con los eventos de herramientas. El bucle de agente de múltiples turnos de Codex acumula estas diferencias de una sola petición turno tras turno, por lo que la brecha de tiempo total suele ser mucho mayor que la de una petición individual.
P2: Si el TTFT es normal, ¿por qué la tarea de Codex sigue siendo lenta?
El TTFT solo mide el tiempo de espera del primer token. Una tarea de Codex incluye múltiples rondas de inferencia y llamadas a herramientas; la velocidad de salida sostenida, la reinferencia tras ejecutar herramientas, los fallos de caché y los reintentos intermedios alargan el tiempo total. Para evaluar la experiencia hay que fijarse en el tiempo de extremo a extremo y en el número de turnos de llamada.
P3: ¿Cuánto puede acelerar Codex con el modo WebSocket?
Los datos publicados por OpenAI indican: en flujos de trabajo específicos con más de 20 llamadas a herramientas, la velocidad de extremo a extremo puede mejorar hasta aproximadamente un 40%. Es el límite superior de un escenario concreto; el beneficio real depende del número de turnos de la tarea y de si la interfaz admite por completo WebSocket y la gestión de estado incremental.
P4: En conversaciones largas Codex se vuelve cada vez más lento, ¿cómo debo gestionarlo?
Primero registra el total de tokens de entrada y los tokens leídos de caché en cada turno, y confirma si la caché está acertando correctamente. Si el contexto histórico es demasiado largo, puedes abrir una sesión nueva o activar la compresión de contexto; además, reduce el alcance de la tarea y disminuye los turnos exploratorios de lectura de archivos.
P5: ¿Cómo medir rápidamente el rendimiento real de una API de terceros en Codex?
1. Regístrate en APIYI apiyi.com y obtén la clave API junto con la cuota de prueba gratuita;
2. Usa el script de conexión directa de este artículo para medir TTFT, TPS y acierto de caché;
3. Configura Codex según la sección 4.2 y ejecuta la misma tarea que en el lado de la suscripción, comparando el tiempo de extremo a extremo y los turnos de llamada.
Así puedes distinguir por separado la diferencia del servicio de inferencia y la que aporta el bucle de agente.
P6: ¿Los datos de los Issues públicos representan el rendimiento general de Codex?
No directamente. Los Issues #60831 y #44305 son registros de un único usuario: el primero mide el tiempo hasta las cabeceras de respuesta HTTP, y el segundo es una tarea de solo lectura que agotó el tiempo. Su valor está en mostrar cómo las fluctuaciones del servidor y el bucle serial de herramientas afectan el tiempo; las conclusiones concretas deben validarse con tus propias pruebas de tareas.
Puntos clave sobre las diferencias de velocidad de Codex
- Rutas distintas: el inicio de sesión por suscripción y la clave API siguen rutas de facturación y servicio diferentes; que el nombre del modelo coincida no significa que el despliegue sea el mismo.
- Amplificación por el bucle: el bucle del agente de Codex acumula la pequeña latencia de cada ronda hasta convertirla en una diferencia de tiempo total considerable.
- Métricas por capas: el TTFT mide la primera respuesta, pero solo el tiempo de extremo a extremo y el número de rondas de invocación reflejan la experiencia real.
- El protocolo influye: WebSocket acelera hasta aproximadamente un 40% en escenarios de múltiples rondas de llamadas a herramientas, pero exige que la interfaz lo soporte por completo.
- Verificar la caché: la capa proxy puede alterar el prefijo de la solicitud y afectar la caché, por lo que hay que contar los tokens leídos desde caché.
- Pruebas comparativas: comparar tres grupos con la misma tarea —suscripción, API oficial y API de terceros— y añadir una prueba de conexión directa para localizar el cuello de botella.
- Elegir según la tarea: probar de forma transversal con tareas reales en plataformas como APIYI apiyi.com, fijándose en el coste de completar la tarea y no en el precio unitario.
Resumen
Que el mismo Codex muestre dos velocidades se debe al efecto combinado de la ruta de servicio y del bucle del agente:
- A nivel de mecanismo: el modelo, la intensidad de razonamiento, el nivel de servicio, la puerta de enlace, el protocolo, la caché y el bucle de herramientas determinan en conjunto el tiempo total; cualquier diferencia en una sola ronda se amplifica con las múltiples rondas de invocación.
- A nivel de evidencia: los datos oficiales muestran que optimizar el protocolo y el nivel de servicio puede aportar aceleraciones considerables, mientras que los registros de usuarios indican que la variabilidad del servidor y los bucles en serie alargan notablemente las tareas.
- A nivel de método: registrar los cuatro indicadores clave, hacer tres grupos de comparación más una prueba de conexión directa y luego optimizar cada punto según los síntomas.
Al diagnosticar, primero fija el modelo y la intensidad de razonamiento, y después deja que los datos hablen. Si necesitas comparar varios modelos y formas de acceso, puedes apoyarte en la interfaz unificada de APIYI para reducir el coste de las pruebas al mínimo.
📚 Referencias
- Codex as a platform: build on the open agent harness: OpenAI presenta las responsabilidades del Codex Agent Harness
- Enlace:
developers.openai.com/blog/codex-as-a-platform -
Descripción: Base oficial para comprender el modelo multiturno y el bucle de herramientas de Codex
-
Documentación de autenticación de Codex: ChatGPT login y API Key como dos formas de acceso
- Enlace:
learn.chatgpt.com/docs/auth?surface=cli -
Descripción: Distinguir entre los beneficios de suscripción y la facturación por API, y las reglas de limitación de velocidad
-
Speeding up agentic workflows with WebSockets in the Responses API: Artículo de ingeniería de OpenAI
- Enlace:
openai.com/index/speeding-up-agentic-workflows-with-websockets -
Descripción: Flujo del bucle del agente y datos de aceleración con WebSocket
-
Documentación de WebSocket mode: Modo WebSocket de la API de Responses
- Enlace:
developers.openai.com/api/docs/guides/websocket-mode -
Descripción: Conexiones persistentes, entrada incremental y casos de uso adecuados
-
Guía de Latency optimization: Principios de optimización de latencia de OpenAI
- Enlace:
developers.openai.com/api/docs/guides/latency-optimization -
Descripción: Enfoques de optimización como tokens de salida, número de invocaciones y paralelización
-
Documentación de Fast mode: Niveles de servicio y alcance de la aceleración
- Enlace:
developers.openai.com/api/docs/guides/fast-mode -
Descripción: Variables del nivel de servicio que deben controlarse al comparar velocidades
-
Documentación de Prompt caching: Escritura, lectura y TTL de la caché
- Enlace:
developers.openai.com/api/docs/guides/prompt-caching -
Descripción: Estadísticas y optimización de aciertos de caché en conversaciones largas
-
openai/codex Issue #60831 / #44305 / #33029 / #41340 / #42471: Problemas de latencia y compatibilidad reportados por usuarios
- Enlace:
github.com/openai/codex/issues/60831,github.com/openai/codex/issues/44305,github.com/openai/codex/issues/33029 - Descripción: Registros de casos de fluctuaciones del servidor, amplificación del bucle de herramientas, solicitudes auxiliares del cliente de escritorio y compatibilidad con protocolos de terceros
Autor: Equipo técnico de APIYI
Intercambio técnico: Te invitamos a ponerte en contacto con nosotros desde la página principal del sitio APIYI apiyi.com para compartir experiencias sobre la integración de Codex y las pruebas de rendimiento. Para más material, puedes visitar el centro de documentación docs.apiyi.com


