
Nota del autor: todos los límites de capacidad de este artículo se han elaborado cotejando la documentación de modelos de APIYI; antes de escribir, se verificaron conforme a la versión de noviembre de 2026, y las conclusiones se rigen por la documentación.
Una imagen de retrato y un audio: el deseo de que la persona de la escena abra la boca y hable es la petición más común dentro de imagen a video. La primera reacción de muchas personas es pasar driving_audio junto con happyhorse-1.1-i2v, y al ver que la conducción por audio no surte efecto, empiezan las dudas sobre el material, sobre el orden de los parámetros e incluso sobre la propia forma de invocar.
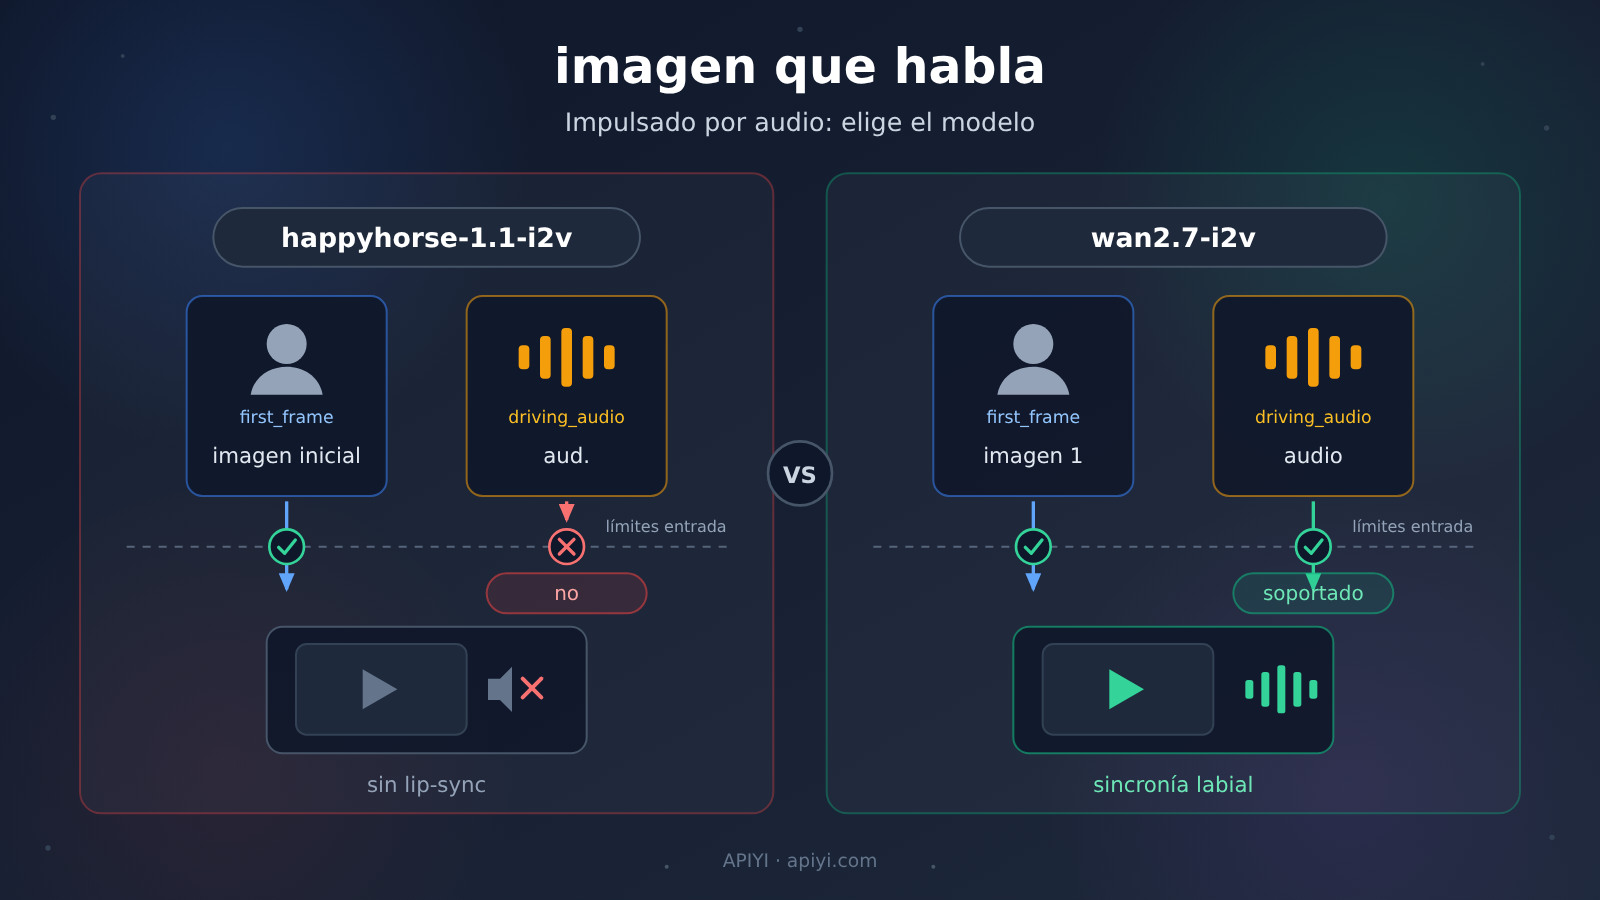
Esto no es una falla inexplicable ni que el material no sea suficientemente bueno. La documentación es muy clara al respecto: happyhorse-1.1-i2v solo acepta first_frame y no admite driving_audio; para lograr sincronización de labios o interpretación tipo rap, la dirección que da la documentación es cambiar a wan2.7-i2v.
Valor central: al terminar este artículo, tendrás claro el límite de responsabilidades entre happyhorse-1.1-i2v y wan2.7-i2v, sabrás a quién hay que pasar los parámetros para «hacer hablar la imagen» y podrás hacerlo funcionar a la primera.
Puntos clave de happyhorse-1.1-i2v
Primero la conclusión, y luego entramos en detalles:
| Punto clave | Según la documentación | Qué significa para ti |
|---|---|---|
| Solo acepta el primer fotograma | happyhorse-1.1-i2v acepta la entrada first_frame |
La imagen es su única vía de entrada |
| No admite audio como controlador | El modelo no admite driving_audio |
Aunque lo pases, no surtirá efecto; no hace falta reintentar una y otra vez |
| La sincronización labial tiene otro camino | La documentación sugiere usar wan2.7-i2v para escenarios de sincronización labial |
Cambiar de modelo resuelve el problema más rápido que cambiar de parámetros |
El primer punto es donde es más fácil equivocarse. driving_audio no es un parámetro oculto de happyhorse-1.1-i2v, ni una capacidad que se abrirá en alguna versión futura. La documentación del modelo lo marca explícitamente como no compatible, e incluso la entrada de imagen a video de la página de descripción general llega a la misma conclusión. En otras palabras, el problema no está en cómo haces la llamada, sino en que el límite de capacidades del modelo está justamente aquí.
El segundo punto tiene que ver con la ruta alternativa. La documentación indica que el control por audio es una capacidad exclusiva de wan2.7-i2v, y que el i2v de HappyHorse no asume este tipo de tareas. Así que cuando un personaje necesita hablar, la acción correcta no es seguir ajustando parámetros, sino cambiar de modelo directamente.
Diferencias clave entre happyhorse-1.1-i2v y wan2.7-i2v
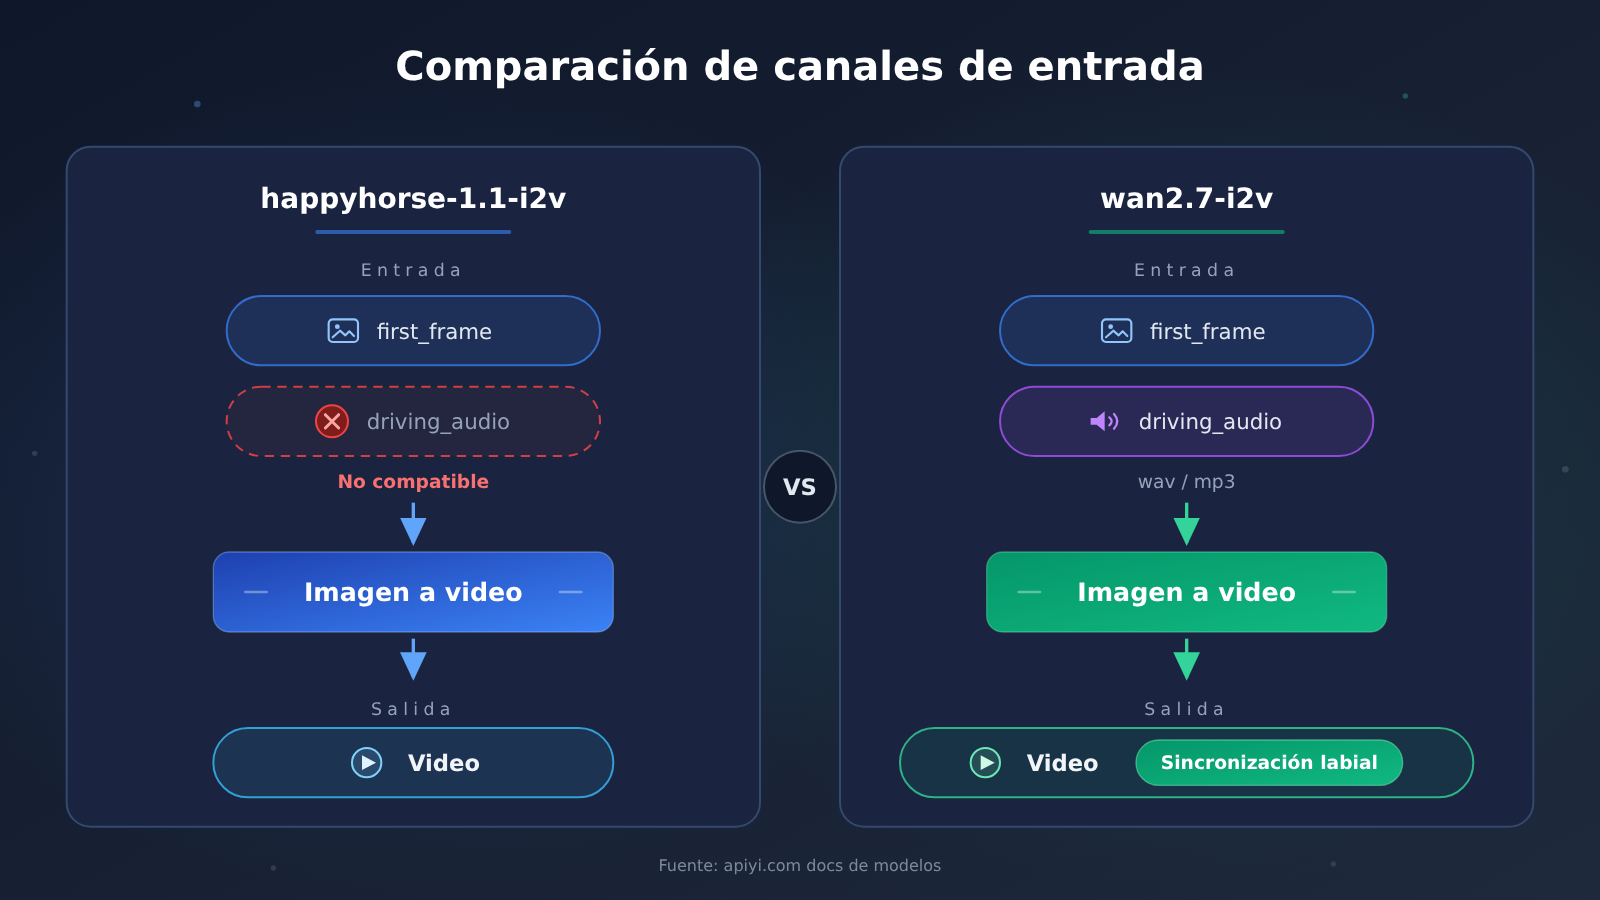
Ambos modelos son de generación de video a partir del primer fotograma, con posicionamiento solapado, y la verdadera línea divisoria es la fila de entrada de audio:
| Aspecto de comparación | happyhorse-1.1-i2v |
wan2.7-i2v |
Conclusión de la diferencia |
|---|---|---|---|
| Tipo de tarea | Generación de video a partir de imagen de primer fotograma | Generación de video a partir de imagen de primer fotograma | Posicionamiento solapado; no juzgues la superioridad por el nombre |
first_frame |
Acepta | Debe haber 1 | La entrada de imagen es indispensable en ambos |
driving_audio |
No soportado | Soportado, opcional 1 | La línea divisoria de la sincronización labial |
| Formato de audio | No aplicable | wav o mp3 |
Confirma el formato antes de pasar parámetros |
| Escenario de sincronización labial | La documentación recomienda usar wan2.7-i2v |
La documentación especifica que soporta este escenario | Basta con mirar esta fila para elegir |
Tanto la tabla anterior como la imagen de referencia se basan en la documentación del modelo de APIYI (apiyi.com), no son conjeturas empíricas.
happyhorse-1.1-i2v va por el camino correcto para «hacer que el primer fotograma estático se mueva»: le das un first_frame y se encarga de que la escena continúe. Pero el audio no está en su lista de entradas; la documentación registra que la capacidad de impulsar por audio no está abierta para el i2v de HappyHorse. En comparación, wan2.7-i2v abre otra puerta además de la misma entrada de primer fotograma: driving_audio, de modo que el ritmo de movimiento del personaje puede seguir el audio.
Las restricciones de wan2.7-i2v también son más específicas: en los medios debe haber exactamente 1 first_frame, como máximo 1 driving_audio, y el formato de audio se limita a wav o mp3. Estas restricciones están escritas de forma muy estricta, y la ventaja es que, si lo armas siguiendo la documentación, funciona a la primera, sin necesidad de adivinar.
Por qué happyhorse-1.1-i2v no acepta driving_audio
Si revisamos las pistas en la documentación, al menos cuatro puntos de información apuntan a la misma conclusión:
- La página del modelo indica que
happyhorse-1.1-i2ves un modelo de generación de video a partir de la imagen del primer frame, y solo aceptafirst_frame. - En la misma página se señala explícitamente que no admite
driving_audio. - La entrada de imagen a video en la página de descripción general también indica que no admite control por audio.
- Para necesidades de sincronización labial o rap, la documentación ofrece directamente una recomendación de migración: cambiar a
wan2.7-i2v.
Y entonces volvemos al escenario clásico: incluyes driving_audio en la solicitud, el resultado no coincide con lo esperado y empiezas a revisar uno por uno los materiales y los parámetros. Independientemente de cómo termine respondiendo la interfaz, la causa raíz es una sola: este campo queda fuera del alcance de entrada para happyhorse-1.1-i2v. La documentación no deja ninguna puerta abierta del tipo «basta cambiar la forma de escribirlo»; reintentar o cambiar los materiales no altera los límites de entrada.
Si realizaste la llamada en APIYI (apiyi.com), al solucionar problemas compara primero, punto por punto, el ID del modelo y los nombres de campos de tu solicitud con la documentación, y después revisa los demás aspectos. La mayoría de los problemas de «el audio no surte efecto» se pueden localizar en este paso, sin necesidad de dar rodeos.
Sincronización labial con driving_audio de wan2.7-i2v: inicio rápido
Después de confirmar el cambio a wan2.7-i2v, todo el proceso se reduce a cuatro pasos, y el peso está por completo en el ensamblaje de medios:
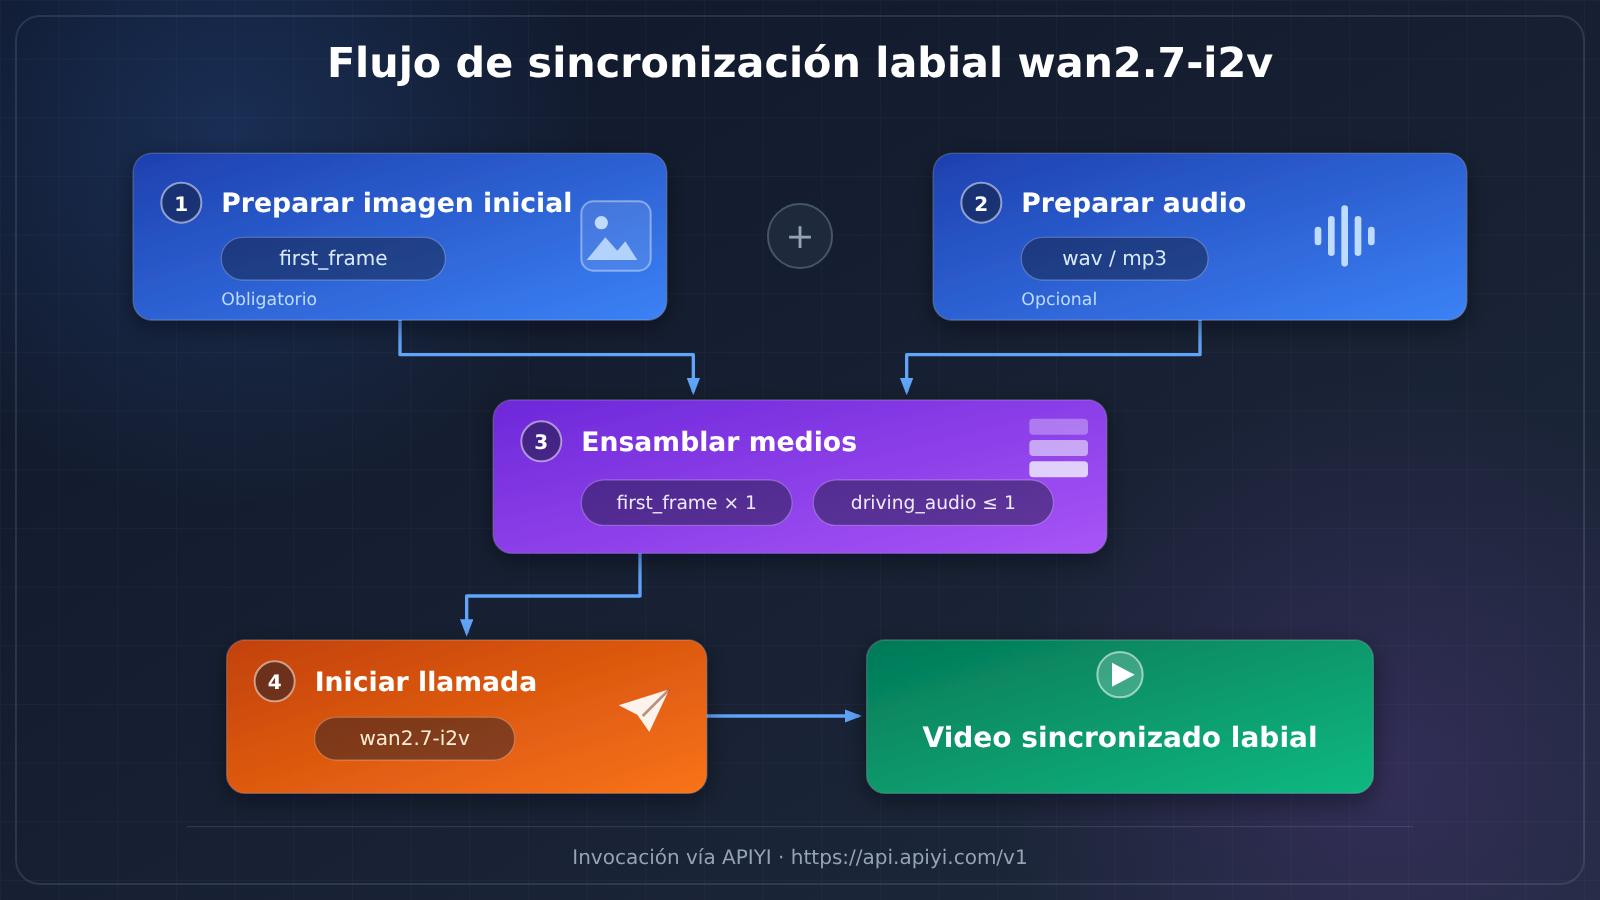
- Preparar la imagen del primer fotograma: una imagen con la persona nítida y composición estable, que servirá como
first_frame. - Preparar el audio: en formato
wavomp3, que actuará comodriving_audiopara impulsar la sincronización labial y el ritmo. - Ensamblar los medios: exactamente 1
first_framey como máximo 1driving_audio, sin añadir nada de más. - Lanzar la invocación: usa el modelo
wan2.7-i2v; al llamar a través de APIYI, la URL base de la interfaz eshttps://api.apiyi.com/v1.
| Campo | ¿Obligatorio? | Restricción de cantidad | Requisito de formato |
|---|---|---|---|
first_frame |
Obligatorio | Exactamente 1 | Imagen del primer fotograma |
driving_audio |
Opcional | Como máximo 1 | wav o mp3 |
Los dos primeros pasos no tienen misterio; lo que realmente decide el éxito o el fracaso es el paso 3. La documentación es muy estricta con las cantidades: first_frame debe haber exactamente 1, y driving_audio es opcional y como máximo 1. Enviar más imágenes o audios de la cuenta puede hacer que la solicitud no cumpla lo acordado, así que no dejes que el instinto de «cuanto más, mejor» se cuele en el ensamblaje de parámetros.
🚀 Inicio rápido: se recomienda validar este flujo directamente a través de APIYI apiyi.com. La plataforma agrega las API de modelos principales como OpenAI, Claude y Gemini; con una sola clave API puedes invocar varios modelos, con facturación por uso, y los nuevos usuarios tienen crédito de prueba gratuito, así que poner en marcha la sincronización labial de
wan2.7-i2vcuesta casi cero.
happyhorse-1.1-i2v o wan2.7-i2v: recomendaciones de escenarios
| Tu necesidad | Modelo recomendado | Entradas clave |
|---|---|---|
| Persona hablando, labios sincronizados con el audio | wan2.7-i2v |
first_frame más driving_audio |
| Actuaciones rítmicas como rap o diálogos | wan2.7-i2v |
first_frame más driving_audio |
| Animar una imagen estática de forma natural, sin sonido | happyhorse-1.1-i2v |
solo first_frame |
Casos en los que conviene seguir con happyhorse-1.1-i2v
Para las tareas de animación que no necesitan audio, happyhorse-1.1-i2v sigue siendo una elección sólida. Su función es convertir una imagen del primer fotograma en un video con sensación de movimiento; la entrada es limpia y solo acepta first_frame. Si el video final se dobla en postproducción, o si directamente no necesitas audio, quedarte aquí te simplifica las cosas.
- Movimiento a partir del primer fotograma: hacer que personajes y paisajes cobren movimiento natural desde una imagen estática.
- Producción de contenido sin sonido: para doblar el video final en postproducción o para escenarios de exhibición donde el audio no hace falta.
Casos en los que conviene cambiar a wan2.7-i2v
Siempre que el video final necesite que el personaje “se mueva al ritmo del sonido”, la respuesta está en wan2.7-i2v. La capacidad de conducción por audio documentada lo convierte en la única opción entre estos dos modelos que recibe driving_audio; la sincronización labial y el ritmo están directamente guiados por el audio.
- Sincronización labial: con un retrato y una voz humana, generas un video en el que la persona habla.
- Actuación guiada por audio: contenido rítmico como rap o diálogos, donde los movimientos siguen el audio.
Si necesitas ambos tipos de casos, puedes probar el mismo conjunto de materiales con cada modelo en APIYI; cambiar de modelo no requiere cambiar la clave API. Compara los resultados y luego decide qué modelo usar para cada tarea, sin prisa.
Recomendaciones de decisión entre happyhorse-1.1-i2v y wan2.7-i2v
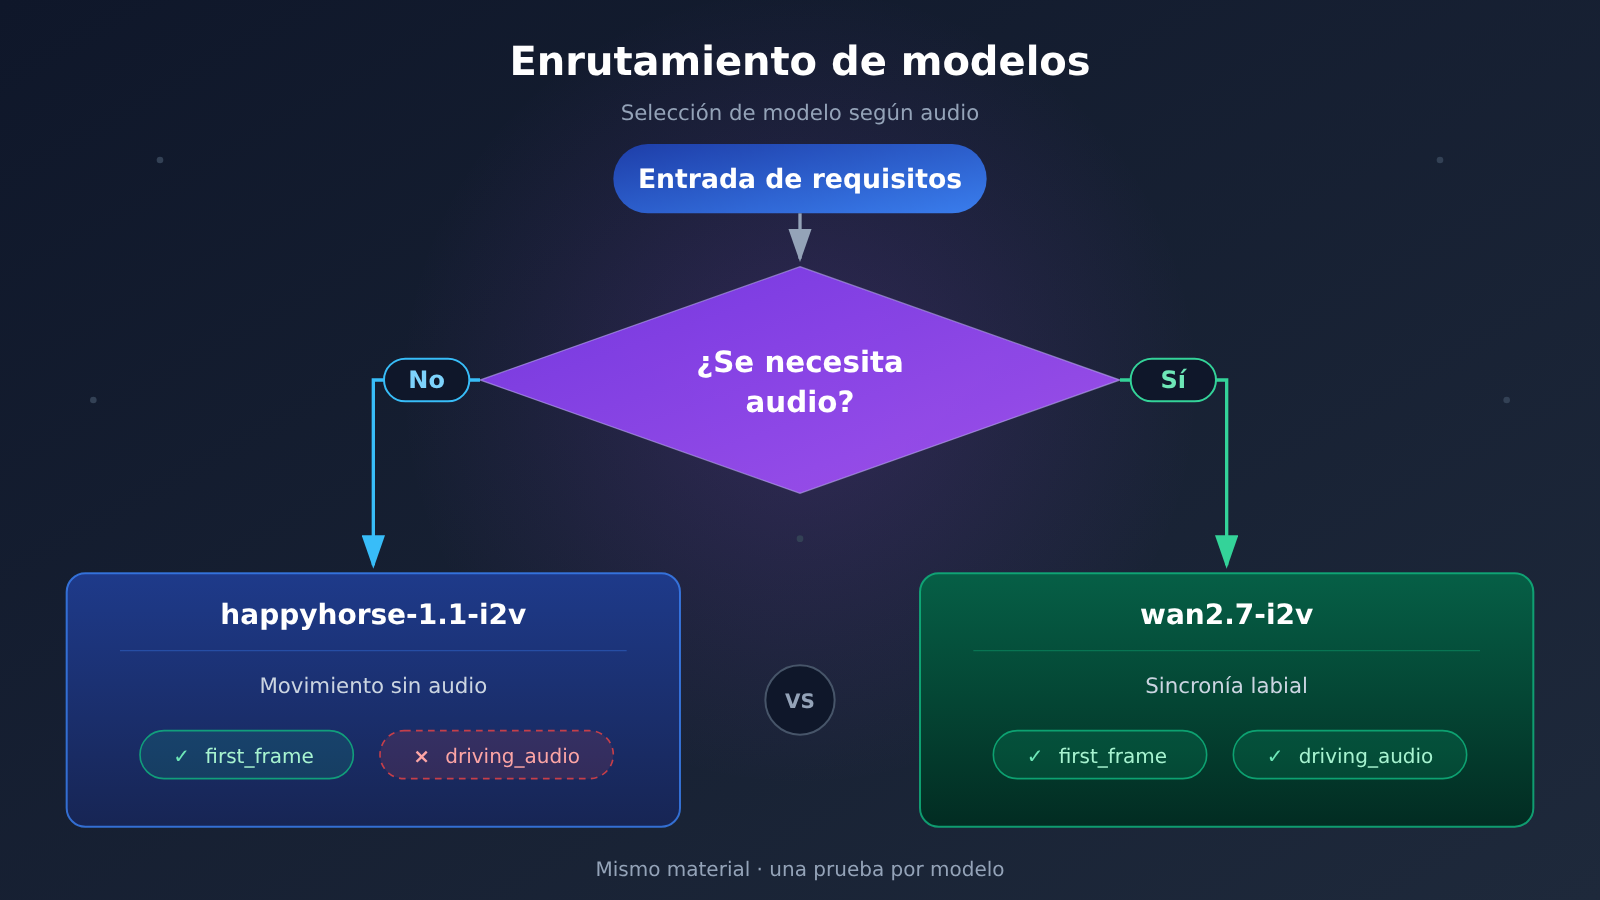
| Estado actual | Acción recomendada |
|---|---|
| La sincronización labial es requisito indispensable | Usar directamente wan2.7-i2v, con driving_audio |
| Solo se necesita que la imagen se mueva | Permanecer en happyhorse-1.1-i2v, pasar solo first_frame |
Ya se pasó audio a happyhorse-1.1-i2v pero no surte efecto |
Dejar de reintentar, cambiar a wan2.7-i2v, no es un problema de parámetros |
La decisión se reduce a una sola frase: preguntar primero «¿este video necesita hablar?». Si se necesita que la voz participe en la actuación, la respuesta es wan2.7-i2v; si no, happyhorse-1.1-i2v sigue siendo capaz de generar video a partir del primer fotograma. Entregar el audio al modelo correcto ahorra más tiempo que insistir con parámetros en cualquier modelo.
💡 Consejo de elección: cuando no estés seguro del resultado, no te quedes en razonamientos a nivel de documentación; ejecuta una vez el caso mínimo en APIYI apiyi.com para cada modelo y decide con dos resultados reales, que es lo más fiable.
Preguntas frecuentes sobre driving_audio
P1: ¿Qué es happyhorse-1.1-i2v?
Es un modelo de video a partir de imagen del primer fotograma, cuya entrada solo acepta `first_frame`. La documentación indica claramente que no admite `driving_audio`: la conducción por audio no entra dentro de sus capacidades.
P2: ¿Cuál es la diferencia entre happyhorse-1.1-i2v y wan2.7-i2v en cuanto a la conducción por audio?
La documentación etiqueta la conducción por audio como una capacidad exclusiva de `wan2.7-i2v` y, al mismo tiempo, especifica que el i2v de HappyHorse no la admite. Dicho de otro modo, `wan2.7-i2v` acepta `driving_audio` y `happyhorse-1.1-i2v` no. Para saber si otros modelos lo admiten, consulta la documentación de cada uno y no lo deduzcas por el nombre de la familia.
P3: ¿Qué pasa si le pasas driving_audio a happyhorse-1.1-i2v?
La respuesta de la documentación es directa: no lo admite, solo acepta `first_frame`. En lugar de investigar los detalles de cada tipo de respuesta, es mejor dirigir ese conjunto de materiales a `wan2.7-i2v`: la misma imagen y el mismo audio enseguida te servirán.
P4: ¿Qué requisitos de formato y cantidad tiene driving_audio?
El formato de audio debe ser `wav` o `mp3`; en el contenido multimedia debe haber exactamente 1 `first_frame` y como máximo 1 `driving_audio`. Si armas la solicitud respetando esta restricción, la tasa de éxito al primer intento será la más alta.
P5: ¿Cómo llamar rápidamente a wan2.7-i2v mediante la API?
Se recomienda empezar desde una plataforma agregadora:
1. Regístrate en APIYI apiyi.com y obtén una clave API; los usuarios nuevos tienen crédito de prueba gratuito;
2. Usa `https://api.apiyi.com/v1` como dirección base de la interfaz;
3. Arma el contenido multimedia con «1 `first_frame` más 1 `driving_audio`» y pon `wan2.7-i2v` como modelo.
P6: ¿Todos los modelos de la familia Wan pueden recibir audio de esta forma?
No se puede generalizar así. La documentación atribuye la conducción por audio únicamente a `wan2.7-i2v`; para saber si otros modelos lo admiten, consulta la documentación correspondiente y no adivines capacidades por el nombre de la familia.
P7: ¿Dónde puedo verificar las capacidades de estos dos modelos?
APIYI describe los límites de capacidad en la documentación de cada modelo; entra en docs.apiyi.com para verificarlo punto por punto. Consultar la documentación antes de elegir un modelo sale mucho más barato que investigar después de tropezar.
Puntos clave de happyhorse-1.1-i2v y driving_audio
- Límite de capacidades:
happyhorse-1.1-i2vsolo aceptafirst_frame;driving_audiono forma parte de sus entradas. - Capacidad exclusiva: la conducción por audio es cosa de
wan2.7-i2v; si necesitas sincronización labial, ve directamente a ese modelo. - Restricciones de medios: exactamente 1
first_frame, como máximo 1driving_audio, y el audio debe serwavomp3. - Guía de migración: la documentación recomienda pasar de
happyhorse-1.1-i2vawan2.7-i2ven escenarios de sincronización labial o rap. - Cómo verificarlo: ejecuta un caso de uso mínimo con cada modelo usando el mismo conjunto de materiales; con dos resultados podrás cerrar la decisión.
Conclusión
Sobre eso de «hacer que la imagen hable», tres conclusiones que vale la pena llevarse:
- Límite de entrada:
happyhorse-1.1-i2vno aceptadriving_audio, solo reconocefirst_frame. Este es el límite de capacidad que la documentación deja claro. - El lugar correcto: la sincronización labial y la conducción por audio son capacidades exclusivas de
wan2.7-i2v; basta una imagen más unwavomp3para ponerse manos a la obra. - Enfoque para solucionar problemas: cuando el audio no surte efecto, lo primero es revisar la correspondencia entre modelo y campo, no ponerse a reintentar una y otra vez.
Si dudas en la selección, ejecuta una vez cada modelo con un caso mínimo y luego decide. Para validar rápido, te recomiendo APIYI apiyi.com: la plataforma ofrece cuota de prueba gratuita y acceso unificado a múltiples modelos, así que cambiar de modelo no requiere cambiar de clave.
📚 Referencias
- Documentación de APIYI · HappyHorse imagen a video
- Enlace:
docs.apiyi.com/api-capabilities/happyhorse/image-to-video.md -
Descripción: definición de las entradas de
happyhorse-1.1-i2vy el texto original donde se indica que «no admitedriving_audio«. -
Documentación de APIYI · Wan imagen a video
- Enlace:
docs.apiyi.com/api-capabilities/wan/image-to-video.md -
Descripción: restricciones de cantidad y formato que
wan2.7-i2vimpone afirst_frameydriving_audio. -
Documentación de APIYI · Panorama general de HappyHorse
- Enlace:
docs.apiyi.com/api-capabilities/happyhorse/overview.md - Descripción: anotación general sobre la capacidad de impulso por audio en la sección de imagen a video.
Autor: Equipo técnico de APIYI
Contacto técnico: puedes escribirnos desde la página de inicio del sitio web de APIYI; para más materiales, visita el centro de documentación en docs.apiyi.com


