
Integrar la API de un Modelo de Lenguaje Grande de terceros en el entorno de producción nunca se vuelve difícil en el momento en que la primera línea de código funciona. Lo que de verdad determina si el proyecto se puede entregar de forma estable son esos problemas que aparecen durante el primer mes después del lanzamiento y que no hay manera de anticipar: la petición vuelve pero con un formato incorrecto, el cliente agota el tiempo de espera mientras la plataforma ya te ha cobrado, el canal principal se cae y el respaldo cambia sin avisar a un modelo más caro, o a los tres meses quieres hacer una retrospectiva y descubres que los logs ya se borraron.
Este no es otro artículo del tipo «qué plataforma de API es mejor»: aquí no repetimos los adjetivos de las páginas promocionales de los proveedores ni publicamos ningún ranking de plataformas. Hablamos de una sola cosa que sí se puede llevar a la práctica: antes de salir a producción, qué evidencias verificables tienes en la mano para juzgar si un servicio proxy de API y gateway de Modelos de Lenguaje Grande es de fiar.
Valor central: al terminar de leer tendrás un método de comprobación con una lista de 7 puntos de aceptación y 1 tabla de conclusiones, para pasar del «parece que va bien» al «lo puedo demostrar con datos».
Primero los términos: entender estas 6 palabras antes de hablar de la puesta en producción
Antes de entrar en los métodos de aceptación, conviene alinear una serie de términos que aparecen una y otra vez. En la documentación de proveedores y en los artículos técnicos se usan a menudo con criterios distintos, y esa falta de criterio común es ya de por sí un riesgo para la puesta en producción.
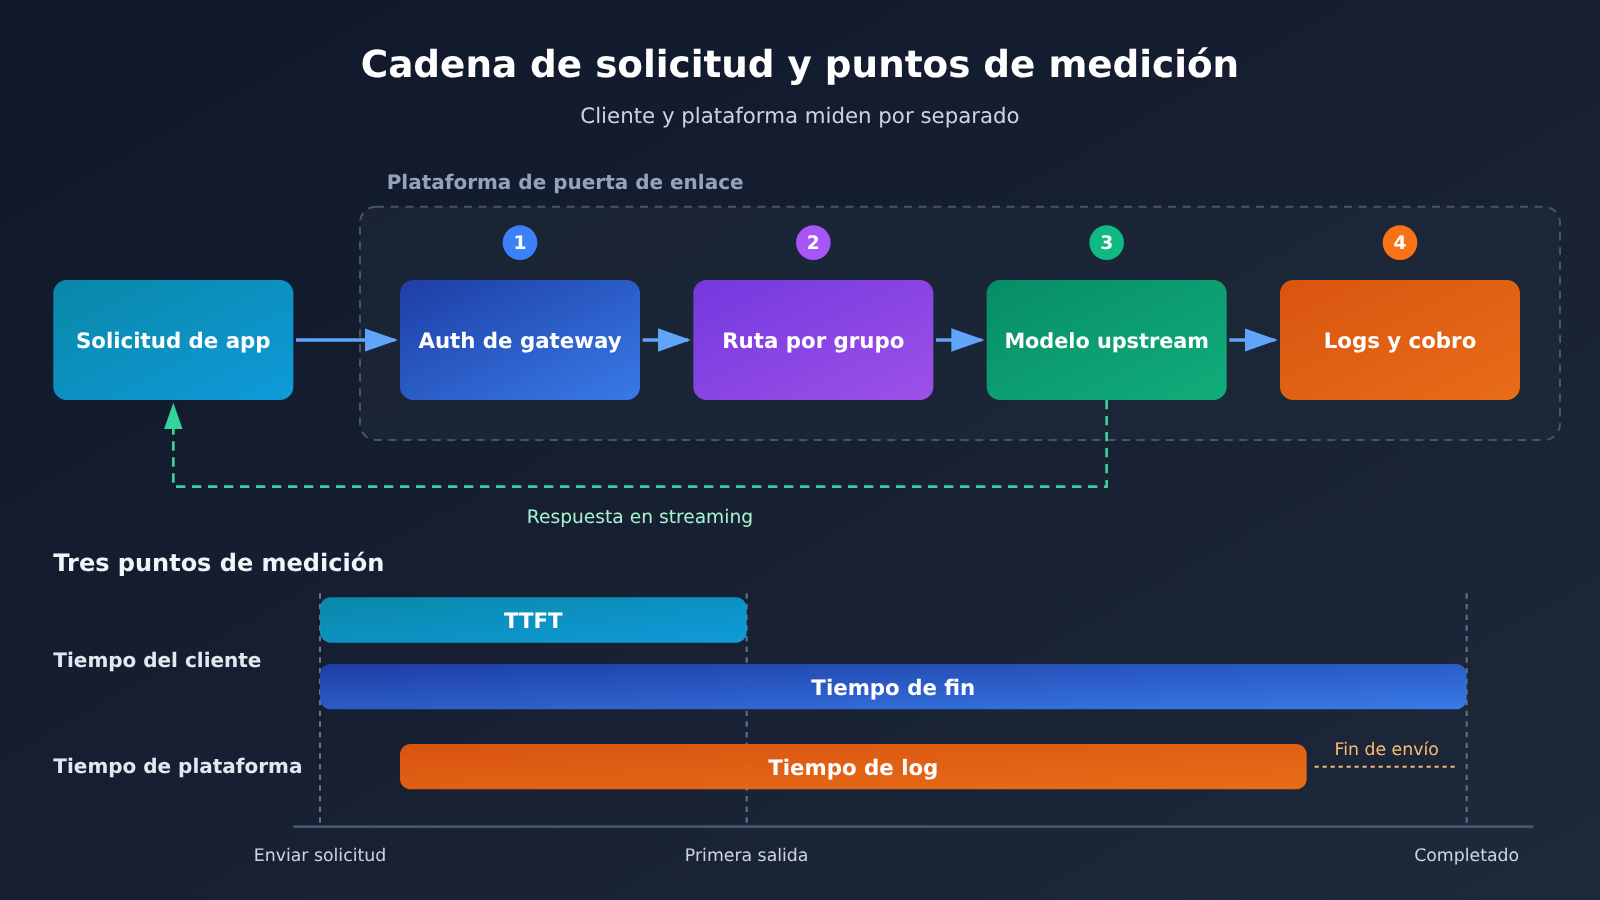
- API gateway: el punto de entrada que recibe las peticiones de la aplicación y las deriva al servicio de modelo upstream. Normalmente asume también cuatro responsabilidades —autenticación, facturación, enrutamiento y registro—, así que el fallo de una invocación puede producirse en cualquier capa de la cadena y la atribución de responsabilidad tiene que quedar clara desde el principio.
- TTFT (tiempo hasta el primer token de salida válido): el tiempo que transcurre desde que se envía la petición hasta que llega el primer token de salida válido. En una interacción en streaming, lo que percibe el usuario es este valor, no el tiempo total de la respuesta completa.
- p95: el valor que no supera aproximadamente el 95 % de las muestras. La media oculta las peticiones lentas; el p95 es el que deja al descubierto ese pequeño grupo de invocaciones que «de vez en cuando se quedan colgadas diez y pico segundos».
- RPM y concurrencia: RPM es el número de peticiones iniciadas por minuto; la concurrencia es el número de peticiones que siguen ejecutándose en el mismo instante. Cuanto más tarda en ejecutarse una petición, más alta puede ser la concurrencia en vuelo aunque el RPM sea bajo, de modo que ambos valores deben registrarse por separado.
- Fallback (respaldo): el mecanismo que intenta un canal o un modelo alternativo cuando el servicio principal no puede atender la petición. En la aceptación hay que comprobar a la vez el modelo final, la funcionalidad principal, el límite de coste y la política de datos, y no solo si la petición se completó con éxito.
- SLA: acuerdo de nivel de servicio; fija el criterio de las métricas, el ámbito estadístico, la responsabilidad ante fallos y las condiciones de compensación. Es un acuerdo ejecutable, no un porcentaje que se pueda citar por sí solo.
Información clave: la confiabilidad del gateway debe desglosarse en 5 niveles de verificación
El valor de un servicio proxy de API y de un gateway para Modelos de Lenguaje Grande está en unificar la interfaz, pero esa misma comodidad tiende a ocultar las diferencias de fondo. Detrás de un base_url compatible con OpenAI puede haber proveedores upstream completamente distintos, políticas de límite de velocidad distintas, reglas de retención de logs distintas y procesos de gestión de fallos distintos.
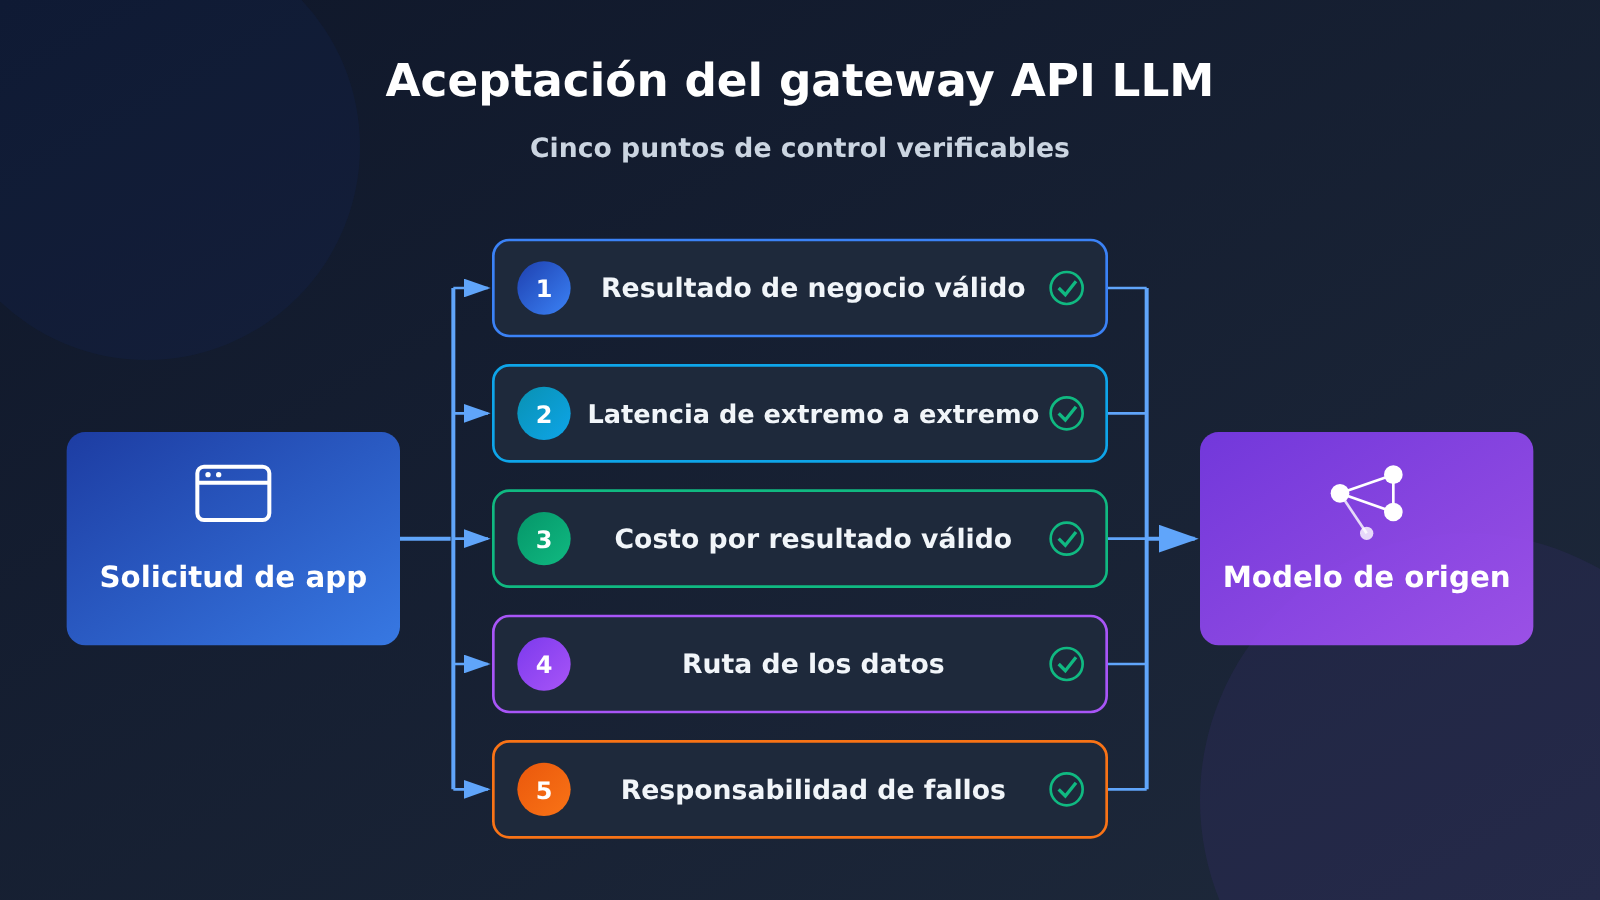
Por eso, la decisión de salir a producción no puede reducirse a preguntar «¿responde o no responde?». Hay que observar tres cosas a la vez: si el resultado sirve, si la espera es aceptable y si las anomalías se pueden rastrear. La tabla siguiente despliega esas tres preguntas en 5 niveles de verificación, que además son el esqueleto de las cinco secciones que vienen en este artículo.
| Nivel de verificación | Pregunta a responder | Criterio de evaluación | Error de juicio habitual |
|---|---|---|---|
| Resultados utilizables para el negocio | ¿El contenido devuelto puede entrar directamente en el flujo de negocio? | Número de respuestas completas, número de respuestas con formato utilizable, número de aprobaciones según el criterio de negocio | Tomar un HTTP 200 como éxito |
| Latencia de extremo a extremo | ¿Cuánto espera el usuario hasta ver el primer fragmento de salida válida? | p50 y p95 del TTFT y del tiempo de finalización, cronometrados por separado en el cliente y en la plataforma | Mirar solo el tiempo medio |
| Coste por resultado utilizable | ¿Cuánto cuesta realmente cada resultado que sirve? | Todo el gasto ya liquidado dividido entre el número de resultados utilizables para el negocio | Comparar solo el precio unitario, sin contar reintentos ni mecanismos de respaldo |
| Ruta de los datos | ¿Por manos de quién pasan las entradas y salidas, cuánto tiempo se conservan, quién puede verlas? | Políticas por capas: gateway, proveedor upstream, logs y productos asíncronos | Confundir el cifrado en tránsito con la imposibilidad de leer el contenido |
| Responsabilidad ante fallos | ¿Con qué criterio se determina un incidente y cómo se compensa? | El periodo de medición del SLA, las exclusiones, el proceso de solicitud y la forma de compensación | Tomar una nota pública como un compromiso contractual |
🎯 Consejo técnico: convierte esta tabla en la lista de aceptación de tu propio equipo y rellena, en cada fila, la fuente de la evidencia. Si antes necesitas dejar funcionando la cadena de invocación, puedes obtener crédito de prueba a través de APIYI apiyi.com y usar el mismo script para registrar una comparativa entre varios modelos.
Por qué definir la fiabilidad como condición de aceptación del negocio
Una interfaz unificada reduce el coste de integración, pero también traslada al equipo de aplicación una serie de decisiones que antes pertenecían a la infraestructura. Antes tenías que mantener tu propia lógica de reintentos y varios SDK; ahora basta con cambiar un base_url para invocar muchos modelos. El precio es que ves bastante menos de lo que ocurre en el camino de la petición.
Por eso el primer paso de la aceptación no es medir el rendimiento, sino dejar bien claro qué significa «disponible». Que la plataforma facture una petición como exitosa, que el cliente reciba un 200 y que el negocio logre parsear la respuesta son tres cosas distintas, y hay que contarlas por separado. Un JSON con estructura inválida sigue siendo producción cero para el negocio, aunque la plataforma haya completado la petición con normalidad, y aun así genera coste.
El segundo paso es dividir el conjunto de pruebas según el tipo de uso del negocio. En preguntas y respuestas interactivas se mira la primera salida válida y el tiempo límite de la respuesta completa; en las invocaciones de herramientas, si la estructura de los parámetros es válida y los campos están completos; en el procesamiento por lotes, cuántos resultados utilizables se obtienen antes de la fecha límite de entrega. Si mezclas estos tres casos en un único «tiempo medio», la conclusión saldrá distorsionada sin remedio.
El tercer paso es alinear el criterio de medición del tiempo. La espera que mide el cliente y el tiempo que registra el log de la plataforma no cubren las mismas fases. La documentación oficial ya describe casos en los que «la plataforma registra la petición como exitosa y la factura, pero el cliente agota el tiempo de espera durante la transmisión de la respuesta o el cierre de la conexión». Además, si el sistema prueba automáticamente otras rutas en segundo plano, la espera total también se alarga. Por eso, ante cada anomalía, primero hay que cruzar tres fuentes (el registro del cliente, el log de la plataforma y el movimiento del saldo) usando el identificador de negocio y el request_id, y solo entonces decidir si se reintenta o no.
Cómo probar la capacidad del gateway y la carga en horas pico con tareas fijas
Para que una prueba sea reproducible, primero hay que fijar las variables: versión del modelo objetivo, canal o grupo, interfaz de invocación, parámetros principales, punto de entrada de red, tamaño de entrada y salida, y si se usa streaming o no. Si cambia cualquiera de ellas, los datos de una ejecución y otra ya no se pueden comparar. Las muestras deben salir de datos reales del negocio, anonimizados, y no de entradas de juguete tipo «hola».
La siguiente tabla es una plantilla de registro de aceptación que puedes usar tal cual. Es una recomendación de método y no incluye ninguna conclusión medida sobre ninguna plataforma. Los umbrales los defines tú según tus necesidades de negocio: por ejemplo, en cuántos segundos debe llegar la primera salida válida en una tarea interactiva, o cuántos resultados utilizables hay que entregar en cuántas horas en una tarea offline.
| Dimensión | Qué registrar | Cómo evaluarlo |
|---|---|---|
| Entrega de negocio exitosa | Total de solicitudes, respuestas completas, respuestas con formato utilizable, respuestas aprobadas por el criterio de negocio | Escribe el denominador completo y fíjate al final en la proporción de resultados utilizables para el negocio |
| Latencia | Hora de envío, hora de la primera salida válida, hora de finalización, tiempo según el log de la plataforma | Mide por separado en el cliente y en la plataforma, y calcula p50 y p95 |
| Capacidades clave | Cierre correcto del streaming, validez de los parámetros de herramientas, parseo de salida estructurada, manejo de entradas largas | Verifica una por una las capacidades de las que depende realmente tu producto |
| Carga en horas pico | Solicitudes en vuelo simultáneas, solicitudes por minuto, proporción de 429, colas y reintentos | Mantén constante el tamaño de las solicitudes, aumenta la carga por niveles y deja una ventana de observación |
| Costo | Cobro por cada llamada, reembolsos, costos de contingencia, número de resultados utilizables | Calcula el costo total que soporta cada resultado utilizable |
| Capacidad de diagnóstico | ID de negocio, request_id, modelo y grupo, código de error, respuesta del ticket | Debes poder vincular un pedido anómalo con el registro de la plataforma |
El siguiente script hace una sola cosa: en una llamada con streaming registra a la vez el tiempo hasta la primera salida válida y el tiempo total, para que puedas comparar el cronómetro del cliente con el log de la plataforma en una misma línea de tiempo.
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI
)

start = time.perf_counter()
stream = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "用一句话说明什么是 API 网关"}],
    stream=True,
)
ttft = None
for chunk in stream:
    delta = chunk.choices[0].delta.content
    if delta and ttft is None:
        ttft = time.perf_counter() - start
total = time.perf_counter() - start
print(f"TTFT {ttft:.3f}s / total {total:.3f}s")
Ver el código de prueba de carga por lotes y estadísticas de percentiles
import statistics
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI
)

def one_call(prompt: str) -> dict:
    start = time.perf_counter()
    ok, ttft = False, None
    try:
        stream = client.chat.completions.create(
            model="gpt-4o-mini",
            messages=[{"role": "user", "content": prompt}],
            stream=True,
        )
        for chunk in stream:
            delta = chunk.choices[0].delta.content
            if delta and ttft is None:
                ttft = time.perf_counter() - start
        ok = True
    except Exception as exc:
        return {"ok": False, "ttft": None,
                "total": time.perf_counter() - start, "err": type(exc).__name__}
    return {"ok": ok, "ttft": ttft,
            "total": time.perf_counter() - start, "err": None}

def summarize(rows: list) -> None:
    done = [r for r in rows if r["ok"]]
    totals = sorted(r["total"] for r in done)
    print(f"成功率 {len(done)}/{len(rows)}")
    if totals:
        print(f"p50 {statistics.median(totals):.3f}s")
        print(f"p95 {totals[int(len(totals) * 0.95) - 1]:.3f}s")

rows = [one_call("把下面这句话翻译成英文:请检查订单状态。") for _ in range(50)]
summarize(rows)
El error más común en las pruebas de carga es confundir RPM con concurrencia. Las solicitudes por minuto, los tokens por minuto y las solicitudes simultáneas en curso son tres restricciones distintas, y ninguna sustituye a las otras. Además, cuando sube la latencia, los reintentos amplifican la presión sobre el sistema, así que tu script debe incluir una cola local, un tiempo máximo de espera y reintentos con backoff acotado.
Hay otro detalle que se pasa por alto con facilidad: en la documentación de APIYI, la página de «Concurrencia» y la de «Tokens y grupos» no describen exactamente igual el alcance del límite de velocidad. La primera menciona que la cuota de cada token es independiente, mientras que la segunda indica que el límite sigue a la cuenta. Lo correcto al validar es medir la cuota real con tu propia cuenta y el canal que vas a usar, registrando por separado la concurrencia y el RPM. No copies las cifras fijas de capturas de pantalla ajenas, ni intentes saltarte el límite creando más claves.
Cómo verificar el costo por resultado utilizable y el comportamiento de respaldo
Más útil que comparar el precio unitario es comparar el «costo real por resultado utilizable para el negocio». La fórmula es sencilla: en el numerador va todo el gasto ya liquidado (incluidos reintentos y respaldos) y en el denominador el número de resultados utilizables para el negocio. Los reembolsos confirmados se restan del numerador.
Lo que sigue es un ejemplo puramente hipotético, solo para ilustrar el cálculo; no representa los precios de ningún proveedor.
| Opción | Gasto neto liquidado | Resultados utilizables | Costo por resultado utilizable |
|---|---|---|---|
| Opción A | 3,0 USD | 90 | aprox. 0,0333 USD |
| Opción B | 3,2 USD | 98 | aprox. 0,0327 USD |
Si solo miras el gasto, la opción A sale más barata; pero si lo calculas por resultado utilizable, la opción B resulta más rentable. Por eso la pregunta «¿quién es más barato?» no tiene sentido si no hay un denominador de negocio. Hay además dos cosas que conviene tener en cuenta: el crédito retenido de tareas asíncronas que todavía no se ha liquidado debe listarse aparte, y si solo acumulas los registros de consumo puedes sobrestimar el gasto neto, porque los reembolsos de tareas asíncronas aparecen en la factura como registros en negativo.
La parte del respaldo (fallback) hay que separarla en dos cambios totalmente distintos. El cambio de canal consiste en cambiar de ruta dentro del mismo modelo, así que en teoría ni las capacidades ni el precio del modelo cambian. El cambio de modelo, en cambio, prueba otros modelos de una lista cuando el modelo principal no está disponible. Es un mecanismo habitual en la industria: por ejemplo, los model fallbacks de OpenRouter indican expresamente que se cobra según el precio del modelo realmente utilizado y que el modelo final se señala en el campo model de la respuesta. Este ejemplo sirve solo para ilustrar el mecanismo; el significado de los campos no es extrapolable a otras plataformas.
Por eso, los criterios de aceptación deben cubrir como mínimo cuatro puntos: qué modelo es el final tras el respaldo, si la funcionalidad central sigue funcionando, si hay un tope de costo por llamada y cuál es el tiempo máximo de espera. Si en algún tipo de negocio no se permite cambiar de modelo, además tendrás que confirmar si el respaldo se puede desactivar. Los escenarios de streaming hay que probarlos por separado: si el fallo ocurre después de haber devuelto parte de la salida, ¿se puede retomar sin cortes? Eso no se puede deducir de un respaldo exitoso en modo no streaming.
💡 Recomendación: compara el precio de conexión directa y la ruta de respaldo en la misma tabla; solo así se ve el costo real. Si quieres obtener rápido registros de cobro reales de varios modelos para compararlos, puedes ejecutar un lote pequeño de muestras a través de APIYI (apiyi.com) y luego volver a tu propia tabla de aceptación para hacer las cuentas.
Cómo verificar la cadena de datos y la responsabilidad ante fallos
Estos dos puntos son los que más fácilmente se despachan con frases como «somos muy seguros» o «somos muy estables», y sin embargo son lo único que te puede salvar cuando algo sale mal. Para verificarlos, hay que colocar en una misma cadena de datos el gateway, el proveedor del modelo upstream, los registros detallados de diagnóstico y los artefactos asíncronos, y preguntar por la política de cada capa.
| Eslabón de la cadena | Política que hay que verificar | Cómo verificarla |
|---|---|---|
| El propio gateway | Si guarda entradas y salidas por defecto, quién puede activar los registros de diagnóstico y cuánto tiempo se conservan | Leer la documentación oficial de seguridad de datos y registros |
| Proveedor del modelo upstream | Uso para entrenamiento, plazo de conservación, si requiere autorización explícita | Leer por separado la política de cada upstream, sin fundirlas en una sola |
| Registros detallados de diagnóstico | Alcance del registro, quién puede verlos, plazo de conservación por defecto, momento de borrado tras desactivarlos | Confirmar que desactivar el interruptor no equivale a borrar de inmediato los registros existentes |
| Artefactos de tareas asíncronas | Dónde se almacenan, vigencia de los enlaces de descarga | Guardarlos a tiempo en tu propio sistema, sin depender de enlaces temporales |
Según la documentación pública, la política habitual de APIYI es no guardar por defecto las entradas y salidas de los clientes. Los registros detallados de diagnóstico los puede activar temporalmente un administrador para registrar la entrada completa, el contexto y la salida; el contenido solo es visible para los administradores, y el plazo de conservación por defecto que indica la página es de 7 a 30 días. Esa misma página aclara también que desactivar el interruptor de registro no debe interpretarse como que los registros existentes se hayan borrado de inmediato. Conviene mantener siempre la atribución de «según lo que indica la documentación oficial»: no equivale a una certificación de cumplimiento ni a una conclusión jurídica.
Hay otro dato operativo que se suele pasar por alto: los propios registros tienen un ciclo de vida. La nota específica de APIYI sobre retención de registros indica que los registros de invocación se conservan de forma rotativa durante unos dos meses; los días 5, 15 y 25 de cada mes se eliminan los registros con más de dos meses de antigüedad, y esa limpieza no es recuperable. Si necesitas el detalle para conciliaciones y auditorías a largo plazo, tienes que exportarlo y guardarlo tú mismo. Además, los plazos de almacenamiento de los resultados síncronos y de los artefactos asíncronos son distintos: la página indica que los enlaces de descarga de los artefactos son válidos durante aproximadamente un día. Si haces el análisis posterior pasada esa ventana, ya no tendrás pruebas.
La responsabilidad ante fallos, por su parte, debe aterrizarse en cláusulas ejecutables. La página específica de SLA de APIYI describe la reposición de crédito cuando la pérdida se debe a causas atribuibles a la plataforma, y explica que las empresas pueden pactar en el contrato el alcance de la garantía, los indicadores de disponibilidad, los tiempos de respuesta y el límite de indemnización; la página no ofrece a todos los clientes un porcentaje de disponibilidad fijo y único. Al comparar proveedores, anota el período de medición del indicador, la definición del denominador, las exclusiones por fallos, el proceso de reclamación y la forma de compensación, y distingue con claridad la diferencia de valor de compra entre una compensación en crédito de servicio y una indemnización en efectivo.
Decidir el alcance del lanzamiento con una tabla de aceptación
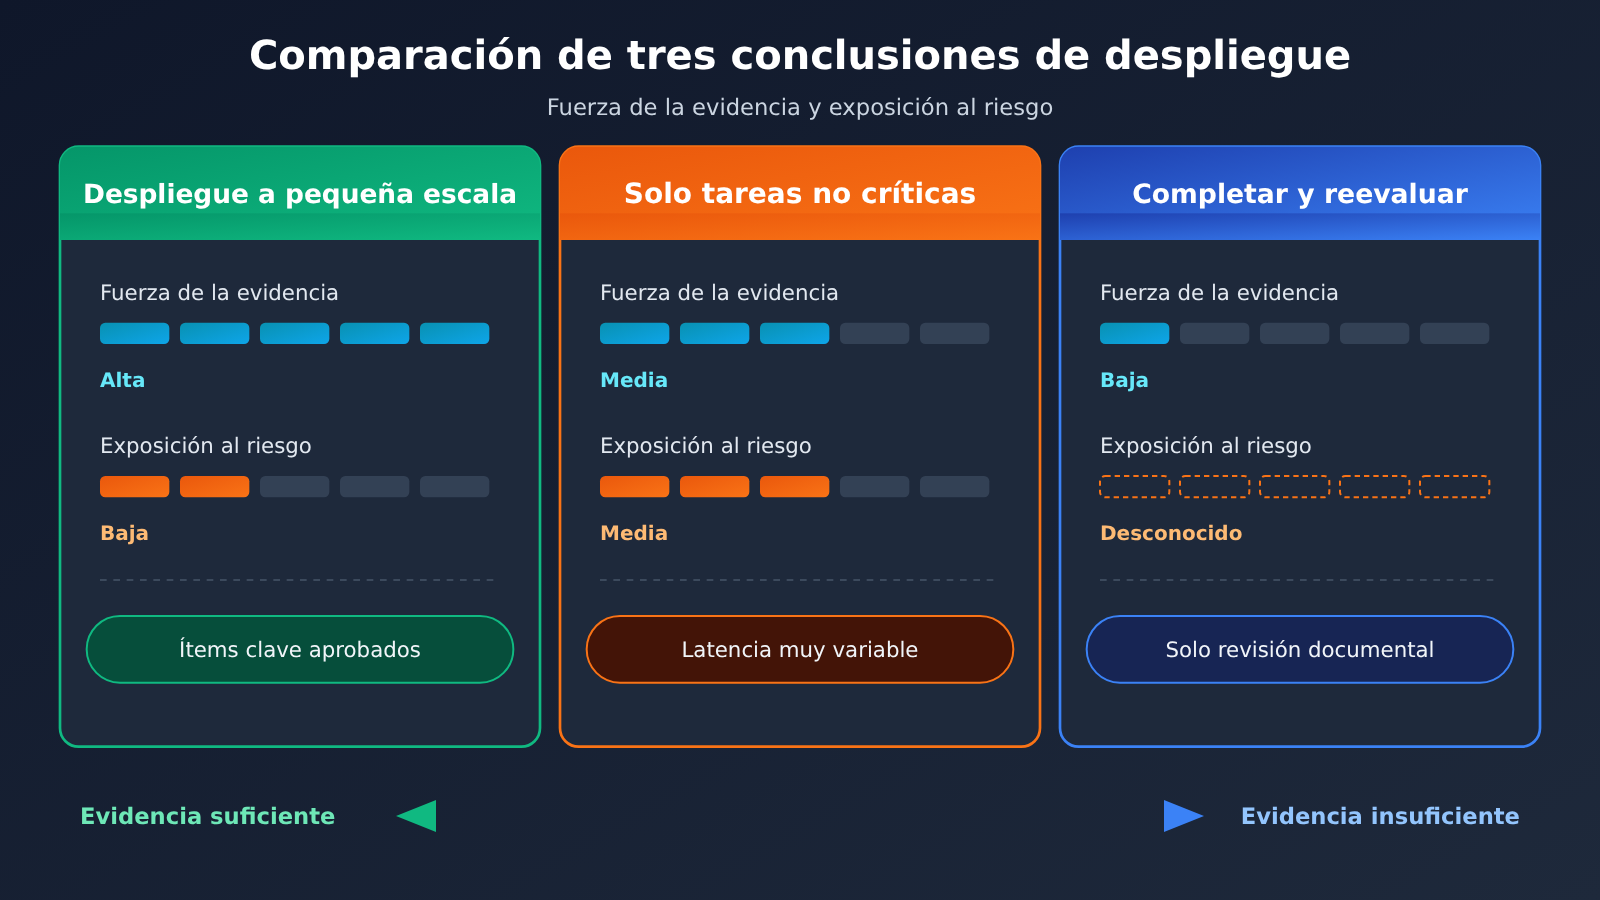
Cuando juntes todos los registros en una conclusión, no entregues un «ranking de fiabilidad»: entrega un juicio sobre el alcance. Un mismo proveedor puede servir solo para «tareas no críticas» en tu negocio interactivo y ser más que suficiente para tu procesamiento por lotes offline.
| Conclusión | Evidencia que debes presentar | Condiciones para cambiar o detener |
|---|---|---|
| Se puede lanzar a pequeña escala | Las capacidades clave pasan una por una, el p95 está dentro del umbral del negocio, el costo por resultado utilizable es aceptable, y el flujo de datos y el SLA están verificados | La tasa de resultados utilizables cae por debajo del umbral de forma sostenida, o hay anomalías de facturación que no se pueden conciliar |
| Solo para tareas no críticas | Las capacidades pasan, pero la latencia fluctúa mucho, o el mecanismo de respaldo cambia el modelo y el costo | Las rutas críticas vuelven a infraestructura propia o a conexión directa, y la estrategia de respaldo se desactiva de forma explícita |
| Reevaluar cuando se completen las condiciones | Solo hay revisión documental, faltan pruebas reales con tu cuenta, o las cláusulas del SLA no están plasmadas en el contrato | Se vuelve a emitir la conclusión cuando se completen los datos de las pruebas reales y las cláusulas contractuales |
Si por ahora solo puedes hacer una revisión documental, escribe la conclusión tal como es: «capacidades públicas y condiciones de contratación verificadas», y deja la aceptación real para la siguiente ronda. Si necesitas comprobar cómo se comporta el sistema ante fallos, usa las configuraciones de prueba que el proveedor permita o un entorno aislado; no interfieras artificialmente con servicios de producción compartidos. Y si se agota el tiempo de espera y no sabes cuál fue el resultado, primero verifica la ejecución y la facturación, para no repetir la misma acción de negocio dos veces.
🚀 Inicio rápido: si no quieres montar los scripts de prueba desde cero, puedes usar primero el crédito de prueba gratuito de APIYI (apiyi.com) para recorrer las columnas de «capacidad» y «latencia» de la lista de 7 puntos anterior, y después decidir si pasas a una fase de pruebas de carga más pesada.
Preguntas frecuentes (FAQ)
P1: ¿Qué son exactamente una pasarela y un servicio proxy de API para Modelos de Lenguaje Grande?
Es la capa de entrada que se sitúa entre tu aplicación y el servicio de modelos de origen: recibe la petición y se encarga de la autenticación, la facturación, el enrutamiento y el registro de logs. Lo de «proxy» hace referencia a que unifica varios modelos en una sola interfaz compatible. Lo que ganas es comodidad de integración; lo que pierdes es visibilidad sobre el enlace subyacente.
P2: ¿En qué se diferencia, en fiabilidad, usar la API oficial directamente frente a una pasarela proxy?
La diferencia está en el número de capas y en los límites de responsabilidad. Con conexión directa, solo tienes que evaluar un proveedor de origen. Con una pasarela, pueden fallar tres capas: la propia pasarela, el canal por grupos y el proveedor de origen. A cambio, también aparece la posibilidad de contar con un mecanismo de respaldo y con logs unificados. La forma de decidir no es ver cuál es más rápida, sino recopilar evidencias de cada uno de los 5 niveles que se describen en este artículo.
P3: ¿Por qué no basta con mirar la latencia media?
Porque la media oculta las pocas peticiones extremadamente lentas, y justamente esas suelen ser el origen de las quejas de los usuarios. En las interacciones con streaming, además, conviene medir por separado el TTFT y el tiempo total de finalización, e indicar el número de muestras, la ventana de tiempo y si se incluyen fallos, colas y reintentos. Sin eso, ni siquiera el p95 es comparable.
P4: Si la petición se completó pero el contenido no sirve, ¿es un problema de la plataforma?
Normalmente no, pero el coste sí cuenta. Si la plataforma completa la petición con normalidad, se cobra; que la estructura de salida sea inválida es algo que debe reintentar el lado del negocio, y ese gasto repetido tiene que sumarse al numerador del «coste por resultado utilizable». Por eso, en la tabla de validación hay que separar en dos columnas el éxito de ejecución de la plataforma y la aprobación según el criterio de negocio.
P5: ¿Cómo puedo comprobar rápido si una pasarela aguanta mi caso de uso?
Usa tus propias muestras anonimizadas, fijando el modelo, el canal, los parámetros y el tamaño de entrada, y lanza una ronda con pocas muestras. Registra el TTFT, el p95, la proporción de resultados utilizables para el negocio y el detalle de los cargos. Puedes conseguir crédito de prueba en APIYI (apiyi.com) para hacer esta ronda y luego volcar los datos en la tabla de validación, en lugar de sacar conclusiones a partir de una sola prueba de conectividad.
P6: ¿Qué limitaciones conocidas tiene este método?
El p95 con pocas muestras fluctúa mucho y no debe tomarse como un compromiso de servicio a largo plazo. Además, la carga del proveedor de origen varía según la franja horaria y eso también afecta a las conclusiones, así que hay que repetir las pruebas en distintos momentos. Por último, todos los criterios de cálculo de este artículo son recomendaciones metodológicas: no incluyen datos de rendimiento medidos de ninguna plataforma ni facturas reales, y la decisión final debe tomarse según tus propios umbrales de negocio y las condiciones del contrato.
Puntos clave de una pasarela proxy de API para Modelos de Lenguaje Grande
- La fiabilidad se define según la aceptación del negocio: que el cobro en la plataforma se complete, que el cliente reciba un 200 y que el negocio parsee correctamente son tres cosas que hay que contar por separado.
- La latencia se mide en dos puntos: el TTFT determina la experiencia interactiva y el tiempo total de finalización determina la capacidad de entrega; conviene mirar el p95 de ambos.
- RPM y concurrencia deben registrarse por separado: un RPM bajo también puede acumular mucha concurrencia en vuelo, así que el criterio de limitación se establece con la medición real de la cuenta objetivo.
- El costo se calcula por resultado utilizable: todo el gasto ya liquidado dividido entre el número de resultados utilizables del negocio, y tanto los reintentos como el fallback entran en el numerador.
- En el fallback hay que distinguir cambio de canal y cambio de modelo: se verifican uno por uno cuatro puntos: modelo final, funciones esenciales, límite de costo y espera máxima.
- Datos y responsabilidad dependen de cláusulas ejecutables: los logs tienen una ventana de retención, y el SLA necesita criterio estadístico, exclusiones y forma de compensación.
- Ruta de inicio: primero validar con una muestra pequeña de APIYI apiyi.com las dos columnas —capacidad y latencia—, y después pasar a las pruebas de carga y a la revisión del contrato.
Conclusión
Determinar si una pasarela proxy y gateway de API para Modelos de Lenguaje Grande es confiable es, en el fondo, un ejercicio de recopilación de evidencia, no una cuestión de impresiones. Si descompones el «¿sirve o no sirve?» en cinco dimensiones —resultados utilizables para el negocio, latencia de extremo a extremo, costo por resultado utilizable, cadena de datos y responsabilidad ante fallos— y dejas un registro verificable de cada una, podrás convertir por adelantado la mayor parte de las sorpresas en elementos conocidos antes del lanzamiento.
Al implementarlo, recuerda tres cosas: en las conclusiones escribe solo el alcance, nunca un ranking; en los criterios, escribe solo lo que mediste tú, no lo que aparece en la captura de pantalla de otra persona; en la evidencia, llega solo hasta donde se pueda volver a comprobar, porque los logs caducan. Con esto, la discusión sobre qué opción elegir deja de depender de quién hable más fuerte.
Recomendamos empezar con una ronda de aceptación de muestra pequeña en APIYI apiyi.com: la plataforma ofrece una interfaz unificada y cuota de pruebas gratuita, lo que facilita comparar varios modelos en una misma tabla.
Referencias
- Tokens y grupos de APIYI: explicación de múltiples claves, cuotas, grupos de recursos y grupo de respaldo
- Enlace:
docs.apiyi.com/faq/token-and-groups -
Descripción: para revisar la asignación de claves, los grupos de recursos y el mecanismo de canal principal y de respaldo
-
Política de retención y limpieza de logs de APIYI: retención rotativa de logs y exportación
- Enlace:
docs.apiyi.com/faq/log-retention-policy -
Descripción: para confirmar la ventana de almacenamiento propio de los detalles necesarios para conciliación y auditoría
-
Logs detallados de APIYI: alcance de activación y período de retención de los logs de diagnóstico
- Enlace:
docs.apiyi.com/faq/user-logs-control -
Descripción: para revisar los niveles de logs a lo largo del flujo de datos
-
Seguridad de datos de APIYI: política de no guardar entradas ni salidas por defecto
- Enlace:
docs.apiyi.com/faq/data-security -
Descripción: para leer junto con las políticas del proveedor upstream y ver cómo se complementan
-
Garantía SLA de APIYI: reposición de cuota y alcance de lo acordado en el contrato
- Enlace:
docs.apiyi.com/faq/sla-guarantee -
Descripción: para entender la forma y los límites de la compensación por fallos
-
Cómo interpretar el importe de facturación en los logs: campos de la factura y criterio de multiplicadores
- Enlace:
docs.apiyi.com/faq/log-billing-explained -
Descripción: para calcular el costo real de cada resultado utilizable
-
El log muestra la solicitud completada y cobrada, pero el cliente no recibe respuesta: diferencias entre el timeout del cliente y la facturación de la plataforma
- Enlace:
docs.apiyi.com/faq/log-duration-vs-client-wait -
Descripción: lectura imprescindible para investigar pedidos anómalos
-
Enlace:
openrouter.ai/docs/guides/routing/provider-selection -
Descripción: para entender la diferencia entre cambiar de canal y cambiar de modelo
-
OpenRouter Model Fallbacks: modelo de respaldo y criterio de facturación real
- Enlace:
openrouter.ai/docs/guides/routing/model-fallbacks - Descripción: explica la práctica habitual del sector sobre el modelo final y a quién se atribuye la facturación
Autor: Equipo técnico de APIYI
Contacto técnico: escríbenos desde la página principal de APIYI (apiyi.com). Más documentación en el centro de documentación docs.apiyi.com


