
gpt-image-2.6-all salió el 2026-11-11 a las 20:30 de la noche, y ese all del nombre llevó a muchos a pensar de entrada que «toda la familia 2.6 se había fusionado en un solo modelo». No es así: APIYI (apiyi.com) lo deja claro en las notas de lanzamiento. Este modelo corresponde a la línea de ingeniería inversa oficial (官逆) de Images 2.6 en la versión web de ChatGPT, y usa la misma lógica de invocación que la web. Es un canal independiente de la línea de pago por uso que emplean flare y sunburst.
No es una simple acumulación de números de versión. flare y sunburst son otra línea de 2.6 y se facturan por volumen de tokens, mientras que all se factura por solicitud, a $0.025 cada una. Que el criterio de facturación sea distinto indica que por debajo no funcionan sobre el mismo servicio.
Valor central: al terminar este artículo podrás saber en 30 segundos, con solo 4 parámetros, a qué línea pertenece el modelo que tienes entre manos. Así no confundirás el all, de pago por solicitud, con el flare, de pago por uso, al calcular costes.
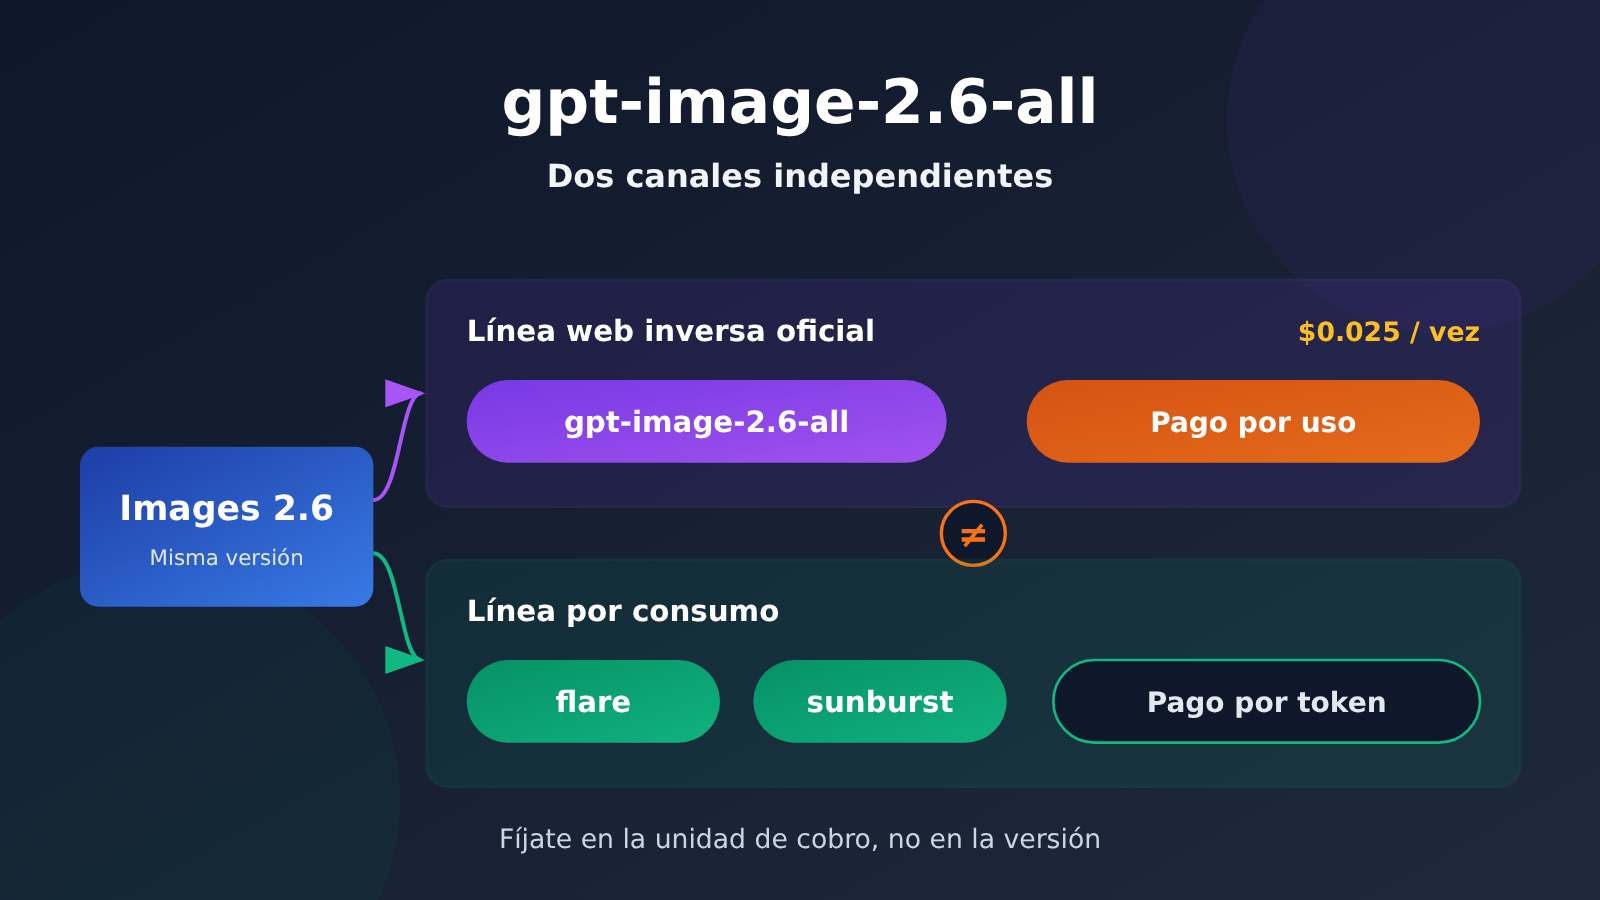
Resumen de la información clave de gpt-image-2.6-all
Primero, lo más importante del anuncio, para evitar malentendidos por la similitud de nombres.
| Elemento | Detalle | Explicación |
|---|---|---|
| Fecha de lanzamiento | 2026-11-11 20:30 | Hora del anuncio; fecha de los datos: 2026-11-12 |
| Línea a la que pertenece | Línea de ingeniería inversa oficial de Images 2.6 de la versión web de ChatGPT | Coincide con la lógica de invocación de la versión web |
| Facturación | Por solicitud, $0.025 / solicitud | No depende del uso de tokens |
| Parámetros de solicitud soportados | size, n, background, output_format | Novedad respecto a 2.5-all |
| Otros modelos de la familia | gpt-image-2.6-flare, gpt-image-2.6-sunburst | Pertenecen a la línea de pago por uso |
| Plataforma disponible | APIYI apiyi.com | Invocación mediante interfaz unificada |
Conviene detenerse un momento en el término «官逆». Se refiere a una línea de invocación obtenida mediante ingeniería inversa de la interfaz web oficial. Su estructura de solicitudes se mantiene igual que la de la versión web, así que los parámetros que se pueden controlar desde la web normalmente también se pueden controlar en esta línea. Eso explica por qué all admite más parámetros que 2.5-all: sigue el comportamiento del cliente web, no las convenciones de parámetros de la línea de pago por uso.
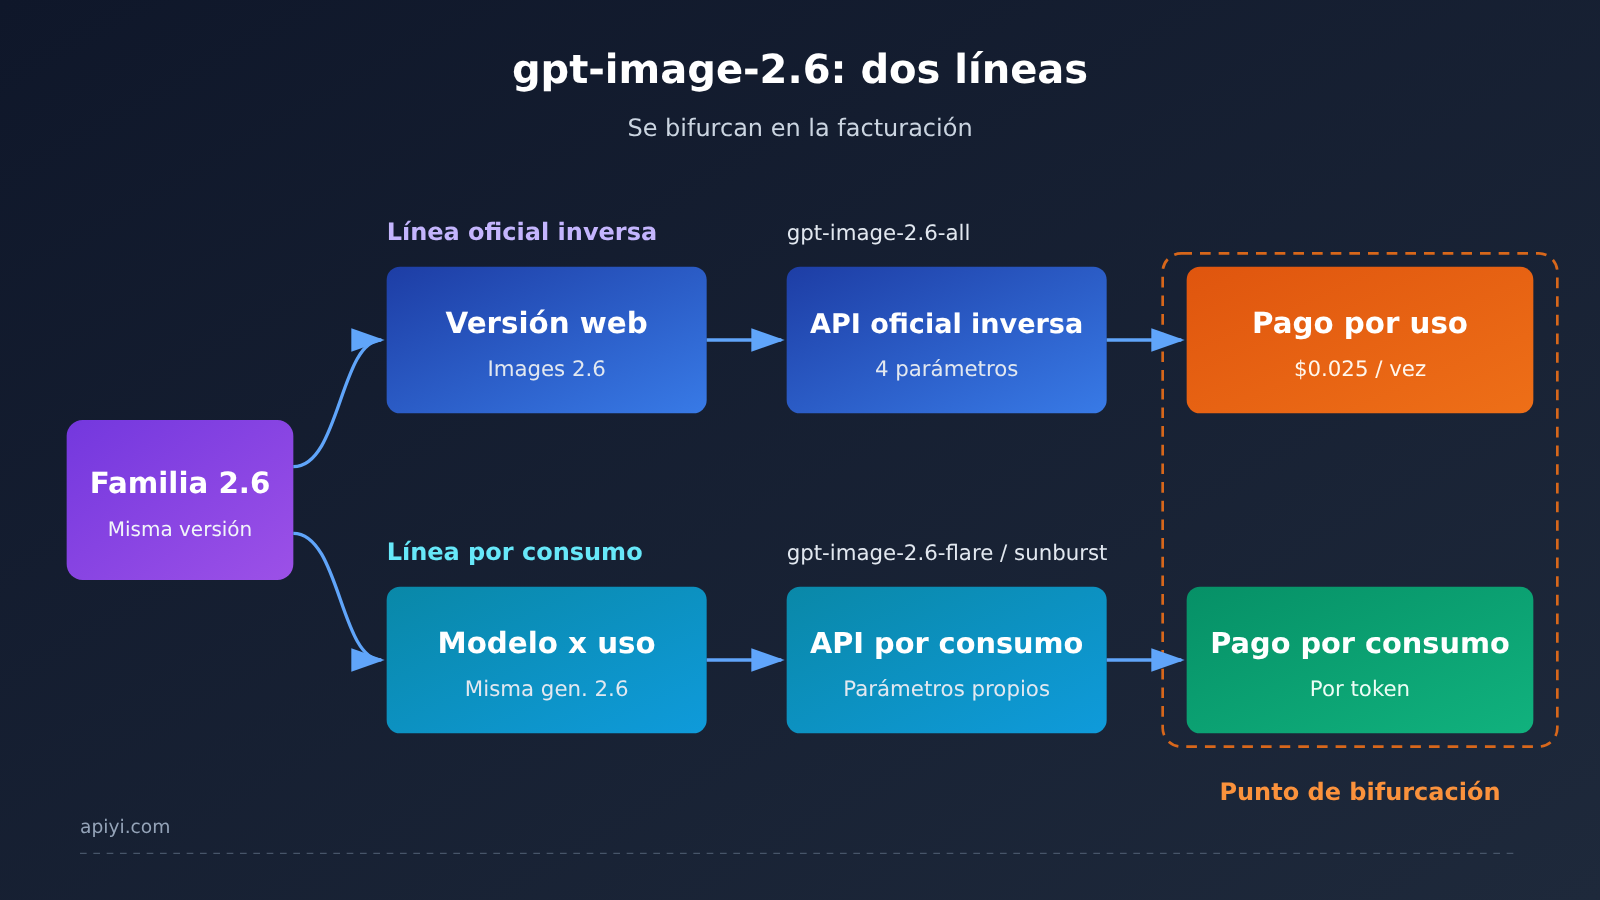
Nota sobre la imagen: el punto donde se bifurcan las dos líneas está en el criterio de facturación, no en el número de versión del modelo. Si quieres comprobar a qué línea pertenece cada modelo, compáralo punto por punto con las notas de lanzamiento de APIYI en apiyi.com.
Diferencias clave entre gpt-image-2.6-all y Flare
El error más común es tratar 2.6 como un bloque único. Si lo separamos por línea de servicio, las diferencias se concentran en tres aspectos.
| Dimensión | gpt-image-2.6-all | gpt-image-2.6-flare / sunburst |
|---|---|---|
| Tipo de línea | Línea oficial inversa de la versión web | Línea de pago por uso |
| Unidad de facturación | Por llamada, $0.025 / llamada | Por cantidad de tokens |
| Control de parámetros | Admite size, n, background, output_format | Convenciones de parámetros propias de la línea de pago por uso |
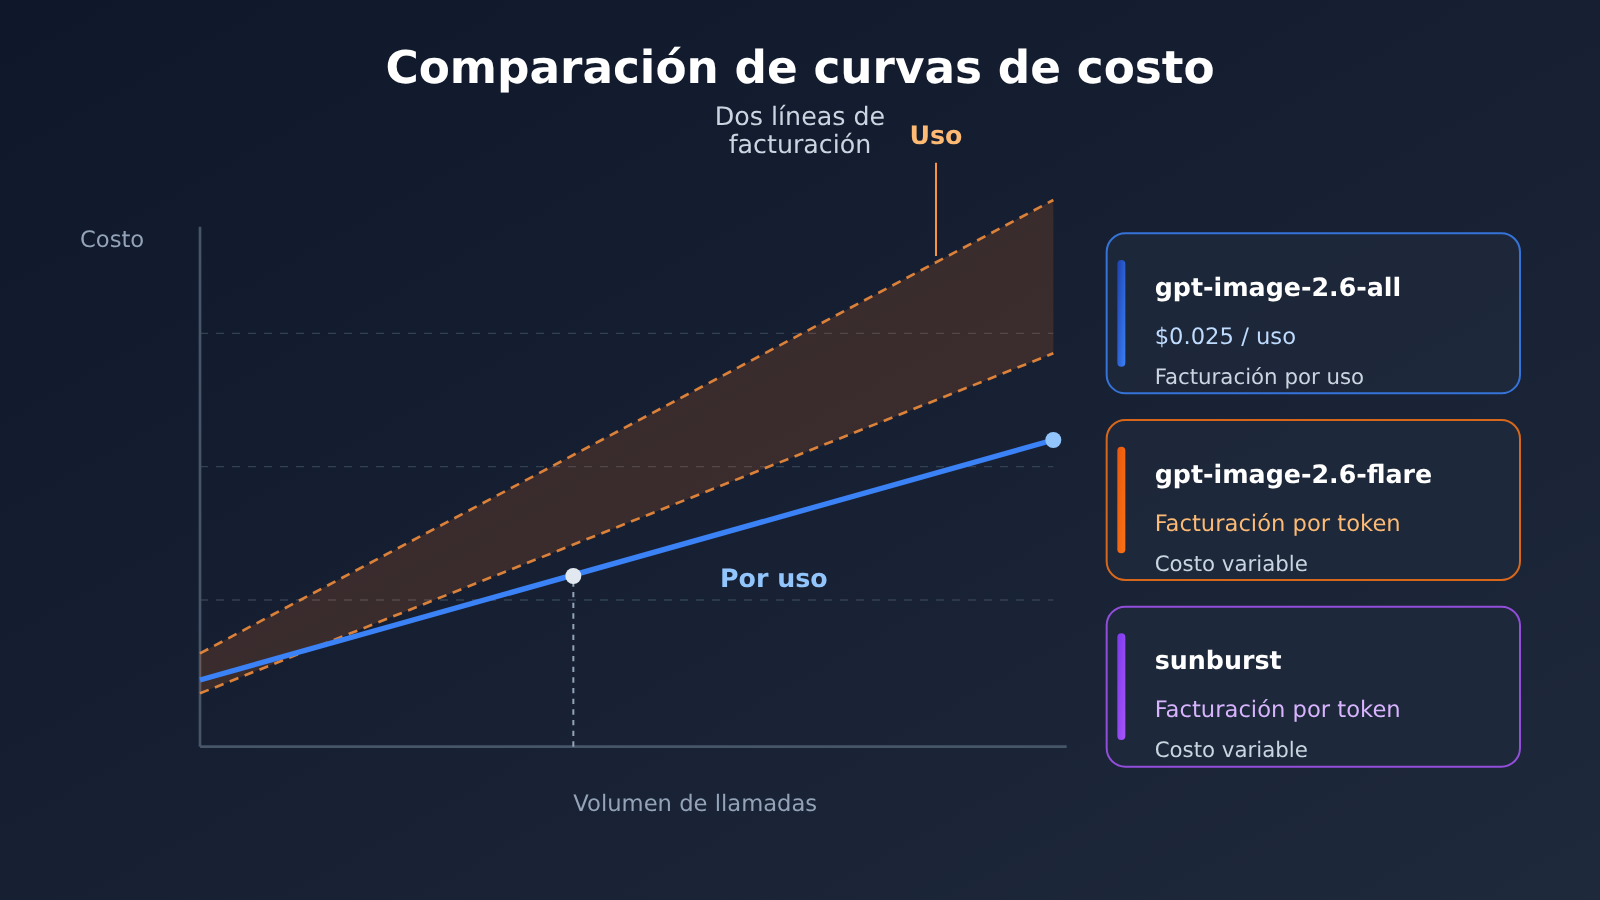
| Variación del costo según el volumen | Lineal respecto al número de llamadas | Depende de los tokens realmente consumidos |
| Método de cálculo adecuado | Presupuesto por número de imágenes | Presupuesto por volumen de tráfico |
gpt-image-2.6-flare es más flexible en la facturación por uso, y encaja bien en escenarios donde el volumen de peticiones fluctúa mucho y se acepta que el costo varíe según la longitud del contenido. Eso sí, su costo no depende del número de imágenes, así que al armar el presupuesto hay que estimar primero el consumo de tokens. En cambio, gpt-image-2.6-all es más directo en cuanto a previsibilidad del costo: 1000 llamadas cuestan exactamente el precio de 1000 llamadas, sin conversiones adicionales.
Esta diferencia se amplifica en los escenarios por lotes. En un proyecto con facturación por llamada, puedes poner el costo por imagen directamente en la cotización; en uno con facturación por uso, primero hay que correr una muestra y luego calcular hacia atrás. Ninguno es mejor que el otro: lo que importa es que el método de cálculo encaje con tu modelo de negocio.
💡 Recomendación: si no tienes claro a qué línea pertenece el modelo que estás usando, fíjate primero en la unidad de facturación y no en el número de versión. En la lista de modelos de APIYI (apiyi.com) puedes ver los puntos de acceso de ambas líneas a la vez, lo que facilita validarlas en paralelo.
Qué nos dicen los 4 parámetros de gpt-image-2.6-all
La frase del anuncio, «a diferencia de 2.5-all, acepta size, n, background y output_format», dice más de lo que parece.
| Parámetro | Función | Valor para el diagnóstico |
|---|---|---|
size |
Define el tamaño de la salida | Los formatos de imagen disponibles en la versión web se pueden reproducir a nivel de API |
n |
Devuelve varias imágenes en una sola solicitud | Permite generar imágenes en lote con una sola llamada, lo que sale más rentable con la facturación por llamada |
background |
Controla cómo se trata el fondo | El interruptor clave para casos con fondo transparente |
output_format |
Define el formato de salida | Decide directamente si hace falta transcodificar después |
Los 4 parámetros son de «control en la solicitud»: le dices al servidor lo que quieres en el momento de hacer el pedido, en lugar de corregirlo después. La línea de pago por uso suele tener su propio conjunto de parámetros, pero no es este. Así que si ves que un modelo soporta estos 4 parámetros, casi seguro está en la línea de ingeniería inversa de la versión web oficial.
Al revés, que 2.5-all no los soporte demuestra que la cobertura de parámetros de esa línea se va completando poco a poco, siguiendo las iteraciones de la versión web. La generación 2.6 cubre esa carencia, y el «all» del nombre se refiere a que la capacidad de parámetros está completa, no a que se hayan fusionado todos los modelos de la serie.
🎯 Consejo técnico: añade a tu servicio una capa de validación de parámetros y usa
size,n,backgroundyoutput_formatcomo criterio de enrutamiento. Así las solicitudes se dirigirán automáticamente a la línea correcta. APIYI (apiyi.com) ofrece una interfaz compatible con OpenAI, y para cambiar de modelo solo tienes que modificar el campomodel.
Cómo invocar gpt-image-2.6-all
La invocación es igual que la de cualquier interfaz de imágenes convencional: basta con apuntar base_url a la entrada unificada. Lo importante es escribir bien el nombre del modelo.
- Dirección de la interfaz:
https://api.apiyi.com/v1 - Nombre del modelo:
gpt-image-2.6-all - Parámetros recomendados:
size,n,background,output_format
Estos campos del cuerpo de la solicitud son los que reflejan la diferencia entre líneas. Si el servidor devuelve un error de parámetro no compatible, normalmente es porque el nombre del modelo es flare o sunburst, pero la solicitud lleva la combinación de parámetros de la versión web.
🚀 Inicio rápido: APIYI (apiyi.com) ofrece crédito de prueba gratuito. Al registrarte obtienes tu clave API, cambias
base_urlahttps://api.apiyi.com/v1y, con el mismo fragmento de código, alternas entre all y flare para comparar. En unos minutos sabrás qué línea encaja mejor con tu estructura de costes.
Cómo afecta a los desarrolladores el lanzamiento de gpt-image-2.6-all
Este lanzamiento tiene impacto en tres niveles.
- Cambia la forma de calcular costes: con $0.025 por solicitud, el coste por imagen es constante. El presupuesto de un proyecto por lotes sale con una simple multiplicación, sin tener que ejecutar muestras para estimar tokens. Para los equipos que presupuestan a clientes, esto es más útil que cualquier parámetro de rendimiento.
- Los parámetros se alinean con la versión web: con
size,n,backgroundyoutput_formatya disponibles, casi todo el control que ofrece la web se puede reproducir en la interfaz, y se reduce el clásico «en la web se puede ajustar, pero en la API no». - Identificar la línea pasa a ser imprescindible: dentro de una misma generación de modelo conviven ahora una línea por solicitud y otra por consumo, y el sufijo del nombre del modelo es lo único que las distingue. Ya no basta con anotar solo el número de versión en la gestión de configuración.
Hay un detalle que se pasa por alto con facilidad: al combinar el parámetro n con la facturación por solicitud, el coste unitario baja aún más cuando una sola llamada genera varias imágenes. Esto no cambia el criterio de facturación, pero sí la estrategia de cuántas imágenes conviene pedir en cada solicitud.
💰 Optimización de costes: si tu proyecto es sensible al presupuesto, primero usa el crédito gratuito de APIYI (apiyi.com) para validar toda la cadena de invocación y luego calcula el gasto mensual a partir del número real de imágenes. Así te acercarás más al gasto real que estimando con una tarifa de lista.
gpt-image-2.6-all: preguntas frecuentes (FAQ)
P1: ¿Qué es exactamente gpt-image-2.6-all?
Es un modelo de la línea de ingeniería inversa oficial (官逆线) de Images 2.6 de la versión web de ChatGPT. Se factura por invocación, a $0.025 cada una. El `all` del nombre indica que cuenta con el conjunto completo de parámetros, no que sea una fusión de toda la serie.
P2: ¿Qué diferencia hay entre gpt-image-2.6-all y gpt-image-2.6-flare?
Cambian tanto la línea como la facturación. all usa la línea de ingeniería inversa oficial de la versión web y se cobra por invocación; flare y sunburst pertenecen a la línea por consumo y se cobran según la cantidad de tokens. No son niveles distintos de un mismo modelo, sino dos canales independientes.
P3: ¿Por qué all admite size, n, background y output_format?
Porque reproduce la estructura de las solicitudes de la interfaz web. Lo que se puede controlar desde la web, normalmente también se puede controlar en la línea de ingeniería inversa oficial. 2.5-all no tiene este conjunto de parámetros, lo que indica que la cobertura de parámetros se ha ido completando a medida que la versión web evolucionaba.
P4: ¿En qué escenarios conviene la facturación por invocación?
Es ideal cuando puedes estimar el número de invocaciones y necesitas incluir el costo por imagen en un presupuesto. La facturación por consumo encaja mejor en proyectos con tráfico muy variable que pueden aceptar que el costo fluctúe según el contenido.
P5: ¿Cómo invoco gpt-image-2.6-all rápidamente?
Regístrate en una plataforma que admita el modelo y obtén tu clave API; luego configura `base_url` como `https://api.apiyi.com/v1` y usa `gpt-image-2.6-all` como nombre del modelo. APIYI (apiyi.com) ofrece una interfaz compatible con OpenAI y crédito gratuito para pruebas; con el mismo código basta cambiar el campo `model` para alternar entre all y flare y comparar resultados.
P6: ¿Hay algo que deba tener en cuenta con este lanzamiento?
Lo más importante: no trates `2.6` como un bloque único. En la misma generación conviven una línea por invocación y otra por consumo, y si en tu configuración solo anotas el número de versión es fácil equivocarse al calcular costos. Además, el anuncio se centra en tres aspectos: a qué línea pertenece, los parámetros y la facturación; para cualquier otro detalle, consulta la documentación posterior.
Puntos clave de gpt-image-2.6-all (Key Takeaways)
- Línea de origen: corresponde a la línea de ingeniería inversa de Images 2.6 en la versión web de ChatGPT, no a la línea de pago por uso.
- Facturación: se cobra por llamada, $0.025 cada una, sin relación con el consumo de tokens.
- Parámetros: admite size, n, background y output_format, algo que 2.5-all no soporta.
- Diferencia con la misma familia: flare y sunburst pertenecen a otra línea de pago por uso, con un esquema de facturación totalmente distinto.
- Cómo identificarlo: fíjate en la unidad de facturación y en la combinación de parámetros; es más fiable que mirar el número de versión.
- Cómo empezar: usa la interfaz unificada de APIYI (apiyi.com) y apunta
base_urlahttps://api.apiyi.com/v1para comprobarlo.
Resumen
Sobre gpt-image-2.6-all, basta con recordar tres ideas:
- Es la línea web por ingeniería inversa, no Flare: flare, sunburst y este modelo se reparten en dos canales distintos; no son niveles diferentes del mismo modelo.
- Se cobra por llamada, no por uso: $0.025 cada vez, así que el costo crece de forma lineal con el número de llamadas y resulta más fácil de presupuestar que en la línea de pago por uso.
- Cuatro parámetros como criterio: si size, n, background y output_format aparecen entre las capacidades del modelo, casi seguro está colgado de la línea web por ingeniería inversa.
Que dos modelos tengan el mismo número de versión no significa que usen la misma línea. La próxima vez que veas en tu configuración un nombre de modelo que empiece por 2.6, confirma primero cómo se factura y después decide dónde colocarlo.
Si quieres comparar el rendimiento real de ambas líneas a la vez, te recomiendo probarlas rápido con APIYI (apiyi.com): la plataforma ofrece crédito gratuito y una interfaz unificada para varios modelos, y para cambiar de uno a otro solo tienes que modificar el campo model.
Referencias
- Notas de lanzamiento de APIYI – Disponibilidad de gpt-image-2.6-all: fuente original sobre la asignación de líneas, los parámetros compatibles y los criterios de facturación
- Enlace:
docs.apiyi.com/live/2026-11/gpt-image-2-6-all-launch -
Descripción: incluye la fecha de lanzamiento, el precio por llamada y la información de los modelos de la misma familia; datos al 12-11-2026
-
Lista de modelos de APIYI: permite consultar los modelos disponibles y sus puntos de acceso
- Enlace:
apiyi.com - Descripción: sirve para verificar a qué línea pertenecen all, flare y sunburst
Autor: Equipo técnico de APIYI
Contacto técnico: escríbenos desde la página principal de APIYI (apiyi.com); encontrarás más material en el centro de documentación docs.apiyi.com


