
Nota del autor: análisis del 64,9 % de Claude Fable 5.2 en RoboDojo Sim: en qué condiciones obtuvo ese resultado, cuánto le sacan Opus 5.5 y GPT-6 Astra, qué cosas no demuestra y qué precios y limitaciones conviene calcular antes de integrarlo.
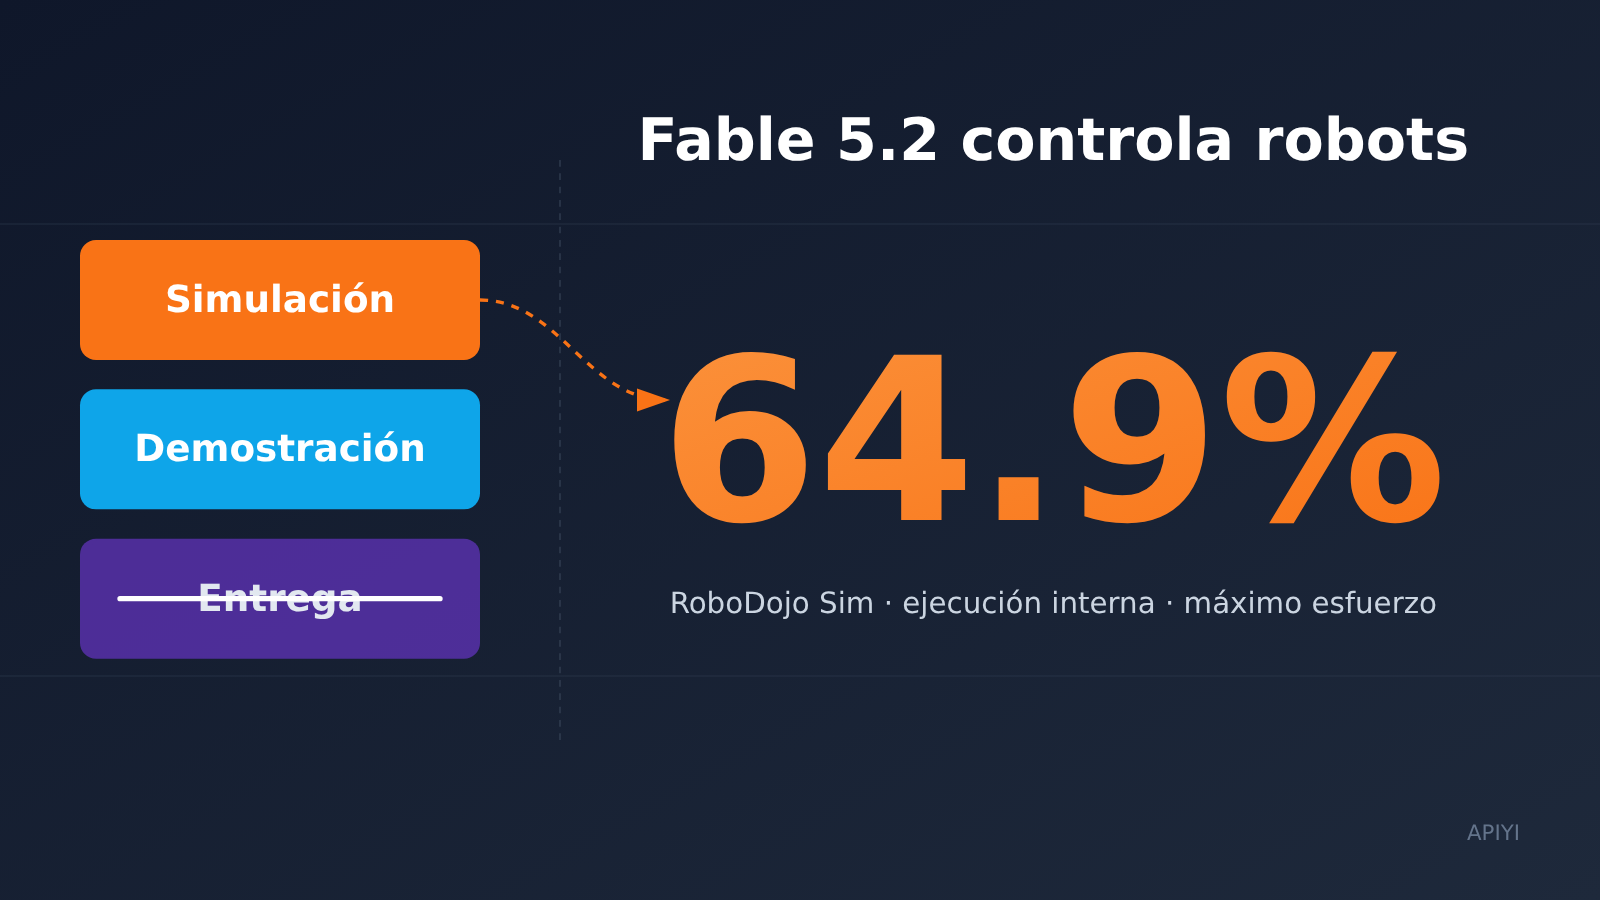
Empecemos por la conclusión. En RoboDojo Sim, ejecutado internamente por Anthropic y con el nivel de esfuerzo más alto, Claude Fable 5.2 obtuvo un 64,9 %, Opus 5.5 un 39,4 %, GPT-6 Astra un 29,8 % y Fable 5.1 un 27,6 %. Es el resultado de un modelo que observa imágenes de cámaras y controla un sistema simulado de dos brazos, no un registro de entregas en fábricas.
Este no es un artículo promocional que proclama «ha llegado la era de los robots». A continuación, analizamos por separado las puntuaciones de simulación, los videos de demostración y las implementaciones en el mundo real. Si estás pensando en integrar una API y calcular los costos, al terminar podrás decidir si este 64,9 % justifica cambiar ahora tu enfoque técnico.
Valor principal: entender qué demuestra y qué no demuestra el 64,9 % de Fable 5.2, y qué modelo puedes invocar actualmente para las primeras pruebas.
Qué significa realmente el 64,9 % de Claude Fable 5.2
Este número se puede explicar en tres frases. RoboDojo es un benchmark público que mide si un modelo puede controlar un robot de dos brazos en un entorno simulado a partir de imágenes de cámaras. Una nota al pie de la publicación indica que el 64,9 % es el resultado de una prueba interna de Anthropic con el nivel de esfuerzo más alto disponible. Al 10 de noviembre de 2026, no pudimos verificar esa misma cifra en la página pública de la clasificación de RoboDojo, así que no se puede presentar como «el número uno de la clasificación pública» y mucho menos como «el modelo de robótica más potente del mundo».
A continuación se muestra la comparación de RoboDojo Sim que Anthropic incluyó en su publicación del 9 de noviembre de 2026:
| Modelo | RoboDojo Sim | Diferencia con Fable 5.2 | Notas |
|---|---|---|---|
| Claude Fable 5.2 | 64,9 % | — | Prueba interna, nivel de esfuerzo más alto |
| Claude Opus 5.5 | 39,4 % | 25,5 puntos porcentuales menos | En la misma tabla |
| GPT-6 Astra | 29,8 % | 35,1 puntos porcentuales menos | Resultado obtenido por Anthropic, no declarado por OpenAI |
| Claude Fable 5.1 | 27,6 % | 37,3 puntos porcentuales menos | Generación anterior |
| Gemini 4 Carbon | Sin dato en la tabla | No se puede comparar | No hay cifra; no debe interpretarse como 0 |
El salto del 27,6 % al 64,9 % es de más del doble y destaca claramente en toda la tabla de resultados. Sin embargo, la puntuación depende de tres condiciones: un entorno simulado, una prueba interna y el nivel de esfuerzo más alto. Si cambia cualquiera de ellas —por ejemplo, si se usa un robot real, una evaluación independiente o el nivel de esfuerzo predeterminado—, no se puede trasladar directamente esa cifra.
¿Qué relación hay entre Fable 5.2 y Mythos 5.2?
La publicación lo deja muy claro: Claude Fable 5.2 y Claude Mythos 5.2 son el mismo modelo subyacente. Fable tiene salvaguardas más estrictas en materia de ciberseguridad y bioseguridad, por lo que está disponible para todos los usuarios. Mythos solo está disponible para organizaciones que hayan superado los procesos de verificación para proyectos de ciencias de la vida o ciberseguridad. Mythos no es «otro modelo más potente»; para evaluar las capacidades en robótica, basta con fijarse en Fable 5.2.
Estos son los ID oficiales de los modelos:
- Claude API, Google Cloud, Microsoft Foundry y Claude Platform on AWS:
claude-fable-5-2 - Amazon Bedrock:
anthropic.claude-fable-5-2 - Los ID correspondientes a Mythos son
claude-mythos-5-2yanthropic.claude-mythos-5-2
Función clave de Fable 5.2 para controlar robots: qué muestra la demo
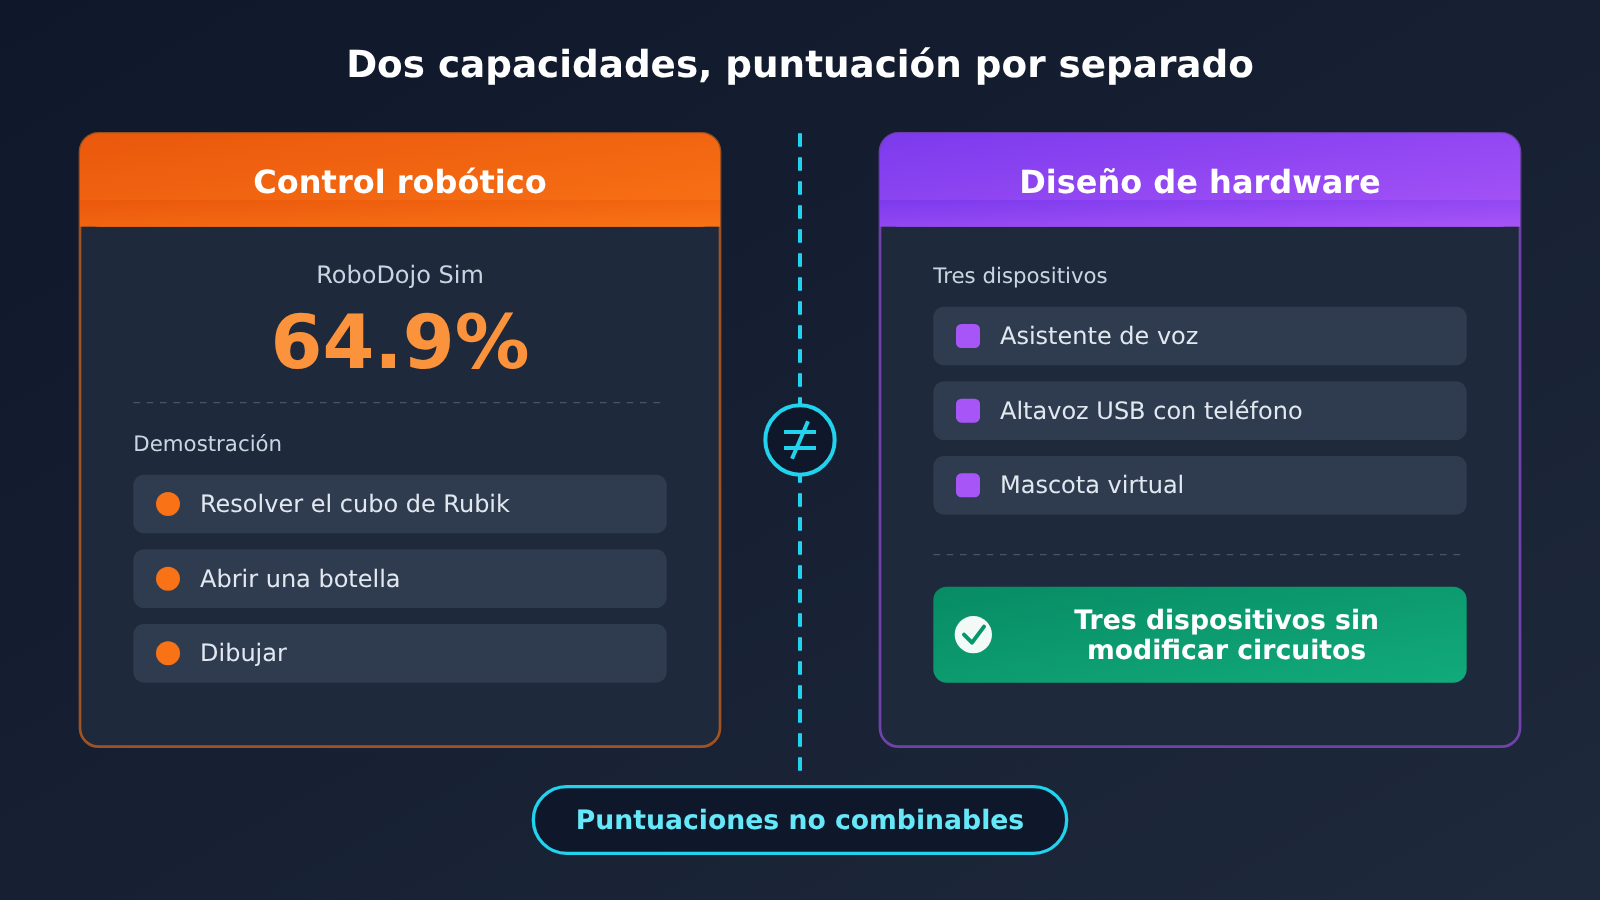
Según la publicación de lanzamiento, Fable 5.2 controla robots físicos mucho mejor que las versiones anteriores de Claude, incluso en tareas para las que no se había entrenado específicamente. El video de demostración muestra tres escenarios: resolver un cubo de Rubik, desenroscar la tapa de una botella y dibujar un robot.
Conviene entenderlo como lo que es: una demostración incluida en la publicación de lanzamiento. Muestra que el modelo logró realizar esas acciones en una configuración concreta, pero no informa de la tasa de éxito, cuántos intentos hicieron falta ni con qué frecuencia falló. Tampoco significa que Anthropic haya lanzado un paquete de habilidades robóticas listo para instalar. La afirmación oficial de que algunas tareas no se habían entrenado específicamente es interesante, pero sigue siendo una declaración de la propia empresa y no viene acompañada de datos de una reproducción independiente.
La publicación también afirma que Fable 5.2 superó a otros modelos de vanguardia en el mismo conjunto de pruebas, así como a la mayoría de los sistemas diseñados específicamente para controlar robots. No se incluye una lista de estos últimos, por lo que no queda claro qué sistemas se compararon ni qué versiones se usaron. Esta afirmación puede tomarse como una señal de hacia dónde apunta el avance, pero no como una conclusión definitiva.
El modelo genera texto; el control depende de un kit externo
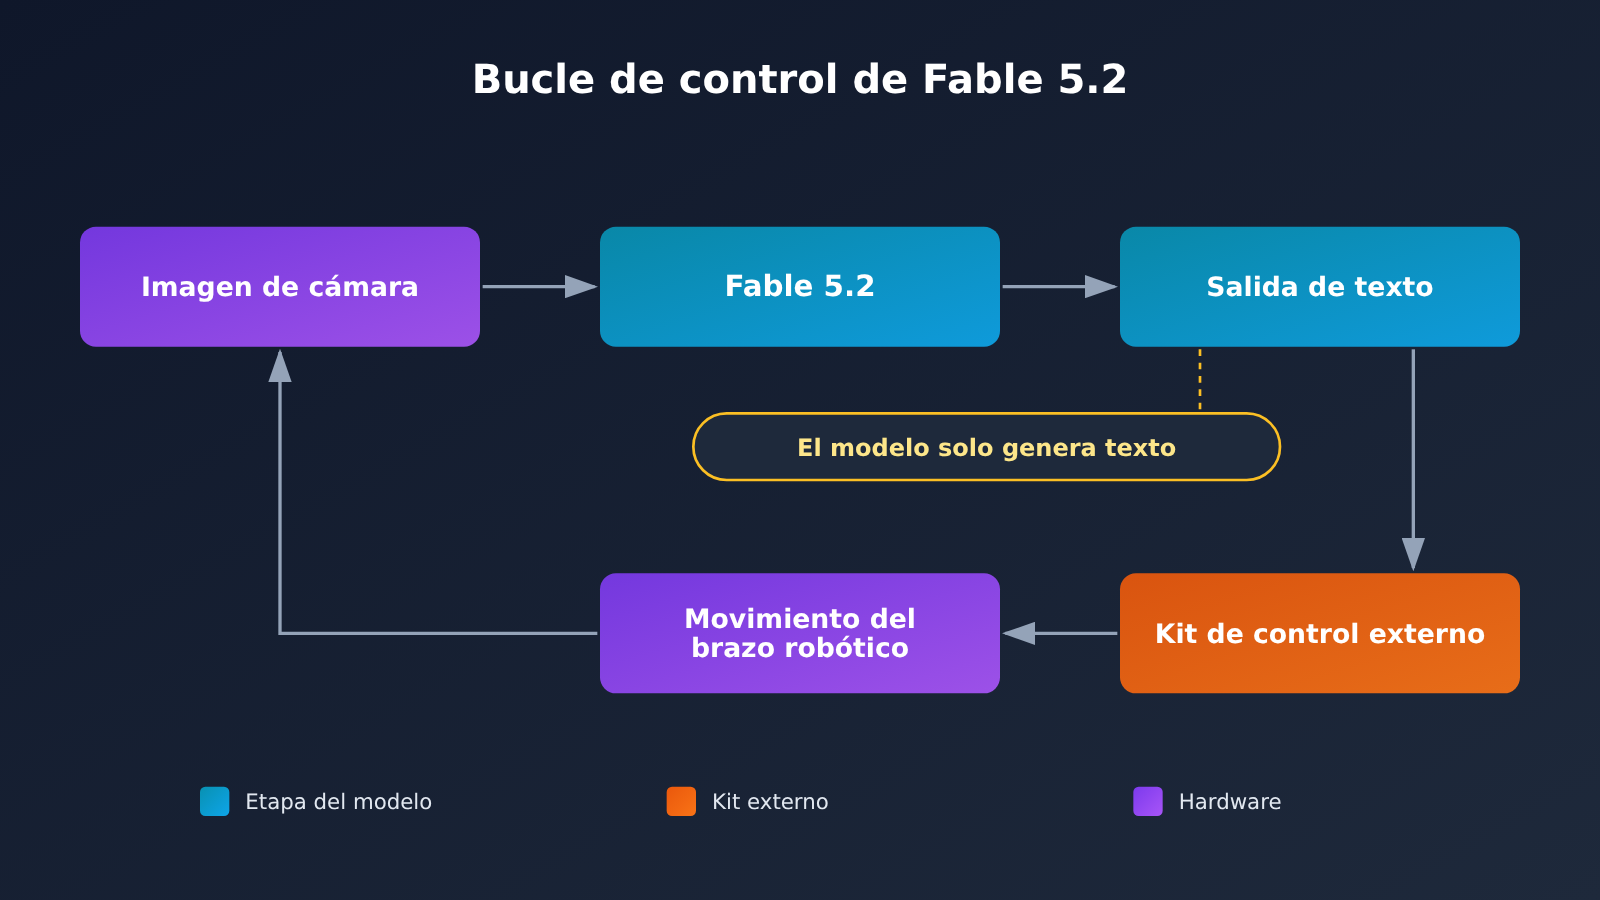
Este es el detalle que más fácilmente puede quedar oculto en el video de demostración. La página del modelo indica que Fable 5.2 recibe texto e imágenes, y que su única salida es texto. No envía instrucciones directamente a los motores: en cada paso, un kit externo interpreta el texto y lo convierte en acciones, y luego envía al modelo una nueva imagen de la cámara.
Por eso, en situaciones reales, el control depende tanto del modelo como de tu kit: de cómo definas el espacio de acciones, de qué medidas tomes cuando falle la interpretación y de si la latencia por paso resulta aceptable. El 64,9 % de RoboDojo se obtuvo con el kit de Anthropic. Por ahora, no sabemos cómo cambiaría la puntuación con otro kit.
Datos de las pruebas de Fable 5.2: la brecha en robótica no es la misma que en el manejo del ordenador
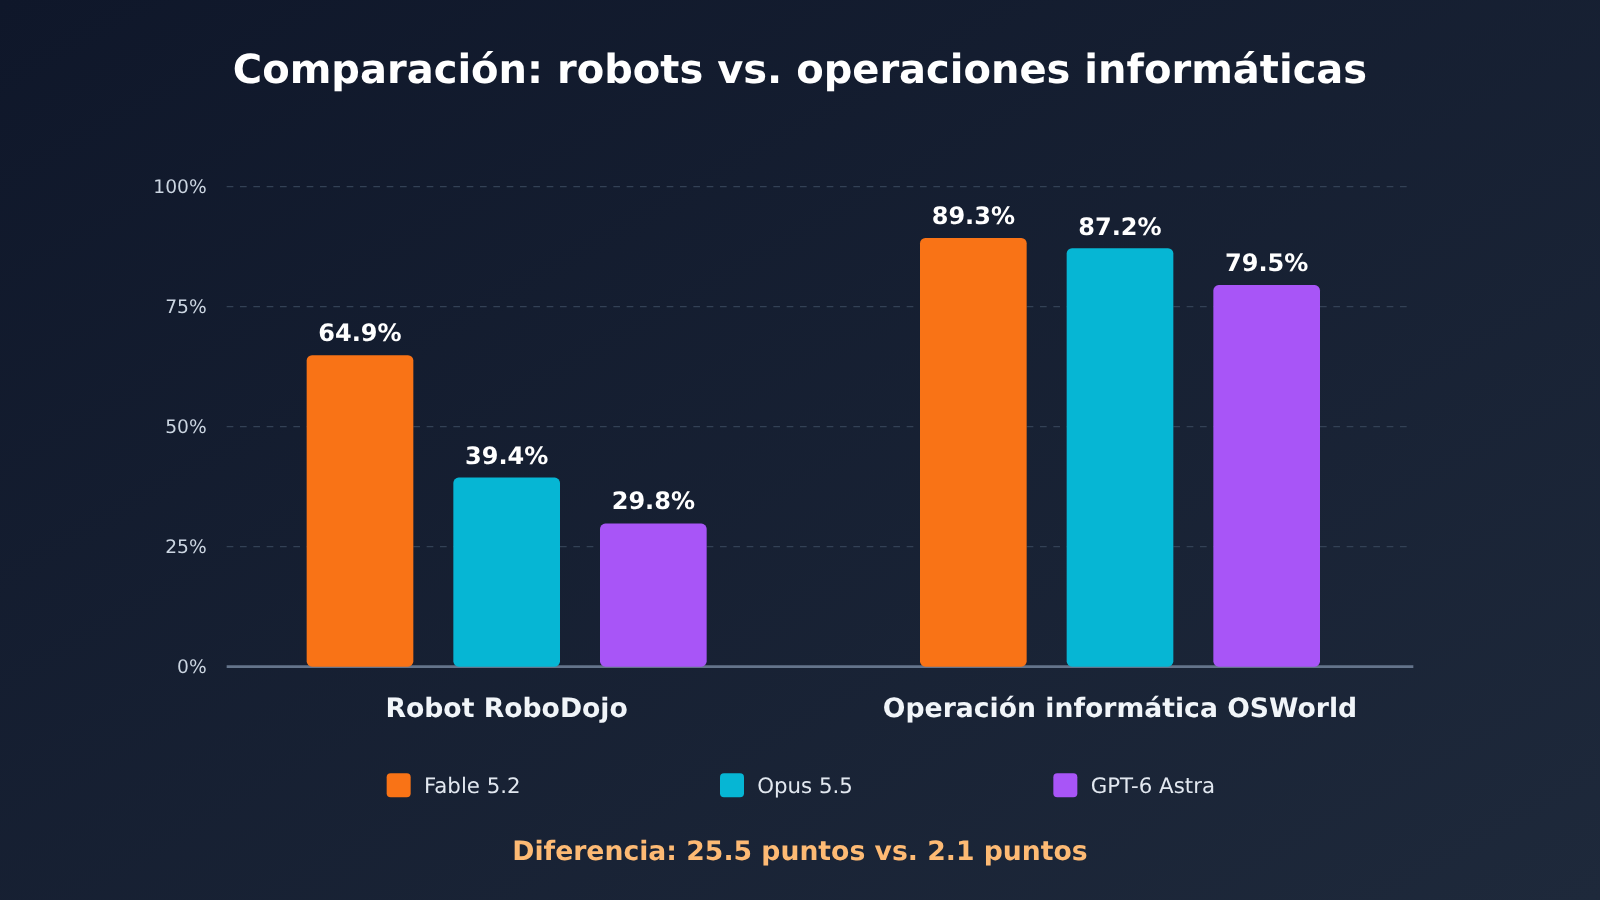
Al ver que «Fable 5.2 es muy potente», mucha gente tiende a mezclar sus puntuaciones en robótica con las de otras pruebas. La siguiente tabla recoge todos los datos de la publicación de Anthropic del 9 de noviembre de 2026 y compara la magnitud de las diferencias en varias pruebas relacionadas con el «control»:
| Prueba | Fable 5.2 | Opus 5.5 | GPT-6 Astra | Ventaja de Fable 5.2 sobre Opus 5.5 |
|---|---|---|---|---|
| RoboDojo Sim (simulación de dos brazos) | 64.9% | 39.4% | 29.8% | 25.5 puntos |
| OSWorld 2.1 (manejo del ordenador, parte del conjunto sin conexión) | 89.3% | 87.2% | 79.5% | 2.1 puntos |
| AutomationBench | 51.4% | 42.5% | 41.4% | 8.9 puntos (Carbon obtiene un 53.9%, una puntuación más alta) |
| Remote Labor Index (nivel High) | 41.3% | 21.3% | 20.8% | 20.0 puntos |
En OSWorld 2.1, Fable 5.2 solo supera a Opus 5.5 por 2.1 puntos. La diferencia no tiene nada que ver con la distancia entre el 39.4% y el 64.9% en RoboDojo. Si necesitas un agente para tareas de manejo del ordenador, la diferencia entre Opus 5.5 y Fable 5.2 es mucho menor que en las pruebas de robótica.
Nivel de esfuerzo: el 64.9% no corresponde al nivel predeterminado
Salvo que se indique lo contrario, la tabla de resultados de la publicación usa el nivel de esfuerzo más alto disponible en ese momento para cada modelo. El nivel de esfuerzo predeterminado de Fable 5.2 en Claude API es high, mientras que en las aplicaciones de Claude y Claude Code es Medium. Es decir, si haces una invocación con los parámetros predeterminados, puede que no obtengas la configuración a la que corresponde el 64.9%.
El nivel más alto implica más tiempo de razonamiento y más tokens. En un ciclo de robótica que exige tomar decisiones una y otra vez, razonar al nivel más alto en cada paso aumenta tanto la latencia como el costo. La publicación no especifica cuánto bajaría el 64.9% en los niveles high o medium.
Comparativa de especificaciones: Fable 5.2, Opus 5.5 y GPT-6 Astra
| Aspecto | Claude Fable 5.2 | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Contexto | 1M | 1M | 1,050,000 |
| Salida máxima | 128K | 128K | 128,000 |
| Modalidades de entrada/salida | Texto + imágenes / texto | Texto + imágenes / texto | Texto + imágenes / texto |
| Nivel de esfuerzo predeterminado de la API | high | medium | Admite de low a max |
| Nivel de latencia | Moderate | Moderate | La página oficial no usa el mismo criterio |
| Fecha de corte del conocimiento | junio de 2026 | 2026-06 | 2026-04-30 |
Los tres modelos generan texto; es una limitación común que no se puede pasar por alto al usarlos para controlar robots.
Aspectos de Fable 5.2 que no deberían contar para la puntuación de robótica
Tres dispositivos electrónicos: un experimento de diseño de hardware
La publicación también incluye una demostración: con una indicación de una sola frase, Fable 5.2 diseñó tres dispositivos electrónicos funcionales: un asistente de voz para el hogar, un teléfono con altavoz USB y una mascota virtual portátil. El proyecto se realizó en colaboración con Diode. Cada placa de circuito se pudo fabricar en menos de un día y los tres dispositivos funcionaron sin necesidad de modificar los circuitos.
Esto demuestra capacidad de diseño de hardware, pero no tiene relación con RoboDojo, y los dispositivos tampoco son robots. Presentar esta demostración junto al 64,9 % puede dar la impresión de que el modelo se encarga de todo, desde el diseño hasta el control, pero ambas cosas no tienen nada que ver entre sí.
Límites de Fable 5.2: restricciones que afectan al bucle de control
La información que sigue procede de la página del modelo y de las notas de actualización. Cada punto afecta directamente al bucle de control que configures:
- Las llamadas forzadas a herramientas generan un error: si
tool_choicese establece enanyotool, se devuelve un error 400. Si tu sistema depende de que el modelo invoque obligatoriamente una herramienta de acción, tendrás que dejar que el modelo elija por sí mismo y añadir una alternativa de respaldo para procesar la respuesta. - No se pueden configurar los parámetros de muestreo: pasar
temperature,top_potop_kdevuelve un error 400. - No se puede desactivar el razonamiento: el razonamiento adaptativo está siempre activado; solo se puede ajustar su intensidad mediante
effort. Las notas de actualización indican que, a partir del nivel medium, escribir en la indicación «no pienses, responde directamente» tampoco consigue que deje de razonar. - Habla poco cuando hay cadenas largas de herramientas: durante llamadas consecutivas a herramientas, el modelo puede producir muy poco contenido dirigido al usuario, o invocar herramientas directamente sin dar explicaciones. La interfaz de supervisión no debe depender de que el modelo informe del progreso por iniciativa propia.
- Puede detenerse antes de tiempo: a veces termina un turno y se detiene, dejando una lista de tareas pendientes, o se queda bloqueado por un obstáculo común. Esto ocurre con más frecuencia en el nivel low.
- Las respuestas de rechazo también consumen cuota: cuando se rechaza una solicitud, se devuelve HTTP 200 y
stop_reasonesrefusal; aun así, se consume cuota de velocidad. - Retención de datos: se exige una retención de datos de 30 días. No se puede optar por la retención cero de datos sin autorización explícita de Anthropic.
Los bucles de control robótico exigen que cada paso produzca una acción ejecutable. En conjunto, estas limitaciones implican que, antes de integrar el modelo en el bucle de control, debes diseñar cómo recuperarte de los tiempos de espera, las acciones vacías, los rechazos y las detenciones a mitad de tarea.
Precio de Fable 5.2: calcula los costos antes de integrarlo
Los precios oficiales se expresan por millón de tokens y proceden de la página del modelo, las notas de actualización y la página del modo rápido:
| Concepto de facturación | Fable 5.2 | Opus 5.5 | GPT-6 Astra (contexto corto) |
|---|---|---|---|
| Entrada / salida estándar | $8 / $40 | $4 / $20 | $10 / $50 |
| Lectura de caché | $0.20 | $0.20 | $1 (entrada en caché) |
| Escritura en caché | 5 minutos: $10; 1 hora: $16 | Disponible en la página oficial, no se incluye aquí | $12.5 |
| Procesamiento por lotes | A mitad de precio: $4 / $20 | También a mitad de precio | No se incluye aquí |
| Modo rápido | $16 / $80 | $8 / $40 | — |
Hay algunos puntos más que conviene tener en cuenta. Fable 5.2 cuesta un 20 % menos que Fable 5.1 ($10 / $50). El modo rápido ofrece las mismas capacidades y puede alcanzar hasta 2,5 veces la velocidad de salida del modo estándar, pero la página oficial no indica por separado los precios de caché para este modo. Si los estimamos aplicando el mismo multiplicador, la lectura de caché costaría unos $0.40, la escritura en caché durante 5 minutos, unos $20, y durante 1 hora, unos $32. Los distintos modos de velocidad no comparten la caché de indicaciones, así que cambiar del modo rápido al estándar provoca fallos de caché. Si la entrada de GPT-6 Astra supera los 272K tokens, se cobra el doble por la entrada y 1,5 veces más por la salida de toda la solicitud.
En un ciclo de control de robots, cada paso envía una imagen nueva, mientras que la indicación del sistema y las instrucciones de acción anteriores apenas cambian. Esta estructura permite reducir costos mediante la caché, pero no se pueden evitar la entrada de imágenes ni los tokens de razonamiento de cada paso.
¿Ya se puede usar Fable 5.2? Disponibilidad en APIYI
A fecha de 2026-11-10, claude-fable-5-2 y cualquier modelo de la familia Mythos siguen sin aparecer en el catálogo de modelos de APIYI apiyi.com ni en su API pública de precios. Lanzaremos este modelo lo antes posible. Los ID de modelo y los precios disponibles en la plataforma son la referencia. Mientras no esté disponible, este artículo no indica un precio de Fable 5.2 en APIYI ni calcula el precio oficial a partir de multiplicadores por grupos.
Estos son los modelos relacionados que ya se podían usar ese día en el catálogo de APIYI (precios de lista, en dólares por millón de tokens):
| ID del modelo | Entrada / salida | Lectura de caché | Endpoint | Para qué sirve |
|---|---|---|---|---|
claude-opus-5-5, claude-opus-5-5-thinking |
$4 / $20 | $0.2 | chat, messages | Empezar a configurar el ciclo de llamadas a herramientas y control del ordenador |
claude-fable-5-1, claude-fable-5-1-thinking |
$10 / $50 | $0.25 | chat, messages | Usar como referencia para comparar con la generación anterior |
claude-fable-5, claude-fable-5-thinking |
$10 / $50 | $1 | chat, messages | Comparar con versiones anteriores |
gpt-6-astra |
$10 / $50 | $1 | responses (principal), chat | Comparar con modelos de otros proveedores |
Los precios del catálogo son precios de lista. El importe real se calcula aplicando también el multiplicador del grupo de tokens; consulta la factura para conocer el cargo definitivo. La nota al pie de gpt-6-astra solo especifica los tramos de precio de entrada: $10 hasta 272,000 tokens y $20 entre 272,001 y 1,050,000. No indica el precio de salida para contextos largos, así que consulta la factura en la consola. Para conectarte, usa la interfaz compatible con OpenAI y establece base_url en https://api.apiyi.com/v1.
Una opción práctica es empezar con claude-opus-5-5 para poner a prueba la entrada de imágenes, la interpretación de acciones y la recuperación ante fallos. Cuando Fable 5.2 esté disponible en APIYI, puedes cambiar el ID del modelo y compararlos. La diferencia en robótica (25.5 puntos) es mucho mayor que en el control del ordenador (2.1 puntos), así que tiene sentido esperar a Fable 5.2; aun así, no basta con decidir basándose solo en un video de demostración.
Análisis de las ventajas y limitaciones de Fable 5.2 en robótica
Ventajas
- Gran salto generacional: RoboDojo Sim pasa del 27,6 % al 64,9 %, uno de los avances más destacados de toda la tabla de resultados.
- Ventaja clara frente a modelos similares: supera a Opus 5.5 por 25,5 puntos y a GPT-6 Astra por 35,1 puntos (datos de la publicación de Anthropic).
- Menor precio: la tarifa estándar es un 20 % más baja que la de 5.1; las lecturas desde caché cuestan $0.20.
- Entrada visual sin cambios: admite imágenes y un contexto de 1M, suficiente para manejar historiales visuales largos y con varios pasos.
Limitaciones
- Evidencia poco sólida: los resultados proceden de una ejecución interna con el nivel de esfuerzo más alto. No se encontró la misma cifra en los rankings públicos y tampoco hay una verificación independiente.
- Solo hay datos de simulación: los videos de demostración no indican tasas de éxito, y la afirmación de que supera a «la mayoría de los sistemas robóticos especializados» no incluye una lista de sistemas.
- Varias restricciones en el bucle de control: solo genera texto, no se puede forzar la invocación de herramientas, no es posible desactivar el razonamiento y rara vez explica lo que hace en cadenas largas.
- Alto costo en el nivel máximo: la puntuación se obtuvo con el nivel de esfuerzo más alto; tendrás que medir por tu cuenta la latencia y el consumo de tokens en un despliegue real.
Cuándo no conviene cambiar de modelo basándose en estos datos
Si no tienes un entorno de simulación propio o un bucle de control con un robot real, el 64,9 % no tiene un valor verificable para ti: no puedes confirmar si se cumple en tu configuración. Tampoco demuestra mucho sobre necesidades de ciberseguridad, biología o programación cotidiana; para esos casos, conviene consultar las pruebas correspondientes. La propia publicación recomienda empezar con Opus 5.5 para la mayoría de las tareas de programación y conocimiento, y cambiar a un modelo superior o inferior según la dificultad.
Preguntas frecuentes
Q1: ¿El 64,9 % de Fable 5.2 es un resultado de una clasificación pública?
No. La nota al pie del anuncio indica que se trata de un resultado obtenido en una ejecución interna de Anthropic. RoboDojo es un benchmark público, pero, al 10 de noviembre de 2026, no pudimos verificar esa misma cifra en la página pública de resultados.
Q2: ¿El 64,9 % corresponde al nivel de esfuerzo predeterminado?
No, corresponde al nivel de esfuerzo más alto disponible. El nivel predeterminado de Claude API es high, mientras que en la aplicación Claude y en Claude Code es Medium. El anuncio no indica cuántos puntos se obtienen con el nivel predeterminado.
Q3: ¿Fable 5.2 superó a los sistemas diseñados específicamente para robótica?
El anuncio afirma que superó a «la mayoría de los sistemas diseñados específicamente para controlar robots», pero no incluye una lista. Por ahora, no sabemos qué sistemas concretos superó.
Q4: ¿Por qué Gemini 4 Carbon no tiene puntuación en RoboDojo?
La celda correspondiente de la tabla del anuncio está vacía y no se explica el motivo. Que esté en blanco no significa que la puntuación sea 0 ni permite sacar conclusiones sobre su rendimiento.
Q5: ¿Cómo puedo empezar a prepararme con la API?
Al 10 de noviembre de 2026, APIYI apiyi.com todavía no ofrece `claude-fable-5-2`. Publicaremos este modelo lo antes posible; consulta la lista de modelos de la plataforma para ver el nombre y el precio. Mientras tanto, puedes probar el flujo de entrada de imágenes y uso de herramientas con `claude-opus-5-5` y cambiar de modelo para comparar cuando esté disponible.
Q6: ¿Los tres dispositivos electrónicos demuestran que puede controlar robots?
No. El asistente de voz, el teléfono con altavoz USB y la mascota virtual son experimentos de diseño de hardware realizados en colaboración con Diode. Demuestran capacidades de diseño de circuitos y no guardan relación con la puntuación de control bimanual de RoboDojo.
Q7: ¿Los agentes que operan computadoras necesitan esperar a Fable 5.2?
No parece necesario. En OSWorld 2.1, Fable 5.2 obtiene un 89,3 % y Opus 5.5 un 87,2 %: una diferencia de solo 2,1 puntos. Además, el precio estándar de Opus 5.5 es la mitad que el de Fable 5.2.
Conclusiones clave sobre las capacidades robóticas de Fable 5.2
- Qué significa la puntuación: el 64,9 % corresponde al rendimiento de un sistema simulado de dos brazos, ejecutado internamente y con el nivel máximo de esfuerzo.
- Tamaño de la diferencia: supera a Opus 5.5 por 25,5 puntos y a GPT-6 Astra por 35,1 puntos.
- Punto de comparación: en OSWorld, la ventaja es de solo 2,1 puntos. No hay que confundir ambos tipos de diferencia.
- Alcance de las demostraciones: resolver un cubo de Rubik, desenroscar tapas de botellas y dibujar son demostraciones incluidas en el anuncio, no habilidades listas para comercializar.
- Limitaciones del ciclo de control: solo genera texto; forzar
tool_choicedevuelve un error 400 y no se puede desactivar el razonamiento. - Disponibilidad: a fecha de 2026-11-10, Fable 5.2 aún no está disponible en APIYI. Mientras tanto, puedes crear el ciclo de control con
claude-opus-5-5.
Resumen
Los avances de Claude Fable 5.2 en el control robótico son una señal clara: su resultado en RoboDojo Sim subió del 27,6 % de la generación anterior al 64,9 %, lo que supone una ventaja notable frente a los modelos con los que Anthropic lo compara. Sin embargo, esta cifra se aplica a un ámbito muy limitado: solo abarca simulaciones, ejecución interna y el nivel máximo de esfuerzo. No refleja la tasa de éxito con robots reales ni demuestra que el sistema esté listo para su implementación en fábricas.
Si ya tienes un ciclo de control para simulación o para robots reales, valdrá la pena hacer una prueba comparativa con Fable 5.2 cuando esté disponible. También conviene tener en cuenta desde el principio sus limitaciones: solo genera texto, no se pueden forzar las llamadas a herramientas y no se puede desactivar el razonamiento. Si aún no tienes un ciclo de control o buscas resolver tareas de programación o manejo del ordenador, no hace falta cambiar tu solución actual por ese 64,9 %.
Autor: equipo técnico de APIYI
Consultas técnicas: puedes contactarnos desde la página principal de APIYI, apiyi.com. La disponibilidad de cada modelo se indica en la lista de modelos de la plataforma.


