
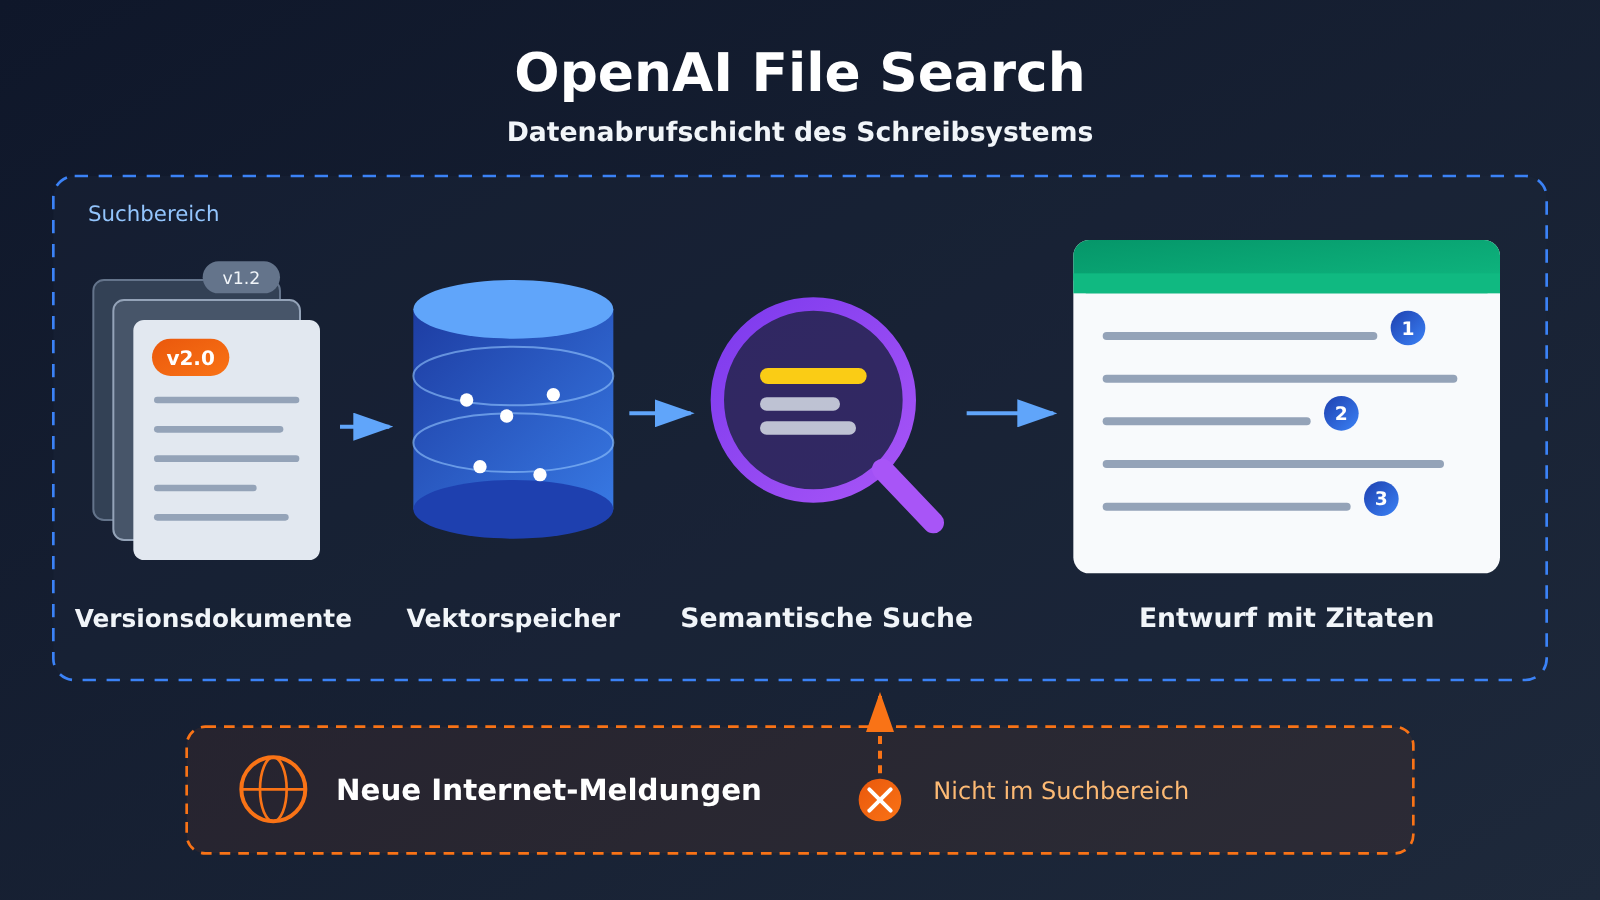
Teilweise lässt sich die Lücke schließen – aber nicht vollständig. OpenAI File Search löst das Problem, dass vorhandene Materialien nicht präzise gefunden und Quellen nicht klar belegt werden. Die Funktion kann Dateien aus einer Vektordatenbank semantisch durchsuchen und die Fundstellen in der Antwort als Dateiverweise mitliefern – für ein Schreibsystem ist das sehr nützlich. Was sie nicht löst: fehlende oder veraltete Materialien. Das Tool durchsucht ausschließlich die Dateien, die Sie selbst eingepflegt haben, und entdeckt nicht automatisch neue Ankündigungen im Internet. Zitatmarker belegen lediglich, aus welcher Datei ein Inhalt stammt – sie garantieren nicht, dass die daraus gezogene Schlussfolgerung stimmt.
Die treffendere Einordnung lautet daher: File Search kann als „Recherche- und Retrieval-Schicht“ eines Schreibsystems dienen. Materialbeschaffung, Versionsverwaltung und Faktenprüfung müssen weiterhin separat organisiert werden.
Das erfahren Sie in diesem Artikel
- Welche Rolle File Search in der Responses API spielt und welche Fähigkeiten es für den Schreibprozess bereitstellt
- Wie Sie die Anzahl der Treffer justieren und wie Sie die tatsächlich gefundenen Inhalte in der Antwort zurückgeben lassen, um Probleme leichter nachzuvollziehen
- Warum eine Datei nach dem Löschen kurzfristig noch gefunden werden kann und wie ein Schreibsystem damit umgehen sollte
- Auf welcher Ebene die drei Problemklassen – fehlendes Material, fehlgeschlagener Abruf und fehlerhafte Formulierung – jeweils zu beheben sind
- Welche Metadaten Sie beim Einpflegen speichern sollten, damit veraltete Beschränkungen nicht als aktuell gültige Regel im Text landen
Überblick: Der Hauptteil erklärt zunächst einige Schlüsselbegriffe und listet die Auswirkungen nach Zielgruppen auf. Der Abschnitt „Objektive Fakten“ stützt sich auf die offizielle OpenAI-Dokumentation und beschreibt, wie File Search arbeitet, welche Parameter sich einstellen lassen und welches Verhalten bekannt ist. Der Abschnitt „Analyse und Einschätzung“ behandelt die Arbeitsteilung nach dem Einbau in ein Schreibsystem, den Weg zur Fehlersuche und die Regeln fürs Einpflegen von Materialien; zum Schluss folgen einige Irrtümer, vor denen man sich in Acht nehmen sollte.
Wichtige Konzepte zu OpenAI File Search
| Konzept | Kurze Erklärung |
|---|---|
| Responses API | OpenAIs Schnittstelle zur Antwortgenerierung, bei der Tools in einer Anfrage eingebunden werden können; File Search ist eines davon |
| File Search | Das integrierte Tool der Responses API, das relevante Ausschnitte aus Dateien in einer Vektorbibliothek abruft, um die Antwortgenerierung zu unterstützen |
| Vektorbibliothek (Vector Store) | Bibliothek, in der hochgeladene Dateien und ihre Vektordarstellungen gespeichert sind; File Search durchsucht genau diesen Bereich |
| Semantische Suche | Sucht Inhalte nach Bedeutungsähnlichkeit; auch Abschnitte mit anderen Worten, aber verwandter Bedeutung werden gefunden |
| Dateiverweis (Citation) | Kennzeichnet in der Antwort, aus welcher Datei ein bestimmter Abschnitt stammt, damit Leser und Prüfer ihn nachschlagen können |
max_num_results |
Parameter, der steuert, wie viele Ergebnisse eine Suche maximal zurückgibt |
include |
Anfrageparameter; wenn file_search_call.results übergeben wird, enthält die Antwort die tatsächlich abgerufenen Inhalte |
| Letztendliche Konsistenz (Eventual Consistency) | Schreib- oder Löschvorgänge werden nicht sofort überall wirksam; kurzzeitig kann noch der alte Zustand sichtbar sein |
Auswirkungen von OpenAI File Search auf einen Blick
| Zielgruppe | Wichtigste Auswirkungen |
|---|---|
| Entwickler von Schreibsystemen | Sie erhalten semantische Suche und Dateiverweise, ohne einen eigenen Suchdienst aufzubauen. Sie müssen jedoch selbst Regeln für die Aufnahme in die Bibliothek und Prozesse zur Fehlerbehebung entwerfen |
| Content-Redakteure / Prüfer | Verweise erleichtern das Nachschlagen, aber die Schlussfolgerungen müssen weiterhin einzeln geprüft werden. Eine vorhandene Quellenangabe ist kein Freibrief |
| Verantwortliche für technische Dokumentation | Dokumente für alte und neue Versionen müssen mit Version und Datum gekennzeichnet werden; sonst können alte Einschränkungen abgerufen und in neue Artikel übernommen werden |
| Kostenverantwortliche | Speicherung in der Vektorbibliothek und Tool-Aufrufe werden berechnet. Maßgeblich sind die aktuellen Preise auf der OpenAI-Preisseite; bei großen Datenmengen ist eine Schätzung nötig |
OpenAI File Search: Fakten
Die folgenden Angaben basieren auf den beiden Leitfäden zu File Search und Retrieval in der OpenAI-Entwicklerdokumentation. Stand der Prüfung: 2026-11-17. Beide Dokumente werden aktiv gepflegt; das ursprüngliche Veröffentlichungsdatum dieser Funktion wurde in diesem Artikel nicht verifiziert.
Was ist File Search? Das Retrieval-Tool in der Responses API
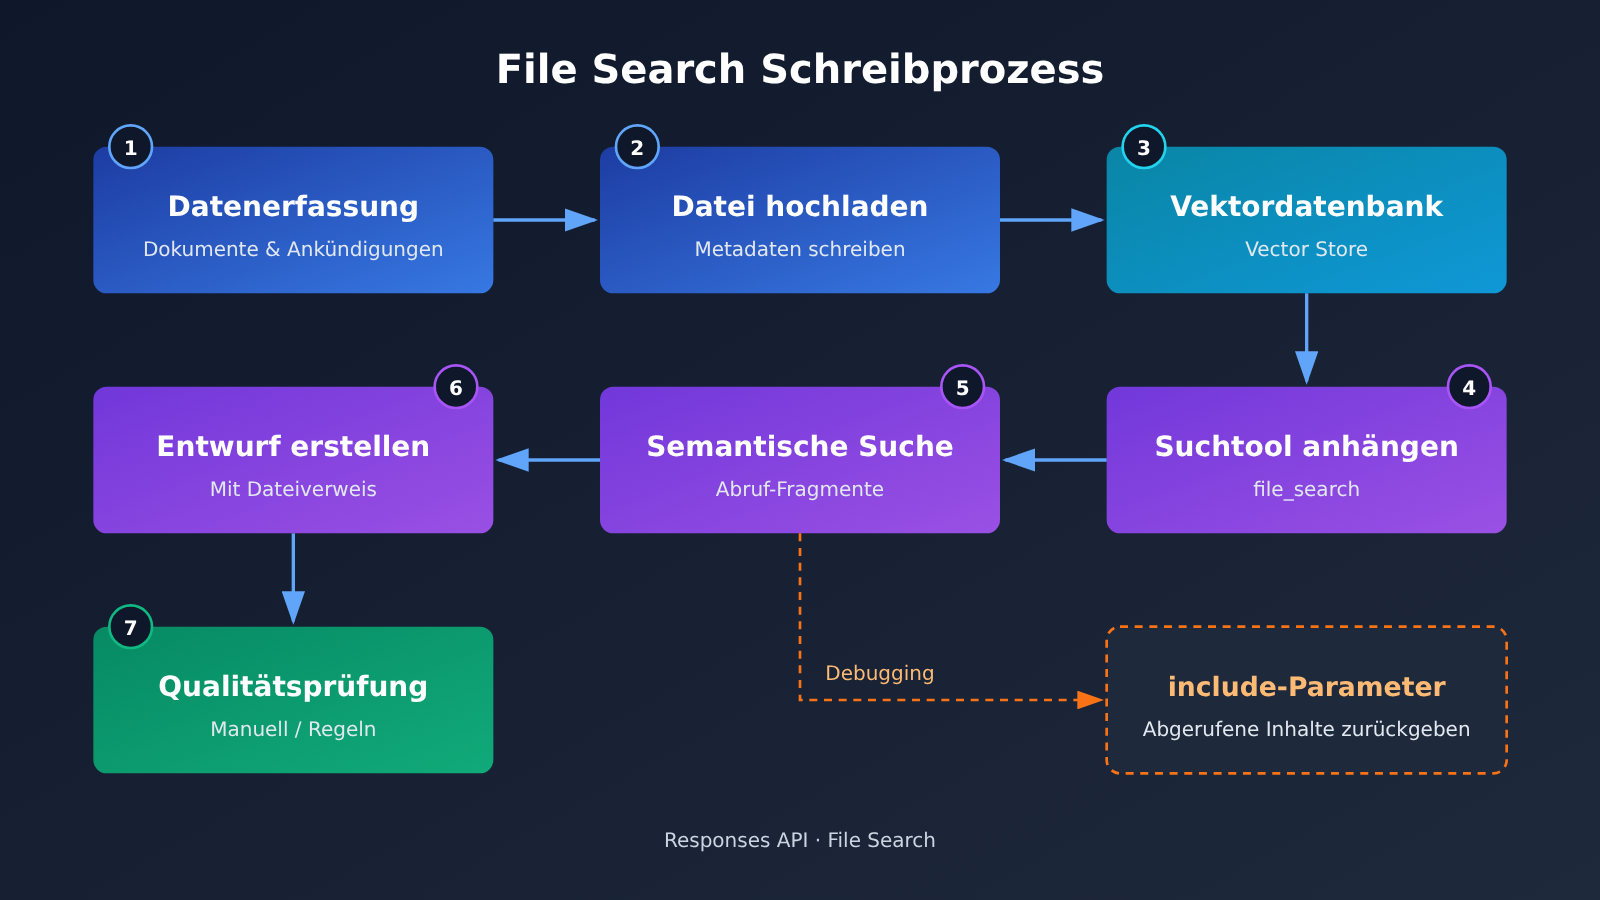
File Search ist ein Tool, das die Responses API bereitstellt. Entwickler laden die Dateien zunächst in einen Vektor-Store hoch und deklarieren bei der Anfrage in tools File Search und geben dabei den Vektor-Store an. Wenn das Modell eine Antwort generiert, ruft es relevante Inhalte aus diesen Dateien ab; die Antwort kann Dateiverweise enthalten, die die Quelle der Informationen angeben.
Es nutzt semantische Suche und findet Inhalte, die inhaltlich relevant sind, auch wenn die Formulierungen nicht exakt übereinstimmen. Beispiel: Bei der Suche nach „API-Drosselung“ kann ein Dokument zurückgegeben werden, in dem von „maximale Anforderungsrate“ die Rede ist. Für ein Schreibsystem bedeutet das: Beim Stellen einer Frage muss man den Wortlaut des Originaltexts nicht exakt wiederholen.
Anpassbare Parameter und Schalter zur Fehlersuche bei File Search
In der Dokumentation gibt es zwei Parameter, die am unmittelbarsten mit dem Schreibsystem zusammenhängen:
| Parameter / Verhalten | Funktion | Bedeutung für den Schreib-Workflow |
|---|---|---|
max_num_results |
Legt die Anzahl der bei einer Suche zurückgegebenen Ergebnisse fest | Weniger Ergebnisse sparen Kontext, aber die Belege sind eventuell unvollständig; mehr Ergebnisse decken breiter ab, dafür nimmt auch das Rauschen zu |
| Standardmäßig zurückgegebener Inhalt | Tool-Aufrufe geben standardmäßig keine vollständigen Suchergebnisse zurück | Wer nur die endgültige Antwort sieht, kann nicht beurteilen, was das Modell tatsächlich gelesen hat |
include: ["file_search_call.results"] |
Lässt die Antwort die tatsächlich abgerufenen Inhalte enthalten | Damit lässt sich unterscheiden, ob „nichts gefunden“ oder „gefunden, aber falsch geschrieben“ vorliegt – unverzichtbar für die Fehlersuche |
| Dateireferenzen | Kennzeichnen in der Antwort die Quelldatei | Praktisch zum Nachschlagen, heißt aber nicht, dass die Schlussfolgerung richtig ist |
Hier ein minimales Aufrufbeispiel: Es zeigt, wie man den Vektorspeicher einbindet, die Anzahl der Treffer begrenzt und die Antwort dazu bringt, die Suchergebnisse zurückzugeben. Ersetzen Sie den Modellnamen und die Vektorspeicher-ID durch Ihre eigene Konfiguration:
from openai import OpenAI

client = OpenAI()  # Liest den Schlüssel aus der Umgebungsvariable OPENAI_API_KEY

response = client.responses.create(
    model="YOUR_MODEL",
    input="根据资料库,总结该接口目前的调用限制,并标明出处。",
    tools=[{
        "type": "file_search",
        "vector_store_ids": ["YOUR_VECTOR_STORE_ID"],
        "max_num_results": 8,   # Anzahl der Treffer: Abwägung zwischen Belegabdeckung und Rauschen
    }],
    include=["file_search_call.results"],  # Gibt die tatsächlich abgerufenen Inhalte zurück, erleichtert die Fehlersuche
)

# Ausgabe durchlaufen: sowohl den endgültigen Text erhalten als auch sehen, welche Fragmente abgerufen wurden
for item in response.output:
    if item.type == "file_search_call":
        for r in (item.results or []):
            print("召回:", r.filename, r.score)
    elif item.type == "message":
        print(item.content[0].text)
Eventuelle Konsistenz beim Löschen von Dateien in File Search
Die Dokumentation weist darauf hin, dass das Löschen von Dateien aus dem Vektorspeicher eventuell konsistent erfolgt: Für eine gewisse Zeit nach dem Löschen kann die Datei noch gefunden werden. Man sollte daher nicht nach außen kommunizieren, dass „eine Datei nach dem Löschen sofort nicht mehr auffindbar ist“. Wenn ein Dokument aufgrund eines Fehlers oder weil es veraltet ist, offline genommen werden muss, ist es für ein Schreibsystem ratsam, zusätzlich auf der eigenen Ebene zu filtern, statt sich allein auf die Löschoperation zu verlassen.
Was File Search nicht leistet
Aus der Beschreibung der offiziellen Dokumentation und der Funktionsweise des Tools selbst ergeben sich einige Punkte, die man klarstellen sollte:
- File Search durchsucht ausschließlich Dateien, die bereits im Vektorspeicher vorhanden sind, und entdeckt nicht automatisch neue Ankündigungen oder Dokumentaktualisierungen im Internet.
- Zitationsmarkierungen geben an, aus welcher Datei ein Inhalt stammt, garantieren aber nicht, dass die daraus gezogenen Schlussfolgerungen korrekt sind.
- Sowohl die Speicherung im Vektorspeicher als auch die Tool-Aufrufe sind kostenpflichtig; die Kosten richten sich nach den aktuell von OpenAI veröffentlichten Preisen, konkrete Zahlen nennt dieser Artikel nicht.
- Dieser Artikel hat nicht überprüft, ob APIYI oder andere Drittanbieter-Plattformen die File-Search-Schnittstellen unterstützen; zur jeweiligen Unterstützung sind die offiziellen Angaben der Plattformen maßgeblich.
Analyse und Einschätzung zu OpenAI File Search
Einschätzung 1: File Search ergänzt die „Retrieval-Ebene“, nicht die „Materialebene“
Bei den Materialien eines Schreibsystems gibt es typischerweise zwei Schwachstellen. Die eine: Man hat die Materialien, trifft aber nicht die richtigen Stellen – das Modell schreibt nach Eindruck, und die Quellen lassen sich nicht sauber belegen. Die andere: Es gibt gar keine Materialien, oder sie sind veraltet. File Search hilft bei der ersten sehr gut: Semantische Suche erhöht die Flexibilität beim Abrufen, und Dateiverweise machen jeden Absatz nachprüfbar.
Bei der zweiten kann es nichts ausrichten. Das Tool holt nicht aktiv neue Ankündigungen – es kann nur abrufen, was in der Vektordatenbank steht. Wenn zum Beispiel gerade Preise oder Limits eines Modells angepasst wurden und die Datenbank nur alte Dokumente enthält, findet File Search die veraltete Information „präzise“ – und liefert dazu eine Quellenangabe, die verlässlich aussieht. Das ist gefährlicher als gar keine Quelle, weil es die Prüfung leichter täuscht.
Man sollte File Search deshalb als eine Ebene im Schreibsystem betrachten, nicht als das gesamte Materialkonzept. Erfassung, regelmäßige Aktualisierung und das Aussortieren alter Versionen brauchen weiterhin eigene Prozesse.
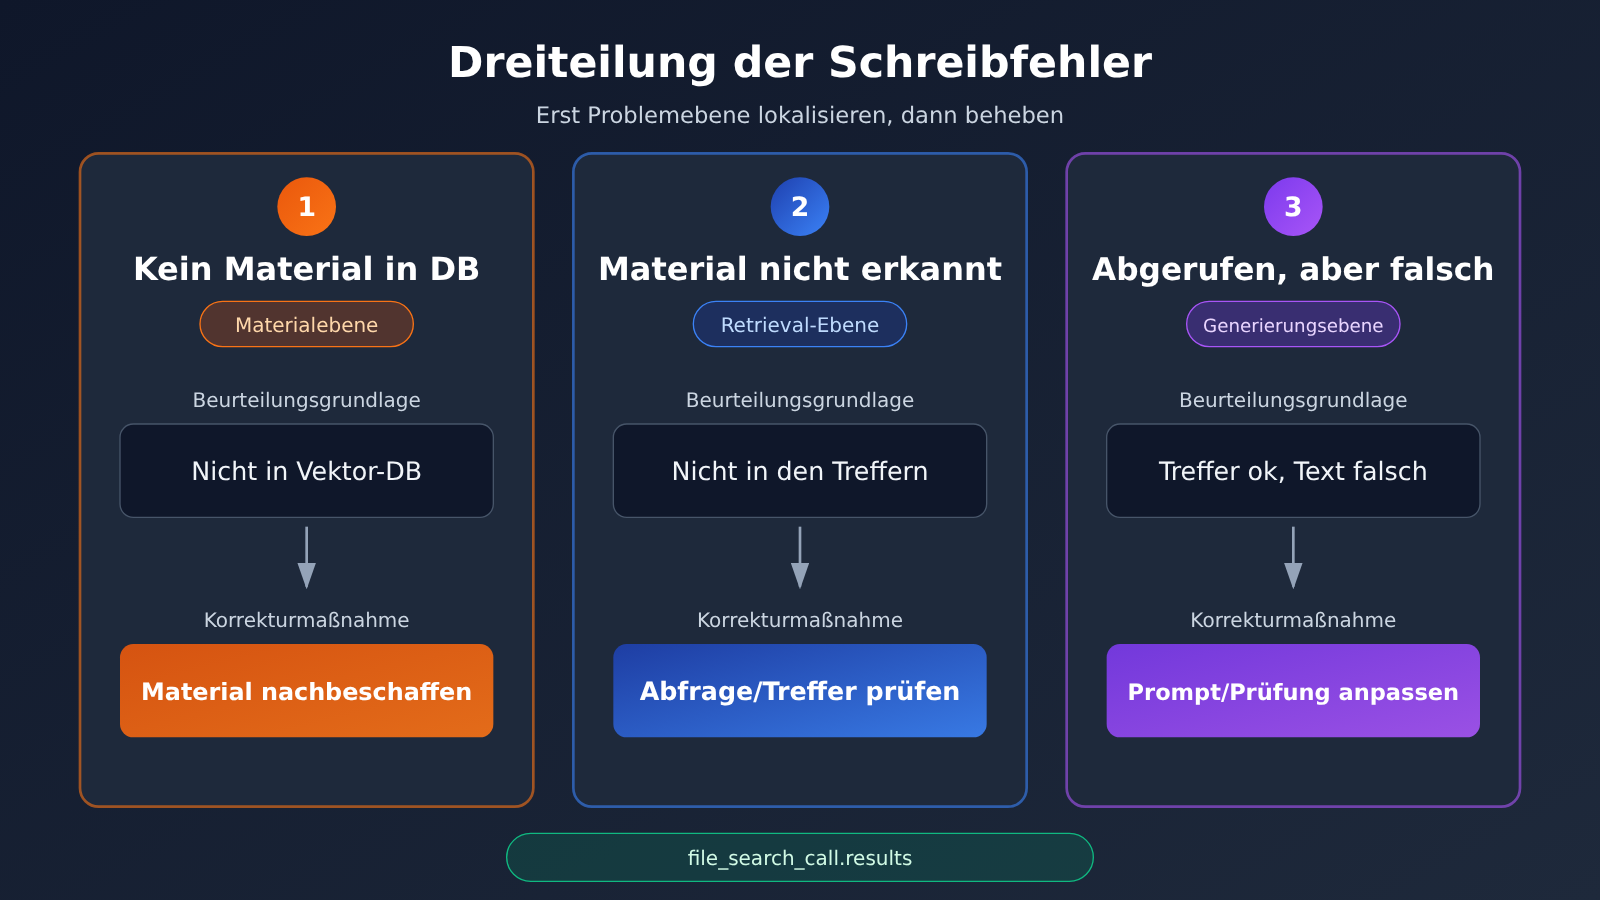
Kriterium zwei: File-Search-Schreibprobleme mit der Dreiteilung lokalisieren
Wenn ein Artikel falsch geschrieben ist, kann das Problem an drei verschiedenen Stellen liegen. Der Wert von include: ["file_search_call.results"] liegt darin, dass diese drei Problemtypen zum ersten Mal voneinander unterschieden werden können.
| Problemtyp | Bewertungskriterium | Reparaturrichtung |
|---|---|---|
| Kein Material in der Bibliothek | In der Vektordatenbank lassen sich keine relevanten Dateien finden | Material nachbeschaffen – ein Problem der Materialebene |
| Material vorhanden, aber nicht abgerufen | Die Datei ist in der Bibliothek, aber nicht in file_search_call.results enthalten |
Abfrageformulierung anpassen, die Frage aufteilen oder max_num_results angemessen erhöhen |
| Abgerufen, aber falsch geschrieben | Die Abrufergebnisse sind korrekt, der fertige Text stimmt aber nicht damit überein | Generierungs-Eingabeaufforderungen und Prüfregeln ändern – ein Problem der Generierungsebene |
Wenn keine abgerufenen Inhalte zurückgegeben werden, sagt das Team oft nur pauschal „die KI hat wieder halluziniert“ und ändert dann die Eingabeaufforderungen. Häufig ist die eigentliche Ursache, dass diese Information in der Bibliothek fehlt oder die Abfrage sie nicht getroffen hat. Erst feststellen, auf welcher Ebene das Problem liegt, dann handeln – so spart man viele Umwege.
Kriterium 3: Die beim Import in OpenAI File Search hinterlegten Metadaten bestimmen die Obergrenze der Schreibqualität
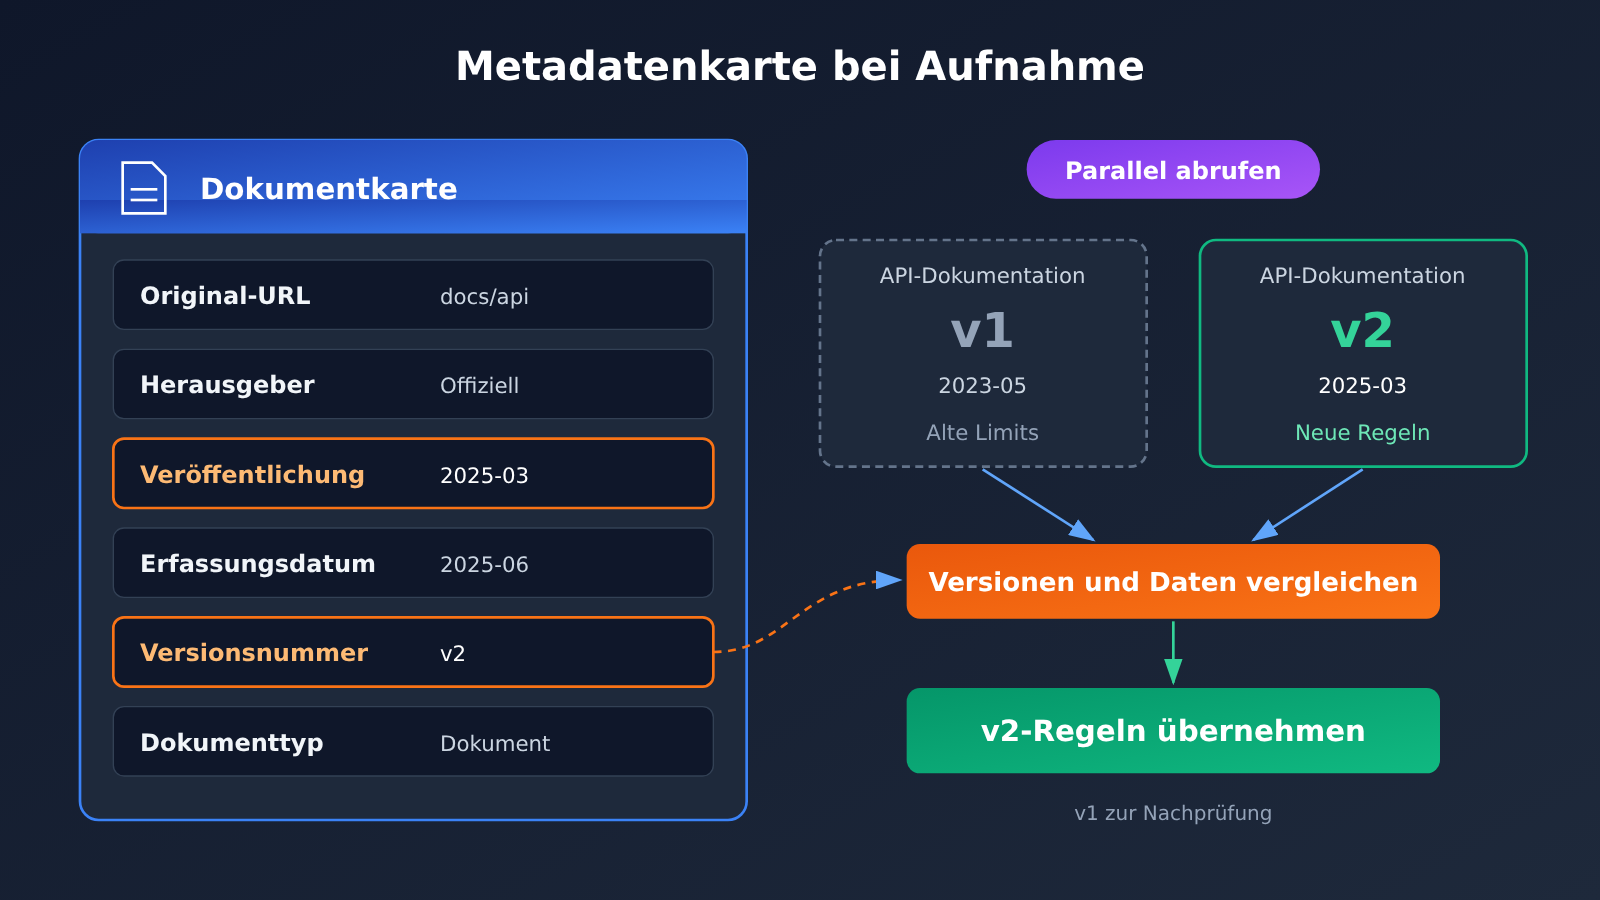
Die Suche kann nur Inhalte zurückgeben, die in der Bibliothek liegen – und deren Qualität hängt davon ab, was beim Import erfasst wurde. Für ein Schreibsystem reicht es nicht, einfach nur den Volltext der Datei hochzuladen. Jedes Dokument sollte mindestens die folgenden Angaben mitbringen:
| Metadatenfeld | Zweck |
|---|---|
| Ursprüngliche URL | Erleichtert die Rückkehr zur Quelle zur Überprüfung und lässt sich in den Referenzen auflisten |
| Herausgebende Stelle | Unterscheidet offizielle Aussagen, Interpretationen Dritter und Community-Gerüchte |
| Veröffentlichungsdatum | Zeigt, ob die Information noch gültig ist |
| Abrufdatum | Zeigt, wie lange das Material nicht aktualisiert wurde |
| Versionsnummer | Verhindert, dass bei gleichzeitig vorhandenen alten und neuen Dokumenten alte Einschränkungen als aktuelle Regel behandelt werden |
| Materialtyp | Unterscheidet Ankündigung, Dokumentation, Blog, Forenbeitrag – erleichtert die Einschätzung der Vertrauenswürdigkeit |
Die Versionsangabe wird am häufigsten übersehen. Alte und neue Dokumentation zur selben Schnittstelle können beide in der Bibliothek liegen und sich semantisch stark ähneln – bei der Suche werden dann leicht beide gleichzeitig abgerufen. Ohne Version und Datum kann das Modell kaum erkennen, welche Einschränkung inzwischen aufgehoben wurde. Die Versionsinformation zu behalten ist sicherer, als alte Dokumente einfach zu löschen: Zum einen braucht man sie noch für historische Vergleiche, zum anderen ist auch das Löschen letztlich konsistent – gelöscht heißt nicht, dass es sofort verschwindet.
Kriterium 4: Für die Anzahl der Treffer gibt es keinen Standardwert
Setzt man max_num_results kleiner, wird der Kontext sauberer, Kosten und Rauschen sinken – allerdings können entscheidende Belege fehlen. Das gilt besonders bei Themen, bei denen mehrere Quellen einander bestätigen müssen, etwa wenn gleichzeitig Preise, Einschränkungen und Versionsunterschiede eine Rolle spielen. Setzt man den Wert größer, wird die Abdeckung vollständiger, aber irrelevante Fragmente verwässern die Aufmerksamkeit, und das Modell neigt eher dazu, Informationen aus verschiedenen Versionen zu vermischen.
Praktikabler ist es, die Einstellung je nach Artikeltyp getrennt vorzunehmen. Bei Nachrichtenanalysen, die eine Kreuzvalidierung aus mehreren Quellen erfordern, kann man den Wert etwas großzügiger wählen. Bei der Parameterbeschreibung einer einzelnen Schnittstelle lässt er sich enger fassen. Für konkrete Zahlen gibt es keine allgemeingültige optimale Lösung. Man sollte sie anhand der tatsächlich zurückgegebenen Abrufinhalte beobachten und dann anpassen, statt aus dem Bauch heraus einen festen Wert festzulegen.
Künftige Entwicklungen, die es zu beobachten gilt
Die folgenden Punkte sind Richtungen, die es zu beobachten gilt, keine bereits bestätigten Fakten: ob File Search eine feinere Metadaten-Filterung anbieten wird, um direkt nach Version oder Datum zu filtern; ob es eine klarere Angabe zur Verzögerung geben wird, bis Löschvorgänge wirksam werden; ob sich das Abrechnungsmodell ändert. All diese Veränderungen wirken sich unmittelbar auf die Architekturentscheidungen des Schreibsystems aus. Vor der Integration empfiehlt es sich, die offizielle Dokumentation und die Preisseite erneut zu konsultieren.
Der häufigste Fehlschluss bei der Integration von File Search in ein Schreibsystem lautet: „Mit Retrieval und Zitaten ist das Problem der Materialbeschaffung gelöst.“ Tatsächlich hilft File Search dabei, vorhandene Materialien besser zu nutzen. Die Aktualität und Genauigkeit des Materials selbst müssen weiterhin durch Erfassung, Versionsverwaltung und Prüfung gewährleistet werden.
Wie kann der Teich so klar sein? Weil aus der Quelle ständig frisches Wasser fließt. — Zhu Xi, „Gedanken beim Lesen“


