
Anmerkung des Autors: Beide sind Flaggschiffe der 2.4T-Klasse – Qwen4-Max senkt den Listenpreis um 25 %, hebt die maximale Ausgabelänge auf nahezu das Dreifache an und benötigt für dieselbe Aufgabe 20 bis 30 % weniger Tokens. Dieser Artikel analysiert die Architektur, die offiziell selbst gemeldeten Benchmark-Ergebnisse und die Listenpreise beider Generationen und liefert eine Checkliste für die Migration von qwen3.8-max.
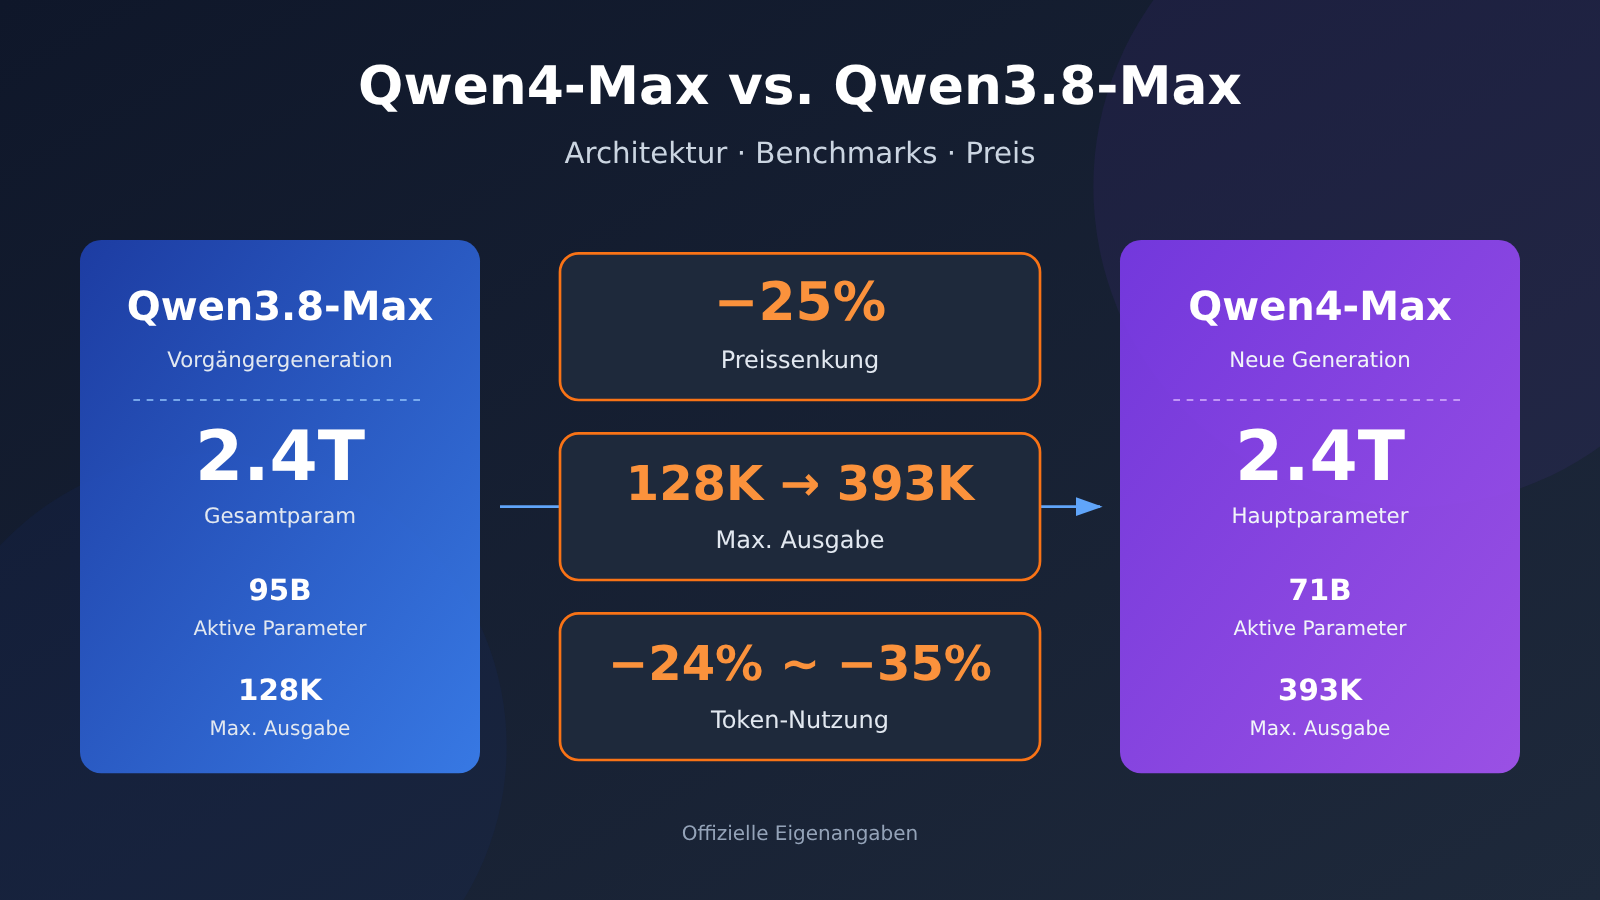
Am 2026-11-16 veröffentlichte Alibaba Qwen4-Max. Das Fazit vorweg: Im Vergleich zu Qwen3.8-Max senkt die neue Generation die Listenpreise für Eingabe und Ausgabe jeweils um 25 %; die maximale Ausgabelänge steigt von 128K auf 393K, was nahezu einer Verdreifachung entspricht; und in der offiziellen Work360-Evaluierung werden für dieselbe Aufgabe 20 bis 30 % weniger Tokens benötigt. Für Teams, die qwen3.8-max bereits in Produktion einsetzen, lohnt sich eine sorgfältige Bewertung dieses Upgrades – ein kompletter Neuanfang ist aber nicht nötig.
Dies ist kein Werbetext im Sinne von „die neue Generation übertrifft alles“. Die unten genannten Benchmark-Ergebnisse sind durchgängig als offizielle Selbstauskunft gekennzeichnet; Rankings von Drittanbietern sind als Momentaufnahme öffentlicher Ranglisten (2026-11-14) markiert. Zwei Zahlen, die leicht übertrieben dargestellt werden, nämlich die 62 % Kostensenkung pro Aufgabe und Platz 6 in der Arena, werden separat aufgeschlüsselt.
Der Kernnutzen: Nach der Lektüre können Sie drei Dinge einschätzen: wie viel von der Einsparung tatsächlich real ist, welche Benchmarks deutlich zulegen und welche praktisch unverändert bleiben – und was bei der Migration außer dem Wechsel der Modell-ID noch angepasst werden muss. Wenn Sie die Modelle über APIYI unter apiyi.com nutzen: Stand 2026-11-16, 11:00 Uhr, ist qwen4-max auf der Plattform noch nicht verfügbar; nutzen Sie vorerst weiter qwen3.8-max. Wir werden dieses Modell so bald wie möglich aufnehmen.
Qwen4-Max vs. Qwen3.8-Max: Die wichtigsten Unterschiede im Überblick
Beide Modellgenerationen liegen in derselben Größenklasse, doch Qwen4-Max bringt Anpassungen bei den aktivierten Parametern, der Ausgabe-Obergrenze und der standardmäßigen Reasoning-Stufe. Die folgende Tabelle stellt zuerst die Spezifikationen gegenüber; die Preise kommen separat im späteren Kostenkapitel.
| Vergleichsaspekt | Qwen3.8-Max | Qwen4-Max | Veränderung |
|---|---|---|---|
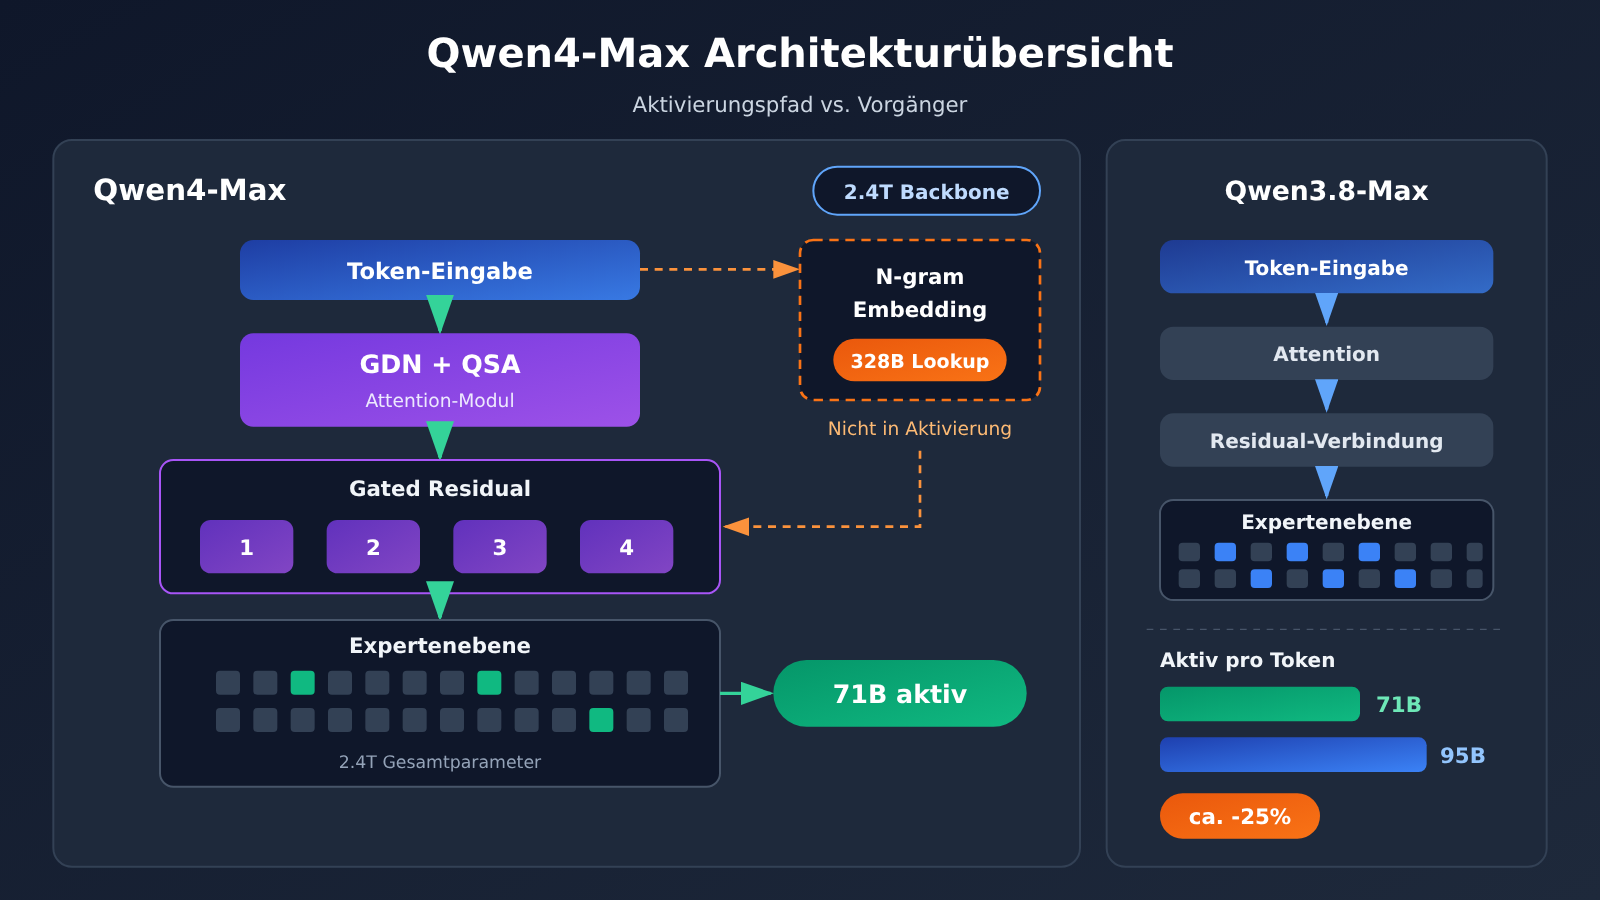
| Parametergröße | 2.4T Gesamtparameter | 2.4T Hauptmodell + 328B N-gram-Embedding | Hauptmodell gleich groß, zusätzliche Embedding-Tabelle |
| Aktivierung pro Durchlauf | 95B | 71B | ca. 25 % weniger |
| Kontext | 1M | 1M (max. Eingabe 991K, Reasoning-Modus 983K) | Eingabe-Obergrenze leicht reduziert |
| Maximale Ausgabe | 128K | 393K | etwa 3-fach |
| Maximale Gedankenkette | offiziell nicht separat ausgewiesen | 262K | neue, explizite Obergrenze |
| Standard-reasoning_effort | xhigh | high | Standardstufe um eine Stufe gesenkt |
| Vision-Fähigkeit | Bild-Eingabe unterstützt | natives Vision | Vision ist jetzt native Fähigkeit |
| Offene Gewichte | Qwen3.8-2.4T-A95B | in den Unterlagen nicht erwähnt | — |
An dieser Tabelle lässt sich die Denkweise des Upgrades erkennen: gleiche Gesamtgröße, weniger Rechenaufwand pro Durchlauf, größerer Ausgaberaum. Die Absenkung der aktivierten Parameter von 95B auf 71B ist die grundlegende Voraussetzung dafür, dass der Listenpreis gesenkt werden konnte; die maximale Ausgabe von 393K verändert direkt die Machbarkeit von Aufgaben wie langen Berichten oder der Generierung großer Codepassagen.
Ein Hinweis noch: Der Standardwert für reasoning_effort wechselt von xhigh zu high. Wenn euer Code diesen Parameter nicht explizit setzt, ändert sich nach dem Austausch der Modell-ID die tatsächlich laufende Reasoning-Stufe – darauf wird in der Migrationscheckliste noch einmal hingewiesen.
Qwen4-Max Architekturänderungen: Wie sich die drei Änderungen auf die Nutzung auswirken
Im offiziellen Blog werden die Architekturänderungen von Qwen4-Max in drei Punkten zusammengefasst: GDN + QSA, Gated Residual mit vier Zweigen und N-gram Embedding. Für API-Nutzer ist es nicht nötig, die Implementierungsdetails Schicht für Schicht zu verstehen, aber man sollte wissen, was die drei Änderungen jeweils beeinflussen.
GDN + QSA: Änderungen auf der Attention-Ebene
Dabei handelt es sich um eine Anpassung der Attention-Struktur. Das offizielle Team stellt sie zusammen mit dem 1M-Kontextfenster und der maximalen Ausgabe von 393K vor. Unser Verständnis ist, dass sie vor allem der Recheneffizienz bei langen Sequenzen dient. Für Aufrufer lässt sich direkt feststellen: Bei gleichem 1M-Kontextfenster kann Qwen4-Max längere Ausgaben erzeugen, während der Preis pro Einheit sogar niedriger ist.
Gated Residual mit vier Zweigen
Die Residualverbindung wurde zu vier Zweigen mit Gating erweitert. Solche Änderungen wirken sich normalerweise auf die Trainingsstabilität und den Informationsfluss zwischen verschiedenen Fähigkeiten aus und zeigen sich letztlich im Modellverhalten. Praktisch bedeutet das: Selbst wenn die Eingabeaufforderung völlig unverändert bleibt, können sich Ausgabestil und Länge der Inferenzschritte von Qwen4-Max von der Vorgängergeneration unterscheiden. Daher müssen die für Qwen3.8-Max feinabgestimmten Eingabeaufforderungen erneut mit Regressionstests geprüft werden.
N-gram Embedding: 328B Parameter bedeuten nicht gleich Rechenaufwand
Die Parametrisierung von Qwen4-Max lautet „2.4T-Backbone / 71B aktiviert + 328B N-gram Embedding“. Nach gängigem Design gehören diese Embeddings zu den tabellenbasierten Lookup-Parametern und fließen nicht in die Aktivierungsberechnung des Hauptmodells pro Token ein. Deshalb kann man die 328B nicht einfach zur Aktivierungsmenge addieren und so vergleichen. Für die Inferenzkosten relevant ist tatsächlich 71B gegenüber 95B, das heißt bei jeder Aktivierung etwa 25 % weniger.
Auf der Pretraining-Ebene gibt das offizielle Team an, dass Qwen4-Max-Base in den vier internen Evaluierungskategorien Wissen, Code, Frage-Antwort und STEM durchweg den niedrigsten BPB (Bits pro Byte, je niedriger, desto besser) erzielt – etwa 5–13 % niedriger als Qwen3.8-Max-Base. Das ist eine offizielle interne Evaluierung, aber sie zeigt zumindest, dass das Basismodell selbst besser geworden ist. Die späteren Benchmark-Verbesserungen stammen also nicht allein aus dem Post-Training.
Qwen4-Max im Benchmark-Vergleich: Wo es deutlich zulegte und wo sich fast nichts tat
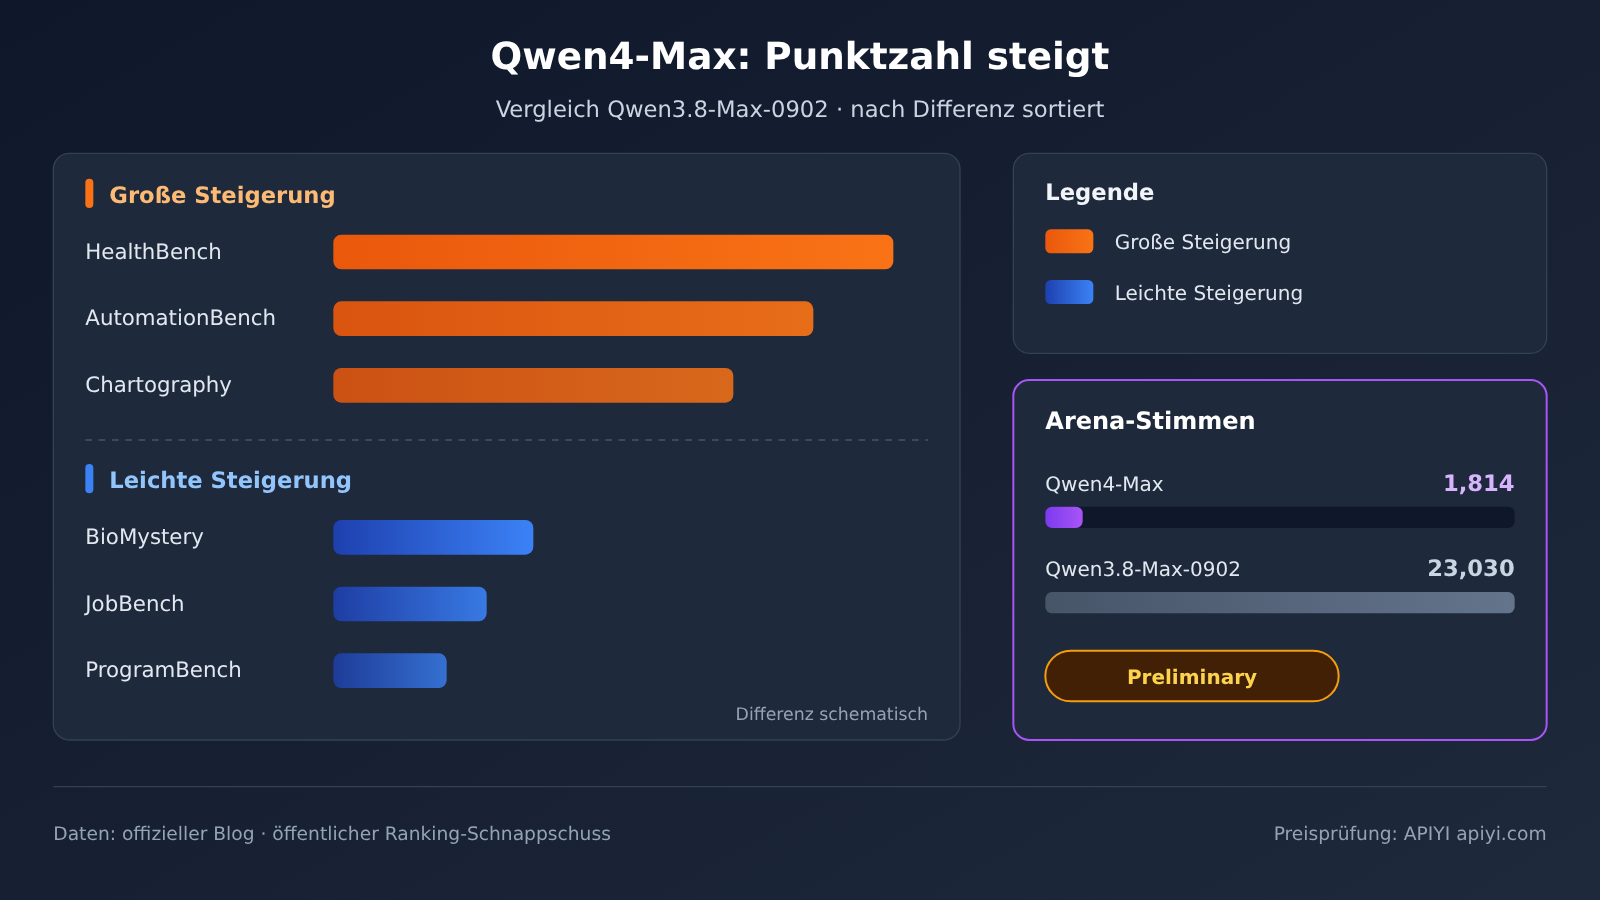
Alle folgenden Daten stammen aus derselben Vergleichstabelle von Alibaba und sind offizielle Eigenangaben. Vergleichsbasis ist Qwen3.8-Max-0902, die September-Refresh-Version. Wir sortieren nach Zuwachs von groß nach klein, damit direkt erkennbar ist, wo der Nutzen des Upgrades am stärksten konzentriert ist.
| Benchmark (offizielle Eigenangabe) | Qwen3.8-Max-0902 | Qwen4-Max | Differenz | Einschätzung des Zuwachses |
|---|---|---|---|---|
| AA-Briefcase | 1605 | 1686 | +81 | deutlich |
| CodeArena | 1676 | 1750 | +74 | deutlich |
| HealthBench | 39.6 | 60.0 | +20.4 | sehr deutlich |
| AutomationBench | 56.2 | 72.5 | +16.3 | sehr deutlich |
| Chartography | 42.0 | 54.2 | +12.2 | deutlich |
| Terminal-Bench | 38.9 | 48.5 | +9.6 | deutlich |
| APEX-Agents | 63.3 | 72.1 | +8.8 | deutlich |
| HLE | 43.9 | 51.7 | +7.8 | deutlich |
| DeepSWE | 69.3 | 75.7 | +6.4 | mittel |
| HLAB-Vals | 15.4 | 21.3 | +5.9 | mittel |
| Video-Index | 63.2 | 68.1 | +4.9 | mittel |
| ProgramBench | 28.0 | 31.5 | +3.5 | gering |
| JobBench | 65.3 | 68.5 | +3.2 | gering |
| BioMystery | 84.1 | 85.0 | +0.9 | nahezu unverändert |
Am stärksten konzentrieren sich die Zuwächse auf Aufgaben im Bereich Agenten und Tool-Calling: AutomationBench +16.3, Terminal-Bench +9.6, APEX-Agents +8.8. Wenn Ihr Geschäft auf mehrstufigen Tool-Aufrufen, Terminal-Operationen oder automatisierten Abläufen basiert, ist das die Richtung mit dem größten Upgrade-Nutzen. HealthBench steigt von 39.6 auf 60.0, Chartography um 12.2 – medizinische Frage-Antwort und Diagrammverständnis sind damit ebenfalls Schwerpunkte dieser Generation.
Am anderen Ende legt BioMystery nur um 0.9 zu, JobBench und ProgramBench um etwas mehr als 3 Punkte. Bei diesen Aufgabentypen ist der Grenznutzen eines Upgrades begrenzt. Wenn Ihr Hauptszenario genau in dieser Nähe liegt, reichen Benchmark-Werte allein nicht als Grundlage für eine Upgrade-Entscheidung; der Kostenaspekt sollte stärker zählen. Der offizielle Work360-Wert liegt bei 52.69 gegenüber 47.74, also 4.95 höher – ebenfalls eine mittlere Verbesserung.
Im Sicherheitsbereich gibt der offizielle Bericht für Last Secure Code Bench eine funktionsbezogene Doppel-Pass-Rate an, die von 22.0% auf 31.8% steigt; die gleichzeitige Sicherheit auf drei Granularitätsstufen steigt von 8% auf 14.7%. Die absoluten Werte bleiben weiterhin niedrig, generierter Code muss also noch immer sicherheitsgeprüft werden – der relative Zuwachs ist aber deutlich.
Arena-Drittanbieter-Ranking: Preliminary-Platzierung mit 1.814 Stimmen
Die offiziellen 1.750 Punkte in der CodeArena sind auch in der Drittanbieter-Rangliste arena.ai Code Arena WebDev zu sehen. Hier ist ein öffentlicher Snapshot der Rangliste, 2026-11-14:
- Qwen4-Max (xHigh): 1.750 Punkte, Platz 6, als Preliminary markiert, 1.814 Stimmen, $4,18/Aufgabe
- Qwen3.8-Max (0902): 1.676 Punkte, Platz 16, 23.030 Stimmen, $1,91/Aufgabe
- Qwen3.8-Max: 1.670 Punkte, Platz 18
Die zweite Stelle, an der gern übertrieben wird, ist diese: Qwen4-Max hat nur 1.814 Stimmen, die Vorgängerversion 0902 kommt auf 23.030 Stimmen – etwa 12-mal so viele. Das Preliminary-Kennzeichen bedeutet, dass sich die Rangliste noch stabilisiert; Platz 6 kann sich noch verschieben. Wenn man ihn jetzt zitiert, sollte man besser „vorläufiger Platz 6“ schreiben.
Ein weiteres Detail im Snapshot ist bemerkenswert: Qwen4-Max tritt in der xHigh-Stufe an und kostet $4,18 pro Aufgabe – mehr als die $1,91 von Qwen3.8-Max 0902. Das steht nicht im Widerspruch zur offiziellen Aussage „sinkende Kosten pro Aufgabe“, denn getestet werden unterschiedliche Stufen und Aufgabentypen. Es erinnert uns aber daran: Auf der höchsten Inferenzstufe ist Qwen4-Max nicht zwangsläufig günstiger.
Qwen4-Max Preis und Kosten: Wie viel von der Ersparnis wirklich echt ist
Ein Upgrade bedeutet letztlich nichts anderes als einen Modellwechsel – und bevor man sich entscheidet, sollte man zuerst die Preise vergleichen. Die folgende Tabelle zeigt die offiziellen Listenpreise der beiden Generationen sowie den aktuell bei APIYI erhältlichen Preis für qwen3.8-max. Alle Angaben beziehen sich auf 1M Tokens, Stand: 2026-11-16.
| Abrechnungsposten (pro 1M Tokens) | Qwen3.8-Max offiziell (Region Singapur) | Qwen4-Max offiziell | Qwen4-Max offiziell in RMB | APIYI qwen3.8-max aktueller Preis |
|---|---|---|---|---|
| Eingabe | $2 | $1.5 | ¥10 | $1.65 |
| Ausgabe | $6 | $4.5 | ¥30 | $4.95 |
| Cache-Lesen | $0.25 | $0.075 | ¥0.5 | $0.20625 |
| Cache-Schreiben (5 Minuten) | Im offiziellen Blog nicht aufgeführt | $1.875 | ¥12.5 | In der Dokumentation nicht separat aufgeführt |
| Cache-Schreiben (1 Stunde) | Im offiziellen Blog nicht aufgeführt | $3 | ¥20 | In der Dokumentation nicht separat aufgeführt |
Eingabe und Ausgabe sinken jeweils um 25 %, das Cache-Lesen fällt von $0.25 auf $0.075 – das sind rund 70 % weniger. Damit ist es der größte Posten in dieser Preisrunde. Andererseits listet Qwen4-Max jetzt ausdrücklich zwei Cache-Schreibpreise auf, für 5 Minuten und für 1 Stunde. Anwendungen, die lange Prefixe häufig wiederverwenden, sollten diese Schreibkosten unbedingt in ihr Budget einrechnen.
Token-Einsparung: 20 bis 30 Prozent bei Work360, 40 bis 50 Prozent bei Terminal-Bench
Offiziell gibt es zwei Datensätze zur Token-Einsparung. Auf Work360 spart die Stufe Xhigh 24 % und die Stufe High 35 % – daraus stammt die Angabe „20 bis 30 Prozent eingespart“. Auf Terminal-Bench 4.0 fällt es noch deutlicher aus: 48 % bzw. 49 %.
Bei Terminal-Aufgaben ist die Einsparung klar größer, was mit der geringeren Zahl an Tool-Runden in solchen Aufgaben zusammenhängen dürfte. Für die Budgetplanung ist es sicherer, bei allgemeinen Büroaufgaben von 20 bis 30 Prozent auszugehen; 40 bis 50 Prozent gelten nur für Terminal-Szenarien, die Terminal-Bench ähneln.
Die 11 Prozentpunkte, bei denen 62 % und 51 % nicht zusammenpassen
Das ist die erste Stelle, an der leicht übertrieben wird. Offiziell sinken die Kosten pro Aufgabe von $4,43 auf $1,67, in Dollar gerechnet also etwa 62 % weniger; in der chinesischen Darstellung steht ¥26,58 auf ¥11,16, also rund 58 % – schon die beiden Bezugsgrößen weichen voneinander ab.
Rechnet man mit den offiziellen eigenen Daten: 35 % weniger Tokens und 25 % niedrigerer Stückpreis ergeben multipliziert nur eine Reduktion von etwa 51 %, also 0,65 × 0,75 ≈ 0,49. Die verbleibenden rund 11 Prozentpunkte erklärt die offizielle Darstellung nicht. Wir vermuten, dass sie aus dem Nutzen von Cache-Treffern durch die starke Senkung des Cache-Lesepreises (etwa −70 %) sowie aus der geringeren Zahl an Tool-Aufrufen stammen – das ist jedoch nur eine Vermutung, keine offizielle Aussage.
Der sichere Weg: Betrachten Sie 51 % als Orientierungsobergrenze „bei gleicher Cache-Trefferquote“; 62 % sind nur in Szenarien mit hoher Cache-Trefferquote und vielen Tool-Runden annähernd realistisch. Für Ihr konkretes Geschäft ist die zuverlässigste Grundlage ein Vergleich der Kosten pro Aufgabe mit echtem Traffic.
APIYI: Aktueller Preis und Verfügbarkeitsstatus
Bei APIYI ist derzeit qwen3.8-max erhältlich: Eingabe $1.65, Ausgabe $4.95, Cache-Lesen $0.20625. Laut Dokumentation liegt das 17,5 % unter den $2 / $6 von Alibaba Cloud. Zum gleichen Preis gibt es außerdem qwen3.8-max-0902; die Version mit offenen Gewichten qwen3.8-2.4t-a95b kostet $1.72 / $5.16 / $0.215.
Bei der Überprüfung am 16.11.2026 um 11:00 Uhr war qwen4-max weder in der Modelldokumentation noch in der Preisliste von APIYI (insgesamt 284 Modelle) zu finden; das Modell ist derzeit noch nicht gelistet. Wir werden es so bald wie möglich aufnehmen. Maßgeblich für Modellname und Preis ist die Modellliste auf der APIYI-Plattform apiyi.com. Ehrlich gesagt liegt der offizielle Listenpreis von Qwen4-Max bereits unter dem aktuellen Plattformpreis von qwen3.8-max. Nach der Aufnahme lohnt es sich, die Abrechnung noch einmal zu prüfen.
Von Qwen3.8-Max auf Qwen4-Max umstellen: eine Checkliste
Viele glauben, ein Upgrade bedeutet nur, eine Modell-ID zu ändern – tatsächlich ändern sich aber Standardparameter, Kontextgrenzen und die Cache-Abrechnung. Die folgende Checkliste ist nach dem Prinzip „wenn Sie das nicht anpassen, kann es Ärger geben“ priorisiert.
| Prüfpunkt | Qwen3.8-Max heute | Nach Umstellung auf Qwen4-Max | Empfohlene Aktion |
|---|---|---|---|
| Modell-ID | qwen3.8-max / qwen3.8-max-0902 |
gemäß Modellliste der Plattform | Erst nach Verfügbarkeit umstellen, vorher Canary |
| Standardwert von reasoning_effort | xhigh | high | Stufe explizit angeben, damit sich das Verhalten nicht unbemerkt ändert |
| Obergrenze für max_tokens | 128K | 393K | Downstream-Truncation, Speicherung und Timeout-Einstellungen prüfen |
| Maximale Eingabe | 1M | 991K (im Thinking-Modus 983K) | Sehr lange Eingaben nahe 1M müssen gekürzt werden |
| Cache-Abrechnung | Cache-Read $0.25 | Cache-Read $0.075, dazu Schreibpreise für 5 Minuten / 1 Stunde | Cache-Präfixe und TTL-Strategie neu bewerten |
| Visuelle Eingabe | Bildeingabe | natives Sehen | Bildbezogene Anwendungsfälle erneut testen |
| Eingabeaufforderung und Ausgabeformat | auf die vorherige Generation abgestimmt | Architektur geändert, Verhalten kann abweichen | Regression mit festem Evaluationsset |
| Kostenüberwachung | pro Token | Token- und Stückpreis sinken gleichzeitig | Statt Stückpreis die Kosten pro Aufgabe betrachten |
Der am leichtesten übersehene Punkt in der Checkliste ist reasoning_effort. Qwen3.8-Max nutzt standardmäßig xhigh, Qwen4-Max standardmäßig high. Wenn im Code nichts explizit gesetzt ist, kann die Umstellung sowohl Token sparen als auch bei komplexen Reasoning-Aufgaben schlechtere Ergebnisse liefern als erwartet. Die offiziellen Token-Einspardaten nennen sowohl die Stufe Xhigh als auch High – testen Sie am besten beide separat und entscheiden Sie dann, welche Stufe produktiv läuft.
Zweitens die Ausgabelänge. Die Obergrenze von 393K bedeutet, dass eine einzelne Antwort deutlich länger sein kann als bisher. Wenn Logsystem, Datenbankfelder und Gateway-Timeouts auf 128K Ausgabe ausgelegt sind, müssen sie vorab erweitert werden. Die maximale Eingabe schrumpft von 1M auf 991K (im Thinking-Modus 983K). Für die meisten Businesses, die das Limit ohnehin nie ausschöpfen, ist das unkritisch – aber Szenarien, die Dokumente bis an die Grenze hineinpacken, bekommen direkt einen Fehler.
Der aktuelle Weg über APIYI
Wenn Sie derzeit über APIYI anbinden, ist die base_url https://api.apiyi.com/v1, Sie nutzen das OpenAI-kompatible Protokoll, und im Modellfeld tragen Sie einfach qwen3.8-max ein – damit läuft die Produktion weiter. Wer das Verhalten der September-Version fixieren möchte, kann auf qwen3.8-max-0902 wechseln; der Preis ist identisch.
Sobald qwen4-max auf der Plattform verfügbar ist, ändert sich am Code nur das model-Feld, da das Protokoll gleich bleibt; anschließend ergänzen Sie reasoning_effort und max_tokens gemäß der obigen Checkliste. Empfehlung: Zuerst 5 %–10 % des Traffics als Canary umstellen, Kosten pro Aufgabe und Geschäftskennzahlen vergleichen, dann vollständig ausrollen.
🚀 Empfehlung zur Migration: Projekte, die heute über APIYI apiyi.com laufen, können weiter
qwen3.8-maxverwenden und parallel Evaluationsset und Canary-Schalter vorbereiten; nach Verfügbarkeit vonqwen4-maxtauschen Sie einfach die ID. So entsteht keine Betriebslücke, weil man auf das neue Modell wartet.
Szenarioempfehlungen für Qwen4-Max und Qwen3.8-Max
Szenarien, in denen ein Upgrade auf Qwen4-Max vorrangig zu prüfen ist
- Mehrstufige Tool-Aufrufe und Automatisierung: AutomationBench, Terminal-Bench und APEX-Agents zeigen deutliche Verbesserungen; die Token-Einsparungen sind bei Terminal-Aufgaben am größten.
- Aufgaben mit sehr langen Ausgaben: Wenn für Berichte, Code oder Dokumente eine einzelne Generierung von mehr als 128K erforderlich ist, kann nur Qwen4-Max mit 393K diese Anforderung erfüllen.
- Medizinische Fragebeantwortung und Diagrammverständnis: HealthBench +20.4 und Chartography +12.2 sind die Bereiche mit den deutlichsten Verbesserungen dieser Generation.
- Anforderungen an Codesicherheit: Die kombinierte Sicherheitsbestehensquote stieg von 22.0 % auf 31.8 %, erfordert aber weiterhin begleitende Review-Prozesse.
- Anwendungen mit hoher Cache-Wiederverwendungsrate: Der Preis für Cache-Lesevorgänge sinkt um rund 70 %; Szenarien mit langen System-Prompts und festen Wissensdatenbank-Präfixen profitieren am meisten.
Szenarien, in denen Qwen3.8-Max weiterhin die Wahl ist
- Bereits stabil in Produktion und Prompts umfassend optimiert: Qwen3.8-Max bleibt ein zuverlässiges Produktionsmodell; ein Upgrade um des Upgrades willen ist nicht nötig.
- Hauptaufgaben ähneln BioMystery und JobBench: In diesen Bereichen sind die Verbesserungen begrenzt, sodass die Migrationskosten den Nutzen übersteigen könnten.
- Selbsthosting mit Open Weights erforderlich: Qwen3.8-2.4T-A95B bietet offene Gewichte; in den Unterlagen wird keine Open-Weights-Version von Qwen4-Max erwähnt.
- Aufruf über APIYI mit Bedarf an sofortiger Verfügbarkeit: Solange
qwen4-maxnoch nicht angeboten wird, istqwen3.8-maxdie verfügbare Option.
| Deine Situation | Empfehlung |
|---|---|
| Agenten und Tool-Aufrufe im Vordergrund, Kostensenkung angestrebt | Qwen4-Max vorrangig evaluieren, Kosten in der High-Stufe messen |
| Einzelausgabe über 128K erforderlich | Nur Qwen4-Max wählen |
| In Produktion stabil, überwiegend allgemeine Fragebeantwortung | Qwen3.8-Max beibehalten, in ruhigen Zeiten Regressionstests durchführen |
| Selbsthosting mit Open Weights erforderlich | Qwen3.8-2.4T-A95B weiterverwenden |
| Aktuell über APIYI angebunden | Weiterhin qwen3.8-max nutzen, nach Verfügbarkeit per Canary-Rollout wechseln |
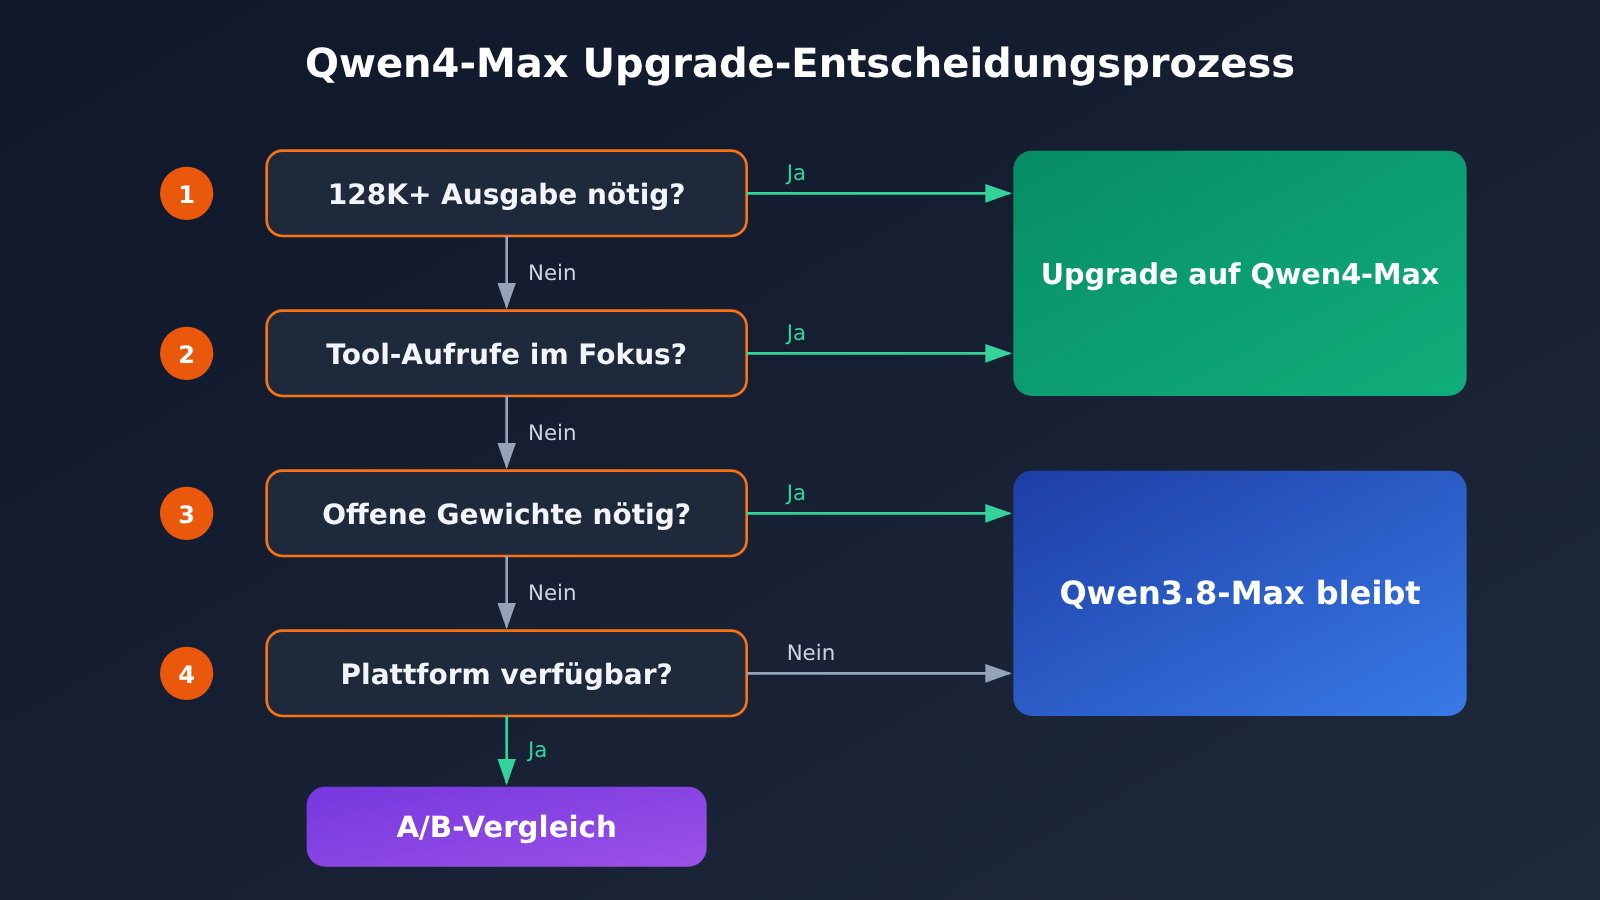
Qwen4-Max vs. Qwen3.8-Max: Empfehlung zur Entscheidungsfindung
Wenn man es in einem Satz zusammenfassen will: Für Agenten, lange Ausgaben und cache-intensive Anwendungen lohnt sich das Upgrade, für allgemeine stabile Anwendungen kann man ruhig abwarten. Von den drei Vorteilen eines Upgrades ist der um 25 % gesenkte Stückpreis sicher; die Token-Einsparung von 20 bis 30 % sind offizielle Angaben aus bestimmten Benchmarks; die 62 % Reduktion bei einzelnen Aufgaben lässt sich nur dann annähernd erreichen, wenn die eigenen Cache- und Tool-Runden-Bedingungen entsprechend zusammenpassen.
💡 Auswahlhinweis: Bevor Sie sich entscheiden, sollten Sie mit Ihren eigenen realen Aufgaben jeweils eine Testreihe durchführen und die Kosten pro Aufgabe sowie die Qualität der Ergebnisse vergleichen, anstatt nur die Benchmark-Tabellen anzusehen. Über APIYI (apiyi.com) können Sie mit demselben API-Schlüssel zunächst eine Baseline mit
qwen3.8-maxlaufen lassen und nach der Verfügbarkeit vonqwen4-maxdirekt im selben Code-Setup vergleichen.
Häufige Fragen (FAQ)
F1: In welchem Verhältnis stehen Qwen4-Max und Qwen3.8-Max?
Beide sind Flaggschiffe der 2,4T-Klasse von Tongyi Qianwen. Qwen3.8-Max wurde am 2026-08-03 veröffentlicht, 0902 ist die im September aktualisierte Version; Qwen4-Max erschien am 2026-11-16 mit einer neuen Architektur, bei der die pro Aktivierung genutzten Parameter von 95B auf 71B sanken, das Ausgabelimit auf 393K angehoben wurde und der Listenpreis um 25 % gesenkt wurde.
F2: Wenn 20 bis 30 % der Token gespart werden, sinkt die Rechnung dann auch um 20 bis 30 %?
Nicht nur das – und nicht zwangsläufig. Der Stückpreis selbst sinkt um 25 %, und zusammen mit der Token-Reduktion könnten die Kosten für dieselbe Aufgabe theoretisch um etwa 51 % sinken. Die Token-Einsparungen stammen jedoch aus dem offiziellen Work360-Benchmark; wie viel Sie in Ihrem Geschäft tatsächlich sparen, müssen Sie selbst messen. Bei Verwendung der xhigh-Stufe können die Kosten pro Aufgabe – wie der Arena-Snapshot zeigt – sogar höher ausfallen.
F3: Qwen4-Max steht in der Arena auf Platz 6 – ist dieser Rang verlässlich?
Das lässt sich nur als vorläufiges Ergebnis betrachten. Im öffentlichen Snapshot der Rangliste (2026-11-14) hat Qwen4-Max nur 1.814 Stimmen und ist als Preliminary gekennzeichnet; die Vorgängergeneration 0902 kommt auf 23.030 Stimmen – ein Unterschied von etwa Faktor 12. Die Punktzahl 1750 stimmt mit der offiziellen Selbstauskunft überein, der Rang kann sich aber noch verschieben, wenn mehr Stimmen eingehen.
F4: Kann man qwen4-max jetzt schon über APIYI aufrufen?
Stand 2026-11-16 11:00 Uhr noch nicht – `qwen4-max` ist derzeit nicht gelistet, wir werden es aber so schnell wie möglich aufnehmen. Verfügbar sind aktuell `qwen3.8-max`, `qwen3.8-max-0902` und die Open-Weights-Version `qwen3.8-2.4t-a95b`. Für die neuesten Modelle und Preise gilt die Modellliste der APIYI-Plattform apiyi.com als maßgeblich; neue Nutzer können mit dem kostenlosen Testkontingent zunächst eine Basislinie erheben.
F5: Reicht es bei der Migration, nur die Modell-ID zu ändern?
Nein. Mindestens müssen Sie zusätzlich reasoning_effort explizit setzen (der Standardwert ändert sich von xhigh auf high), max_tokens und die Limits der nachgelagerten Speicherung bei Bedarf erweitern, Eingaben mit nahezu 1M Länge prüfen und die Kosten für Cache-Schreibvorgänge neu bewerten. Auf Protokollebene gilt: Wenn Sie die OpenAI-kompatible Schnittstelle `https://api.apiyi.com/v1` nutzen, müssen im Code nur das Feld model geändert werden.
F6: Lohnt es sich, Qwen3.8-Max weiterzuverwenden?
Ja. Es bleibt ein Flaggschiff der 2,4T-Klasse mit 1M-Kontextfenster, 128K Ausgabe, vollständigen Denk- und Nicht-Denk-Modi sowie einer Open-Weights-Version. Qwen4-Max erzielt bei Benchmarks wie BioMystery und JobBench nur sehr geringe Verbesserungen; für solche Geschäftsfelder kann ein stabil laufendes Qwen3.8-Max den Produktionsverkehr problemlos weiter tragen.
Qwen4-Max vs. Qwen3.8-Max: die wichtigsten Punkte (Key Takeaways)
- Gleiche Größenordnung, weniger aktivierte Parameter: Der 2,4T-Backbone bleibt unverändert, die pro Aufruf aktivierten Parameter sinken von 95B auf 71B – rund 25 % weniger.
- Stückpreis minus 25 %: Input $2→$1.5, Output $6→$4.5, Cache-Reads rund 70 % günstiger; neu hinzu kommt die Abrechnung von Cache-Writes.
- Ausgabe etwa verdreifacht: Maximale Ausgabe 128K→393K, maximale Eingabe auf 991K begrenzt.
- Zuwächse vor allem bei Agenten: AutomationBench, Terminal-Bench und HealthBench legen deutlich zu, BioMystery praktisch unverändert.
- Zwei Punkte nicht überzeichnen: Aus den 62 % Kostensenkung lassen sich nur etwa 51 % belegen; Platz 6 in der Arena beruht auf nur 1.814 Stimmen und ist „Preliminary“.
- Migration heißt mehr als nur ID austauschen: Auf den Default-Wert von reasoning_effort, das max_tokens-Limit und die Cache-Strategie achten.
- APIYI-Status:
qwen4-maxist noch nicht verfügbar; weiterhinqwen3.8-maxnutzen und erst nach der Verfügbarkeit schrittweise (Canary) umstellen.
Zusammenfassung
Die Kernaussagen von Qwen4-Max im Vergleich zu Qwen3.8-Max:
- Kosten: Die 25 % Preisnachlass sind ein sicherer Gewinn. Ob sich 20–30 % der Token einsparen lassen, müsst ihr an eurem eigenen Workload messen; bei den 62 % Senkung sind rund 11 Prozentpunkte unklar, woher sie stammen.
- Fähigkeiten: Deutliche Verbesserungen bei Agenten, Tool-Aufrufen, Medizin und Diagrammen; manche Benchmarks nahezu unverändert. Alle Werte sind offizielle Eigenangaben des Anbieters.
- Migration: Das Protokoll bleibt gleich, aber Standard-Reasoning-Stufe, Ausgabelimit und Cache-Abrechnung haben sich geändert – die Checkliste Punkt für Punkt durchgehen.
Qwen3.8-Max ist nach wie vor ein zuverlässiges Produktionsmodell. Ein Upgrade sollte eine datengestützte, schrittweise Entscheidung sein – und kein Komplettwechsel, nur weil eine neue Version erschienen ist. Empfehlung: Zuerst über APIYI apiyi.com mit qwen3.8-max eine solide Kosten- und Qualitätsbasis aufbauen und qwen4-max nach der Verfügbarkeit über dieselbe Schnittstelle direkt vergleichen.
📚 Referenzen
- Offizieller Qwen3.8-Blog: Release-Ankündigung zu Qwen3.8-Max mit Parametern, Kontextfenster und offizieller Preisgestaltung
- Link:
qwen.ai/blog?id=qwen3.8 -
Beschreibung: Quelle für die Spezifikationen der vorherigen Generation und die Preise in der Region Singapur
-
Hugging Face – Qwen3.8-2.4T-A95B: Open-Weights-Version von Qwen3.8
- Link:
huggingface.co/Qwen/Qwen3.8-2.4T-A95B -
Beschreibung: Modellkarte und Download der Gewichte, falls du selbst hosten möchtest
-
Offizieller Qwen-Blog: Ankündigungsbeitrag zu Qwen4-Max mit Benchmark-Vergleich in derselben Grafik
- Link:
qwen.ai/blog -
Beschreibung: Quelle für Architekturänderungen, offiziell selbst gemeldete Benchmark-Ergebnisse sowie Daten zu Token- und Kosten pro Aufgabe
-
arena.ai Code Arena WebDev: Drittanbieter-Leaderboard für Modellduelle
- Link:
arena.ai - Beschreibung: Dieser Artikel bezieht sich auf einen Snapshot vom 14.11.2026; die Platzierungen ändern sich mit der Anzahl der Stimmen
Autor: APIYI-Team
Technischer Austausch: Melde dich gerne über die Startseite von APIYI bei uns – Modellbezeichnungen und Preise findest du im Dokumentationszentrum unter docs.apiyi.com


