
Am 9. November 2026 veröffentlichte Anthropic Claude Fable 5.2 und gab Einblick in ein internes Experiment. Es begann mit einem leeren Ordner: Fable 5.2 koordinierte mehr als 1.000 Subagents, arbeitete acht Tage lang ohne Unterbrechung und entwickelte schließlich einen Prototyp eines Betriebssystems, der sich auf einem Laptop starten lässt.
Kernpunkt: Dieser Artikel wiederholt nicht einfach die Ankündigung, sondern ordnet die öffentlich zugänglichen Materialien von Anthropic zu Multi-Agent-Systemen ein. Er erklärt die jeweiligen Rollen von Orchestrator, Subagent, Advisor und Workflow, zeigt, wie sich Aufgaben sinnvoll aufteilen lassen und warum die Kosten steigen können. Außerdem geht es darum, wie sich Zuverlässigkeit sicherstellen lässt. Zum Schluss gibt es eine praktische Checkliste, die Entwickler direkt nutzen können.
Die wichtigsten Informationen zum Betriebssystem-Experiment mit Claude Fable 5.2
Zunächst sollten wir bestätigte Fakten von noch nicht veröffentlichten Informationen trennen. Das ist die Voraussetzung, um die Herausforderungen der Zusammenarbeit mehrerer Agents zu verstehen.
| Angabe | Details |
|---|---|
| Veröffentlichungsdatum | 9. November 2026, zusammen mit Claude Fable 5.2 vorgestellt |
| Herausgeber | Anthropic |
| Ausgangspunkt des Experiments | Leerer Ordner; die Aufgabe bestand darin, einen Prototyp eines Betriebssystems zu entwerfen und umzusetzen |
| Umfang | Mehr als 1.000 Subagents arbeiteten acht Tage lang rund um die Uhr daran, Code zu schreiben, zu testen, zu überprüfen und zu überarbeiten |
| Ergebnis | Ein Prototyp mit Kernel, Festplatten-, Tastatur- und Netzwerktreibern, dauerhaftem Dateispeicher, Fenstersystem, Anmeldeoberfläche, Installationsprogramm und integrierter Claude-Funktion. Das System lässt sich auf einem echten Laptop starten. |
| Nicht veröffentlichte Informationen | Aufteilung der Agents, Harness, Kommunikationsprotokoll, Umfang des Codes, Programmiersprache, Gesamtverbrauch an Tokens, Kosten des Experiments und unabhängige Sicherheitsaudits |
Anthropic bezeichnet das Ergebnis als working prototype operating system, also als „funktionsfähigen Betriebssystemprototyp“ – nicht als ausgereiftes kommerzielles Betriebssystem. Außerdem ist zu beachten, dass Anthropic im selben Zeitraum auch über andere Experimente berichtete. Bei einem Experiment rund um den Großen Fermatschen Satz wurde beispielsweise eine Struktur aus „einem Lead und 999 Helfern“ offengelegt. Das war jedoch ein eigenständiges Experiment und lässt sich nicht ohne Weiteres auf das Betriebssystemprojekt übertragen.
Bemerkenswert an diesem Experiment ist nicht in erster Linie, wie viel Code geschrieben wurde, sondern dass das Modell ein langfristiges Softwareprojekt über acht Tage hinweg organisieren konnte: Aufgaben aufteilen, parallel bearbeiten, Ergebnisse zusammenführen, Fehler finden und Korrekturen veranlassen. Daraus ergibt sich die zentrale Frage dieses Artikels: Bei 1.000 Agents ist die Organisation die eigentliche Herausforderung.
Wie die Zusammenarbeit mehrerer Agents funktioniert: Rollenverteilung hinter Claude Fable 5.2
Bevor wir darüber sprechen, ob mehrere Agents sinnvoll sind, sollten wir zunächst einige leicht zu verwechselnde Begriffe klären. Die folgende Tabelle fasst die Konzepte nach den Angaben in der Dokumentation zu Anthropic Managed Agents zusammen.
| Begriff | Aufgabe | Typisches Beispiel |
|---|---|---|
| Agent | Ein intelligenter Agent, der Aufgaben ausführen und Tools aufrufen kann | Ein Programmierassistent, der Code lesen und Tests ausführen kann |
| Orchestrator | Koordiniert die Aufgabenverteilung und führt die Ergebnisse zusammen | Teilt „Erstelle ein Blogsystem“ in mehrere Module auf und fasst sie zusammen |
| Subagent | Ein Agent, der eine delegierte Teilaufgabe übernimmt und einen eigenen Kontext hat | Implementiert gezielt das Kommentarmodul und schreibt passende Tests |
| Advisor | Führt Aufgaben nicht selbst aus, sondern gibt an wichtigen Punkten gezielte Empfehlungen | Fragt ein leistungsfähigeres Modell um Rat, wenn der Haupt-Agent nicht weiterkommt |
| Workflow | Organisiert die Reihenfolge der Aufgaben, die parallele Ausführung und die Übergabe von Ergebnissen | Ein mehrstufiger Ablauf: „Recherche → Implementierung → Prüfung → bei Ablehnung überarbeiten“ |
| Harness | Das übergeordnete System, das Modelle und Tools aufruft und die Ausführung verwaltet | Selbst geschriebener Orchestrierungscode oder eine gehostete Agent-Plattform |
Drei Kooperationsmuster für mehrere Agents
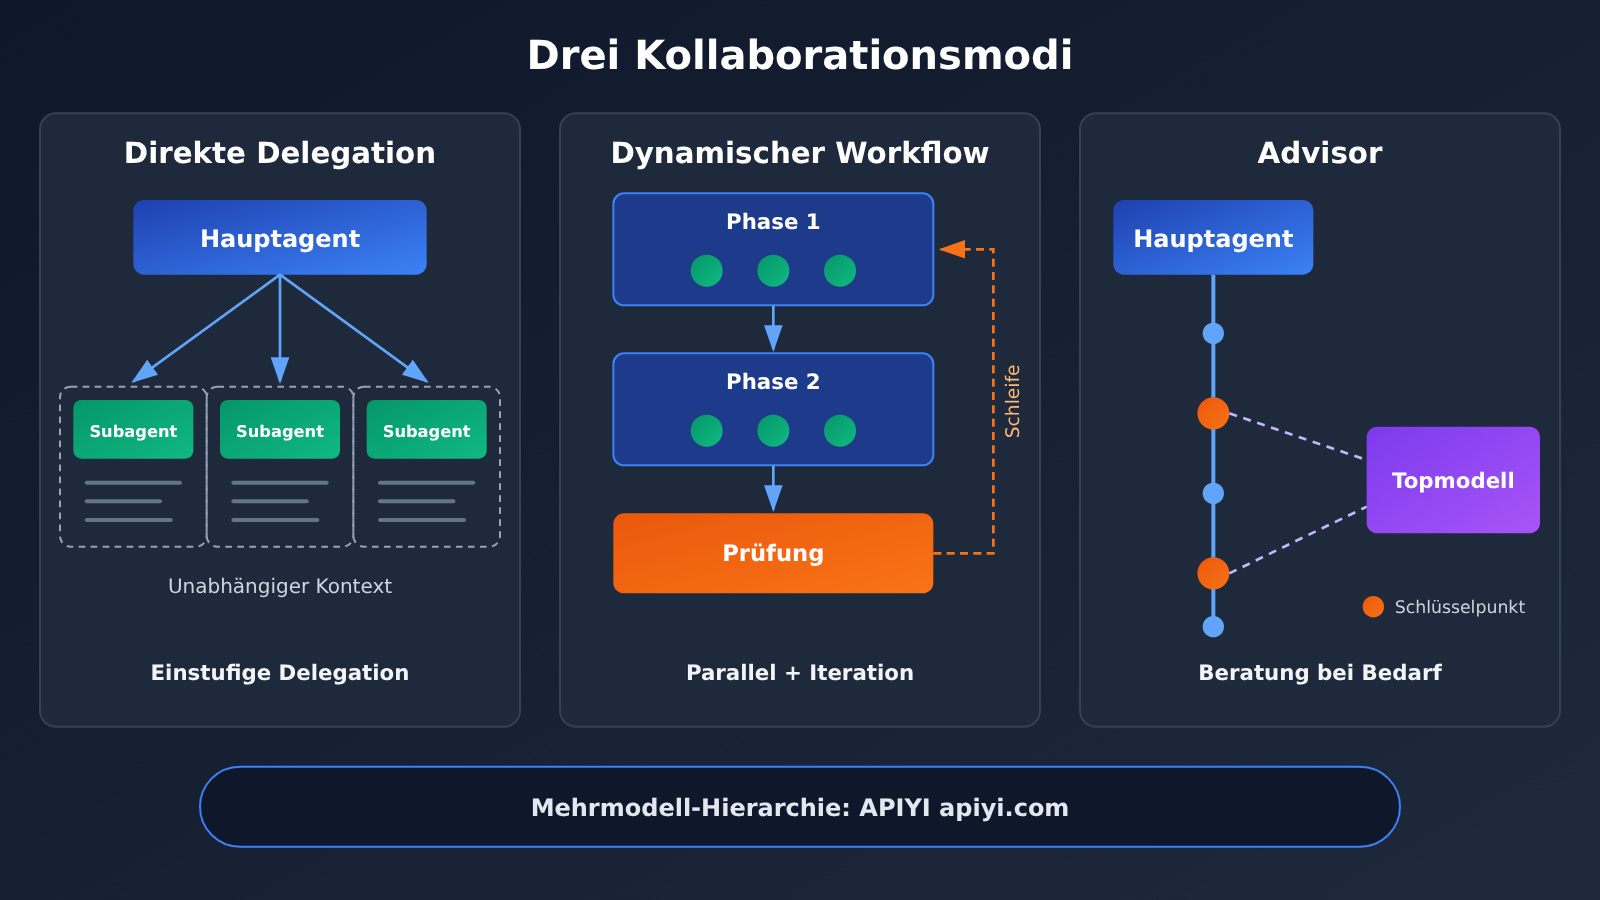
Die Dokumentation zu Anthropic Managed Agents unterscheidet drei Muster für die Zusammenarbeit mehrerer Agents, die sich jeweils für unterschiedliche Anwendungsfälle eignen.
- Direkte Delegation an Subagents: Der Haupt-Agent entscheidet selbst, welche Subagents erstellt werden, welche Aufgaben sie erhalten, wann ihre Ergebnisse abgerufen werden und ob Rückfragen nötig sind. Jeder Subagent hat einen eigenen Session Thread. Die Delegation ist jedoch auf eine Ebene beschränkt; pro Session sind höchstens 25 direkte Unter-Threads möglich. Das eignet sich für eine kleine Zahl spezialisierter Aufgaben, bei denen eine kontinuierliche Nachverfolgung erforderlich ist.
- Dynamische Workflows: Statt die Subagents einzeln zu verwalten, erzeugt der Haupt-Agent ein Workflow-Programm. Dieses kann Aufgaben in Phasen aufteilen, mehrere Agents parallel ausführen, Ergebnisse weitergeben und anhand der Resultate die nächste Phase auswählen. Wird eine Prüfung nicht bestanden, kann der Ablauf bis zum Erreichen der maximalen Anzahl an Durchläufen wiederholt werden. Das eignet sich für Aufgaben wie die Prüfung einer großen Zahl von Dateien oder die Migration von Code über mehrere Module hinweg.
- Advisor-Modus: Der Haupt-Agent führt die Aufgabe weiterhin selbst aus und konsultiert nur an schwierigen oder entscheidenden Punkten ein leistungsfähigeres Modell. So muss die Aufgabe nicht aufgeteilt werden, und der Koordinationsaufwand bleibt minimal.
Ein konkretes Beispiel macht den Unterschied deutlich. Angenommen, ein E-Commerce-Backend soll von Python nach Go migriert werden: Sollen nur die Zahlungs- und Lagermodule migriert werden, reicht die direkte Delegation aus. Müssen dagegen 200 unabhängige Schnittstellen migriert und einzeln geprüft werden, eignet sich ein dynamischer Workflow. Arbeitet nur ein Agent auf Ingenieurniveau an der Aufgabe und braucht gelegentlich ein Feedback von einem leistungsstärkeren Modell zum Entwurf der Datenbanktransaktionen, ist der Advisor-Modus die beste Wahl.
Wann sollte man Agents hinzufügen? Die richtige Methode zur Aufteilung von Aufgaben auf mehrere Agents
In einem Artikel vom 23. Januar 2026 mit dem Titel „Building multi-agent systems: When and how to use them“ beschreibt Anthropic ein Phänomen aus der Praxis: Manche Teams investieren Monate in den Aufbau komplexer Multi-Agent-Systeme und stellen am Ende fest, dass sich mit einer verbesserten Eingabeaufforderung für einen einzelnen Agent ein ähnliches Ergebnis erzielen lässt. Die erste Frage lautet daher immer: „Sollten wir die Aufgabe überhaupt aufteilen?“ – und nicht: „In wie viele Teile?“
Drei Szenarien, in denen mehrere Agents wirklich einen Mehrwert bieten
Laut dem Artikel gibt es vor allem drei Szenarien, in denen mehrere Agents verlässlich einen Mehrwert schaffen:
- Kontext isolieren: Ein Kundenservice-Agent liest beispielsweise zunächst eine große Menge an Bestellhistorien und soll anschließend ein technisches Problem diagnostizieren. Die Bestelldaten beanspruchen dann Kontext und können die Beurteilung beeinträchtigen. Übernimmt ein separater Agent die Bestellabfrage und gibt nur eine knappe Zusammenfassung zurück, kann sich der Haupt-Agent besser auf die eigentliche Aufgabe konzentrieren.
- Aufgaben parallel bearbeiten: Verschiedene regionale Märkte recherchieren, mehrere Dokumente parallel prüfen oder unterschiedliche Codemodule gleichzeitig untersuchen. Anthropic weist besonders darauf hin, dass solche Architekturen in erster Linie die Aufgabenabdeckung und Vollständigkeit verbessern – nicht unbedingt die Gesamtbearbeitungszeit verkürzen.
- Spezialisierte Aufgabenverteilung: Verschiedene Agents erhalten unterschiedliche System-Eingabeaufforderungen, Tools, MCP-Server, Skills und Modelle. So muss ein einzelner Agent nicht zu viele verschiedene Aufgaben gleichzeitig übernehmen.
Nach Kontextgrenzen aufteilen, nicht nach Rollen
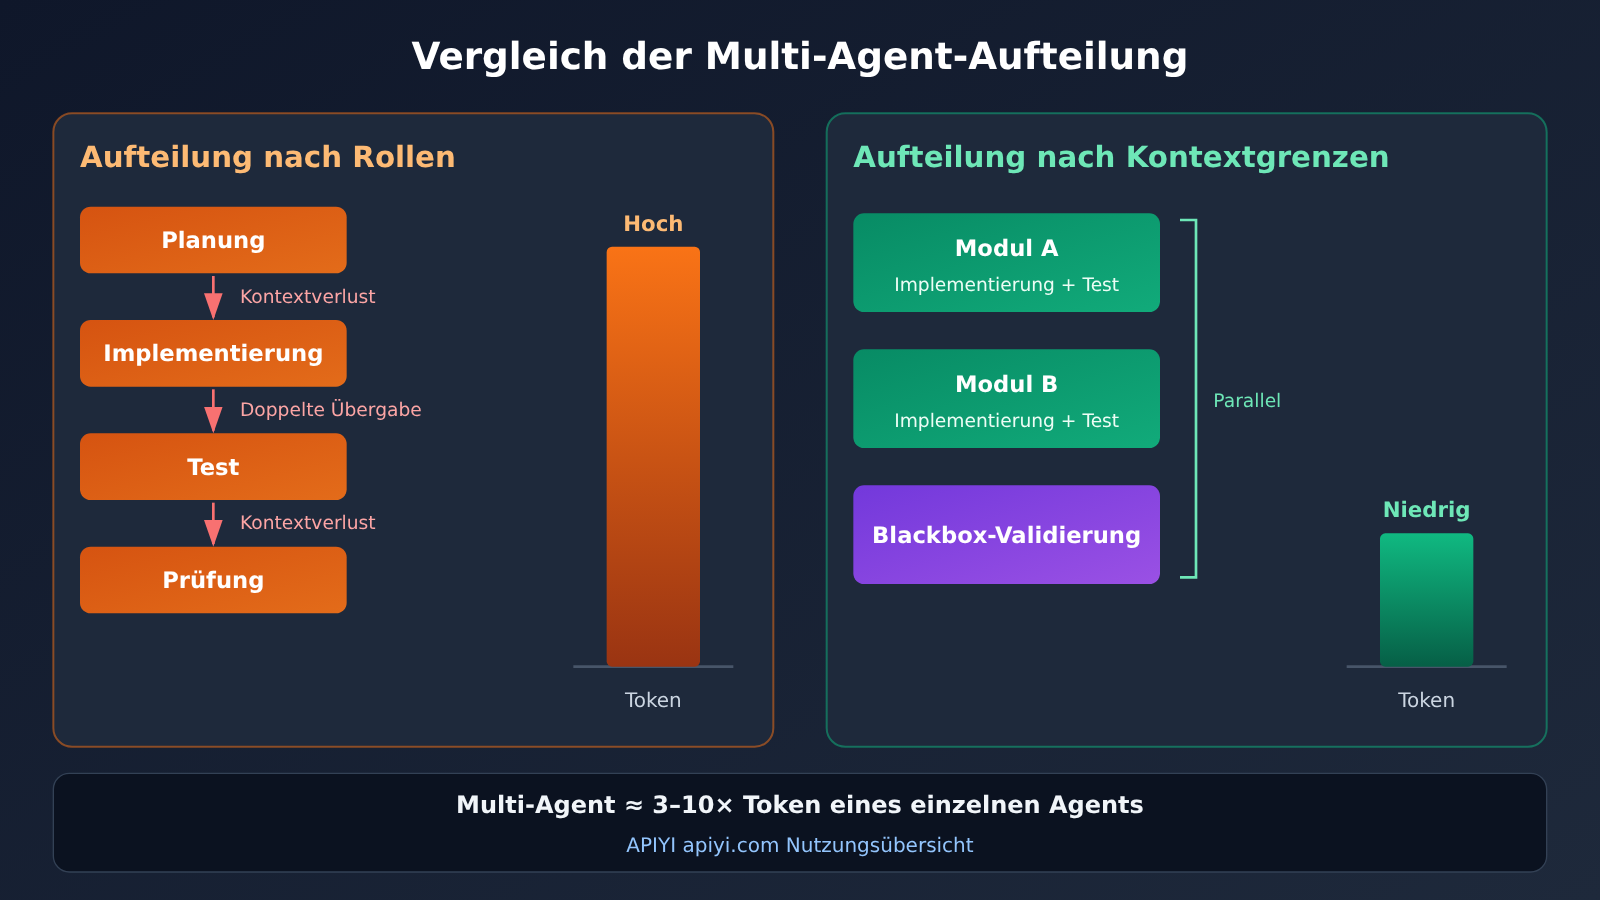
Anthropics Entwurfsprinzip heißt „Context-centric decomposition“: Aufgaben sollen nach Kontextgrenzen aufgeteilt werden, statt sie mechanisch in einzelne Arbeitsschritte zu zerlegen. Viele Teams denken zuerst an ein „Planungs-Agent + Coding-Agent + Test-Agent + Review-Agent“-Modell. Das sieht nach einem Entwicklungsteam mit klar verteilten Zuständigkeiten aus, hat in der Praxis aber erhebliche Nachteile.
Der Test-Agent weiß nicht, warum der Code auf diese Weise entworfen wurde, und der Review-Agent kennt den vorherigen Rechercheprozess nicht. Informationen müssen wiederholt zwischen den Agents weitergegeben werden und können dabei wie beim Stille-Post-Spiel verfälscht werden. Besser ist es, einen Agent für ein vollständiges Funktionsmodul einschließlich Implementierung und zugehöriger Tests verantwortlich zu machen. Ein weiterer Agent übernimmt ein Modul mit einer eigenständigen Schnittstelle. Ein dritter Agent führt ausschließlich eine Blackbox-Prüfung durch und erhält dafür das zu prüfende Ergebnis, klare Abnahmekriterien und Testwerkzeuge.
| Aufgabentyp | Eignung für mehrere Agents | Grund |
|---|---|---|
| Unabhängige Marktanalysen für mehrere Regionen | Hoch | Die Teilaufgaben haben kaum gemeinsame Informationen |
| Parallele Prüfung vieler Dokumente | Hoch | Jedes Dokument lässt sich unabhängig bearbeiten und anschließend zusammenfassen |
| Unabhängige Entwicklung verschiedener Module | Hoch | Bei klaren Schnittstellen ergeben sich natürliche Kontextgrenzen |
| Unabhängige Tests und Validierung | Hoch | Für eine Blackbox-Prüfung genügen das Ergebnis und die Kriterien |
| Änderungen an eng gekoppeltem Code | Eher gering | Eine Änderung zieht oft weitere nach sich; die Übergabekosten sind hoch |
| Aufgaben, bei denen viele Echtzeitinformationen geteilt werden müssen | Eher gering | Der Aufwand für die Synchronisierung kann den Nutzen der parallelen Bearbeitung übersteigen |
| Einfache Faktenabfragen | Meist nicht nötig | Ein einzelner Agent kann die Aufgabe mit einem Aufruf erledigen |
Zurück zum Betriebssystem-Experiment: Zwischen Kernel, Treibern, Dateisystem und Fenstersystem gibt es tatsächlich vergleichsweise klare Modulgrenzen. Das ist einer der Gründe, warum sich dieses Projekt besser für eine umfangreiche parallele Bearbeitung eignet als etwa ein großes Refactoring eines komplexen Geschäftssystems. Anthropic hat allerdings keine konkrete Aufgabenverteilung veröffentlicht. Das ist daher eine plausible Vermutung, aber keine belegte Tatsache.
Warum Multi-Agent-Systeme mehr kosten: die Token-Bilanz im Zeitalter von Claude Fable 5.2
Viele gehen intuitiv davon aus, dass sich die Kosten senken lassen, wenn eine Aufgabe auf mehrere parallel arbeitende Agenten verteilt wird. In der Praxis ist oft das Gegenteil der Fall. Anthropic weist in einem Artikel vom Januar 2026 ausdrücklich darauf hin: Bei derselben Aufgabe verbrauchen Multi-Agent-Architekturen in der Regel drei- bis zehnmal so viele Token wie ein einzelner Agent.
Die zusätzlichen Token entstehen hauptsächlich an fünf Stellen: Jeder Agent muss seinen eigenen Kontext aufbauen. Die Agenten müssen Aufgabenbeschreibungen und Ergebnisse austauschen. Der Hauptagent muss die Ausgaben mehrerer Subagenten lesen und zusammenfassen. Die Aufteilung der Aufgabe verursacht zusätzliche Aufrufe. Außerdem kann es passieren, dass mehrere Agenten dieselbe Arbeit erledigen.
Zwei Kostenangaben mit unterschiedlichen Vergleichsbasen
Bei Diskussionen über die Kosten von Multi-Agent-Systemen werden häufig Daten aus unterschiedlichen Quellen vermischt. Die folgende Tabelle ordnet sie getrennt ein:
| Datenquelle | Kennzahl | Vergleichsbasis |
|---|---|---|
| „Building multi-agent systems“, Januar 2026 | Multi-Agent-Systeme verbrauchen drei- bis zehnmal so viele Token wie ein einzelner Agent | Einzelner Agent bei derselben Aufgabe |
| Anthropic Research-System, Juni 2025 | Token-Verbrauch etwa 15-mal so hoch wie bei gewöhnlichen Chats | Gewöhnliche Chats |
| Anthropic Research-System, Juni 2025 | Das interne Research Eval lag beim Token-Verbrauch 90,2 % über einem einzelnen Opus 4 | Einzelner Opus 4, spezifischer interner Test |
| Anthropic Research-System, Juni 2025 | Die Recherchezeit bei komplexen Anfragen verkürzte sich um bis zu etwa 90 %; in frühen typischen Szenarien wurden parallel drei bis fünf Subagenten eingesetzt | Recherche mit demselben System in einem einzelnen Thread |
Wichtig ist: Die Werte von 90,2 % und dem 15-fachen Token-Verbrauch stammen beide aus dem Research-System von 2025. Die 90,2 % beziehen sich lediglich auf die relative Leistung in einem bestimmten internen Test und bedeuten nicht, dass die Genauigkeit bei allen Aufgaben um 90,2 % steigt. Die Werte stehen in keinem Zusammenhang mit den Experimenten zum Betriebssystem von 2026 und lassen sich nicht direkt mit dem Faktor von drei bis zehn vergleichen.
Gesamtberechnungsaufwand, Ausführungszeit und Abdeckung sind drei verschiedene Dinge
Um die Kosten mehrerer Agents zu verstehen, müssen drei Kennzahlen unterschieden werden. Der Gesamtberechnungsaufwand steigt in der Regel, weil Kontext kopiert und Ergebnisse wiederholt gelesen werden. Die Ausführungszeit kann sich verkürzen, sofern die Teilaufgaben tatsächlich unabhängig voneinander sind. Die Aufgabenabdeckung nimmt oft zu, da mehrere Agents gleichzeitig mehr Ansätze erkunden können.
Laut den offiziellen API-Preisen kostet Fable 5.2 im Standardmodus 8 US-Dollar pro Million Eingabe-Token und 40 US-Dollar pro Million Ausgabe-Token. Über die Batch API gibt es 50 % Rabatt; das Lesen aus dem Cache kostet 0,20 US-Dollar pro MTok. Wenn eine Aufgabe mit einem einzelnen Agent bereits eine beträchtliche Zahl an Token verbraucht, fällt der Unterschied bei einer Steigerung um das Drei- bis Zehnfache deutlich ins Gewicht. Anthropic hat keine tatsächlichen Kosten für das Betriebssystem-Experiment veröffentlicht. Aussagen wie „Wie viel haben die acht Tage gekostet?“ entbehren daher jeder Grundlage.
So entwerfen Sie zuverlässige Multi-Agent-Systeme: technische Erkenntnisse aus Claude Fable 5.2
Modellhierarchie: Nicht jeder Agent braucht das stärkste Modell
Managed Agents unterstützen zwei Arten von Agent-Definitionen. Predefined Agents werden im Voraus konfiguriert und können ein eigenes Modell, einen eigenen System-Prompt, eigene Tools, MCP-Server und Skills haben. Inline Agents werden während der Ausführung dynamisch definiert und übernehmen standardmäßig die Modell- und Tool-Konfiguration des Haupt-Agenten.
So lässt sich ein ausgewogenes Verhältnis zwischen Kosten und Fähigkeiten erreichen: Für die Koordination und komplexe Prüfungen kommen starke Modelle wie Fable 5.2 zum Einsatz, für gewöhnliche Recherchen Modelle der Sonnet-Klasse und für einfache Klassifizierungen Modelle der Haiku-Klasse. Das ist nur ein mögliches Designbeispiel, keine von Anthropic vorgeschriebene Architektur. Die Konfiguration sollte anhand der tatsächlichen Aufgaben getestet und angepasst werden.
Verifizierung: Ein Reviewer-Agent ist kein echter Nachweis
Anthropic erwähnt in der Prompting-Dokumentation zu Fable 5.2 eine Neuerung: Bei höheren Effort-Einstellungen wie xhigh und max ruft Fable 5.2 aktiv einen Subagent auf, der die eigene Arbeit überprüft. Bei Fable 5.1 war dieses Verhalten in denselben Testaufgaben nicht zu beobachten. Das ist ein Fortschritt bei der Orchestrierung, sollte aber nicht mit Qualitätssicherung verwechselt werden.
Ein Reviewer-Agent stützt sich letztlich weiterhin auf das Urteil eines Modells. Eine verlässliche Verifizierung braucht drei Dinge: klar formulierte Abnahmekriterien, ausführbare Blackbox-Tests und eine echte Prüfung der Änderungen an Code und externen Systemen – etwa indem Tests tatsächlich ausgeführt und Dienste wirklich gestartet werden. Das überzeugendste Ergebnis des Betriebssystem-Experiments war gerade der harte Nachweis, dass sich das System auf einem echten Laptop starten ließ, und nicht die Aussage eines Agents, dass „alles in Ordnung zu sein scheint“.
Übermäßige Delegation und Regelanhäufung vermeiden
Ob ein Agent Aufgaben delegiert, hängt nicht nur von den Fähigkeiten des Modells ab, sondern auch vom Harness und den Tool-Beschreibungen. Anthropic stellte in Tests fest: Wenn die Beschreibung des Subagent-Tools die zusätzlichen Kosten pro Subagent, sinnvolle und weniger sinnvolle Delegationsfälle sowie die richtige Aufgabenbeschreibung erläutert, delegiert das Modell bei kurzen Aufgaben etwa ein Drittel seltener als bei einer Version, die lediglich die Gründe für eine Delegation hervorhebt. Die Erfolgsquote der Aufgaben bleibt dabei unverändert.
Ein weiteres leicht übersehenes Problem ist die Anhäufung von Regeln. Fable 5.2 hält sich recht strikt an einschränkende Anweisungen, die sich im Kontext angesammelt haben. Wenn Verlaufsdateien, Reviewer-Feedback und System-Prompts immer mehr Verbote enthalten, kann es passieren, dass das Modell bei der täglichen Arbeit auch erlaubte Aktionen nicht mehr ausführt. Deshalb sollten Sie das Gedächtnis, die Regeln und die Genehmigungsanforderungen des Agents regelmäßig aufräumen.
Laufzeitbeschränkungen: die tatsächlichen Grenzen öffentlicher Produkte
Auch bei öffentlichen Produkten ist die Zahl von „1000 Agenten“ klar begrenzt. Die folgenden Limits stammen aus der Dokumentation zu Managed Agents. Sie gelten für das öffentliche Produkt und bedeuten nicht, dass in den Experimenten mit dem internen Betriebssystem derselbe Scheduler verwendet wurde:
| Kennzahl | Limit |
|---|---|
| Direkte Subagent-Threads | Höchstens 25 |
| Gleichzeitig aktive Threads in einem Dynamic Workflow | 64 |
| Innerhalb eines Workflow-Lebenszyklus gestartete Agenten | 1000 |
| Standardlebensdauer eines Workflows | 24 Stunden |
| Gleichzeitig geöffnete Workflows pro Session (Standard) | 10 |
Außerdem können Agenten innerhalb eines Workflows keine verschachtelten Workflows erstellen. Ist das Budget aufgebraucht, wird der laufende Workflow angehalten. Wenn ein Agent fehlschlägt, versucht das System es üblicherweise noch einmal. Scheitert auch dieser Versuch, entscheidet der Workflow, wie es weitergeht. Anders gesagt: Die 1000 Agenten sind die Gesamtzahl der „innerhalb eines Lebenszyklus gestarteten“ Agenten – gleichzeitig aktiv sind deutlich weniger.
Bei langen Laufzeiten gibt es noch ein Problem mit der Nutzererfahrung: Fable 5.2 gibt während langer Tool-Aufrufe unter Umständen nur wenige Texte für Nutzer aus. Dadurch kann der Eindruck entstehen, die Aufgabe sei hängen geblieben. Empfohlen wird, thinking.display: "updates" zu aktivieren oder den Harness das Modell nach mehreren aufeinanderfolgenden Tool-Aufrufen an eine Fortschrittsmeldung erinnern zu lassen. In offiziellen Tests halbierte sich die längste Phase ohne Rückmeldung durch solche Erinnerungen ungefähr.
Schnellstart für mehrere Agents: Mit Claude Fable 5.2 einen minimalen Orchestrator bauen
Das folgende Beispiel kommt ohne gehostete Plattform aus und zeigt über eine OpenAI-kompatible Schnittstelle den grundlegendsten Schritt: Ein Koordinationsmodell teilt eine Aufgabe anhand von Kontextgrenzen in Teilaufgaben auf.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible Schnittstelle von APIYI
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",  # Maßgeblich ist der tatsächliche Name in der Modellliste der Plattform
    messages=[{"role": "user", "content": "把“为博客增加评论功能”按上下文边界拆成子任务,每个子任务包含实现和测试,输出 JSON"}]
)
print(resp.choices[0].message.content)
Die vollständige Version ergänzt eine Modellhierarchie, parallele Ausführung, ein Token-Budget, einen einmaligen Wiederholungsversuch bei Fehlern und eine Blackbox-Abnahme. Ihr Aufbau entspricht der zuvor beschriebenen Vorgehensweise für die Entwicklung:
Vollständigen Beispielcode für die Multi-Agent-Orchestrierung anzeigen
import json
from concurrent.futures import ThreadPoolExecutor
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Mit einem Schlüssel mehrere Modelle aufrufen
)

ORCHESTRATOR_MODEL = "claude-fable-5-2"   # Leistungsstarkes Modell für Koordination und Prüfung
WORKER_MODEL = "your-fast-model"          # Schnelleres und günstigeres Modell für Teilaufgaben, bei Bedarf ersetzen
TOKEN_BUDGET = 200_000                     # Token-Budget für die gesamte Aufgabe
used_tokens = 0


def call(model, system, user):
    global used_tokens
    if used_tokens >= TOKEN_BUDGET:
        raise RuntimeError("超出预算,暂停工作流")
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "system", "content": system},
                  {"role": "user", "content": user}],
    )
    used_tokens += r.usage.total_tokens
    return r.choices[0].message.content


def plan(goal):
    text = call(ORCHESTRATOR_MODEL,
                "你是协调者。按上下文边界拆分任务,简单任务不要拆。"
                "只输出 JSON 数组,每项含 name、spec、acceptance 字段。",
                goal)
    return json.loads(text)


def run_subagent(task):
    # Jeder Sub-Agent erhält nur den Kontext, den er benötigt; bei einem Fehler wird es einmal erneut versucht
    for _ in range(2):
        try:
            return call(WORKER_MODEL,
                        "你负责一个完整模块,同时给出实现和测试。",
                        f"任务:{task['spec']}\n验收标准:{task['acceptance']}")
        except Exception:
            continue
    return "FAILED"


def review(task, output):
    # Blackbox-Abnahme: Nur Ergebnis und Kriterien werden bereitgestellt, nicht der Erkundungsprozess
    return call(ORCHESTRATOR_MODEL,
                "你是审核者,只依据验收标准判断,输出 PASS 或 FAIL 及理由。",
                f"验收标准:{task['acceptance']}\n成果:{output}")


if __name__ == "__main__":
    tasks = plan("为博客系统增加评论功能,含后端接口与前端组件")
    with ThreadPoolExecutor(max_workers=4) as pool:  # Parallelität begrenzen
        outputs = list(pool.map(run_subagent, tasks))
    for t, o in zip(tasks, outputs):
        print(t["name"], "->", review(t, o)[:80])
    print("累计 Token:", used_tokens)
Der Code dient nur zur Veranschaulichung der Struktur. Die Prüfung beruht weiterhin auf einer Einschätzung des Modells. In einer Produktionsumgebung sollte review durch echte Testausführungen ersetzt oder ergänzt werden, etwa durch das Ausführen von Unit-Tests oder durch Schnittstellenprüfungen nach dem Start des Dienstes.
🚀 Empfehlung für den schnellen Einstieg: Entscheidend bei mehreren Agents ist, dass unterschiedliche Rollen verschiedene Modelle nutzen und sich die Kosten jederzeit vergleichen lassen. Über APIYI apiyi.com können Sie Claude, OpenAI, Gemini und weitere Modelle mit einem einzigen API-Schlüssel anbinden. Testen Sie zunächst mit dem kostenlosen Testkontingent für neue Nutzer eine Basisversion mit nur einem Agent. Anschließend können Sie die Zusammenarbeit schrittweise erweitern.
Auswirkungen der Zusammenarbeit mehrerer Agents auf Entwickler
Auswirkungen auf Entwickler
- Mit einem einzelnen Agent beginnen: Erstellen Sie zunächst mit einem einzelnen Agent und einer guten Eingabeaufforderung eine Basisversion. Fügen Sie erst dann eine Zusammenarbeitsebene hinzu, wenn einer dieser Engpässe auftritt: Der Kontext wird verunreinigt, Teilaufgaben lassen sich unabhängig voneinander parallelisieren oder es werden spezialisierte Konfigurationen benötigt.
- Infrastruktur als zentrale Komponente betrachten: Modell-APIs, Tool-APIs, Budgetlimits, Parallelitätssteuerung und Aufrufprotokolle entscheiden darüber, ob ein Multi-Agent-System zuverlässig läuft. Ohne Protokolle lässt sich nicht feststellen, welcher Sub-Agent Arbeit wiederholt.
- Die Aufgabenteilung zwischen mehreren Modellen wird zum Standard: Koordinator, Ausführende und Prüfer mit unterschiedlichen Modellen auszustatten, ist eine der wichtigsten Möglichkeiten, eine drei- bis zehnfache Kostensteigerung einzudämmen.
Auswirkungen auf die Branche
- Die Grenzen der KI-Fähigkeiten verschieben sich: Statt „eine Programmieraufgabe zu erledigen“ geht es zunehmend darum, „ein langfristiges Softwareentwicklungsprojekt zu organisieren“. Auch das Feedback früher Testpartner wie Vercel, Shopify und Datadog weist in diese Richtung. Ein Datadog-Ingenieur beschrieb das System beispielsweise als „Einsatzleiter“, der Aufgaben an schnellere Modelle delegieren kann. Dabei ist zu beachten, dass es sich um zum Zeitpunkt der Veröffentlichung bekannt gegebene Rückmeldungen von Partnern handelt, nicht um einen unabhängigen Blindtest.
- Die Orchestrierung ist wichtiger als die Anzahl der Agents: Der tatsächliche Effizienzgewinn durch mehrere Agents hängt gemeinsam davon ab, wie gut sich Aufgaben parallelisieren lassen, wie hoch der Koordinationsaufwand ist, wie der gemeinsame Zustand verwaltet wird, welche Codekonflikte auftreten, wie hoch die Testabdeckung ist und welche Kosten die Aufrufe verursachen.
Häufige Fragen (FAQ)
F1: Was hat das Experiment mit 1.000 Agents in Claude Fable 5.2 tatsächlich hervorgebracht?
Anthropic zufolge koordinierte Fable 5.2 ausgehend von einem leeren Ordner mehr als 1.000 Sub-Agents, die acht Tage lang kontinuierlich arbeiteten. Das Ergebnis war ein Betriebssystemprototyp, der sich auf einem echten Laptop starten lässt und einen Kernel, Treiber, Dateispeicher, ein Fenstersystem, eine Anmeldeoberfläche und ein Installationsprogramm umfasst. Offiziell wird er als „funktionsfähiger Prototyp“ bezeichnet. Quellcode, Codeumfang, Gesamtzahl der Tokens und Kosten wurden nicht veröffentlicht; ein unabhängiges Audit gab es ebenfalls nicht.
F2: Sind Multi-Agent-Systeme immer besser als einzelne Agents?
Nein. Anthropic betont ausdrücklich, dass Multi-Agent-Systeme nicht immer einem einzelnen Agent überlegen sind. Ein Team investierte mehrere Monate in den Aufbau eines Multi-Agent-Systems und stellte schließlich fest, dass die Optimierung des Prompts für einen einzelnen Agent ein ähnliches Ergebnis lieferte. Bei derselben Aufgabe verbrauchen Multi-Agent-Systeme in der Regel drei- bis zehnmal so viele Tokens wie ein einzelner Agent. Ein stabiler Mehrwert zeigt sich vor allem in drei Szenarien: bei der Kontextisolierung, der parallelen Verarbeitung und der spezialisierten Aufgabenverteilung.
F3: Lassen sich die Leistungssteigerung von 90,2 % und der 15-fache Token-Verbrauch zur Bewertung von Fable 5.2 heranziehen?
Nein. Beide Zahlen stammen aus dem Anthropic-Research-System, das im Juni 2025 veröffentlicht wurde: Die 90,2 % beziehen sich auf die Leistung bei einer bestimmten internen Research-Eval im Vergleich zu einem einzelnen Agent mit Opus 4. Der Vergleichswert für den 15-fachen Token-Verbrauch war ein gewöhnlicher Chat. Diese Werte haben nichts mit dem Betriebssystemexperiment von Fable 5.2 aus dem Jahr 2026 zu tun und dürfen auch nicht mit den Angaben zum drei- bis zehnfachen Verbrauch bei derselben Aufgabe vermischt werden.
F4: Wie kann ich schnell einen eigenen Multi-Agent-Prototyp über eine API erstellen?
Empfohlenes Vorgehen:
1. Registrieren Sie sich bei APIYI unter apiyi.com und besorgen Sie sich einen API-Schlüssel sowie ein kostenloses Testkontingent.
2. Setzen Sie `base_url` im Code dieses Artikels auf `https://api.apiyi.com/v1`.
3. Führen Sie zunächst eine Basisversion mit einem einzelnen Agent aus und erfassen Sie Token-Verbrauch und Erfolgsquote.
4. Weisen Sie anschließend dem Koordinator und den Sub-Agents unterschiedliche Modelle zu und vergleichen Sie Kosten und Qualität.
F5: Wie lassen sich die Kosten eines Multi-Agent-Systems kontrollieren?
Entscheidend sind vier Punkte: Teilen Sie Aufgaben entlang der Kontextgrenzen auf, um den Informationsaustausch zu reduzieren. Nutzen Sie für Teilaufgaben schnellere und günstigere Modelle und setzen Sie leistungsstärkere Modelle nur für die Planung und wichtige Prüfungen ein. Erläutern Sie in den Tool-Beschreibungen die Kosten einer Delegation und welche Aufgaben sich nicht dafür eignen, damit nicht zu viel delegiert wird. Legen Sie außerdem ein globales Token-Budget und eine Obergrenze für die Parallelität fest. Für gebündelte Offline-Aufgaben bietet sich der Rabatt der Batch API an. Bei alltäglichen Aufrufen helfen außerdem die nutzungsbasierte Abrechnung und die Verbrauchsstatistiken von APIYI unter apiyi.com bei der genauen Kostenkontrolle.
F6: Welche bekannten Einschränkungen haben Multi-Agent-Systeme derzeit?
Erstens die Kosten: Bei derselben Aufgabe steigt der Token-Verbrauch in der Regel um das Drei- bis Zehnfache. Zweitens die Grenzen der Orchestrierung: Bei den öffentlich verfügbaren Managed Agents sind höchstens 25 direkte untergeordnete Threads möglich, bei Workflows arbeiten gleichzeitig höchstens 64 Threads, und während der gesamten Laufzeit können insgesamt höchstens 1.000 Threads gestartet werden. Drittens die Verifikation: Ein prüfender Agent ersetzt keine echten Tests. Viertens gibt es Probleme wie die Anhäufung von Regeln und lange Phasen ohne Rückmeldung. Deshalb sollten Regeln regelmäßig bereinigt und Fortschrittsmeldungen aktiviert werden.
Zentrale Erkenntnisse zur Zusammenarbeit mehrerer Agenten mit Claude Fable 5.2
- Mehr Agenten bedeuten nicht automatisch mehr Effizienz: Der Wert von 1.000 Agenten liegt in der Fähigkeit, sie zu organisieren – nicht in ihrer bloßen Anzahl.
- Rollen klar definieren: Der Orchestrator koordiniert, Subagents führen Aufgaben aus, Advisors geben Empfehlungen und Workflows steuern Abläufe.
- Auf Grundlage von Kontextgrenzen aufteilen: Ein Agent sollte ein vollständiges Modul samt Tests verantworten. So vermeidet man Informationsverluste durch die Weitergabe zwischen verschiedenen Rollen.
- Kosten im Blick behalten: Bei derselben Aufgabe verbraucht ein System mit mehreren Agenten in der Regel drei- bis zehnmal so viele Tokens wie ein einzelner Agent.
- Ergebnisse konsequent überprüfen: Neben einem Review-Agenten braucht es klare Abnahmekriterien und Tests unter realen Bedingungen.
- Mit einem einzelnen Agenten beginnen: Ergänzen Sie erst dann eine Zusammenarbeitsschicht, wenn ein tatsächlicher Engpass auftritt. Über den Zugang zu mehreren Modellen per APIYI unter apiyi.com können Sie verschiedene Aufteilungen testen.
Zusammenfassung
Das Betriebssystem-Experiment mit Claude Fable 5.2 liefert folgende Erkenntnisse:
- Orchestrierung wird zur neuen Schlüsselkompetenz: Fable 5.2 eignet sich zunehmend als Koordinator. Dazu gehört auch, bei hohem Effort eigenständig Subagents einzusetzen, die die eigene Arbeit überprüfen.
- Der Einsatz mehrerer Agenten hat klare Grenzen: Aufgaben mit isolierbarem Kontext, paralleler Verarbeitung oder Spezialisierung lassen sich sinnvoll aufteilen. Eng gekoppelte Aufgaben und einfache Abfragen hingegen nicht.
- Kosten, Parallelität und Validierung setzen enge Grenzen: Der zusätzliche Token-Verbrauch, die Beschränkungen bei der Ausführung und Tests unter realen Bedingungen entscheiden darüber, ob ein System langfristig betrieben werden kann.
Für die meisten Entwickler ist es sinnvoll, zunächst mit einem einzelnen Agenten eine Ausgangsbasis zu schaffen. Anschließend können sie je nach tatsächlichem Engpass Subagents, Workflows oder Advisors einführen. Gleichzeitig sollten sie die Grundlagen rund um Modell-APIs, Budgets, Parallelität und Protokollierung solide umsetzen. Die API-Infrastruktur bildet schließlich das Fundament jeder Anwendung mit mehreren Agenten.
Mit APIYI unter apiyi.com können Sie Ihre Lösung mit mehreren Agenten schnell testen. Die Plattform bietet eine einheitliche, OpenAI-kompatible Schnittstelle und ein kostenloses Testkontingent für neue Nutzer. So lässt sich die Aufgabenverteilung zwischen verschiedenen Modellen vergleichen.
📚 Quellen
- Offizielle Ankündigung von Anthropic: Claude Fable 5.2 and Mythos 5.2 (2026-11-09)
- Link:
anthropic.com/claude-fable-and-mythos-5-2 -
Hinweis: Primärquelle zu Betriebssystem-Experimenten, Programmier-Benchmarks und Preisen
-
Building multi-agent systems: When and how to use them: Einsatzszenarien und Kosten von Multi-Agent-Systemen (2026-01-23)
- Link:
claude.com/resources/articles/building-multi-agent-systems-when-and-how-to-use-them -
Hinweis: Angaben zum 3- bis 10-fachen Token-Verbrauch und zum Prinzip, Aufgaben entlang von Kontextgrenzen aufzuteilen
-
How we built our multi-agent research system: Das Anthropic-Research-System (2025-06-13)
- Link:
anthropic.com/research/multi-agent-research-system -
Hinweis: Orchestrator-Worker-Architektur, 90,2 % in internen Evaluationen und Angaben zum 15-fachen Token-Verbrauch
-
Dokumentation zu Managed Agents, Multi-Agent-Orchestrierung und Workflows: Kooperationsmuster und Laufzeitbeschränkungen
- Link:
platform.claude.com/docs/en/managed-agents/multiagent-orchestration -
Hinweis: Definitionen von Subagents, Dynamic Workflows und Advisor sowie Obergrenzen für die Parallelität
-
Prompting Claude Fable 5.2: Offizieller Leitfaden zum Prompt Engineering
- Link:
platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-fable-5-2 -
Hinweis: Selbstüberprüfung, Experimente zur übermäßigen Delegation und Empfehlungen zur Fortschrittsmeldung
-
Modellspezifikation für Fable 5.2: Kontextfenster, Ausgabelimit und Abrechnung
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview - Hinweis: Kontextfenster mit 1M, maximale Ausgabe von 128K und API-Model-ID
Autor: Technisches Team von APIYI
Technischer Austausch: Besuchen Sie die APIYI-Startseite unter apiyi.com und kontaktieren Sie uns, um sich über Multi-Agent-Architekturen und die Anbindung mehrerer Modelle auszutauschen.


