
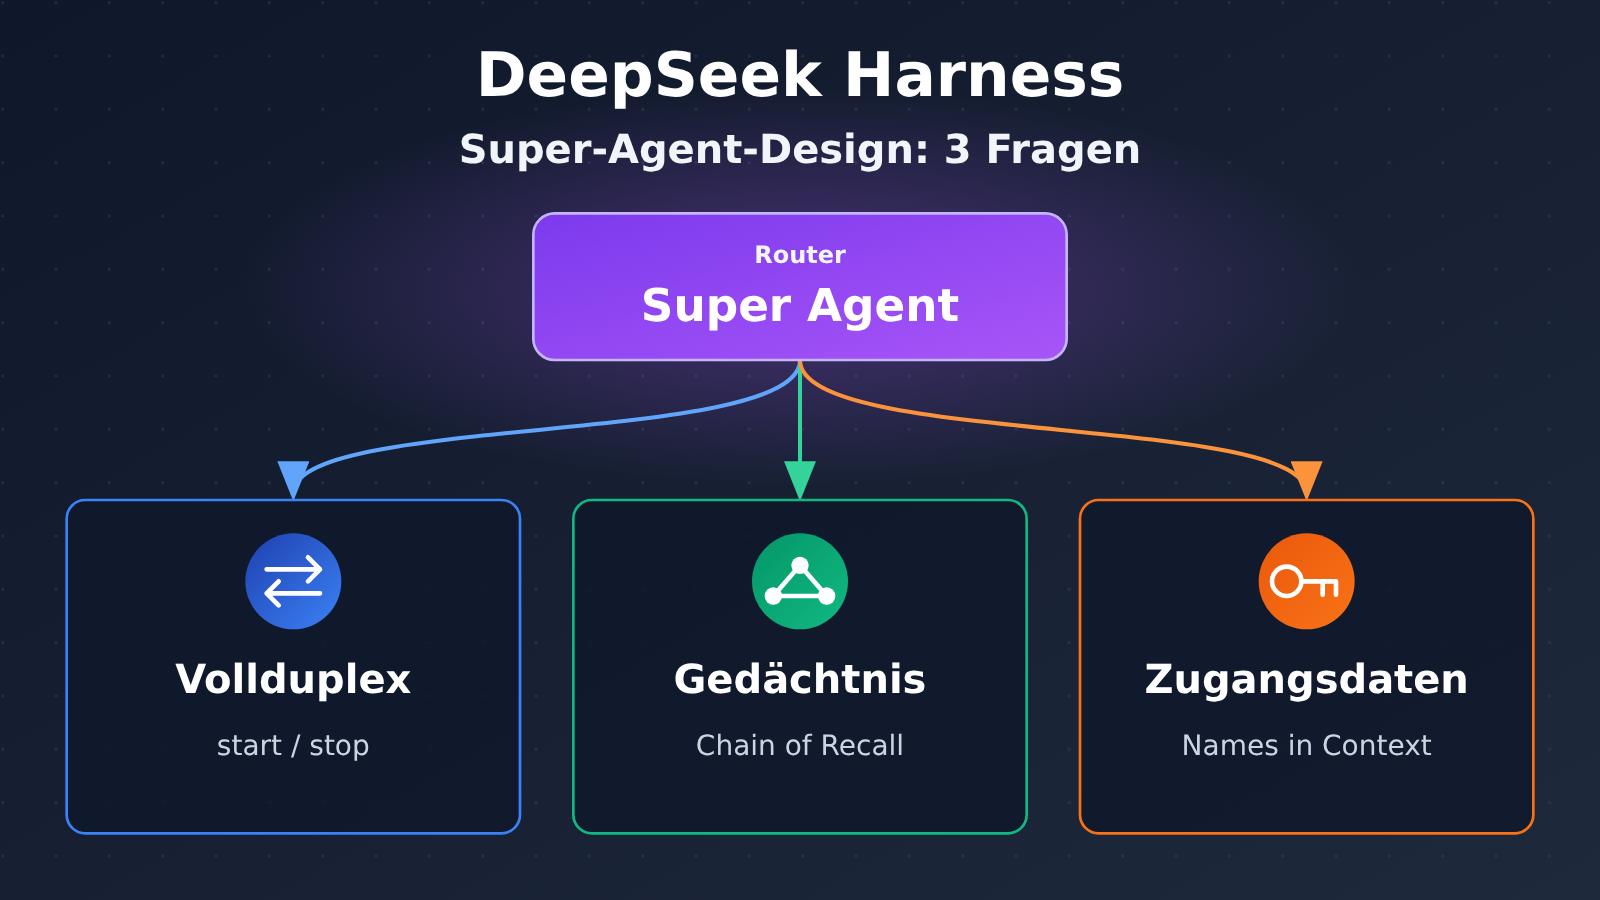
Anmerkung des Autors: Dieser Beitrag beleuchtet drei Designfragen aus DeepSeek Harness „Exploring Super-agent Design“: Vollduplex, Gedächtnis und Zugangsdaten. Er zeigt, welche Ansätze sich schon heute übernehmen lassen, welche noch offene Fragen sind, und liefert Schnittstellenverträge sowie eine Checkliste für die Umsetzung.
Ein Agent, der lange läuft, stößt oft gleichzeitig auf drei Probleme: Während eines sechsminütigen Testlaufs müssen neue Fragen des Nutzers warten. Der Kontext von gestern wird durch heutige Ereignisse aus dem Kontextfenster verdrängt. Und beim Debuggen öffnet der Agent nebenbei die Datei .env – schon stehen die Schlüssel im Gesprächsverlauf. Am 2026-11-01 veröffentlichte das DeepSeek-Harness-Team den ausführlichen Designbeitrag „Exploring Super-agent Design“ und fasste diese drei Probleme als Vollduplex (Full-Duplex), Gedächtnis (Chain of Recall) und „Zugangsdaten verwenden, ohne sie zu sehen“ zusammen.
Dies ist keine Analyse einer Produktveröffentlichung. Der Originalbeitrag beschreibt eine Architektur, keinen Schalter, den man einfach umlegen kann: Vollduplex ist in DeepSeek Harness bereits implementiert, aber standardmäßig deaktiviert. Teile davon befinden sich im Prototyp-Plugin dsh-superagent-prototype, das laut Autor ausdrücklich „kein offizielles Produkt von DeepSeek“ ist. Auch das Langzeitgedächtnis und der Umgang mit Zugangsdaten werden im Original als offene Fragen aufgeführt.
Der Kernnutzen: Nach der Lektüre wissen Sie, welche Ansätze sich für diese drei Designfragen übernehmen lassen, welche Verträge die jeweiligen APIs erfüllen müssen und welchen Schritt Sie in Ihrem eigenen Agent-Projekt zuerst angehen sollten.
DeepSeek Harness: Die wichtigsten Designprinzipien des Super-Agents
Die folgende Tabelle zeigt, wie der Originaltext die drei Designfragen einordnet und welche Ansätze sich schon heute übernehmen lassen.
| Designfrage | Kerngedanke im Original | Status im Original | Direkt übernehmbare Ansätze |
|---|---|---|---|
| Vollduplex | Das blockierende run() wird in start() und stop() aufgeteilt, sodass der Agent auch während der Arbeit Anweisungen empfangen kann |
Implementiert, aber standardmässig deaktiviert | Asynchrone Tool-Verträge, Rückführung von Ereignissen, Stapelverarbeitung |
| Gedächtnis | Der Kontext enthält nur stabile IDs, kurze Zusammenfassungen und benachbarte Nachrichten. Übrige Inhalte werden ausgelagert und über Zeiger referenziert; ID-Verknüpfungen ermöglichen den mehrstufigen Abruf | Langzeitgedächtnis als offene Frage aufgeführt | Stabile IDs, Inline/S spill, gezielter Abruf per ID |
| Zugangsdaten | Der Agent soll Zugangsdaten nutzen können, ohne dass diese in seinen Kontext gelangen | Als offene Frage aufgeführt | Engineering-Muster, bei denen Namen im Kontext stehen und Werte extern bleiben |
Gesamtarchitektur des DeepSeek-Harness-Super-Agents
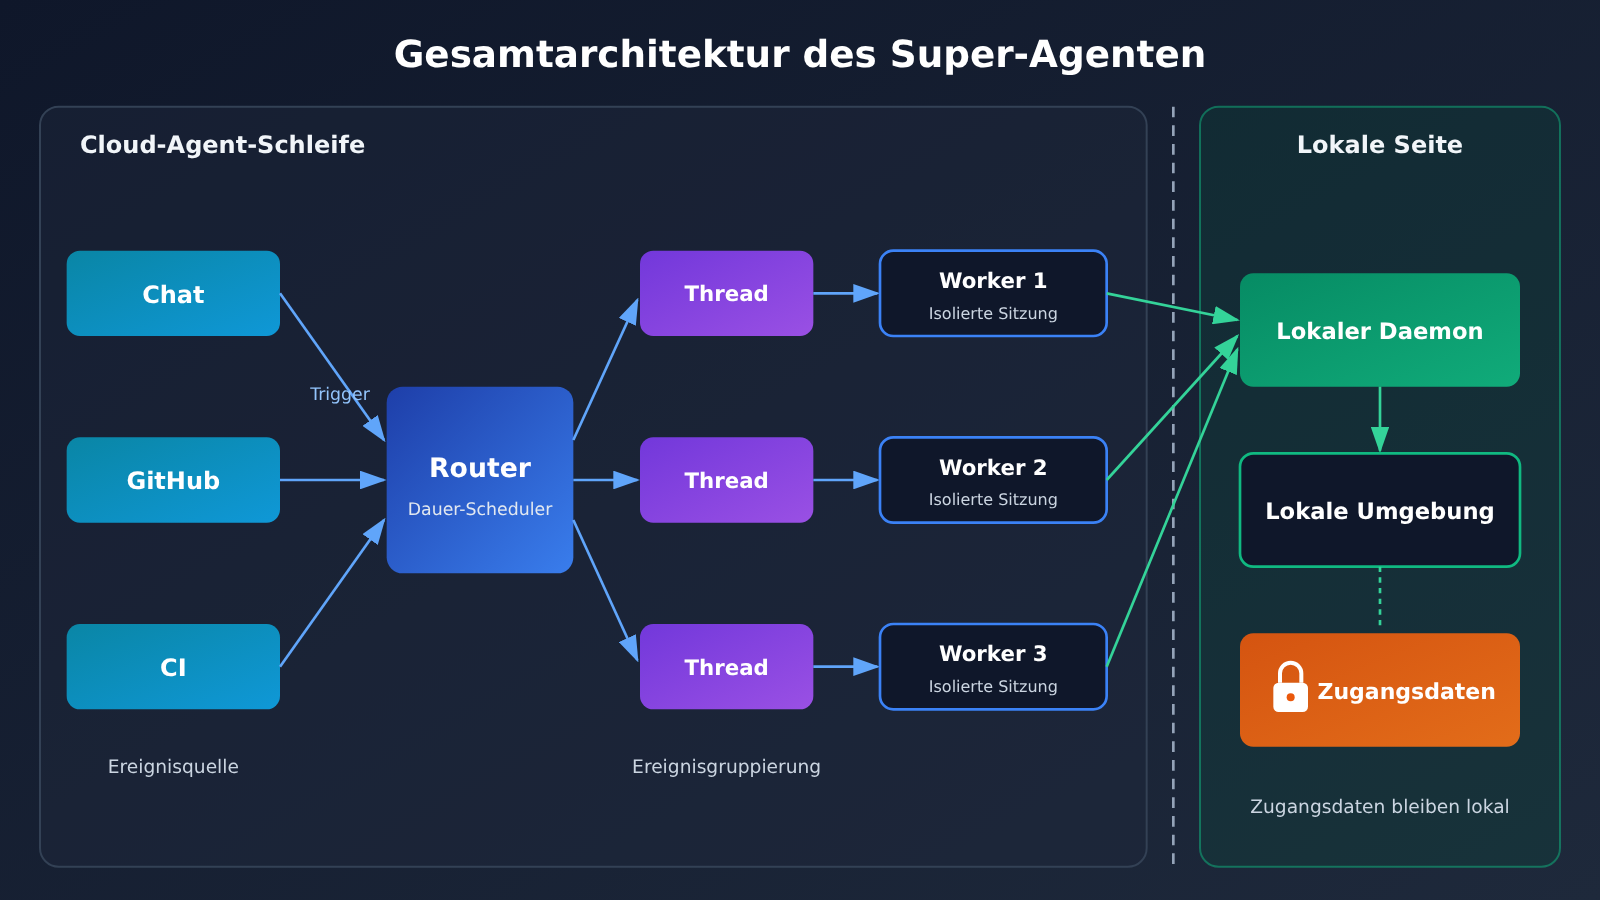
Der Super-Agent im Originaltext besteht aus Router und Workern. Der Router ist die dauerhaft aktive zentrale Steuerungsinstanz und überwacht gleichzeitig Ereignisse aus Quellen wie Chat, GitHub und CI. Ein Worker ist eine isolierte Agent-Sitzung und bearbeitet jeweils nur eine Aufgabe. Jedes eingehende Ereignis heisst Trigger. Zusammengehörige Ereignisse, etwa zu demselben PR, demselben IM-Thema oder derselben E-Mail-Kette, werden einem Thread zugeordnet.
Eine Besonderheit dieser Architektur betrifft die Bereitstellung: Die Agent-Schleife läuft in der Cloud, während die Ausführungsumgebung des Nutzers lokal bleibt. Ein kleiner Daemon stellt die Verbindung her; auch die Zugangsdaten bleiben zusammen mit der Umgebung lokal. Alle drei Designfragen bauen auf dieser Voraussetzung auf. Wer die vier Begriffe Router, Worker, Trigger und Thread verstanden hat, kann die folgenden Entwürfe für Vollduplex und Gedächtnis leichter einordnen.
Das Vollduplex-Design von DeepSeek Harness als Vorbild
Vollduplex löst das Problem, dass ein langsames Werkzeug den gesamten Agenten blockiert. Üblicherweise wartet der Agent nach einem Werkzeugaufruf synchron auf das Ergebnis. Bei einer Abfrage von 200 ms ist das unproblematisch. Ein sechsminütiger Testlauf bringt dagegen drei Probleme mit sich: Die Wartezeiten nachfolgender Anfragen summieren sich, der Agent hört nicht, wenn der Nutzer zwischendurch „E2E-Tests überspringen“ sagt, und das Gateway kann eine lange offene Verbindung trennen. Dann meldet der Aufruf einen Timeout, obwohl die Arbeit erfolgreich abgeschlossen wurde.
Der Originalartikel nennt den Idealzustand „productive“: Der Agent kann bereits die nächste Anweisung entgegennehmen, während die vorherige noch läuft. Dafür wird ein blockierender run()-Aufruf in mehrere kleine Verträge aufgeteilt: start() gibt sofort ein Task-Handle zurück, status() meldet den Fortschritt, stop() leitet den Abbruch ein, und das Ergebnis kehrt später als Ereignis in die Konversation zurück. Der Unterschied liegt darin, wer wartet: Bei run() wartet das Modell, bei start() die Laufzeitumgebung.
Der asynchrone Werkzeugvertrag von DeepSeek Harness für Vollduplex
In der Werkzeugdefinition stellt jede zeitaufwendige Funktion nach außen drei Werkzeuge statt eines einzigen bereit. Am Beispiel eines Tests gibt start_test_run nur die job_id und den Status queued zurück, aber keine Ergebnisdaten. get_job_status liefert einen der Statuswerte queued, running, done oder failed sowie eine kurze Fortschrittsmeldung. stop_job leitet den Abbruch ein und gibt den tatsächlich erreichten Status zurück.
Zwei Regeln verhindern, dass das Modell vom gewünschten Verhalten abweicht. Erstens sollte in der Werkzeugbeschreibung ausdrücklich stehen: „Nicht auf das Ergebnis warten.“ Andernfalls fragt das Modell möglicherweise häufig get_job_status ab. Zweitens darf start niemals Ergebnisdaten zurückgeben, da das Modell sonst raten müsste, welche Struktur es gerade erhalten hat. Die Task-API hinter den Werkzeugen lässt sich nach folgendem Muster gestalten. RFC 9110 definiert 202 Accepted passend dazu als „Anfrage zur Verarbeitung angenommen, aber Verarbeitung noch nicht abgeschlossen“.
| Aufruf | Antwort | Zugehöriges Werkzeug |
|---|---|---|
POST /jobs (mit dem Anfrage-Header Idempotency-Key) |
202, gibt job_id und den Status queued zurück; Location verweist auf /jobs/{id} |
start |
GET /jobs/{id} |
200, gibt queued / running / done / failed zurück | status, Task-Listener |
GET /jobs/{id}/result |
Bei Abschluss 200 mit Ergebnis, andernfalls 409 | Werkzeug zum Abrufen des Ergebnisses |
DELETE /jobs/{id} |
202 bedeutet, dass die Abbruchanfrage angenommen wurde; spätere Aufrufe geben 404 oder 409 zurück | stop |
| Optionale Callback-URL | Sendet bei Abschluss des Tasks einen POST an den Aufrufer | Task-Listener |
Vollduplex-Rückmeldung und Batch-Verarbeitung im DeepSeek Harness
Polling ist nur eine Ausweichlösung. Besser ist es, wenn die Laufzeitumgebung den Task überwacht und nach Abschluss ein kurzes Ereignis in den Dialog sendet: mit job_id, Status und einer einzeiligen Zusammenfassung wie „412 bestanden, 3 fehlgeschlagen“. Das vollständige Log bleibt über ein Tool zum Abrufen der Ergebnisse zugänglich. So gelangen nicht direkt 40.000 Logzeilen in den Kontext.
Der Originaltext beschreibt auch die Batch-Verarbeitung im Router: Trigger, die während einer Generierungsrunde eintreffen, werden zunächst in eine Warteschlange gestellt und beim nächsten Modellaufruf zusammengefasst. Solche Aufrufe haben lange Eingaben und kurze Ausgaben; der größte Teil des Aufwands fällt in der Prefill-Phase an. Im Experiment des Originaltexts stieg die durchschnittliche Batch-Größe von 1,0 auf 2,8, als die Trigger-Frequenz von einem auf 40 pro Minute erhöht wurde. Die Dauer pro Entscheidung sank dabei von 6,4 s auf 1,6 s. Das sind eigene Testdaten des Originaltexts, kein allgemeingültiger Benchmark. Der Ansatz lässt sich aber direkt übernehmen: Während das Modell generiert, werden Ereignisse und Nutzernachrichten zunächst eingereiht und nach Ende der laufenden Runde gemeinsam in ihrer Eingangsreihenfolge übergeben.
Technische Details zu Reihenfolge, Abbruch und Idempotenz
Diese Details werden in der Prototypphase leicht übersehen und führen nach dem Produktivstart besonders häufig zu Problemen:
- Reihenfolge: Tasks werden nicht immer in derselben Reihenfolge abgeschlossen. Wenn B von A abhängt, muss diese Abhängigkeit ausdrücklich festgelegt werden: Entweder startet B erst nach dem Abschlussereignis von A, oder die API unterstützt
depends_on. - Abbruch:
stopist nur eine Anfrage und garantiert keinen Abbruch. Der tatsächliche Endstatus muss zurückgegeben werden. War der Task vor dem Abbruch bereits abgeschlossen, solltedonezurückkommen, damit das Modell den Nutzer entsprechend informieren kann. - Idempotenzschlüssel: Modelle versuchen Aufrufe erneut, und eine verloren gegangene Antwort kann ein zweites
startauslösen. Jedesstartsollte deshalb einenidempotency_keyverlangen. Bei einem bereits verwendeten Schlüssel wird der vorhandene Task zurückgegeben. Andernfalls könnte die Anweisung „Migration ausführen“ zweimal ausgeführt werden. - Teilergebnisse und Timeouts: Frühe Ausgaben werden über eine Ergebnisschnittstelle mit Cursor bereitgestellt. Jeder Task erhält eine Deadline; bei Zeitüberschreitung wird ein
job_timed_out-Ereignis ausgelöst.
Wenn Ihre Tools MCP verwenden, lohnt sich ein Blick auf die optionale Erweiterung Tasks in Version 2026-07-28 der MCP-Spezifikation. Der Server kann einen Tool-Aufruf mit einem Ergebnis beantworten, das eine taskId enthält. Der Client kann dann über tasks/get pollen oder auf notifications/tasks lauschen und mit tasks/cancel einen Abbruch anfordern. Client und Server müssen die Erweiterung beide ausdrücklich aktivieren. Da die Unterstützung je nach Host unterschiedlich ausfällt, sollten Sie sie vorab prüfen.
Wann Asynchronität nicht nötig ist: wenn ein Aufruf innerhalb von ein bis zwei Sekunden zurückkommt, der nächste Schritt zwingend auf das Ergebnis warten muss oder dahinter keine echte Task-API steht. Ist das Tool intern blockierend, erhöht eine asynchrone Hülle nach außen nur die Komplexität. Eine praktische Faustregel: Leseoperationen bleiben blockierend, länger dauernde Schreiboperationen und Berechnungen werden asynchron ausgeführt.
Was sich vom Speicherkonzept des DeepSeek Harness lernen lässt: Chain of Recall
Lang laufende Agenten stoßen früher oder später an die Grenzen ihres Kontextfensters, weil ständig neue Aufgaben hinzukommen. Die drei üblichen Gegenmaßnahmen haben jeweils Nachteile: Behält man alles, füllt sich das Fenster und die Kosten steigen mit jeder Runde. Rollierende Zusammenfassungen verlieren konkrete Fehlermeldungen oder PR-Nummern, die später gebraucht werden. Und die Ähnlichkeitssuche findet Fakten nicht, wenn sie sich sprachlich zu stark von der Suchanfrage unterscheiden.
Der Ansatz im Originalartikel behandelt den Kontext als Cache und kennt nur zwei Operationen. Inline hält Inhalte bereit, die der Agent wahrscheinlich unmittelbar benötigt, darunter IDs, kurze Zusammenfassungen und benachbarte Nachrichten. Spill lagert den Rest aus: Der Inhalt wird im Kontext gekürzt und durch einen Verweis ersetzt, über den er später abgerufen werden kann. Die ausgelagerten Inhalte werden nicht gelöscht – im Prompt bleibt lediglich der Verweis zurück. Bei einem fehlgeschlagenen CI-Lauf könnte zum Beispiel nur die Zusammenfassung „CI für PR #412 fehlgeschlagen, 3 von 118 Tests im Verzeichnis payments rot“ im Kontext stehen. Vom vollständigen, 41 KB großen Log bleibt nur der Abrufpfad. Reicht die Zusammenfassung aus, muss der Agent nicht für die Verarbeitung dieser 41 KB bezahlen.
Stabile IDs und der Referenzgraph im Speicherkonzept des DeepSeek Harness
Die Voraussetzung für Chain of Recall ist, dass IDs dauerhaft unverändert bleiben. Im Originalartikel tragen drei Arten von Objekten eine ID:
| Objekt | Bedeutung | Beispiel-ID | Verknüpfung |
|---|---|---|---|
| Trigger | Ein Ereignis, das im System eingeht: Chatnachricht, Webhook oder CI-Callback | trg_8f21 |
Gehört zu einem Thread |
| Thread | Eine Reihe zusammengehöriger Ereignisse zu demselben PR, IM-Thema oder E-Mail-Verlauf | thr_pr_412 |
Wird von einem oder mehreren Workern bearbeitet |
| Worker | Eine isolierte Agent-Sitzung, die eine einzelne Aufgabe bearbeitet | wkr_77a0 |
Verweist in seinem Bericht auf die bearbeiteten Trigger |
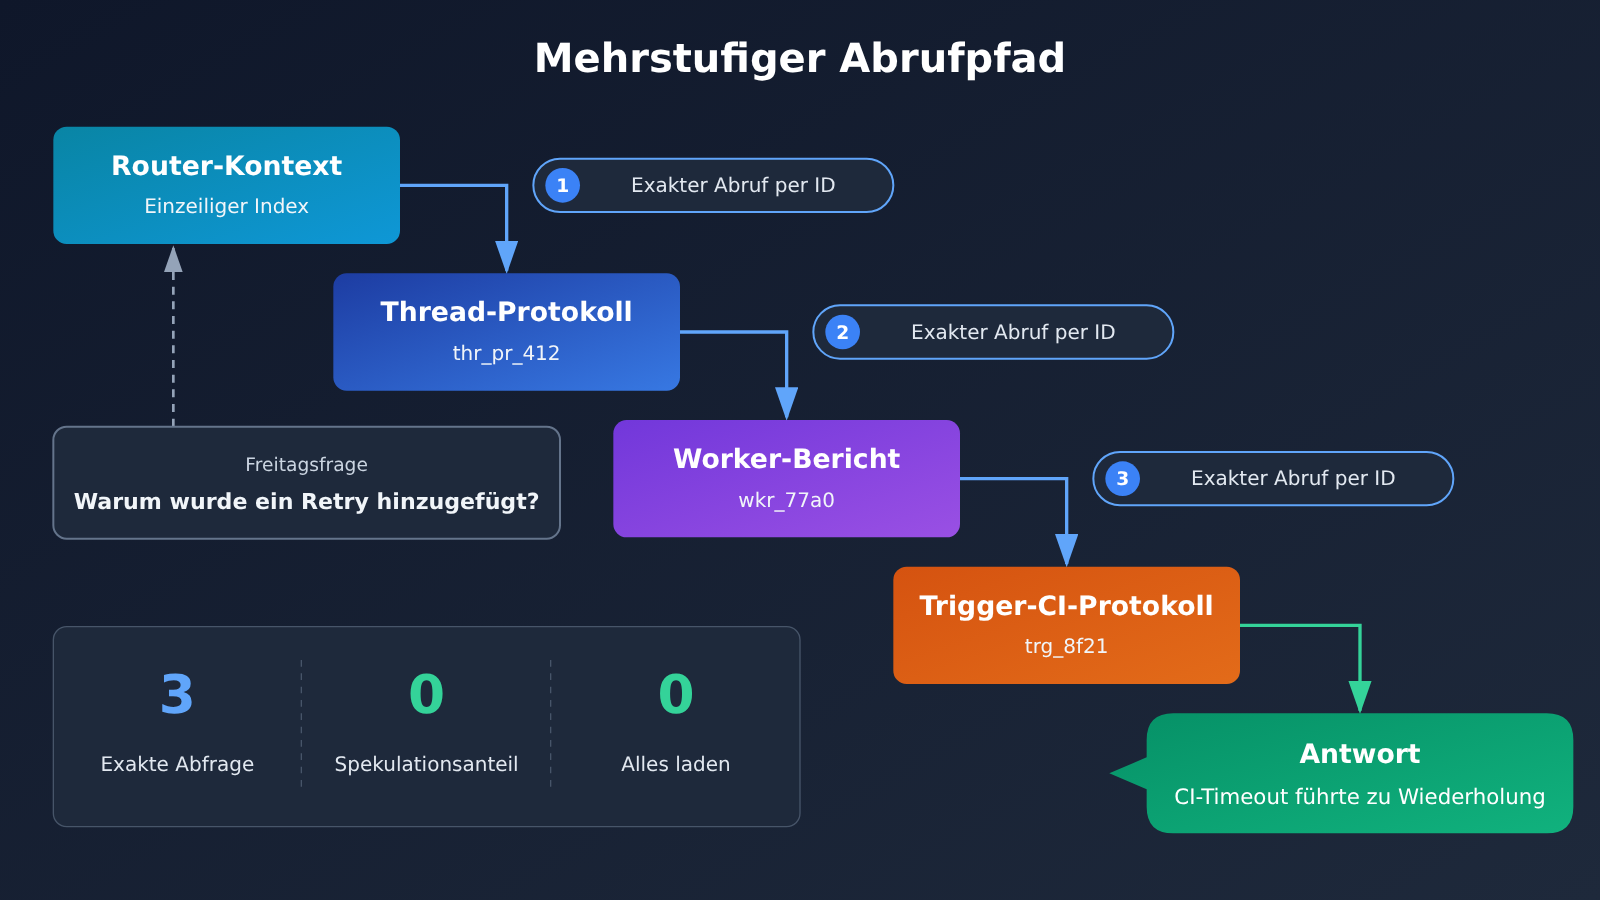
Diese Verknüpfungen bilden einen Referenzgraphen – das Gedächtnis des Agenten. Beim Abruf folgt er den Verknüpfungen Schritt für Schritt, ohne den gesamten Verlauf zu laden oder nach ähnlichen Texten zu suchen. Ein Beispiel: Am Freitag fragt jemand den Router, warum für den Zahlungsclient Retries hinzugefügt wurden. Die relevante Diskussion fand am Dienstag statt und wurde längst ausgelagert. Im ersten Schritt ruft der Router thr_pr_412 über eine Indexzeile ab, die noch im Kontext steht. Im zweiten Schritt liest er im Thread-Eintrag, welcher Worker den Thread bearbeitet hat, und ruft dessen Abschlussbericht ab. Im dritten Schritt folgt er dem Verweis im Bericht auf den Trigger des fehlgeschlagenen CI-Laufs, ruft dessen Log ab und findet den Timeout-Fehler. Drei kleine, gezielte Abfragen – und die Antwort kommt ohne jede Vermutung aus.
Vier Verträge für die Speicher-API des DeepSeek Harness
Jeder Schritt in der Abrufkette ist ein API-Aufruf. Gibt einer davon einen anderen Datensatz oder gar nichts zurück, reisst die Kette ab: Der Agent bleibt entweder stecken oder muss die Antwort erraten. Deshalb muss die zugrunde liegende API vier Verträge erfüllen:
- IDs ändern sich nie: Eine heute zurückgegebene ID muss auch nächsten Monat auf dasselbe Objekt verweisen. Nach einer Löschung wird sie nicht wiederverwendet, nach einer Migration nicht neu vergeben.
- Der Abruf per ID ist kostengünstig und präzise:
GET /threads/{id}gibt nur diesen einen Datensatz zurück, führt keine Suche durch und liefert auch nicht den „ähnlichsten Treffer“. - Unbekannte IDs schlagen eindeutig fehl: Die API gibt einen 404-Status und einen verständlichen Fehler-Body zurück. Bei einer 200-Antwort mit leerem Objekt würde der Agent annehmen, dass diese Erinnerung existiert.
- Cursor-Paginierung ohne Lücken: Lange Threads werden der Reihe nach seitenweise abgerufen, wobei jedes Ereignis genau einmal erscheint. Der Cursor bleibt auch dann gültig, wenn neue Ereignisse hinzukommen.
Beim Refactoring können diese Verträge leicht unbemerkt verletzt werden. Deshalb sollten sie als automatisierte Tests formuliert und bei jedem Merge ausgeführt werden.
Zwei Einschränkungen sollte man nüchtern betrachten. Erstens ersetzt Chain of Recall keine Vektorsuche: Die Vektorsuche beantwortet die Frage „Was ist diesem Inhalt ähnlich?“, Chain of Recall dagegen „Was ist mit diesem Inhalt verknüpft?“. In der Praxis werden beide häufig kombiniert: Zuerst findet ein Vektorindex die ID eines Ausgangs-Threads, danach führen die Links zu den genauen Fakten. Zweitens bezieht sich die Zahl „37 %“ im Original auf die Thread-Durchreichung: Ohne diese Funktion stieg die Zahl der pro Durchlauf aus dem Cache gelesenen Token von 23.2M auf 31.8M. Das sind die Kosten einer fehlenden Funktion, nicht die Einsparungen durch Chain of Recall selbst. Beim Zitieren sollte man das nicht verwechseln.
Was sich vom DeepSeek-Harness für den Umgang mit Zugangsdaten lernen lässt: nutzen, ohne sie zu sehen
Der Originalartikel führt dies als offene Frage auf: Gelangen Zugangsdaten in den Kontext eines Agenten, können sie offengelegt werden. Deshalb sollte ein Agent Zugangsdaten verwenden können, ohne sie zu sehen. Vier typische Wege führen zu einer Offenlegung: Der Agent liest zur Fehlersuche eine .env-Datei; er schreibt unverschlüsselte Request-Header in einen Debug-Befehl oder führt echo aus, um „zu prüfen, ob eine Variable gesetzt ist“; er übernimmt echte Werte in eine PR-Beschreibung, einen Issue-Kommentar oder eine Test-Fixture; oder er wird durch Prompt-Injection in einer Webseite oder API-Antwort dazu verleitet, Umgebungsvariablen auszugeben. OWASP führt Prompt-Injection als größtes Risiko für LLM-Anwendungen und ordnet die Offenlegung von Zugangsdaten der Kategorie „Preisgabe sensibler Informationen“ zu.
Alle Schutzmaßnahmen folgen derselben Regel: Nur die Namen gehören in den Kontext, die Werte bleiben außerhalb des Modells. Im Kontext dürfen Variablennamen wie STRIPE_KEY, Verweise auf einen Secret Manager, Platzhalter wie {{token}} oder maskierte Werte stehen. Echte Schlüssel, aufgelöste Werte und nicht bereinigte Logzeilen dürfen dort nicht auftauchen. Sobald ein echter Wert in einer Unterhaltung erscheint, muss der Schlüssel noch am selben Tag rotiert werden: Gesprächsverläufe werden protokolliert, zwischengespeichert und exportiert – ein einmal ausgegebenes Token lässt sich nicht zurückholen.
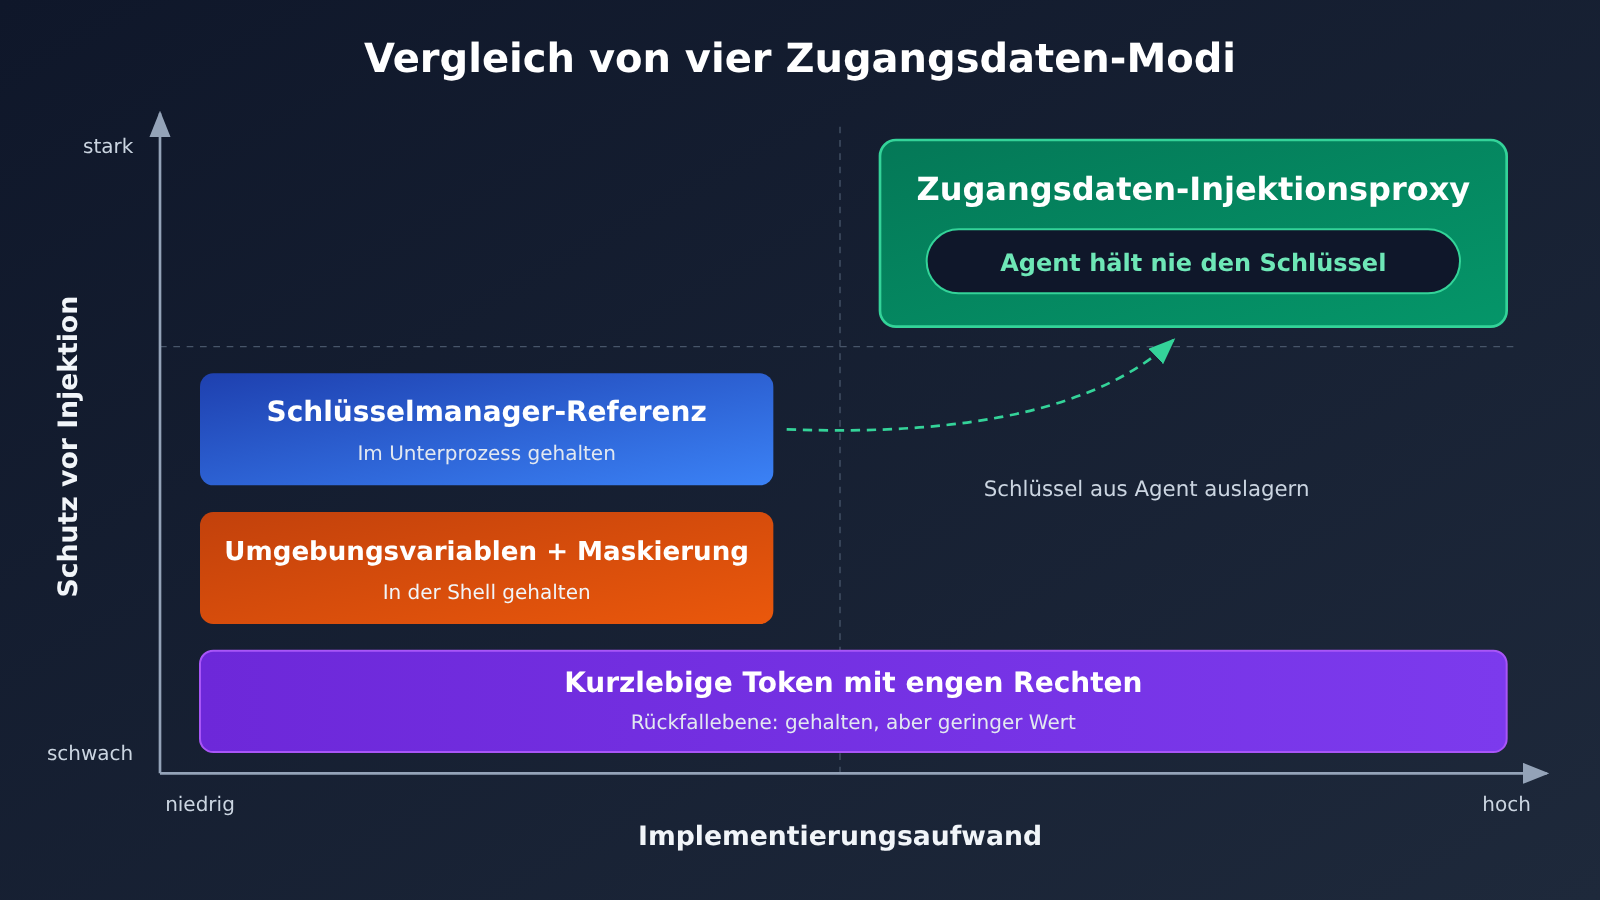
Vier praktische Ansätze für Zugangsdaten im DeepSeek Harness
| Ansatz | Umsetzung | Hat der Agent Zugriff auf den Wert? | Wichtigste Einschränkung |
|---|---|---|---|
| Umgebungsvariablen + Maskierung | Im Befehl steht $NAME, das die Shell auflöst; das Lesen von .env ist verboten; Ausgaben werden vor der Rückgabe maskiert |
In der Shell vorhanden | Verhindert versehentliche Offenlegung, aber nicht das gezielte Ausgeben nach einer Injection |
| Verweis auf einen Schlüsselmanager | Die Konfiguration enthält nur einen Verweis wie op://vault/item/field, den die CLI zur Laufzeit für den Kindprozess auflöst |
Im Kindprozess vorhanden | Dieselben Einschränkungen wie bei Umgebungsvariablen |
| Proxy zur Zugangsdateninjektion | Der Agent sendet Anfragen ohne Schlüssel an einen lokalen Proxy; dieser ergänzt den Authentifizierungsheader und leitet Anfragen anhand einer Allowlist weiter | Nie vorhanden | Der Proxy muss separat bereitgestellt und gewartet werden |
| Kurzlebige Token mit eingeschränkten Rechten | Für jede Sitzung wird ein Token ausgestellt, das nach wenigen Minuten abläuft und nur eine Aufgabe erlaubt | Vorhanden, aber von geringem Wert | Nur eine zusätzliche Absicherung; während der Gültigkeitsdauer ist Missbrauch weiterhin möglich |
Von diesen vier Ansätzen sorgt nur der Proxy zur Zugangsdateninjektion tatsächlich dafür, dass der Agent keinen Schlüssel besitzt. Die Allowlist des Proxys ist genauso wichtig wie die Injektion selbst: Sie kann beispielsweise GET /v1/charges erlauben und DELETE /v1/customers ablehnen. Selbst wenn der Agent durch eine Injection manipuliert wird, kann er nur die von Ihnen freigegebenen Aufrufe ausführen und den Schlüssel nicht entwenden. Der Proxy sollte unter einem separaten Benutzerkonto oder in einem eigenen Container laufen, damit der Agent seine Konfiguration nicht lesen kann. Das entspricht dem Bereitstellungsansatz im Original: Die Zugangsdaten bleiben zusammen mit der Umgebung lokal.
Wenn Ihr Agent Modelle über APIYI aufruft, lässt sich derselbe Ansatz für den Modellschlüssel nutzen: Der Proxy fügt den Schlüssel bei der Weiterleitung an APIYI hinzu. Der Agent muss lediglich wissen, dass er den lokalen Proxy verwendet. So enthält auch ein exportierter Gesprächsverlauf keinen verwendbaren APIYI-Schlüssel. Die konkreten Endpunkte und Authentifizierungsmethoden finden Sie in der APIYI-Dokumentation unter docs.apiyi.com.
Die letzte Schutzschicht ist die Maskierung. In Tool-Ausgaben, CI-Logs und gespeicherten Sitzungen müssen bekannte Präfixe maskiert werden, darunter sk_live_, ghp_, github_pat_, AKIA und xoxb-. Das gilt auch für die Werte sämtlicher Authorization– und X-API-Key-Request-Header sowie für die konkreten Werte, die in der jeweiligen Sitzung injiziert wurden. Bleibt auch nur eine Zeile unmaskiert, können alle vorherigen Schutzmaßnahmen umsonst gewesen sein.
Schnellstart für das DeepSeek-Harness-Design: Checkliste und Modellauswahl
Die drei Designfragen müssen nicht alle auf einmal gelöst werden. Nach Aufwand und Nutzen empfiehlt sich diese Reihenfolge:
- Zuerst Zugangsdaten absichern: Agents dürfen
.envnicht lesen. InCLAUDE.mdoderAGENTS.mdfesthalten, dass keine Variablen ausgegeben werden dürfen, deren Namen auf_KEY,_TOKENoder_SECRETenden. Außerdem einen Filter zur Maskierung sensibler Daten in die Ausgabe einbauen. Das lässt sich in einem halben Tag umsetzen und bringt sofort Nutzen. - Dann langsame Tools auf asynchron umstellen: Zunächst Tools für Tests, Builds und Deployments auswählen, die häufig länger als ein paar Sekunden laufen. Ihre Abläufe in start / status / stop aufteilen und um Idempotenzschlüssel und Deadlines ergänzen.
- Danach stabile IDs einführen: Ereignissen, Sitzungsthreads und Teilaufgaben einheitlich unveränderliche IDs zuweisen. Im Kontext nur die ID und eine einzeilige Zusammenfassung behalten; längere Inhalte auslagern und einen Verweis darauf hinterlegen.
- Zuletzt einen Injection-Proxy und kurzlebige Tokens einführen: Für APIs von Drittanbietern einen Proxy bereitstellen und eine Allowlist konfigurieren. Jede Agent-Sitzung erhält ein eigenes Token.
Bei der Modellauswahl gilt: Der Router verarbeitet lange Eingaben, erzeugt kurze Ausgaben und trifft häufig Entscheidungen im Batch. Dafür eignen sich günstige, schnelle Modelle mit niedrigen Kosten für Cache-Treffer. Worker schreiben Code und übernehmen komplexe Schlussfolgerungen; für sie sind leistungsfähigere Modelle geeignet. Die Preise in der folgenden Tabelle stammen von der APIYI-Preisseite docs.apiyi.com/models. Für Abrechnung und aktuelle Preise gelten die Angaben auf der Seite; dieser Artikel gibt keine weiteren Preiszusagen.
| Modell (APIYI-Modellname) | Eingabepreis | Ausgabepreis | Cache-Preis | Empfohlene Rolle | Verfügbare Plattform |
|---|---|---|---|---|---|
| deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | Router für Batch-Entscheidungen und Ereigniszusammenfassungen | APIYI apiyi.com |
| claude-sonnet-5-5 | $2 | $10 | $0.1 | Worker für alltägliche Programmieraufgaben | APIYI apiyi.com |
| kimi-k3.1-pro | $2 | $10 | $0.2 | Worker für lange Kontexte und Dokumentaufgaben | APIYI apiyi.com |
| claude-opus-5-5 | $4 | $20 | $0.2 | Worker für komplexes Refactoring und wichtige Entscheidungen | APIYI apiyi.com |
Wichtig dabei: Sowohl die Batch-Verarbeitung als auch die Experimente zur Thread-Durchreichung im Originalartikel betonen die Anzahl der aus dem Cache gelesenen Tokens. Beim Router entfällt ein Grossteil der Kosten auf Prefill und Cache-Lesevorgänge. Deshalb lohnt sich bei der Auswahl oft ein genauerer Blick auf den Cache-Preis als auf den Ausgabepreis.
🚀 Schnellstart: APIYI bietet API-Zugriff auf die Modelle aus der Tabelle und unterstützt sowohl das OpenAI- als auch das Anthropic-Schnittstellenformat. Der Router kann deepseek-v4.1-flash über das OpenAI-Format ansprechen, der Worker claude-sonnet-5-5 über das Anthropic-Format. Beide lassen sich gemeinsam über ein Konto verwalten. Hinweise zur Integration finden Sie in der APIYI-Dokumentation unter docs.apiyi.com; für Preise gilt docs.apiyi.com/models.
Häufig gestellte Fragen (FAQ)
F1: Was ist „Super-agent Design“ von DeepSeek Harness?
„Exploring Super-agent Design“ ist ein ausführlicher Designartikel, den das DeepSeek-Harness-Team am 2026-11-01 veröffentlicht hat. Er behandelt die Frage, wie sich ein dauerhaft aktiver Super-Agent gestalten lässt, der gleichzeitig mehrere Ereignisquellen überwacht. Der Artikel beschreibt eine Architektur, keine offiziell veröffentlichte Funktion. Teile davon sind im Prototyp-Plugin `dsh-superagent-prototype` enthalten. Laut den Autoren ist es kein offizielles DeepSeek-Produkt.
F2: Was ist der Unterschied zwischen Vollduplex und parallelen Tool-Aufrufen?
Bei parallelen Tool-Aufrufen werden mehrere Tools innerhalb einer Runde gleichzeitig ausgeführt. Das Modell muss trotzdem warten, bis alle Ergebnisse vorliegen. Bei asynchronen Tool-Aufrufen im Vollduplexbetrieb wird dagegen sofort ein Handle zurückgegeben. Die Ergebnisse treffen in späteren Runden als Ereignisse ein. Währenddessen kann das Modell das Gespräch fortsetzen, neue Anweisungen entgegennehmen und weitere Aufgaben starten.
F3: Lässt sich Chain of Recall direkt aktivieren? Kann es RAG ersetzen?
Beides ist nicht möglich. Chain of Recall ist ein Designmuster aus dem Originalartikel und lässt sich nicht einfach per Schalter aktivieren. Stabile IDs und eine Schnittstelle zum Abrufen anhand dieser IDs müssen selbst implementiert werden. Außerdem lösen Chain of Recall und RAG unterschiedliche Probleme: RAG sucht nach ähnlichen Inhalten, während Chain of Recall Informationen über exakte Verknüpfungen abruft. In der Praxis wird häufig zunächst per Vektorsuche ein Ausgangspunkt gefunden und anschließend den ID-Verknüpfungen bis zu den konkreten Fakten gefolgt. Auch der Originalartikel führt das Langzeitgedächtnis als offene Frage auf und behauptet nicht, dass Chain of Recall sie bereits gelöst hat.
F4: Für welche Anwendungen eignen sich die drei Designansätze besonders?
– **Vollduplex**: Aufgaben wie Tests, Builds, Crawling, Rendering oder Deployments, die oft länger als ein paar Sekunden dauern und bei denen Nutzer währenddessen mit dem Agenten weiterkommunizieren.
– **Gedächtnis**: Historien aus einzelnen, verknüpfbaren Ereignissen, etwa PRs, Tickets, CI-Läufen, Kundendienstgesprächen oder Veröffentlichungen.
– **Zugangsdaten**: Coding- und Operations-Agenten, die kostenpflichtige oder sensible APIs von Drittanbietern aufrufen müssen.
F5: Wie lassen sich schnell unterschiedliche Modelle für Router und Worker anbinden?
Ein einfacher Weg ist eine Plattform, die sowohl das OpenAI- als auch das Anthropic-Schnittstellenformat unterstützt. Nach der Registrierung bei APIYI auf apiyi.com erhalten Sie einen API-Schlüssel. Um das Modell zu wechseln, tragen Sie beim Router und beim Worker jeweils den passenden Modellnamen ein. Die gültige API-Adresse finden Sie in der APIYI-Dokumentation unter docs.apiyi.com. Vor dem produktiven Einsatz empfiehlt es sich, die Entscheidungsqualität von deepseek-v4.1-flash und claude-sonnet-5-5 anhand derselben realen Ereignisse zu testen und dann die Aufgabenverteilung festzulegen.
F6: Wo lassen sich die im Originalartikel genannten Modelle und Preise überprüfen?
Für alle in diesem Artikel erwähnten Modellpreise gelten die aktuellen Angaben auf der APIYI-Preisseite docs.apiyi.com/models. Zahlen aus dem Originalartikel und aus Drittquellen dienen lediglich zum Vergleich. Ist ein Modell auf der Preisseite nicht zu finden, bietet APIYI es derzeit noch nicht an. Es soll schnellstmöglich verfügbar gemacht werden; maßgeblich sind dann die Angaben auf der Preisseite.
F7: Welche Einschränkungen dieser Ansätze sind bekannt?
Vollduplex braucht eine echte Aufgaben-API. Ein mit blockierenden Aufrufen umgesetztes „Pseudo-Async“ erhöht nur die Komplexität. Chain of Recall findet keine Inhalte, zu denen keine Verknüpfung angelegt wurde. Zudem kann der ID-Vertrag bei Migrationen und Refactoring leicht verletzt werden. Bei Zugangsdaten verhindern weder Umgebungsvariablen noch Schlüsselreferenzen, dass ein Agent die Werte nach einer Injektion aktiv ausgibt. Nur ein Injektions-Proxy sorgt dafür, dass der Agent die Werte gar nicht erst erhält; kurzlebige Tokens dienen lediglich als Absicherung. Auch der Originalartikel selbst führt Speicher und Zugangsdaten als offene Fragen auf.
DeepSeek Harness: Die wichtigsten Erkenntnisse zum Design eines Super-Agents
- Einordnung des Originals: Der Artikel beschreibt ein Architekturdesign. Vollduplex ist standardmäßig deaktiviert, und das Prototyp-Plug-in ist kein offizielles Produkt.
- Vollduplex: start / status / stop ersetzen das blockierende run. Ergebnisse werden als Ereignisse zurückgeführt und stapelweise zusammengeführt.
- Vertrag der Aufgaben-API: 202 bestätigt die Annahme, Idempotenzschlüssel verhindern Duplikate, eine Abbruchanfrage gibt den tatsächlichen Status zurück und jede Aufgabe erhält eine Deadline.
- Speicherdesign: Im Kontext stehen nur stabile IDs und kurze Zusammenfassungen. Für ausgelagerte Inhalte bleiben Verweise zurück; beim Abruf werden sie über mehrere Schritte entlang der ID-Verknüpfungen zurückgeholt.
- Vertrag der Speicher-API: IDs bleiben unverändert, Inhalte werden exakt abgerufen, unbekannte IDs liefern 404 und die Cursor-Paginierung ist lückenlos.
- Grundsatz für Zugangsdaten: Namen kommen in den Kontext, Werte bleiben außerhalb. Bevorzugt wird ein Injektions-Proxy eingesetzt, kurzlebige Tokens dienen als Absicherung und Logs werden vollständig um sensible Daten bereinigt.
- Rollenverteilung der Modelle: Der Router verwendet ein günstiges Modell mit niedrigen Cache-Kosten, der Worker ein leistungsstarkes Modell. Über APIYI lassen sich Modelle mit einem einzigen Konto vergleichend testen.
Zusammenfassung
DeepSeek Harness’ „Super-Agent-Design“ bietet mehr direkt übertragbare Ansätze, als der Status als Prototyp vermuten lässt:
- Vollduplex: Asynchrone Tool-Verträge und die Rückführung von Ereignissen sind bewährte Vorgehensweisen. Die zugrunde liegende Task-API lässt sich testen, bevor sie in den Agent integriert wird.
- Gedächtnis: Stabile IDs zusammen mit inline/spill bieten eine kostengünstige Möglichkeit, ereignisgesteuerten Agents ein präzises Gedächtnis zu geben. Sie ersetzen jedoch keine Vektorsuche.
- Zugangsdaten: Die Regel „Namen in den Kontext, Werte nach außen“ lässt sich schon heute umsetzen. Ein Injection-Proxy ist die einzige Lösung, bei der der Agent selbst zu keinem Zeitpunkt Schlüssel besitzt.
Beginnen Sie am besten mit einem sicheren Umgang mit Zugangsdaten und der asynchronen Ausführung langsamer Tools. Stabile IDs und der Injection-Proxy können in einer zweiten Phase folgen. Wenn Sie unterschiedliche Modelle für Router und Worker kombinieren möchten, können Sie diese über APIYI apiyi.com mit einer einheitlichen Schnittstelle testen, die mit den Formaten von OpenAI und Anthropic kompatibel ist. Die Preise finden Sie unter docs.apiyi.com/models.
📚 Referenzen
- What Is Chain of Recall? How Stable IDs Give AI Agents Memory: Erläuterung des Chain-of-Recall-Gedächtnisdesigns
- Link:
apidog.com/blog/chain-of-recall-ai-agent-memory -
Inhalt: Stabile IDs, inline/spill, Beispiele für mehrstufigen Abruf und vier API-Verträge
-
Async Tool Calls for AI Agents: Why start() Beats a Blocking run(): Erläuterung des asynchronen Vollduplex-Tool-Designs
- Link:
apidog.com/blog/async-tool-calls-ai-agents -
Inhalt: start/status/stop-Verträge, Versuchsdaten zur Stapelverarbeitung und Erläuterung der MCP-Tasks-Erweiterung
-
How to Let AI Agents Use API Keys Without Seeing Them: Praktischer Leitfaden zum sicheren Umgang mit Zugangsdaten für Agents
- Link:
apidog.com/blog/ai-agents-use-api-keys-without-seeing-them -
Inhalt: Vier Zugangsdatenmuster, mögliche Leckpfade und eine Checkliste zur Maskierung
-
APIYI Dokumentation und Preisseite: Informationen zur Integration und Abrechnung der in diesem Artikel behandelten Modelle
- Link:
docs.apiyi.comunddocs.apiyi.com/models - Inhalt: Modellnamen, Schnittstellenformate und aktuelle Preise
Autor: APIYI Technikteam
Technischer Austausch: Bei Fragen zur Wahl einer Agent-Architektur oder zur Integration mehrerer Modelle kontaktieren Sie uns über die Startseite von APIYI apiyi.com. Weitere Informationen finden Sie im Dokumentationszentrum unter docs.apiyi.com.


