
Anmerkung des Autors: Welche Zuverlässigkeitskennzahlen zählen bei AI-API-Proxy- und Aggregationsdiensten? Dieser Artikel stellt zehn Kennzahlen und einen siebentägigen Prüfprozess vor.
Viele Teams wählen einen AI-API-Proxy- oder Aggregationsdienst zunächst danach aus, ob die API-Aufrufe funktionieren und der Preis niedrig ist. Im Produktionsbetrieb zeigen sich die Probleme oft erst nach und nach: Zu Spitzenzeiten häufen sich 429-Fehler, Streaming-Ausgaben brechen mittendrin ab, die Rechnung stimmt nicht mit den selbst erfassten Token-Zahlen überein oder das Verhalten eines Modells ändert sich über Nacht. Dieser Artikel stellt die 10 wichtigsten Zuverlässigkeitskennzahlen für die Auswahl eines AI-API-Proxy- oder Aggregationsdienstes im Produktionsbetrieb vor – zusammen mit einem siebentägigen Prüfprozess.
Dies ist kein weiterer Preisvergleich nach dem Motto „Hauptsache günstig“. Es geht um eine Frage: Kann ein AI-API-Proxy- oder Aggregationsdienst deinen Datenverkehr im Produktionsbetrieb bewältigen? Und lassen sich Probleme erkennen, erklären und entschädigen?
Das bringt dir der Artikel: Du erhältst eine praktische Checkliste zur Zuverlässigkeit von AI-API-Proxy-Diensten. Damit kannst du vor Vertragsabschluss oder vor der Umstellung des Datenverkehrs anhand von Daten beurteilen, ob eine Plattform für den Produktionsbetrieb geeignet ist.
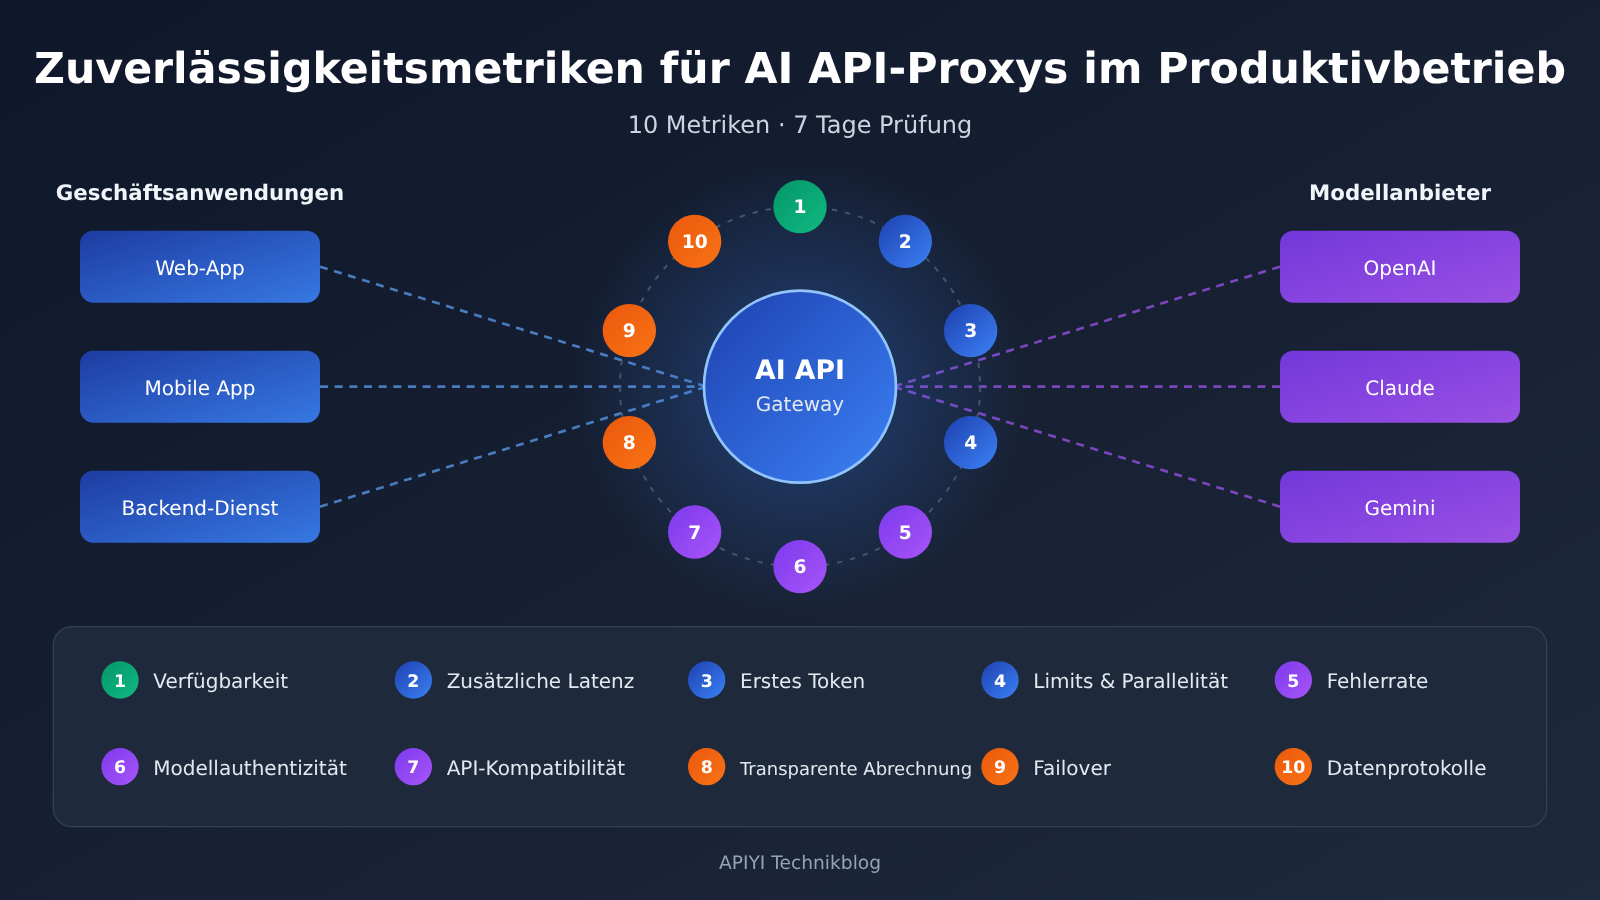
Zentrale Zuverlässigkeitskriterien für AI-API-Proxy- und Aggregationsdienste im Produktivbetrieb
Bevor du einen AI-API-Proxy- und Aggregationsdienst bewertest, solltest du die Kennzahlen einordnen. Zuverlässigkeit bedeutet mehr als nur, ob ein Dienst läuft: Auch die Vorhersehbarkeit der Latenz, die Vertrauenswürdigkeit der Ergebnisse und die Nachprüfbarkeit der Abrechnung zählen. Die folgende Tabelle ordnet zehn Kennzahlen vier Kategorien zu, damit du die Bewertung im Team aufteilen kannst.
| Kategorie | Zentrale Kennzahlen | Worauf es ankommt | Auswirkungen auf den Produktivbetrieb |
|---|---|---|---|
| Verfügbarkeit | Frühere Störungen, Statusseite, SLA-Zusagen | Häufigkeit von Störungen, Wiederherstellungsdauer, öffentliche Nachbereitung | Entscheidet, ob der Betrieb durchgehend verfügbar bleibt |
| Performance | Zusätzliche Latenz, Zeit bis zum ersten Token, Ratenbegrenzung und Parallelität | Aufwand durch die Proxy-Ebene, Verhalten zu Spitzenzeiten | Wirkt sich direkt auf das Nutzererlebnis und die Timeout-Rate aus |
| Konsistenz | Authentizität der Modellversion, Schnittstellenkompatibilität, Transparenz der Fehlercodes | Heimlicher Modellaustausch, vollständige Unterstützung von Streaming und Tool-Aufrufen | Entscheidet über Ausgabequalität und Stabilität des Codes |
| Steuerbarkeit | Abrechnungstransparenz, Failover, Daten- und Protokollierungsrichtlinien | Nachprüfbare Abrechnung, Redundanz durch mehrere Upstream-Anbieter, Datenschutz-Compliance | Entscheidet, ob sich der Dienst langfristig bedenkenlos nutzen lässt |
Verfügbarkeitskennzahlen für AI-API-Proxy-Dienste im Detail
Die Verfügbarkeit ist die erste Hürde bei der Auswahl eines AI-API-Proxy-Dienstes für den Produktivbetrieb. Achte nicht nur auf die beworbenen Prozentwerte, sondern auch darauf, ob es eine öffentliche Statusseite gibt, frühere Störungen einsehbar sind und Vorfälle nachbereitet werden. Eine Plattform, die den zeitlichen Ablauf von Vorfällen offenlegt, ist oft vertrauenswürdiger als eine, die lediglich mit „hoher Verfügbarkeit“ wirbt.
Quellen Dritter können als Vergleich dienen. Der Ofox.ai-Blog erwähnt beispielsweise in einem Test von OpenRouter für den Produktivbetrieb drei dokumentierte Störungen zwischen 2025 und 2026 sowie eine zusätzliche Latenz von etwa 25 bis 40 ms (Quelle: Ofox.ai Blog, nur zum Vergleich). Solche Daten dienen weniger dazu, eine einzelne Plattform zu beurteilen. Sie erinnern vielmehr daran: Jede Proxy-Ebene kann ausfallen und zusätzlichen Aufwand verursachen. Entscheidend ist, ob das Ausmaß akzeptabel und transparent ist.
Performance und Konsistenz von AI-API-Aggregationsdiensten im Detail
Bei der Performance solltest du die zusätzliche Latenz der Proxy-Ebene in zwei Teile aufschlüsseln: erstens den festen Aufwand für Netzwerk und Authentifizierung und zweitens die schwankenden Verzögerungen durch Warteschlangen zu Spitzenzeiten. Ersterer ist normalerweise stabil und messbar; Letztere sind die häufigere Ursache für Störungen im laufenden Betrieb. Miss deshalb unbedingt während der Spitzenzeiten deiner eigenen Anwendung, statt nach einem einzigen Benchmark mitten in der Nacht ein Fazit zu ziehen.
Bei der Konsistenz ist ein heimlicher Modellaustausch das am schwersten erkennbare Risiko. Manche Plattformen leiten Anfragen bei Engpässen beim Upstream-Anbieter an ein günstigeres Modell oder eine quantisierte Version weiter. Die Schnittstelle gibt zwar weiterhin 200 zurück, doch die Ausgabequalität sinkt deutlich. Prüfe deshalb, ob das Feld model in der Antwort mit der Anfrage übereinstimmt. Führe außerdem regelmäßig Regressionstests mit einem festen Aufgabensatz durch, um abrupte Änderungen im Ausgabestil und in der Genauigkeit zu erkennen.
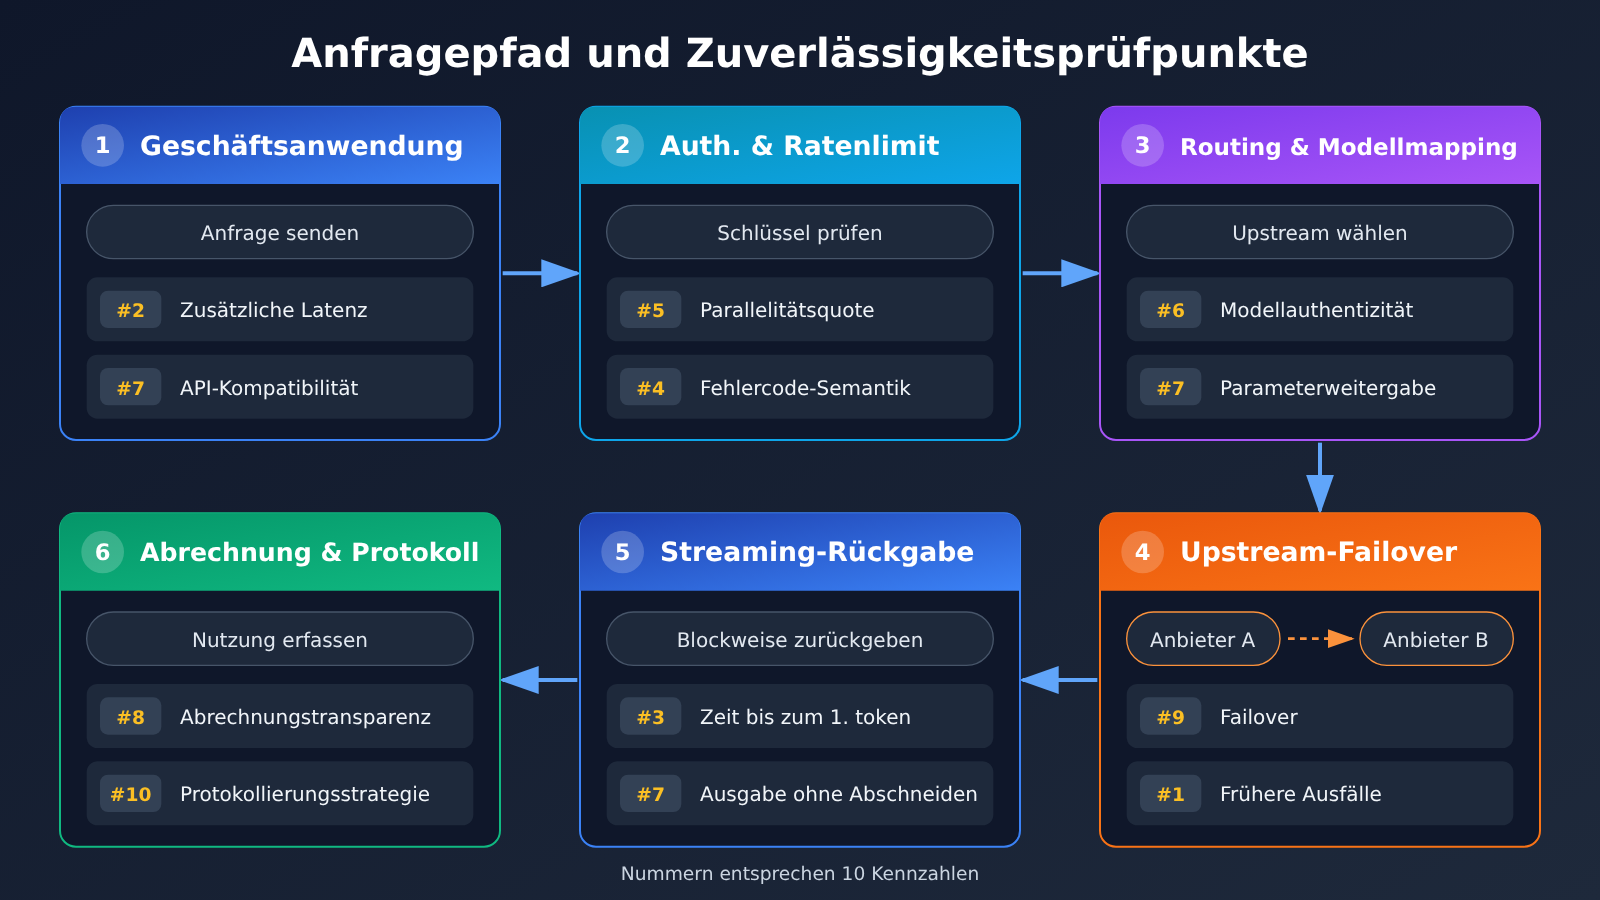
10 Zuverlässigkeitskriterien für AI-API-Proxy-Dienste im Produktionseinsatz
Die folgende Tabelle ist die zentrale Checkliste dieses Artikels. Für jeden Punkt finden Sie eine Prüfmethode und ein empfohlenes Erfolgskriterium. Sie können die Tabelle direkt in ein internes Prüfungsdokument übernehmen. Die Kriterien beruhen auf Erfahrungswerten – passen Sie sie an die Anforderungen Ihres Unternehmens an.
| Nr. | Zuverlässigkeitskriterium | Prüfmethode | Empfohlenes Erfolgskriterium |
|---|---|---|---|
| 1 | Frühere Ausfälle und Statusseite | Öffentliche Statusseite und Nachberichte zu Vorfällen prüfen | Statusseite vorhanden; für größere Ausfälle gibt es Nachberichte |
| 2 | Zusätzliche Latenz | Dieselbe Anfrage über eine direkte Verbindung und den Proxy vergleichen | Konstanter Overhead; keine deutliche Verschlechterung zu Spitzenzeiten |
| 3 | Zeit bis zum ersten Token | Bei Streaming-Anfragen die Ankunftszeit des ersten Pakets erfassen | Stabile Perzentilwerte; Ausreißer mit hoher Latenz sind erklärbar |
| 4 | Fehlerrate und Fehlercodes | Verteilung von 4xx- und 5xx-Fehlern auswerten | Fehlercodes sind eindeutig und unterscheiden zwischen Problemen beim Upstream-Anbieter und auf der Plattform |
| 5 | Ratenbegrenzung und Parallelitätskontingente | Last stufenweise erhöhen und beobachten, ab wann 429-Fehler auftreten | Kontingente sind klar definiert und können auf Anfrage erhöht werden |
| 6 | Echtheit der Modellversion | model-Feld prüfen und Regressionstests mit einem festen Aufgabensatz durchführen |
Zurückgegebenes Modell entspricht der Anfrage; keine ungewöhnlichen Abweichungen in den Ausgaben |
| 7 | Schnittstellenkompatibilität | Streaming, Tool-Aufrufe, multimodale Funktionen und Caching testen | Gängige Parameter werden vollständig weitergeleitet und nicht stillschweigend verworfen |
| 8 | Transparente Abrechnung | Eigene Token-Zählung mit der Plattformrechnung abgleichen | Abweichungen sind erklärbar; die Regeln zur Abrechnung gecachter Inhalte sind öffentlich |
| 9 | Failover-Fähigkeit | Redundanzstrategie für Upstream-Anbieter und Umschaltmechanismen prüfen | Der Ausfall eines einzelnen Upstream-Anbieters führt nicht zur vollständigen Nichtverfügbarkeit |
| 10 | Daten- und Protokollierungsrichtlinien | Datenschutzbedingungen und Angaben zur Aufbewahrung von Logs lesen | Es ist klar, ob und wie lange Daten gespeichert werden und ob sich die Speicherung abschalten lässt |
Warum transparente Abrechnung bei AI-APIs ein Zuverlässigkeitsindikator ist
Viele betrachten die Abrechnung als reine Kostenfrage. Im Produktionsbetrieb ist mangelnde Transparenz aber selbst ein Zuverlässigkeitsrisiko. Eine plötzlich stark steigende Rechnung kann bedeuten, dass der Cache nicht greift, sich die Regeln zur Token-Zählung geändert haben oder der Client Anfragen ungewöhnlich oft wiederholt. All das sind Probleme auf Systemebene. Der Ofox.ai Blog berichtete, dass Anthropic Ratenbegrenzungen zu Spitzenzeiten und zwei Cache-Bugs bestätigt hatte, die Token-Rechnungen um das 10- bis 20-Fache erhöhen konnten (Quelle: Ofox.ai Blog, als Vergleichsquelle). Das zeigt: Auch bei offiziellen Anbietern solltest du die Abrechnung selbst prüfen.
Dieselbe Quelle erwähnt, dass manche Aggregationsplattformen Gebühren für das Aufladen von Guthaben erheben, etwa die Credit Fee von 5,5 % bei OpenRouter (Quelle: Ofox.ai Blog, als Vergleichsquelle). Bei der Bewertung eines API-Proxy-Dienstes solltest du Gebühren, Wechselkurs, Mindestaufladebetrag und Cache-Preise in den „tatsächlichen Stückpreis“ einrechnen, statt nur auf die angegebenen Ein- und Ausgabepreise zu schauen.
Worauf es bei der Schnittstellenkompatibilität von AI-API-Aggregationsdiensten ankommt
Kompatibilitätsprobleme zeigen sich meist nicht schon beim Hello-World-Test. Kritisch sind vielmehr diese Szenarien: Die Proxy-Schicht bricht eine Streaming-Ausgabe vorzeitig ab, verändert die Parameterstruktur von Tool-Aufrufen, begrenzt die Größe von Bildeingaben oder verwirft Cache-Control-Felder im Anthropic-Format stillschweigend. Liste am besten alle Parameter auf, die deine Anwendung tatsächlich nutzt, und prüfe sie einzeln mit echten Anfragen auf Regressionen.
Wenn dein System sowohl das OpenAI- als auch das Anthropic-Schnittstellenformat nutzt, solltest du besonders darauf achten, dass der API-Proxy-Dienst beide Formate nativ unterstützt. Anthropic-Anfragen sollten nicht erst zwangsläufig ins OpenAI-Format und anschließend wieder zurück konvertiert werden. Je mehr Formatkonvertierungen stattfinden, desto höher ist das Risiko, dass Felder verloren gehen oder sich das Verhalten unterscheidet.
AI-API-Proxy-Dienst für die Produktion: Validierung in 7 Tagen
Die Checkliste steht – jetzt geht es an die Validierung. Wir empfehlen einen siebentägigen Test mit einem kleinen Teil des Datenverkehrs. So lassen sich sowohl Spitzen an Werktagen als auch die Verkehrsmuster am Wochenende beobachten. Komplexe Tools braucht es dafür nicht: Logs und eine Tabelle reichen aus.
| Phase | Zeitpunkt | Hauptaktivitäten | Ergebnis |
|---|---|---|---|
| Vorbereitung | Tag 1 | Geschäftlich genutzte Modelle, Parameter und Spitzen-QPS erfassen; festen Regressionstestdatensatz vorbereiten | Parameterliste und Testdatensatz |
| Funktionsregression | Tag 2 | Streaming, Tool-Aufrufe, multimodale Funktionen und Cache-Felder einzeln testen | Kompatibilitätscheckliste |
| Lasttest | Tag 3 | Last stufenweise auf das 1,5-Fache des Spitzenwerts erhöhen und erfassen, ab wann 429- und 5xx-Fehler auftreten | Kurven für Parallelität und Rate-Limits |
| Shadow Traffic | Tag 4–6 | Einen kleinen Teil der realen Anfragen an den API-Proxy-Dienst kopieren und mit dem bestehenden Anfragepfad vergleichen | Bericht zu Latenz, Fehlerrate und Ausgabeunterschieden |
| Abgleich und Auswertung | Tag 7 | Eigene Token-Statistiken mit der Plattformrechnung vergleichen und die 10 Kennzahlen zusammenfassen | Auswahlentscheidung und Umstellungsplan |
Konfiguration für die Anbindung an einen AI-API-Proxy-Dienst
Bei der Anbindung solltest du möglichst nur die Konfiguration ändern, nicht den Code. Wenn dein Projekt das offizielle OpenAI-SDK nutzt, reicht es normalerweise, base_url auf die Adresse des API-Proxy-Dienstes zu setzen und den api_key auszutauschen. Bei APIYI lässt sich base_url für das OpenAI-kompatible Format beispielsweise auf https://api.apiyi.com/v1 setzen. Als Modellnamen trägst du die Modell-ID ein, die auf der Preisseite aufgeführt ist.
Wenn du das Anthropic-SDK oder ein Tool wie Claude Code verwendest, das auf dem Anthropic-Format basiert, prüfe, ob die Plattform eine native Anthropic-Anbindung bietet. Setze dann die passende Basisadresse und die Umgebungsvariable für den Schlüssel gemäß Dokumentation. APIYI unterstützt sowohl das OpenAI- als auch das Anthropic-Schnittstellenformat. Maßgeblich für Adressen und Parameter ist die Dokumentation unter docs.apiyi.com – übernimm keine veralteten Adressen aus Anleitungen Dritter.
Bei der Anbindung empfehlen sich drei weitere Maßnahmen:
- Timeouts und Wiederholungsversuche abstufen: Setze den Verbindungs-Timeout kurz und den Lese-Timeout je nach Modell und Ausgabelänge länger. Wiederhole Anfragen nur bei 429- und 5xx-Fehlern und nutze exponentielles Backoff.
- Wichtige Felder protokollieren: Erfasse für jede Anfrage die Anfrage-ID, den Modellnamen, Eingabe- und Ausgabe-Token, die Dauer und den Statuscode. Das bildet die Grundlage für spätere Abrechnungsprüfungen und die Fehlersuche.
- Einen Ausweichkanal bereithalten: Halte mindestens eine alternative Verbindung bereit – etwa über einen anderen API-Proxy-Dienst oder direkt zum offiziellen Anbieter – und wechsle per Konfigurationsschalter.
🚀 Tipp für den schnellen Einstieg: Wenn du den oben beschriebenen 7-Tage-Ablauf zunächst mit geringem Anfragevolumen testen möchtest, kannst du dich bei APIYI unter apiyi.com registrieren und Testguthaben erhalten. Die Plattform bietet eine einheitliche API-Schnittstelle, die sowohl das OpenAI- als auch das Anthropic-Format unterstützt. Durch Ändern der
base_urlkannst du Shadow-Traffic für den Vergleich dorthin umleiten.
Modellabdeckung und Preisprüfung bei KI-API-Aggregationsdiensten
Prüfe bei der Auswahl, ob die benötigten Modelle tatsächlich verfügbar sind und wie die Preise berechnet werden. Die folgende Tabelle zeigt einige der aktuell bei APIYI verfügbaren Modelle und die auf der Preisseite angegebenen Einzelpreise. Für alle Preise gelten die tatsächlichen Angaben auf der APIYI-Preisseite unter https://docs.apiyi.com/models. Abrechnungseinheiten und aktuelle Änderungen findest du ebenfalls dort; die Zahlen in diesem Artikel dienen nur als Anhaltspunkt.
| Modell-ID | Einsatzgebiet | Einzelpreis für Eingabe / Ausgabe / Cache (APIYI-Preisseite) | Verfügbare Plattform |
|---|---|---|---|
| claude-opus-5-5 | Komplexe Schlussfolgerungen, umfangreiche Programmieraufgaben | $4 / $20 / $0.2 | APIYI apiyi.com |
| claude-sonnet-5-5 | Alltägliche Programmieraufgaben, Hauptmodell für Agenten | $2 / $10 / $0.1 | APIYI apiyi.com |
| kimi-k3.1-pro | Langer Kontext, chinesischsprachige Anwendungen | $2 / $10 / $0.2 | APIYI apiyi.com |
| deepseek-v4.1-flash | Hohe Parallelität, kostengünstige Stapelverarbeitung | $0.3 / $1.2 / $0.006 | APIYI apiyi.com |
| gpt-image-2.6-flare / sunburst | Bilderzeugung | Texteingabe $5, Bildeingabe $8, Ausgabe $30 | APIYI apiyi.com |
| qwen3.8 系列 | Allgemeine chinesischsprachige Aufgaben | Siehe Preisseite | APIYI apiyi.com |
Wichtig: Wenn deine Anwendung von der ERNIE-Modellreihe von Baidu abhängt, solltest du wissen, dass APIYI diese Modelle derzeit noch nicht anbietet. Wir werden sie so bald wie möglich bereitstellen; bis dahin solltest du deinen bisherigen Zugang beibehalten. Bei der Bewertung eines API-Proxy-Dienstes empfiehlt sich grundsätzlich, jedes benötigte Modell einzeln in der Preisliste zu prüfen. Lass dich nicht von pauschalen Aussagen wie „Hunderte Modelle werden unterstützt“ leiten.
💡 Empfehlung für die Auswahl: Multipliziere den Cache-Einzelpreis mit deiner tatsächlichen Cache-Trefferquote und addiere die Kosten für Ein- und Ausgabe, um die tatsächlichen Kosten zu ermitteln. Teste auf APIYI apiyi.com dieselben Anfragen mit Modellen wie Claude, Kimi und DeepSeek. Wähle dann nach dem Prinzip „niedrigste Kosten bei ausreichender Qualität“, statt nur auf den Einzelpreis zu schauen.
Häufig gestellte Fragen (FAQ)
Q1: Was ist ein aggregierender AI-API-Proxy-Dienst?
Ein aggregierender AI-API-Proxy-Dienst ist ein Gateway zwischen deiner Anwendung und den Modellanbietern. Er bündelt die Modelle mehrerer Anbieter unter einer einheitlichen Schnittstelle und übernimmt Authentifizierung, Routing, Abrechnung und Failover. Das vereinfacht die Integration und ermöglicht einen flexiblen Wechsel. Allerdings kommt eine weitere Abhängigkeit hinzu, deren Zuverlässigkeit du prüfen musst.
Q2: Ist ein AI-API-Proxy-Dienst zwangsläufig weniger zuverlässig als die direkte Anbindung an die offizielle API?
Nicht unbedingt. Bei einer direkten Anbindung bist du von einem einzigen Anbieter abhängig. Wenn dieser Anfragen begrenzt oder ausfällt, hast du keine Alternative. Ein API-Proxy-Dienst mit mehreren redundanten Upstream-Anbietern kann dagegen automatisch wechseln, wenn einer davon Probleme hat. Entscheidend ist die Qualität der Proxy-Ebene selbst. Prüfe sie deshalb anhand der 10 Kriterien in diesem Artikel, statt vorschnell ein Urteil zu fällen.
Q3: Wie oft sollte ich die Zuverlässigkeitskennzahlen eines AI-API-Proxy-Dienstes überprüfen?
Vor dem Produktivstart empfiehlt sich eine vollständige Prüfung über 7 Tage. Danach solltest du monatlich die Fehlerrate, die Latenzperzentile und Abweichungen bei der Abrechnung kontrollieren. Wenn die Plattform Modellversionen aktualisiert, Preise ändert oder dein Datenverkehr deutlich zunimmt, solltest du erneut Funktionstests und Lasttests durchführen.
Q4: In welchen Produktionsszenarien ist die Zuverlässigkeit eines aggregierenden AI-API-Dienstes besonders wichtig?
Vor allem in diesen Fällen:
– **Echtzeitdialoge für Endnutzer**: Die Zeit bis zum ersten Token und die Stabilität des Streamings wirken sich unmittelbar auf das Nutzererlebnis aus.
– **Coding-Agents und automatisierte Workflows**: Werden Felder bei Tool-Aufrufen verändert, kann der gesamte Ablauf fehlschlagen.
– **Stapelverarbeitung von Daten**: Limits für parallele Anfragen und eine korrekte Abrechnung entscheiden darüber, ob Aufgaben rechtzeitig und innerhalb des Budgets abgeschlossen werden.
Q5: Wie kann ich schnell per API prüfen, ob ein Proxy-Dienst die Anforderungen erfüllt?
Am einfachsten bindest du zunächst eine Plattform an, die mehrere Modelle unterstützt, und vergleichst sie anhand von Shadow Traffic:
1. Registriere dich bei APIYI auf apiyi.com und sichere dir Testguthaben.
2. Setze base_url auf `https://api.apiyi.com/v1` oder konfiguriere das Anthropic-Format anhand der Dokumentation auf docs.apiyi.com.
3. Kopiere einen kleinen Teil deiner tatsächlichen Anfragen und vergleiche Latenz, Fehlerrate und Unterschiede in den Antworten.
APIYI bietet API-Zugriff auf die in diesem Artikel genannten Modelle, darunter Claude, Kimi, DeepSeek, GPT Image und Qwen. So kannst du sie über dieselbe Schnittstelle vergleichen.
Q6: Welche Quelle ist für die Preise eines API-Proxy-Dienstes verbindlich?
Massgeblich ist die offizielle Preisseite der Plattform. Speichere ausserdem einen Screenshot oder notiere das Datum der Überprüfung. Bei APIYI gelten beispielsweise für die Eingabe-, Ausgabe- und Cache-Preise aller Modelle die Angaben auf https://docs.apiyi.com/models. Preisangaben in Blogs Dritter dienen nur als Orientierung, da sich Berechnungsgrundlagen und Aktualisierungszeitpunkte unterscheiden können.
Q7: Welche unvermeidbaren Einschränkungen haben aggregierende AI-API-Proxy-Dienste?
Jede Proxy-Ebene verursacht zusätzliche Latenz und schafft eine weitere mögliche Fehlerquelle. Ausserdem sind neue Modelle auf Proxy-Plattformen meist erst nach der offiziellen Veröffentlichung verfügbar. Bei manchen anbieterspezifischen Parametern kann es ebenfalls dauern, bis sie unterstützt werden. Halte daher eine direkte Anbindung an den offiziellen Anbieter oder einen zweiten Dienst als Ausweichlösung bereit und plane für kritische Geschäftsprozesse einen eingeschränkten Betrieb für den Fehlerfall ein.
Das Wichtigste zur Zuverlässigkeit von AI-API-Proxy-Diensten im Produktivbetrieb
- Zuverlässigkeit hat vier Ebenen: Verfügbarkeit, Leistung, Konsistenz und Steuerbarkeit sind gleichermaßen wichtig. Es reicht nicht, nur auf Ausfälle zu achten.
- Latenz unter Spitzenlast messen: Der zusätzliche Aufwand durch die Proxy-Schicht ist stabil und messbar. Schwankungen durch Warteschlangen bei hoher Last sind dagegen eine Hauptursache für Störungen.
- Auf ausgetauschte Modelle achten: Das Feld
modelprüfen und Regressionstests mit einem festen Aufgabensatz durchführen, um eine unbemerkte Herabstufung zu verhindern. - Auch die Abrechnung gehört zur Zuverlässigkeit: Auffällige Rechnungen deuten oft auf Cache-Ausfälle oder eine Flut von Wiederholungsversuchen hin. Deshalb regelmäßig abgleichen.
- Kompatibilität einzeln testen: Streaming, Tool-Aufrufe und Cache-Felder müssen mit echten Anfragen geprüft werden. Ein einfacher Hello-World-Test reicht nicht.
- Sieben Tage mit Shadow-Traffic testen: Ein Vergleich mit geringem Datenverkehr ist aussagekräftiger als eine Entscheidung aus dem Bauch heraus.
- Einstieg: Mit APIYI auf apiyi.com lassen sich mehrere Modelle über eine einheitliche Schnittstelle vergleichen. Maßgeblich sind die Preise auf der Preisseite.
Fazit
Bei der Auswahl eines AI-API-Proxy- oder Aggregationsdienstes für den Produktivbetrieb sind drei Punkte entscheidend:
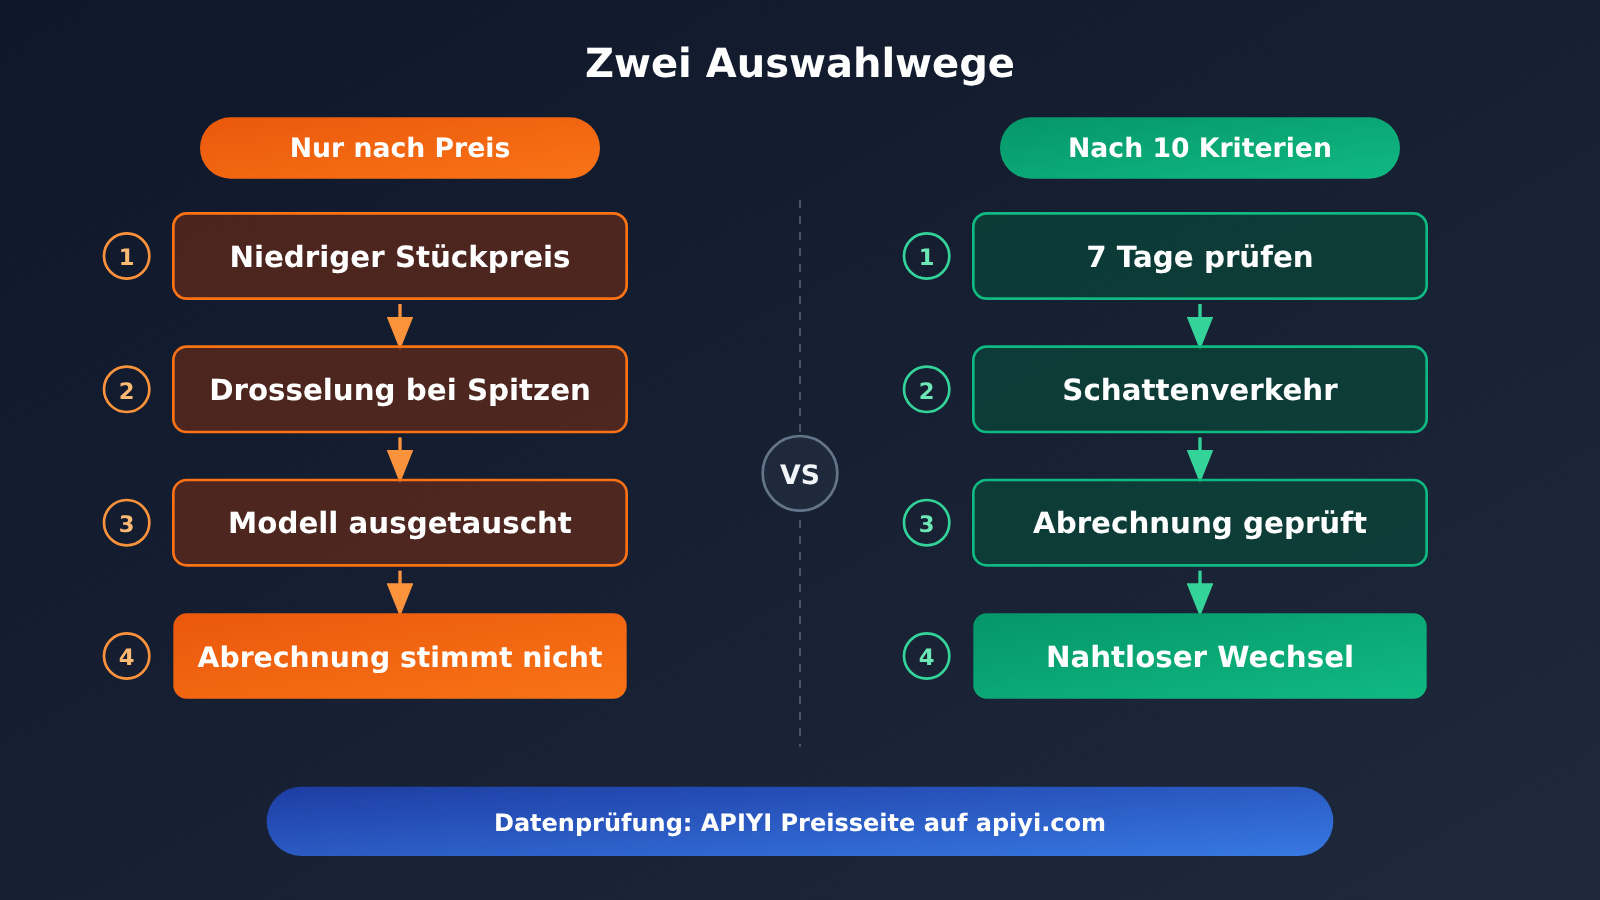
- Erst Kriterien festlegen, dann Preise vergleichen: Anhand von zehn Zuverlässigkeitskriterien ungeeignete Plattformen aussortieren und erst danach die Kosten der verbleibenden Anbieter vergleichen.
- Daten statt Werbeversprechen nutzen: Ein siebentägiger Test liefert Latenz-, Fehlerraten- und Abrechnungsdaten für den eigenen Anwendungsfall.
- Immer einen Ausweichplan bereithalten: Jede einzelne Verbindung kann ausfallen. Ein Ersatzkanal und ein Plan für eingeschränkten Betrieb gehören daher zum Standard im Produktivbetrieb.
Wenn Sie ein AI-API-Gateway für einen laufenden Dienst einführen möchten, testen Sie es zunächst mit der Bewertungstabelle aus diesem Artikel und geringem Datenverkehr. Für eine schnelle Prüfung bietet sich APIYI auf apiyi.com an. Die Plattform ist mit den Schnittstellenformaten von OpenAI und Anthropic kompatibel. Modelle und Preise können Sie direkt auf der Preisseite https://docs.apiyi.com/models prüfen; Details zur Anbindung finden Sie im Dokumentationszentrum docs.apiyi.com.
📚 Referenzen
- APIYI-Preisseite: Modellliste und Stückpreise für Eingabe, Ausgabe und Cache
- Link:
docs.apiyi.com/models -
Hinweis: Diese Seite ist die Grundlage für alle APIYI-Preisangaben in diesem Artikel
-
APIYI-Dokumentation: Anleitungen zur Anbindung im OpenAI- und Anthropic-Format
- Link:
docs.apiyi.com -
Hinweis: Enthält Informationen zur base_url-Konfiguration, zu Modell-IDs und häufigen Fragen
-
Ofox.ai Blog: Bewertung der Zuverlässigkeit von OpenRouter im Produktionsbetrieb und Bericht über Claude-Abrechnungsprobleme
- Link:
ofox.ai/blog/page/39 -
Hinweis: Quelle für die Angaben zu Ausfällen, zusätzlicher Latenz und Gebühren bei Drittanbietern; dient nur zum Vergleich
-
Ofox.ai Blog: Berichte über Claude-Ratenbegrenzungen zu Spitzenzeiten und Probleme bei der Cache-Abrechnung
- Link:
ofox.ai/blog/page/36 - Hinweis: Verdeutlicht, warum eine Prüfung der Abrechnung notwendig ist; dient nur zum Vergleich
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns über die APIYI-Startseite apiyi.com, um Erfahrungen zur Auswahl eines AI-API-Gateways auszutauschen. Weitere Anleitungen zur Anbindung finden Sie in der Dokumentation unter docs.apiyi.com.


