
ملاحظة المؤلف: كلاهما نموذج رائد من فئة 2.4T. Qwen4-Max بسعر معلن أقل بنسبة 25%، وحدّ الإخراج الأقصى تضاعف نحو ثلاث مرات، واستهلاك الـ tokens للمهمة نفسها أقل بنسبة 20 إلى 30%. يفكك هذا المقال البنية، ونتائج التقييم التي أعلنتها الشركة رسميًا، والأسعار المعلنة للجيلين، ويقدّم قائمة تحقق للترحيل من qwen3.8-max.
في 2026-11-16 أعلنت علي بابا (Alibaba) عن Qwen4-Max. نبدأ بالخلاصة: مقارنةً بـ Qwen3.8-Max، سعر الإدخال وسعر الإخراج المعلنان لكل منهما أقل بنسبة 25%، والحد الأقصى للإخراج ارتفع من 128K إلى 393K، أي نحو ثلاثة أضعاف، وفي تقييم Work360 الرسمي استهلاك الـ tokens للمهمة نفسها أقل بنسبة 20 إلى 30%. أما الفرق التي تشغّل qwen3.8-max في بيئة الإنتاج، فهذه الترقية تستحق تقييمًا جديًا، لكنها لا تتطلب إعادة البناء من الصفر.
هذا ليس مقالًا دعائيًا من نوع «الجيل الجديد يتفوق على كل شيء». جميع نتائج التقييم أدناه مُعلَّمة بأنها مقاييس رسمية أعلنتها الشركة، أما لوحات التصنيف الخارجية فمُعلَّمة بأنها لقطة من لوحة تصنيفات عامة (2026-11-14). وهناك رقمان يُسهل المبالغة فيهما، وهما انخفاض تكلفة المهمة الواحدة بنسبة 62% والمركز السادس في Arena، وسنفصّلهما على حدة.
القيمة الأساسية: بعد القراءة ستكون قادرًا على تقدير ثلاثة أمور: أي جزء من المال الموفَّر هو حقيقي فعلًا، وأي المعايير ارتفعت بشكل واضح وأيها لم تتحرك تقريبًا، وما الذي يجب تغييره عند الترحيل إلى جانب معرّف النموذج. وإضافةً إلى ذلك، إذا كنت تستدعي النماذج عبر APIYI apiyi.com، فحتى 2026-11-16 11:00 لم تكن المنصة قد أدرجت qwen4-max بعد؛ في هذه المرحلة يمكنك الاستمرار في استخدام qwen3.8-max، وسنضيف هذا النموذج في أقرب وقت.
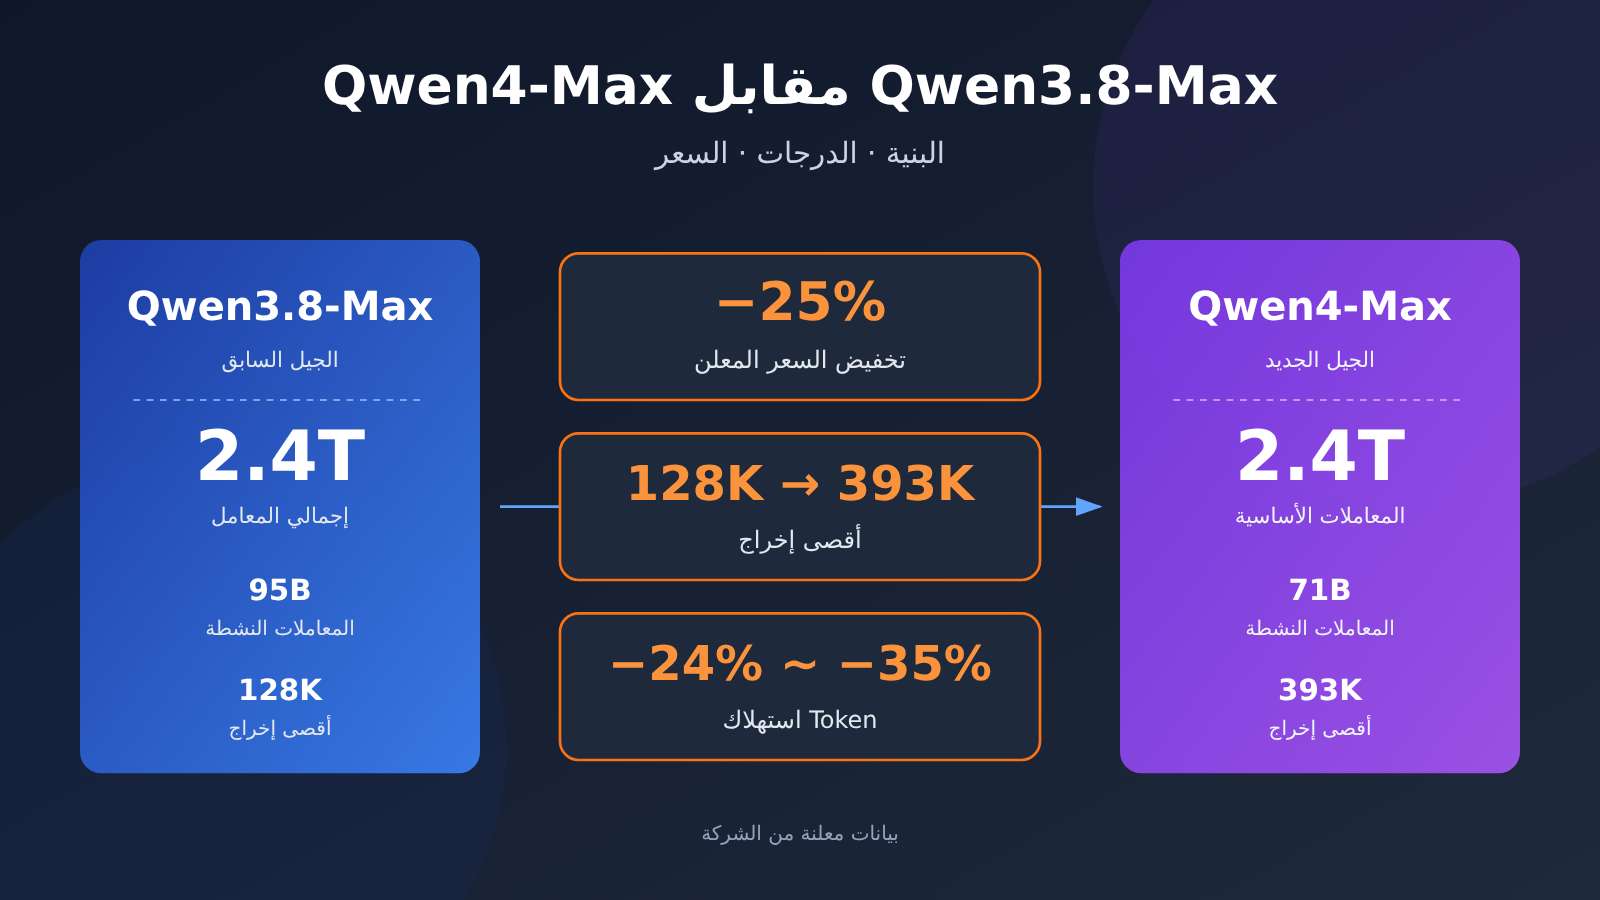
نظرة سريعة على أبرز الفروق بين Qwen4-Max وQwen3.8-Max
يقع الجيلان من النموذجين في الحجم الكلي نفسه، لكن Qwen4-Max أدخل تعديلات على المعاملات المنشَّطة، وسقف الإخراج، والمستوى الافتراضي للاستدلال. يعرض الجدول التالي أولًا الفروق على مستوى المواصفات، بينما تُترك الأسعار لقسم التكلفة اللاحق.
| بُعد المقارنة | Qwen3.8-Max | Qwen4-Max | التغيير |
|---|---|---|---|
| حجم المعاملات | 2.4T معامل إجمالي | هيكل رئيسي 2.4T + 328B تضمين N-gram | الهيكل الرئيسي في المستوى نفسه، مع جدول تضمين جديد |
| ما يُنشَّط في كل استدعاء | 95B | 71B | أقل بنحو 25% |
| السياق | 1M | 1M (الحد الأقصى للإدخال 991K، وضع التفكير 983K) | سقف الإدخال أضيق قليلًا |
| الحد الأقصى للإخراج | 128K | 393K | نحو 3 أضعاف |
| الحد الأقصى لسلسلة التفكير | غير مذكور منفصلًا رسميًا | 262K | سقف صريح جديد |
| reasoning_effort الافتراضي | xhigh | high | خفض المستوى الافتراضي بدرجة واحدة |
| القدرات البصرية | يدعم إدخال الصور | رؤية أصلية | الرؤية أصبحت قدرة أصلية |
| الأوزان المفتوحة | Qwen3.8-2.4T-A95B | غير مذكورة في المصادر | — |
من هذا الجدول يمكن استقراء منطق هذه الترقية: الحجم الكلي ثابت، والحساب لكل مرة أقل كلفة، ومساحة الإخراج أوسع. انخفاض المعاملات المنشَّطة من 95B إلى 71B هو الشرط الأساسي الذي أتاح خفض السعر المعلن؛ أما توسيع الحد الأقصى للإخراج إلى 393K فيغيّر مباشرةً جدوى مهام مثل التقارير الطويلة وتوليد كتل الشيفرة الكبيرة.
يجدر الانتباه إلى أن reasoning_effort الافتراضي انتقل من xhigh إلى high. إذا لم تكن شيفرتك تضبط هذا المعامل صراحةً، فإن مستوى الاستدلال الفعلي سيتغير بعد تبديل معرّف النموذج، وهذه النقطة سنؤكد عليها مجددًا في قائمة الترحيل.
تغييرات بنية Qwen4-Max: كيف تؤثر التغييرات الثلاثة في الاستخدام
لخّصت المدونة الرسمية تغييرات بنية Qwen4-Max في ثلاثة تعديلات رئيسية: GDN + QSA، وGated Residual بأربعة فروع، وN-gram Embedding. وبالنسبة لمستخدمي API، لا حاجة إلى فهم تفاصيل التنفيذ طبقة بطبقة، لكنهم يحتاجون إلى معرفة ما يؤثر فيه كل تعديل من هذه التعديلات الثلاثة.
GDN + QSA: تغيير على مستوى الانتباه
هذا تعديل في بنية الانتباه. وقد قدّمته الجهة الرسمية إلى جانب سياق 1M وأقصى إخراج 393K، وفهمنا أنه يخدم أساسًا كفاءة الحساب في سيناريوهات التسلسلات الطويلة. وبالنسبة لجهة الاستدعاء، فالنتيجة الملموسة مباشرة هي: مع نافذة السياق نفسها البالغة 1M، يستطيع Qwen4-Max إنتاج إخراج أطول، مع سعر وحدة أقل في المقابل.
Gated Residual بأربعة فروع
وُسّعت اتصالات البقايا إلى أربعة فروع مزودة ببوابات. وعادةً ما تؤثر هذه التعديلات في استقرار التدريب وتدفق المعلومات بين القدرات المختلفة، ثم تظهر في النهاية في سلوك النموذج. ويتمثل التأثير العملي في أنه حتى مع بقاء الموجه نفسه دون تغيير، قد يختلف أسلوب إخراج Qwen4-Max وطول خطوات الاستدلال عن الجيل السابق، لذلك تحتاج الموجهات التي ضُبطت بدقة لـ Qwen3.8-Max إلى اختبار انحدار.
N-gram Embedding: معلمات 328B لا تعني حجم الحساب
صيغة معلمات Qwen4-Max هي «2.4T للعمود الفقري / 71B تنشيط + 328B N-gram Embedding». ووفق التصميم الشائع، تنتمي هذه الأنواع من التضمينات إلى معلمات البحث في جدول، ولا تُحتسب ضمن حساب تنشيط العمود الفقري لكل token، لذلك لا يمكن إضافة 328B مباشرة إلى كمية التنشيط للمقارنة. أما ما يرتبط فعليًا بتكلفة الاستدلال فهو 71B مقابل 95B، أي أقل بنحو 25% في كل تنشيط.
وعلى مستوى التدريب المسبق، أوردت الجهة الرسمية أن Qwen4-Max-Base سجّل أدنى قيم BPB (بت لكل بايت، وكلما انخفض كان أفضل) في التقييمات الداخلية الأربعة: المعرفة، والبرمجة، والأسئلة والأجوبة، وSTEM، إذ جاءت أقل بنحو 5–13% من Qwen3.8-Max-Base. هذا تقييم داخلي رسمي، لكنه على الأقل يوضح أن النموذج الأساسي نفسه قد تحسّن، وأن التحسينات اللاحقة في نتائج الاختبارات لم تعتمد فقط على التدريب اللاحق.
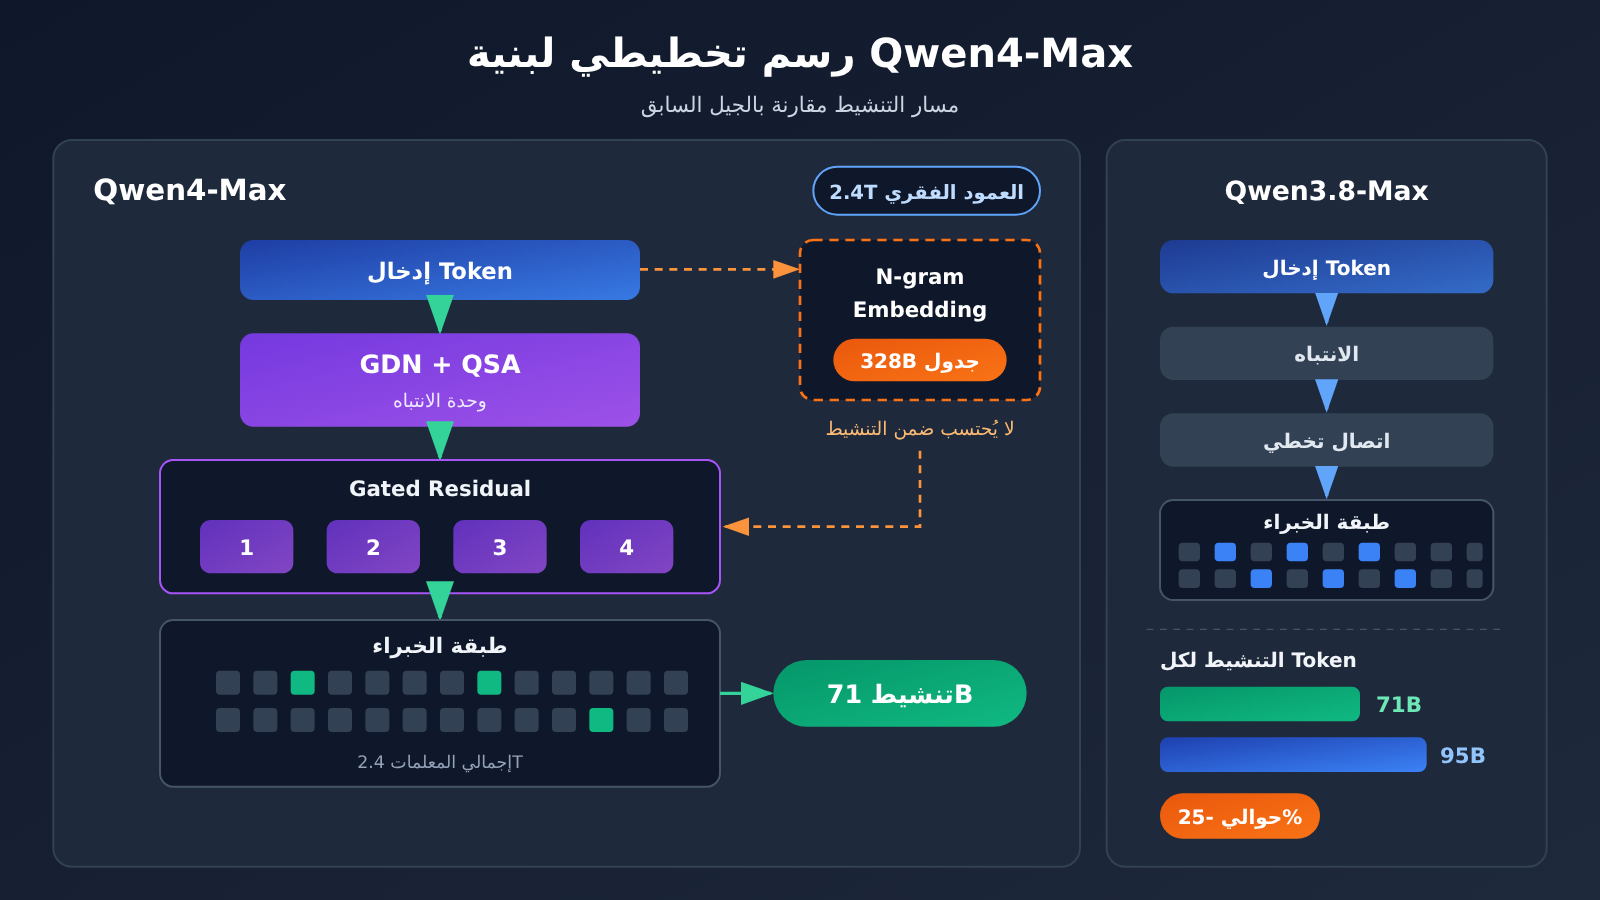
مقارنة نتائج Qwen4-Max: ما الذي ارتفع كثيرًا وما الذي لم يتغيّر تقريبًا
جميع البيانات أدناه مأخوذة من الرسم البياني نفسه الذي نشرته Alibaba، وهي بيانات رسمية مُبلّغ عنها من الشركة، ومقارنةً بـ Qwen3.8-Max-0902 (النسخة المحدّثة في سبتمبر). رتّبناها تنازليًا حسب حجم التحسن، لتظهر مباشرة أين تتركّز مكاسب الترقية.
| المعيار (مُبلّغ عنه رسميًا) | Qwen3.8-Max-0902 | Qwen4-Max | الفرق | تقييم حجم التحسن |
|---|---|---|---|---|
| AA-Briefcase | 1605 | 1686 | +81 | واضح |
| CodeArena | 1676 | 1750 | +74 | واضح |
| HealthBench | 39.6 | 60.0 | +20.4 | واضح جدًا |
| AutomationBench | 56.2 | 72.5 | +16.3 | واضح جدًا |
| Chartography | 42.0 | 54.2 | +12.2 | واضح |
| Terminal-Bench | 38.9 | 48.5 | +9.6 | واضح |
| APEX-Agents | 63.3 | 72.1 | +8.8 | واضح |
| HLE | 43.9 | 51.7 | +7.8 | واضح |
| DeepSWE | 69.3 | 75.7 | +6.4 | متوسط |
| HLAB-Vals | 15.4 | 21.3 | +5.9 | متوسط |
| Video-Index | 63.2 | 68.1 | +4.9 | متوسط |
| ProgramBench | 28.0 | 31.5 | +3.5 | صغير |
| JobBench | 65.3 | 68.5 | +3.2 | صغير |
| BioMystery | 84.1 | 85.0 | +0.9 | لم يتغيّر تقريبًا |
تتركّز أكبر التحسينات في مهام الوكلاء واستدعاء الأدوات: AutomationBench +16.3، وTerminal-Bench +9.6، وAPEX-Agents +8.8. وإذا كانت أعمالك تعتمد على استدعاء الأدوات في جولات متعددة، أو عمليات الطرفية، أو تدفقات الأتمتة، فهذا هو المجال الذي تعود منه الترقية بأكبر فائدة. كما ارتفع HealthBench من 39.6 إلى 60.0، وارتفع Chartography بمقدار 12.2، ما يشير إلى أن الأسئلة الطبية وفهم الرسوم البيانية من نقاط التركيز في هذا الجيل أيضًا.
وفي الطرف المقابل، ارتفع BioMystery بمقدار 0.9 فقط، بينما زاد JobBench وProgramBench قليلًا فوق 3 نقاط. الفائدة الحدّية من الترقية في هذه الأنواع من المهام محدودة؛ وإذا كانت سيناريوهاتك الأساسية قريبة منها، فإن نتائج التقييم وحدها لا تكفي لدعم قرار الترقية، وينبغي النظر إلى التكلفة. كما أعلنت الشركة عن نتيجة Work360: 52.69 مقابل 47.74، أي بفارق 4.95، وهو تحسن متوسط.
أما من ناحية الأمان، فقد أعلنت الشركة أن معدل النجاح المزدوج على مستوى الدوال في Last Secure Code Bench ارتفع من 22.0% إلى 31.8%، كما ارتفع معدل الأمان المتزامن وفق المعايير الثلاثة من 8% إلى 14.7%. لا تزال القيم المطلقة غير مرتفعة، ولا يزال الكود المولّد يحتاج إلى مراجعة أمنية، لكن التحسن النسبي واضح.
لوحة Arena التابعة لطرف ثالث: مرتبة Preliminary مع 1,814 صوتًا
درجة 1750 في CodeArena الرسمية يمكن رؤيتها أيضًا على لوحة Code Arena WebDev التابعة لطرف ثالث على arena.ai. فيما يلي لقطة من اللوحة العامة بتاريخ 2026-11-14:
- Qwen4-Max (xHigh): 1750 نقطة، المركز السادس، موسوم بـ Preliminary، 1,814 صوتًا، $4.18/مهمة
- Qwen3.8-Max (0902): 1676 نقطة، المركز 16، 23,030 صوتًا، $1.91/مهمة
- Qwen3.8-Max: 1670 نقطة، المركز 18
هناك نقطة ثانية يسهل المبالغة فيها هنا: Qwen4-Max لديه 1,814 صوتًا فقط، بينما النسخة السابقة 0902 لديها 23,030 صوتًا، أي فرق يقارب 12 ضعفًا. وجود علامة Preliminary يعني أن الترتيب لا يزال في طور الاستقرار، وأن المركز السادس قد يتغير، لذا يُفضّل عند الاقتباس الآن كتابة «ترتيب أولي بالمركز السادس».
وفي اللقطة تفصيل آخر يستحق الانتباه: شارك Qwen4-Max في فئة xHigh، وبلغت تكلفة المهمة $4.18، وهي أعلى من $1.91 لدى Qwen3.8-Max 0902. هذا لا يتعارض مع قول الجهة الرسمية إن «تكلفة المهمة الواحدة انخفضت»، لأن الفئة ونوع المهام مختلفان، لكنه يذكّرنا بأن Qwen4-Max، عند أعلى فئة استدلال، ليس بالضرورة أكثر توفيرًا.
أسعار Qwen4-Max والتكلفة: ما مقدار التوفير الحقيقي؟
الترقية في جوهرها تعني تغيير النموذج، وقبل اتخاذ القرار لا بد أولًا من مقارنة الأسعار. يوضح الجدول التالي الأسعار الرسمية المعلنة للجيلين، إلى جانب سعر qwen3.8-max المعروض حاليًا على APIYI، وجميع الوحدات محسوبة لكل 1M tokens، بتاريخ 2026-11-16.
| بند الفوترة (لكل 1M tokens) | Qwen3.8-Max الرسمي (منطقة سنغافورة) | Qwen4-Max الرسمي | Qwen4-Max الرسمي باليوان | سعر qwen3.8-max الحالي على APIYI |
|---|---|---|---|---|
| الإدخال | $2 | $1.5 | ¥10 | $1.65 |
| الإخراج | $6 | $4.5 | ¥30 | $4.95 |
| قراءة الذاكرة المؤقتة | $0.25 | $0.075 | ¥0.5 | $0.20625 |
| كتابة الذاكرة المؤقتة (5 دقائق) | غير مذكورة في مدونة الشركة الرسمية | $1.875 | ¥12.5 | غير مذكورة بشكل منفصل في الوثائق |
| كتابة الذاكرة المؤقتة (ساعة واحدة) | غير مذكورة في مدونة الشركة الرسمية | $3 | ¥20 | غير مذكورة بشكل منفصل في الوثائق |
انخفض سعر الإدخال والإخراج بنسبة 25% لكل منهما، وتراجعت قراءة الذاكرة المؤقتة من $0.25 إلى $0.075، أي بنحو 70%، وهي أكبر نسبة خفض في تعديل الأسعار هذا. من ناحية أخرى، يحدد Qwen4-Max بوضوح سعرين لكتابة الذاكرة المؤقتة: فئة 5 دقائق وفئة ساعة واحدة، لذا على التطبيقات التي تعيد استخدام المقدمات الطويلة بوتيرة عالية أن تحتسب تكلفة الكتابة هذه ضمن ميزانيتها.
توفير الرموز (tokens): بين 20% و30% على Work360، وبين 40% و50% على Terminal-Bench
تقدم الجهة الرسمية مجموعتين من البيانات حول توفير الرموز (tokens). على Work360، تنخفض الرموز بنسبة 24% في فئة Xhigh و35% في فئة High، وهنا مصدر عبارة «توفير بين 20% و30%». وعلى Terminal-Bench 4.0 يكون الانخفاض أكبر، إذ يبلغ 48% و49% على التوالي.
يبدو أن نسبة التوفير أكبر بوضوح في مهام الطرفية (terminal)، وقد يكون ذلك مرتبطًا بانخفاض عدد جولات الأدوات في هذا النوع من المهام. عند إعداد الميزانية، يكون تقدير المهام المكتبية العامة بنسبة 20%–30% أكثر أمانًا، أما 40%–50% فلا ينطبق إلا على سيناريوهات تشغيل الطرفية المشابهة لـ Terminal-Bench.
النقاط الـ11 التي لا تتوافق فيها نسبة 62% مع 51%
هذه أول نقطة يسهل المبالغة فيها. تذكر الجهة الرسمية أن تكلفة المهمة الواحدة انخفضت من $4.43 إلى $1.67، أي انخفاض بنحو 62% بالدولار؛ بينما تكتب الصيغة الصينية من ¥26.58 إلى ¥11.16، أي انخفاض بنحو 58%. والنسختان متعارضتان في الأساس.
وبالحساب من البيانات الرسمية نفسها: انخفاض الرموز بنسبة 35% وانخفاض سعر الوحدة بنسبة 25%، وحاصل ضربهما لا يعطي سوى انخفاض بنحو 51%، أي 0.65 × 0.75 ≈ 0.49. أما الـ11 نقطة المتبقية فلم تقدم الجهة الرسمية تفسيرًا لها. نرجّح أنها قد تأتي من مكسب إصابة الذاكرة المؤقتة الناتج عن الانخفاض الكبير في سعر قراءة الذاكرة المؤقتة (نحو −70%)، ومن انخفاض عدد جولات استدعاء الأدوات؛ لكن هذا مجرد استنتاج وليس تفسيرًا رسميًا.
النهج الأكثر أمانًا هو اعتبار 51% سقفًا مرجعيًا «عند نفس معدل إصابة الذاكرة المؤقتة»، ولا يمكن الاقتراب من 62% إلا في السيناريوهات التي يكون فيها معدل إصابة الذاكرة المؤقتة مرتفعًا وعدد جولات الأدوات كبيرًا. وبالنسبة إلى عملك تحديدًا، فإن الأساس الأكثر موثوقية هو تشغيل مقارنة لتكلفة المهمة الواحدة باستخدام بيانات استخدام حقيقية.
أسعار APIYI الحالية وحالة الإدراج
تتوفر حاليًا على APIYI نسخة qwen3.8-max بسعر إدخال $1.65، وإخراج $4.95، وقراءة من الذاكرة المؤقتة $0.20625؛ وبحسب وثائق المنصة، فإن هذا أقل بنسبة 17.5% من سعر Alibaba Cloud البالغ $2 / $6. وبالسعر نفسه يأتي أيضًا qwen3.8-max-0902، أما النسخة مفتوحة الأوزان qwen3.8-2.4t-a95b فسعرها $1.72 / $5.16 / $0.215.
عند المراجعة في 2026-11-16 الساعة 11:00، لم يكن qwen4-max موجودًا بعد في وثائق النماذج وقائمة الأسعار على APIYI (البالغ عددها 284 نموذجًا)، أي أنه لم يُدرج بعد. سنعمل على إدراج هذا النموذج في أقرب وقت، وتُعتمد أسماء النماذج وأسعارها وفق قائمة النماذج على منصة APIYI عبر apiyi.com. وبصراحة، فإن سعر الوحدة الرسمي المعلن لـ Qwen4-Max أصبح أقل من سعر qwen3.8-max الحالي على المنصة، لذا يستحق الأمر إعادة مراجعة الحسابات بعد إدراجه.
الانتقال من Qwen3.8-Max إلى Qwen4-Max: قائمة تحقق
كثيرون يظنون أن الترقية مجرد تغيير معرّف النموذج، لكن الحقيقة أن المعاملات الافتراضية وحدود السياق وفوترة التخزين المؤقت كلها تغيّرت. هذه القائمة مرتبة وفق أولوية «التغييرات التي قد تسبب مشكلة إن لم تُنفّذ».
| بند التحقق | الوضع الحالي في Qwen3.8-Max | بعد الانتقال إلى Qwen4-Max | الإجراء المقترح |
|---|---|---|---|
| معرّف النموذج | qwen3.8-max / qwen3.8-max-0902 |
حسب قائمة الطُرز على المنصة | انتظر الإتاحة ثم بدّل، وابدأ بنشر تدريجي |
| القيمة الافتراضية لـ reasoning_effort | xhigh | high | اكتب المستوى صراحةً لتجنّب تغيّر السلوك دون ملاحظة |
| الحد الأعلى لـ max_tokens | 128K | 393K | راجع الاقتطاع في الأنظمة اللاحقة، وإعدادات التخزين والمهلات |
| الحد الأقصى للإدخال | 1M | 991K (983K في وضع التفكير) | المدخلات الطويلة جدًا القريبة من 1M تحتاج إلى تقليص |
| فوترة التخزين المؤقت | قراءة من التخزين المؤقت $0.25 | قراءة من التخزين المؤقت $0.075، مع سعر كتابة لمدة 5 دقائق / ساعة واحدة | أعد تقييم بادئة التخزين المؤقت واستراتيجية TTL |
| المدخلات البصرية | إدخال صور | رؤية أصلية | أعد اختبار حالات الاستخدام المتعلقة بالصور |
| الموجه وتنسيق الإخراج | مُحسّنان للجيل السابق | تغيّر في المعمارية، وقد يختلف السلوك | نفّذ اختبار انحدار بمجموعة تقييم ثابتة |
| مراقبة التكاليف | تُحسب بعدد tokens | ينخفض عدد tokens وسعر الوحدة معًا | راقب تكلفة المهمة الواحدة بدلًا من سعر الوحدة |
أكثر ما يُغفَل في القائمة هو reasoning_effort. فـ Qwen3.8-Max يعتمد xhigh افتراضيًا، بينما Qwen4-Max يعتمد high. إذا لم يُضبط صراحةً في الشيفرة، فقد يستهلك عددًا أقل من tokens بعد التبديل، وقد يأتي دون المستوى المتوقع في مهام الاستدلال المعقدة. البيانات الرسمية لتوفير tokens تشمل المستويين Xhigh وHigh، لذا يُنصح باختبار كل مستوى على حدة ثم تحديد المستوى المستخدم في بيئة الإنتاج.
والثاني هو طول الإخراج. فحد 393K يعني أن الاستجابة الواحدة قد تكون أطول بكثير مما كانت عليه سابقًا. وإذا كانت أنظمة السجلات وحقول قواعد البيانات ومهلات البوابة مصممة على إخراج 128K، فيجب توسيعها مسبقًا. كما انخفض الحد الأقصى للإدخال من 1M إلى 991K (983K في وضع التفكير)؛ والأعمال التي لا تقترب عادةً من الحد لن تتأثر كثيرًا، أما الحالات التي تحزم المستندات حتى الحد الأقصى فستتلقى أخطاء مباشرة.
الطريقة الحالية للاستدعاء عبر APIYI
إذا كنت تتصل الآن عبر APIYI، فإن base_url هو https://api.apiyi.com/v1، وتستخدم بروتوكولًا متوافقًا مع OpenAI، ويكفي أن تضع qwen3.8-max في حقل model لمواصلة التشغيل في بيئة الإنتاج. وإذا أردت تثبيت سلوك النسخة المحدّثة الصادرة في سبتمبر، يمكنك استخدام qwen3.8-max-0902 بدلًا منها، فالسعر نفسه.
بعد إتاحة qwen4-max على المنصة، ولأن البروتوكول لن يتغير، لن يتطلب الترحيل على مستوى الشفرة سوى تعديل حقل model، ثم استكمال reasoning_effort وmax_tokens وفق القائمة أعلاه. ننصح أولًا بتوجيه 5%–10% من حركة المرور إلى إطلاق تدريجي، ومقارنة تكلفة المهمة الواحدة ومؤشرات الأعمال، ثم الانتقال إلى التبديل الكامل.
🚀 توصية للترحيل: يمكن للمشروعات التي تستخدم APIYI عبر apiyi.com الآن الاستمرار في
qwen3.8-max، مع تجهيز مجموعة التقييم ومفتاح الإطلاق التدريجي في الوقت نفسه؛ وبعد إتاحةqwen4-maxغيّر المعرّف فقط. بهذه الطريقة لن تتعرض أعمالك لتوقف بسبب انتظار النموذج الجديد.
توصيات استخدام Qwen4-Max وQwen3.8-Max حسب السيناريو
السيناريوهات التي يُفضّل فيها تقييم الترقية إلى Qwen4-Max
- استدعاء الأدوات على مدى جولات متعددة والأتمتة: حققت AutomationBench وTerminal-Bench وAPEX-Agents تحسنًا ملحوظًا، كما أن توفير الرموز (tokens) هو الأكبر في مهام الطرفية.
- مهام الإخراج الطويل جدًا: عندما تحتاج إلى توليد تقرير أو كود أو مستند يتجاوز 128K في مرة واحدة، فإن سعة 393K لدى Qwen4-Max وحدها هي القادرة على تلبية ذلك.
- الأسئلة الطبية وفهم المخططات: ارتفع HealthBench بمقدار +20.4 وChartography بمقدار +12.2، وهما من أبرز مجالات التحسن في هذا الجيل.
- الحاجة إلى أمان الكود: ارتفع معدل الاجتياز المزدوج لاختبارات الأمان من 22.0% إلى 31.8%، لكنه لا يزال يتطلب عملية مراجعة مرافقة.
- التطبيقات ذات معدل إعادة استخدام مرتفع للذاكرة المؤقتة: انخفض سعر قراءة الذاكرة المؤقتة بنحو 70%، وتستفيد أكثر السيناريوهات ذات الموجهات النظامية الطويلة وبادئات قواعد المعرفة الثابتة.
السيناريوهات التي يُفضّل فيها الاستمرار باستخدام Qwen3.8-Max
- مستقر في الإنتاج مع موجهات مُحسّنة بعمق: يبقى Qwen3.8-Max نموذجًا إنتاجيًا موثوقًا، وليست هناك حاجة إلى الترقية لمجرد الترقية.
- المهام الرئيسية المشابهة لـ BioMystery وJobBench: التحسن في هذه الاتجاهات محدود، وقد تكون تكلفة الانتقال أعلى من العائد.
- الحاجة إلى نشر ذاتي بأوزان مفتوحة: تتوفر أوزان مفتوحة لـ Qwen3.8-2.4T-A95B، ولم ترد في المواد نسخة بأوزان مفتوحة من Qwen4-Max.
- الاستدعاء عبر APIYI مع الحاجة إلى إتاحة فورية: ما دام
qwen4-maxغير مدرج بعد، فإنqwen3.8-maxخيار جاهز.
| حالتك | التوصية |
|---|---|
| التركيز على الوكلاء الأذكياء واستدعاء الأدوات، مع هدف خفض التكلفة | قيّم Qwen4-Max أولاً، واختبر التكلفة على المستوى High |
| الحاجة إلى إخراج واحد يتجاوز 128K | اختر Qwen4-Max فقط |
| بيئة إنتاج مستقرة، والاستخدام أساسًا للأسئلة العامة | أبقِ Qwen3.8-Max، ونفّذ اختبارات انحدار في وقت الفراغ |
| الحاجة إلى نشر ذاتي بأوزان مفتوحة | واصل استخدام Qwen3.8-2.4T-A95B |
| الاتصال الحالي عبر APIYI | واصل استخدام qwen3.8-max، ثم بدّل تدريجيًا بعد الإدراج |
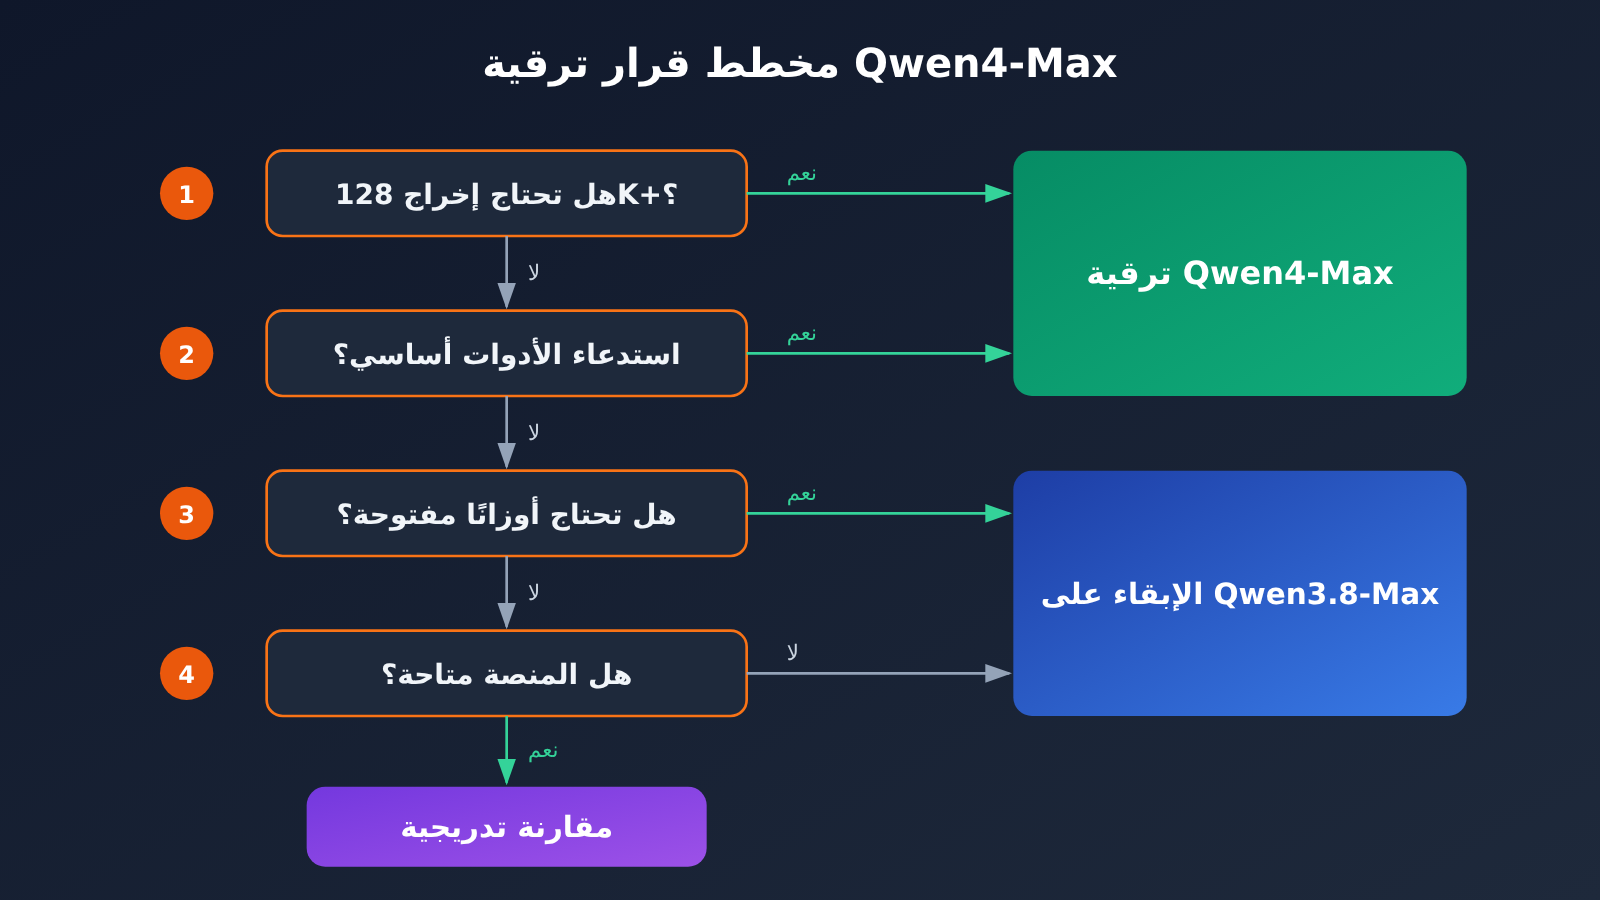
توصيات القرار: Qwen4-Max مقابل Qwen3.8-Max
إذا أردنا تلخيصها في جملة واحدة: أعمال الوكلاء الأذكياء والمخرجات الطويلة والأعباء كثيفة الاعتماد على التخزين المؤقت تستحق الترقية، أما الأعمال العامة المستقرة فيمكن تأجيلها دون قلق.
من بين المكاسب الثلاثة للترقية، انخفاض سعر الوحدة بنسبة 25% أمر مؤكد، وتوفير الرموز (tokens) بنسبة تتراوح بين 20% و30% هو بيانات رسمية على تقييمات محددة، أما انخفاض تكلفة المهمة الواحدة بنسبة 62% فيتطلب أن تتوافق ظروف التخزين المؤقت وعدد دورات استدعاء الأدوات لديك كي يمكن الاقتراب منه.
💡 توصية الاختيار: قبل اتخاذ القرار، يُفضّل تشغيل مجموعة اختبارات على مهامك الحقيقية لكل نموذج على حدة، ثم مقارنة تكلفة المهمة الواحدة وجودة النتائج، بدلًا من الاكتفاء بالنظر إلى جدول الدرجات. عبر APIYI (apiyi.com) يمكنك استخدام مفتاح API نفسه لتشغيل خط الأساس
qwen3.8-maxأولًا، وبعد إتاحةqwen4-maxيمكنك المقارنة مباشرة ضمن مجموعة الشيفرة نفسها.
الأسئلة الشائعة (FAQ)
س1: ما العلاقة بين Qwen4-Max وQwen3.8-Max؟
كلاهما طراز رائد من عائلة Tongyi Qianwen بفئة 2.4T. صدر Qwen3.8-Max في 2026-08-03، أما 0902 فهو نسخة محدّثة من سبتمبر؛ وصدر Qwen4-Max في 2026-11-16 بمعمارية جديدة، حيث انخفض عدد المعاملات المنشّطة في كل استدعاء من 95B إلى 71B، وارتفع حدّ الإخراج إلى 393K، وخُفّض السعر المعلن بنسبة 25%.
س2: إذا وفّرنا 20% إلى 30% من الـ tokens، فهل تنخفض الفاتورة بالنسبة نفسها؟
ليس بالضرورة، وقد يكون الانخفاض أكبر. فسعر الوحدة نفسه انخفض بنسبة 25%، ومع انخفاض استهلاك الـ tokens، يمكن نظريًا أن تنخفض تكلفة المهمة نفسها بنحو 51%. لكن بيانات توفير الـ tokens تأتي من تقييم Work360 الرسمي، ومقدار ما يمكن أن توفره أعمالك يحتاج إلى قياس فعلي؛ وإذا استخدمت مستوى xhigh، كما يوضح ملخص Arena، فقد تكون تكلفة المهمة الواحدة أعلى في الواقع.
س3: يحتل Qwen4-Max المرتبة السادسة في Arena، فهل هذه المرتبة موثوقة؟
يمكن اعتبارها نتيجة أولية فقط. ففي ملخص لوحة التصنيف العام (2026-11-14) لم يحصل Qwen4-Max إلا على 1,814 صوتًا مع وسم Preliminary، بينما حصل الجيل السابق 0902 على 23,030 صوتًا، أي فرق يقارب 12 ضعفًا. الدرجة 1750 تتوافق مع ما أعلنته الجهة الرسمية، لكن المرتبة ستتغيّر بعد تراكم الأصوات.
س4: هل يمكن الآن استدعاء qwen4-max عبر APIYI؟
حتى 2026-11-16 11:00 ليس ذلك ممكنًا بعد، فـ `qwen4-max` لم يُطرح حتى الآن، وسنطرحه في أقرب وقت. المتاح حاليًا هو `qwen3.8-max` و`qwen3.8-max-0902` والإصدار مفتوح الأوزان `qwen3.8-2.4t-a95b`. ويُرجى الاعتماد على قائمة الطرازات على منصة APIYI apiyi.com لمعرفة أحدث الطرازات والأسعار، ويمكن للمستخدمين الجدد استخدام حصة الاختبار المجانية لتشغيل خط الأساس أولًا.
س5: هل يكفي تغيير معرّف النموذج فقط عند الترحيل؟
لا يكفي. يجب على الأقل ضبط `reasoning_effort` صراحةً (فالقيمة الافتراضية تغيّرت من xhigh إلى high)، وتوسيع `max_tokens` وحدود التخزين في الأنظمة اللاحقة حسب الحاجة، وفحص المدخلات الطويلة جدًا التي تقترب من 1M، وإعادة تقييم تكلفة كتابة ذاكرة التخزين المؤقت. وعلى مستوى البروتوكول، عند استخدام الواجهة المتوافقة مع OpenAI `https://api.apiyi.com/v1`، يكفي تغيير الحقل `model` في الكود.
س6: هل ما زال Qwen3.8-Max يستحق الاستخدام؟
نعم. فهو لا يزال طرازًا رائدًا بفئة 2.4T، مع نافذة سياق 1M وإخراج 128K ووضعي التفكير وغير التفكير، بالإضافة إلى إصدار مفتوح الأوزان. وتحسّن Qwen4-Max على معايير مثل BioMystery وJobBench تحسّن طفيف، وبالنسبة لهذا النوع من الأعمال، يمكن لـ Qwen3.8-Max المستقر أن يواصل حمل حركة الإنتاج.
Qwen4-Max مقابل Qwen3.8-Max: النقاط الأساسية
- الحجم نفسه، تفعيل أقل: يبقى الهيكل الأساسي 2.4T كما هو، بينما ينخفض التفعيل في كل مرة من 95B إلى 71B، أي أقل بنحو 25%.
- انخفاض سعر الوحدة 25%: المدخلات من $2 إلى $1.5، والمخرجات من $6 إلى $4.5، وقراءة الذاكرة المؤقتة (cache) تنخفض بنحو 70%، مع إضافة تسعير جديد لكتابة الذاكرة المؤقتة.
- الإخراج ثلاثة أضعاف تقريبًا: الحد الأقصى للإخراج من 128K إلى 393K، بينما تم تقليص الحد الأقصى للمدخلات إلى 991K.
- الزيادة تتركز في الوكلاء (Agents): التحسن واضح في AutomationBench وTerminal-Bench وHealthBench، بينما لم يتحرك BioMystery تقريبًا.
- موضعان يجب ألا نبالغ فيهما: خفض التكلفة بنسبة 62% لا يمكن أن يُستنتج منه سوى نحو 51%، والمركز السادس في Arena حصل على 1,814 صوتًا فقط وهو تصنيف Preliminary (مبدئي).
- الترحيل ليس مجرد تغيير المعرّف: انتبه إلى القيمة الافتراضية لـ
reasoning_effort، والحد الأعلى لـmax_tokens، واستراتيجية الذاكرة المؤقتة. - وضع APIYI الحالي:
qwen4-maxلم يُطرح بعد، فاستمر في استخدامqwen3.8-max، وبعد طرحه يمكن التبديل التدريجي (gray release).
الملخص
الخلاصة الأساسية لمقارنة Qwen4-Max بـ Qwen3.8-Max:
- التكلفة: انخفاض سعر الوحدة بنسبة 25% مكسب مؤكد، أما توفير tokens بنسبة 20% إلى 30% فيجب التحقق منه عبر الاختبار الفعلي في عملك، وانخفاض بنسبة 62% منه نحو 11 نقطة مئوية مصدرها غير واضح.
- القدرات: تحسّن ملحوظ في الوكلاء الذكية واستدعاء الأدوات ومجالي الصحة والرسوم البيانية، وبعض المعايير شبه متطابقة، وجميع النتائج معلنة رسميًا من الشركة نفسها.
- الترحيل: البروتوكول لم يتغير، لكن مستوى الاستدلال الافتراضي والحد الأقصى للإخراج وفوترة التخزين المؤقت تغيّرت جميعها، ويجب فحصها بندًا بندًا وفق القائمة.
يظل Qwen3.8-Max نموذجًا إنتاجيًا موثوقًا، وينبغي أن يكون الترقية قرارًا تدريجيًا مدعومًا بالبيانات، لا تحويلاً كاملاً لمجرد ظهور إصدار جديد. نوصي أولاً ببناء خط أساس للتكلفة والجودة عبر APIYI على apiyi.com باستخدام qwen3.8-max، ثم بعد طرح qwen4-max إجراء مقارنة مباشرة عبر الواجهة نفسها.
📚 المراجع
- مدونة Qwen3.8 الرسمية: ملاحظات إصدار Qwen3.8-Max، وتتضمن المعاملات ونافذة السياق والتسعير الرسمي
- الرابط:
qwen.ai/blog?id=qwen3.8 -
الوصف: مصدر مواصفات الجيل السابق وأسعار منطقة سنغافورة
-
Hugging Face – Qwen3.8-2.4T-A95B: إصدار Qwen3.8 بالأوزان المفتوحة
- الرابط:
huggingface.co/Qwen/Qwen3.8-2.4T-A95B -
الوصف: بطاقة النموذج وتنزيل الأوزان عند الحاجة إلى النشر الذاتي
-
مدونة Qwen الرسمية: مقال إصدار Qwen4-Max ومقارنة النتائج على الرسم البياني نفسه
- الرابط:
qwen.ai/blog -
الوصف: مصدر تعديلات البنية ونتائج التقييم المعلنة رسميًا وبيانات tokens وتكلفة المهمة الواحدة
-
arena.ai Code Arena WebDev: لوحة مقارنة النماذج من طرف ثالث
- الرابط:
arena.ai - الوصف: تستند هذه المقالة إلى لقطة بتاريخ 2026-11-14، والترتيب يتغير حسب عدد الأصوات
المؤلف: فريق APIYI التقني
التواصل التقني: نرحب بتواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI، ويمكن الاستعلام عن الطُرز والأسعار في مركز الوثائق docs.apiyi.com


