
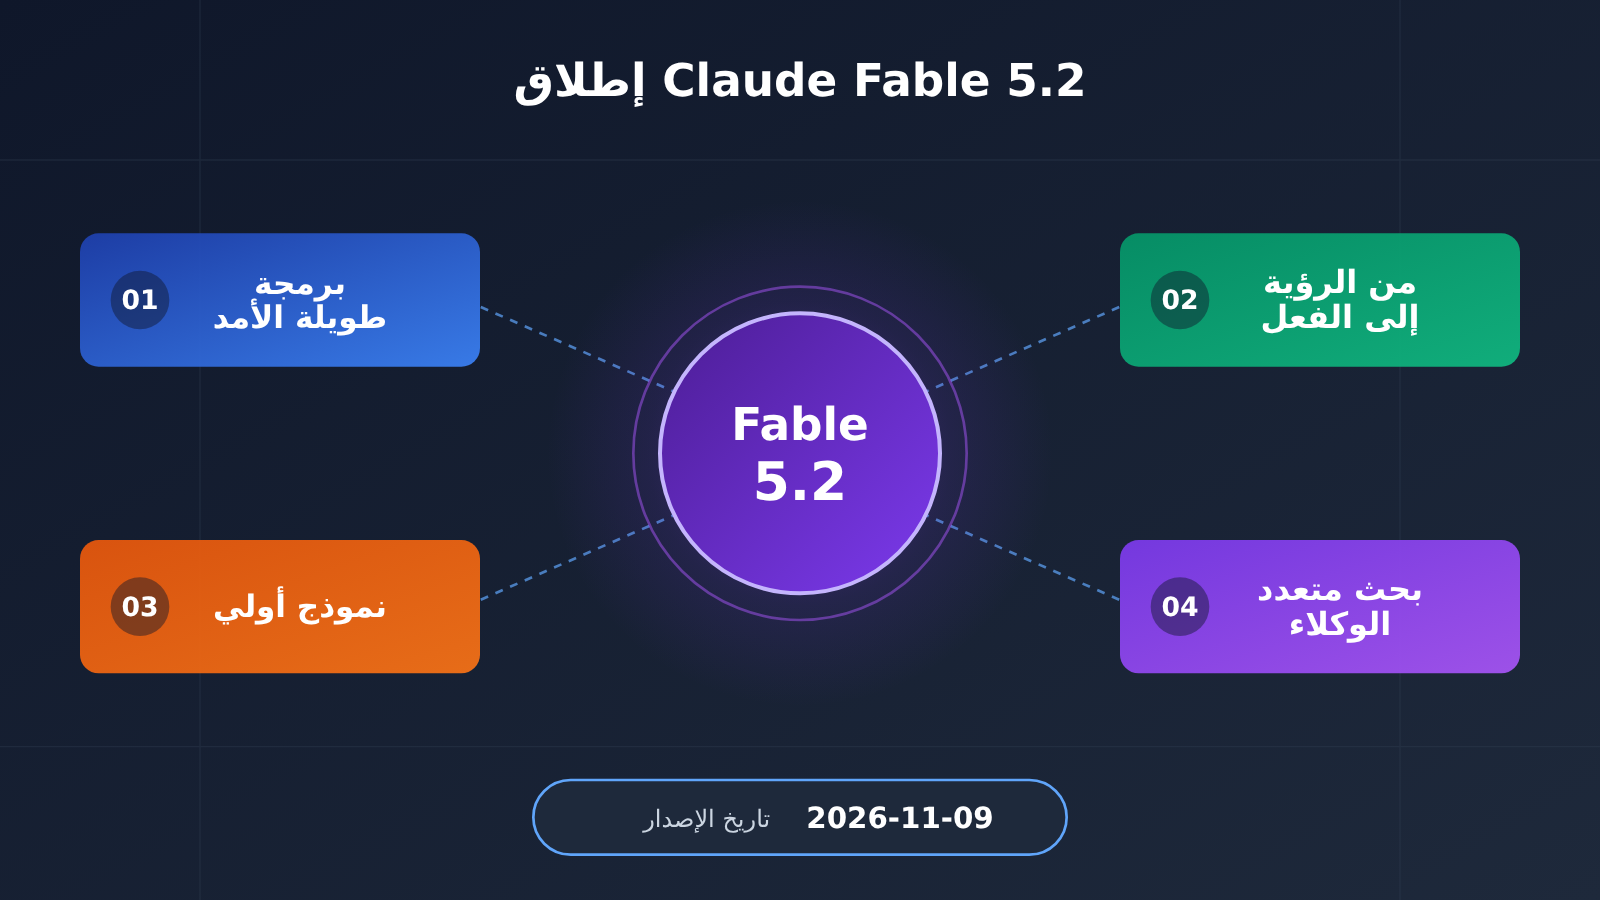
أعلنت Anthropic رسميًا عن Claude Fable 5.2 في 9 نوفمبر 2026. وتشير جداول القدرات الرسمية والتصنيفات الصادرة عن جهات خارجية إلى تفوقه بوضوح على الإصدار 5.1 في المهام الصعبة والتعاون طويل الأمد، كما أن سعر واجهة API القياسية أقل بنسبة 20% من سعر الإصدار 5.1.
القيمة الأساسية: يساعدك هذا المقال، وفق تسلسل «الخلاصة أولًا، ثم الأدلة، ثم الحدود»، على تحديد مواطن قوة Claude Fable 5.2، ومدى تفوقه، وما إذا كان من المجدي نقل مهامك إليه الآن.
مصطلحات سريعة لفهم تقييم Claude Fable 5.2
ستتكرر في ما يلي بعض المصطلحات المتعلقة بأساليب التقييم. وقد يؤدي فهمها على نحو خاطئ إلى اعتبار عروض الشركات المصنّعة تحققًا مستقلًا، أو إلى تفسير الدرجات الجزئية على أنها معدلات نجاح.
- Agent: نظام نموذج قادر على استدعاء الأدوات وتنفيذ مهام متعددة الخطوات بصورة متواصلة.
- Intelligence Index: مؤشر القدرات الشامل الصادر عن Artificial Analysis (AA). وهو درجة مركبة، وليس معدلًا للإجابات الصحيحة.
- OSWorld partial: أسلوب لتسجيل النقاط في تقييم عمليات سطح المكتب، بناءً على مستوى الإنجاز الجزئي؛ ولا يعادل معدل اجتياز كامل المهام وفق معايير صارمة.
- RoboDojo Sim: تقييم للتحكم في بيئة روبوتية محاكاة، ولا يمثّل معدل نجاح الروبوتات في العالم الحقيقي.
- PCB: لوحة الدوائر المطبوعة، تُستخدم لتركيب المكونات الإلكترونية وتوصيلها.
- Lean / البرهان الصوري: Lean لغة وأداة تتيحان للحاسوب التحقق من البراهين. أما البرهان الصوري فهو تحويل الحجة الرياضية إلى خطوات دقيقة يستطيع الحاسوب التحقق منها واحدة تلو الأخرى.
- التعاون متعدد الوكلاء: تقسيم العمل بين عدة نُسخ من النموذج تتواصل فيما بينها، ثم تجمع النتائج في مخرَج واحد.
ما مدى قوة Claude Fable 5.2؟ الخلاصة أولًا، ثم خلفية الإصدار
الخلاصة في جملة واحدة: حقق Claude Fable 5.2 تحسنًا ملحوظًا في البرمجة الصعبة والمهام طويلة الأمد والتقييمات التي تربط الرؤية بالفعل، لكن لا يمكن وصفه بأنه «الأفضل في كل المهام». فما يزال متأخرًا عن نماذج أخرى في بعض التقييمات الآلية ودرجات التفضيل.
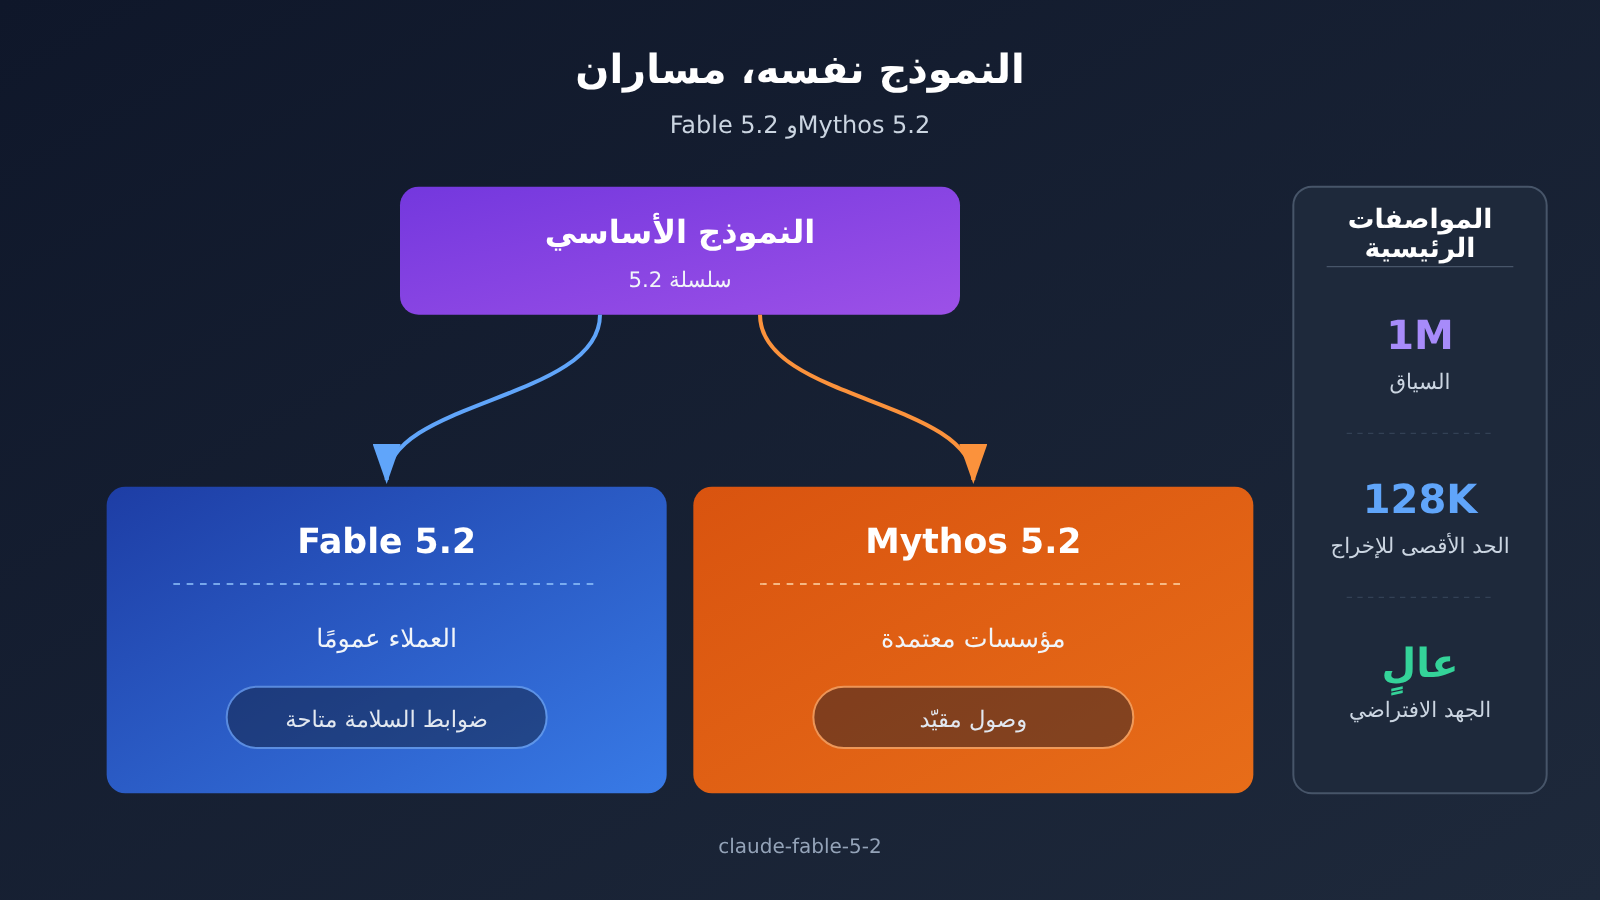
قبل ذلك، لا بد من توضيح خلفية الإصدار. تقول الشركة إن Fable وMythos يستخدمان النموذج الأساسي نفسه. وتسمح إجراءات الحماية من مخاطر الأمن السيبراني والسلامة البيولوجية في Fable بإتاحته للعملاء عمومًا، بينما يقتصر Mythos على المؤسسات التي اجتازت التحقق. لذلك، لا يصح أن تُنسب قدرات Mythos أو درجاته الخاصة مباشرةً إلى إصدار Fable المتاح للجميع.
نظرة سريعة على أبرز معلومات Claude Fable 5.2
| بند المعلومات | التفاصيل | طبيعة المصدر |
|---|---|---|
| تاريخ الإصدار | 9 نوفمبر 2026 | إعلان رسمي |
| معرّف النموذج في API | claude-fable-5-2 |
وثائق النموذج الرسمية |
| نافذة السياق / الحد الأقصى للإخراج | 1M token / 128K token | وثائق النموذج الرسمية |
| أنماط الإدخال والإخراج | إدخال النصوص والصور، وإخراج النصوص | وثائق النموذج الرسمية |
| وضع التفكير | التفكير التكيفي مفعّل دائمًا، والقيمة الافتراضية لـ effort في API هي high | وثائق النموذج الرسمية |
| تاريخ انتهاء المعرفة | يونيو 2026 (ولا يعني ذلك امتلاك قدرة على الاتصال بالإنترنت لحظيًا) | وثائق النموذج الرسمية |
| السعر القياسي | 8 دولارات للإدخال و40 دولارًا للإخراج لكل مليون token، أي أقل بنسبة 20% لكل منهما مقارنةً بـ 5.1 | صفحة الأسعار الرسمية |
| السرعة | «أسرع بنسبة تصل إلى 30%» في توليد الإخراج مقارنةً بـ 5.1 | الحد الأقصى وفقًا للشركة |
هناك نقطتان يسهل إساءة فهمهما. أولًا، عبارة «أسرع بنسبة تصل إلى 30%» هي الحد الأقصى لسرعة الإخراج الذي تعلنه الشركة، ولا تعني أن مدة كل مهمة ستنخفض بنسبة 30%. ثانيًا، يظل السعر القياسي لـ Fable 5.2 ضعف سعر Opus 5.5 (4/20 دولارًا).
وتوصي الشركة رسميًا بأن يبدأ معظم المستخدمين بـ Opus 5.5 في مهام البرمجة والعمل المعرفي اليومية، ثم ينتقلوا إلى Fable عند مواجهة مهام معقدة.
أدلة تحسّن Claude Fable 5.2 في البرمجة والمهام طويلة الأمد
تتصدر البرمجة محاور هذا الإصدار. لنبدأ بالبيانات التي نشرتها الشركة، ثم ننتقل إلى مجموعتين من بيانات الجهات الخارجية في بيئتين مختلفتين.
جدول القدرات الرسمي: مقارنة Fable 5.2 بـ 5.1 وOpus 5.5
| التقييم (بحسب إفصاح الشركة) | Fable 5.2 | Fable 5.1 | Opus 5.5 | ملاحظات |
|---|---|---|---|---|
| FrontierCode 2.0 | 49.1% | 32.4% | — | إعدادات effort مختلفة بين النموذجين |
| FrontierSWE v2 | 69.9% | 56.3% | 62.3% | مهام هندسة برمجيات طويلة الأمد |
| AutomationBench | 51.4% | 31.4% | 42.5% | مهام الأتمتة |
| OSWorld 2.1، المجموعة الفرعية غير المتصلة partial | 89.3% | 83.5% | 87.2% | احتساب الدرجات جزئيًا |
| RoboDojo Sim | 64.9% | 27.6% | 39.4% | التحكم بالروبوتات في المحاكاة |
يتضح من الجدول أن Fable 5.2 يتقدم على الإصدار 5.1 بمقدار 13.6 نقطة مئوية في FrontierSWE v2، ويتفوق أيضًا على Opus 5.5. أما الزيادة في FrontierCode 2.0 فهي أكبر، لكن إعداد effort يختلف بين نتيجتي الإصدارين، لذا قد يُعزى جزء من التحسن إلى مستوى الاستدلال.
بيانات الجهات الخارجية: أداء Claude Fable 5.2 في AA وCursor
| بيئة التقييم | الإعداد | النتيجة | التكلفة لكل مهمة (بالدولار) |
|---|---|---|---|
| Artificial Analysis | Fable 5.2 medium | 56 | 3.80 |
| Artificial Analysis | Fable 5.2 high | 62 | 9.08 |
| Artificial Analysis | Fable 5.2 xhigh | 62 | 14.83 |
| Artificial Analysis | Fable 5.2 max | 65 | 26.54 |
| Artificial Analysis | Opus 5.5 max | 59 | 10.04 |
| CursorBench 4.0 | Fable 5.2 High | 56.9% | 9.70 |
| CursorBench 4.0 | Fable 5.2 Max | 60.0% | 32.79 |
| CursorBench 4.0 | Opus 5.5 High | 56.0% | 3.97 |
AA جهة تقييم مستقلة، وقد سجّل Fable 5.2 max درجة 65 في مؤشر الذكاء لديها، متقدمًا على Opus 5.5 max الذي سجّل 59، وهو ما يتوافق مع اتجاه النتائج في الجدول الرسمي.
تستند بيانات Cursor إلى مهامه وبيئة أدواته. وقد سجّل Fable 5.2 Max نسبة 60.0%، لكن الفارق بينه وبين Opus 5.5 High في فئة High لا يتجاوز 0.9 نقطة مئوية.
تُظهر مجموعتا بيانات الجهات الخارجية أن السقف الأعلى للأداء يقترن عادةً بتكلفة أكبر لكل مهمة. ففي AA، ترتفع النتيجة 3 نقاط عند الانتقال من high إلى max، بينما تصبح تكلفة المهمة نحو 2.92 ضعفًا.
🎯 نصيحة تقنية: تساعدك لوحات الصدارة على تضييق نطاق الخيارات، لكن عليك استخلاص النتيجة النهائية باستخدام مجموعة مهامك الخاصة. ننصحك بمقارنة Opus وFable وغيرهما من النماذج عبر واجهة متوافقة مع OpenAI نفسها، باستخدام المطالبات ومعايير القبول ذاتها من خلال APIYI apiyi.com، ثم تسجيل الجودة والتكلفة لكل مستوى.
إلى أي مدى وصلت قدرات Claude Fable 5.2 في الرؤية والهندسة؟
من فهم الشاشة إلى التحكم في الحركة
أبرز نتيجتين في مجال الرؤية هما OSWorld 2.1 وRoboDojo Sim. ارتفعت درجة مجموعة البيانات الفرعية غير المتصلة بالإنترنت في OSWorld 2.1، وفق مقياس partial، من 83.5% إلى 89.3%. لكن Opus 5.5 حقق بدوره 87.2%، لذا فالفارق ليس كبيرًا.
أما RoboDojo Sim، فشهد قفزة أكبر، إذ ارتفعت النتيجة من 27.6% إلى 64.9%. وهذا يشير إلى تحسن ملحوظ في قدرة النموذج على تحويل الفهم البصري إلى سلسلة من إجراءات التحكم.
مشاركة Fable 5.2 في تصميم النماذج الإلكترونية الأولية
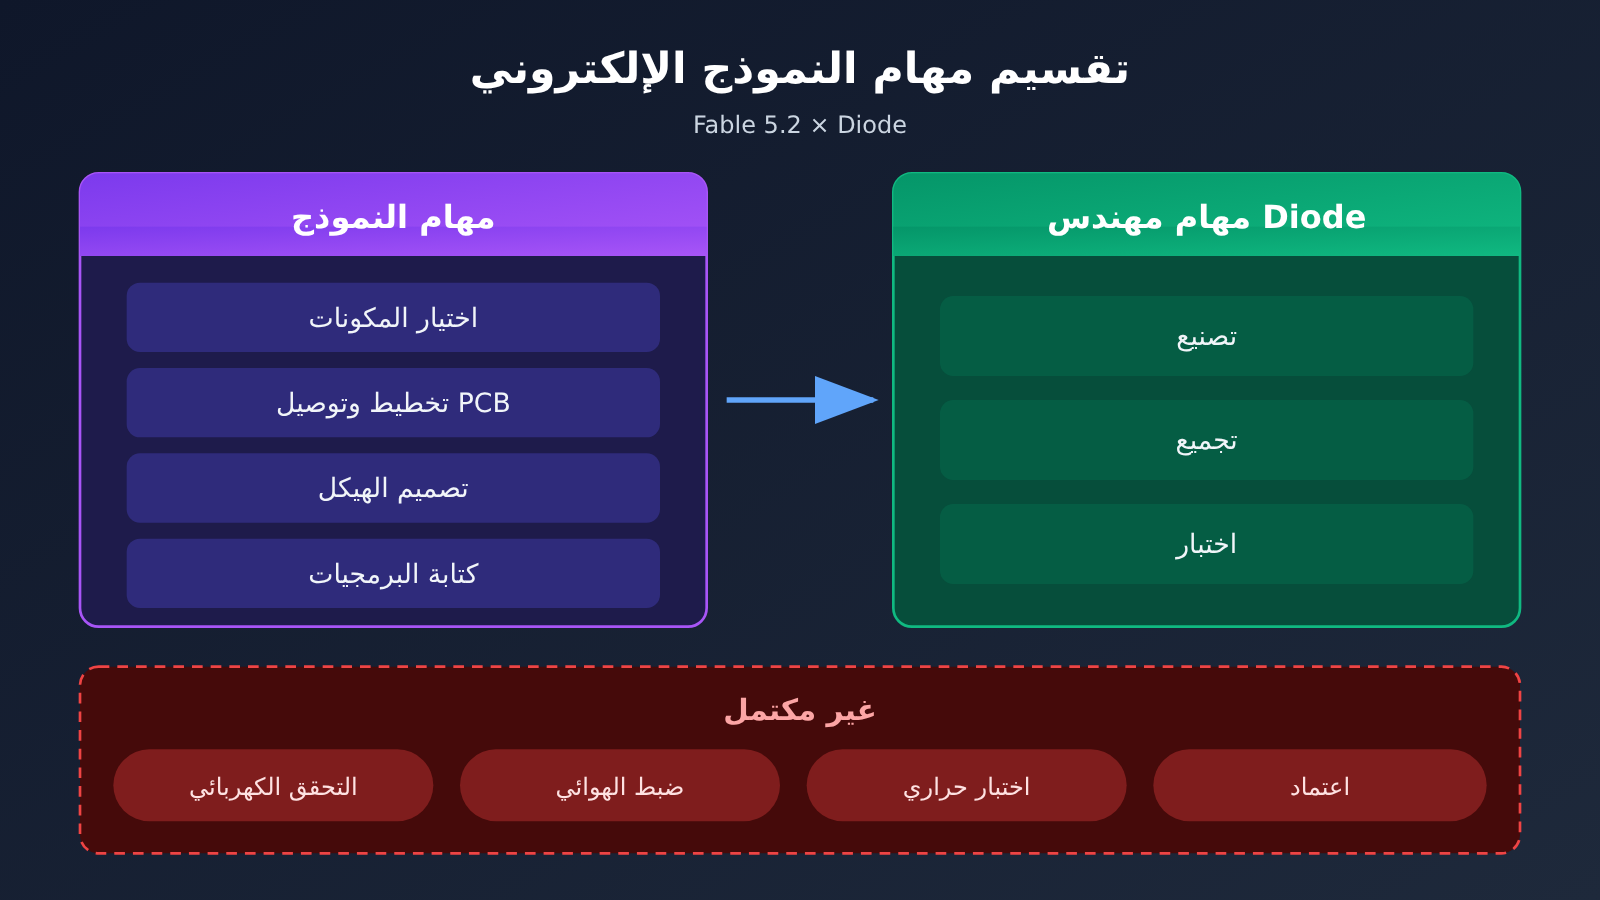
تعاونت Anthropic مع Diode على تصنيع ثلاثة نماذج أولية لأجهزة إلكترونية: مساعد صوتي، ومكبر صوت هاتف USB، وحيوان أليف افتراضي. شارك النموذج في اختيار المكونات، وتخطيط لوحة الدوائر المطبوعة وتوصيل مساراتها، وتصميم الهيكل، وكتابة البرامج. أما مهندسو Diode فتولوا التصنيع الفعلي والتجميع والاختبار. وبما أن الطرفين تربطهما علاقة تجارية، فمن المهم أخذ ذلك في الحسبان عند قراءة هذه الحالة.
حدود هذه الحالة واضحة: الأجهزة الثلاثة نماذج أولية فقط، ولم تخضع للتحقق الكهربائي أو ضبط الهوائي أو الاختبارات الحرارية أو إجراءات الاعتماد، كما أنها لم تُصمم وفق متطلبات الإنتاج الكمي. ولم يتصل النموذج بمعدات المصنع أو أدوات الاختبار. لذا فالوصف الأدق هو أن «النموذج قادر على المشاركة بعمق في تصميم النماذج الإلكترونية الأولية»، لا أنه «صنع بمفرده منتجًا جاهزًا للإنتاج الكمي».
وتتضمن الوثيقة البحثية نفسها نتيجتين أخريين في مجال التصميم. الأولى من اختبار PCB Gym الداخلي الذي أجرته Diode، حيث حصل Fable 5.2 على 69%، مقارنةً بـ Fable 5 الذي سجل 25%، وليس Fable 5.1. والثانية من المعيار المفتوح BenchCAD 2.1، المخصص لإعادة بناء أجزاء ثلاثية الأبعاد وتجميعات ولوحات دوائر من الرسومات الهندسية والصور المعروضة؛ وقد أفادت الشركة المصنّعة بأن Fable 5.2 حقق 83.5%. المعيار نفسه متاح للعامة، لكن هذه النتيجة لم تخضع بعد لإعادة اختبار مستقلة.
لماذا تحظى حالات Claude Fable 5.2 في البحث العلمي وتعدد الوكلاء بالاهتمام؟
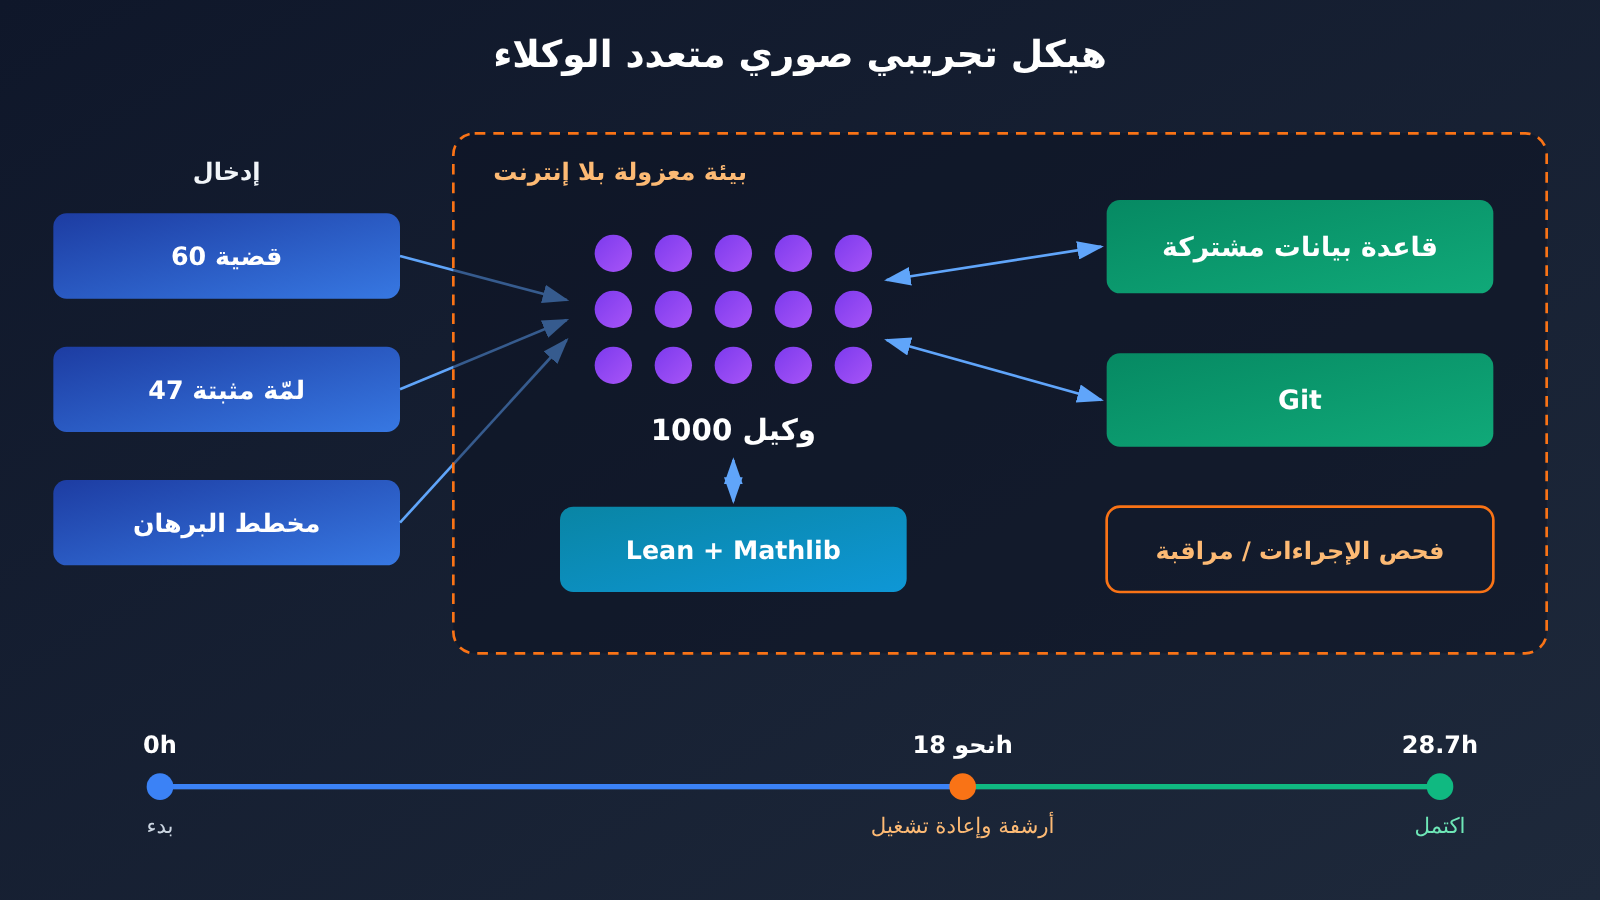
حظيت التجربة الرياضية القائمة على الصياغة الرسمية بأكبر قدر من الاهتمام. ووفقًا لما ورد في مدونة المطورين الرسمية، استخدم 1000 وكيل من الإصدارات المبكرة لـ Fable 5.2 مدة 28.7 ساعة لإعادة إنتاج البرهان الرسمي لمبرهنة فيرما الأخيرة باستخدام Lean.
تكمن أهمية هذه الحالة في القدرة على تنظيم المهام واسعة النطاق والممتدة زمنيًا، لا في اكتشاف نتائج رياضية جديدة.
من المهم توضيح ظروف التجربة كاملةً:
- كانت المدخلات محددة مسبقًا: 60 قضية وتعريفًا، ومخططًا موجزًا لمسار البرهان الكلاسيكي، و47 لمّة سبق إثباتها.
- الأدوات والبيئة: Lean وMathlib وGit وقاعدة بيانات مشتركة، إلى جانب بيئة معزولة غير متصلة بالإنترنت، مع فحوص للإجراءات ومراقبة تعمل دون اتصال.
- سير التجربة: بعد نحو 18 ساعة من التشغيل، أُعيد تشغيل الوكلاء من الحالة المحفوظة، ثم أُضيفت 12 ساعة أخرى.
- وصف المؤلفين للتجربة: أشار المؤلفون أنفسهم إلى أنها تجربة مبسطة، وذكروا أن استخدام بيئة تنفيذ متخصصة وتوجيه بشري لمسار العمل من شأنه أن يرفع الكفاءة أكثر.
لذلك، فهذه صياغة رسمية لبرهان رياضي موجود مسبقًا.
حتى مع هذه القيود، تبيّن الحالة أحد المسارات الممكنة: إذ تستطيع عدة نسخ من النموذج، عند عملها بتقسيم المهام في ظل حالة مشتركة، تقديم النتائج ومراجعتها، ومواصلة العمل على مهمة طويلة جدًا. وقد تكون هذه القدرة مفيدة أيضًا في الأعمال الهندسية، مثل ترحيل قواعد برمجية كبيرة وإعادة هيكلة الأنظمة المعقدة.
الجوانب التي لم يتفوق فيها Claude Fable 5.2 على الجميع
لا بد لأي مراجعة مسؤولة لقدرات نموذج ما أن تذكر الحالات التي لم يتفوق فيها. ففي الجدول نفسه الوارد في الإعلان الرسمي، هناك نتيجتان لم يحقق فيهما Fable 5.2 الأفضلية.
| التقييم | Fable 5.2 | النموذج المقارَن | ملاحظات |
|---|---|---|---|
| AutomationBench | 51.4% | Gemini 4 Carbon 53.9% | النموذج المنافس يتقدم في هذا التقييم |
| AA-Briefcase (معايير التقييم) | 66.1% | Opus 5.5 61.2% | Fable يتقدم وفقًا لمعايير التقييم |
| AA-Briefcase (Elo) | 1785 | Opus 5.5 1800 | Opus يتقدم وفقًا لتفضيلات المواجهات |
يُعدّ تقييم AA-Briefcase المثال الأوضح. ففي المهمة نفسها، يتقدم Fable عند احتساب النقاط وفقًا لمعايير التقييم (rubric)، بينما يتقدم Opus عند احتسابها وفقًا لتفضيلات المواجهات بنظام Elo. قد تنقلب النتائج بتغيّر طريقة التقييم، لذا لا يصح إعلان «التفوق الشامل» استنادًا إلى قائمة تصنيف واحدة أو اثنتين.
ومن التكاليف الأخرى ارتفاع السعر. ففي بيئة Cursor، تبلغ تكلفة كل مهمة باستخدام Fable 5.2 Max نحو 32.79 دولارًا، مقابل 3.97 دولارات باستخدام Opus 5.5 High، أي بفارق يقارب 8 أضعاف، رغم أن الفارق في الدرجات لا يتجاوز 4 نقاط مئوية. وأظهرت تجربة محدودة أجراها المطوّر المستقل Lex Toumbourou أن دقة 5.2 high أعلى من 5.1، لكن حجم المخرجات وتكلفة كل جولة تضاعفا تقريبًا.
إضافة إلى ذلك، لا ينبغي اعتبار النتائج الخاصة بـ Mythos في مجالي السلامة والموضوعات الحيوية مقياسًا لقدرات Fable العادي.
ما المستخدمون الذين ينبغي لهم تجربة Claude Fable 5.2 الآن؟
استنادًا إلى دليل اختيار النماذج الرسمي والبيانات أعلاه، يمكن تصنيف المستخدمين على النحو الآتي:
- يستحق التجربة أولًا: من يواجهون تحديات في البرمجة الممتدة والمعقدة، أو تصميم الأنظمة الهندسية المعقدة، أو مهام البحث التي تتطلب استدعاءات متعددة للأدوات. يمكنهم التحقق من وجود تحسن فعلي باستخدام مجموعة مهام خاصة بهم.
- ابدأ بنموذج للاستخدام اليومي: في الأسئلة المعرفية اليومية والبرمجة العادية، يُنصح باتباع التوصية الرسمية والبدء بنماذج للاستخدام اليومي مثل Opus 5.5، ثم الترقية عند مواجهة عوائق فعلية.
خمسة معايير لتقييم Claude Fable 5.2 قبل تجربته
| المعيار | ما الذي ينبغي التأكد منه؟ | الإجراء المقترح |
|---|---|---|
| التوفّر | هل أُتيح هذا الطراز على المنصة التي تستخدمها؟ وما معرّف النموذج ونقطة النهاية؟ | اعتمد قائمة النماذج المتاحة على المنصة في ذلك اليوم، ولا تفترض أنه متاح بالفعل |
| البيانات | هل تسمح سياسات بيانات مهامك بإرسالها إلى نموذج تابع لجهة خارجية؟ | راجع شروط الاحتفاظ بالبيانات ومتطلبات الامتثال المؤسسي |
| القبول | ما المعايير التي تحدد اكتمال المهمة؟ | أعدّ حالات اختبار أو معايير تقييم مسبقًا |
| الوقت | هل مدة الانتظار مهمة؟ | سجّل الوقت المستغرق من البداية إلى النهاية أيضًا، ولا تكتفِ بسرعة الإخراج |
| الميزانية | ما الحد الأقصى للتكلفة المقبولة لكل مهمة ناجحة؟ | سجّل عدد الرموز والمهام الناجحة بحسب الفئة، ثم احسب تكلفة كل نجاح |
إجراء اختبار مقارنة Claude Fable 5.2 باستخدام واجهة موحّدة
يستخدم هذا المثال المبسّط واجهة متوافقة مع OpenAI لاستدعاء النموذج. غيّر قيمة MODEL إلى معرّف نموذج موجود فعليًا في قائمة نماذج المنصة، لتتمكن من التبديل بين النماذج ومقارنتها دون تعديل الشفرة.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI المتوافقة مع OpenAI
)

MODEL = "your-model-id"  # يُرجى الرجوع إلى قائمة النماذج المتاحة على المنصة في اليوم نفسه
resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": "为下面的函数补充单元测试:..."}]
)
print(resp.choices[0].message.content, resp.usage)
عرض شفرة مقارنة النماذج المتعددة وسجل الاستخدام
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# يُرجى الرجوع إلى قائمة النماذج المتاحة على المنصة في اليوم نفسه لاختيار معرّفات النماذج المرشحة
CANDIDATES = ["daily-model-id", "candidate-model-id"]

def run_task(model: str, prompt: str, check) -> dict:
    """ينفّذ مهمة واحدة ويسجّل المدة وعدد الرموز ونتيجة التحقق"""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    text = resp.choices[0].message.content
    return {
        "model": model,
        "seconds": round(time.time() - start, 2),
        "prompt_tokens": resp.usage.prompt_tokens,
        "completion_tokens": resp.usage.completion_tokens,
        "passed": bool(check(text)),  # استخدم دالة التحقق الخاصة بك
    }

def check(text: str) -> bool:
    return "def test_" in text

tasks = ["为 parse_date 函数补充单元测试:..."]
results = [run_task(m, t, check) for m in CANDIDATES for t in tasks]
for r in results:
    print(r)
بعد إتمام المقارنة، راجع الفاتورة الفعلية أيضًا. تعرض وثائق السجلات لدى APIYI حقولًا مثل model_name وprompt_tokens وcompletion_tokens وquota وrequest_id. ويعادل quota مقسومًا على 500000 المبلغ المخصوم بالدولار، ما يتيح لك مطابقة تكاليف كل مهمة قبل الترقية وبعدها. تجدر الإشارة إلى أن المبالغ المحسوبة وفق الأسعار الرسمية تقديرية فقط، والمرجع النهائي هو السجلات الفعلية للمنصة.
🚀 ابدأ بسرعة: يمكنك التسجيل في APIYI عبر apiyi.com والحصول على رصيد مجاني للاختبار بصفتك مستخدمًا جديدًا. جرّب سير المقارنة على 10 إلى 20 مهمة حقيقية أولًا، ثم قرر ما إذا كنت ستوسّع نطاق الاستخدام إلى مستوى Fable. تحقّق من المعلومات التي تنشرها المنصة في اليوم نفسه لمعرفة ما إذا كان النموذج الجديد قد أُطلق وسعره.
الأسئلة الشائعة
س1: ما Claude Fable 5.2؟ وما علاقته بـ Mythos 5.2؟
Fable 5.2 نموذج أطلقته Anthropic في 9 نوفمبر 2026، ورقم طرازه في API هو `claude-fable-5-2`، ويدعم نافذة سياق بسعة 1M. يستخدم مع Mythos 5.2 النموذج الأساسي نفسه، لكن وسائل الحماية في Fable تتيح تقديمه للعملاء عمومًا، بينما يقتصر Mythos على المؤسسات التي اجتازت التحقق.
س2: ما مدى تفوق Claude Fable 5.2 على Opus 5.5؟
وفقًا للجدول الرسمي، حقق Fable 5.2 نسبة 69.9% في FrontierSWE v2، مقابل 62.3% لـ Opus 5.5. وفي مؤشر AA، سجل 65 في فئة max مقابل 59. أما في فئة High من CursorBench 4.0، فلا يتجاوز الفارق 0.9 نقطة مئوية. إجمالًا، يتمتع Fable 5.2 بسقف قدرات أعلى، لكن سعره ضعف سعر Opus 5.5، وقد يكون الفارق في تكلفة المهمة الواحدة أكبر عند استخدام الفئات الأعلى.
س3: هل يتصدر Claude Fable 5.2 جميع المهام؟
لا. ففي AutomationBench، حقق Gemini 4 Carbon نسبة 53.9%، متقدمًا على Fable 5.2 الذي سجل 51.4%. كما جاء Opus 5.5 في مرتبة أعلى عند احتساب نقاط AA-Briefcase وفق مقياس Elo. تختلف النتائج باختلاف طريقة التقييم، وكذلك الترتيب.
س4: هل استخدام Fable 5.2 أقل تكلفة من 5.1 حتمًا؟
ليس بالضرورة. ينخفض سعر الوحدة بنسبة 20%، لكنك لن توفر 20% إلا إذا ظل حجم الاستخدام ثابتًا. لنفترض أن المهمة تتضمن 100 ألف رمز إدخال و20 ألف رمز إخراج؛ عندئذٍ تبلغ تكلفة 5.2 دولارًا واحدًا و60 سنتًا، مقابل دولارين لـ 5.1. لكن إذا ارتفع الإخراج إلى 40 ألف رمز، فستبلغ تكلفة 5.2 دولارين و40 سنتًا، أي إنها ستكون أعلى. الغرض من هذا المثال هو توضيح العلاقة بين المتغيرات، وليس التنبؤ بأن النموذج سيُخرج دائمًا نصًا أطول. يُنصح بمراجعة سجلات الاستدعاء في APIYI عبر apiyi.com، والتحقق من استهلاك الرموز الفعلي لكل مهمة.
س5: كيف أقارن بسرعة بين Claude Fable 5.2 والنماذج الأخرى عبر API؟
1. سجّل في APIYI عبر apiyi.com للحصول على مفتاح API ورصيد مجاني للاختبار؛
2. تحقّق من معرّفات النماذج المتاحة في قائمة المنصة لذلك اليوم؛
3. استخدم الشفرة الواردة في هذه المقالة، واضبط `base_url` على `https://api.apiyi.com/v1`، ثم استدعِ النماذج بالتتابع على مجموعة المهام نفسها؛
4. سجّل عدد المهام المنجزة بنجاح والوقت المستغرق والرموز المستخدمة، ثم احسب تكلفة كل نجاح.
س6: هل تثبت تجربة مبرهنة فيرما الأخيرة أن Fable 5.2 قادر على ابتكار رياضيات أصلية؟
لا. وفّرت التجربة 60 قضية و47 لمّة مثبتة ومخططًا للبرهان، وشغّلت 1000 وكيل من لقطات مبكرة في بيئة معزولة غير متصلة بالإنترنت لمدة 28.7 ساعة. ما أنجزه النموذج هو إضفاء صيغة رسمية على براهين موجودة، وذلك في تشغيل واحد فقط. توضح التجربة قدرته على تنظيم العمل طويل الأمد، لكنها لا تثبت قدرته على تحقيق اكتشافات رياضية أصلية.
أبرز النقاط حول Claude Fable 5.2
- الفئة المستهدفة عند الإطلاق: أُطلق في 9 نوفمبر، ويستخدم النموذج الأساسي نفسه الذي يستخدمه Mythos، وهو متاح للعملاء عمومًا.
- الحد الأقصى في البرمجة: حقق 69.9% في FrontierSWE v2، متقدمًا على 5.1 وOpus 5.5 وفقًا للجدول الرسمي.
- تأكيد من جهات خارجية: سجل 65 نقطة في فئة AA max و60.0% في CursorBench Max، لكن تكلفة المهمة الواحدة أعلى بكثير.
- من الرؤية إلى الحركة: ارتفعت نتيجته في RoboDojo Sim من 27.6% إلى 64.9%، لكن هذا القياس يعتمد على المحاكاة.
- الهندسة والبحث العلمي: يمكنه المشاركة في تصميم النماذج الأولية الإلكترونية وفي إضفاء الطابع الصوري على Lean على نطاق واسع، لكن ذلك مشروط بمتطلبات واضحة.
- ليس الأفضل في كل شيء: تتفوق نماذج أخرى في بعض الحالات، وفقًا لمقاييس AutomationBench وElo.
- طريقة البدء: يمكنك استخدام الواجهة الموحدة في APIYI عبر apiyi.com لمقارنته بمهامك الخاصة، ثم تحديد ما إذا كنت تريد الترقية.
الخلاصة
أبرز النقاط حول Claude Fable 5.2:
- تحسّن ملحوظ في المهام الصعبة: حقق تقدمًا كبيرًا مقارنةً بالإصدار 5.1 في تقييمات البرمجة طويلة الأمد والتحكم البصري وغيرها.
- ينبغي تقييم الأدلة كلٌّ على حدة: لكل من التقييم الذاتي للشركة، وتصنيفات AA المستقلة، وبيئة Cursor الخاصة نطاق استخدام مختلف؛ فلا يصح خلط أرقامها ومقارنتها مباشرةً.
- الأداء الأعلى له كلفة: غالبًا ما تأتي القدرات القصوى في الفئات الأعلى مع زيادة تكلفة المهمة الواحدة عدة أضعاف. انخفاض سعر الوحدة لا يعني بالضرورة انخفاض تكلفة المهمة.
إذا كان عملك يتركز على البرمجة الصعبة طويلة الأمد، أو المشاريع الهندسية المعقدة، أو مهام البحث، فمن المفيد اختبار التحسن الفعلي لـ Fable 5.2 الآن باستخدام مجموعة مهامك الخاصة. أما للأعمال اليومية، فننصح بالبدء بنماذج يومية مثل Opus. ويمكنك مقارنة عدة نماذج عبر الواجهة نفسها باستخدام APIYI apiyi.com، ثم احتساب التكاليف استنادًا إلى السجلات؛ دع البيانات، لا التصنيفات، تحدد ما إذا كان الترقية تستحق.
📚 المراجع
- إعلان Anthropic: نطاق إطلاق Fable وMythos 5.2 وجدول القدرات الرسمي
- الرابط:
anthropic.com/claude-fable-and-mythos-5-2 -
ملاحظة: مصدر أولي لتاريخ الإطلاق ومنهجية قياس السرعة وبيانات المقارنة (تقييم ذاتي من الشركة)
-
مواصفات نموذج Fable 5.2: السياق، والحد الأقصى للمخرجات، وأوضاع التفكير
- الرابط:
platform.claude.com/docs/en/models/fable-5-2/overview -
ملاحظة: وثائق API الرسمية
-
تصنيفات نماذج Artificial Analysis: مؤشر الذكاء وتكلفة كل مهمة
- الرابط:
artificialanalysis.ai/leaderboards/models -
ملاحظة: لقطة دورية من جهة خارجية
-
CursorBench 4.0: تقييم ضمن بيئة Cursor الخاصة
- الرابط:
prod.cursor.com/evals -
ملاحظة: تقييم من مزود الأداة، وليس إعادة اختبار مستقلة وعامة
-
بحث تصميم النماذج الأولية الإلكترونية باستخدام Claude: ثلاثة نماذج أولية بالتعاون مع Diode
- الرابط:
anthropic.com/research/claude-electronics-design -
ملاحظة: يتضمن بيانات PCB Gym وBenchCAD 2.1، إلى جانب قيود النماذج الأولية
-
تجربة فريق متعدد الوكلاء باستخدام Fable 5.2: ظروف تجربة Lean الصورية
- الرابط:
claude.dev/blog/safely-scaling-multi-agent-teams-with-fable-5-2/ -
ملاحظة: تشغيل واسع النطاق يمثّل لقطة مبكرة من الشركة
-
دليل اختيار نماذج Claude: إرشادات استخدام Opus وFable
- الرابط:
claude.dev/blog/which-claude-model-should-you-build-with/ - ملاحظة: دليل المطورين الرسمي
الكاتب: الفريق التقني في APIYI
للتواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI. يمكنكم الاطلاع على حقول السجلات وتفاصيل الفوترة في مركز الوثائق على docs.apiyi.com


