
ملاحظة الكاتب: نستعرض تفاصيل Kimi K3.1 Pro، من إجمالي معاملاته البالغ 2.8T ومعاملاته النشطة البالغة 104B إلى التكميم بتقنية MXFP4 ونافذة السياق البالغة 1M. ونقدّر حجم الأوزان ومتطلبات العتاد، ونقارنها بسعر API البالغ $2/$10، مع جدول قرار وقائمة تحقق للمفاضلة بين النشر الذاتي وواجهة API.
لنبدأ بالخلاصة: Kimi K3.1 Pro نموذج من نوع MoE بإجمالي 2.8T من المعاملات، ولا يمكن تشغيله على جهاز واحد. وفق تقديرات MXFP4، يصل حجم الأوزان وحدها إلى مستوى التيرابايت، ولا تتسع لها خوادم العقدة الواحدة الشائعة المزودة بـ 8 بطاقات. لذا يلزم نشر النموذج على بطاقات متعددة عبر عدة عُقد على الأقل، مع تخصيص ذاكرة GPU إضافية لذاكرة KV Cache اللازمة لنافذة السياق البالغة 1M. إتاحة الأوزان تحل مشكلة «هل يمكن الحصول على النموذج؟»، لكنها لا تخفّض متطلبات تشغيله بكفاءة.
لذلك، بالنسبة إلى الغالبية العظمى من الفرق التقنية، يُعد البدء باستدعاء API بسعر $2/$10 خيارًا أكثر واقعية. ولا يستحق النشر الذاتي دراسة جادة من حيث التكلفة إلا عند اجتماع ثلاثة شروط: أن يكون حجم الاستدعاءات كبيرًا ومستقرًا، وأن تكون هناك ضرورة لبقاء البيانات في مركز بيانات الفريق، وأن يمتلك الفريق خبرة في تشغيل عناقيد GPU وصيانتها. بدلًا من تكرار نتائج اختبارات الأداء، سنحسب أولًا تكلفة الأوزان والعتاد، ثم ننظر إلى معدلات الاستخدام والتشغيل والصيانة، ونختتم بتوصيات حسب نوع الفريق. وإذا كنت تريد التحقق من الأداء أولًا، فيمكنك الاتصال عبر مفتاح واحد باستخدام منصة تجميع مثل APIYI على apiyi.com، ثم تحديد المسار المناسب لاحقًا.
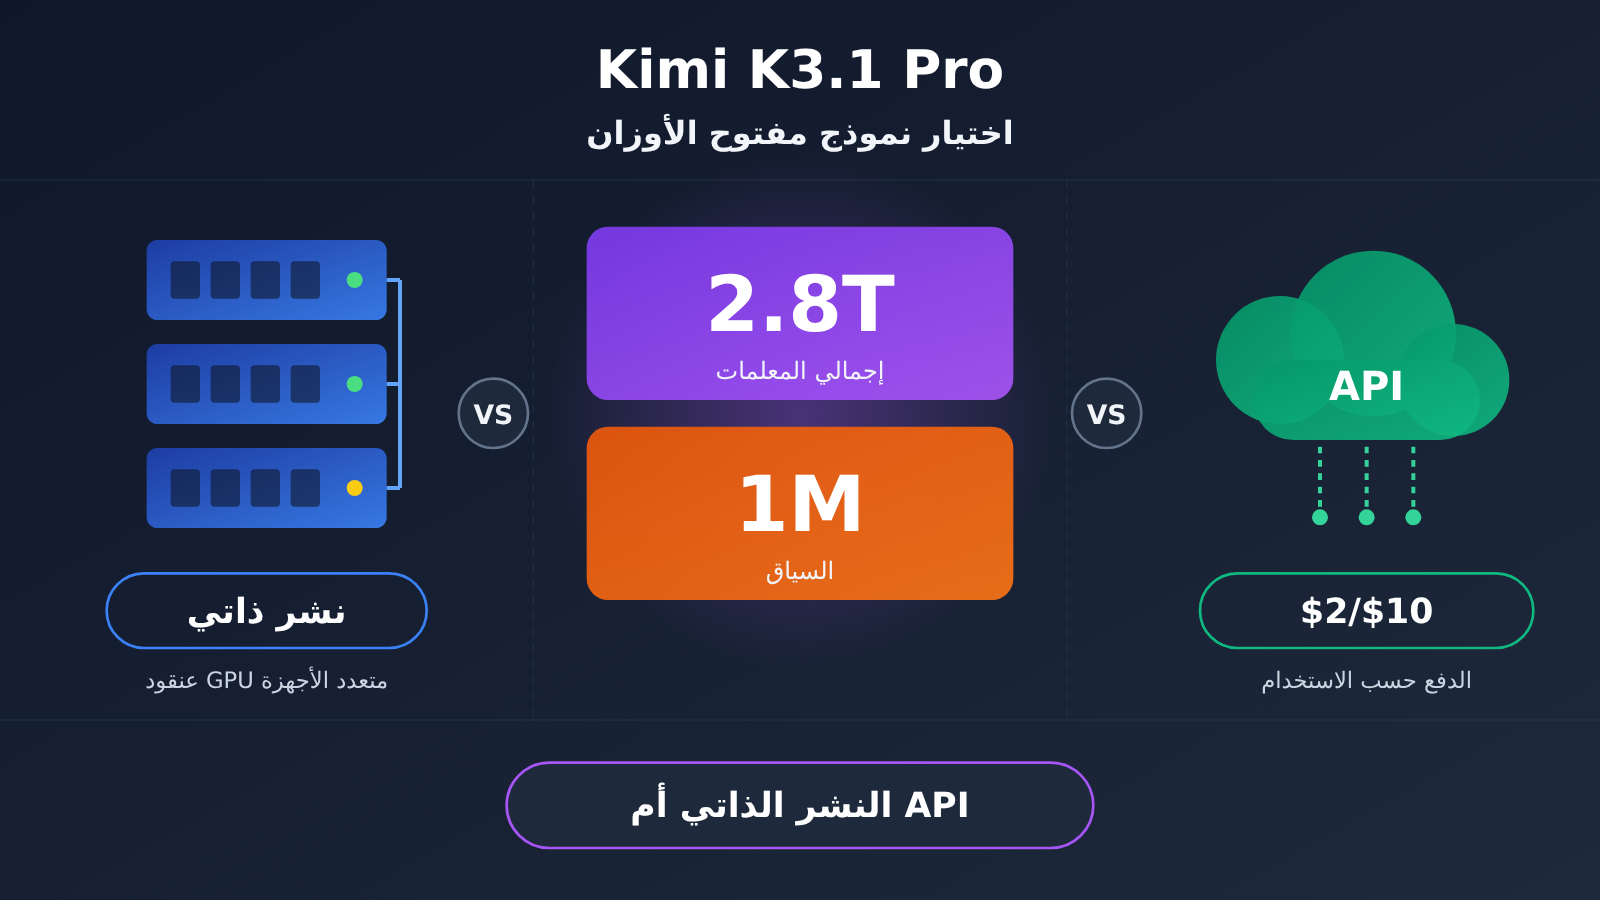
مواصفات Kimi K3.1 Pro: ماذا يعني 2.8T من المعلمات ونافذة سياق بحجم 1M؟
Kimi K3.1 Pro هو أول نموذج في سلسلة K3.1، وقد طُرح بأوزان مفتوحة. يعتمد على بنية MoE (مزيج الخبراء)، ويبلغ إجمالي معلماته 2.8T، فيما يُفعّل نحو 104B معلمة لكل رمز (token). ببساطة، تُحسب تكلفة التخزين على أساس 2.8T، بينما تقترب تكلفة الحوسبة من نموذج كثيف بحجم 104B. وهذا هو التحدي المعتاد عند استضافة نماذج MoE ذاتيًا: متطلبات الحوسبة ليست مرتفعة بالقدر نفسه، لكن يصعب خفض متطلبات ذاكرة GPU.
ومن النقاط المهمة أيضًا التدريب الواعي بالتكميم (QAT). يجمع النموذج بين أوزان MXFP4 وتنشيطات MXFP8، مع مراعاة التكميم منذ مرحلة التدريب. وهذا يعني أن التشغيل بدقة منخفضة هو الحالة «الأصلية» للنموذج، وليس نتيجة ضغطه بعد التدريب، ما يجعل فقدان الدقة أكثر قابلية للضبط نظريًا. لكن ذلك يفرض متطلبات على أجهزة ومحركات الاستدلال، إذ يجب أن تدعم تنسيقات القياس الدقيق من عائلة MX بكفاءة.
| المواصفة | معلمات Kimi K3.1 Pro | أهميتها عند الاختيار |
|---|---|---|
| البنية | MoE، 93 طبقة | يُحسب التخزين وفق إجمالي المعلمات، والحوسبة وفق المعلمات المُفعّلة |
| إجمالي المعلمات | 2.8T | يحدد حجم الأوزان والحد الأدنى لذاكرة GPU |
| المعلمات المُفعّلة | 104B | تحدد حجم الحوسبة لكل رمز |
| المُرمّز البصري | MoonViT-V2، بمعلمات تبلغ 401M | متعدد الوسائط بطبيعته، ويفهم الصور دون إضافات خارجية |
| طريقة التكميم | أوزان MXFP4 / تنشيطات MXFP8، باستخدام QAT | الدقة المنخفضة هي الحالة الأصلية، لكنها تعتمد على دعم الأجهزة |
| السياق | 1M رمز | مناسب للمستندات الطويلة ومستودعات الشفرة الكبيرة، لكنه يضع ضغطًا كبيرًا على ذاكرة KV Cache |
| حالات الاستخدام | البرمجة، والإبداع ثلاثي الأبعاد، والبحوث المالية، ووكلاء الذكاء الاصطناعي | يركز على المهام المعقدة وسلاسل الاستدعاءات الطويلة |
نافذة سياق Kimi K3.1 Pro بحجم 1M وقدراته متعددة الوسائط
تتسع نافذة السياق البالغة 1M رمز لإدخال مستودع شفرة متوسط الحجم، أو مجموعة كاملة من التقارير المالية، أو مواد بحثية مطوّلة دفعة واحدة. وهذا ما تحتاجه حالات استخدام وكلاء الذكاء الاصطناعي والبحوث المالية. وتتيح القدرة الأصلية على التعامل مع وسائط متعددة للنموذج قراءة الصور ولقطات الشاشة والمخططات مباشرةً، ما يجعله أكثر ملاءمة لمهام البرمجة والإبداع ثلاثي الأبعاد.
لكن الاستضافة الذاتية لهاتين القدرتين تأتي بتكلفة. فمع السياق الطويل، تنمو ذاكرة KV Cache خطيًا مع طول التسلسل، وقد يصبح استهلاك ذاكرة GPU كبيرًا جدًا عند استخدام نافذة 1M كاملةً. أما المُرمّز البصري نفسه فليس كبيرًا، لكن المعالجة المسبقة للمدخلات متعددة الوسائط وجدولة معالجتها على دفعات تزيدان من تعقيد خدمة الاستدلال. وعند استخدام API، يتولى مزود الخدمة كل ذلك، ولا تدفع أنت إلا مقابل الرموز.
حجم أوزان Kimi K3.1 Pro ومتطلبات العتاد
تقدير حجم أوزان Kimi K3.1 Pro
للتوضيح أولًا: الأحجام التالية تقديرية بناءً على عدد المعاملات، ويُرجع إلى الإصدار الرسمي لمعرفة حجم الملفات الفعلي. يشغل كل معامل في صيغة MXFP4 نحو 4 بت، أي 0.5 بايت، ما يعني أن حجم 2.8 تريليون معامل يبلغ نحو 1.4 تيرابايت. وتتطلب صيغة MX أيضًا مساحة إضافية لتخزين عوامل التحجيم لكل كتلة، إلى جانب أجزاء قد تحتفظ بدقة أعلى، مثل مُرمّز الرؤية وطبقة التضمين. لذلك يكون حجم الملفات الفعلي عادةً أكبر قليلًا من الناتج الحسابي المباشر.
| الدقة المفترضة | البايتات لكل معامل | الحجم التقديري لأوزان 2.8 تريليون معامل | ملاحظات |
|---|---|---|---|
| MXFP4 | نحو 0.5 بايت | نحو 1.4 تيرابايت | الصيغة التي يوصي بها المطوّر رسميًا، دون احتساب مساحة عوامل التحجيم |
| مستوى 8 بت | نحو 1 بايت | نحو 2.8 تيرابايت | للمقارنة فقط، وليست توصية رسمية |
| BF16 | 2 بايت | نحو 5.6 تيرابايت | للمقارنة فقط، وتوضيح أهمية QAT |
يوضح الجدول أن حجم الأوزان يصل إلى مستوى التيرابايت حتى باستخدام MXFP4، وهي الصيغة الأقل استهلاكًا للمساحة. وتنزيل هذه الأوزان والتحقق منها وتوزيعها على عدة أجهزة مهمة هندسية بحد ذاتها، لذا يجب التخطيط مسبقًا لسعة التخزين وعرض نطاق الشبكة الداخلية.
متطلبات الأجهزة للنشر الذاتي لـ Kimi K3.1 Pro
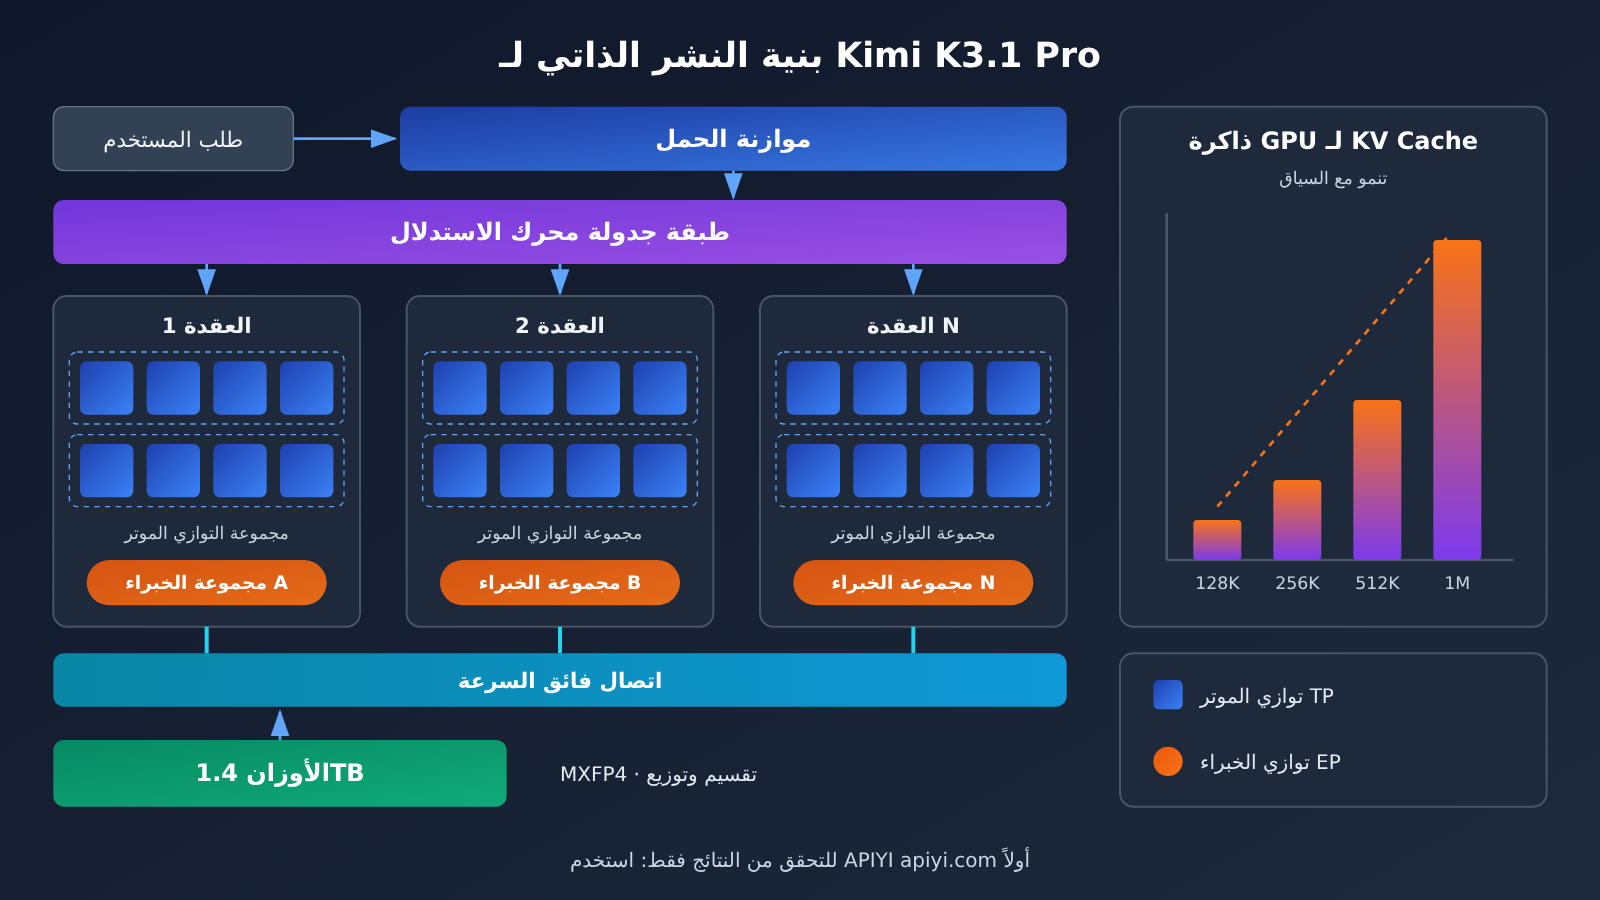
بحساب تقريبي على أساس 1.4TB، ستحتاج إلى نحو 18 بطاقة تسريع بذاكرة GPU سعة 80GB لكل منها، فقط لاستيعاب الأوزان. وهذا لا يشمل ذاكرة KV Cache، وقيم التنشيط، والأعباء التشغيلية لمحرك الاستدلال. من الواضح أن خادمًا عاديًا يضم 8 بطاقات لا يكفي؛ وحتى مع بطاقات أحدث ذات ذاكرة أكبر، قد تستوعب عقدة واحدة الأوزان بالكاد، دون أن تترك مساحة كافية للسياق الطويل. لذلك يعتمد الحل العملي غالبًا على بطاقات متعددة وعُقد متعددة، مع تقسيم النموذج باستخدام مزيج من توازي الموترات، وتوازي الخبراء، وتوازي خطوط المعالجة.
إلى جانب الأجهزة، هناك تكاليف أخرى يسهل التقليل من شأنها:
- محرك الاستدلال واستراتيجية التوازي: تحتاج إلى إطار عمل للاستدلال يدعم توازي خبراء MoE وتنسيق MX. راجع وثائق النشر الرسمية لمعرفة المحركات وإعدادات التوازي الموصى بها.
- الربط بين العُقد: ينتج عن توازي الخبراء قدر كبير من الاتصالات بين العُقد، ويؤثر عرض النطاق الترددي وزمن الاستجابة مباشرةً في معدل المعالجة.
- مركز البيانات والطاقة: يجب التخطيط مسبقًا لإمدادات الطاقة والتبريد ومساحة الخزائن اللازمة لعنقود GPU متعدد الخوادم.
- السعة وقت الذروة: تتطلب فترات الذروة موارد احتياطية إضافية، وتتحول هذه القدرة الحاسوبية إلى تكلفة غير مستغلة خارج تلك الفترات.
- كوادر التشغيل والصيانة: تتطلب ترقية النموذج، واستكشاف الأعطال، والمراقبة والتنبيهات، جهودًا مستمرة من مهندسين لديهم خبرة بعناقيد GPU.
من المهم التأكيد على أن المصادر المرجعية لا تتضمن بيانات رسمية مقاسة لمعدل المعالجة أو التكلفة، ولذلك لا تقدم هذه المقالة تقديرًا نهائيًا لتكلفة النشر الذاتي. إذا كنت تخطط لتنفيذ المشروع، فاعتمد على وثائق النشر الرسمية ونتائج اختبارات الضغط الخاصة بك.
ترخيص Kimi K3.1 Pro: إتاحة الأوزان لا تعني حرية الاستخدام التجاري بلا قيود
«الأوزان المتاحة» و«المصدر المفتوح المتاح للاستخدام التجاري بلا قيود» أمران مختلفان، ومن المهم التحقق من ذلك عند اختيار النموذج. تفرض تراخيص كثير من النماذج ذات الأوزان المتاحة شروطًا على الاستخدام التجاري، مثل حدود الإيرادات أو عدد المستخدمين، أو الالتزام بالإشارة إلى مصدر النموذج داخل المنتج. أما شروط الاستخدام التجاري وحدود الإيرادات والتزامات الإشعار الخاصة بـ Kimi K3.1 Pro، فيُرجع فيها جميعًا إلى النص الأصلي للترخيص الرسمي.
إلى جانب الاستخدام التجاري المباشر، قد تخضع بعض الأنشطة الأخرى لمتطلبات إضافية:
- التوزيع: إتاحة الأوزان أو إصدارات مشتقة منها لأطراف أخرى.
- التعديل: كيفية تطبيق الترخيص على النماذج الناتجة عن الضبط الدقيق أو التقطير أو الدمج.
- الخدمة المستضافة: إتاحة النموذج المستضاف ذاتيًا للآخرين عبر API، وهو سيناريو تركز التراخيص غالبًا على تنظيمه.
يُنصح بأن يراجع المسؤولون القانونيون والتقنيون الترخيص معًا، بندًا بندًا، وأن يوثقوا استنتاجاتهم قبل شراء العتاد. وعند استدعاء النموذج عبر واجهة API الرسمية أو منصة خارجية، تنطبق شروط الخدمة بالدرجة الأولى، ولا تنشأ عادةً مسألة توزيع الأوزان، لكن يجب أيضًا التأكد من امتثال استخدام البيانات ونطاق الاستخدام للشروط.
سعر واجهة Kimi K3.1 Pro API: كيف تُحسب تكلفة $2/$10؟
معرّف النموذج في واجهة API الرسمية هو kimi-k3.1-pro، وتتوفر واجهات متوافقة مع OpenAI وAnthropic، ما يجعل التعديلات المطلوبة على المشاريع الحالية محدودة. تُحسب الأسعار لكل مليون رمز (token):
| بند التسعير | الإصدار القياسي kimi-k3.1-pro |
إصدار Highspeed | توضيح |
|---|---|---|---|
| الإدخال | $2 |
$4 |
لكل مليون رمز |
| الإخراج | $10 |
$20 |
لكل مليون رمز |
| الإدخال من ذاكرة التخزين المؤقت | $0.20 |
وفق السعر الرسمي | يمكن خفض التكلفة كثيرًا عند تكرار بداية المحتوى |
| الكتابة إلى ذاكرة التخزين المؤقت | $2 |
وفق السعر الرسمي | بالسعر نفسه للإدخال القياسي |
| السرعة | السرعة الأساسية | نحو 3 أضعاف | خيار مناسب للمهام الحساسة لزمن الاستجابة |
إليك مثالًا حسابيًا للتوضيح، لا يستند إلى اختبار فعلي: إذا افترضنا استخدام 100 مليون رمز إدخال و20 مليون رمز إخراج شهريًا، فستبلغ تكلفة الإصدار القياسي نحو 100 × $2 + 20 × $10 = $400. وإذا استُرجع 70% من رموز الإدخال من ذاكرة التخزين المؤقت، تصبح تكلفة الإدخال 70 × $0.20 + 30 × $2 = $74، وتنخفض التكلفة الإجمالية إلى نحو $274. أما إصدار Highspeed فيكلف نحو $800 للاستخدام نفسه، دون احتساب التخزين المؤقت.
توضح هذه الأرقام الفارق: حتى عند استهلاك مئات الملايين من الرموز شهريًا، تظل فاتورة API أقل بكثير من مجموع الاستهلاك المحاسبي الشهري للكهرباء والأجهزة وتكاليف العمالة في عنقود GPU متعدد الأجهزة. وفي تطبيقات الوكلاء، تتكرر موجهات النظام وتعريفات الأدوات كثيرًا، لذا فإن الاستفادة من سعر التخزين المؤقت هي الطريقة الأكثر مباشرة لخفض تكلفة استخدام API.
وللبدء، ما دام العميل يدعم البروتوكول المتوافق مع OpenAI، يكفي تغيير base_url إلى https://api.apiyi.com/v1 وإدخال معرّف النموذج الذي توفره المنصة، دون الحاجة إلى كتابة طبقة توافق إضافية.
🚀 ابدأ سريعًا: إذا أراد فريقك مقارنة أداء Kimi وClaude وGPT وGemini في المهمة نفسها، فيمكنه استخدام مفتاح API واحد لاستدعائها عبر APIYI على apiyi.com، وعرض قائمة النماذج والاستخدام والسجلات في لوحة التحكم. يُرجى الرجوع إلى المعلومات المباشرة في لوحة التحكم لمعرفة ما إذا كان
kimi-k3.1-proمتاحًا وسعره الحالي.
الفروق الأساسية بين النشر الذاتي لـ Kimi K3.1 Pro واستخدام API
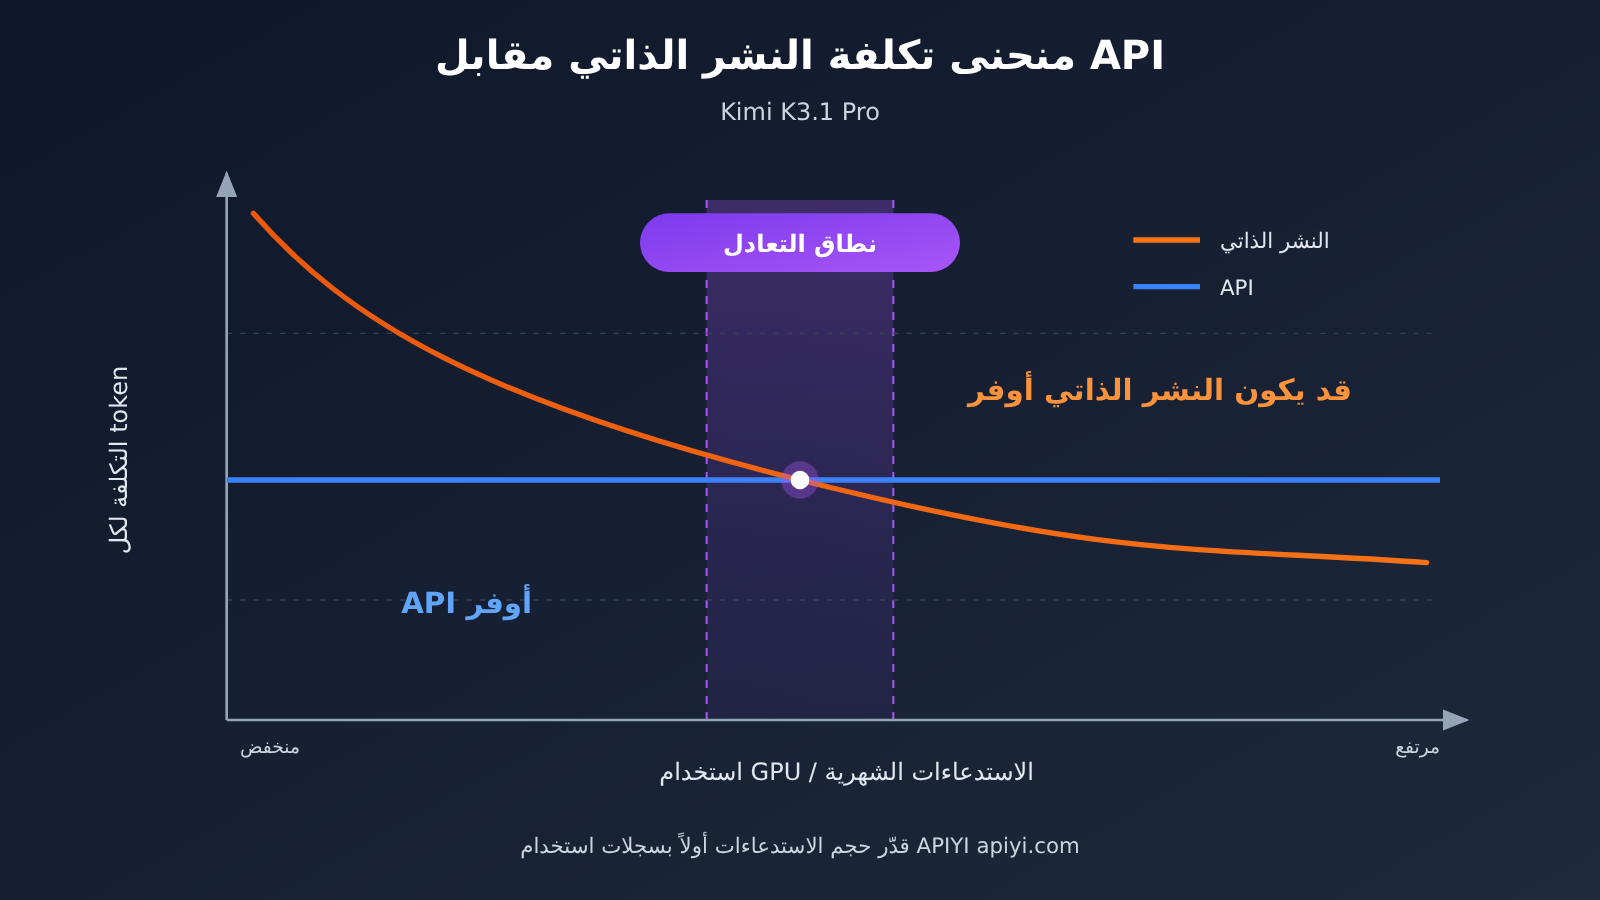
يكمن الفرق الجوهري بين النشر الذاتي وAPI في هيكل التكلفة. تكلفة API متغيرة بالكامل: تدفع مقابل ما تستخدمه فقط، ولا تدفع شيئًا عند عدم الاستخدام. أما النشر الذاتي فيجمع بين تكلفة ثابتة مرتفعة وتكلفة هامشية منخفضة؛ فبمجرد الاستثمار في الأجهزة ومركز البيانات والكوادر، تستمر التكاليف سواء استُخدمت الموارد بكامل طاقتها أم لا. لذلك فإن العامل الحاسم هو معدل الاستخدام: فقد تنخفض تكلفة التوكن الواحد بعد توزيع التكاليف إلى ما دون سعر API، ولكن فقط إذا حافظت مجموعة الخوادم على حمل مرتفع لفترة طويلة.
| معيار القرار | النشر الذاتي لـ Kimi K3.1 Pro | استخدام API | الخيار المرجح |
|---|---|---|---|
| معدل الاستخدام | يتطلب حملًا مرتفعًا لفترة طويلة لتوزيع التكاليف | الدفع حسب الاستخدام، دون هدر ناتج عن الموارد الخاملة | API للاستخدام المنخفض أو المتوسط |
| الامتثال للبيانات | يمكن إبقاء البيانات بالكامل داخل البيئة الخاصة | يجب إرسال البيانات إلى مزود الخدمة | النشر الذاتي للقطاعات شديدة التنظيم |
| الاستثمار الأولي | استثمار كبير في أجهزة متعددة مزودة بوحدات GPU ومركز البيانات والشبكة | يكاد يكون معدومًا | API |
| تكلفة التشغيل والصيانة | يتطلب فريقًا متخصصًا لتشغيل مجموعة وحدات GPU وصيانتها | يتحملها مزود الخدمة | API |
| المرونة عند الذروة | يتطلب حجز موارد إضافية مسبقًا، والتوسع فيه بطيء | مرونة أفضل، مع الالتزام بحدود معدل الطلبات | API |
| إمكانات التخصيص | إمكانية الضبط الدقيق وتعديل إعدادات الاستدلال | مقيدة بمعلمات الواجهة | النشر الذاتي للتخصيص العميق |
| سرعة الإطلاق | من أسابيع إلى أشهر | في غضون ساعات | API |
| طريقة الوصول | إنشاء خدمة استدلال خاصة | API الرسمي ومنصات مثل APIYI apiyi.com | حسب الاحتياجات |
تحليل مقارنة API: يتفوق API في سرعة الإطلاق والمرونة والتكلفة الإجمالية للملكية، لكنه يتطلب إرسال البيانات خارج البيئة الخاصة، كما أن معلمات الواجهة القابلة للتعديل محدودة. في المقابل، يوفر النشر الذاتي تحكمًا أكبر في البيانات وإمكانات أوسع للتخصيص العميق، مما يجعله أنسب للفرق العاملة في قطاعات شديدة التنظيم والتي تتعامل مع أحجام استدعاء ضخمة.
تحليل مقارنة النشر الذاتي: قد يتيح النشر الذاتي خفض تكلفة الوحدة وتعزيز التحكم، لكن استثماره الأولي واحتياجاته من كوادر التشغيل ومخاطر بقاء الموارد خاملة كلها مرتفعة. أما عند تقلب حجم الاستدعاءات أو غياب فريق متخصص في وحدات GPU، فيظل API الخيار الأكثر أمانًا.
سيناريوهات استخدام Kimi K3.1 Pro وتوصيات الاختيار
الفرق التي يناسبها استدعاء Kimi K3.1 Pro عبر API
- الشركات الناشئة والفرق الصغيرة والمتوسطة: عندما لا تتوفر عنقود GPU أو فرق متخصصة في التشغيل والصيانة، يكون API الخيار المنطقي الوحيد.
- الأعمال التي يتقلب حجم استدعاءاتها: سواء ارتفع الطلب نهارًا وانخفض ليلًا أو قفز خلال الحملات، يساعد الدفع حسب الاستخدام على تجنب تكلفة الموارد المعطلة.
- المشاريع التي تحتاج إلى إطلاق سريع: السرعة هي الأولوية في مرحلة اختبار المنتج، ويمكن إتمام الربط خلال ساعات.
- تقييم عدة نماذج بالتوازي: عند مقارنة نماذج مختلفة في المهمة نفسها، تكون الواجهة الموحدة أسهل بكثير من نشر كل نموذج على حدة.
الفرق التي يناسبها النشر الذاتي لـ Kimi K3.1 Pro
- البيانات التي لا يجوز أن تغادر البيئة الداخلية: كما في القطاعات المالية والطبية والجهات الحكومية والمؤسسات، حيث قد تتطلب اللوائح بقاء البيانات بالكامل داخل الشبكة الداخلية.
- الاستدعاءات المتكررة والمستقرة: عندما يستمر الحمل المرتفع على مدار 24 ساعة طوال أيام الأسبوع، ويمكن الحفاظ على معدل استخدام مرتفع لفترة طويلة.
- توفر عنقود GPU وفريق للتشغيل والصيانة: تكون الاستثمارات الإضافية قابلة للضبط، ويمكن دمج النموذج في البنية التحتية الحالية.
- الحاجة إلى تخصيص متقدم: عند الحاجة إلى ضبط دقيق يستند إلى الأوزان المفتوحة أو إلى تحسينات خاصة للاستدلال، شريطة أن تسمح الرخصة بذلك.
النهج الهجين
هناك خيار آخر يُغفل عنه كثيرًا: استخدام API لبناء النموذج الأولي، ثم إعادة تقييم النشر الذاتي للإنتاج. ويمكن أيضًا اعتماد العكس: معالجة البيانات الحساسة الأساسية عبر النشر الذاتي، وتوجيه الطلبات العامة عبر API. يتيح النهج الأول الاعتماد على بيانات استخدام فعلية بدلًا من التقديرات الحدسية، بينما يوازن الثاني بين الامتثال والمرونة.
💡 نصيحة للاختيار: قبل الاستثمار في العتاد، جرّب تشغيل حركة عمل فعلية عبر APIYI apiyi.com لفترة، واستخدم سجلات الاستخدام في لوحة التحكم لحساب عدد رموز tokens اليومية، ونسبة الذروة إلى أدنى مستوى، ومعدل إصابة ذاكرة التخزين المؤقت. هذه البيانات هي الأساس الأكثر موثوقية لتحديد جدوى النشر الذاتي.
الأسئلة الشائعة FAQ
س1: هل يمكن نشر Kimi K3.1 Pro ذاتيًا على خادم واحد؟
وفقًا لتقديرات MXFP4، يبلغ حجم الأوزان نحو 1.4 تيرابايت، وهو ما يتجاوز سعة خادم عادي مزود بـ 8 بطاقات. وحتى العقد التي تحتوي على بطاقات بذاكرة أكبر ستجد صعوبة في توفير مساحة كافية لذاكرة KV Cache لنافذة سياق تبلغ مليون رمز. الحل العملي هو النشر على عدة بطاقات وخوادم، على أن تُحدد الإعدادات وفقًا لوثائق النشر الرسمية.
س2: هل يعني تنشيط 104 مليارات معلمة أن متطلبات العتاد تُحسب بناءً على هذا العدد فقط؟
لا. يحدد عدد المعلمات النشطة حجم الحسابات لكل رمز، لكن أوزان جميع الخبراء يجب أن تبقى في ذاكرة البطاقات الرسومية، لذا تظل متطلبات الذاكرة محسوبة على أساس إجمالي المعلمات البالغ 2.8 تريليون. وهذه سمة نماذج MoE: حسابات أسرع، لكن بأوزان أكثر يجب تخزينها.
س3: هل يمكن استخدام الأوزان المفتوحة تجاريًا مباشرة؟
ليس بالضرورة. إتاحة الأوزان لا تعني السماح بالاستخدام التجاري دون شروط. يجب الرجوع إلى نص الترخيص الرسمي لمعرفة حدود الإيرادات والتزامات الإخطار والقيود على الخدمات المستضافة، ويُنصح باستشارة الفريق القانوني قبل شراء العتاد.
س4: كيف أجرّب واجهة API الخاصة بـ Kimi K3.1 Pro بتكلفة منخفضة؟
يمكنك التسجيل في APIYI على apiyi.com واستخدام رصيد الاختبار المجاني للمستخدمين الجدد، ثم ربط مشاريعك الحالية عبر واجهة متوافقة مع OpenAI. يتيح مفتاح واحد على المنصة استدعاء نماذج سلسلة Kimi ونماذج أخرى مثل Claude وGPT وGemini. يُرجى الرجوع إلى لوحة التحكم للتحقق من توفر `kimi-k3.1-pro` وسعره.
س5: كيف أختار بين الإصدار القياسي وإصدار Highspeed؟
يبلغ سعر Highspeed `$4/$20`، أي ضعف سعر الإصدار القياسي، وتبلغ سرعته نحو ثلاثة أضعاف. يناسب Highspeed التفاعل الفوري مع المستخدمين والوكلاء الحساسين لزمن ظهور أول رمز، بينما يكون الإصدار القياسي مع التخزين المؤقت أقل تكلفة للمعالجة الدفعية غير الفورية والمهام الخلفية.
الخلاصة: قائمة التحقق للاختيار بين النشر الذاتي لـ Kimi K3.1 Pro وواجهة API
إتاحة أوزان Kimi K3.1 Pro خطوة إيجابية، فهي تمنح الفرق التي تملك الإمكانات خيارًا تتحكم فيه بالكامل. لكن عدد معلماته البالغ 2.8T يجعله نموذجًا يتطلب عنقودًا من الأجهزة؛ فالتحدي في النشر الذاتي ليس تنزيل الأوزان، بل حساب تكاليف العتاد ومعدل الاستخدام والتشغيل والصيانة والترخيص. بالنسبة إلى معظم الفرق، فإن المسار الأقل مخاطرة هو تشغيل الخدمة أولًا عبر API بسعر $2/$10، ثم تقييم جدوى النشر الذاتي باستخدام بيانات فعلية.
أبرز النقاط حول Kimi K3.1 Pro
- المواصفات: إجمالي معلمات يبلغ 2.8T، منها 104B مفعّلة، و93 طبقة MoE، مع دعم أصيل لتعدد الوسائط ونافذة سياق بحجم 1M.
- الأوزان: يُقدّر حجمها بنحو 1.4TB بتنسيق MXFP4، والحجم الفعلي تحدده الملفات الرسمية؛ ولا يمكن استيعابها على جهاز واحد.
- العتاد: يتطلب النشر المتوازي عدة بطاقات GPU وأجهزة، مع تخصيص ذاكرة GPU إضافية لـ KV Cache عند استخدام سياق طويل.
- الترخيص: إتاحة الأوزان لا تعني حرية استخدامها تجاريًا دون قيود؛ وتخضع الشروط للترخيص الرسمي.
- الأسعار: الإصدار القياسي
$2/$10، وعند إصابة ذاكرة التخزين المؤقت$0.20، وإصدار Highspeed بسعر$4/$20. - القرار: معدل الاستخدام هو العامل الحاسم؛ وتُفضّل API للعمليات منخفضة أو متوسطة التكرار، أو التي يتقلب حجمها بشدة.
قائمة التحقق: النشر الذاتي أم API
| عنصر التحقق | مؤشرات اختيار API | مؤشرات اختيار النشر الذاتي |
|---|---|---|
| حجم الاستدعاءات | حجم شهري محدود أو متقلب بوضوح | حمل مرتفع مستمر على مدار 7×24 |
| امتثال البيانات | يمكن إرسال البيانات إلى مزود الخدمة | يجب أن تبقى البيانات داخل الشبكة الداخلية |
| إمكانات GPU | لا يوجد عنقود أو فريق مخصص للتشغيل والصيانة | يتوفر عنقود متعدد الأجهزة وفريق تشغيل وصيانة |
| الترخيص | لا ترغب في التعامل مع شروط التوزيع والاستضافة | أكد الفريق القانوني شروط الاستخدام التجاري |
| وقت الإطلاق | تحتاج إلى الإطلاق والتحقق بسرعة | يمكن قبول دورة نشر تستغرق أسابيع إلى أشهر |
| بيانات التكلفة | لا تتوفر بعد إحصاءات فعلية للاستدعاءات | حُسبت نقطة التعادل باستخدام بيانات فعلية |
إذا كانت معظم إجاباتك تقع في عمود API، فيمكنك البدء بها مباشرة. نوصي باستخدام APIYI على apiyi.com للوصول إلى سلسلة Kimi وغيرها من النماذج الرائدة بمفتاح واحد، والاستفادة من سجلات الاستخدام في لوحة التحكم لجمع بيانات فعلية. وعندما يزداد حجم الاستدعاءات أو تستدعي متطلبات الامتثال ذلك، يمكنك استخدام هذه البيانات لتقييم النشر الذاتي.
الكاتب: الفريق التقني في APIYI
التواصل التقني: يمكنك التواصل معنا عبر الصفحة الرئيسية لموقع APIYI، والاطلاع على مزيد من إرشادات الدمج في مركز التوثيق على docs.apiyi.com


