
Примечание автора: в этой статье — по мотивам официального исследовательского поста о том, как несколько копий Claude Fable 5.2 в режиме мультиагентной работы решили две задачи по физике чёрных дыр, — я собрал практические приёмы для тяжёлых агентных задач: как выбирать модель, как разбивать роли и как задавать условия остановки.
17 ноября 2026 года Anthropic опубликовала исследовательский пост: несколько копий Claude Fable 5.2 около шести недель работали в фоне и в итоге решили две задачи по физике чёрных дыр. Тем, кто запускает долгие задачи и мультиагентные пайплайны, здесь интересна не сама физика, а показанный способ работы: долго, несколькими параллельными ветками, со взаимной проверкой.
Это не научпоп про физику, и статья не будет решать за вас, чей API стабильнее. Задача у неё одна: перевести инженерные сигналы из исследовательского поста в шаги, которые вы сможете повторить, когда запускаете свои тяжёлые агентные задачи.
Главное: после прочтения вы будете знать, как разделить основное рассуждение и проверку на разные роли, как прописать условия остановки для каждой ветки агентов и как выбирать только среди моделей с явной ценой в таблице моделей — чтобы расходы на долгую задачу можно было оценить заранее и ограничить сверху.
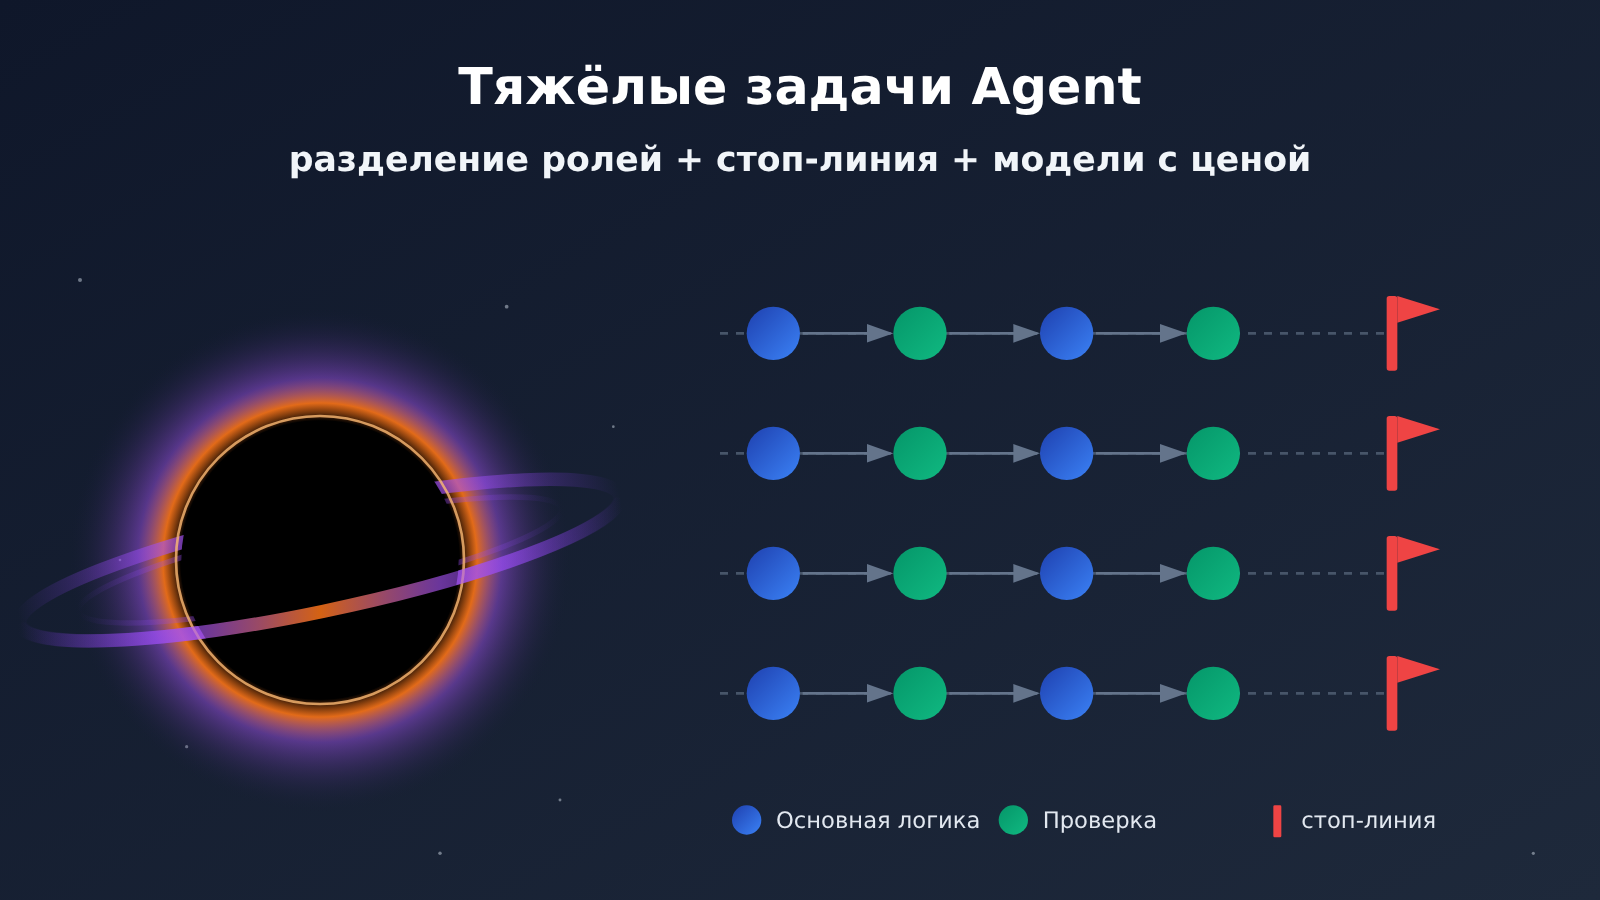
Ключевые выводы о задачах с интенсивным использованием агентов из исследовательского поста Claude Fable 5.2
Сначала пара абзацев о том, с чего всё началось. Исследовательский пост — это официальное описание от Anthropic; упомянутые в нём две статьи на данный момент являются препринтами, а не рецензированными работами. Обе задачи относятся к теоретической физике, описывают не нашу Вселенную и не имеют практического применения, поэтому их значение прежде всего в «методе», а не в том, «насколько важны выводы».
Согласно посту, в августе 2026 года исследователь Hongbin Chen попросил Claude составить список открытых задач в области чёрных дыр и bootstrap. Через несколько часов тот выдал 22 задачи. На каждую задачу он назначил отдельного агента, агенты могли читать прогресс друг друга, и примерно шесть недель всё работало в фоне. В посте сказано «без особой настройки», но это официальное описание того, как всё было построено, а не утверждение о нулевой стоимости — сметы расходов в посте тоже нет.
| Факты из исследовательского поста | Что это значит для задач с интенсивным использованием агентов | Что можно сделать у себя |
|---|---|---|
| Одна задача — один агент, агенты видят прогресс друг друга | Гранулярность разбиения задач должна быть чёткой, общее состояние — читаемым | Отдельный агент на каждую подзадачу, прогресс пишется в общее хранилище |
| Почти каждый шаг выполняют независимо два агента, затем сверка с литературой | Ключевые шаги требуют независимой проверки | Разделить основное рассуждение и проверку на две роли |
| На раннем этапе агенты параллельно пробовали 61 раз и не справились | Провал — норма, но у провала должен быть предел | Для каждого направления прописать максимальное число неудач и бюджет |
| Результаты проверялись формально в Lean и проверялись физиками | Машинный результат в итоге должен пройти внешнюю проверку | Оставить этап ручной или инструментальной валидации |
| В фоне работало около шести недель | Затраты на длительные задачи накапливаются | Оценивать по прайс-листу моделей и ставить потолок расходов |
Что показывают две задачи из области тяжёлых Agent-задач
Первая задача — вычисление фазового перехода Хокинга — Пейджа, которое было предложено ещё в 2003 году и до сих пор не было доведено до конца. В посте говорится, что почти каждый шаг независимо выполняли две копии агентов, а затем сверяли с литературой; вывод — при слабой связи переход всё равно остаётся резким. Другой физик независимым методом получил тот же ответ, что дало перекрёстное подтверждение. Для инженерной практики эта задача иллюстрирует подход к проверке «независимое повторение + внешняя сверка».
Вторая задача — вопрос о верхней границе в простейшей версии модулярного bootstrap. Более ранняя группа Claude-агентов параллельно сделала 61 попытку и не справилась; более поздние агенты заметили закономерность в численных результатах, заимствовали метод из другой задачи — задачи упаковки шаров — и доказали, что верхняя граница массы самой лёгкой чёрной дыры составляет примерно c/9.1266, а также указали, что этим методом границу уже нельзя опустить ещё ниже. В сентябре 2026 года результат прошёл формальную проверку в Lean, статью написала модель Claude, а физики проверили основные результаты. Инженерный вывод из этой задачи: множество неудачных попыток — часть процесса, поэтому у каждого направления должны быть бюджет и условия остановки.
Отдельно стоит пояснить: в посте описан подход «несколько копий одной и той же модели проверяют друг друга», а не «планирование дорогой моделью, проверка дешёвой». Описанная ниже схема разделения ролей для экономии — это инженерный приём, который читатель может попробовать, а не вывод, уже подтверждённый этим исследованием.
Как разделять роли в тяжёлых задачах агента: основной reasoning и проверка отдельно
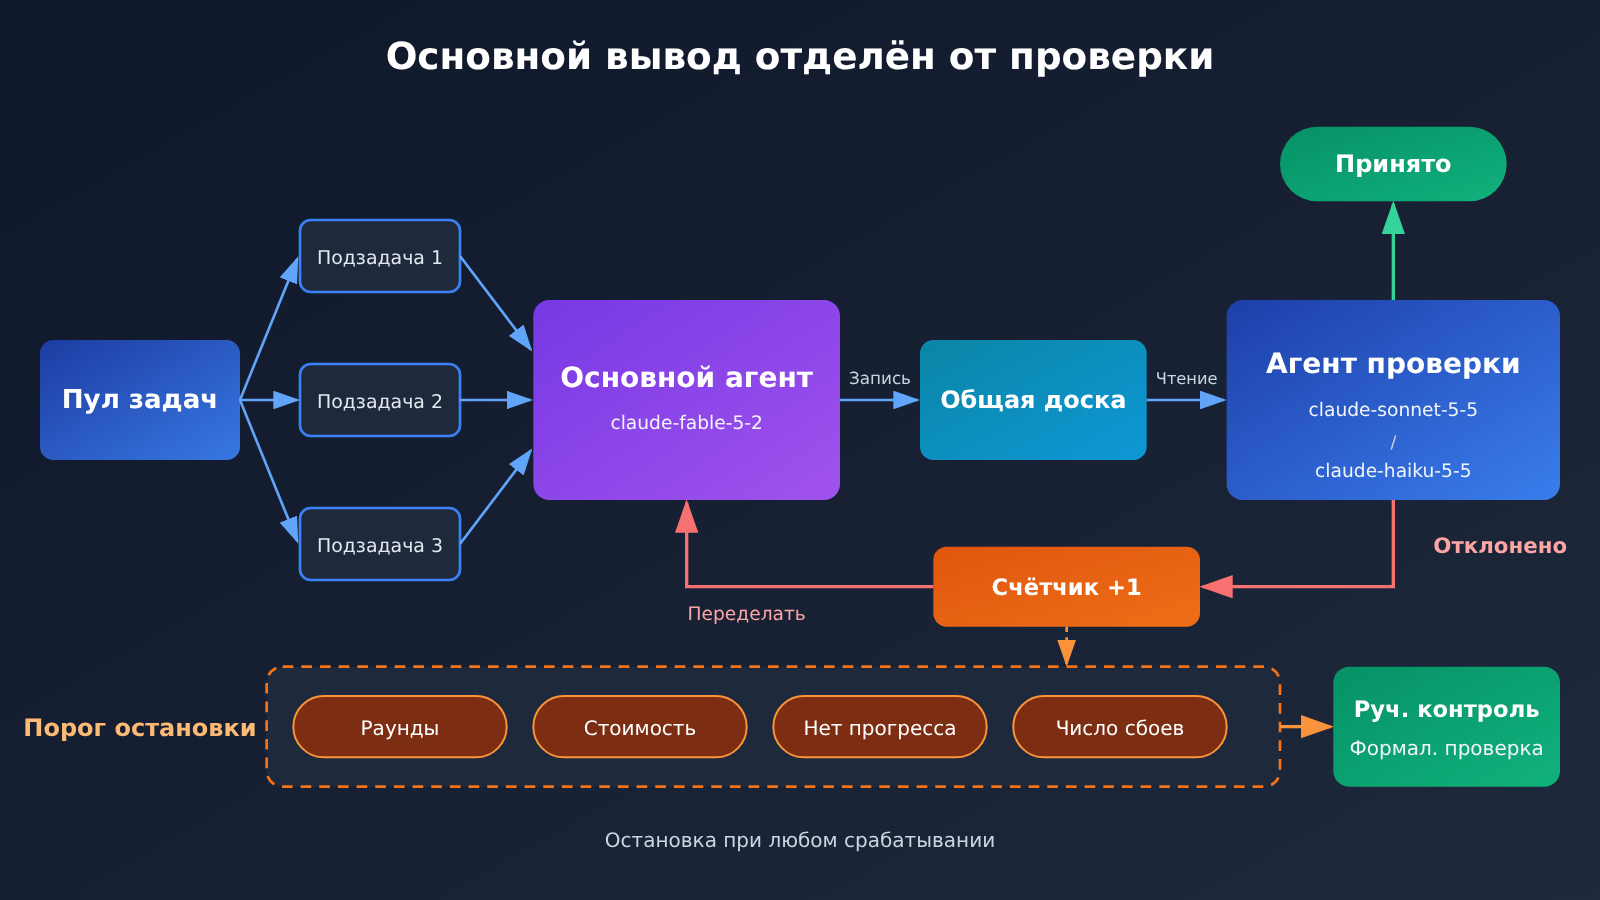
В тяжёлых задачах агента самое дорогое — обычно та ветка, где нужен глубокий reasoning, а самое частое — проверки, сравнения, валидация формата и тому подобные действия. Если все вызовы идут через одну самую дорогую модель, расходы растут линейно, а то и сверхлинейно с числом шагов. Разделить «придумать» и «проверить» на две роли — самый прямой способ сдерживать затраты.
Принцип разделения можно сформулировать так: шаги, где нужен открытый reasoning и длинная цепочка планирования, отдаём роли основного reasoning; проверки с чёткими критериями — «совпадает ли этот шаг с предыдущим», «соответствует ли формат вывода требованиям», «не противоречит ли вывод известной литературе» — отдаём роли проверки. Проверяющая роль должна выдавать структурированное суждение, а не заново прокручивать всё рассуждение.
| Роль | За что отвечает | Кандидаты model ID | Требования к выводу |
|---|---|---|---|
| Основной reasoning | Открытые рассуждения, генерация решений, ключевые шаги | claude-fable-5-2, claude-fable-5-2-thinking |
Полный процесс рассуждений и промежуточные выводы |
| Первичная проверка | Логическая согласованность, сопоставление шагов, проверка ссылок | claude-sonnet-5-5 |
PASS / FAIL плюс обоснование |
| Лёгкая валидация | Проверка формата, полнота полей, простое сравнение | claude-haiku-5-5 |
Структурированный JSON-результат |
| Внешняя проверка | Формальное доказательство, численная проверка, ручной обзор | Инструменты или человек | Финальное подтверждение |
После такого разделения все роли могут обращаться к одному и тому же входу для вызова. Через APIYI apiyi.com один API-ключ позволяет переключаться между моделями из таблицы выше, интерфейс совместим с OpenAI, и для основного reasoning и проверки достаточно поменять параметр model — не нужно держать несколько SDK и несколько наборов ключей. Для длинных задач с несколькими параллельными ветками единый вход ещё и собирает статистику использования в одном месте, что удобно для сверки.
Но обратите внимание: то, что проверяющая модель дешевле, не значит, что она надёжнее. Справится ли роль проверки, зависит от того, насколько чётко вы задали критерии. Рекомендую сначала прогнать небольшую выборку примеров с известными ответами и убедиться, что проверяющая модель в основном даёт ожидаемые решения «пропустить» и «отправить на доработку», и только потом ставить её в длинную задачу.
Как выбрать API для ресурсоёмких задач Agent: о ценах и ID моделей
Контроль бюджета длительных задач возможен только при условии, что цена каждого вызова определена. Рекомендую держаться одного принципа: вызывать только те модели, у которых в каталоге есть явная цена, и жёстко прописывать в коде ID модели вместе с соответствующей ценой, а не менять всё на лету во время выполнения.
Согласно официальной странице моделей Anthropic, Claude Fable 5.2 выпущена 9 ноября 2026 года, ID модели — claude-fable-5-2, контекстное окно — 1 млн tokens, максимальный вывод — 128 тыс. tokens, режим размышления включён по умолчанию. В таблице ниже — цены моделей, связанных с этой статьей, из общего каталога моделей APIYI apiyi.com на день сверки (2026-11-19), в долларах за миллион tokens.
| ID модели | Ввод | Чтение кэша | Вывод | Рекомендуемая роль в статье |
|---|---|---|---|---|
claude-fable-5-2 |
8 | 0.2 | 40 | Основное рассуждение |
claude-fable-5-2-thinking |
8 | 0.2 | 40 | Основное рассуждение (версия с размышлением) |
claude-fable-5-1 |
10 | 0.25 | 50 | Соседняя версия, для сравнения |
claude-sonnet-5-5 |
2 | 0.1 | 10 | Первичная проверка |
claude-haiku-5-5 |
0.1 | 0.01 | 0.5 | Лёгкая проверка |
Из таблицы можно вынести несколько вещей, критичных для длительных задач. Во-первых, цена claude-fable-5-2 ниже, чем у соседней claude-fable-5-1: если ваше основное рассуждение работало на старой версии, стоит оценить переход. Во-вторых, цена чтения кэша составляет всего 2.5% от цены ввода: в длительных задачах агент многократно перечитывает общий прогресс, системный промпт и фоновые документы, и если эта часть попадает в кэш, разница в расходах будет очень заметной. Попадёт ли она в кэш — зависит от способа вызова и правил платформы, сверяйтесь с документацией. В-третьих, разрыв в цене за единицу между моделью проверки и основной моделью — на порядки.
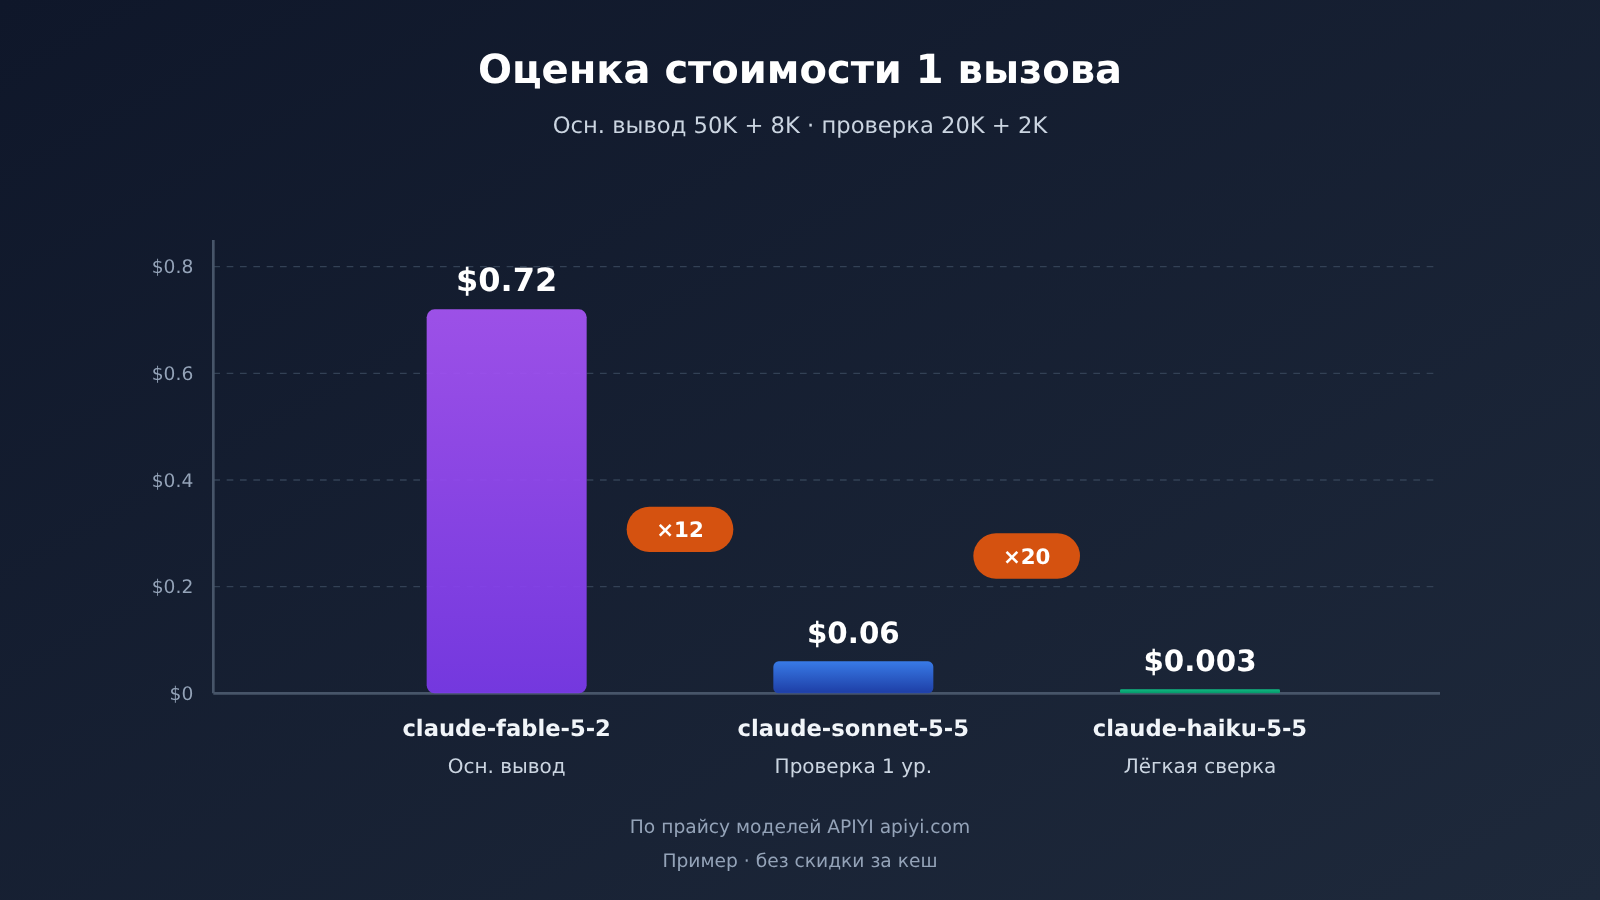
Давайте почувствуем это на наборе условных чисел: один вызов основного рассуждения с вводом 50 тыс. tokens и выводом 8 тыс. tokens на claude-fable-5-2 — примерно 0.4 + 0.32 = 0.72 доллара; один вызов проверки с вводом 20 тыс. и выводом 2 тыс. tokens на claude-sonnet-5-5 — примерно 0.04 + 0.02 = 0.06 доллара, а на claude-haiku-5-5 — около 0.003 доллара. Если для проверки тоже использовать основную модель, такой же вызов проверки обойдётся примерно в 0.16 + 0.08 = 0.24 доллара. Это всего лишь арифметическая иллюстрация, реальное количество tokens зависит от вашей задачи.
Кроме того, на официальной странице моделей указаны цены Opus 5.5: вход — 4, выход — 20; Sonnet 5.5 — 2 и 10; Haiku 5.5 — от 0.10 и 0.50. Это можно использовать как ориентир для понимания официальной ценовой градации. При фактическом вызове модель и цена определяются списком моделей на платформе; серия claude-fable-5-2 от APIYI поддерживает два эндпоинта — chat и messages, единая точка входа — https://api.apiyi.com/v1.
Быстрый старт для ресурсоёмких Agent-задач: код планировщика с механизмом остановки
Минимальный пример
Сначала убедитесь, что основная модель рассуждения вызывается нормально и возвращает поле usage — это основа для последующего подсчёта расходов:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # OpenAI-совместимый интерфейс APIYI
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",
    messages=[{"role": "user", "content": "列出这一步推导需要独立核对的三个关键假设"}],
    max_tokens=2000,
)
print(resp.choices[0].message.content)
print(resp.usage)  # для подсчёта токенов и оценки стоимости
Пропишите чёткие линии остановки для каждого агента
В исследовательском посте ранние агенты параллельно сделали 61 попытку и ни одна не удалась — это хорошее напоминание: в тяжёлых Agent-задачах обязательно будет масса неудачных попыток, а неудачи тоже стоят денег. Смысл линии остановки в том, чтобы каждый агент автоматически останавливался до того, как выйдет из-под контроля, и передавал решение человеку или инструменту.
| Линия остановки | Значение | Рекомендуемое начальное значение (корректируется по задаче) |
|---|---|---|
| Максимальное число раундов | Верхний предел циклов между основным рассуждением и проверкой | 10–30 раундов |
| Потолок расходов | Верхний предел накопленной оценочной стоимости одного агента | Задаётся по бюджету на одну задачу |
| Отсутствие прогресса подряд | Проверка раз за разом возвращает на доработку, новых выводов нет | 3–5 раз |
| Максимальное число неудач | Накопленное число возвратов на доработку проверкой | Примерно половина числа раундов |
| Длина вывода | Верхний предел токенов на один вывод | Значительно ниже максимального вывода в 128 тыс. |
Посмотреть полный код реализации
from dataclasses import dataclass, field
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Единая точка входа APIYI, общая для основного рассуждения и проверки
)

# Цена: доллары США за миллион токенов, взята из таблицы моделей платформы; при изменениях обновлять вручную
PRICES = {
    "claude-fable-5-2": (8.0, 40.0),
    "claude-sonnet-5-5": (2.0, 10.0),
    "claude-haiku-5-5": (0.1, 0.5),
}

SOLVER = "claude-fable-5-2"
REVIEWER = "claude-sonnet-5-5"


@dataclass
class StopLine:
    max_rounds: int = 20
    max_cost_usd: float = 5.0
    max_no_progress: int = 4
    max_failures: int = 10
    max_output_tokens: int = 8000


@dataclass
class RunState:
    rounds: int = 0
    cost_usd: float = 0.0
    failures: int = 0
    no_progress: int = 0
    notes: list = field(default_factory=list)


def estimate_cost(model: str, usage) -> float:
    """Оценка по каталожной цене; скидки за кеширование не учитываются, поэтому результат получается слегка завышенным."""
    price_in, price_out = PRICES[model]
    return (usage.prompt_tokens * price_in + usage.completion_tokens * price_out) / 1_000_000


def call(model: str, messages: list, max_tokens: int, state: RunState) -> str:
    resp = client.chat.completions.create(
        model=model, messages=messages, max_tokens=max_tokens
    )
    state.cost_usd += estimate_cost(model, resp.usage)
    return resp.choices[0].message.content


def should_stop(state: RunState, line: StopLine) -> str | None:
    if state.rounds >= line.max_rounds:
        return "达到最大轮数"
    if state.cost_usd >= line.max_cost_usd:
        return "达到费用封顶"
    if state.no_progress >= line.max_no_progress:
        return "连续无进展"
    if state.failures >= line.max_failures:
        return "失败次数过多"
    return None


def run_task(task: str, line: StopLine = StopLine()) -> dict:
    state = RunState()
    progress = "(尚无进展)"

    while True:
        reason = should_stop(state, line)
        if reason:
            return {"status": "stopped", "reason": reason, "progress": progress,
                    "cost_usd": round(state.cost_usd, 4), "rounds": state.rounds}

        state.rounds += 1
        draft = call(SOLVER, [
            {"role": "system", "content": "你是主推理代理,只推进一步,写清依据。"},
            {"role": "user", "content": f"任务:{task}\n当前进展:{progress}\n请推进下一步。"},
        ], line.max_output_tokens, state)

        verdict = call(REVIEWER, [
            {"role": "system", "content": "你是复核代理,不重新推导,只判断。"
                                          "第一行只输出 PASS 或 FAIL,第二行给理由。"},
            {"role": "user", "content": f"已有进展:{progress}\n新的一步:{draft}"},
        ], 500, state)

        if verdict.strip().upper().startswith("PASS"):
            progress = draft
            state.no_progress = 0
            if "已完成" in draft:
                return {"status": "done", "progress": progress,
                        "cost_usd": round(state.cost_usd, 4), "rounds": state.rounds}
        else:
            state.failures += 1
            state.no_progress += 1
            state.notes.append(verdict)


if __name__ == "__main__":
    print(run_task("核对给定推导中每一步的符号约定是否一致,完成后写“已完成”"))
В этом коде есть три намеренных решения. Во-первых, таблица цен жёстко зашита в код: любой, кто меняет модель, обязан заодно поменять и цену — чтобы замена на «модель без ценника» не исказила бюджет. Во-вторых, от роли-проверяющего требуется выводить только PASS или FAIL с обоснованием, без повторных рассуждений — так длина вывода проверки остаётся под контролем. В-третьих, после остановки возвращаются текущий прогресс и накопленные расходы — чтобы человек мог подхватить работу, а не агент бесконечно повторял попытки.
🚀 Быстрый старт: рекомендую сначала на APIYI apiyi.com воспользоваться бесплатным тестовым лимитом нового пользователя, прогнать описанный процесс на небольшой задаче, ответ на которую вы уже знаете, убедиться, что вердикт проверки и оценка расходов совпадают с ожиданиями, и только потом постепенно увеличивать число параллельных путей и раундов.
FAQ: частые вопросы о выборе API для тяжёлых Agent-задач
Q1: Насколько достоверна история о том, как Claude Fable 5.2 решил сложную задачу физики чёрных дыр?
Это официальное заявление самой Anthropic из исследовательского поста от 17 ноября 2026 года. Две соответствующие статьи — препринты, ещё не прошедшие рецензирование. Результат второй задачи в сентябре 2026 года был формально проверён с помощью Lean, а для первой задачи другой физик получил тот же ответ другим методом. При чтении стоит воспринимать это на уровне «официальное заявление + препринт».
Q2: В посте сказано «без особой конфигурации» — значит, это дёшево?
Нет. «Без особой конфигурации» описывает способ настройки, но счёта затрат в посте нет. 22 задачи, по одному агенту на задачу, работа в фоне около шести недель — сам объём вызовов уже немалый. Если вы запускаете задачи похожего масштаба самостоятельно, оценивайте стоимость по ценам из таблицы моделей и устанавливайте лимит расходов.
Q3: Использование дешёвой модели для проверки — это метод, проверенный в исследовательском посте?
Нет. В посте применялся подход, где несколько независимых копий одной и той же модели заново решают задачу и сверяют результаты друг с другом. «Дорогая модель для основного рассуждения, дешёвая — для проверки» — это инженерный приём, который мы предлагаем вам попробовать; его эффективность нужно проверить на собственных задачах. Для шагов с особо высокими требованиями к корректности можно сохранить схему «две независимые копии основного рассуждения».
Q4: Как выбрать между `claude-fable-5-2` и `claude-fable-5-2-thinking`?
В таблице моделей APIYI у обоих одинаковая цена: вход 8, чтение кэша 0.2, выход 40 долларов за миллион токенов. На официальной странице модели указано, что у Fable 5.2 режим рассуждения включён по умолчанию. Конкретные различия в поведении при вызове двух ID уточняйте в описании модели на платформе; рекомендую несколько раз прогнать одну и ту же задачу на каждом и сравнить длину вывода и `usage`, прежде чем решать, какой брать для основного рассуждения.
Q5: Как через один интерфейс вызывать и модель основного рассуждения, и модель проверки?
Зарегистрируйтесь на APIYI apiyi.com и получите API-ключ, затем укажите в SDK `base_url` равным `https://api.apiyi.com/v1`. Для основного рассуждения и проверки достаточно переключить параметр `model`, например между `claude-fable-5-2` и `claude-sonnet-5-5`. Новым пользователям даётся бесплатная квота на тесты — удобно, чтобы сначала проверить условие остановки и логику проверки.
Q6: Какое значение имеет цена чтения кэша в длинных задачах?
Цена чтения кэша у Fable 5.2 составляет 2.5% от цены входа, то есть 0.2 доллара за миллион токенов. В длинных многоагентных задачах система многократно перечитывает системный промпт, фоновые материалы и общий прогресс. Если эта часть остаётся стабильной и размещена в начале промпта, шанс попасть в кэш выше. Попадёт ли запрос в кэш и как именно это тарифицируется — уточняйте в документации платформы.
Q7: Какой предел остановки установить?
Универсальных цифр нет. Рекомендую начать с консервативных значений: 10–30 раундов, 3–5 итераций подряд без прогресса, лимит стоимости одного прогона — в зависимости от ценности задачи. После первой партии прогонов посмотрите на распределение причин остановки: если большинство — «упёрлись в лимит стоимости», но задача уже почти решена, лимиты можно слегка ослабить; если большинство — «нет прогресса подряд», значит задачу декомпозировали недостаточно мелко.
Вопрос 8: какие ограничения есть у такого подхода?
Первое — модель-ревьюер может пропустить ошибку или, наоборот, сработать ложно, поэтому её нужно калибровать на выборке с известными ответами. Второе — оценка стоимости сделана по каталожным ценам, без учёта скидки за кэш и колебаний из-за повторных попыток при сбоях. Третье — как и в том исследовательском посте, итоговый вывод всё равно требует внешней проверки: формального доказательства или ревью профильного эксперта. То, что агенты друг у друга приняли результат, ещё не значит, что он верный.
Ключевые выводы: как выбирать API для тяжёлых агентных задач
- Что это за история: исследование чёрных дыр на Fable 5.2 — это официальный рассказ самой компании, статья — препринт, смотрите на метод, а не на выводы
- Разделяйте роли: открытые рассуждения — основной модели-рассуждателю, проверки с чёткими критериями — модели-ревьюеру
- Ревью должно быть независимым: ревьюер только выносит вердикт, не повторяя рассуждение; на выходе PASS / FAIL плюс обоснование
- Границы остановки прописывать обязательно: четыре линии — раунды, стоимость, итерации подряд без прогресса, число сбоев — нужны все
- Только модели с известной ценой: ID модели и цену за единицу жёстко зашивайте в код; меняете модель — сразу меняйте и цену
- Активно используйте чтение из кэша: стабильное описание задачи и прогресс — в начало промпта, чтение из кэша стоит всего 2,5% от цены входа
- Начните с единой точки входа: через APIYI один ключ переключает основную модель и ревьюера; сначала прогоните мелкую задачу на бесплатном лимите
Итог
На примере того, как Claude Fable 5.2 разобрался с задачей по физике чёрных дыр, в тяжёлых агентных задачах стоит взять на вооружение три подхода:
- Разделять основное рассуждение и проверку: в исследовательском посте несколько копий одной и той же модели сверяют результаты друг друга. На этой основе можно попробовать выбирать модели разной ценовой категории под разные роли и проверять качество проверки на выборках.
- Для каждой ветки явно прописывать условия остановки: 61 неудачная попытка наглядно показывает, что неудачи — это норма. Нужно задавать верхние границы для числа раундов, затрат, отсутствия прогресса и количества ошибок.
- Настраивать только модели с ценой в таблице моделей: если записать в код ID и цену за единицу для моделей вроде
claude-fable-5-2,claude-sonnet-5-5,claude-haiku-5-5, расходы можно будет прогнозировать и ограничивать сверху.
Успех длинных задач часто зависит не от того, насколько умён отдельный вызов, а от того, может ли весь процесс продвигаться вперёд в рамках контролируемого бюджета и оставлять проверяемые результаты. Рекомендую через APIYI apiyi.com с бесплатным тестовым лимитом сначала прогнать небольшую задачу, а затем, ориентируясь на причины остановки, постепенно подкручивать параметры и масштабироваться.
📚 Источники
-
Исследовательский пост Anthropic: официальный рассказ о том, как Claude Fable 5.2 в мультиагентном режиме решил две задачи по физике чёрных дыр.
- Ссылка:
anthropic.com/research/claude-black-hole-physics - Описание: первоисточник о разделении ролей между агентами, времени работы и способах проверки результатов.
- Ссылка:
-
Препринт №1: препринт, связанный с исследовательским постом, без рецензирования.
- Ссылка:
hexagonmath.org/2611.00175v1 - Описание: подойдёт тем, кто хочет посмотреть на исходный текст результатов.
- Ссылка:
-
Препринт №2: ещё один препринт, связанный с исследовательским постом, без рецензирования.
- Ссылка:
hexagonmath.org/2611.00174v1 - Описание: стоит читать в паре с предыдущим.
- Ссылка:
-
Официальная страница модели Claude Fable 5.2: ID модели, контекстное окно, максимальный объём вывода и официальные цены.
- Ссылка:
platform.claude.com/docs/en/models/fable-5-2/overview - Описание: проверка характеристик модели и официальной градации тарифов.
- Ссылка:
Автор: техническая команда APIYI
По техническим вопросам: пишите нам через главную страницу сайта APIYI; описание моделей и цен есть в документации docs.apiyi.com


