
Anthropic официально выпустила Claude Fable 5.2 9 ноября 2026 года. Согласно официальной таблице возможностей и сторонним рейтингам, модель заметно превосходит версию 5.1 в решении сложных задач и длительной совместной работе. При этом стандартные тарифы API на 20% ниже, чем у 5.1.
Главное: в этой статье мы сначала подведём итоги, затем рассмотрим доказательства и обозначим ограничения. Это поможет понять, в чём именно силён Claude Fable 5.2, насколько он лучше и стоит ли уже сейчас переходить на него для ваших задач.
Краткий словарь терминов для оценки Claude Fable 5.2
Ниже часто будут встречаться разные методики оценки. Если неверно их истолковать, легко принять демонстрацию от производителя за независимую проверку или решить, что частичный балл означает процент успешно пройденных заданий.
- Агент (Agent): система на базе модели, способная вызывать инструменты и выполнять задачи в несколько последовательных шагов.
- Intelligence Index: сводный индекс возможностей от Artificial Analysis (AA). Это комплексная оценка, а не процент правильных ответов.
- OSWorld partial: методика оценки работы с компьютером, при которой учитывается частичное выполнение задачи. Это не то же самое, что строгий процент заданий, пройденных целиком.
- RoboDojo Sim: оценка управления роботами в симуляционной среде. Её результаты не отражают успешность работы реальных роботов.
- PCB: печатная плата, на которой размещают и соединяют электронные компоненты.
- Lean / формальное доказательство: Lean — язык и инструмент, с помощью которого компьютер может проверять доказательства. Формальное доказательство — это математическое рассуждение, записанное в виде строгих шагов, которые можно последовательно проверить машиной.
- Сотрудничество нескольких агентов: несколько экземпляров модели распределяют между собой задачи, обмениваются результатами, а затем объединяют их.
Насколько хорош Claude Fable 5.2: сначала выводы, затем контекст выпуска
Коротко: Claude Fable 5.2 заметно лучше справляется со сложным программированием, длительными задачами и тестами на преобразование визуальной информации в действия, но нельзя сказать, что он «лучший во всём». В некоторых автоматизированных тестах и оценках предпочтений он по-прежнему уступает другим моделям.
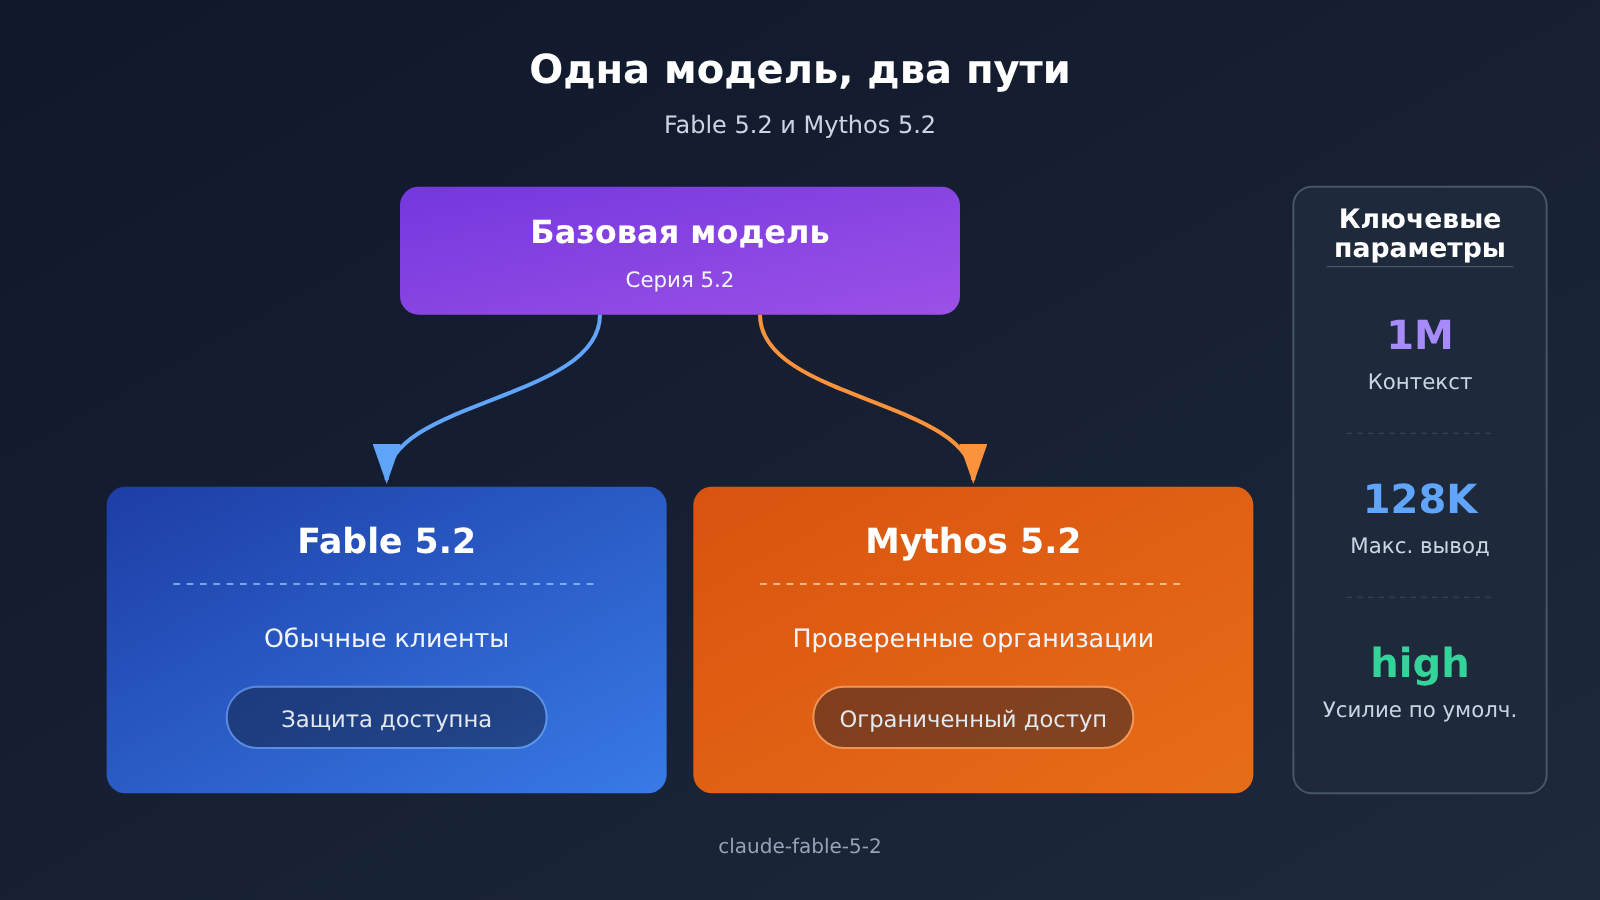
Сначала важно пояснить контекст выпуска. По словам разработчиков, Fable и Mythos используют одну и ту же базовую модель. Защита Fable от угроз в сфере кибербезопасности и биобезопасности позволяет открыть его для широкой аудитории, тогда как Mythos доступен только прошедшим проверку организациям. Поэтому возможности и результаты, доступные только для Mythos, нельзя автоматически приписывать обычной версии Fable.
Ключевые сведения о Claude Fable 5.2
| Параметр | Подробности | Тип источника |
|---|---|---|
| Дата выпуска | 9 ноября 2026 года | Официальный анонс |
| Идентификатор API | claude-fable-5-2 |
Официальная документация модели |
| Контекстное окно / максимальный объём вывода | 1 млн токенов / 128 тыс. токенов | Официальная документация модели |
| Входные и выходные данные | На входе — текст и изображения, на выходе — текст | Официальная документация модели |
| Режим рассуждений | Адаптивное рассуждение включено постоянно, значение effort по умолчанию в API — high |
Официальная документация модели |
| Дата отсечения знаний | Июнь 2026 года (это не означает наличие доступа к интернету в реальном времени) | Официальная документация модели |
| Стандартная цена | 8 долларов за миллион входных токенов и 40 долларов за миллион выходных — на 20% дешевле, чем у версии 5.1 | Официальная страница с ценами |
| Заявленная скорость | Генерация выходных данных «до 30% быстрее», чем у версии 5.1 | Максимальный показатель от производителя |
Здесь легко неверно истолковать два момента. Во-первых, «до 30% быстрее» — это максимальный показатель скорости генерации, заявленный производителем, а не обещание сократить время выполнения каждой задачи на 30%. Во-вторых, стандартная цена Fable 5.2 всё ещё вдвое выше, чем у Opus 5.5 (4/20 долларов).
Разработчики также прямо рекомендуют для большинства повседневных задач по программированию и работе со знаниями сначала использовать Opus 5.5, а на Fable переходить для более сложных задач.
Основания для улучшения Claude Fable 5.2 в программировании и длительных задачах
Программирование — главная тема этого релиза. Сначала посмотрим на данные, опубликованные разработчиком, а затем — на результаты двух независимых тестов в разных средах.
Официальные показатели: Fable 5.2 в сравнении с 5.1 и Opus 5.5
| Тест (данные разработчика) | Fable 5.2 | Fable 5.1 | Opus 5.5 | Примечание |
|---|---|---|---|---|
| FrontierCode 2.0 | 49.1% | 32.4% | — | Для двух моделей выбраны разные уровни effort |
| FrontierSWE v2 | 69.9% | 56.3% | 62.3% | Длительные задачи по разработке ПО |
| AutomationBench | 51.4% | 31.4% | 42.5% | Задачи автоматизации |
| OSWorld 2.1, офлайн-подмножество, partial | 89.3% | 83.5% | 87.2% | Используется частичный подсчёт баллов |
| RoboDojo Sim | 64.9% | 27.6% | 39.4% | Управление роботами в симуляции |
По таблице видно, что в FrontierSWE v2 результат Fable 5.2 на 13,6 процентного пункта выше, чем у версии 5.1, и выше, чем у Opus 5.5. Прирост в FrontierCode 2.0 ещё заметнее, но для двух моделей использовались разные уровни effort, поэтому часть прироста может объясняться настройками рассуждений.
Независимые данные: Claude Fable 5.2 в тестах AA и Cursor
| Среда тестирования | Конфигурация | Результат | Стоимость задачи (доллары США) |
|---|---|---|---|
| Artificial Analysis | Fable 5.2 medium | 56 | 3.80 |
| Artificial Analysis | Fable 5.2 high | 62 | 9.08 |
| Artificial Analysis | Fable 5.2 xhigh | 62 | 14.83 |
| Artificial Analysis | Fable 5.2 max | 65 | 26.54 |
| Artificial Analysis | Opus 5.5 max | 59 | 10.04 |
| CursorBench 4.0 | Fable 5.2 High | 56.9% | 9.70 |
| CursorBench 4.0 | Fable 5.2 Max | 60.0% | 32.79 |
| CursorBench 4.0 | Opus 5.5 High | 56.0% | 3.97 |
AA — независимая организация, проводящая оценку моделей. В её рейтинге Intelligence Index Fable 5.2 max набрала 65 баллов против 59 у Opus 5.5 max. Это согласуется с направлением результатов из официальной таблицы.
Данные Cursor получены на собственных задачах и в собственной среде с инструментами. Fable 5.2 Max набрала 60,0%, но в режиме High разрыв с Opus 5.5 High составляет всего 0,9 процентного пункта.
Оба независимых теста показывают: более высокий потолок возможностей обычно обходится дороже в пересчёте на задачу. В тесте AA при переходе с high на max результат растёт на 3 балла, а стоимость одной задачи увеличивается примерно в 2,92 раза.
🎯 Техническая рекомендация: рейтинги помогают сузить круг кандидатов, но окончательный вывод стоит делать на своих задачах. С помощью APIYI apiyi.com можно сравнить Opus, Fable и другие модели через один и тот же OpenAI-совместимый интерфейс, используя одинаковые промпты и критерии приёмки. Затем фиксируйте качество и стоимость для каждого режима.
На каком уровне находятся визуальные и инженерные возможности Claude Fable 5.2
От понимания экрана к управлению действиями
В области компьютерного зрения больше всего внимания заслуживают два теста: OSWorld 2.1 и RoboDojo Sim. В офлайн-подмножестве OSWorld 2.1 частичный результат вырос с 83,5% до 89,3%. При этом Opus 5.5 уже набрал 87,2%, так что разница невелика.
В RoboDojo Sim прогресс заметнее: результат вырос с 27,6% до 64,9%. Это говорит о значительном улучшении способности модели преобразовывать визуальное понимание в последовательность управляющих действий.
Fable 5.2 участвует в разработке электронных прототипов
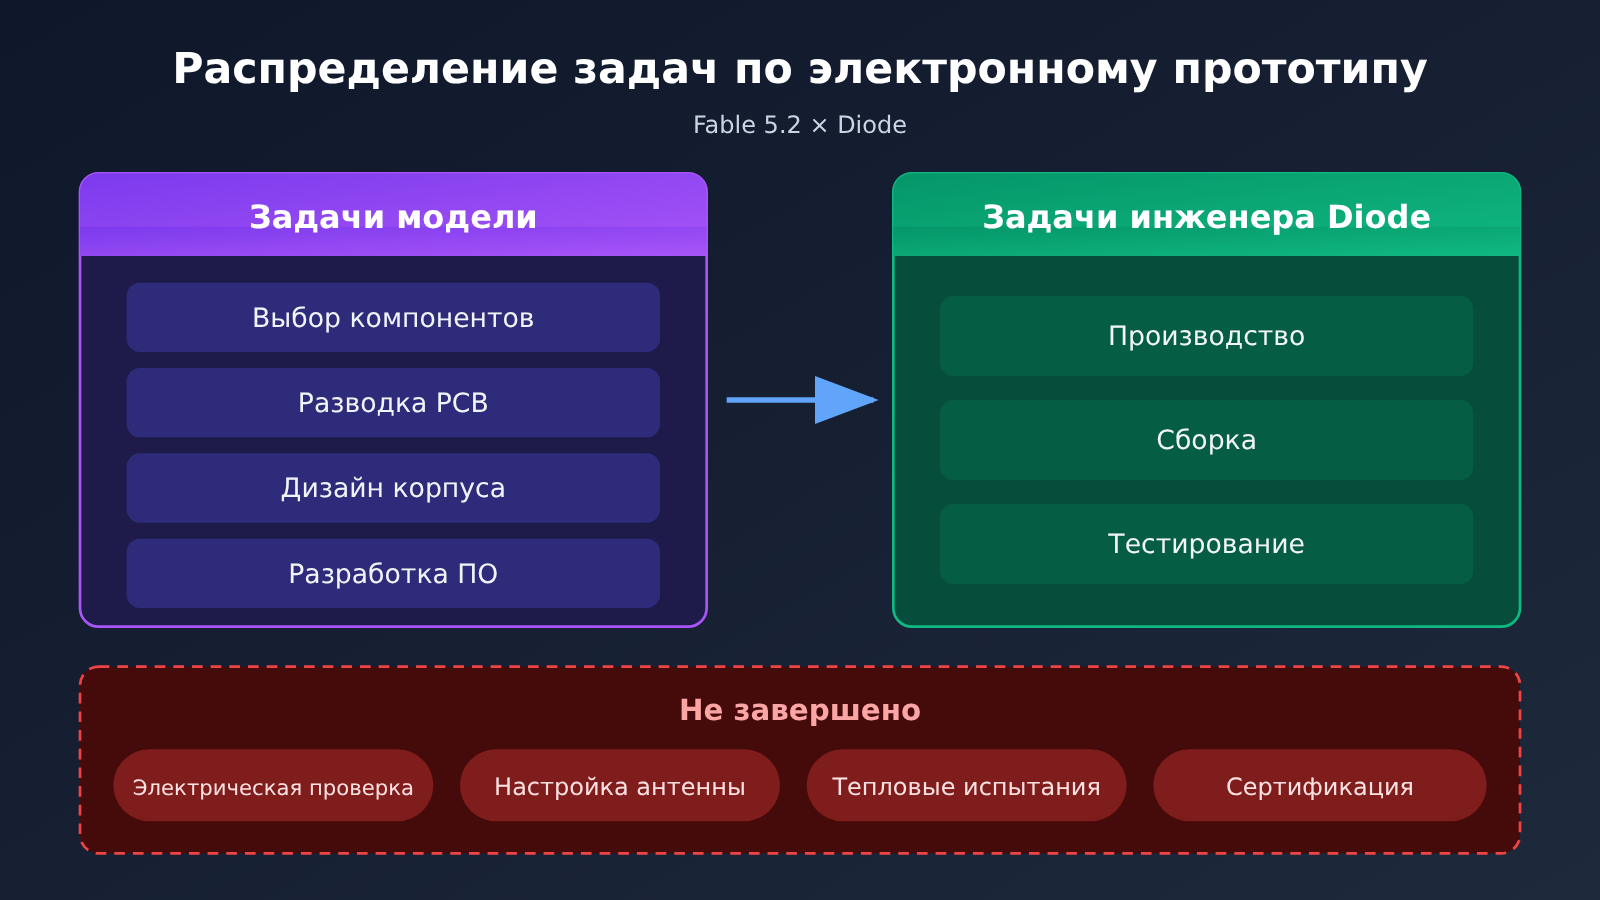
Anthropic и Diode совместно создали три прототипа электронных устройств: голосового помощника, USB-спикерфон и виртуального питомца. Модель участвовала в выборе компонентов, проектировании и разводке печатных плат, разработке корпусов и написании программного обеспечения. Инженеры Diode отвечали за изготовление, сборку и тестирование устройств. Между компаниями есть коммерческое сотрудничество — это стоит учитывать при оценке примера.
Границы этого примера вполне ясны. Все три устройства остались прототипами: они не прошли электрическую проверку, настройку антенны, тепловые испытания или сертификацию и не проектировались с расчётом на серийное производство. Модель не подключалась к производственному оборудованию или тестовым приборам. Поэтому точнее сказать, что «модель может активно участвовать в разработке электронных прототипов», а не что «модель самостоятельно создала готовый к серийному выпуску продукт».
В том же исследовательском документе приведены результаты ещё двух тестов, связанных с проектированием. Первый — внутренний тест PCB Gym, который проводит Diode: Fable 5.2 набрал 69%, а контрольная модель Fable 5 — 25% (не Fable 5.1). Второй — общедоступный бенчмарк BenchCAD 2.1. Он проверяет, насколько хорошо модель умеет восстанавливать 3D-детали, сборки и печатные платы по инженерным чертежам и рендерингам. По данным производителя, Fable 5.2 набрал 83,5%. Сам бенчмарк открыт, но этот результат пока не проверен независимым тестированием.
Почему кейсы Claude Fable 5.2 в науке и работе нескольких агентов привлекают внимание
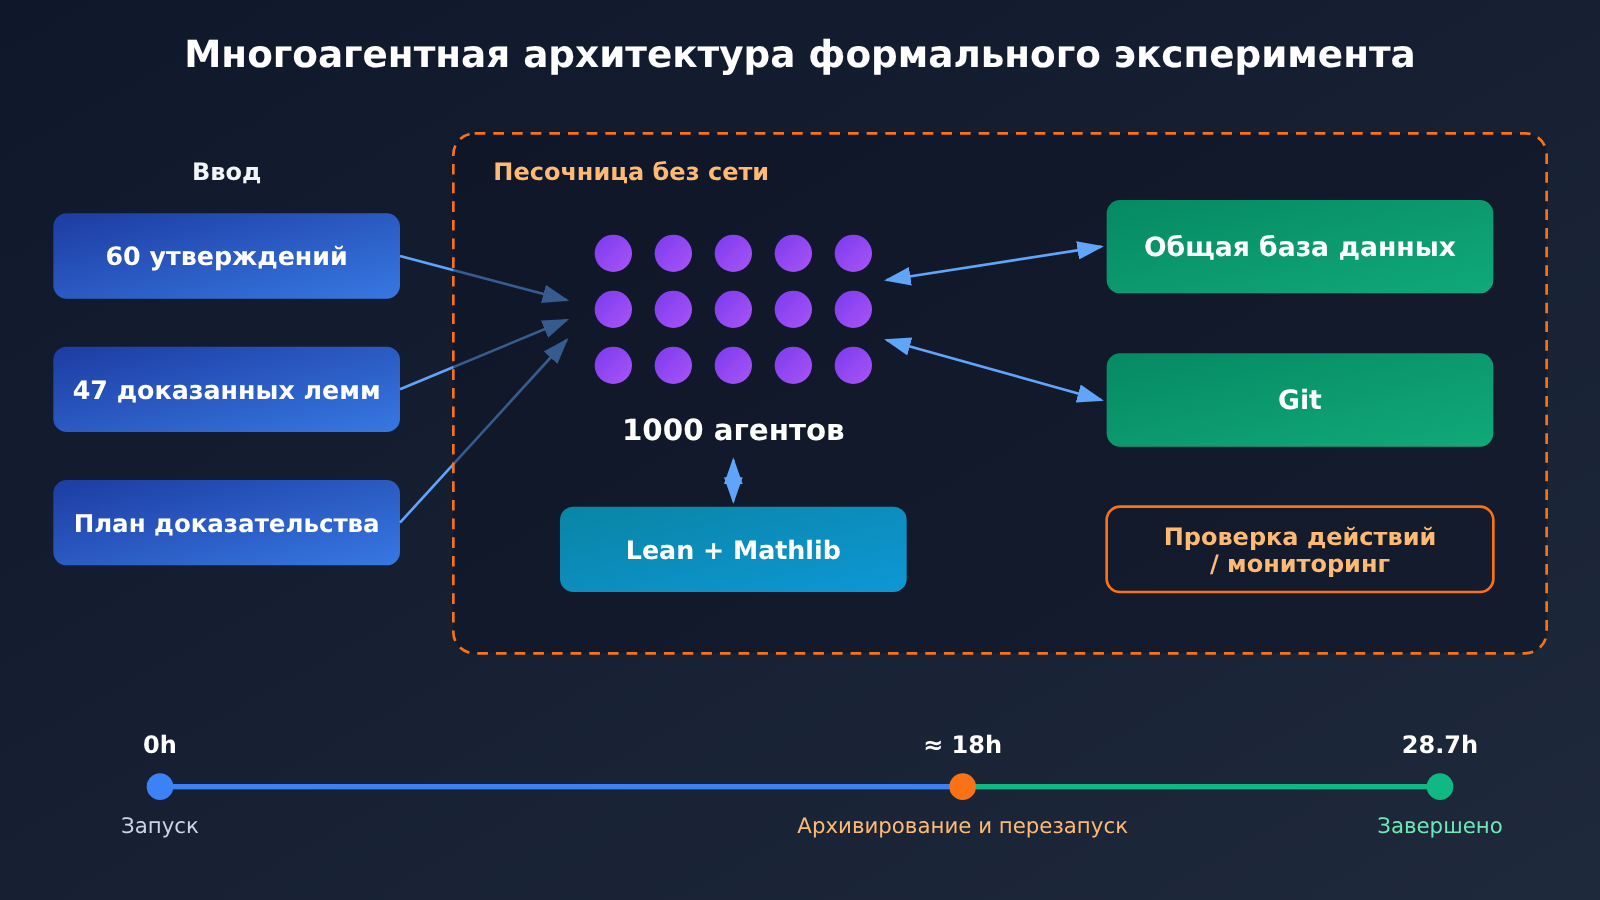
Больше всего внимания привлёк эксперимент с математической формализацией. В официальном блоге для разработчиков говорится, что 1000 агентов Fable 5.2 ранней версии за 28,7 часа воспроизвели в Lean формальное доказательство Великой теоремы Ферма.
Ценность этого кейса — в способности организовать масштабную и длительную работу, а не в математическом открытии.
Важно учитывать условия эксперимента:
- Исходные данные были заданы заранее: 60 утверждений и определений, краткий план классического доказательства, а также 47 лемм, доказанных ранее.
- Инструменты и среда: Lean, Mathlib, Git, общая база данных и изолированная песочница без доступа к сети, дополненная проверкой действий и офлайн-мониторингом.
- Ход эксперимента: примерно через 18 часов агенты перезапустили из сохранённого состояния и добавили ещё 12 часов работы.
- Оценка авторов: сами авторы назвали эксперимент игрушечным и отметили, что специализированная инфраструктура и помощь человека с выбором направления могли бы повысить эффективность.
Итак, речь идёт о формализации уже существующего математического доказательства.
Даже с учётом этих ограничений кейс показывает перспективное направление: несколько экземпляров модели могут работать над общей задачей, используя общее состояние, распределяя обязанности, внося изменения и проверяя их. Эта способность может пригодиться и в инженерных задачах — например, при масштабной миграции кода или рефакторинге сложных систем.
В чём Claude Fable 5.2 не оказался безоговорочным лидером
В объективном обзоре возможностей важно приводить и примеры, которые не подтверждают общую картину. В той же таблице официального анонса есть два показателя, по которым Fable 5.2 уступает конкурентам.
| Тест | Fable 5.2 | Модель для сравнения | Комментарий |
|---|---|---|---|
| AutomationBench | 51.4% | Gemini 4 Carbon 53.9% | В этом тесте конкурент показал лучший результат |
| AA-Briefcase (rubric) | 66.1% | Opus 5.5 61.2% | По критериям оценки Fable впереди |
| AA-Briefcase (Elo) | 1785 | Opus 5.5 1800 | По результатам парных сравнений Opus впереди |
Строка AA-Briefcase особенно показательна. В одном и том же тесте Fable лидирует по оценке согласно критериям (rubric), но уступает Opus по итогам парных сравнений, учитываемых в рейтинге Elo. Стоит изменить методику оценки — и расстановка сил может перевернуться. Поэтому не стоит объявлять модель «безоговорочным лидером» на основании одного-двух рейтингов.
Есть и другая цена лидерства. В Cursor Fable 5.2 Max обходится в 32.79 доллара за задачу, а Opus 5.5 High — в 3.97 доллара, то есть разница примерно восьмикратная. При этом разрыв в результатах составляет 4 процентных пункта. Небольшой эксперимент независимого разработчика Lex Toumbourou тоже показал: точность 5.2 high выше, чем у 5.1, но объём вывода и стоимость каждого раунда примерно удвоились.
Кроме того, специализированные показатели Mythos в области безопасности и биологических задач не следует считать показателями возможностей обычной версии Fable.
Каким пользователям стоит попробовать Claude Fable 5.2
С учётом официальных рекомендаций по выбору модели и данных выше можно выделить две группы:
- Стоит попробовать в первую очередь: сложные задачи по долгосрочной разработке, проектирование сложных систем и исследовательские задачи, требующие нескольких последовательных вызовов инструментов. Проверьте на собственном наборе задач, действительно ли модель даёт улучшение.
- Для начала используйте повседневную модель: для обычных вопросов и повседневного программирования следуйте официальной рекомендации и начните с таких моделей, как Opus 5.5. Переходите на более мощную модель, только если столкнётесь с ограничениями.
Пять критериев, которые стоит учесть перед пробным использованием Claude Fable 5.2
| Критерий | Что нужно выяснить | Рекомендация |
|---|---|---|
| Доступность | Доступна ли эта модель на используемой платформе, каковы её ID и адрес эндпоинта | Ориентируйтесь на текущий список моделей платформы и не предполагайте, что модель уже доступна |
| Данные | Разрешено ли отправлять данные задачи сторонним моделям | Проверьте условия хранения данных и требования корпоративного комплаенса |
| Приёмка | По каким критериям задача считается выполненной | Заранее подготовьте тестовые сценарии или критерии оценки |
| Время | Важна ли продолжительность ожидания | Фиксируйте полное время выполнения задачи, а не только скорость генерации ответа |
| Бюджет | Какова предельная стоимость выполнения одной задачи | Записывайте расход токенов и количество успешно выполненных задач для каждого тарифного уровня, затем рассчитывайте стоимость одного успешного выполнения |
Сравнительное тестирование Claude Fable 5.2 через единый интерфейс
В этом минимальном примере модель вызывается через совместимый с OpenAI интерфейс. Замените MODEL на ID модели из актуального списка платформы — и сможете сравнивать разные модели, не меняя код.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Совместимый с OpenAI интерфейс APIYI
)

MODEL = "your-model-id"  # Сверяйтесь с актуальным списком моделей платформы
resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": "为下面的函数补充单元测试:..."}]
)
print(resp.choices[0].message.content, resp.usage)
Посмотреть код для сравнения нескольких моделей и записи данных об использовании
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Сверяйтесь с актуальным списком моделей платформы
CANDIDATES = ["daily-model-id", "candidate-model-id"]

def run_task(model: str, prompt: str, check) -> dict:
    """Выполняет задачу и записывает время выполнения, количество токенов и результат проверки."""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    text = resp.choices[0].message.content
    return {
        "model": model,
        "seconds": round(time.time() - start, 2),
        "prompt_tokens": resp.usage.prompt_tokens,
        "completion_tokens": resp.usage.completion_tokens,
        "passed": bool(check(text)),  # Используйте собственную функцию проверки
    }

def check(text: str) -> bool:
    return "def test_" in text

tasks = ["为 parse_date 函数补充单元测试:..."]
results = [run_task(m, t, check) for m in CANDIDATES for t in tasks]
for r in results:
    print(r)
После сравнения стоит сверить результаты с фактическим счётом. В документации APIYI по журналам указаны поля model_name, prompt_tokens, completion_tokens, quota, request_id и другие. Значение quota, делённое на 500000, соответствует списанию в долларах — так можно сопоставить расходы до и после перехода для каждой задачи. Учтите, что сумма, рассчитанная по официальным тарифам, — лишь оценка. Ориентируйтесь на фактические данные в журнале платформы.
🚀 Быстрый старт: зарегистрируйтесь на APIYI apiyi.com и получите бесплатный тестовый лимит для новых пользователей. Сначала проверьте процесс сравнения на 10–20 реальных задачах, а затем решите, стоит ли увеличивать трафик до уровня Fable. Информацию о появлении новых моделей и их ценах уточняйте в актуальных объявлениях платформы.
Часто задаваемые вопросы
Вопрос 1: Что такое Claude Fable 5.2 и как он связан с Mythos 5.2?
Fable 5.2 — модель Anthropic, выпущенная 9 ноября 2026 года. Её API-идентификатор — `claude-fable-5-2`, модель поддерживает контекстное окно на 1 млн токенов. Она использует ту же базовую модель, что и Mythos 5.2. Разница в том, что благодаря настройкам безопасности Fable доступна широкому кругу клиентов, а Mythos предоставляется только организациям, прошедшим проверку.
Вопрос 2: Насколько Claude Fable 5.2 превосходит Opus 5.5?
Согласно официальной таблице, результат на FrontierSWE v2 составляет 69,9% против 62,3%. В индексе AA на максимальном уровне — 65 против 59. На уровне High в CursorBench 4.0 разница составляет всего 0,9 процентного пункта. В целом Fable 5.2 обладает более высоким потенциалом, но стоит вдвое дороже Opus 5.5, поэтому на высоких уровнях тарифов разница в стоимости отдельной задачи может быть ещё существеннее.
Вопрос 3: Claude Fable 5.2 занимает первое место во всех задачах?
Нет. В AutomationBench Gemini 4 Carbon набирает 53,9%, что выше результата Fable 5.2 — 51,4%. По рейтингу Elo в AA-Briefcase выше стоит Opus 5.5. Результаты зависят от методики оценки, поэтому меняется и рейтинг.
Вопрос 4: Использование Fable 5.2 обязательно обойдётся дешевле, чем 5.1?
Не обязательно. Снижение цены за единицу на 20% даст такую же экономию только при неизменном объёме использования. Допустим, задача включает 100 тысяч входных и 20 тысяч выходных токенов: стоимость работы с 5.2 составит 1,60 доллара, а с 5.1 — 2 доллара. Но если объём вывода вырастет до 40 тысяч токенов, работа с 5.2 обойдётся уже в 2,40 доллара — то есть дороже. Этот пример лишь показывает взаимосвязь переменных и не предсказывает, что модель обязательно будет генерировать больше текста. Чтобы проверить фактический расход токенов, сравните задачи по журналам вызовов APIYI apiyi.com.
Вопрос 5: Как быстро сравнить Claude Fable 5.2 с другими моделями через API?
1. Зарегистрируйтесь на APIYI apiyi.com и получите API-ключ и бесплатный тестовый лимит.
2. Проверьте, какие идентификаторы моделей доступны на платформе в этот день.
3. Используйте код из статьи, задайте `base_url` равным `https://api.apiyi.com/v1` и выполните вызовы для одного и того же набора задач.
4. Запишите число успешных выполнений, время и количество токенов, а затем рассчитайте стоимость одного успешного выполнения.
Вопрос 6: Доказывает ли эксперимент с великой теоремой Ферма, что Fable 5.2 способна самостоятельно делать математические открытия?
Нет. В эксперименте использовались 60 утверждений, 47 доказанных лемм и план доказательства. В офлайн-песочнице 1000 агентов на ранних снимках модели работали 28,7 часа. Они формализовали уже существовавшее доказательство, причём эксперимент проводился только один раз. Он демонстрирует способность модели организовывать долгую работу, но не доказывает, что она умеет самостоятельно делать оригинальные математические открытия.
Ключевые выводы о Claude Fable 5.2
- Позиционирование при запуске: модель представили 9 ноября. Она использует ту же базовую модель, что и Mythos, и доступна широкой аудитории.
- Программирование: результат FrontierSWE v2 составил 69,9% — в официальной таблице модель обошла 5.1 и Opus 5.5.
- Подтверждение от сторонних площадок: 65 баллов в категории AA max и 60,0% в CursorBench Max, но стоимость одного задания заметно выше.
- Переход от зрения к действию: результат RoboDojo Sim вырос с 27,6% до 64,9%, но оценка основана на симуляции.
- Инженерия и научные задачи: модель может участвовать в разработке электронных прототипов и масштабной формализации на Lean, но для этого есть чёткие ограничения.
- Не во всём лидирует: в AutomationBench и рейтингах Elo есть модели с более высокими результатами.
- Как попробовать: на APIYI apiyi.com можно сравнить модели через единый интерфейс на собственных задачах и решить, стоит ли переходить на новую версию.
Итоги
Главное о Claude Fable 5.2:
- Заметный прогресс на сложных задачах: по сравнению с 5.1 модель значительно улучшила результаты в долгосрочных задачах программирования и визуального управления.
- Результаты нужно оценивать с учётом контекста: оценки производителя, независимый рейтинг AA и собственная среда Cursor подходят для разных целей — их показатели нельзя напрямую сравнивать.
- Высокие возможности обходятся дороже: максимальный уровень часто означает многократный рост стоимости одного задания. Снижение цены за единицу использования не обязательно снижает стоимость выполнения задачи.
Если вы в основном решаете сложные долгосрочные задачи программирования, инженерные или исследовательские задачи, стоит уже сейчас проверить Fable 5.2 на собственном наборе задач. Для повседневной работы лучше начать с обычных моделей вроде Opus. Сравните несколько моделей через единый интерфейс APIYI apiyi.com и рассчитайте затраты по журналам вызовов — так вы сможете принять решение об обновлении на основе данных, а не рейтингов.
📚 Источники
- Анонс Anthropic: охват выпуска Fable и Mythos 5.2, официальная таблица возможностей
- Ссылка:
anthropic.com/claude-fable-and-mythos-5-2 -
Примечание: первоисточник данных о дате выпуска, заявленной скорости и сравнительных показателях (оценка самого производителя)
-
Спецификация модели Fable 5.2: контекст, максимальный объём вывода, режим рассуждений
- Ссылка:
platform.claude.com/docs/en/models/fable-5-2/overview -
Примечание: официальная документация API
-
Рейтинг моделей Artificial Analysis: Intelligence Index и стоимость выполнения отдельных задач
- Ссылка:
artificialanalysis.ai/leaderboards/models -
Примечание: актуальный срез данных сторонней организации
-
CursorBench 4.0: оценка в собственной среде Cursor
- Ссылка:
prod.cursor.com/evals -
Примечание: оценка поставщика инструмента, а не независимая проверка общего назначения
-
Исследование электронного прототипирования с Claude: три прототипа, созданных в сотрудничестве с Diode
- Ссылка:
anthropic.com/research/claude-electronics-design -
Примечание: содержит данные PCB Gym и BenchCAD 2.1, а также описание ограничений прототипов
-
Эксперимент с командой мультиагентных систем на Fable 5.2: условия эксперимента по формализации в Lean
- Ссылка:
claude.dev/blog/safely-scaling-multi-agent-teams-with-fable-5-2/ -
Примечание: один масштабный запуск на раннем срезе данных от производителя
-
Руководство по выбору модели Claude: рекомендации по использованию Opus и Fable
- Ссылка:
claude.dev/blog/which-claude-model-should-you-build-with/ - Примечание: официальное руководство для разработчиков
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами на главной странице сайта APIYI. Описание полей журналов и условий оплаты можно найти в центре документации docs.apiyi.com.


