
Примечание автора: разбираем 2.8T параметров Kimi K3.1 Pro, 104B активных параметров, квантование MXFP4 и контекстное окно на 1M токенов. Оцениваем объём весов и требования к оборудованию, сравниваем их со стоимостью API по цене $2/$10 и предлагаем таблицу для выбора между самостоятельным развёртыванием и API, а также чек-лист.
Сразу к выводу: Kimi K3.1 Pro — это MoE-модель с 2.8T параметров, которую не запустить на одной машине. По оценке для MXFP4, одни только веса занимают терабайты: они не поместятся на обычном сервере с 8 GPU. Как минимум потребуется развёртывание на нескольких GPU и узлах, а ещё нужно оставить видеопамять для KV-кэша при контекстном окне на 1M токенов. Открытые веса решают вопрос «можно ли получить модель», но не снижают требования к её эффективному запуску.
Поэтому для большинства технических команд реалистичнее начать с вызовов API по цене $2/$10. Серьёзно рассматривать самостоятельное развёртывание стоит только при одновременном выполнении трёх условий: объём вызовов большой и стабильный, данные должны оставаться в собственном дата-центре, а команда умеет обслуживать GPU-кластер. В этой статье мы не будем пересказывать результаты бенчмарков: сначала оценим расходы на веса и оборудование, затем — загрузку ресурсов и обслуживание, а в конце дадим рекомендации для разных команд. Если вы пока хотите только проверить модель, можно подключиться к ней с одним ключом через агрегатор вроде APIYI apiyi.com и позже определиться с дальнейшим вариантом.
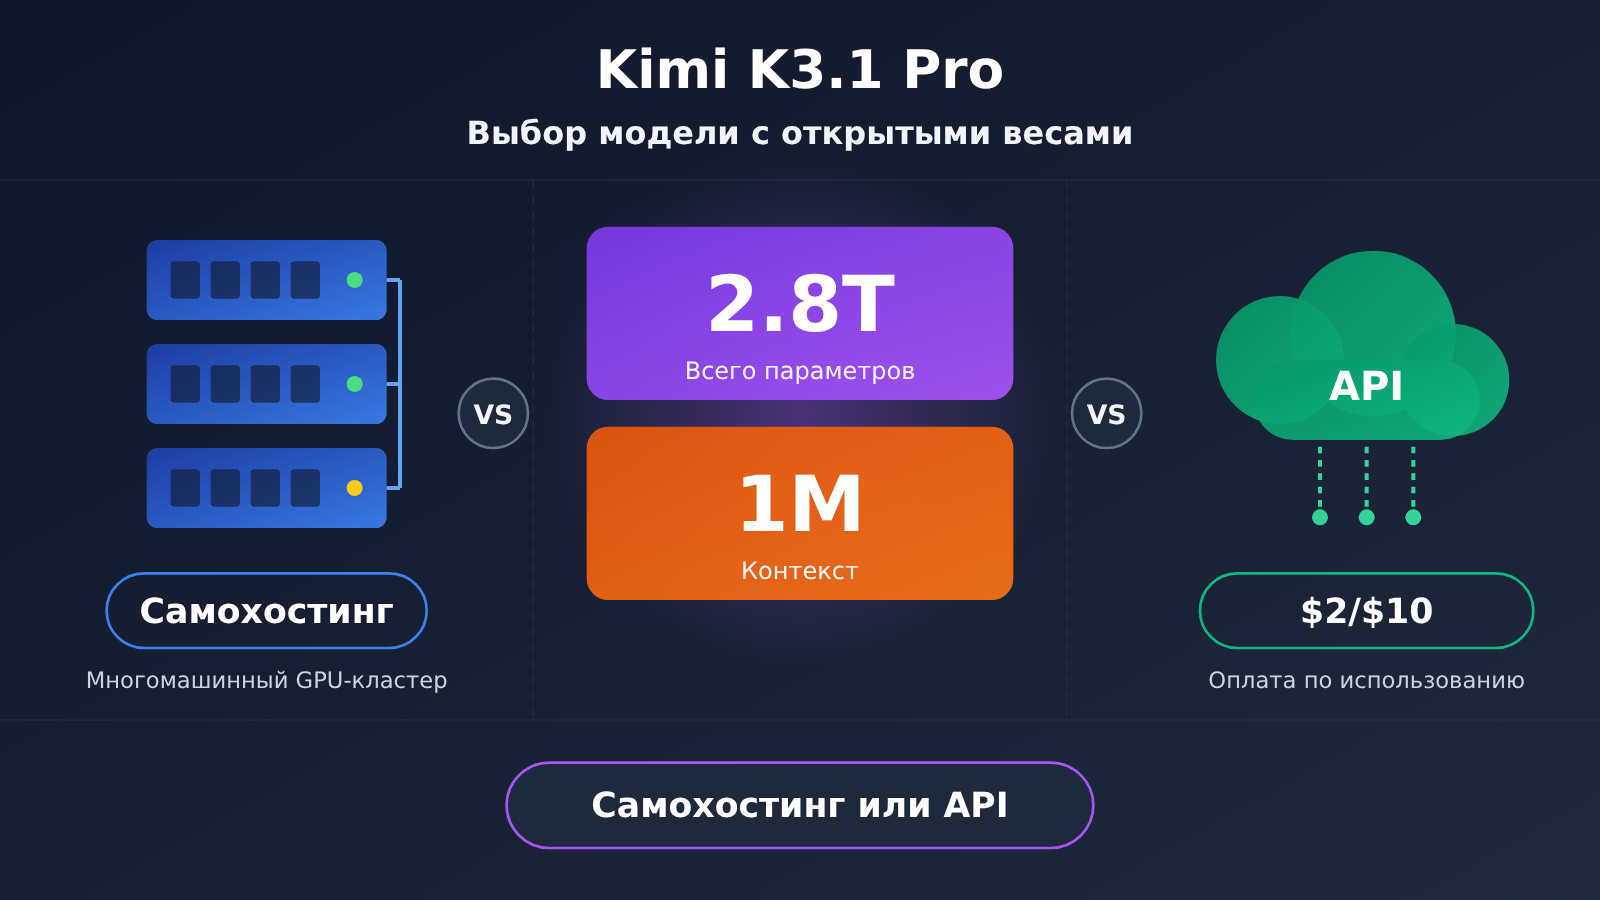
Характеристики Kimi K3.1 Pro: что означают 2.8T параметров и контекст 1M
Kimi K3.1 Pro — первая модель серии K3.1, выпущенная с открытыми весами. Она построена на архитектуре MoE (смесь экспертов): из 2.8T параметров для каждого токена активируются около 104B. Проще говоря, затраты на хранение определяются всеми 2.8T параметрами, а вычислительные затраты ближе к уровню плотной модели с 104B параметров. Это типичный компромисс при самостоятельном развёртывании MoE: вычислительные требования не так велики, но снизить потребность в видеопамяти сложно.
Ещё одна важная особенность — обучение с учётом квантования (QAT). Разработчики использовали сочетание весов MXFP4 и активаций MXFP8, учитывая квантование уже на этапе обучения. То есть работа с низкой точностью — «родной режим» модели, а не результат последующего сжатия. Теоретически это позволяет лучше контролировать потерю точности. Однако такой подход предъявляет требования к оборудованию и движку инференса: они должны эффективно поддерживать форматы микромасштабирования серии MX.
| Характеристика | Параметры Kimi K3.1 Pro | Что это значит при выборе |
|---|---|---|
| Архитектура | MoE, 93 слоя | Хранение зависит от общего числа параметров, вычисления — от числа активных |
| Всего параметров | 2.8T | Определяет размер весов и минимальный объём видеопамяти |
| Активных параметров | 104B | Определяет объём вычислений на один токен |
| Визуальный энкодер | MoonViT-V2, 401M параметров | Встроенная мультимодальность: для понимания изображений не нужны внешние компоненты |
| Квантование | Веса MXFP4 / активации MXFP8, QAT | Низкая точность — родной режим, требуется поддержка оборудования |
| Контекст | 1M токенов | Подходит для длинных документов и больших репозиториев, но создаёт высокую нагрузку на KV Cache |
| Основные сценарии | Программирование, 3D-творчество, финансовые исследования, агенты | Ориентация на сложные задачи и длинные цепочки вызовов |
Контекст 1M и мультимодальные возможности Kimi K3.1 Pro
Контекстное окно на 1M токенов позволяет за один раз передать модели репозиторий кода среднего размера, полный комплект финансовой отчётности или объёмные исследовательские материалы. Это как раз то, что нужно агентам и для финансовых исследований. Благодаря встроенной мультимодальности модель напрямую понимает изображения, скриншоты и графики, что удобно для 3D-творчества и задач программирования.
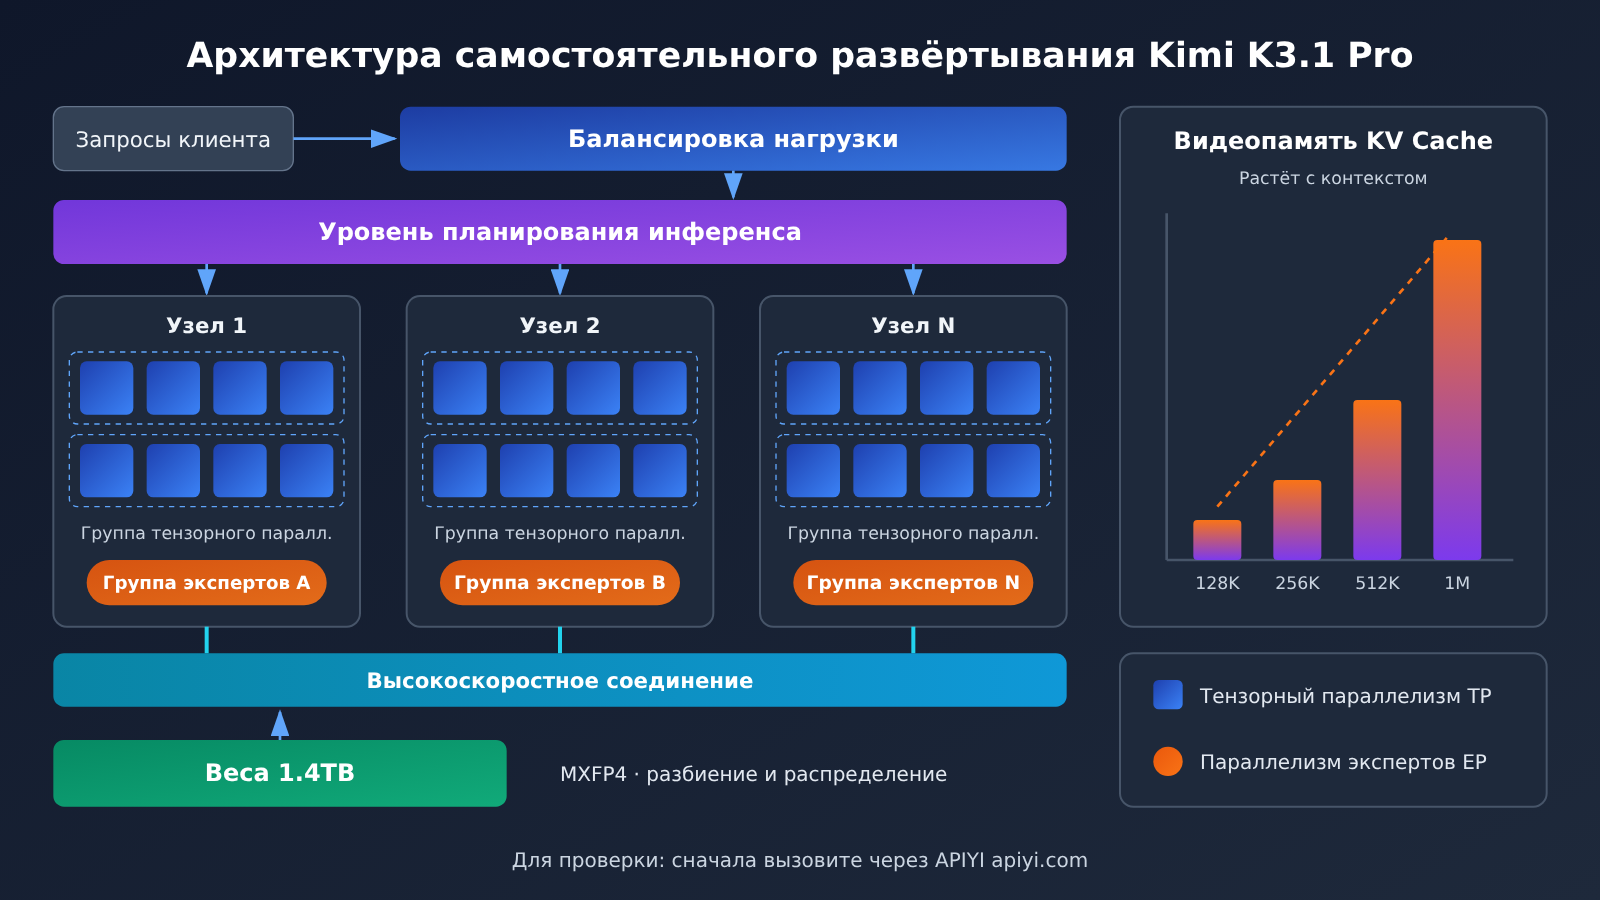
Но при самостоятельном развёртывании за обе возможности приходится платить ресурсами. При длинном контексте KV Cache растёт линейно с длиной последовательности, поэтому при использовании всех 1M токенов расход видеопамяти может быть весьма значительным. Сам визуальный энкодер невелик, но предварительная обработка мультимодальных данных и планирование пакетной обработки усложняют сервис инференса. При работе через API всё это берёт на себя поставщик, а вы платите только за токены.
Размер весов Kimi K3.1 Pro и требования к оборудованию
Оценка размера весов Kimi K3.1 Pro
Сразу оговоримся: размеры ниже рассчитаны по количеству параметров; фактический размер файлов станет известен после официального выпуска. В MXFP4 каждый параметр занимает около 4 бит, или 0,5 байта. Для 2,8 трлн параметров это примерно 1,4 ТБ. Формату MX также требуется дополнительное место для коэффициентов масштабирования блоков, а визуальный энкодер, слои эмбеддингов и другие компоненты могут сохраняться с более высокой точностью. Поэтому фактический размер файлов обычно немного больше расчётного.
| Формат точности | Байт на параметр | Оценка размера весов для 2,8 трлн параметров | Примечание |
|---|---|---|---|
| MXFP4 | Около 0,5 байта | Около 1,4 ТБ | Основной формат, предлагаемый разработчиками; без учёта коэффициентов масштабирования |
| Уровень 8 bit | Около 1 байта | Около 2,8 ТБ | Только для сравнения, официально не рекомендуется |
| BF16 | 2 байта | Около 5,6 ТБ | Только для сравнения, чтобы показать значение QAT |
Эта таблица показывает главное: даже в самом экономичном формате MXFP4 размер весов измеряется терабайтами. Скачивание, проверка и распределение файлов между несколькими машинами — уже сами по себе инженерная задача. Место в хранилище и пропускную способность внутренней сети стоит предусмотреть заранее.
Требования к оборудованию для самостоятельного развёртывания Kimi K3.1 Pro
Если ориентироваться на примерный размер весов в 1,4 ТБ, то для их размещения понадобится около 18 ускорителей с 80 ГБ видеопамяти каждый. И это без учёта KV Cache, значений активаций и накладных расходов движка инференса. Обычного сервера с 8 ускорителями явно не хватит. Даже с картами нового поколения, у которых больше видеопамяти, один узел едва вместит веса модели — запаса для работы с длинным контекстом почти не останется. Поэтому на практике придётся использовать несколько ускорителей и серверов, распределяя модель с помощью сочетания тензорного, экспертного и конвейерного параллелизма.
Помимо оборудования, есть ещё несколько статей расходов, которые легко недооценить:
- Движок инференса и стратегия параллелизма: нужен фреймворк инференса с поддержкой экспертного параллелизма MoE и формата MX. Рекомендации по движку и настройке параллелизма ищите в официальной документации по развёртыванию.
- Соединение между узлами: экспертный параллелизм требует интенсивного обмена данными между узлами. Пропускная способность сети и задержки напрямую влияют на производительность.
- Серверная инфраструктура и электропитание: питание, охлаждение и место в стойках для GPU-кластера из нескольких серверов нужно обеспечить заранее.
- Пиковая нагрузка: на время пиков понадобится запас мощностей, который в периоды затишья будет простаивать.
- Команда эксплуатации: для обновления модели, устранения неполадок и настройки мониторинга и оповещений на постоянной основе нужны инженеры, разбирающиеся в GPU-кластерах.
Важно: в исходных материалах нет официальных данных о производительности и стоимости по результатам тестов, поэтому мы не приводим конкретную цену собственного развёртывания. Если планируете запуск проекта, ориентируйтесь на официальную документацию и результаты собственного нагрузочного тестирования.
Лицензия Kimi K3.1 Pro: открытые веса не означают свободного коммерческого использования
«Открытые веса» и «открытый исходный код со свободным коммерческим использованием» — не одно и то же. Это важно проверить ещё при выборе модели. Лицензии многих моделей с открытыми весами устанавливают условия для коммерческого применения: например, ограничения по доходу или числу пользователей, а также требование указывать источник модели в продукте. Конкретные условия коммерческого использования Kimi K3.1 Pro, пороги дохода и требования об уведомлении следует уточнять в оригинальном тексте официальной лицензии.
Помимо прямого коммерческого использования, дополнительные требования могут распространяться на следующие действия:
- Распространение: передача весов или их производных версий третьим лицам.
- Модификация: применение лицензии к моделям после дообучения, дистилляции или слияния.
- Хостинг: предоставление самостоятельно развёрнутой модели через API внешним пользователям. Такой сценарий часто отдельно регулируется лицензией.
Рекомендуем юристам и техническим руководителям вместе изучить лицензию пункт за пунктом и оформить письменное заключение до закупки оборудования. При вызове модели через официальный API или стороннюю платформу в первую очередь действуют условия сервиса. Вопрос распространения весов при этом обычно не возникает, но всё равно стоит проверить, соответствуют ли правилам используемые данные и сценарии применения.
Цена Kimi K3.1 Pro API: как считать расходы при $2/$10
Официальный ID модели — kimi-k3.1-pro. API совместим с интерфейсами OpenAI и Anthropic, поэтому для интеграции в существующий проект потребуется минимум изменений. Цены указаны за миллион токенов:
| Статья расходов | Стандартная версия kimi-k3.1-pro |
Версия Highspeed | Примечание |
|---|---|---|---|
| Ввод | $2 |
$4 |
За миллион токенов |
| Вывод | $10 |
$20 |
За миллион токенов |
| Попадание в кэш | $0.20 |
Уточняйте у провайдера | Повторяющиеся префиксы помогают значительно сократить расходы |
| Запись в кэш | $2 |
Уточняйте у провайдера | По цене стандартного ввода |
| Скорость | Базовая | Примерно в 3 раза выше | Для сценариев, где важна задержка |
Разберём пример расчёта — это не результат тестирования, а пересчёт по тарифам. Допустим, за месяц вы используете 100 млн входных и 20 млн выходных токенов. Расходы на стандартную версию составят примерно 100 × $2 + 20 × $10 = $400. Если 70% входных токенов найдутся в кэше, стоимость ввода снизится до 70 × $0.20 + 30 × $2 = $74, а общий счёт — примерно до $274. При том же объёме Highspeed без учёта кэша обойдётся примерно в $800.
Эти цифры показательны: даже при обработке сотен миллионов токенов в месяц счёт за API намного ниже, чем ежемесячные расходы на амортизацию, электричество и персонал для GPU-кластера из нескольких машин. В сценариях с агентами системные промпты и определения инструментов часто повторяются, поэтому использование кэша — самый прямой способ сократить расходы на API.
Для подключения достаточно клиента, поддерживающего совместимый с OpenAI протокол: замените base_url на https://api.apiyi.com/v1 и укажите ID модели, предоставленный платформой. Дополнительный слой адаптации не понадобится.
🚀 Быстрый старт: если команда хочет сравнить Kimi, Claude, GPT и Gemini на одной задаче, через APIYI apiyi.com можно вызывать все модели с одним API-ключом, а список моделей, расход и логи просматривать в консоли. Доступность
kimi-k3.1-proи актуальную цену уточняйте в консоли.
Kimi K3.1 Pro: ключевые различия между самостоятельным развёртыванием и API
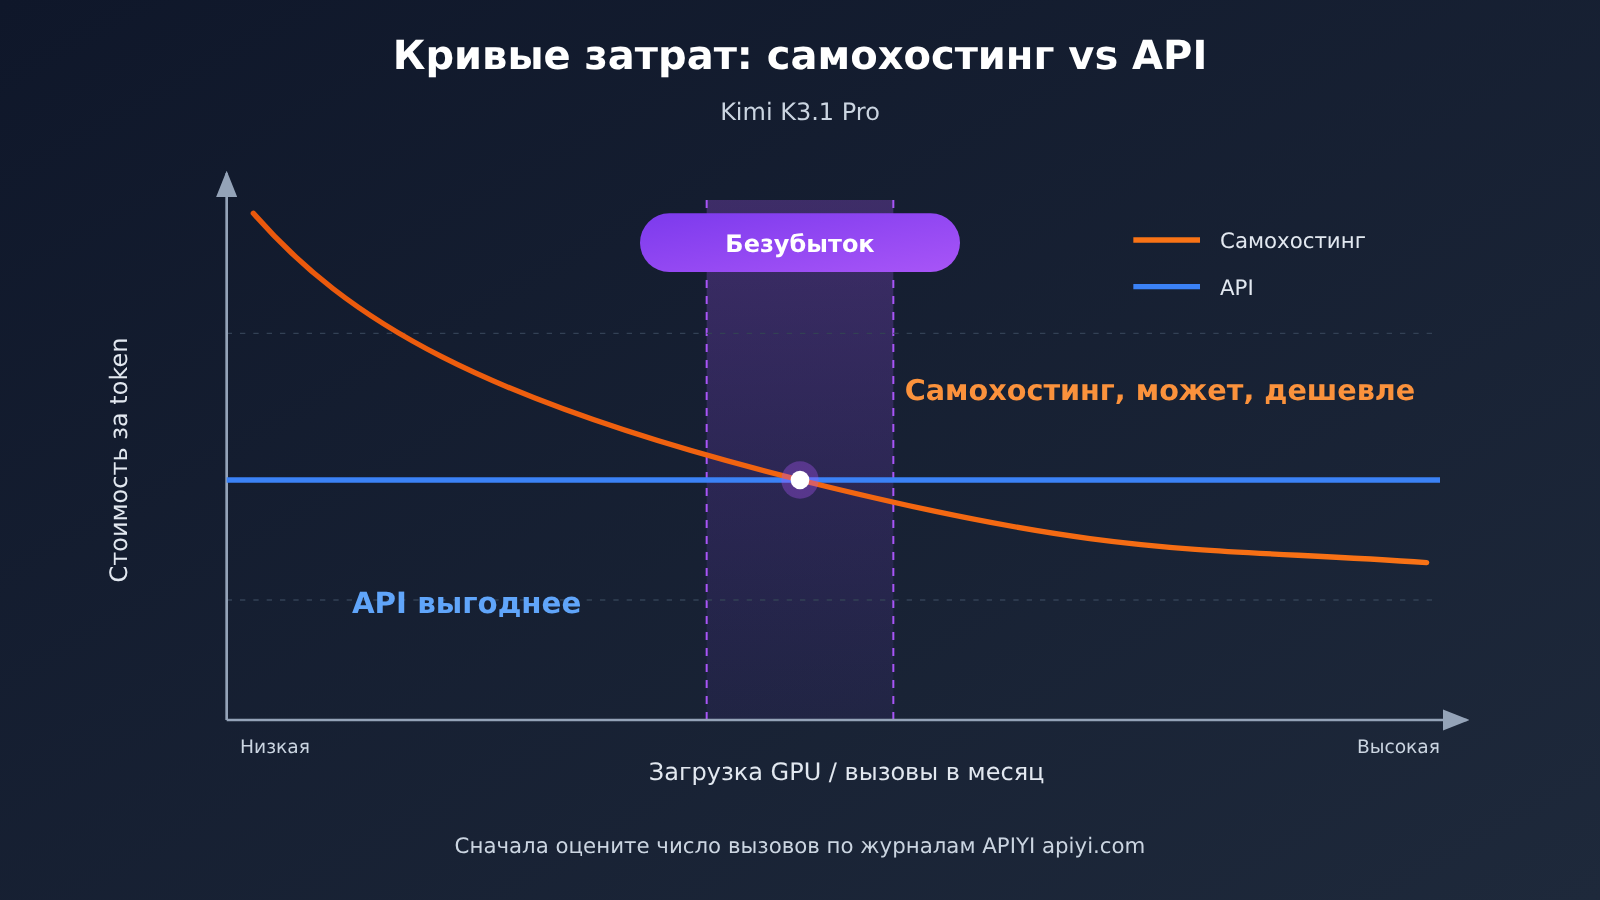
Главное различие между самостоятельным развёртыванием и API — структура затрат. API предполагает только переменные расходы: платите за то, что используете, а если не используете — не платите. При самостоятельном развёртывании постоянные затраты высоки, а дополнительные расходы на каждый вызов низки. Купив оборудование и вложившись в инфраструктуру и команду, вы несёте расходы независимо от того, загружен кластер или нет. Поэтому решающий фактор — уровень загрузки: только при длительной высокой нагрузке стоимость токена с учётом всех затрат может оказаться ниже цены API.
| Критерий | Самостоятельное развёртывание Kimi K3.1 Pro | Вызов через API | Что выбрать |
|---|---|---|---|
| Загрузка | Для снижения удельных затрат нужна длительная высокая нагрузка | Оплата по использованию, без потерь на простой | При низкой и средней частоте вызовов — API |
| Требования к данным | Данные могут полностью оставаться внутри контура | Данные нужно отправлять поставщику сервиса | При строгих требованиях регуляторов — самостоятельное развёртывание |
| Первоначальные вложения | Несколько серверов с GPU, инфраструктура и сеть требуют значительных затрат | Практически отсутствуют | API |
| Эксплуатационные расходы | Нужна выделенная команда для обслуживания GPU-кластера | Обслуживание берёт на себя поставщик | API |
| Масштабирование при пиковых нагрузках | Нужно резервировать мощности, расширение занимает время | Хорошая гибкость, но действуют ограничения на частоту запросов | API |
| Возможности настройки | Можно дообучать модель и менять конфигурацию инференса | Ограничены параметрами интерфейса | Для глубокой настройки — самостоятельное развёртывание |
| Скорость запуска | От недель до месяцев | Несколько часов | API |
| Способ подключения | Собственный сервис инференса | Официальный API, платформы вроде APIYI apiyi.com | Зависит от потребностей |
Сравнение API: API выигрывает по скорости запуска, гибкости и совокупной стоимости владения, но данные приходится передавать за пределы контура, а набор настраиваемых параметров ограничен. Самостоятельное развёртывание, напротив, даёт больше контроля над данными и возможностей для глубокой настройки. Оно лучше подходит командам, которые работают в условиях строгого регулирования и делают огромное количество вызовов.
Сравнение самостоятельного развёртывания: самостоятельное развёртывание потенциально даёт больше контроля и позволяет ограничить стоимость токена, но требует значительных первоначальных вложений и команды для обслуживания, а риск простоя высок. Если объём вызовов нестабилен и собственной команды по работе с GPU нет, API остаётся более надёжным выбором.
Рекомендации по выбору способа использования Kimi K3.1 Pro
Кому подойдёт API Kimi K3.1 Pro
- Стартапам и небольшим командам: если нет GPU-кластера и выделенных специалистов по эксплуатации, API — единственный разумный вариант.
- Проектам с переменной нагрузкой: при дневных пиках, ночных спадах или всплесках во время акций оплата по факту использования избавит от расходов на простаивающие ресурсы.
- Проектам, которые нужно быстро запустить: на этапе проверки продукта важнее всего скорость, а интеграцию можно завершить за несколько часов.
- Командам, которые параллельно оценивают несколько моделей: если одну задачу нужно протестировать на разных моделях, единый интерфейс гораздо удобнее отдельного развёртывания каждой из них.
Кому подойдёт самостоятельное развёртывание Kimi K3.1 Pro
- Организациям, чьи данные не должны покидать внутреннюю сеть: в финансовой сфере, медицине и госсекторе требования безопасности могут предписывать полное хранение данных внутри сети.
- Проектам с постоянной высокой нагрузкой: при непрерывной работе 7×24 часа ресурсы могут долгое время оставаться загруженными.
- Командам с GPU-кластером и специалистами по эксплуатации: дополнительные затраты будут контролируемыми, а модель можно включить в существующую инфраструктуру.
- Проектам, которым нужна глубокая настройка: например, дообучение модели с открытыми весами или особая оптимизация инференса — при условии, что это разрешает лицензия.
Гибридный подход
Есть и ещё один подход, о котором часто забывают: создать прототип с помощью API, а затем оценить целесообразность самостоятельного развёртывания для продакшена. Или наоборот: обрабатывать критически важные конфиденциальные данные на собственной инфраструктуре, а общий трафик направлять через API. В первом случае реальные данные об использовании заменят приблизительные оценки, а во втором получится совместить соблюдение требований и гибкость.
💡 Совет по выбору: прежде чем вкладываться в оборудование, попробуйте некоторое время обрабатывать реальный рабочий трафик через APIYI apiyi.com. По журналам использования в консоли подсчитайте ежедневное число токенов, соотношение пиковой и минимальной нагрузки и долю попаданий в кэш. Эти данные помогут надёжнее всего оценить, окупится ли самостоятельное развёртывание.
Частые вопросы FAQ
Q1: Можно ли самостоятельно развернуть Kimi K3.1 Pro на одном сервере?
При использовании MXFP4 веса модели займут около 1,4 ТБ — на обычном сервере с 8 GPU они не поместятся. Даже на узлах с большим объёмом видеопамяти на каждой карте будет сложно оставить запас для KV Cache при контексте в 1M токенов. Практичный вариант — развёртывание на нескольких серверах с несколькими GPU. Точную конфигурацию уточняйте в официальной документации.
Q2: Означают ли 104B активных параметров, что требования к оборудованию рассчитываются только по ним?
Нет. Число активных параметров определяет объём вычислений на каждый токен, но веса всех экспертов должны постоянно находиться в видеопамяти. Поэтому её необходимый объём по-прежнему рассчитывается исходя из общего числа параметров — 2,8T. В этом и особенность моделей MoE: вычислений меньше, но загрузить нужно больше.
Q3: Можно ли сразу использовать модель с открытыми весами в коммерческих целях?
Не обязательно. Открытые веса не означают безусловного разрешения на коммерческое использование. Порог дохода, обязательства по уведомлению и ограничения на предоставление модели как хостингового сервиса нужно уточнять в тексте официальной лицензии. Перед закупкой оборудования рекомендуем проконсультироваться с юристами.
Q4: Как недорого попробовать API Kimi K3.1 Pro?
Можно зарегистрироваться на APIYI apiyi.com и воспользоваться бесплатным тестовым лимитом для новых пользователей. OpenAI-совместимый интерфейс позволяет подключить API к существующему проекту. С одним API-ключом платформы можно вызывать модели семейства Kimi, а также Claude, GPT, Gemini и другие. Доступность `kimi-k3.1-pro` и цены проверяйте в консоли.
Q5: Как выбрать между стандартной версией и Highspeed?
Highspeed стоит `$4/$20` — вдвое дороже стандартной версии, но работает примерно в три раза быстрее. Highspeed подходит для взаимодействия с пользователем в реальном времени и агентов, чувствительных к задержке первого токена. Для пакетной обработки и фоновых задач экономичнее использовать стандартную версию с кешированием.
Итоги: чек-лист по самостоятельному развёртыванию Kimi K3.1 Pro и использованию API
Открытые веса Kimi K3.1 Pro — это хорошая новость: команды с необходимыми ресурсами получают полностью контролируемый вариант развёртывания. Но 2.8T параметров делают её моделью кластерного масштаба. Главный вопрос не в том, можно ли скачать веса, а в четырёх составляющих: оборудовании, его загрузке, эксплуатации и лицензии. Для большинства команд путь с наименьшим риском — сначала запустить проект через API по цене $2/$10, а затем на реальных данных оценить целесообразность собственного развёртывания.
Kimi K3.1 Pro: главное
- Характеристики: 2.8T параметров всего, 104B активных, 93 слоя MoE, нативная мультимодальность, контекстное окно 1M.
- Веса: при MXFP4 их размер оценивается примерно в 1.4TB; точное значение нужно смотреть в официальных файлах. На одной машине они не поместятся.
- Оборудование: потребуется параллельное развёртывание на нескольких GPU и машинах, а также запас видеопамяти для KV Cache при работе с длинным контекстом.
- Лицензия: открытые веса не означают неограниченное коммерческое использование — условия нужно проверять в официальной лицензии.
- Цена: стандартная версия —
$2/$10, при попадании в кеш —$0.20, Highspeed —$4/$20. - Решение: ключевой фактор — загрузка оборудования. При низкой или средней частоте вызовов и нестабильной нагрузке лучше выбрать API.
Чек-лист: самостоятельное развёртывание vs API
| Критерий | Когда выбрать API | Когда выбрать самостоятельное развёртывание |
|---|---|---|
| Объём вызовов | Небольшой или заметно меняется от месяца к месяцу | Стабильная высокая нагрузка 7×24 |
| Требования к данным | Данные можно передавать поставщику сервиса | Данные должны оставаться во внутренней сети |
| Ресурсы GPU | Нет кластера и выделенной команды эксплуатации | Уже есть кластер из нескольких машин и команда эксплуатации |
| Лицензия | Не хочется разбираться с условиями распространения и хостинга | Юристы уже подтвердили условия коммерческого использования |
| Срок запуска | Нужно как можно быстрее запуститься и проверить решение | Допустимо развёртывание в течение нескольких недель или месяцев |
| Данные о затратах | Реальной статистики вызовов пока нет | Точка безубыточности уже рассчитана на реальных данных |
Если большинство пунктов в вашем случае попадает в левый столбец, выбирайте API. Через APIYI на apiyi.com можно с одним Key подключиться к моделям семейства Kimi и другим популярным моделям. Журналы использования в консоли помогут накопить реальные данные: когда объём вызовов и требования к данным станут достаточным основанием, на их основе можно будет оценить самостоятельное развёртывание.
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами через главную страницу сайта APIYI. Подробнее о подключении — в центре документации docs.apiyi.com


