
Аннотация: эта статья отвечает на один вопрос — справится ли GPT-6.2 Sol с вопросами по данным, которые приходят от пользователей фронт-офиса, и какие вопросы ещё нужно перепроверять.
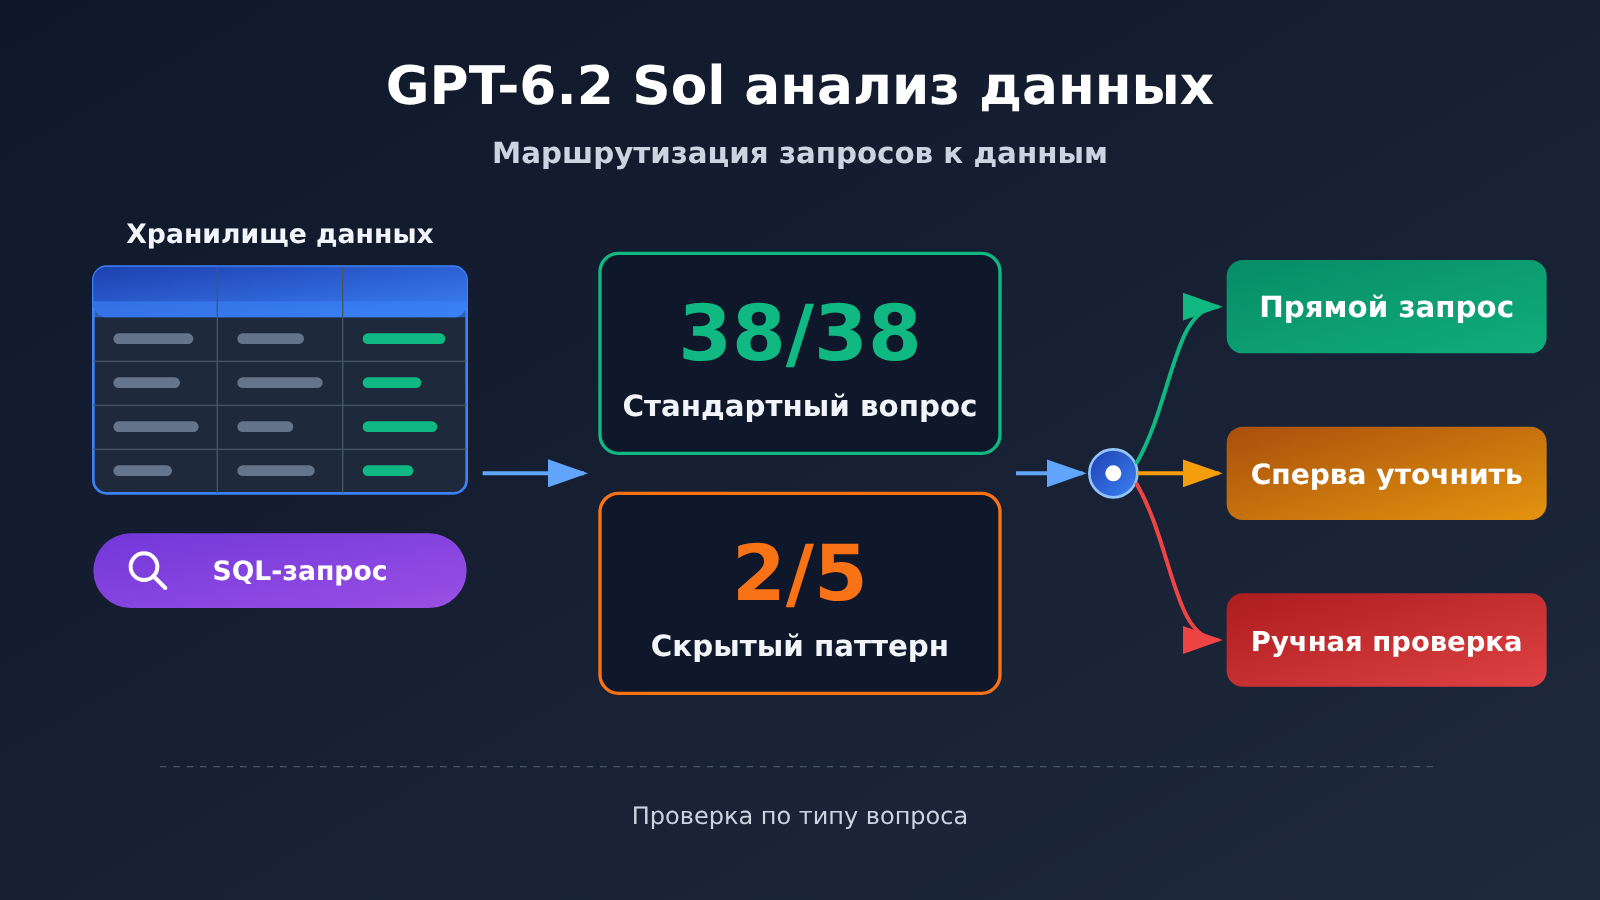
Результаты GPT-6.2 Sol в анализе данных стоит рассматривать в двух частях. В однораундовом специализированном тесте, опубликованном Plotly 17 ноября 2026 года, модель верно решила все 38 задач из пяти категорий — обычный анализ, распознавание неоднозначности, вопросы, на которые данные не дают ответа, качество данных и статистические ловушки. Медианное время на одну задачу — около 10,5 секунды. В том же раунде из 5 задач на скрытые закономерности она прошла только 2.
Отсюда напрашивается вывод: сводные вопросы по данным с ясным определением метрик и небольшим влиянием можно запускать в пилотном режиме — поручать Sol отвечать напрямую с правами только на чтение; если определение метрики отсутствует, пусть сначала уточняет; открытую атрибуцию причин и решения, влияющие на внешние стороны, нужно передавать аналитику на проверку. У этого вывода три предпосылки: тест прогонялся только один раунд, банк заданий — англоязычные задачи, смоделированные по ветроэнергетической компании, а расходы шли через канал OpenRouter. После переноса на ваши собственные данные и каналы нужно заново провести приёмку по типам задач.
GPT-6.2 Sol: карта знаний по анализу данных и индекс для чтения
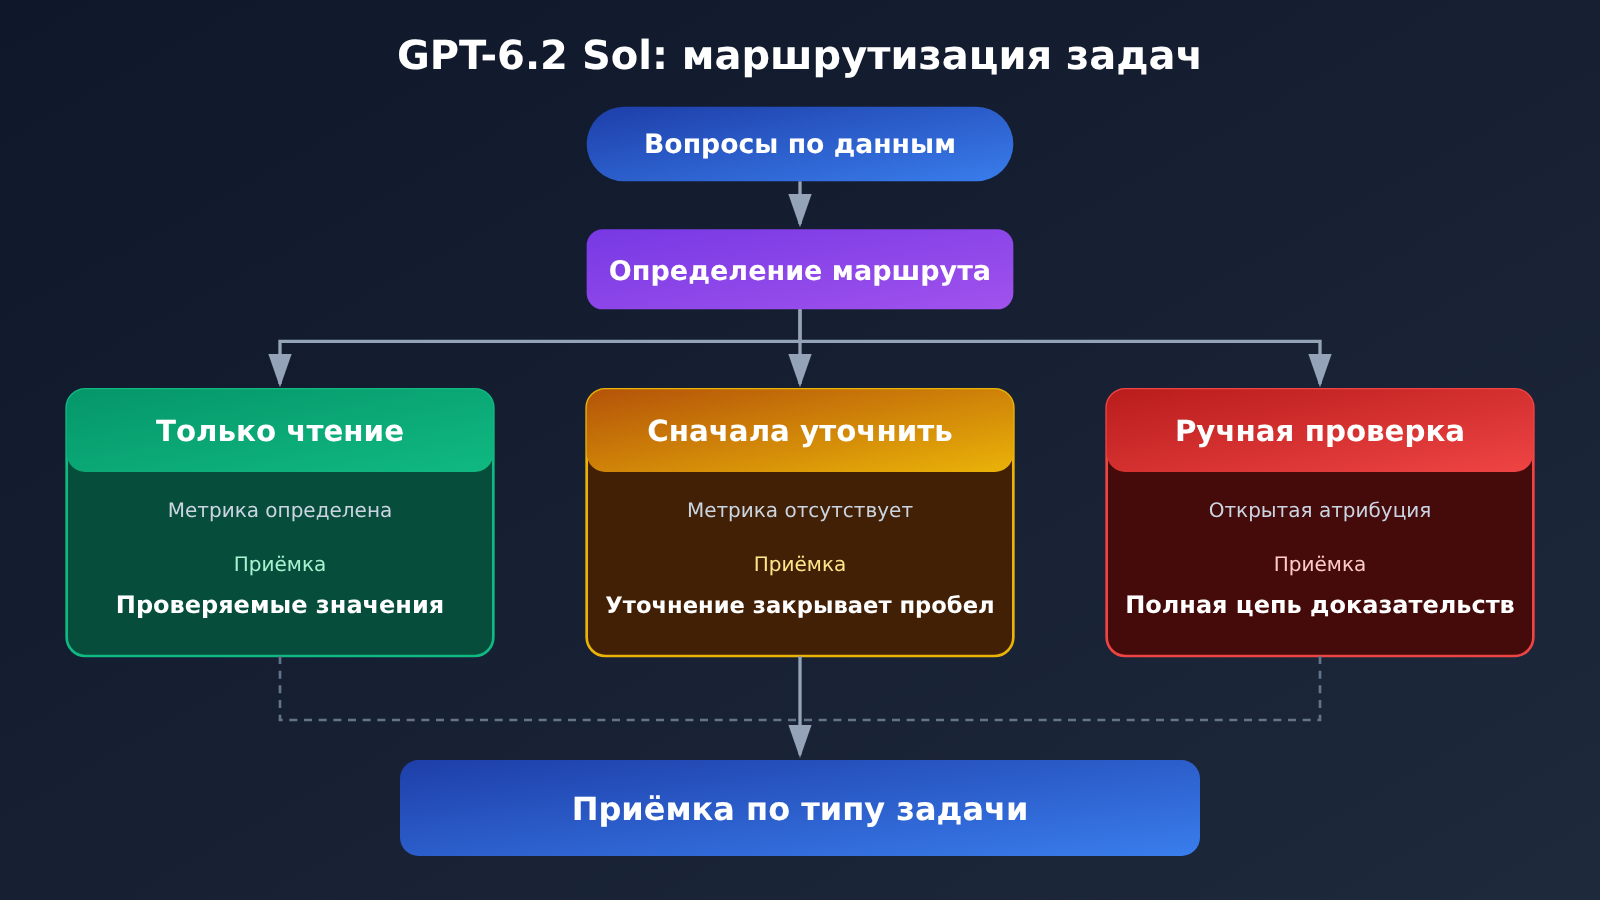
На схеме ниже показана логика распределения задач по веткам. В каждой ветке указаны входные условия, ожидаемый результат работы модели и номер этого раздела в основной части.
Пользователь задаёт вопрос по данным
 │
 ├─ Методика ясна + низкое влияние сводки ──→ [1] Sol отвечает на вопрос только чтением
 │                              Результат: число + числитель/знаменатель + временной диапазон и часовой пояс + запрос
 │
 ├─ Методики нет / данных недостаточно ────→ [3.2] Сначала уточнить
 │                              Результат: один конкретный уточняющий вопрос + список возможных методик
 │
 └─ Открытый разбор причин / внешнее решение ──→ [3.3] Передать аналитику на проверку
                                Результат: запись первичной проверки + подтверждающие данные + проверка альтернативных объяснений
            ↓
   [2] По задержке и стоимости одного вопроса решаем, выносить ли на передний план
            ↓
   [4] Приёмка на своих данных по типам задач, выдача результата с датой данных и доказательствами запроса
Порядок разделов следующий. Параллельный раздел 3 можно читать по необходимости, остальные разделы рекомендуется читать по порядку.
| Номер раздела | На какой вопрос отвечает | Что даёт для следующего раздела | Что можно сделать после прочтения |
|---|---|---|---|
| 1 | На каких задачах Sol стабилен | Границы типов задач: 38/38 и 2/5 | Очертить диапазон, где можно спрашивать напрямую |
| 2 | Выгодно ли выносить на передний план | Задержка, стоимость одного вопроса и допущения экстраполяции | Оценить бюджет и ожидание в интерактивных сценариях |
| 3 | Что требует уточнения или передачи человеку | Три формы провала и три примера результата | Проектировать правила маршрутизации |
| 4 | Как проводить приёмку на своих данных | Метрики и границы по типам задач | Выдавать проверяемый результат |
To Know: термины, связанные с анализом данных в GPT-6.2 Sol
| Термин | Краткое объяснение |
|---|---|
| Хранилище данных (data warehouse) | Набор данных, в котором собраны разрозненные исторические данные из бизнес-систем для последующего запроса и анализа |
| Методика показателя | Определение показателя, условия фильтрации, числитель и знаменатель, временные границы |
| SQL только для чтения | Способ запроса, который выполняет лишь поиск и агрегацию, а сам источник данных остаётся в режиме только для чтения |
| Задача со скрытой закономерностью | В данные заранее встроена структурная аномалия, в задаче даются только подсказки, а модель должна самостоятельно найти конкретную закономерность |
| Доказательства запроса | Запрос, методика, результат и дата данных, позволяющие другим проверить вывод |
| Задержка p50 / p95 | За какое время завершается половина запросов / за какое время завершаются 95% запросов |
| Кэшированный ввод | Входные токены, которые вышестоящий сервис при тарификации распознаёт как повторно используемые, их цена значительно ниже обычного ввода |
| Приёмка по типам задач | Задачи на числа, уточнение, отказ от ответа и исследование оцениваются раздельно, чтобы общий балл не скрывал ошибки какого-то одного типа |
1. GPT-6.2 Sol 做数据分析:先看能够稳定验收的问数结果
1.1 Plotly 测试做了什么
Plotly 在 Plotly Studio Embedded 测试框架里通过 OpenRouter 调用模型,只开放四种只读工具:列出数据集、执行 SQL 查询、绘图、展示表格。测试仓库模拟一家风电企业,包含约 1,990 万行数据、44 张表、554 列。43 道英文题按答案键和评分规则逐题判定是否通过。判分模型是 Claude Sonnet 5,temperature=0,失分题目由团队人工复核。
这套设置接近企业 BI 问数的真实形态:模型看不到全部数据,只能自己找表、写 SQL、读结果再作答。题库和答案键由 Plotly 保留,外部无法逐题复现,所以下面的数字应理解为一次有方法说明的单轮观察,不宜当作稳定排名。
| 题型 | 题数 | GPT-6.2 Sol 结果 | 对业务的含义 |
|---|---|---|---|
| 常规分析 | 20 | 20/20 | 固定口径汇总可以试点直答 |
| 歧义判断 | 5 | 5/5 | 能识别问题本身有多种理解 |
| 数据不可回答 | 5 | 5/5 | 数据不支持时能拒答,不硬编数字 |
| 数据质量 | 3 | 3/3 | 能注意到缺失、重复等问题 |
| 统计陷阱 | 5 | 5/5 | 能避开常见的统计误读 |
| 隐藏规律 | 5 | 2/5 | 开放式找规律仍需人工验证 |
| 合计 | 43 | 40/43 | 前 38 题全过,失分全部集中在探索题 |
Plotly 还提到,其他模型在复跑时出现过最多三题的波动。40/43 与满分只差三题,正好落在这个波动范围内。因此更值得关注的是失分的分布:失分全部落在隐藏规律题,前五类一题没错。
1.2 为什么固定口径的问数可以复核
以售后报表为例,「过去 7 天各仓库退货率」能够稳定验收,前提是三件事已经事先固定:分母是已签收订单还是全部订单,时间范围按哪个时区截断,过滤条件是否排除了测试单和内部单。这三点一旦写进口径文档,模型生成的 SQL 和结果就能逐项与人工查询核对。
固定口径把「模型是否聪明」变成了「数字是否一致」,后者可以自动比对。这也是 38 道题能全过、而且全过有意义的原因:这些题大多有唯一的标准答案。
2. Задержка и стоимость анализа данных в GPT-6.2 Sol: стоит ли выводить его в пользовательский интерфейс
2.1 Сравнение двух поколений Sol в рамках одного раунда
Когда пользователь задаёт вопрос о данных прямо в интерфейсе, время ожидания напрямую определяет впечатление от работы. Отчёт Plotly приводит сравнение GPT-6.2 Sol и GPT-6.1 Sol на одном и том же раунде из 43 вопросов:
| Метрика | GPT-6.1 Sol | GPT-6.2 Sol | Изменение |
|---|---|---|---|
| Стоимость всего раунда | $2.61 | $1.22 | примерно на 53.3% ниже |
| Медианное время на один вопрос | 17.6 с | 10.5 с | примерно на 40.3% ниже |
| Число вызовов инструментов | 258 | 158 | заметно меньше |
| Число вызовов модели | 227 | 173 | меньше |
| Объём входных данных | около 7.8 млн токенов | около 4.6 млн токенов | меньше |
| Объём выходных данных | около 70 тыс. токенов | около 45 тыс. токенов | меньше |
| Доля кэшированного ввода | 94% | 97% | выше |
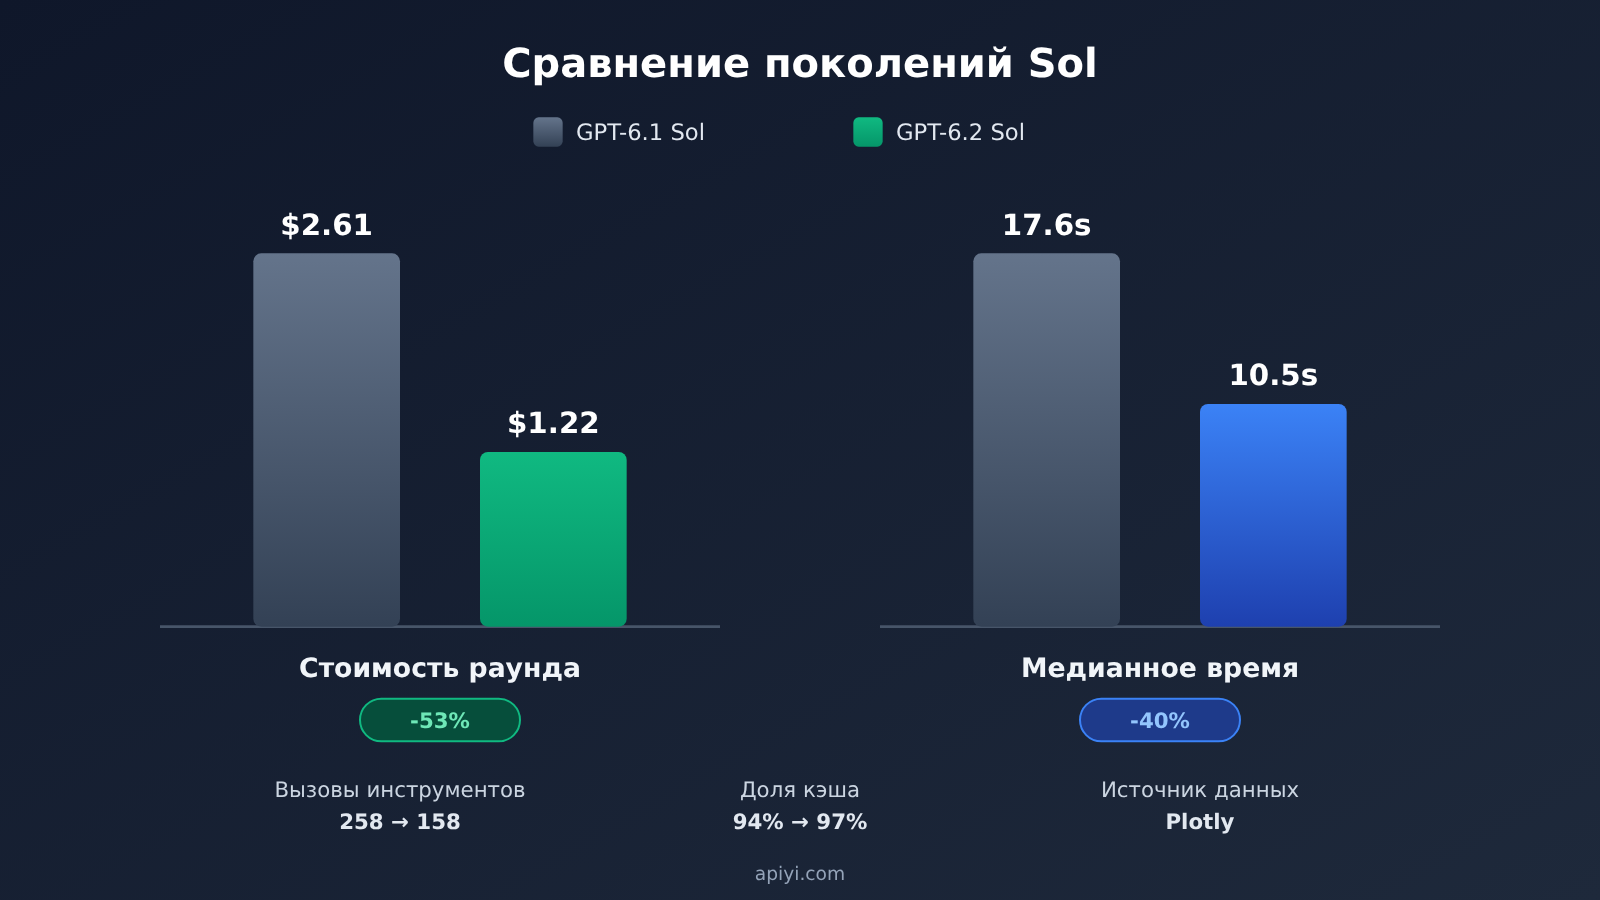
Базовые тарифы Standard с коротким контекстом у двух поколений Sol одинаковые, но стоимость всего раунда почти вдвое ниже. Разница возникает в процессе выполнения задачи: меньше раундов вызовов, меньше токенов на чтение и запись, выше доля попаданий в кэш. Поэтому при оценке стоимости сценария анализа данных стоит считать в единицах «сколько стоит решить одну задачу»; цена за миллион токенов — лишь один из факторов.
2.2 Экстраполяция и допущения для примерно $28.4 за тысячу задач
Делим $1.22 за весь прогон на 43 задачи и получаем в среднем около $0.0284 за задачу. Если экстраполировать это на тысячу задач, выходит примерно $28.4. Чтобы такая цифра имела смысл, должны одновременно выполняться несколько допущений:
- Распределение типов задач совпадает с 43 задачами Plotly, где исследовательские задачи составляют около 12%;
- Используется тот же канал OpenRouter и то же ценообразование;
- Доля попаданий в кэш остаётся около 97%, а задачи используют общий системный промпт и описание структуры таблиц;
- Каждая задача запускается только один раз, без повторных попыток.
Ещё одна цифра в рейтинге Plotly — медианная стоимость одной задачи $0.017. Это другая статистическая величина по сравнению со средним значением. Исследовательские задачи делают больше вызовов инструментов и выполняются дольше, что завышает среднее; медиана же ближе к стоимости обычной задачи с вопросом по данным. При планировании бюджета можно оценивать повседневные вопросы по данным по медиане, а затем отдельно добавлять долю исследовательских задач.
Официальная цена OpenAI для Standard с коротким контекстом: обычный ввод — $2.00, чтение кэша — $0.10, вывод — $10.00 (USD / млн токенов; вывод уже включает токены рассуждения). Если общий объём входных данных запроса превышает 272K, весь запрос переключается на тариф длинного контекста. В публичном интерфейсе цен APIYI apiyi.com тариф для короткого контекста совпадает с официальным, а для длинного контекста: ввод $3, чтение кэша $0.15, запись кэша $3.75, вывод $11.25. В сценариях вопросов по данным один запрос обычно намного меньше 272K; о переключении тарифа стоит думать только когда за один раз передаётся много описаний таблиц или исторических результатов.
3. GPT-6.2 Sol: три сигнала в анализе данных — когда нужно уточнить, а когда передать человеку
3.1 Почему задачи со скрытой закономерностью теряют баллы
В 38 задачах без скрытой закономерности 6.2 Sol в среднем делала около 2,9 вызова инструментов на задачу, а 6.1 Sol — около 4,3. Обе версии прошли все задачи. На 5 задачах со скрытой закономерностью в специализированном отчёте по Sol указано, что 6.2 Sol выполняла в среднем около 9 запросов к базе данных, а 6.1 Sol — около 16. (В статье с общим рейтингом Plotly для предыдущего поколения использовался показатель около 18 запросов; здесь я опираюсь на специализированный отчёт.)
После ручной проверки три задачи, где были потеряны баллы, выглядели так:
- внедрённая закономерность не была выделена отдельно;
- не было указано, какие именно объекты затронуты;
- не был найден тот участок данных, где эффект действительно присутствует.
У всех трёх провалов есть общее: запросы остановились на поверхностном уровне. Это можно записать как наблючение: в исследовательских задачах новая версия ищет более поверхностно. А вот причинно-следственную связь «мало запросов → потеря баллов» можно подтвердить только экспериментом с контролем переменных. Для бизнеса вывод всё равно один: в любых задачах атрибуции, где нужно активно искать доказательства, нельзя принимать первый ответ модели за окончательный вывод.
3.2 Пробел в определении метрики: сначала уточнить, потом отвечать
Ниже на вымышленном наборе данных по тикетам послепродажного обслуживания показаны три варианта вывода. Набор содержит четыре таблицы: заказы, тикеты, партии товаров и склады. Это образцы вывода, а не результаты реальных замеров.
Обычный ответ (определение метрики задано явно). Пользователь спрашивает: «Покажи долю возвратов по складам за последние 7 дней». Качественный ответ должен не только содержать значения по каждому складу, но и сохранять: числитель (количество тикетов на фактический возврат товара), знаменатель (количество заказов, полученных за тот же период), диапазон дат и часовой пояс (например, пекинское время, 11-13 — 11-19), измерение агрегации (склад), а также приложенный выполненный SQL-запрос.
Сначала уточнить определение (определение отсутствует). Пользователь спрашивает только: «Какая доля возвратов была на прошлой неделе?» Модель должна сначала задать уточняющий вопрос: «Долю возвратов считать по заявкам на возврат денег или по фактическому возврату товара? В сценарии возврата только денег эти два подхода сильно расходятся». Затем нужно перечислить два варианта определения на выбор пользователя и не выводить цифры, пока пользователь не выберет.
3.3 Открытая атрибуция: передать аналитику
Пользователь спрашивает: «Доля возвратов по одному каналу выросла вдвое; на каких партиях сосредоточена аномалия?» Это уже задача на скрытые закономерности. Модель может сначала провести первичную проверку: убедиться, что в данных нет пропусков и общего объёма выборки достаточно, а затем последовательно разбить данные по каналу, категории, складу и партии. В выводе нужно сохранить как минимум одно подтверждающее доказательство и одну проверку для исключения альтернативного объяснения (например, подтвердить, что объём заказов по этому каналу на той неделе не снизился аномально, чтобы исключить удвоение из-за уменьшения знаменателя).
После этого вывод следует пометить как «ожидает проверки аналитика», а не как «заключение». Правила маршрутизации можно свести в таблицу:
| Сигнал | Типичный вопрос | Маршрут | Вывод модели | Что проверять при приёмке |
|---|---|---|---|---|
| Определение задано, низкое влияние | Доля возвратов по складам за 7 дней | Sol: только чтение данных | Значения + определение + SQL | Значения совпадают с ручным запросом |
| Не хватает определения или данных | Какова доля возвратов на прошлой неделе | Сначала уточнить | Один уточняющий вопрос + варианты определения | Уточняющий вопрос точно попадает в пробел |
| Открытая атрибуция, внешние решения | На каких партиях сосредоточена аномалия | Передать аналитику на проверку | Журнал проверки + подтверждающие доказательства + проверка альтернативных объяснений | Покрытие доказательствами, ложные срабатывания и пропуски |
4. Проверка аналитических способностей GPT-6.2 Sol на собственных данных
4.1 Подключение и код маршрутизации
gpt-6.2-sol можно вызывать через два эндпоинта — Responses и Chat Completions; вызов функций и встроенные инструменты идут по пути Responses. Ни один из эндпоинтов не принимает уровень рассуждений none, поэтому при переносе старого кода этот параметр нужно проверить. Ниже — минимальный пример классификации маршрутов через Chat Completions:
import openai, json

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)

question = "Какая была доля возвратов на прошлой неделе"
resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[
        {"role": "system", "content": "Классифицируй вопрос пользователя о данных как direct / clarify / escalate, "
                                      "возвращай только JSON: {\"route\":..., \"reason\":...}"},
        {"role": "user", "content": question},
    ],
)
print(json.loads(resp.choices[0].message.content))
Полный пример вызова инструмента read-only SQL (Responses API)
import openai, json, sqlite3

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# На уровне базы соединение открываем в режиме только для чтения,
# проверка строки запроса — лишь вторая линия защиты
conn = sqlite3.connect("file:aftersales.db?mode=ro", uri=True)

def run_readonly_sql(sql: str) -> str:
    head = sql.strip().lower()
    if not (head.startswith("select") or head.startswith("with")):
        return json.dumps({"error": "only read-only queries allowed"})
    rows = conn.execute(sql).fetchmany(200)
    return json.dumps({"rows": rows, "row_count": len(rows)}, default=str)

tools = [{
    "type": "function",
    "name": "run_readonly_sql",
    "description": "Выполняет read-only SQL в хранилище данных послепродажного обслуживания, возвращает не более 200 строк",
    "parameters": {
        "type": "object",
        "properties": {"sql": {"type": "string"}},
        "required": ["sql"],
    },
}]

instructions = (
    "Ты ассистент по анализу данных. Ответ обязательно должен содержать: числитель, знаменатель, "
    "временной диапазон и часовой пояс, измерение агрегации, выполненный SQL. "
    "Если трактовка метрики неоднозначна — сначала задай вопрос; выводы о причинах помечай как ожидающие проверки аналитиком."
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    instructions=instructions,
    input="Покажи долю возвратов по складам за последние 7 дней",
    tools=tools,
)

# Крутим вызовы инструментов в цикле, пока модель не выдаст финальный ответ
while True:
    calls = [o for o in resp.output if o.type == "function_call"]
    if not calls:
        break
    outputs = [{
        "type": "function_call_output",
        "call_id": c.call_id,
        "output": run_readonly_sql(json.loads(c.arguments)["sql"]),
    } for c in calls]
    resp = client.responses.create(
        model="gpt-6.2-sol",
        previous_response_id=resp.id,
        input=outputs,
        tools=tools,
    )

print(resp.output_text)
print("output_tokens:", resp.usage.output_tokens)
🚀 Быстрый старт: чтобы проверить модель на собственных бизнес-примерах, можно запросить бесплатный тестовый лимит для новых пользователей через APIYI apiyi.com. Один и тот же API-ключ позволяет переключаться между
gpt-6.2-solи другими популярными моделями и сравнивать их на одном и том же наборе задач — достаточно держать источник данных в режиме только для чтения.
4.2 Приёмочные метрики по типам заданий
Набор вопросов для приёмки стоит строить так, чтобы он покрывал все три маршрута из раздела 3, а каждый тип задания оценивался отдельно.
| Тип задания | Основная метрика | Способ оценки | Что рекомендуется фиксировать |
|---|---|---|---|
| Вопросы с фиксированным определением метрики | Точность числовых значений | Построчное сравнение с результатами ручного SQL | Стоимость одного вопроса, задержка p50/p95 |
| Отсутствует определение метрики | Доля уместных уточнений | Попадает ли уточняющий вопрос в действительно отсутствующее определение | Были ли случаи «спросил, хотя не должен был» |
| Данные не позволяют ответить | Доля корректных отказов | Не выдумывать цифры | Число ошибочных ответов |
| Открытый анализ причин | Покрытие доказательствами, ложные срабатывания и пропуски | Проверка полноты поддерживающих доказательств и альтернативных объяснений | Согласованность при нескольких повторных прогонах |
В отчёте Plotly приведена только медиана времени выполнения — в собственной приёмке обязательно добавьте p95. Впечатление пользователя часто портят немногочисленные «длиннохвостые» запросы, а в исследовательских заданиях такой хвост встречается особенно часто. Что касается стоимости: объём вывода читайте из usage.output_tokens, токены рассуждений обычно перечислены в подпункте output_tokens_details.reasoning_tokens, а затем вместе с объёмом чтения из кэша считайте фактическую стоимость одного вопроса.
4.3 Малая выборка и границы повторных прогонов
У Plotly скрытый набор — всего 5 задач, и доверительный интервал для 2/5 очень широкий: на другой выборке может выйти 1/5, а может и 4/5. У других моделей при повторных прогонах колебания достигали трёх задач, так что разница в суммарном балле за один прогон ещё не основание для выбора модели. Когда принимаете решение сами, прогоняйте исследовательские задачи хотя бы несколько раундов и держите одинаковыми пять переменных: снимок данных, набор инструментов, уровень рассуждений модели, канал вызова и таблицу оценки. Если изменилось хоть что-то одно, результаты «до» и «после» напрямую сравнивать нельзя.
💡 Рекомендация по приёмке: канал — та переменная, которую проще всего упустить. Расходы Plotly идут через OpenRouter, а в вашем продакшн-канале тарификация и политика кэширования могут быть другими. Прогоните тот же снимок данных через APIYI apiyi.com, пересчитайте стоимость на тысячу задач с учётом реального счёта — и уже потом решайте про квоты для фронтенда.
4.4 Как выглядит результат, готовый к приёмке
Критерий приёмки такой: каждый результат запроса данных должен давать третьему человеку возможность независимо его перепроверить. Вот как выглядит годный результат (данные вымышленные):
question: Доля возвратов по складам за последние 7 дней
route: direct
data_snapshot: 2026-11-19 23:59 (Asia/Shanghai)
metric_definition:
  numerator: количество заявок на фактический возврат товара (status = returned)
  denominator: количество заказов, доставленных за тот же период (исключая тестовые и внутренние заказы)
  time_range: 2026-11-13 ~ 2026-11-19, по пекинскому времени
  group_by: warehouse_id
query: "SELECT w.warehouse_id, ... GROUP BY w.warehouse_id"
result: [{warehouse: Склад Восток-1, rate: 3.1%}, {warehouse: Склад Юг-2, rate: 2.4%}]
model: gpt-6.2-sol
cost_usd: 0.012
latency_s: 8.7
reviewer: проверка не требуется (запрос с фиксированной методикой расчёта)
Готовый результат включает дату данных, методику расчёта, запрос и сам результат — на этапе запросов данных во фронтенде GPT-6.2 Sol уже можно принимать. Вывод без этих пунктов, даже если цифры случайно оказались верными, в отчётность попадать не должен. Если хотите прогнать эту схему на своём складе, начните с OpenAI-совместимого интерфейса APIYI apiyi.com: сначала запустите запросы с фиксированной методикой, а потом постепенно расширяйте до уточняющих вопросов и разбора причин.
Справочные материалы
- Plotly — специальный отчёт по анализу данных GPT-6.2 Sol: результаты по 43 задачам, сравнение стоимости и времени выполнения
- Ссылка:
plotly.com/blog/gpt-6-2-sol-plotly-data-analytics-bench
- Ссылка:
- Plotly — методика тестирования DataAnalyticsBench: дизайн типов задач, правила оценки и методика подсчёта в рейтинге
- Ссылка:
plotly.com/blog/introducing-dataanalyticsbench
- Ссылка:
- OpenAI — карточка модели GPT-6.2 Sol: контекстное окно, поддержка эндпоинтов и правила тарификации длинного контекста
- Ссылка:
developers.openai.com/api/docs/models/gpt-6.2-sol
- Ссылка:
- OpenAI — тарифы API: цена за вход в Standard, кэш и выход
- Ссылка:
developers.openai.com/api/docs/pricing
- Ссылка:
- Публичный интерфейс тарифов APIYI: выражения расчёта цены для
gpt-6.2-solв коротком и длинном диапазонах- Ссылка:
api.apiyi.com/api/pricing
- Ссылка:
Автор: техническая команда APIYI
Обсуждение технологий: свяжитесь с нами на главной странице официального сайта APIYI, больше материалов по интеграции — в центре документации docs.apiyi.com


